8Hệ thống RAG#
Quay lại trợ lý quy chế ở Chương 1. Mô hình không biết quy chế của công ty, còn ta đã có cách tìm những điều khoản liên quan tới một câu hỏi (Chương 6 và 7). Bước còn lại là đưa các điều khoản đó vào ngữ cảnh và yêu cầu mô hình trả lời dựa trên chúng. Kỹ thuật này có tên Retrieval-Augmented Generation (RAG; Lewis và cộng sự, 2020): truy xuất các tài liệu liên quan tới câu hỏi rồi đưa chúng vào ngữ cảnh, để mô hình trả lời dựa trên tài liệu thay vì chỉ dựa vào kiến thức nằm trong tham số. Đây là mẫu thiết kế phổ biến nhất của ứng dụng LLM trong doanh nghiệp. Nghe thì đơn giản, nhưng như thí nghiệm ở Mục 8.5 sẽ cho thấy, đưa tài liệu vào ngữ cảnh có thể giúp mà cũng có thể hại.
8.1Vai trò của RAG#
RAG giải quyết ba giới hạn của LLM đã nêu ở Mục 2.6: kiến thức dừng ở mốc cắt, không biết tài liệu nội bộ của tổ chức, và ảo giác khi không biết. Với RAG, kiến thức nằm trong kho tài liệu và cập nhật được bất cứ lúc nào mà không cần huấn luyện lại; câu trả lời có thể kèm trích dẫn nguồn để người dùng kiểm tra; và quyền truy cập được kiểm soát theo từng tài liệu. Các trường hợp sử dụng điển hình là hỏi đáp trên tài liệu nội bộ như quy định, hướng dẫn hay hợp đồng, hỗ trợ khách hàng dựa trên cơ sở tri thức sản phẩm, tìm kiếm và tổng hợp trong tài liệu kỹ thuật hoặc mã nguồn, và trợ lý nghiên cứu trên một kho bài báo.
Người mới thường phân vân giữa RAG và tinh chỉnh. Hai kỹ thuật giải quyết hai vấn đề khác nhau. RAG đưa kiến thức vào: sự kiện, số liệu, nội dung tài liệu. Tinh chỉnh thay đổi hành vi: định dạng, giọng văn, cách làm một nhiệm vụ hẹp. Ovadia và cộng sự (2024) so sánh hai cách đưa kiến thức mới vào LLM và thấy RAG cho kết quả tốt hơn tinh chỉnh không giám sát một cách nhất quán, cả với kiến thức mô hình đã gặp khi huấn luyện lẫn kiến thức hoàn toàn mới. Hai kỹ thuật cũng không loại trừ nhau: một mô hình được tinh chỉnh để trả lời đúng định dạng và biết trích dẫn, kết hợp với RAG để cung cấp nội dung, là thiết kế thường gặp.
8.2Quy trình RAG#
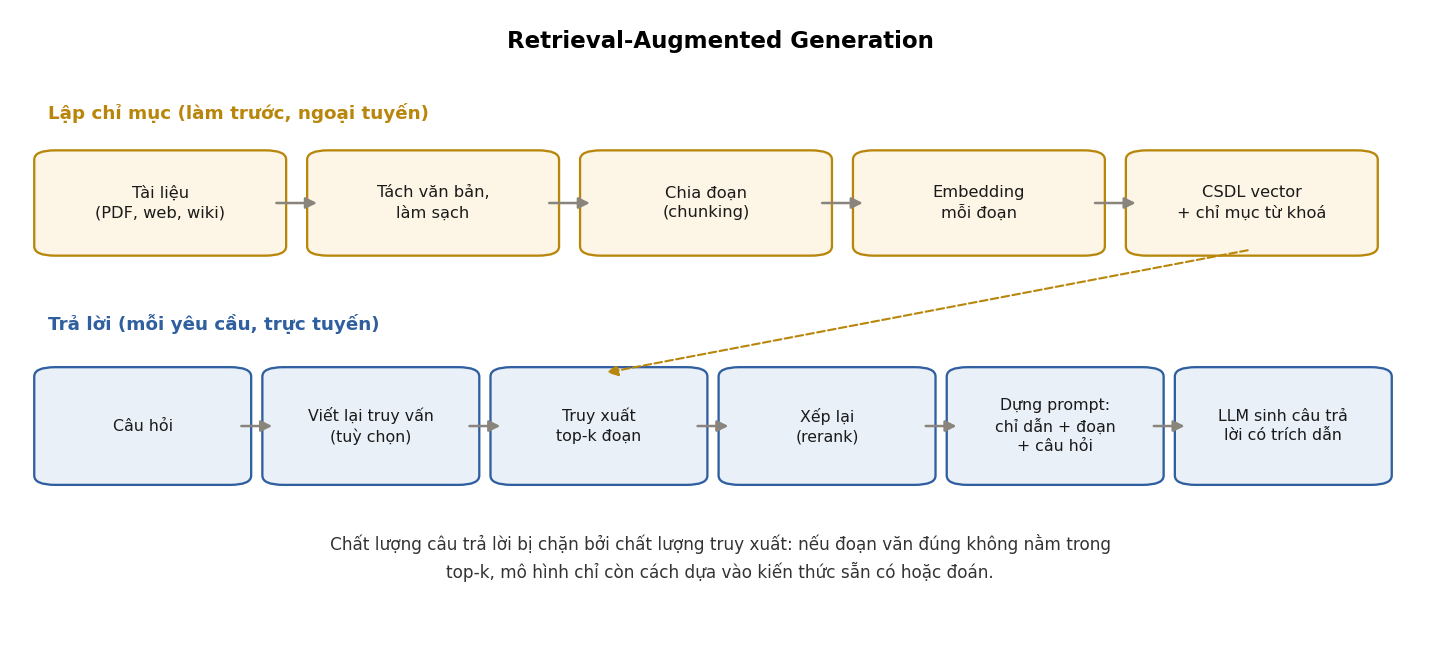
Như Hình 8 cho thấy, một hệ thống RAG có hai giai đoạn chạy vào hai thời điểm khác nhau. Giai đoạn lập chỉ mục được làm trước và ngoại tuyến. Văn bản được tách khỏi tài liệu gốc (PDF, trang web, tệp văn phòng) và làm sạch, giữ lại cấu trúc như tiêu đề và bảng, cùng metadata như tên tài liệu, ngày và quyền truy cập. Văn bản sau đó được chia thành các đoạn, là đơn vị truy xuất (Mục 8.3). Mỗi đoạn được tính embedding và lưu vào cơ sở dữ liệu vector (Chương 7), thường kèm một chỉ mục từ khoá để tìm kiếm kết hợp.
Giai đoạn trả lời chạy cho mỗi yêu cầu. Câu hỏi có thể được viết lại trước: một câu phụ thuộc hội thoại như "còn cái kia thì sao?" được biến thành câu hỏi đầy đủ, hoặc một câu hỏi phức tạp được tách thành nhiều câu hỏi con. Hệ thống truy xuất đoạn liên quan nhất, thường là vài chục ứng viên, rồi có thể xếp lại các ứng viên bằng một mô hình chính xác hơn và giữ vài đoạn tốt nhất (Mục 8.4). Prompt được dựng từ chỉ dẫn, các đoạn kèm nguồn và câu hỏi, và mô hình sinh câu trả lời kèm trích dẫn tới các đoạn đã dùng.
Chỉ dẫn cho bước sinh thường yêu cầu mô hình trả lời chỉ dựa trên các đoạn tài liệu được cung cấp, trích dẫn nguồn cho mỗi khẳng định, nói rõ là không tìm thấy nếu tài liệu không chứa câu trả lời thay vì dùng kiến thức bên ngoài, và nếu các tài liệu mâu thuẫn thì nêu cả hai kèm nguồn của mỗi bên.
Từ quy trình này thấy ngay rằng chất lượng của RAG bị chặn trên bởi chất lượng truy xuất. Nếu đoạn chứa câu trả lời không nằm trong đoạn đưa vào ngữ cảnh, mô hình tốt đến đâu cũng chỉ có thể dựa vào kiến thức sẵn có, đoán, hoặc nói không biết.
8.3Chia đoạn#
Chia đoạn (chunking) quyết định đơn vị mà hệ thống truy xuất và đưa vào ngữ cảnh. Đoạn nhỏ cho phép truy xuất chính xác phần liên quan, nhưng mất ngữ cảnh xung quanh: một đoạn "Thời hạn là 30 ngày" không cho biết thời hạn của việc gì. Đoạn lớn giữ đủ ngữ cảnh, nhưng embedding của nó là "trung bình" của nhiều ý nên kém đặc trưng, tốn nhiều token khi đưa vào ngữ cảnh, và có thể vượt độ dài tối đa của mô hình embedding.
Có bốn chiến lược chia đoạn thường dùng, và chúng có thể kết hợp với nhau. Cách đơn giản nhất là chia theo kích thước cố định tính bằng token, với một phần chồng lấn giữa các đoạn liền nhau, thường từ 10 tới 20%, để một ý nằm ở ranh giới không bị cắt đôi. Với tài liệu có cấu trúc rõ như văn bản quy định hay tài liệu kỹ thuật, chia theo cấu trúc thường tốt hơn: chia theo chương, mục, điều khoản, đoạn văn, và chỉ chia tiếp khi một đơn vị quá dài. Để mỗi đoạn tự đứng được khi bị tách khỏi tài liệu, có thể gắn tiêu đề của tài liệu và của các mục cha vào đầu đoạn; đoạn "Thời hạn là 30 ngày" khi đó mang theo cả tên điều khoản nói về thời hạn gì. Cuối cùng, có thể truy xuất đoạn nhỏ nhưng trả về đoạn lớn (parent document retrieval): lập chỉ mục các đoạn nhỏ để tìm cho chính xác, còn khi đưa vào ngữ cảnh thì lấy cả mục chứa đoạn đó.
Nửa bên phải của Hình 6 ở Mục 6.5 đo ảnh hưởng của kích thước đoạn trên kho văn bản của lộ trình, với 80 truy vấn có nhãn mục (30 câu trắc nghiệm có lời giải trỏ tới mục và 50 câu hỏi diễn đạt lại). Mỗi đoạn được gắn với mục chứa nó, và thước đo là tỉ lệ truy vấn có mục đúng nằm trong 5 mục đầu tiên sau khi loại trùng.
| Kích thước đoạn | Số đoạn | BM25 | e5-small | RRF |
|---|---|---|---|---|
| 50 từ | 2 245 | 0,637 | 0,662 | 0,700 |
| 100 từ | 1 161 | 0,675 | 0,637 | 0,688 |
| 200 từ | 616 | 0,688 | 0,662 | 0,713 |
| 400 từ | 391 | 0,738 | 0,650 | 0,738 |
| cả mục | 332 | 0,725 | 0,637 | 0,750 |
Trên kho này, BM25 tốt lên khi đoạn lớn hơn và tốt nhất ở khoảng 400 từ, vì đoạn lớn chứa nhiều từ khoá của chủ đề hơn. Embedding gần như không đổi theo kích thước, một phần vì đoạn dài bị cắt ở 512 token. Kết hợp RRF tốt nhất khi dùng nguyên mục (0,750). Kết quả này phản ánh một kho có cấu trúc rõ, mỗi mục bàn một chủ đề; với tài liệu không có cấu trúc, như bản ghi cuộc họp, kết quả có thể khác. Điều không đổi là kích thước đoạn nên được chọn bằng thí nghiệm như trên, và chia theo cấu trúc tự nhiên của tài liệu là điểm khởi đầu hợp lý.
8.4Cải thiện truy xuất#
Vì truy xuất chặn trên chất lượng của cả hệ thống, khi kết quả kém thì đó thường là chỗ đầu tiên cần sửa. Các kỹ thuật dưới đây thường được thử theo thứ tự chi phí tăng dần.
Rẻ nhất là tìm kiếm kết hợp BM25 và embedding bằng RRF như ở Mục 6.5. Cách này ít tốn kém và cho hiệu quả ổn định, nhất là với tài liệu có nhiều thuật ngữ, mã sản phẩm hay tên riêng mà embedding hay bỏ lỡ. Tiếp theo là bộ lọc metadata, giới hạn truy xuất trong đúng loại tài liệu, đúng phiên bản còn hiệu lực, đúng phòng ban. Bộ lọc thường cải thiện kết quả nhiều hơn việc đổi mô hình embedding, vì nó loại bỏ những ứng viên sai mà nội dung lại giống câu hỏi, như một quy định của năm cũ đã hết hiệu lực.
Đắt hơn một chút là viết lại truy vấn bằng LLM: viết lại câu hỏi cho đầy đủ, sinh nhiều cách diễn đạt rồi truy xuất với từng cách (multi-query), hoặc sinh một câu trả lời giả định rồi dùng embedding của nó để tìm những tài liệu giống câu trả lời (HyDE; Gao và cộng sự, 2023). Mỗi cách tốn thêm một lời gọi mô hình trước bước truy xuất. Đắt hơn nữa là xếp lại bằng cross-encoder: truy xuất khoảng 20 tới 100 ứng viên bằng phương pháp nhanh, rồi dùng cross-encoder (Mục 6.1) chấm mức liên quan của từng cặp câu hỏi và đoạn văn, giữ lại vài đoạn tốt nhất (Nogueira và Cho, 2019). Cross-encoder chính xác hơn bi-encoder vì nhìn cả câu hỏi và đoạn văn cùng lúc, và chi phí của nó tăng theo số ứng viên được xếp lại.
Cuối cùng là chọn . lớn tăng khả năng có đoạn đúng trong ngữ cảnh, nhưng cũng tăng chi phí, độ trễ và lượng thông tin gây nhiễu (Mục 5.3). Giá trị hợp lý nằm ở chỗ recall@ đo trên bộ truy vấn bắt đầu tăng chậm lại.
8.5Thí nghiệm RAG với câu hỏi trắc nghiệm#
Để đo tác dụng của truy xuất một cách định lượng, thí nghiệm cho mô hình Qwen2.5-0.5B-Instruct trả lời 254 câu hỏi trắc nghiệm 4 phương án của các giáo trình, trong ba điều kiện. Ở điều kiện thứ nhất, mô hình chỉ nhận câu hỏi và bốn phương án, nên phải dựa vào kiến thức sẵn có. Ở điều kiện thứ hai, prompt có thêm 2 mục có điểm cao nhất theo tìm kiếm kết hợp BM25 và e5-small (Mục 6.5), dùng chính câu hỏi làm truy vấn, mỗi mục cắt còn 220 từ đầu; đây là RAG thông thường. Ở điều kiện thứ ba, prompt có thêm 2 mục thuộc đúng chương của câu hỏi, ưu tiên mục mà lời giải trỏ tới, và cho biết kết quả khi truy xuất gần như hoàn hảo ở mức chương. Mô hình chọn đáp án bằng cách so xác suất của bốn chữ cái A, B, C, D ở token trả lời đầu tiên, nên kết quả tất định và không phụ thuộc vào cách mô hình trình bày câu trả lời.
| Điều kiện | Độ chính xác | Token đầu vào trung bình |
|---|---|---|
| Không có ngữ cảnh | 0,480 | 137 |
| 2 mục truy xuất (BM25 + e5-small, RRF) | 0,516 | 813 |
| 2 mục thuộc đúng chương | 0,535 | 813 |
Để có mốc so sánh, chọn ngẫu nhiên được 0,250, và bước truy xuất đưa về ít nhất một mục thuộc đúng chương ở 88,6% số câu. Bảng này cần được đọc cẩn thận, vì ba con số độ chính xác dễ dẫn tới những kết luận vội.
Trước hết, không có ngữ cảnh mô hình đã đúng gần một nửa. Nhiều câu hỏi về các khái niệm phổ biến như overfitting, gradient descent hay attention trả lời được bằng kiến thức học từ tiền huấn luyện, và RAG chỉ có thể cải thiện những câu mà kiến thức sẵn có chưa đủ.
Tiếp theo, mức cải thiện chung không có ý nghĩa thống kê. Ngữ cảnh truy xuất tăng độ chính xác 3,6 điểm phần trăm, ngữ cảnh đúng chương tăng 5,5 điểm. Với 254 câu, sai số chuẩn của mỗi độ chính xác khoảng 3,1 điểm, nên không thể kết luận chỉ bằng cách so hai con số. Vì ba điều kiện chạy trên cùng các câu hỏi, cách so sánh đúng là so sánh ghép cặp bằng kiểm định McNemar (Mục 12.4), trong đó chỉ những câu mà hai điều kiện cho kết quả khác nhau mới mang thông tin về việc điều kiện nào tốt hơn.
| So sánh | Số câu chỉ A đúng | Số câu chỉ B đúng | |
|---|---|---|---|
| A: ngữ cảnh truy xuất, B: không ngữ cảnh | 39 | 30 | 0,34 |
| A: ngữ cảnh đúng chương, B: không ngữ cảnh | 45 | 31 | 0,14 |
| A: ngữ cảnh đúng chương, B: ngữ cảnh truy xuất | 26 | 21 | 0,56 |
Ngữ cảnh truy xuất giúp trả lời đúng 39 câu mà không có ngữ cảnh thì sai, nhưng lại làm sai 30 câu mà không có ngữ cảnh thì đúng. Không so sánh nào đạt mức ý nghĩa 5%. Mô phỏng với đúng các tỉ lệ này cho thấy cần khoảng 1 800 câu hỏi để có 80% khả năng phát hiện mức cải thiện của ngữ cảnh truy xuất. Một bộ đánh giá vài trăm câu đủ để thấy các khác biệt lớn, nhưng không đủ cho các khác biệt cỡ vài điểm phần trăm.
Điều thứ ba chỉ lộ ra khi tách các câu theo kết quả của bước truy xuất: ngữ cảnh sai làm hại nhiều hơn ngữ cảnh đúng giúp ích.
| Nhóm câu | Số câu | Không ngữ cảnh | Có ngữ cảnh truy xuất |
|---|---|---|---|
| Truy xuất có mục thuộc đúng chương | 225 | 0,467 | 0,547 |
| Truy xuất không có mục nào thuộc đúng chương | 29 | 0,586 | 0,276 |
Khi truy xuất đúng, độ chính xác tăng 8 điểm phần trăm. Khi truy xuất sai, độ chính xác giảm từ 0,586 xuống 0,276: ở 29 câu này, mô hình vốn trả lời đúng phần lớn bằng kiến thức của mình, nhưng khi được đưa hai đoạn văn không liên quan, nó bị kéo theo nội dung của đoạn văn. Nhóm này chỉ có 29 câu nên con số cụ thể có sai số lớn, nhưng chiều của hiệu ứng khớp với các nghiên cứu về việc mô hình ngôn ngữ dễ bị ngữ cảnh không liên quan làm sai lệch (Shi và cộng sự, 2023). Trong thực tế, điều này có nghĩa là độ chính xác của bước truy xuất quan trọng không kém recall: nên cân nhắc bỏ các đoạn có điểm truy xuất thấp thay vì luôn đưa đủ đoạn, và nên cho mô hình biết nó được phép bỏ qua tài liệu không liên quan.
Cuối cùng, ngay cả với ngữ cảnh đúng, bước sinh vẫn yếu: với ngữ cảnh thuộc đúng chương, mô hình chỉ đúng khoảng 54%. Có ba nguyên nhân có thể. Mô hình 0,5 tỉ tham số còn yếu khi phải đọc 800 token văn bản kỹ thuật tiếng Việt. Mỗi mục bị cắt còn 220 từ đầu, nên phần chứa đáp án có thể bị bỏ mất. Và nhiều câu trắc nghiệm đòi hỏi suy luận từ nội dung chứ không phải tra một câu có sẵn.
Kết luận đúng ở đây không phải là "RAG không hiệu quả", mà là tác dụng của RAG phụ thuộc vào cả hai bước, và đo riêng từng bước (Mục 8.6) cho biết nên đầu tư vào đâu. Với hệ thống này, cả hai hướng đều cần: lọc bỏ ngữ cảnh không liên quan ở bước truy xuất, và dùng mô hình lớn hơn hoặc đưa ngữ cảnh đầy đủ hơn ở bước sinh. Chi phí cũng phải tính vào, vì ngữ cảnh làm số token đầu vào tăng khoảng 6 lần, từ 137 lên 813 token mỗi câu.
8.6Đánh giá RAG#
Thí nghiệm trên cho thấy vì sao đánh giá RAG phải tách riêng hai bước: chất lượng cuối cùng phụ thuộc vào hai bước nối tiếp, và chỉ khi đo riêng mới biết lỗi nằm ở bước nào. Với bước truy xuất, câu hỏi là đoạn chứa câu trả lời có nằm trong ngữ cảnh không. Nó được đo bằng recall@ và MRR trên bộ truy vấn có nhãn đoạn đúng (Mục 6.6); khi không có nhãn, có thể dùng giám khảo LLM chấm mức liên quan của từng đoạn truy xuất được, gọi là context precision. Với bước sinh, câu hỏi là khi đã có ngữ cảnh, câu trả lời có đúng và có bám vào ngữ cảnh không. Hai thước đo phổ biến là độ trung thành (faithfulness), tức tỉ lệ các khẳng định trong câu trả lời được ngữ cảnh hỗ trợ, dùng để đo sai lệch so với nguồn và ảo giác, và mức liên quan của câu trả lời (answer relevance), tức câu trả lời có thật sự trả lời câu hỏi không.
Thư viện RAGAS (Es và cộng sự, 2023) cài đặt các thước đo này bằng giám khảo LLM. Như mọi đánh giá dựa trên giám khảo (Mục 12.2), điểm số cần được đối chiếu định kỳ với nhãn do người gán.
Khi phân tích lỗi, cách làm thường dùng là lấy các câu trả lời sai, xem ngữ cảnh đã đưa vào (Chương 13), và xếp mỗi lỗi vào một trong các nhóm: tài liệu không có trong kho; có trong kho nhưng không được truy xuất; được truy xuất nhưng bị cắt hoặc bị chôn giữa nhiều đoạn khác; có trong ngữ cảnh nhưng mô hình trả lời sai hoặc bịa thêm. Tỉ lệ giữa các nhóm cho biết nên đầu tư vào đâu: bổ sung tài liệu, cải thiện truy xuất, chỉnh cách đưa ngữ cảnh, hay đổi mô hình và prompt ở bước sinh.
8.7Các cách hiện thực#
Có thể xây RAG bằng cách gọi trực tiếp SDK của các thành phần (mô hình embedding, cơ sở dữ liệu vector, API mô hình ngôn ngữ), hoặc dùng các khung chuyên cho RAG được nhắc tới trong roadmap như LangChain, LlamaIndex, Haystack và RAGFlow. Khung giúp có nhanh một hệ thống chạy được, với sẵn các bộ đọc tài liệu, chiến lược chia đoạn và cách kết hợp truy xuất. Tự viết giúp kiểm soát và hiểu rõ từng bước, và với một quy trình RAG cơ bản, lượng mã không nhiều. Dù chọn cách nào, những quyết định ảnh hưởng nhiều nhất tới chất lượng là chung: cách tách và chia tài liệu, phương pháp truy xuất, bộ lọc quyền, chỉ dẫn cho bước sinh, và bộ đánh giá. Các quyết định đó không nên để giá trị mặc định của thư viện quyết định thay.
8.8Tóm tắt#
RAG đưa kiến thức vào mô hình bằng cách truy xuất tài liệu liên quan và đặt chúng vào ngữ cảnh, còn tinh chỉnh dùng để thay đổi hành vi. Hệ thống gồm giai đoạn lập chỉ mục chạy trước và giai đoạn trả lời chạy cho mỗi yêu cầu, và chất lượng của nó bị chặn trên bởi chất lượng truy xuất. Trên kho văn bản của lộ trình, chia đoạn theo mục cho kết quả truy xuất tốt nhất khi kết hợp BM25 và embedding. Thí nghiệm với Qwen2.5-0.5B-Instruct trên 254 câu trắc nghiệm cho thấy RAG tăng độ chính xác từ 0,480 lên 0,516, một mức chưa có ý nghĩa thống kê với cỡ mẫu này; ngữ cảnh đúng giúp tăng 8 điểm phần trăm, còn ngữ cảnh sai làm độ chính xác giảm từ 0,586 xuống 0,276. Vì vậy đánh giá RAG phải đo riêng truy xuất và sinh.
Trong RAG, ứng dụng quyết định mọi bước: luôn truy xuất, luôn đưa đoạn vào, luôn gọi mô hình một lần. Nhiều nhiệm vụ không đi theo một đường cố định như vậy. Muốn biết vì sao một đơn hàng chưa tới, trước hết phải tra mã đơn, rồi tuỳ trạng thái mà tra tiếp đơn vị vận chuyển hay hệ thống hoàn tiền. Khi để mô hình tự quyết định bước tiếp theo, ta có một agent, chủ đề của Chương 9.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1RAG phù hợp hơn fine-tuning trong trường hợp nào?
Vì sao: Fine-tuning phù hợp để thay đổi hành vi; RAG phù hợp để đưa kiến thức vào (Mục 8.1).2Trên kho văn bản của lộ trình, cách chia đoạn nào cho kết quả tốt nhất khi kết hợp BM25 và e5-small bằng RRF?
Vì sao: RRF đạt 0,750 khi dùng cả mục; BM25 đơn lẻ tốt nhất với đoạn 400 từ (0,738) và cả mục (0,725). Kết quả phụ thuộc cấu trúc tài liệu nên cần đo (Mục 8.3).3Vì sao cần ghi lại các đoạn đã truy xuất cho mỗi câu trả lời của hệ thống RAG?
Vì sao: Hai loại lỗi cần cách sửa khác nhau và được đo bằng thước đo khác nhau (Mục 8.6).
Đã trả lời 0/3