9Agent#
Hệ thống RAG ở Chương 8 đi theo một đường cố định do lập trình viên vạch sẵn. Câu hỏi "vì sao đơn hàng DH1024 chưa tới?" thì không có đường cố định nào: phải tra đơn trước, và tuỳ đơn đang ở kho, đang trên đường hay đã bị huỷ mà bước tiếp theo là hỏi đơn vị vận chuyển, kiểm tra thanh toán hay mở yêu cầu hoàn tiền. Muốn hệ thống xử lý được những nhiệm vụ như vậy, ta phải để mô hình tự chọn bước tiếp theo dựa trên kết quả của bước trước. Hệ thống như thế gọi là agent. Nó linh hoạt hơn mọi thứ đã xét ở các chương trước, và cũng khó làm cho đáng tin hơn, như phép tính ở Mục 9.7 sẽ cho thấy.
9.1Workflow và agent#
Có nhiều định nghĩa khác nhau về agent. Giáo trình dùng cách phân biệt của Anthropic (2024) giữa hai loại hệ thống dùng LLM kết hợp với tool. Trong một workflow, mô hình và tool được điều phối theo một đường đi định sẵn trong mã. Chẳng hạn hệ thống truy xuất tài liệu, gọi mô hình để trả lời, rồi gọi mô hình lần nữa để kiểm tra câu trả lời; các bước và thứ tự của chúng do lập trình viên quyết định. Trong một agent, mô hình tự quyết định bước tiếp theo: gọi tool nào, với tham số nào, và khi nào dừng, dựa trên kết quả của các bước trước.
Định nghĩa 9.1 (Agent)
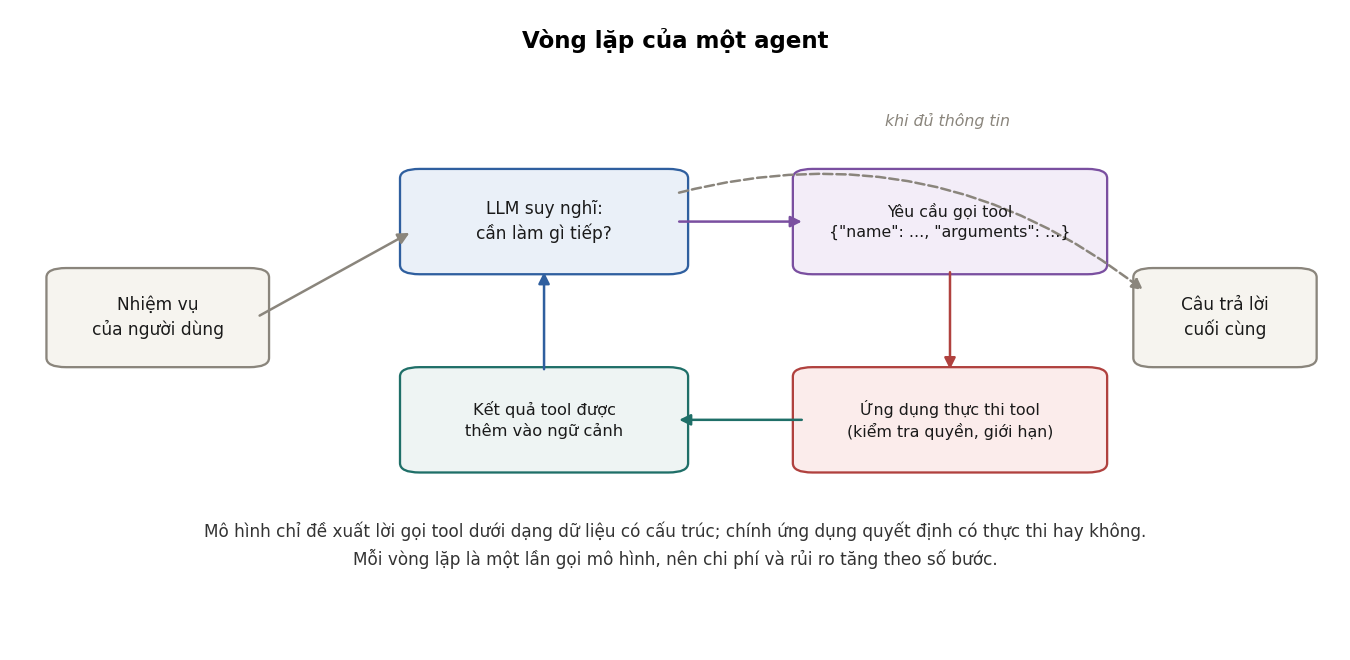
Một agent là hệ thống trong đó mô hình ngôn ngữ được gọi lặp đi lặp lại trong một vòng lặp: ở mỗi vòng, mô hình quan sát trạng thái hiện tại (nhiệm vụ, kết quả các hành động trước), chọn một hành động (gọi một tool hoặc đưa ra câu trả lời cuối), và ứng dụng thực hiện hành động đó rồi đưa kết quả trở lại cho mô hình.
Agent linh hoạt hơn workflow, vì nó xử lý được những nhiệm vụ mà số bước và thứ tự bước không biết trước. Đổi lại, agent khó dự đoán hơn, tốn nhiều lời gọi mô hình hơn, và có thêm nhiều cách hỏng. Vì vậy nguyên tắc chung là dùng giải pháp đơn giản nhất đáp ứng được yêu cầu. Nhiều bài toán được giải tốt bằng một lời gọi mô hình với ngữ cảnh tốt, hoặc bằng một workflow vài bước; chỉ nên dùng agent khi thật sự cần sự linh hoạt đó.
Agent hiện được dùng nhiều nhất trong lập trình, nơi nó đọc mã, sửa tệp, chạy kiểm thử rồi sửa tiếp theo kết quả kiểm thử (Chương 15). Nó cũng được dùng trong hỗ trợ khách hàng có hành động như tra đơn hàng, kiểm tra chính sách và tạo yêu cầu đổi trả; trong nghiên cứu, khi phải tìm nhiều nguồn, đọc, tổng hợp rồi tìm tiếp theo những gì vừa đọc; và trong phân tích dữ liệu, khi phải viết truy vấn SQL, chạy, xem kết quả rồi viết truy vấn tiếp. Các trường hợp này có chung một đặc điểm: kết quả của mỗi bước kiểm tra được, như kiểm thử chạy qua hay truy vấn trả về dữ liệu, nên agent tự nhận ra được khi bước trước sai.
9.2Các mẫu workflow#
Trước khi dùng agent, nên xét các mẫu workflow đơn giản hơn. Anthropic (2024) mô tả năm mẫu thường gặp, tóm tắt trong bảng dưới.
| Mẫu | Cách làm | Ví dụ |
|---|---|---|
| Nối chuỗi prompt (prompt chaining) | chia nhiệm vụ thành các bước cố định, đầu ra bước trước là đầu vào bước sau, có thể kiểm tra giữa các bước | viết dàn ý, kiểm tra dàn ý, rồi viết bài |
| Định tuyến (routing) | phân loại yêu cầu rồi chuyển tới quy trình chuyên biệt | câu hỏi hoàn tiền đi một đường, câu hỏi kỹ thuật đi đường khác |
| Song song hoá (parallelization) | chạy nhiều lời gọi độc lập cùng lúc rồi gộp kết quả | kiểm tra một văn bản theo năm tiêu chí khác nhau cùng lúc |
| Điều phối và thực thi (orchestrator–workers) | một lời gọi chia việc động thành các phần việc con, các lời gọi khác làm từng phần | sửa một thay đổi cần chạm nhiều tệp |
| Đánh giá và tối ưu (evaluator–optimizer) | một lời gọi sinh kết quả, lời gọi khác đánh giá và góp ý, lặp lại | dịch thuật có vòng phản biện |
Các mẫu này có thể kết hợp với nhau. Bộ phân loại yêu cầu hỗ trợ ở Ví dụ 4.1 chính là bước đầu của một workflow định tuyến. So với agent, các mẫu workflow dễ kiểm thử và dễ dự đoán chi phí hơn, vì số lời gọi mô hình bị giới hạn ngay trong mã.
9.3Tool và function calling#
Function calling (Mục 4.5) là cơ chế nền tảng của agent. Ta đi qua một lượt đầy đủ với ví dụ tra đơn hàng.
Đầu tiên, ứng dụng gửi cho mô hình danh sách tool, mỗi tool có tên, mô tả và lược đồ tham số theo JSON Schema:
{
  "name": "tra_don_hang",
  "description": "Tra trạng thái của một đơn hàng theo mã đơn. Dùng khi khách hỏi đơn hàng đang ở đâu, bao giờ tới.",
  "parameters": {
    "type": "object",
    "properties": {
      "ma_don": {"type": "string", "description": "Mã đơn hàng, dạng DH kèm 4 chữ số, ví dụ DH1024"}
    },
    "required": ["ma_don"]
  }
}
Với tin nhắn "Đơn DH1024 của tôi giao chưa?", mô hình trả về một yêu cầu gọi tool thay vì văn bản: tên tra_don_hang, tham số {"ma_don": "DH1024"}, kèm một mã định danh cho lời gọi. Ứng dụng nhận yêu cầu đó, kiểm tra tham số, kiểm tra người dùng có quyền xem đơn này không, gọi hệ thống quản lý đơn hàng, rồi thêm kết quả vào hội thoại dưới dạng một tin nhắn kết quả tool, gắn với mã định danh của lời gọi. Mô hình đọc kết quả và trả lời người dùng, hoặc đề xuất một lời gọi tool khác nếu cần thêm thông tin.
Mô hình được huấn luyện để hiểu định dạng mô tả tool và sinh lời gọi đúng lược đồ, nhưng lời gọi tốt hay dở phụ thuộc nhiều vào cách mô tả tool. Tên và mô tả của tool cần nói rõ cả khi nào nên dùng và khi nào không nên dùng nó, còn mô tả tham số nên kèm định dạng và ví dụ, như mô tả ma_don ở trên. Số tool nên ít nhưng đủ. Nhiều tool có chức năng chồng lấn làm mô hình khó chọn; Anthropic (2025) khuyên giữ một tập tool tối thiểu đủ dùng, sao cho một kỹ sư đọc danh sách cũng biết ngay nên dùng tool nào cho mỗi tình huống.
Kết quả tool cũng cần được thiết kế, vì nó đi thẳng vào ngữ cảnh. Trả về 500 dòng log làm tốn token và làm loãng ngữ cảnh (Chương 5); nên trả về phần cần thiết, kèm cách lấy thêm nếu cần. Khi tool thất bại, lỗi nên được trả về như một kết quả bình thường chứ không phải một ngoại lệ làm dừng cả vòng lặp. Một thông báo dễ hiểu như "không tìm thấy đơn DH1O24, mã đơn gồm DH và 4 chữ số" cho phép mô hình nhận ra mã đơn đã bị gõ chữ O thay cho số 0 và tự sửa lời gọi.
Tool có tác dụng phụ, như gửi email, chuyển tiền hay xoá dữ liệu, cần được bảo vệ thêm. Quyền phải được kiểm tra trong mã chứ không trông vào mô hình, người dùng phải xác nhận trước khi thao tác được thực hiện, và khi có thể thì tool nên được thiết kế để gọi lặp lại không gây hại (idempotent). Ngoài ra, nhiều API cho phép mô hình đề xuất nhiều lời gọi tool trong một lượt (parallel tool calling) khi các lời gọi độc lập với nhau, chẳng hạn tra thời tiết ở ba thành phố; ứng dụng chạy chúng song song để giảm độ trễ.
9.4ReAct#
Function calling cho mô hình cách hành động, nhưng chưa nói mô hình nên quyết định thế nào. ReAct (Yao và cộng sự, 2023) là phương pháp prompt đặt nền móng cho agent hiện đại, với ý tưởng cho mô hình xen kẽ suy luận (reasoning) và hành động (acting). Ở mỗi bước, mô hình viết một đoạn suy nghĩ về tình hình hiện tại, rồi một hành động, rồi nhận về một quan sát từ môi trường:
Suy nghĩ: Tôi cần biết đơn DH1024 đang ở đâu.
Hành động: tra_don_hang[DH1024]
Quan sát: Đơn DH1024 đã rời kho Bình Dương lúc 9:40, dự kiến giao 15:00 hôm nay.
Suy nghĩ: Tôi đã có đủ thông tin để trả lời khách.
Hành động: tra_loi[Đơn của anh/chị đã rời kho và dự kiến được giao lúc 15 giờ hôm nay.]
Phần suy nghĩ giúp mô hình lập kế hoạch, theo dõi tiến độ và xử lý ngoại lệ. Phần hành động giúp mô hình lấy thông tin thật từ bên ngoài thay vì dựa vào kiến thức sẵn có, nhờ đó giảm ảo giác. Trên các môi trường ra quyết định tương tác ALFWorld và WebShop, bài báo gốc báo cáo ReAct vượt các phương pháp học bắt chước và học tăng cường với chênh lệch tỉ lệ thành công tuyệt đối 34% và 10%, dù chỉ dùng một hai ví dụ trong prompt.
Function calling hiện nay có thể xem là ReAct đã được đưa vào API. Thay vì định dạng "Hành động: ..." trong văn bản tự do, lời gọi tool có cấu trúc JSON, và nhiều mô hình được huấn luyện riêng cho định dạng đó. Phần suy nghĩ có thể nằm trong văn bản trước lời gọi tool, hoặc trong chuỗi suy luận của mô hình suy luận.
9.5Lập kế hoạch, bộ nhớ và tự đánh giá#
Vòng lặp ở Hình 9 đủ cho nhiệm vụ vài bước. Với nhiệm vụ dài hơn, người ta thường thêm vào ba khả năng. Khả năng thứ nhất là lập kế hoạch: trước khi hành động, mô hình viết một kế hoạch gồm các bước, rồi thực hiện và cập nhật kế hoạch khi có thông tin mới. Kế hoạch viết ra nằm trong ngữ cảnh, nên giúp mô hình không lạc hướng ở nhiệm vụ dài, và giúp người dùng biết agent định làm gì. Khả năng thứ hai là bộ nhớ: với nhiệm vụ dài hơn cửa sổ ngữ cảnh, agent cần ghi thông tin quan trọng ra ngoài ngữ cảnh và đọc lại khi cần, theo các cách đã bàn ở Mục 5.4.
Khả năng thứ ba là tự đánh giá: sau khi thực hiện, mô hình, hoặc một lời gọi riêng, kiểm tra kết quả và sửa nếu cần. Reflexion (Shinn và cộng sự, 2023) cho agent ghi lại nhận xét về lần thử thất bại vào bộ nhớ, để lần thử sau tránh được lỗi đó. Tự đánh giá hiệu quả nhất khi có tín hiệu khách quan để dựa vào, như kết quả chạy kiểm thử. Khi chỉ dựa vào đánh giá chủ quan của chính mô hình, nó có thể tự tin vào một câu trả lời sai.
9.6Hệ nhiều agent#
Hệ nhiều agent (multi-agent) chia nhiệm vụ cho nhiều agent, mỗi agent có chỉ dẫn, tool và cửa sổ ngữ cảnh riêng. Mẫu phổ biến nhất là điều phối viên và agent con: một agent chính lập kế hoạch, giao các phần việc con cho các agent con chạy song song, rồi tổng hợp kết quả.
Lợi ích chính của mẫu này là mỗi agent con có một cửa sổ ngữ cảnh sạch dành riêng cho phần việc của nó, và chỉ trả về bản tóm tắt cho agent chính, nên tổng lượng thông tin được xử lý vượt xa một cửa sổ ngữ cảnh (Mục 5.5). Anthropic (2025) báo cáo rằng hệ thống nghiên cứu nhiều agent của họ, gồm một agent chính dùng Claude Opus 4 và các agent con dùng Claude Sonnet 4, đạt kết quả tốt hơn 90,2% so với một agent đơn dùng Claude Opus 4 trên bộ đánh giá nghiên cứu nội bộ. Cùng báo cáo cũng cho biết phần phải trả thêm: một agent dùng khoảng 4 lần số token so với một cuộc trò chuyện thông thường, còn hệ nhiều agent dùng khoảng 15 lần.
Hệ nhiều agent hợp với những nhiệm vụ chia được thành các phần độc lập, như tìm hiểu nhiều chủ đề con cùng lúc. Nó kém phù hợp với nhiệm vụ mà các phần phụ thuộc chặt vào nhau, như sửa nhiều chỗ liên quan trong cùng một đoạn mã, vì các agent không thấy công việc của nhau và có thể đưa ra quyết định mâu thuẫn.
9.7Độ tin cậy và chi phí#
Ta trở lại nhận xét ở đầu chương rằng agent khó làm cho đáng tin. Giả sử mỗi bước của agent thực hiện đúng với xác suất , độc lập với các bước khác, và nhiệm vụ cần bước đều đúng. Xác suất hoàn thành nhiệm vụ khi đó là .
| Số bước | |||
|---|---|---|---|
| 1 | 0,990 | 0,950 | 0,900 |
| 5 | 0,951 | 0,774 | 0,590 |
| 10 | 0,904 | 0,599 | 0,349 |
| 20 | 0,818 | 0,358 | 0,122 |
| 50 | 0,605 | 0,077 | 0,005 |
Giả định độc lập là một đơn giản hoá, nhưng kết luận của nó đúng về hướng. Một bước đúng 95% nghe có vẻ tốt, vậy mà agent 20 bước với độ chính xác đó chỉ hoàn thành 36% số nhiệm vụ. Khi thử agent bằng tay, ta thường chỉ nhìn từng bước và thấy chúng ổn; độ tin cậy của cả chuỗi chỉ lộ ra khi tính hoặc đo trên nhiều nhiệm vụ.
Cách chữa là kiểm tra sau mỗi bước và thử lại khi phát hiện lỗi. Giả sử một bước kiểm tra phát hiện được bước sai với xác suất , và mỗi bước được thử lại tối đa lần khi bị phát hiện sai. Một bước thành công nếu có một lần thử đúng trước khi hết lượt, mà mỗi lần sai chỉ được thử lại khi bị phát hiện, nên
Chẳng hạn với , và : một bước thành công ngay lần đầu với xác suất 0,95, hoặc sai nhưng bị phát hiện rồi thử lại đúng với xác suất , nên và một chuỗi 20 bước hoàn thành với xác suất . Thí nghiệm mô phỏng 200 000 lần một agent 20 bước với , và so với công thức:
| Tỉ lệ phát hiện lỗi | Số lần thử lại tối đa | Công thức | Mô phỏng | Lời gọi trung bình mỗi bước |
|---|---|---|---|---|
| 0 | 0 | 0,358 | 0,357 | 1,000 |
| 0,5 | 1 | 0,587 | 0,586 | 1,025 |
| 0,8 | 1 | 0,785 | 0,784 | 1,040 |
| 0,8 | 3 | 0,811 | 0,810 | 1,042 |
| 0,95 | 3 | 0,949 | 0,949 | 1,050 |
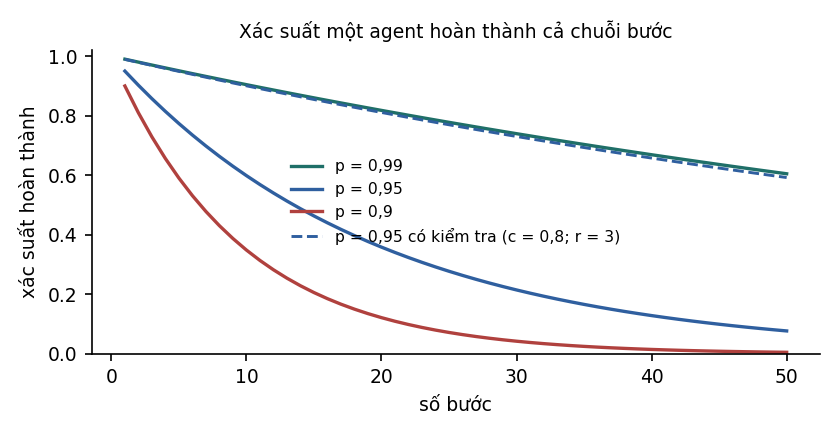
Một bước kiểm tra phát hiện 80% lỗi, cho phép thử lại một lần, nâng tỉ lệ hoàn thành từ 36% lên 79%, trong khi số lời gọi thực hiện bước chỉ tăng 4%. Cột cuối chưa tính chi phí của chính bước kiểm tra; khi kiểm tra là một phép tính rẻ và khách quan, như chạy kiểm thử, kiểm tra lược đồ hay so với dữ liệu nguồn, đánh đổi này rất có lợi. Yếu tố quyết định là tỉ lệ phát hiện : tăng số lần thử lại từ 1 lên 3 ở chỉ thêm 2,6 điểm phần trăm, vì lỗi không bị phát hiện thì không được thử lại. Có thể thử các giá trị khác của , , , ở công cụ agent của trang Phòng thí nghiệm.
Bên cạnh độ tin cậy, agent cần những biện pháp vận hành để an toàn và có chi phí kiểm soát được. Mỗi nhiệm vụ cần một giới hạn số bước và ngân sách token; khi vượt, agent dừng lại và báo cáo. Agent chỉ nên có những tool và quyền cần cho nhiệm vụ, theo nguyên tắc quyền tối thiểu (least privilege), và tool truy cập dữ liệu phải dùng quyền của người dùng đang yêu cầu chứ không dùng quyền quản trị. Những hành động không đảo ngược được, như gửi ra ngoài, thanh toán hay xoá, cần người phê duyệt. Agent chạy mã hoặc lệnh hệ thống cần một môi trường cách ly (sandbox). Và mỗi lần chạy cần được ghi lại toàn bộ trace (Chương 13), để khi nhiệm vụ thất bại có thể tìm ra bước nào sai.
9.8Xây dựng agent#
Vòng lặp của một agent đủ ngắn để tự viết, và tự viết giúp hiểu rõ mọi chi tiết. Hàm dưới đây cài đặt đúng vòng lặp ở Hình 9 với API dạng OpenAI, kể cả việc trả lỗi về như một kết quả và giới hạn số bước.
def chay_agent(client, model, tools, ham_tool, tin_nhan, so_buoc_toi_da=10):
    for _ in range(so_buoc_toi_da):
        tl = client.chat.completions.create(model=model, messages=tin_nhan, tools=tools)
        msg = tl.choices[0].message
        tin_nhan.append(msg)
        if not msg.tool_calls:                      # mô hình đưa ra câu trả lời cuối
            return msg.content
        for goi in msg.tool_calls:                  # thực thi từng lời gọi tool
            try:
                ket_qua = ham_tool[goi.function.name](**json.loads(goi.function.arguments))
            except Exception as loi:                # lỗi được trả về như một kết quả
                ket_qua = f"Lỗi: {loi}"
            tin_nhan.append({"role": "tool", "tool_call_id": goi.id, "content": str(ket_qua)})
    return "Đã dừng vì vượt quá số bước cho phép."
Các thư viện và nền tảng xây agent được nhắc tới trong roadmap cung cấp thêm quản lý trạng thái, ghi trace, tích hợp tool và điều phối nhiều agent: OpenAI Agents SDK và AgentKit, Claude Agent SDK, Google Agent Development Kit (ADK) và Vertex AI Agent Builder, cùng các khung mã nguồn mở như LangChain, LangGraph và LlamaIndex. Các thư viện này giúp đi nhanh hơn, nhưng thêm một lớp trừu tượng che bớt prompt và luồng gọi thật sự. Nên bắt đầu bằng vòng lặp đơn giản như trên hoặc một thư viện mỏng, chỉ dùng tới khung phức tạp khi thấy rõ lợi ích, và khi dùng thì bật ghi trace để luôn xem được prompt thật mà mô hình nhận.
9.9Tóm tắt#
Workflow điều phối mô hình và tool theo đường đi định sẵn trong mã, còn agent để mô hình tự chọn bước tiếp theo trong một vòng lặp quan sát, hành động và nhận kết quả. Function calling là cơ chế cho mô hình đề xuất lời gọi tool, ReAct là cách cho mô hình xen kẽ suy nghĩ với hành động, và chất lượng của agent phụ thuộc nhiều vào cách mô tả tool và cách tool trả kết quả, kể cả khi lỗi. Hệ nhiều agent mở rộng lượng thông tin xử lý được nhưng tốn khoảng 15 lần số token của một cuộc trò chuyện. Độ tin cậy giảm theo cấp số nhân với số bước: 20 bước đúng 95% mỗi bước chỉ hoàn thành 36% nhiệm vụ, và một bước kiểm tra phát hiện 80% lỗi kèm một lần thử lại nâng con số đó lên 79%. Agent cần giới hạn số bước, quyền tối thiểu, người phê duyệt cho hành động không đảo ngược và ghi trace đầy đủ.
Trong ví dụ tra đơn hàng, tool tra_don_hang được viết riêng cho một ứng dụng. Một công ty có hàng chục ứng dụng AI và hàng chục hệ thống nội bộ sẽ phải viết lại những tool tương tự nhiều lần. Chương 10 trình bày một giao thức chung để tránh việc đó.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Agent 20 bước, mỗi bước đúng với xác suất 0,95, hoàn thành nhiệm vụ với xác suất khoảng bao nhiêu nếu các bước độc lập?
Vì sao: . Bước kiểm tra phát hiện 80% lỗi kèm một lần thử lại nâng con số này lên khoảng 79% (Mục 9.7).2Workflow khác agent ở điểm nào?
3Khi một tool thất bại trong vòng lặp của agent, nên xử lý thế nào?
Đã trả lời 0/3