1Tổng quan về học máy#
Có rất nhiều thuật toán học máy mang tên khác nhau, và người mới dễ có cảm giác phải học thuộc từng cái một. Thực ra phần lớn chúng được ghép từ cùng ba thành phần, và khi đã hiểu ba thành phần ấy thì học một thuật toán mới chỉ còn là trả lời ba câu hỏi. Trước khi đi vào từng thuật toán ở các chương sau, ta dựng khung đó, bắt đầu từ câu hỏi học máy là gì.
1.1Khái niệm học máy#
Một định nghĩa hay được trích dẫn là của Tom Mitchell (1997): một chương trình được gọi là học từ kinh nghiệm đối với một lớp nhiệm vụ và một thước đo hiệu năng , nếu hiệu năng của nó trên các nhiệm vụ trong , đo bằng , tăng lên theo kinh nghiệm . Với bài toán lọc thư rác, là việc gắn nhãn "rác" hoặc "không rác" cho một thư, là tỉ lệ thư được gắn nhãn đúng, còn là tập thư đã được người dùng đánh dấu.
Định nghĩa trên đúng nhưng chưa nói cách làm. Để thấy cách làm, ta nhìn vào cấu tạo của các thuật toán. Mỗi thuật toán học có giám sát đều gồm ba thành phần, như Hình 1 minh hoạ.
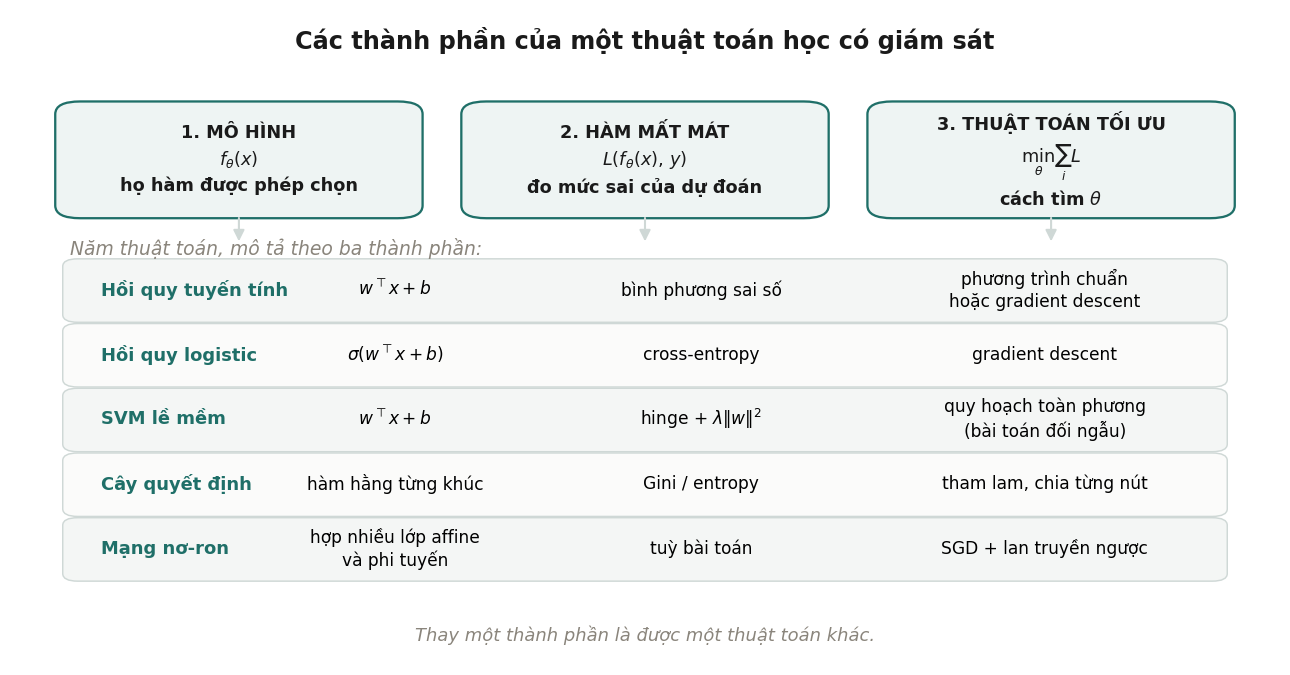
Thành phần thứ nhất là mô hình, tập các hàm mà ta cho phép thuật toán chọn. Hồi quy tuyến tính chỉ cho phép các hàm tuyến tính, chính xác hơn là affine, của đầu vào; cây quyết định cho phép các hàm hằng trên từng vùng; mạng nơ-ron cho phép hợp của nhiều phép biến đổi tuyến tính xen với các hàm phi tuyến. Thành phần thứ hai là hàm mất mát, đo mức sai của một dự đoán so với nhãn thật. Đây là nơi ta nói ra điều mình thực sự muốn: sai lệch lớn có bị phạt nặng hơn không, đoán sai lớp dương có đắt hơn đoán sai lớp âm không. Thành phần thứ ba là thuật toán tối ưu, cách tìm tham số làm tổng mất mát trên dữ liệu huấn luyện nhỏ nhất. Có bài toán giải được bằng công thức, có bài toán phải lặp như gradient descent.
Khung ba thành phần biến việc học một thuật toán mới thành việc trả lời ba câu hỏi: mô hình là họ hàm nào, mất mát là gì, tối ưu bằng cách nào. Với bài toán định giá căn hộ theo diện tích ở Chương 4, câu trả lời là: mô hình là các đường thẳng , mất mát là bình phương độ lệch giữa giá dự đoán và giá thật, còn tối ưu bằng một công thức đóng, hoặc bằng gradient descent ở Chương 5. Nó cũng cho thấy nhiều thuật toán mang tên khác nhau thực ra rất gần nhau. Chương 6 sẽ chỉ ra rằng perceptron, hồi quy logistic và SVM dùng chung một mô hình là hàm tuyến tính và chung một cách tối ưu là gradient descent; chúng chỉ khác nhau ở hàm mất mát.
Định nghĩa 1.1 (Bài toán học có giám sát)
Cho tập huấn luyện , một họ hàm và một hàm mất mát . Bài toán học có giám sát là tìm
với mục đích cuối cùng là dự đoán tốt trên những điểm dữ liệu chưa gặp khi huấn luyện.
Vế cuối của định nghĩa là chỗ tạo ra toàn bộ độ khó của học máy. Tối thiểu hoá mất mát trên dữ liệu huấn luyện chỉ là phương tiện; mục tiêu thật là khả năng tổng quát hoá (generalization) sang dữ liệu mới. Một mô hình ghi nhớ nguyên văn tập huấn luyện có mất mát huấn luyện bằng 0 nhưng có thể vô dụng trên dữ liệu mới. Hiện tượng này gọi là overfitting và được bàn kỹ ở Chương 9.
1.2Các dạng bài toán học máy#
Cách phân loại thông dụng nhất dựa vào việc dữ liệu có nhãn hay không. Trong học có giám sát (supervised learning), mỗi điểm dữ liệu đi kèm một nhãn . Nếu nhãn là số thực, như giá nhà hay nhiệt độ ngày mai, bài toán là hồi quy; nếu nhãn thuộc một tập hữu hạn các lớp, như thư rác hay không, ảnh chứa chữ số nào, bài toán là phân loại. Trong học không giám sát (unsupervised learning), ta chỉ có mà không có nhãn, và mục tiêu là tìm cấu trúc trong dữ liệu: gom các điểm giống nhau thành cụm, tìm vài hướng chứa phần lớn thông tin, hay ước lượng mật độ phân phối. Dạng thứ ba là học tăng cường (reinforcement learning), trong đó một tác tử tương tác với môi trường và nhận tín hiệu thưởng thay vì nhận nhãn đúng cho từng đầu vào; giáo trình Biểu diễn & Căn chỉnh trình bày dạng này.
Bảng sau xếp các chương của giáo trình theo cách phân loại trên.
| Có nhãn | Không có nhãn | |
|---|---|---|
| Dự đoán một số thực | hồi quy (Chương 4) | |
| Dự đoán một lớp | phân loại (Chương 6, 7, 13) | phân cụm (Chương 15) |
| Tìm cấu trúc, giảm chiều | LDA (Mục 14.4) | PCA, SVD (Chương 14) |
| Điền giá trị còn thiếu | phân rã ma trận (Chương 16) |
Ranh giới giữa hai cột không cứng. Trong hệ thống gợi ý ở Chương 16, các ô đánh giá đã biết đóng vai trò nhãn, nhưng phần lớn ma trận là ô trống cần điền, nên bài toán nằm giữa hai loại. Ngoài ra còn các dạng lai như học bán giám sát, khi chỉ một phần nhỏ dữ liệu có nhãn, và học tự giám sát, khi nhãn được tạo ra từ chính dữ liệu, chẳng hạn đoán từ tiếp theo trong câu. Học tự giám sát là cách các mô hình ngôn ngữ lớn được huấn luyện, và được trình bày trong giáo trình Biểu diễn & Căn chỉnh.
Ba ví dụ nhỏ đi suốt giáo trình, mỗi ví dụ ứng với một dạng bài toán. Bốn căn hộ với diện tích và giá là bài toán hồi quy, xuất hiện từ Chương 2 tới Chương 11. Sáu sinh viên với số giờ ôn thi và kết quả đỗ hay trượt là bài toán phân loại, từ Chương 6 tới Chương 13. Bốn cửa hàng cần đặt hai kho hàng là bài toán phân cụm ở Chương 15. Các ví dụ đủ nhỏ để tính tay, nên mỗi công thức được kiểm tra trên chúng trước khi đi tới thí nghiệm trên dữ liệu lớn hơn.
1.3Các yếu tố cần xét trước khi chọn thuật toán#
Trước khi chọn một mô hình cụ thể, có ba câu hỏi về dữ liệu và mục tiêu ảnh hưởng tới lựa chọn nhiều hơn bản thân thuật toán.
Câu hỏi đầu tiên là số điểm dữ liệu so với số đặc trưng. Tỉ lệ quyết định mô hình được phép linh hoạt tới mức nào. Khi lớn hơn rất nhiều, ta có thể dùng mô hình nhiều tham số mà ít lo overfitting. Khi xấp xỉ hoặc nhỏ hơn , regularization trở thành bắt buộc (Chương 9), và một số phương pháp không dùng được nữa: Mục 4.3 cho thấy phương trình chuẩn của hồi quy tuyến tính không có nghiệm duy nhất khi các cột của phụ thuộc tuyến tính, điều chắc chắn xảy ra khi .
Câu hỏi thứ hai là dữ liệu có cấu trúc gì. Ảnh có tính cục bộ, vì điểm ảnh gần nhau liên quan với nhau, và bất biến theo dịch chuyển, vì con mèo ở góc trái hay góc phải vẫn là con mèo. Văn bản và chuỗi thời gian có thứ tự. Dữ liệu dạng bảng, như bảng thông tin khách hàng, không có cấu trúc nào như vậy: đổi thứ tự các cột không làm thay đổi ý nghĩa. Mạng nơ-ron tích chập và Transformer mạnh vì khai thác được cấu trúc của ảnh và chuỗi. Trên dữ liệu dạng bảng, mô hình tuyến tính và các mô hình dựa trên cây quyết định thường cho kết quả tương đương hoặc tốt hơn mạng nơ-ron với chi phí thấp hơn nhiều.
Câu hỏi thứ ba là mục tiêu là dự đoán hay giải thích. Có bài toán chỉ cần dự đoán đúng, chẳng hạn xếp hạng quảng cáo. Có bài toán cần trả lời câu hỏi "đặc trưng này ảnh hưởng tới kết quả bao nhiêu", chẳng hạn đánh giá tác dụng của một chính sách. Hai mục tiêu có thể dẫn tới hai lựa chọn khác nhau. Mục 4.4 đo một trường hợp cụ thể: khi hai đặc trưng gần như trùng nhau, độ dao động của hệ số hồi quy tăng khoảng 25 lần trong khi độ dao động của dự đoán gần như không đổi. Nếu chỉ cần dự đoán thì hiện tượng này vô hại; nếu cần đọc ý nghĩa của hệ số thì các hệ số đó không đáng tin.
1.4Vị trí của giáo trình trong lộ trình#
Giáo trình này là chặng đầu của một lộ trình sáu giáo trình, xây dựng theo roadmap AI Engineer của roadmap.sh và bổ sung phần kiến thức nền mà roadmap đó giả định người học đã có.
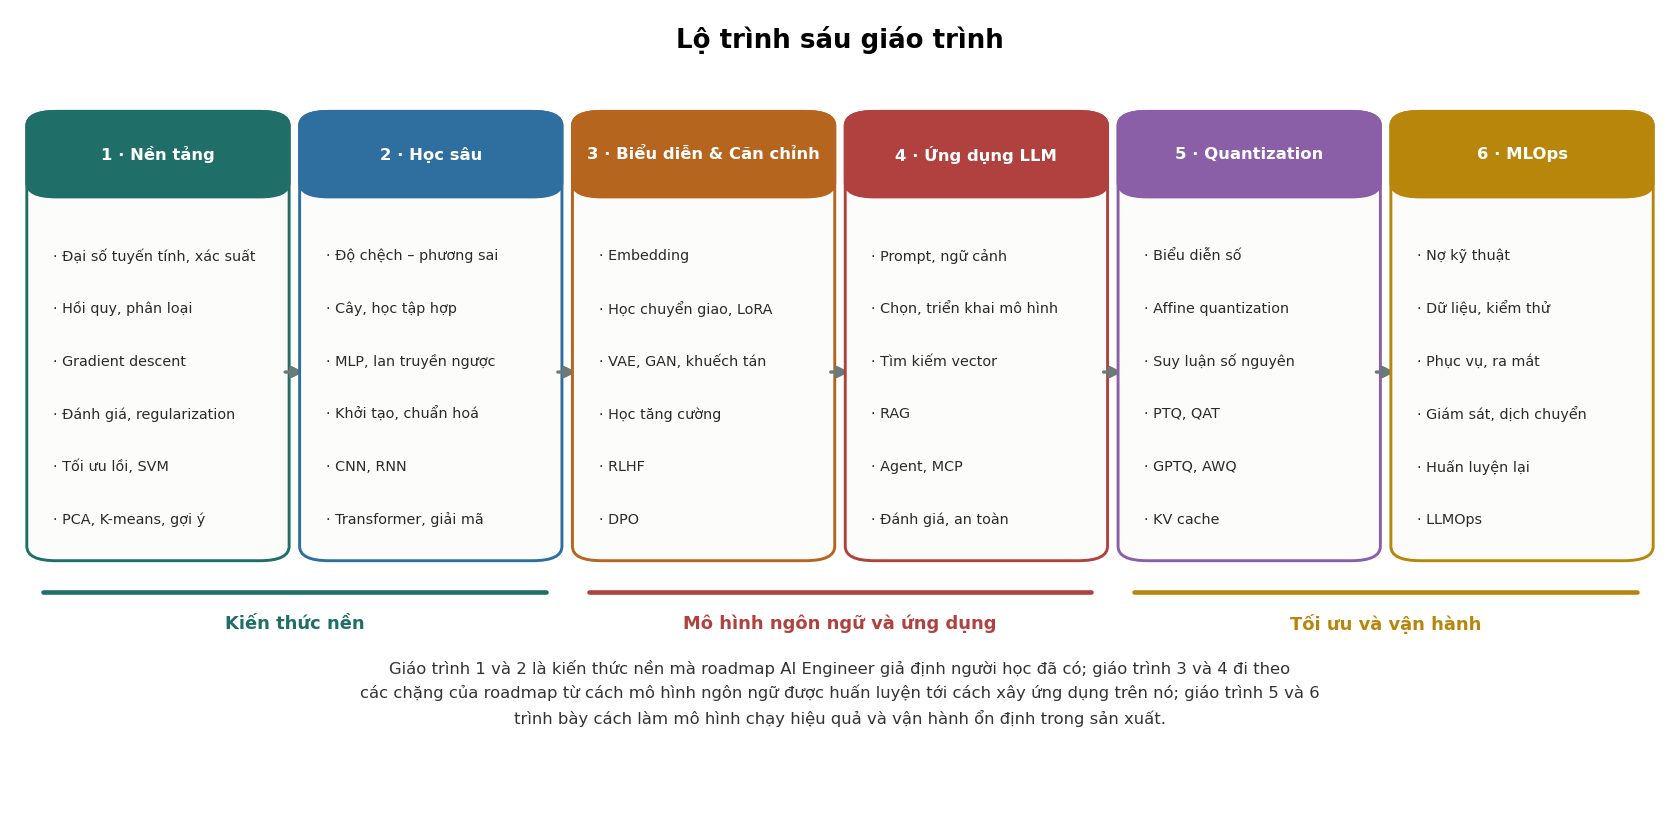
Kiến thức của giáo trình này được dùng lại ở nhiều chỗ trong các giáo trình sau. Gradient descent ở Chương 5 là nền cho Chương 5 của Học sâu, nơi thuật toán được mở rộng thành momentum, Adam và lan truyền ngược qua nhiều lớp. Hồi quy logistic ở Chương 6 là một mạng nơ-ron một lớp, và Chương 4 của Học sâu bắt đầu bằng việc chồng nhiều lớp như vậy lên nhau. Regularization ở Chương 9 và ước lượng MAP ở Chương 10 giải thích nguồn gốc của weight decay, kỹ thuật được dùng mặc định khi huấn luyện mạng sâu (Chương 5 của Học sâu). Các độ đo đánh giá ở Chương 8 là nền cho việc đánh giá mô hình trong sản xuất ở Chương 6 của MLOps. Tích vô hướng, cosine và PCA ở Chương 2 và Chương 14 là công cụ để hiểu embedding và tìm kiếm vector trong giáo trình Biểu diễn & Căn chỉnh và Ứng dụng LLM. Còn SVD ở Mục 2.6 là công cụ để đọc Chương 11 của Quantization, nơi các phương pháp như GPTQ dựa trên phân rã ma trận.
1.5Quy trình giải một bài toán học máy#
Các chương sau đi sâu vào từng thuật toán. Mục này mô tả quy trình bao quanh thuật toán, vì trên thực tế phần lớn lỗi nằm ở quy trình chứ không nằm ở thuật toán.
Mọi thứ bắt đầu từ việc xác định bài toán và thước đo: viết rõ đầu vào, đầu ra và thước đo thành công trước khi đụng tới dữ liệu. Thước đo phải phản ánh chi phí thật. Với bài toán phát hiện gian lận, bỏ sót một ca gian lận thường đắt hơn nhiều so với báo động nhầm, nên độ chính xác không phải thước đo phù hợp (Mục 8.1).
Bước tiếp theo là thu thập và chia dữ liệu. Dữ liệu được chia thành tập huấn luyện, tập xác thực và tập kiểm tra ngay từ đầu. Tập huấn luyện dùng để học tham số, tập xác thực dùng để chọn siêu tham số và so sánh mô hình, còn tập kiểm tra chỉ dùng một lần ở cuối để báo cáo kết quả. Cách chia phải khớp với cách mô hình sẽ được dùng, chẳng hạn dữ liệu có yếu tố thời gian thì chia theo thời gian (Mục 8.5).
Trước khi thử mô hình phức tạp, nên dựng một mô hình cơ sở đơn giản nhất có thể: đoán giá trị trung bình, đoán lớp phổ biến nhất, hoặc một mô hình tuyến tính. Mô hình cơ sở cho biết một mô hình phức tạp hơn có thật sự mang lại gì hay không. Sau đó mới tới xây dựng đặc trưng và huấn luyện: chuẩn hoá đặc trưng, mã hoá biến hạng mục, xử lý giá trị thiếu. Mọi phép biến đổi có tham số, như trung bình và độ lệch chuẩn khi chuẩn hoá, chỉ được ước lượng trên tập huấn luyện.
Mô hình được đánh giá và điều chỉnh trên tập xác thực hoặc bằng cross-validation (Mục 9.5) để chọn siêu tham số. Khi đánh giá, nên xem lỗi theo từng nhóm dữ liệu chứ không chỉ một con số tổng. Cuối cùng, mô hình được đo trên tập kiểm tra đúng một lần rồi mới triển khai. Sau khi triển khai, mô hình cần được giám sát vì phân phối dữ liệu thay đổi theo thời gian; giáo trình MLOps trình bày phần này.
Lưu ý
Nếu tập kiểm tra được dùng nhiều lần để chọn mô hình, nó trở thành một tập xác thực thứ hai và con số báo cáo sẽ lạc quan hơn thực tế. Đây là lỗi phổ biến nhất khi so sánh mô hình, và Mục 9.5 nói cách tránh.
1.6Tóm tắt#
Mỗi thuật toán học có giám sát gồm ba thành phần: mô hình là họ hàm được phép chọn, hàm mất mát đo mức sai, và thuật toán tối ưu tìm tham số. Mục tiêu thật của học máy là tổng quát hoá sang dữ liệu chưa gặp, không phải tối thiểu hoá mất mát trên dữ liệu huấn luyện. Bài toán học máy chia theo việc có nhãn hay không thành học có giám sát, gồm hồi quy và phân loại, học không giám sát, và học tăng cường; bốn căn hộ, sáu sinh viên và bốn cửa hàng là ba ví dụ của ba dạng đó, đi cùng các chương sau. Trước khi chọn thuật toán cần xét tỉ lệ số điểm trên số đặc trưng, cấu trúc của dữ liệu, và mục tiêu là dự đoán hay giải thích. Quy trình bao quanh thuật toán, từ chọn thước đo, chia dữ liệu tới dùng tập kiểm tra đúng một lần, là nơi xảy ra phần lớn lỗi.
Để làm việc với cả ba thành phần, ta cần một ngôn ngữ chung: dữ liệu là ma trận, mô hình tuyến tính là phép nhân ma trận với vector, và tối ưu cần đạo hàm theo vector. Chương 2 nhắc lại phần đại số tuyến tính cần cho ngôn ngữ đó.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Ba thành phần của mọi thuật toán học có giám sát là gì?
Vì sao: Thay đổi một thành phần là được một thuật toán khác. Chương 6 cho thấy perceptron, hồi quy logistic và SVM dùng chung mô hình tuyến tính và chung cách tối ưu; chúng chỉ khác nhau ở hàm mất mát.2Yếu tố nào nên xét trước khi chọn thuật toán?
Vì sao: Tỉ lệ quyết định mô hình được phép linh hoạt tới đâu. Mục tiêu dự đoán và mục tiêu giải thích có thể dẫn tới lựa chọn khác nhau; Mục 4.4 cho một ví dụ đo được.3Tập kiểm tra nên được dùng thế nào?
Vì sao: Nếu tập kiểm tra được dùng nhiều lần để chọn mô hình, nó trở thành một tập xác thực thứ hai và con số báo cáo sẽ lạc quan hơn thực tế.
Đã trả lời 0/3