13Quan sát và vận hành#
Một nhân viên báo rằng trợ lý quy chế trả lời sai số ngày phép năm. Để sửa lỗi, ta cần biết trợ lý đã nhận được gì: câu hỏi nguyên văn, các đoạn quy chế được truy xuất, kết quả của tool tra ngày phép, và phiên bản prompt đang chạy lúc đó. Nếu những thứ ấy không được ghi lại, lỗi không tái tạo được, và việc sửa chỉ còn là đoán. Khả năng trả lời những câu hỏi như vậy về một hệ thống đang chạy gọi là quan sát (observability).
Các nguyên tắc giám sát chung của hệ thống học máy đã có trong giáo trình MLOps, và Chương 13 của MLOps bàn các vấn đề vận hành đặc thù của LLM. Chương này xét từ phía người xây ứng dụng, bắt đầu từ việc nên ghi lại những gì.
13.1Dữ liệu cần ghi lại#
Với mỗi yêu cầu, một hệ thống quan sát đầy đủ ghi lại các nhóm thông tin trong bảng dưới.
| Nhóm | Nội dung |
|---|---|
| Định danh | mã yêu cầu, thời điểm, người dùng hoặc tổ chức (đã ẩn danh hoá khi cần), phiên hội thoại |
| Cấu hình | tên và phiên bản mô hình, phiên bản prompt, tham số lấy mẫu, phiên bản chỉ mục tài liệu |
| Nội dung | đầu vào đầy đủ đã gửi cho mô hình, đầu ra, các lời gọi tool kèm tham số và kết quả, các tài liệu truy xuất được kèm điểm |
| Tài nguyên | số token đầu vào, số token đọc từ cache, số token đầu ra, chi phí |
| Thời gian | thời gian tới token đầu tiên, tổng thời gian, thời gian của từng bước |
| Kết quả | lỗi, lý do kết thúc, kết quả kiểm tra của rào chắn, phản hồi của người dùng |
Trong đó, thứ quan trọng nhất là đầu vào đầy đủ đã gửi cho mô hình, chứ không chỉ câu hỏi của người dùng. Khi một câu trả lời sai, nguyên nhân thường nằm ở ngữ cảnh: tài liệu truy xuất sai, lịch sử hội thoại bị cắt, kết quả tool bị lỗi. Trong ví dụ về ngày phép, câu hỏi của nhân viên không cho biết gì về nguyên nhân; chỉ ngữ cảnh đầy đủ mới cho thấy đó là lỗi truy xuất hay lỗi của tool. Không có đầu vào đầy đủ thì không tái tạo được lỗi.
13.2Trace và span#
Một yêu cầu trong ứng dụng LLM gồm nhiều bước: kiểm tra đầu vào, truy xuất, xếp lại, gọi mô hình, gọi tool, gọi mô hình lần nữa. Cách tổ chức dữ liệu quan sát theo chuẩn của ngành là trace: mỗi bước là một span có thời điểm bắt đầu, thời điểm kết thúc và các thuộc tính, và các span lồng nhau theo quan hệ cha con, tạo thành một cây mô tả toàn bộ yêu cầu.
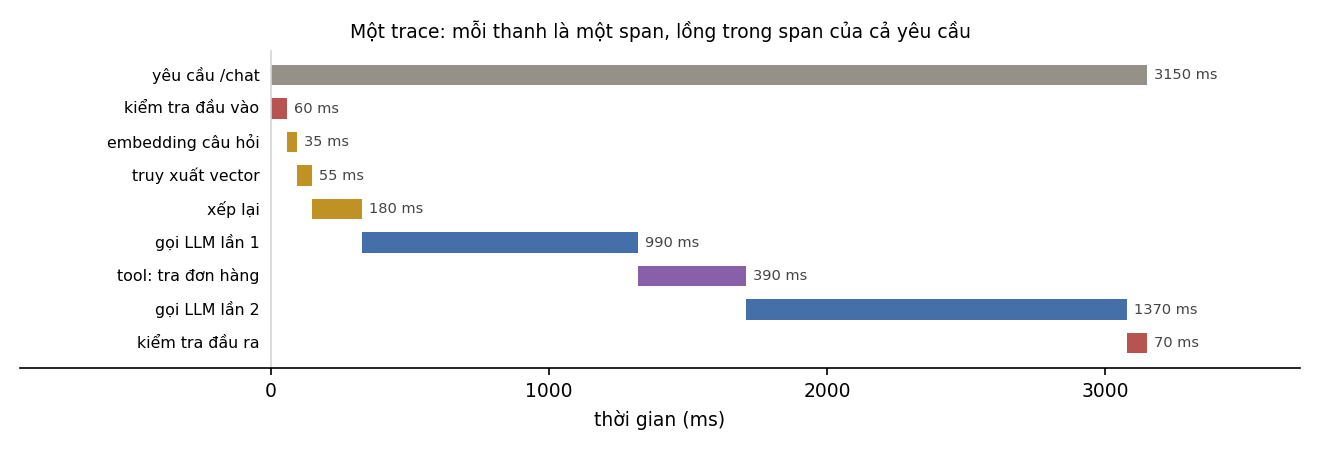
Trace cho biết ngay thời gian đi đâu. Trong ví dụ ở Hình 14, hai lần gọi mô hình chiếm khoảng 75% tổng thời gian và lần gọi tool chiếm gần 400 ms, nên tối ưu truy xuất gần như không giúp gì cho độ trễ. Trace cũng cho phép xem lại từng bước của một yêu cầu cụ thể khi người dùng báo lỗi.
OpenTelemetry là chuẩn mở phổ biến nhất cho trace, và đã có bộ quy ước thuộc tính riêng cho các lời gọi AI tạo sinh (GenAI semantic conventions), như tên mô hình, số token đầu vào và đầu ra. Dùng chuẩn này giúp gửi dữ liệu tới nhiều công cụ khác nhau mà không phải đổi mã. Đặc tả MCP phiên bản 2026-07-28 cũng quy định cách truyền ngữ cảnh trace của OpenTelemetry trong trường _meta, để trace đi xuyên qua các MCP server.
13.3Theo dõi chi phí và độ trễ#
Độ trễ nên được theo dõi theo phân vị (p50, p95, p99) chứ không theo trung bình, vì trải nghiệm tệ nhất của người dùng nằm ở đuôi phân phối (Mục 7.3 của MLOps). Với ứng dụng LLM, cần theo dõi riêng thời gian tới token đầu tiên và tổng thời gian, và theo dõi riêng từng bước trong trace. Độ trễ của API bên ngoài thay đổi theo giờ trong ngày và theo tải của nhà cung cấp, nằm ngoài kiểm soát của ứng dụng, nên mỗi lời gọi cần có thời gian chờ tối đa và phương án dự phòng.
Chi phí nên được theo dõi theo từng tính năng và từng nhóm người dùng, cùng với phân phối số token mỗi yêu cầu. Chi phí trung bình ổn định có thể che giấu những yêu cầu cá biệt rất đắt, như một agent rơi vào vòng lặp gọi tool liên tục hay một người dùng dán vào cả một cuốn sách. Vì vậy cần cảnh báo khi chi phí của một yêu cầu, một người dùng hay cả hệ thống vượt ngưỡng, và cần giới hạn cứng để một lỗi không thể tiêu hết ngân sách của cả tháng.
13.4Giám sát chất lượng trong sản xuất#
Chất lượng trong sản xuất không đo trực tiếp được như trên bộ đánh giá, vì không có nhãn đúng. Thay vào đó, người ta ghép nhiều nguồn tín hiệu gián tiếp. Nguồn đầu tiên là đánh giá trực tuyến: chạy các kiểm tra tất định trên mọi yêu cầu (định dạng, trích dẫn, thông tin nhạy cảm), và chạy giám khảo LLM trên một mẫu nhỏ lưu lượng, cỡ 1 tới 10%. Nguồn thứ hai là phản hồi tường minh của người dùng, như nút thích, không thích hay báo lỗi. Tỉ lệ người phản hồi thấp và lệch về phía người không hài lòng, nên nguồn này dùng để tìm ví dụ lỗi hơn là để đo chất lượng tổng thể. Nguồn thứ ba là tín hiệu ngầm: người dùng yêu cầu sinh lại câu trả lời, sao chép câu trả lời, hỏi lại cùng một ý bằng cách khác, bỏ cuộc giữa chừng hay chuyển sang gặp nhân viên hỗ trợ. Nguồn cuối cùng là sự thay đổi của phân phối câu hỏi: phân cụm embedding của câu hỏi (Mục 6.4) theo thời gian giúp phát hiện những chủ đề mới mà bộ đánh giá chưa có, tương tự việc phát hiện dịch chuyển phân phối ở Chương 9 của MLOps.
Các nguồn tín hiệu này nối vận hành trở lại với đánh giá. Ví dụ lỗi tìm được trong sản xuất được gán nhãn và đưa vào bộ vàng (Mục 12.5), để lần thay đổi sau được kiểm tra trên đúng những trường hợp đã từng hỏng. Vòng khép kín này chính là vòng lặp của phát triển dựa trên đánh giá ở Mục 1.3.
13.5Quyền riêng tư của dữ liệu quan sát#
Log của ứng dụng LLM chứa nguyên văn những gì người dùng nhập, thường gồm thông tin cá nhân, dữ liệu nội bộ, đôi khi cả mật khẩu hay khoá API dán nhầm. Dữ liệu quan sát vì vậy cần được bảo vệ như dữ liệu nhạy cảm: che hoặc loại bỏ thông tin cá nhân trước khi lưu khi có thể, giới hạn quyền truy cập, đặt thời hạn lưu trữ, và tuân thủ quy định về bảo vệ dữ liệu cá nhân áp dụng cho sản phẩm. Khi gửi log tới một dịch vụ quan sát bên ngoài, dữ liệu đó rời khỏi hạ tầng, với cùng các cân nhắc như khi gửi dữ liệu tới API mô hình (Mục 3.2).
13.6Các công cụ quan sát#
Các công cụ quan sát cho ứng dụng LLM được nhắc tới trong roadmap gồm LangSmith, Langfuse (mã nguồn mở, tự triển khai được), Helicone và Arize (có Phoenix là bản mã nguồn mở). Chúng cung cấp giao diện xem trace, thống kê chi phí và độ trễ, quản lý bộ dữ liệu đánh giá và chạy giám khảo trên dữ liệu sản xuất. Khi chọn công cụ, nên hỏi ba câu: có hỗ trợ OpenTelemetry để không bị khoá vào một nhà cung cấp không, có tự triển khai được không nếu dữ liệu không được rời hạ tầng, và có nối được với quy trình đánh giá ở Chương 12 không.
13.7Tóm tắt#
Quan sát một ứng dụng LLM bắt đầu từ việc ghi lại đầy đủ mỗi yêu cầu: cấu hình, đầu vào thật đã gửi cho mô hình, lời gọi tool, số token, thời gian và kết quả. Dữ liệu đó được tổ chức thành trace gồm các span lồng nhau, theo chuẩn OpenTelemetry với quy ước riêng cho AI tạo sinh, để thấy thời gian và lỗi nằm ở bước nào. Độ trễ được theo dõi theo phân vị, còn chi phí theo tính năng và người dùng, kèm giới hạn cứng. Chất lượng trong sản xuất được ước lượng gián tiếp qua kiểm tra trực tuyến, giám khảo trên một mẫu lưu lượng, phản hồi của người dùng và sự thay đổi của phân phối câu hỏi, và mọi lỗi tìm được quay về bộ vàng. Log chứa dữ liệu của người dùng nên phải được bảo vệ như dữ liệu nhạy cảm.
Đến đây, mọi chương đều giả định đầu vào và đầu ra là văn bản. Người dùng thật còn gửi ảnh chụp hoá đơn, tệp PDF có bảng biểu, đoạn ghi âm cuộc họp. Chương 14 xét những gì thay đổi khi mô hình làm việc với nhiều loại dữ liệu.
Tự kiểm tra
2 câu. Chọn đáp án để xem ngay lời giải thích.
1Điều quan trọng nhất cần ghi lại để gỡ lỗi một câu trả lời sai trong sản xuất là gì?
Vì sao: Nguyên nhân thường nằm ở ngữ cảnh; không có đầu vào đầy đủ thì không tái tạo được lỗi (Mục 13.1).2Vì sao theo dõi độ trễ theo phân vị p95, p99 thay vì trung bình?
Vì sao: Tương tự với chi phí: trung bình ổn định có thể che các yêu cầu cá biệt rất đắt như agent rơi vào vòng lặp (Mục 13.3).
Đã trả lời 0/2