1Vì sao cần quantization#
1.1Chi phí bộ nhớ#
Kích thước lưu trữ của một mô hình xấp xỉ bằng số tham số × số byte mỗi tham số. Số tham số không đổi khi lượng tử hóa; chỉ số byte mỗi tham số thay đổi.
| Mô hình | Số tham số | FP32 | FP16 / BF16 | INT8 | INT4 |
|---|---|---|---|---|---|
| ResNet-50 | 25,6 triệu | 102 MB | 51 MB | 25,6 MB | 12,8 MB |
| LLM 7 tỉ tham số | 7 tỉ | 28 GB | 14 GB | 7 GB | 3,5 GB |
Bảng trên chưa tính phần phụ trội nhỏ để lưu các scale (xem Mục 11.8). Với LLM, con số này quyết định mô hình có vừa bộ nhớ GPU hay điện thoại hay không.
1.2Chi phí năng lượng#
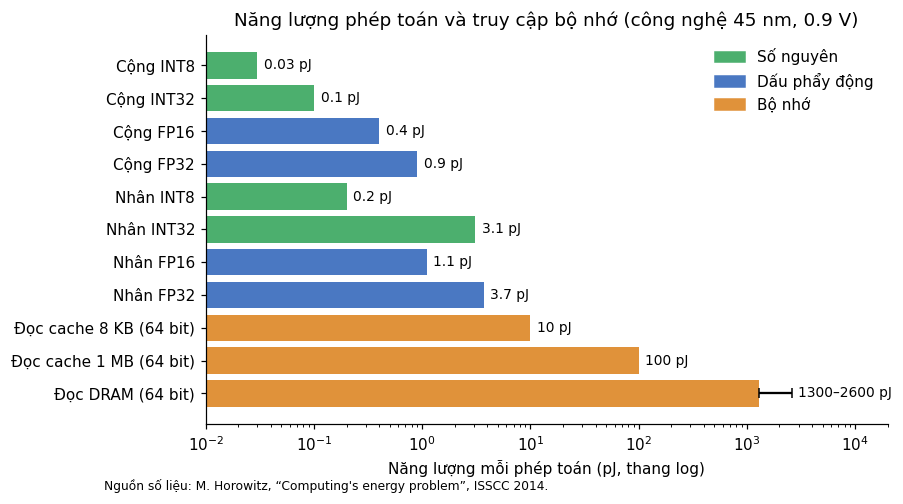
Có hai nhận xét quan trọng từ Hình 1:
- Phép toán số nguyên rẻ hơn dấu phẩy động nhiều lần. Một phép cộng INT8 (0,03 pJ) rẻ hơn khoảng 30 lần so với phép cộng FP32 (0,9 pJ). Một phép nhân INT8 (0,2 pJ) rẻ hơn khoảng 18 lần so với phép nhân FP32 (3,7 pJ).
- Di chuyển dữ liệu đắt hơn tính toán rất nhiều. Đọc 64 bit từ DRAM tốn 1300–2600 pJ, tức gấp hàng trăm lần một phép nhân FP32. Vì vậy, giảm số byte phải đọc từ bộ nhớ thường mang lại lợi ích lớn hơn việc tính toán rẻ hơn.
1.3Tốc độ: bài toán bị giới hạn bởi tính toán hay bởi bộ nhớ#
Một phép toán trên phần cứng bị chặn bởi một trong hai giới hạn:
- Compute-bound (giới hạn bởi tính toán): ví dụ nhân hai ma trận lớn với batch lớn. Lượng tử hóa giúp nhanh hơn vì các đơn vị tính số nguyên có thông lượng cao hơn. Trên nhiều GPU, thông lượng tensor core INT8 gấp đôi FP16.
- Memory-bound (giới hạn bởi băng thông bộ nhớ): ví dụ sinh từng token của LLM với batch nhỏ. Mỗi trọng số được đọc một lần nhưng chỉ tham gia rất ít phép tính. Lúc này, chỉ cần nén trọng số (weight-only quantization) là đã nhanh hơn gần tỉ lệ với mức nén, kể cả khi phép nhân vẫn làm bằng FP16.
Khái niệm định lượng cho sự phân biệt này là cường độ số học (arithmetic intensity) = số phép toán / số byte đọc ghi. Mô hình roofline so sánh đại lượng này với tỉ số giữa thông lượng tính toán và băng thông bộ nhớ của phần cứng.
1.4Cái giá phải trả#
Lượng tử hóa là phép nén có mất mát (lossy). Nó gây sai số, và sai số này có thể làm giảm độ chính xác của mô hình. Ngoài ra, lợi ích tốc độ chỉ xuất hiện khi phần cứng và thư viện có kernel số nguyên tương ứng. Nếu không, mô hình chỉ nhẹ hơn chứ không nhanh hơn, thậm chí chậm hơn (ví dụ thực tế ở Mục 10.1.5). Toàn bộ phần còn lại của tài liệu xoay quanh câu hỏi: làm sao giảm số bit mà sai số gây ra là nhỏ nhất?
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Theo Hình 1, đọc 64 bit từ DRAM tốn năng lượng gấp khoảng bao nhiêu lần một phép nhân FP32?
Vì sao: Đọc 64 bit từ DRAM tốn 1300–2600 pJ, còn một phép nhân FP32 tốn 3,7 pJ — chênh nhau hàng trăm lần. Đây là lý do giảm số byte phải đọc thường có lợi hơn việc làm phép tính rẻ đi.2Sinh từng token của một LLM với batch nhỏ là bài toán thuộc loại nào?
Vì sao: Mỗi trọng số được đọc một lần nhưng chỉ tham gia rất ít phép tính, nên cường độ số học rất thấp. Vì vậy chỉ cần nén trọng số (weight-only) là đã nhanh hơn gần tỉ lệ với mức nén, kể cả khi phép nhân vẫn làm bằng FP16.3"Lượng tử hoá luôn làm mô hình chạy nhanh hơn." Phát biểu này:
Vì sao: Mục 10.1.5 đo đượcInt8WeightOnlychạy eager chậm hơn FP32 hơn 2 lần, vì không cótorch.compilethì trọng số bị giải lượng tử về số thực ở mỗi lần gọi. Không có kernel phù hợp thì mô hình chỉ nhẹ hơn chứ không nhanh hơn.
Đã trả lời 0/3