1Các họ mô hình#
Ở giáo trình Nền tảng, mỗi chương giới thiệu một mô hình: hồi quy tuyến tính, hồi quy logistic, SVM, k láng giềng gần nhất. Khi đứng trước một bài toán mới, câu hỏi thực tế lại khác: nên dùng mô hình nào? Câu trả lời hay nghe là "thử vài mô hình rồi chọn cái tốt nhất". Lời khuyên đó không sai, nhưng có thể đoán trước khá nhiều điều nếu biết mỗi họ mô hình giả định gì về hàm cần học. Chẳng hạn, cây tăng cường gradient vẫn thường thắng mạng nơ-ron trên dữ liệu dạng bảng, trong khi mạng tích chập và Transformer vượt xa mọi thứ khác trên ảnh và văn bản; cả hai sự kiện đều giải thích được bằng giả định của mô hình. Ta bắt đầu bằng việc dựng một khung để so sánh các họ mô hình theo cách đó.
1.1Các câu hỏi khi thiết kế một mô hình#
Mọi thuật toán học có giám sát đều phải trả lời cùng một nhóm câu hỏi, và mỗi thuật toán là một cách trả lời cụ thể. Câu hỏi đầu tiên là xét họ hàm nào: hàm tuyến tính của đặc trưng, hàm hằng trên từng vùng hình hộp, hay hợp của nhiều phép biến đổi. Đây chính là thành phần "mô hình" trong ba thành phần của một thuật toán học (Mục 1.1 của Nền tảng). Câu hỏi thứ hai là đo mức tốt của một hàm bằng gì, tức hàm mất mát, thành phần thứ hai trong ba thành phần đó; Domingos (2012) tóm gọn cả ba thành công thức học = biểu diễn + đánh giá + tối ưu. Câu hỏi thứ ba là số tham số được cố định trước hay tăng theo dữ liệu. Hồi quy tuyến tính có tham số dù có bao nhiêu dữ liệu, còn cây quyết định có thể mọc thêm nút khi có thêm dữ liệu; những mô hình như cây được gọi là phi tham số (nonparametric). Tên gọi này dễ gây hiểu nhầm: chúng vẫn có tham số, chỉ là số tham số tăng theo dữ liệu, và một cây bị giới hạn độ sâu, như cây một lần chia ở Mục 1.4, lại là mô hình có tham số.
Câu hỏi thứ tư là tìm tham số bằng cách nào: bằng nghiệm dạng đóng như hồi quy tuyến tính, giải bài toán tối ưu lồi như hồi quy logistic và SVM, tìm kiếm tham lam như cây quyết định, hay chạy gradient descent trên một hàm không lồi như mạng nơ-ron. Câu hỏi cuối cùng là kiểm soát overfitting bằng cách nào: phạt chuẩn của trọng số, giới hạn độ sâu của cây, lấy trung bình nhiều mô hình, hay dừng sớm quá trình tối ưu.
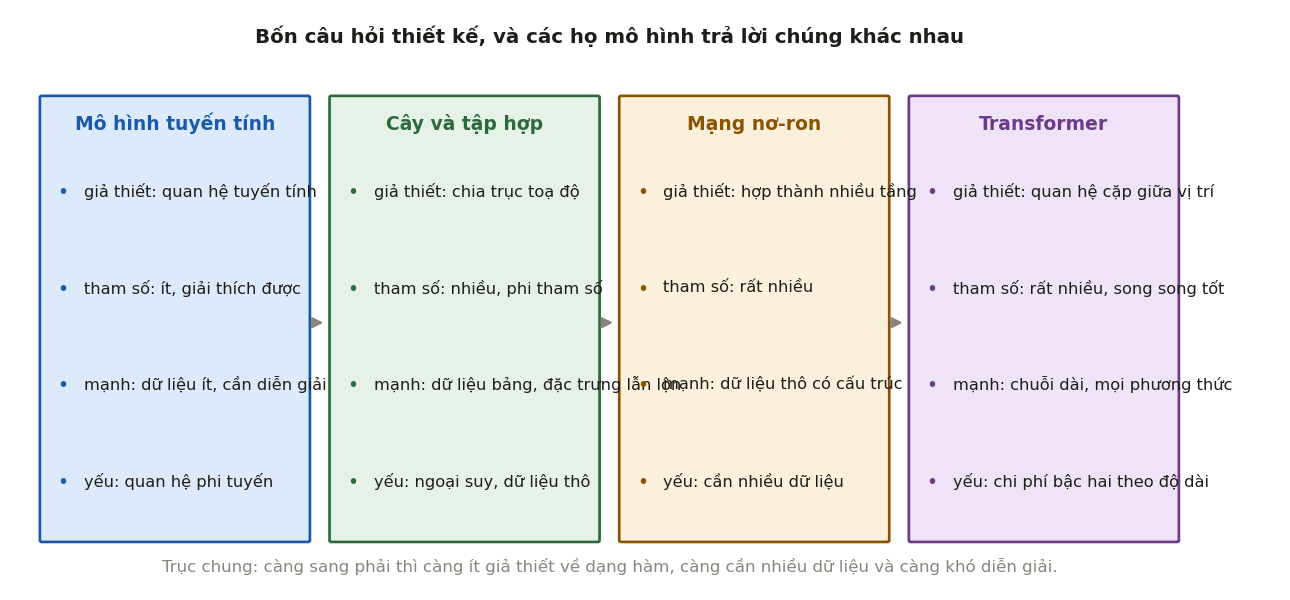
Trả lời được năm câu hỏi này cho một mô hình là nắm được những đặc điểm quan trọng nhất của nó: nó biểu diễn được gì, cần bao nhiêu dữ liệu, huấn luyện tốn kém thế nào và dễ hỏng ở đâu. Hình 1 xếp bốn họ mô hình lớn theo mức độ giả định của chúng.
1.2So sánh các họ mô hình#
Bảng dưới trả lời các câu hỏi ở Mục 1.1 cho bốn họ mô hình, kèm trường hợp phù hợp và hạn chế của mỗi họ. Bảng không có dòng cho hàm mất mát, vì lựa chọn đó phụ thuộc vào bài toán, hồi quy hay phân loại, nhiều hơn vào họ mô hình.
| Mô hình tuyến tính | Cây và phương pháp tập hợp | Mạng nơ-ron nhiều lớp | Transformer | |
|---|---|---|---|---|
| Giả định về dạng hàm | tổ hợp tuyến tính của các đặc trưng | hằng số trên các hình hộp có cạnh song song với trục | hợp của nhiều phép biến đổi affine xen với hàm phi tuyến | như mạng nơ-ron, thêm cơ chế kết hợp thông tin giữa mọi cặp vị trí |
| Số tham số | , cố định | tăng theo dữ liệu nếu không giới hạn độ sâu | rất nhiều, cố định trước | rất nhiều, cố định trước |
| Cách tối ưu | nghiệm dạng đóng hoặc tối ưu lồi | tham lam theo từng lần chia | gradient descent và lan truyền ngược | như mạng nơ-ron |
| Kiểm soát overfitting | regularization , | giới hạn độ sâu, cắt tỉa, lấy trung bình | dừng sớm, weight decay, dropout, tăng cường dữ liệu | như mạng nơ-ron |
| Phù hợp khi | ít dữ liệu, cần diễn giải, quan hệ gần tuyến tính | dữ liệu dạng bảng, đặc trưng lẫn số và hạng mục | dữ liệu thô có cấu trúc: ảnh, âm thanh | chuỗi dài, văn bản, và ngày càng nhiều loại dữ liệu khác |
| Hạn chế | không biểu diễn được quan hệ phi tuyến nếu không tự tạo đặc trưng | không ngoại suy được; kém với dữ liệu thô | cần nhiều dữ liệu; kém với dữ liệu bảng thuần | chi phí tăng theo bình phương độ dài chuỗi |
Bảng này giải thích được một kết quả thực nghiệm mà người mới thường ngạc nhiên: trên dữ liệu dạng bảng, các mô hình dựa trên cây, nhất là gradient boosting, vẫn thường cho kết quả bằng hoặc tốt hơn mạng nơ-ron sâu, với chi phí thấp hơn nhiều. Grinsztajn, Oyallon và Varoquaux (2022) so sánh trên 45 bộ dữ liệu dạng bảng cỡ vừa, khoảng 10 nghìn mẫu huấn luyện mỗi bộ, sau khi tinh chỉnh kỹ siêu tham số cho mọi mô hình, và chỉ ra ba nguyên nhân. Dữ liệu bảng thường có nhiều đặc trưng không liên quan. Hàm cần học thường không trơn mà có những bước nhảy theo ngưỡng. Và mỗi cột có ý nghĩa riêng, nên một phép quay không gian đặc trưng làm mất thông tin. Cả ba đặc điểm này hợp với cách chia theo từng trục của cây, và không hợp với phép biến đổi affine của mạng nơ-ron. Kết luận đúng trong phạm vi đó chứ không phải một quy luật chung: McElfresh và cộng sự (2023) so sánh trên 176 bộ dữ liệu và thấy rằng trên nhiều bộ, chênh lệch giữa hai họ không đáng kể, còn tinh chỉnh nhẹ siêu tham số của gradient boosting quan trọng hơn việc chọn giữa mạng nơ-ron và cây.
1.3Các yếu tố quyết định kết quả#
Họ mô hình không phải yếu tố duy nhất, và thường cũng không phải yếu tố quan trọng nhất. Với cùng một bài toán, kinh nghiệm thực tế cho thấy thứ tự ảnh hưởng tới kết quả thường là
Đây là quy tắc kinh nghiệm, không phải định lý, và có ngoại lệ: với ảnh và văn bản, chọn đúng họ mô hình như mạng tích chập hay Transformer quan trọng hơn nhiều so với tự thiết kế đặc trưng. Nhưng quy tắc này nhắc một điều hay bị quên: nhãn sai, hoặc dữ liệu không đại diện cho tình huống sử dụng thật, là những lỗi mà không mô hình nào sửa được. Giáo trình này tập trung vào ba mức sau; hai mức đầu được bàn trong MLOps.
Với một dự án cụ thể, không cần dựa vào thứ tự chung này, vì có thể đo được thành phần nào đáng cải thiện nhất. Andrew Ng thường dạy hai phép đo cho việc đó trong phần hướng dẫn áp dụng học máy của khoá CS229. Phân tích lỗi (error analysis) lần lượt thay đầu ra của từng bước trong hệ thống bằng kết quả đúng, rồi xem độ chính xác cuối cùng tăng bao nhiêu. Chẳng hạn một hệ thống đọc hoá đơn gồm ba bước, tìm vùng chữ, nhận dạng chữ và trích các trường thông tin, đạt độ chính xác 85%. Thay bước tìm vùng chữ bằng vùng đúng chỉ đưa con số lên 86%, còn thay thêm bước nhận dạng chữ bằng chữ đúng đưa lên 97%, nên bước nhận dạng chữ là chỗ đáng đầu tư trước. Phân tích loại bỏ (ablation) đi theo chiều ngược lại: bỏ lần lượt từng thành phần khỏi hệ thống hoàn chỉnh rồi đo mức giảm, để biết thành phần nào thật sự đóng góp.
1.4Thiên kiến quy nạp#
Một tập dữ liệu hữu hạn luôn khớp được với vô số hàm khác nhau. Qua 10 điểm dữ liệu có vô số đường cong đi qua chính xác mọi điểm, và chúng dự đoán rất khác nhau ở những điểm chưa thấy. Muốn dự đoán được, thuật toán học phải ưu tiên một số hàm hơn các hàm khác, bằng những giả định không đến từ dữ liệu.
Định nghĩa 1.1 (Thiên kiến quy nạp)
Thiên kiến quy nạp (inductive bias) của một thuật toán học là tập các giả định nó dùng để chọn giữa các hàm cùng khớp dữ liệu huấn luyện, và do đó quyết định cách nó dự đoán cho các điểm chưa thấy.
Mỗi họ mô hình có một thiên kiến quy nạp riêng. Hồi quy tuyến tính giả định quan hệ tuyến tính. Regularization ưu tiên trọng số nhỏ (Mục 9.2 của Nền tảng). k láng giềng gần nhất giả định các điểm gần nhau có nhãn giống nhau. Mạng tích chập giả định đặc trưng có tính cục bộ và giống nhau ở mọi vị trí trong ảnh (Mục 7.1). Transformer giả định rất ít, và vì thế cần rất nhiều dữ liệu.
Bốn căn hộ ở Chương 4 của Nền tảng, rộng 40, 60, 80, 100 m² với giá 1,5; 2,1; 2,4; 3,0 tỉ đồng, cho thấy thiên kiến quy nạp quyết định dự đoán ra sao. Ba mô hình học từ cùng bốn điểm này. Hồi quy tuyến tính cho đường . Cây quyết định một lần chia cắt ở 70 m², dự đoán 1,8 tỉ cho mọi căn nhỏ hơn và 2,7 tỉ cho mọi căn lớn hơn. Còn 1 láng giềng gần nhất lấy giá của căn gần nhất. Với căn 120 m², ba mô hình dự đoán lần lượt 3,45; 2,7 và 3,0 tỉ. Cả ba đều khớp bốn căn hộ ở mức chấp nhận được, nhưng khác nhau ở giả định: hồi quy tuyến tính giả định giá tăng đều theo diện tích nên ngoại suy theo đường thẳng, cây giả định giá là hằng số trên từng khoảng nên mọi dự đoán của nó nằm trong khoảng giá đã thấy, còn 1 láng giềng gần nhất giả định một căn hộ đáng giá như căn giống nó nhất đã thấy. Dữ liệu không cho biết giả định nào đúng.
Không có thiên kiến quy nạp nào tốt nhất cho mọi bài toán. Định lý "không có bữa trưa miễn phí" (no free lunch; Wolpert, 1996) phát biểu chặt chẽ điều này: lấy trung bình trên mọi bài toán có thể, mọi thuật toán học có cùng sai số trên các điểm ngoài tập huấn luyện. Một thuật toán chỉ tốt hơn thuật toán khác trên những bài toán mà giả định của nó phù hợp. Vì vậy câu hỏi "mô hình nào tốt nhất" không có câu trả lời chung; câu hỏi đúng là giả định của mô hình nào khớp với cấu trúc của dữ liệu đang có.
Lượng dữ liệu cũng quyết định giả định nào có lợi. Domingos (2012) dẫn một thí nghiệm trong đó dữ liệu được sinh từ một tập luật, vậy mà Naive Bayes, với giả định độc lập vốn sai với dữ liệu đó, vẫn thắng một thuật toán học luật cho tới khoảng 1 000 mẫu: khi dữ liệu còn ít, một giả định mạnh mà sai có thể tốt hơn một giả định yếu mà đúng. Andrew Ng minh hoạ chiều còn lại bằng đồ thị hiệu năng theo lượng dữ liệu có nhãn trong khoá Deep Learning Specialization. Các mô hình như hồi quy logistic chững lại khi dữ liệu tăng, còn mạng nơ-ron càng lớn càng tiếp tục cải thiện. Ở vùng ít dữ liệu, thứ tự giữa các thuật toán không rõ ràng, và cách thiết kế đặc trưng quyết định nhiều hơn.
1.5Tóm tắt#
Mỗi họ mô hình là một cách trả lời năm câu hỏi: xét họ hàm nào, đo mức tốt bằng hàm mất mát nào, số tham số cố định hay tăng theo dữ liệu, tìm tham số bằng cách nào, và kiểm soát overfitting ra sao. Các câu trả lời đó quy về thiên kiến quy nạp của mô hình, tức những giả định nó dùng để chọn giữa các hàm cùng khớp dữ liệu; từ cùng bốn căn hộ, hồi quy tuyến tính, cây một lần chia và 1 láng giềng gần nhất định giá căn 120 m² là 3,45; 2,7 và 3,0 tỉ. Không có thiên kiến nào tốt nhất cho mọi bài toán: cây hợp với dữ liệu bảng vì nó chia theo từng trục, còn mạng tích chập và Transformer hợp với ảnh và văn bản vì giả định của chúng khớp với cấu trúc của các loại dữ liệu đó. Khi dữ liệu ít, giả định mạnh có lợi kể cả khi nó sai; khi dữ liệu nhiều, mô hình ít giả định như mạng nơ-ron lớn tiếp tục cải thiện. Dù vậy, dữ liệu và nhãn thường ảnh hưởng tới kết quả nhiều hơn việc chọn mô hình, và trong một dự án cụ thể, phân tích lỗi cho biết thành phần nào đáng cải thiện nhất.
Giả định càng mạnh thì họ hàm càng hẹp. Nếu giả định đúng, mô hình học được từ ít dữ liệu; nếu sai, nó mắc một sai số có hệ thống mà thêm dữ liệu cũng không sửa được. Chương 2 đặt tên cho loại sai số này và loại sai số đối lập với nó, rồi đo cả hai.
Tự kiểm tra
2 câu. Chọn đáp án để xem ngay lời giải thích.
1Thiên kiến quy nạp của một thuật toán học là gì?
2Vì sao gradient boosting thường tốt hơn mạng nơ-ron trên dữ liệu dạng bảng?
Vì sao: Grinsztajn và cộng sự (2022) so sánh trên 45 bộ dữ liệu bảng và chỉ ra ba đặc điểm đó. Phép biến đổi affine của mạng nơ-ron trộn các cột với nhau, trong khi cây xử lý từng cột riêng (Mục 1.2).
Đã trả lời 0/2