1Nghề kỹ sư AI#
Giả sử một công ty muốn có một trợ lý trả lời câu hỏi của nhân viên về quy chế nội bộ. Cách làm quen thuộc trước đây là thu thập hàng nghìn câu hỏi mẫu, gán nhãn ý định cho từng câu, huấn luyện một bộ phân loại ý định, rồi viết tay câu trả lời cho từng ý định. Ngày nay có thể bắt đầu từ một mô hình ngôn ngữ lớn do người khác huấn luyện: đưa cho nó văn bản quy chế cùng câu hỏi, và nhận lại một câu trả lời đọc được ngay trong buổi chiều.
Phần khó không biến mất mà dời sang chỗ khác. Mô hình phải tìm đúng điều khoản trong hàng trăm trang quy chế, không được bịa ra điều khoản không có, không được làm theo một câu lệnh ai đó cài vào tài liệu, phải trả lời đủ nhanh, và tổng chi phí mỗi tháng phải nằm trong ngân sách. Người giải quyết những việc đó là kỹ sư AI. Chương đầu tiên mô tả công việc của họ, để các chương sau có chỗ đặt vào.
1.1Công việc của kỹ sư AI#
Kỹ sư AI (AI engineer) xây ứng dụng trên các mô hình nền tảng (foundation model) đã được huấn luyện sẵn, mà phổ biến nhất là mô hình ngôn ngữ lớn. Họ hiếm khi huấn luyện mô hình từ đầu. Việc của họ là chọn một mô hình có sẵn rồi dựng quanh nó những thành phần cần thiết để mô hình giải đúng bài toán của sản phẩm.
Trở lại trợ lý quy chế, các thành phần đó xuất hiện theo một thứ tự khá tự nhiên. Trước hết phải chọn mô hình, cân nhắc giữa chất lượng, chi phí, độ trễ, quyền riêng tư và giấy phép (Chương 3). Có mô hình rồi thì phải nói cho nó biết cần làm gì: viết chỉ dẫn, chọn ví dụ, và quyết định ở mỗi lần gọi thì thông tin nào được đưa vào cửa sổ ngữ cảnh (Chương 4 và 5). Mô hình không biết quy chế của công ty, nên cần một hệ thống truy xuất tìm đúng các điều khoản liên quan rồi đưa chúng vào ngữ cảnh (Chương 6, 7 và 8). Nếu trợ lý còn phải làm việc, chẳng hạn tra số ngày phép còn lại của một nhân viên, thì mô hình phải gọi được API và cơ sở dữ liệu, thông qua function calling và MCP (Chương 9 và 10). Vì tài liệu và câu hỏi đều có thể chứa nội dung độc hại, hệ thống cần chống prompt injection, bảo vệ dữ liệu cá nhân và giới hạn quyền của mô hình (Chương 11). Cuối cùng, phải đo được hệ thống trả lời đúng tới đâu, và theo dõi chất lượng, chi phí, độ trễ khi nó đã chạy thật (Chương 12 và 13).
1.2Kỹ sư AI và kỹ sư học máy#
Hai vai trò này chồng lấn nhau nhiều nhưng xuất phát từ hai điểm khác nhau. Kỹ sư học máy bắt đầu từ dữ liệu có nhãn của bài toán và đi tới một mô hình; kỹ sư AI bắt đầu từ một mô hình đã có và đi tới một sản phẩm. Bảng dưới so sánh hai vai trò ở những khía cạnh còn lại.
| Kỹ sư học máy | Kỹ sư AI | |
|---|---|---|
| Điểm xuất phát | dữ liệu có nhãn của bài toán | một mô hình nền tảng đã huấn luyện sẵn |
| Công việc chính | thu thập dữ liệu, xây đặc trưng, huấn luyện và tinh chỉnh mô hình | thiết kế prompt và ngữ cảnh, truy xuất, tool, đánh giá hệ thống |
| Mô hình | thường nhỏ, chuyên cho một nhiệm vụ | thường lớn, đa năng, gọi qua API hoặc tự triển khai |
| Chi phí chính | huấn luyện | suy luận (mỗi lần gọi mô hình) |
| Vòng lặp phát triển | tính bằng ngày hoặc tuần (mỗi lần huấn luyện lại) | tính bằng phút (mỗi lần sửa prompt) |
| Đầu ra | thường có cấu trúc (một nhãn, một con số) | thường là văn bản tự do, khó đánh giá tự động |
Hàng cuối của bảng là nguồn gốc của phần lớn cái khó trong nghề. Với bộ phân loại ở giáo trình Nền tảng, đánh giá chỉ là so nhãn dự đoán với nhãn thật. Với một câu trả lời bằng văn bản, cùng một ý đúng có thể được diễn đạt theo rất nhiều cách, nên không thể so từng chữ, và việc đánh giá cần những kỹ thuật riêng mà Chương 12 sẽ trình bày.
Ranh giới giữa hai vai trò cũng không cố định. Kỹ sư AI vẫn cần hiểu học máy: để biết khi nào nên tinh chỉnh mô hình thay vì sửa prompt, để dùng thống kê cho đúng khi so sánh hai phiên bản, và để đoán được vì sao mô hình hỏng. Vì vậy lộ trình đặt giáo trình này sau Nền tảng, Học sâu và Biểu diễn & Căn chỉnh.
1.3Phát triển dựa trên đánh giá#
Trước khi có LLM, muốn thêm một tính năng dùng học máy, chẳng hạn phân loại email hay trích thông tin từ hoá đơn, đội phát triển phải thu thập và gán nhãn dữ liệu, huấn luyện mô hình, rồi mới có bản đầu tiên để thử. Với LLM, bản thử đầu tiên có thể xong trong một buổi: viết prompt mô tả nhiệm vụ, gọi API và xem kết quả.
Khởi đầu nhanh như vậy làm đổi thứ tự công việc. Phần tốn công nhất không còn là làm cho hệ thống chạy được, mà là biết chắc nó chạy tốt tới mức nào. Một prompt cho kết quả tốt trên năm ví dụ thử bằng tay vẫn có thể sai ở 20% trường hợp thật, và người viết prompt không thể nhận ra điều đó nếu chỉ thử bằng tay. Do đó một quy trình tốt bắt đầu bằng bản thử nhanh để hiểu bài toán, rồi dừng lại xây một bộ đánh giá gồm vài chục tới vài trăm ví dụ đại diện, mỗi ví dụ kèm tiêu chí đúng sai (Chương 12). Từ lúc đó, mọi thay đổi về prompt, ngữ cảnh, truy xuất hay mô hình đều được đo trên bộ đánh giá ấy. Khi hệ thống đã được đưa vào sử dụng, những trường hợp hỏng gặp trong thực tế lại được bổ sung vào bộ đánh giá (Chương 13), và vòng lặp tiếp tục.
Cách làm này được gọi là phát triển dựa trên đánh giá (evaluation-driven development). Bộ đánh giá đóng vai trò giống bộ kiểm thử tự động trong phát triển phần mềm, với một khác biệt: kết quả mang tính thống kê. Một thay đổi thường làm tốt hơn ở một số ví dụ và tệ hơn ở một số ví dụ khác, nên chỉ có số liệu trên đủ nhiều ví dụ mới cho biết tổng thể tốt lên hay xấu đi.
1.4Các thuật ngữ cơ bản#
Trước khi đi vào chi tiết, ta điểm qua những thuật ngữ sẽ gặp ở mọi chương sau, kèm nơi chúng được trình bày kỹ.
Trí tuệ nhân tạo (AI) là tên chung của lĩnh vực nghiên cứu cách cho máy tính làm những việc vốn cần trí thông minh. Trên báo chí còn hay gặp chữ AGI (artificial general intelligence), chỉ một hệ thống giả định có năng lực tổng quát ngang con người ở hầu hết nhiệm vụ trí tuệ. AGI chưa có định nghĩa nào vừa được thống nhất vừa kiểm chứng được, nên giáo trình không dùng khái niệm này.
Mô hình ngôn ngữ lớn (large language model, LLM) là một mạng nơ-ron, thường có kiến trúc Transformer, được huấn luyện để dự đoán token tiếp theo trên một lượng văn bản rất lớn. Chương 2 xét nó từ phía người xây ứng dụng; kiến trúc bên trong nằm ở Chương 9 của Học sâu. Mỗi mô hình trải qua hai giai đoạn khác hẳn nhau. Huấn luyện là quá trình học tham số, rất tốn kém và chỉ làm một lần. Suy luận (inference) là chạy mô hình đã huấn luyện để sinh kết quả, và lặp lại mỗi khi có yêu cầu. Kỹ sư AI làm việc chủ yếu ở giai đoạn suy luận. Khi cần thay đổi hành vi của mô hình mà prompt không làm được, có thể tinh chỉnh (fine-tuning), tức huấn luyện tiếp mô hình trên dữ liệu riêng; xem Chương 6 và 7 của Biểu diễn & Căn chỉnh.
Ở phía dữ liệu, embedding là một vector số biểu diễn nghĩa của một đoạn văn, sao cho hai đoạn có nghĩa gần nhau thì có vector gần nhau (Chương 6). Cơ sở dữ liệu vector lưu các embedding và tìm nhanh những vector gần một vector cho trước (Chương 7). Ghép hai thứ đó lại ta có RAG (retrieval-augmented generation): truy xuất các tài liệu liên quan tới câu hỏi rồi đưa chúng vào ngữ cảnh để mô hình trả lời dựa trên đó (Chương 8). Ở phía hành động, agent là hệ thống trong đó mô hình tự quyết định chuỗi bước cần làm, như gọi một tool, đọc kết quả rồi chọn bước tiếp theo, để hoàn thành một nhiệm vụ (Chương 9).
Cuối cùng là hai thuật ngữ về cách giao tiếp với mô hình. Prompt engineering là việc viết chỉ dẫn cho mô hình. Context engineering rộng hơn: quản lý toàn bộ thông tin nằm trong cửa sổ ngữ cảnh ở mỗi lần gọi, gồm chỉ dẫn, lịch sử hội thoại, tài liệu và kết quả của tool (Chương 4 và 5).
1.5Cấu trúc của một ứng dụng dùng LLM#
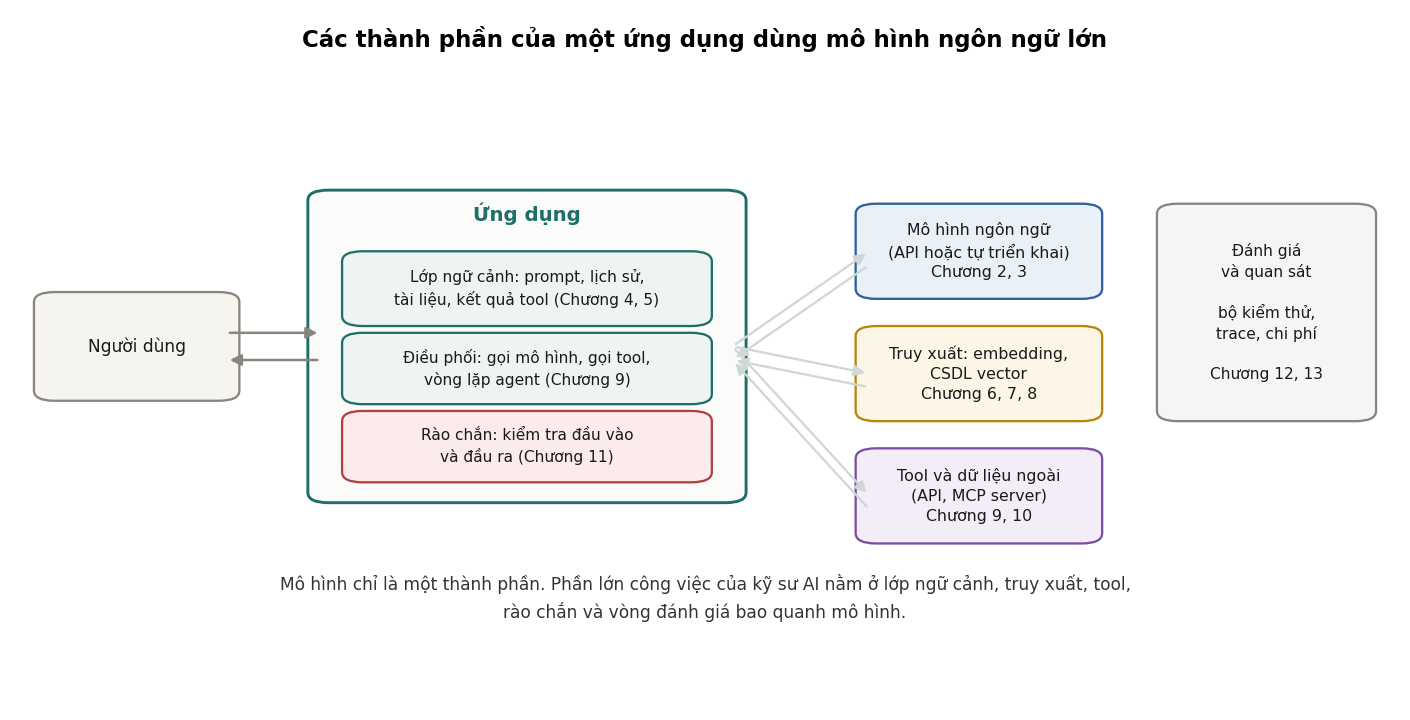
Hình 1 gom các thành phần vừa kể vào một sơ đồ. Người dùng gửi yêu cầu tới ứng dụng. Ứng dụng dựng ngữ cảnh cho mô hình từ chỉ dẫn, lịch sử hội thoại, các tài liệu truy xuất được và kết quả của các tool, rồi gọi mô hình. Nếu mô hình yêu cầu gọi một tool, ứng dụng thực thi tool đó và đưa kết quả trở lại cho mô hình. Rào chắn kiểm tra cả đầu vào lẫn đầu ra, và mọi hoạt động được ghi lại để đánh giá và theo dõi.
Trong sơ đồ, mô hình chỉ chiếm một ô. Cùng một mô hình có thể cho ra một sản phẩm rất tốt hoặc rất kém tuỳ vào những ô xung quanh, và phần lớn giáo trình này nói về các ô đó. Mỗi ô cũng hỏng theo kiểu riêng của nó: truy xuất lấy nhầm tài liệu, tool trả về lỗi, prompt bị chèn lệnh, mô hình bịa thông tin. Khi hệ thống trả lời sai, việc đầu tiên là tìm xem lỗi nằm ở ô nào, và chỉ làm được việc đó nếu từng ô được ghi lại riêng (Chương 13).
1.6Tóm tắt#
Kỹ sư AI xây sản phẩm trên một mô hình nền tảng có sẵn, thay vì huấn luyện mô hình từ dữ liệu có nhãn. Vì bản thử đầu tiên có rất nhanh, công sức chính dời sang việc đo xem hệ thống tốt tới đâu, và quy trình phát triển xoay quanh một bộ đánh giá. Một ứng dụng dùng LLM gồm mô hình và nhiều thành phần bao quanh nó: dựng ngữ cảnh, truy xuất, tool, rào chắn và ghi nhận hoạt động.
Trước khi dựng các thành phần đó, ta cần hiểu thứ nằm ở giữa sơ đồ. Chương 2 xét mô hình ngôn ngữ lớn ở đúng mức người xây ứng dụng cần: nó đọc văn bản dưới dạng nào, nhìn thấy được bao nhiêu, sinh chữ ra sao, và vì sao mỗi lần gọi lại tốn thời gian và tiền.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Điểm xuất phát điển hình của một kỹ sư AI khác kỹ sư học máy ở chỗ nào?
2Trong phát triển dựa trên LLM, vì sao nên xây bộ đánh giá sớm?
Vì sao: Một prompt tốt trên vài ví dụ thử bằng tay có thể sai ở nhiều trường hợp thật. Quy trình phát triển dựa trên đánh giá đo sau mỗi thay đổi (Mục 1.3).3Khi một ứng dụng dùng LLM trả lời sai, việc đầu tiên nên làm là gì?
Đã trả lời 0/3