Lộ trình kỹ sư AI
Lộ trình
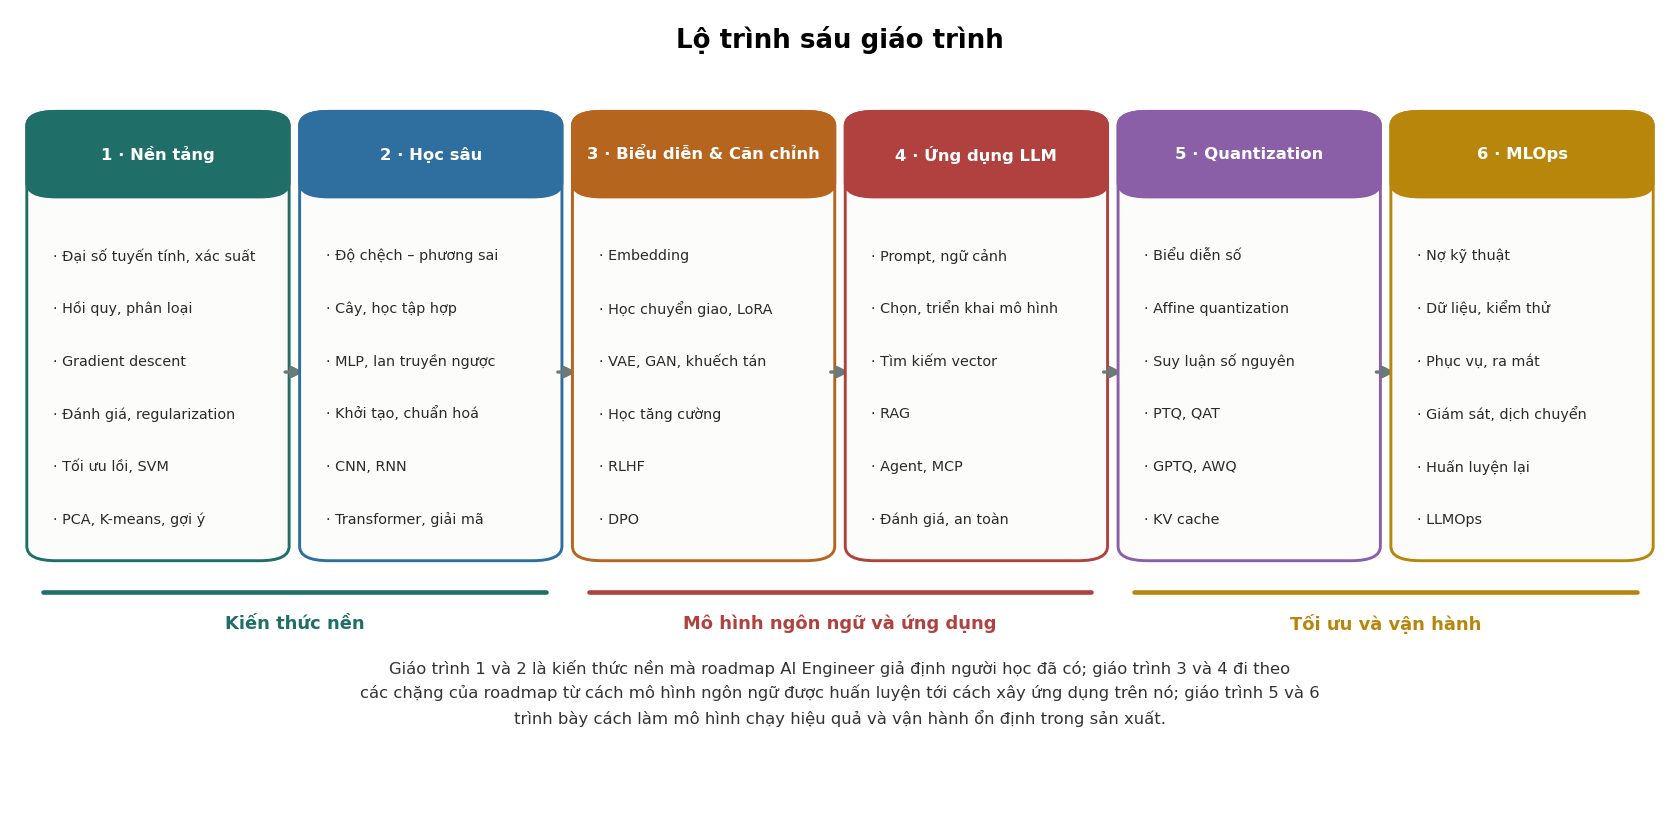
Lộ trình đi theo các chặng của roadmap AI Engineer trên roadmap.sh, bắt đầu bằng phần kiến thức nền mà roadmap đó giả định người học đã có: toán, học máy cổ điển, học sâu và cách mô hình ngôn ngữ được huấn luyện. 6 giáo trình được xếp thành 13 chặng với 84 bài đánh số liên tục.
Thứ tự này ít phải quay lại nhất, nhưng không bắt buộc: mỗi bài có liên kết tới đúng mục kiến thức cũ mà nó cần. Bảng đối chiếu ở cuối trang cho biết mỗi chủ đề của roadmap được trình bày ở đâu.
13 chặng · 84 bài · 88 hình sinh bằng mã · khoảng 19 giờ đọc
Chặng 1 · Nền tảng
Toán cho học máy
Đại số tuyến tính và xác suất ở đúng mức cần để đọc mọi chặng sau.
- 1Tổng quan về học máyChương 1 · Nền tảngPhần lớn thuật toán học máy được ghép từ cùng ba thành phần: một họ hàm, một hàm mất mát và một cách tối ưu; chương dựng khung đó, phân loại các dạng bài toán và mô tả quy trình bao quanh thuật toán, nơi xảy ra phần lớn lỗi.
- 2Đại số tuyến tínhChương 2 · Nền tảngNhững khái niệm đại số tuyến tính mà các chương sau cần, mỗi khái niệm kèm lý do: hạng quyết định hồi quy có nghiệm duy nhất hay không, số điều kiện quyết định tốc độ của gradient descent, SVD dẫn tới PCA và ridge.
- 3Xác suất và thống kêChương 3 · Nền tảngNgôn ngữ để nói về sự không chắc chắn: kỳ vọng, phương sai, ma trận hiệp phương sai, phân phối Gauss và định lý Bayes, cùng phép tách sai số của một ước lượng thành độ chệch và phương sai.
Chặng 2 · Nền tảng, Học sâu
Học máy cổ điển
Hồi quy, phân loại, đánh giá mô hình, regularization, tối ưu lồi, SVM, học không giám sát, rồi so sánh các họ mô hình, phân rã độ chệch – phương sai, cây quyết định và phương pháp tập hợp.
- 4Hồi quy tuyến tínhChương 4 · Nền tảngThuật toán đơn giản nhất có nghiệm dạng đóng, nên các hiện tượng như ma trận suy biến và đa cộng tuyến quan sát được trực tiếp; thí nghiệm cho thấy đa cộng tuyến làm hệ số dao động gấp 25 lần mà dự đoán gần như không đổi.
- 5Gradient descentChương 5 · Nền tảngKhi không có công thức, ta đi từng bước xuống dốc: số vòng lặp tỉ lệ với số điều kiện, momentum hạ nó xuống theo căn bậc hai, và gradient tự tính cần được kiểm tra bằng sai phân với bước sai phân chọn đúng.
- 6Phân loại tuyến tínhChương 6 · Nền tảngPerceptron, hồi quy logistic và hồi quy softmax dùng chung mô hình tuyến tính và khác nhau ở hàm mất mát; khác biệt đó quyết định perceptron có hội tụ không và hồi quy logistic có cho ra xác suất không.
- 7k láng giềng gần nhất và Naive BayesChương 7 · Nền tảngHai cách tiếp cận khác với việc học biên quyết định: k-NN tra cứu các điểm gần nhất, còn Naive Bayes mô tả dữ liệu từng lớp rồi suy ngược bằng Bayes; với dữ liệu Gauss, Naive Bayes, LDA và QDA là cùng một mô hình.
- 8Đánh giá mô hình phân loạiChương 8 · Nền tảngĐộ chính xác có thể chọn nhầm một mô hình vô dụng khi lớp dương hiếm; chương xây các thước đo thay thế từ ma trận nhầm lẫn, so ROC-AUC với PR-AUC, và nêu các lỗi chia dữ liệu làm mọi con số mất ý nghĩa.
- 9Overfitting và regularizationChương 9 · Nền tảngMô hình có thể khớp dữ liệu huấn luyện rất tốt mà dự đoán kém; ridge và lasso kiểm soát điều đó theo hai cách khác nhau, phân tích được chính xác qua SVD, và cường độ regularization được chọn bằng cross-validation.
- 10Ước lượng hợp lý cực đại và hậu nghiệm cực đạiChương 10 · Nền tảngPhần lớn hàm mất mát và thành phần phạt đã gặp suy ra được từ hai nguyên lý: hợp lý cực đại cho bình phương sai số và cross-entropy, hậu nghiệm cực đại cho ridge, lasso và làm trơn Laplace.
- 11Tập lồi và hàm lồiChương 11 · Nền tảngTính lồi là ranh giới giữa bài toán tối ưu có bảo đảm và không có: định nghĩa, cách nhận ra hàm lồi qua các phép toán bảo toàn, và thí nghiệm cho thấy gradient descent dừng ở nhiều điểm khác nhau khi tính lồi mất đi.
- 12Tối ưu lồi và đối ngẫu LagrangeChương 12 · Nền tảngCông cụ để xử lý ràng buộc trong bài toán lồi: hàm Lagrange, bài toán đối ngẫu, điều kiện Slater và KKT, với điều kiện bù dẫn thẳng tới vector hỗ trợ; mọi khái niệm được tính tay trên một ví dụ xuyên suốt.
- 13Máy vector hỗ trợChương 13 · Nền tảngSVM chọn siêu phẳng có lề lớn nhất; đối ngẫu chỉ ra rằng chỉ vài vector hỗ trợ quyết định nghiệm, lề mềm tương đương mất mát hinge cộng regularization, và kernel cho biên phi tuyến mà không phải dựng không gian đặc trưng.
- 14Giảm chiều dữ liệuChương 14 · Nền tảngPCA tìm các hướng có phương sai lớn nhất và hoá ra là phân tích trị riêng của ma trận hiệp phương sai; định lý Eckart–Young được kiểm chứng tới 10⁻¹², và một thí nghiệm cho thấy khi có nhãn, LDA chọn hướng tốt hơn hẳn.
- 15Phân cụm K-meansChương 15 · Nền tảngK-means đơn giản nhưng đặt ra ba câu hỏi: kết quả phụ thuộc khởi tạo tới mức nào, thuật toán ngầm giả định cụm có hình dạng gì, và chọn số cụm ra sao khi không có nhãn để đối chiếu.
- 16Hệ thống gợi ýChương 16 · Nền tảngPhân rã ma trận dùng lại gần như mọi công cụ của giáo trình; thí nghiệm cho thấy nó chỉ có ích khi mỗi người có số đánh giá gấp vài lần hạng, và người dùng mới cần một phương án dựa trên nội dung.
- 17Các họ mô hìnhChương 1 · Học sâuMỗi họ mô hình là một cách trả lời cùng một nhóm câu hỏi về họ hàm, số tham số, cách tối ưu và cách chống overfitting; các câu trả lời đó quy về thiên kiến quy nạp, và giải thích vì sao cây vẫn mạnh trên dữ liệu dạng bảng.
- 18Độ chệch và phương saiChương 2 · Học sâuSai số của một mô hình tách thành độ chệch, phương sai và nhiễu; mô phỏng trên 250 tập huấn luyện đo từng thành phần, đường cong học thay phép đo trên dữ liệu thật, và double descent bổ sung cho bức tranh cổ điển.
- 19Cây quyết định và phương pháp tập hợpChương 3 · Học sâuMột cây quyết định có phương sai cao; bagging và rừng ngẫu nhiên giảm phương sai, gradient boosting giảm độ chệch, và số đo trên cùng một bài toán cho thấy từng cách tác động vào đâu.
Chặng 3 · Học sâu
Học sâu
Mạng nơ-ron nhiều lớp, lan truyền ngược và các thuật toán tối ưu, khởi tạo, chuẩn hoá, kết nối tắt, mạng tích chập, phát hiện đối tượng và phân đoạn ảnh, mạng hồi quy.
- 20Mạng nơ-ron nhiều lớpChương 4 · Học sâuVì sao giữa các lớp phải có hàm phi tuyến, mạng một lớp ẩn biểu diễn được tới đâu theo định lý xấp xỉ phổ quát, và một phép dựng cho thấy độ sâu tiết kiệm số tham số theo cấp số mũ.
- 21Lan truyền ngược và các thuật toán tối ưuChương 5 · Học sâuLan truyền ngược tính gradient với chi phí cỡ ba lần tính hàm mất mát nhưng tốn bộ nhớ kích hoạt; SGD, momentum, Adam và AdamW dùng gradient đó để cập nhật tham số, kèm một ví dụ tính tay đầy đủ.
- 22Khởi tạo, chuẩn hoá và kết nối tắtChương 6 · Học sâuGradient co lại hoặc phình ra qua nhiều lớp; khởi tạo Xavier và He, chuẩn hoá và kết nối tắt giữ nó ổn định, và thí nghiệm với mạng 40 lớp cho thấy kết nối tắt một mình làm gradient bùng nổ.
- 23Mạng nơ-ron tích chậpChương 7 · Học sâuBa giả định về ảnh giảm số tham số đi hàng nghìn lần; chương đi từ phép tích chập và trường tiếp nhận tới so sánh CNN với ViT, phát hiện đối tượng với IoU, NMS và AP, và phân đoạn ảnh.
- 24Mạng nơ-ron hồi quyChương 8 · Học sâuRNN đọc chuỗi bằng một trạng thái cập nhật qua từng bước; gradient tiêu biến và bùng nổ theo thời gian, LSTM giữ thông tin nhờ cổng quên, và giới hạn về tính song song khiến Transformer thay thế RNN.
Chặng 4 · Học sâu
Transformer và mô hình ngôn ngữ
Attention, ba kiểu kiến trúc Transformer, các cải tiến hiện nay như RoPE, GQA và FlashAttention, các chiến lược giải mã, và cách ước lượng tham số, FLOP, bộ nhớ.
- 25Attention và TransformerChương 9 · Học sâuAttention như một phép tra cứu mềm, lý do chia điểm số cho √dₖ được chứng minh và đo, attention nhiều đầu, mặt nạ, cấu trúc một khối Transformer, mã hoá vị trí và ba kiểu kiến trúc.
- 26Các cải tiến của TransformerChương 10 · Học sâuKhung Transformer giữ nguyên nhưng các thành phần đã đổi: pre-LN, RoPE, GQA, SwiGLU, mixture of experts và FlashAttention, mỗi thay đổi kèm vấn đề nó giải quyết và điểm yếu của nó.
- 27Các chiến lược giải mãChương 11 · Học sâuCùng một mô hình với hai chiến lược giải mã cho hai hành vi rất khác nhau; chương so sánh greedy, beam search, nhiệt độ, top-k và top-p trên một phân phối đuôi dài, và các vấn đề giải mã trong hệ thống thật.
- 28Tham số, FLOP và bộ nhớ của TransformerChương 12 · Học sâuCông thức số tham số, số phép tính và bộ nhớ của Transformer, kiểm chứng khớp tới từng tham số với GPT-2 và Llama 2, và ngân sách huấn luyện Llama 2 7B ước lượng từ C ≈ 6ND.
Chặng 5 · Biểu diễn & Căn chỉnh
Biểu diễn, học chuyển giao và mô hình sinh
Embedding, vì sao tiền huấn luyện hiệu quả, tinh chỉnh và LoRA, VAE, GAN và mô hình khuếch tán.
- 29Tổng quanChương 1 · Biểu diễn & Căn chỉnhBốn nhóm kỹ thuật ra đời riêng rẽ, embedding, học chuyển giao, mô hình sinh và căn chỉnh, xếp thành một chuỗi khi nhìn theo quá trình tạo ra một trợ lý ngôn ngữ; mỗi nhóm trả lời một câu hỏi mà nhóm trước để lại.
- 30Word2VecChương 2 · Biểu diễn & Căn chỉnhĐếm số lần đồng hiện, chuyển sang PMI rồi nén bằng SVD đã cho embedding giải đúng mọi phép loại suy trên một kho ngữ liệu nhân tạo; word2vec làm cùng việc mà không lập ma trận, vì ở điểm tối ưu tích vô hướng của nó bằng PMI dịch đi log k.
- 31Hình học của không gian embeddingChương 3 · Biểu diễn & Căn chỉnhKhi đám mây embedding lệch tâm, hai vector ngẫu nhiên độc lập có cosine trung bình tới 0,87; trừ vector trung bình, làm trắng hoặc học tương phản sửa được hiện tượng này, còn từng chiều riêng lẻ của embedding thường không mang nghĩa.
- 32Embedding theo ngữ cảnh và tìm kiếm vectorChương 4 · Biểu diễn & Căn chỉnhEmbedding tĩnh không phân biệt được các nghĩa của một từ; Transformer gán vector theo ngữ cảnh nhưng cần học tương phản mới cho embedding câu tốt, và tìm kiếm trên hàng triệu vector dựa vào các chỉ mục gần đúng như IVF, HNSW và PQ.
- 33Tiền huấn luyệnChương 5 · Biểu diễn & Căn chỉnhDữ liệu không nhãn rẻ và dồi dào, và việc đoán token tiếp theo buộc mô hình học sự kiện, ngữ pháp, phép tính và cấu trúc mã; mô hình đã tiền huấn luyện được dùng lại theo bốn cách, và có những trường hợp tiền huấn luyện không giúp được.
- 34Đóng băng và tinh chỉnhChương 6 · Biểu diễn & Căn chỉnhMột thí nghiệm có kiểm soát cho thấy với 20 và 50 mẫu ba cách làm không phân biệt được, từ 150 mẫu tinh chỉnh toàn phần dẫn đầu, còn đóng băng chững lại từ 500 mẫu vì đặc trưng cố định đặt ra giới hạn trên.
- 35LoRA và tinh chỉnh tiết kiệm tham sốChương 7 · Biểu diễn & Căn chỉnhTinh chỉnh toàn phần Llama 2 7B cần 96,4 GiB; LoRA chỉ học phần cộng thêm hạng thấp, đưa trạng thái Adam xuống 32 MiB, không làm suy luận nhanh hơn nhưng cho phép một mô hình gốc phục vụ nhiều adapter và kết hợp được với lượng tử hoá trong QLoRA.
- 36Mô hình sinhChương 8 · Biểu diễn & Căn chỉnhHằng số chuẩn hoá làm ước lượng hợp lý cực đại không áp dụng trực tiếp được cho bài toán sinh; mô hình tự hồi quy, VAE, GAN và mô hình khuếch tán là bốn cách tránh nó, với những đánh đổi khác nhau về độ ổn định, độ sắc nét và tốc độ lấy mẫu.
- 37Bộ tự mã hoá biến phânChương 9 · Biểu diễn & Căn chỉnhVAE tối đa chặn dưới ELBO để không gian ẩn có cấu trúc lấy mẫu được; thí nghiệm cho thấy hệ số β quyết định số chiều ẩn còn mang thông tin, từ 6 chiều ở β = 0 tới không chiều nào khi hậu nghiệm sụp, và mẫu mờ là do hàm mất mát bình phương.
- 38Mạng đối sinhChương 10 · Biểu diễn & Căn chỉnhBộ sinh học qua đánh giá của bộ phân biệt; dạng gốc của hàm mất mát có gradient gần 0 đúng lúc bộ sinh còn tệ nên không phủ được cụm nào, dạng không bão hoà phủ đủ 8 cụm, và việc phải tìm điểm cân bằng thay vì cực tiểu làm GAN khó huấn luyện.
- 39Mô hình khuếch tánChương 11 · Biểu diễn & Căn chỉnhQuá trình thuận có dạng đóng, kiểm chứng trên 200 000 quỹ đạo mô phỏng; lịch nhiễu đọc qua tỉ số tín hiệu trên nhiễu, huấn luyện chỉ là hồi quy dự đoán nhiễu, còn lấy mẫu chậm được khắc phục bằng DDIM, chưng cất và khuếch tán trong không gian ẩn.
Chặng 6 · Biểu diễn & Căn chỉnh
Căn chỉnh mô hình
Học tăng cường, gradient chính sách, RLHF và DPO: cách một mô hình ngôn ngữ học làm theo ý người dùng.
- 40Nhập môn học tăng cườngChương 12 · Biểu diễn & Căn chỉnhHọc từ phần thưởng thay vì đáp án đúng: phương trình Bellman, Q-learning, và một thí nghiệm trên lưới 7 × 7 cho thấy khởi tạo lạc quan đủ để khám phá với ε = 0, còn khởi tạo bi quan làm cả ε = 0,3 thất bại.
- 41Gradient chính sáchChương 13 · Biểu diễn & Căn chỉnhThủ thuật log biến gradient của phần thưởng kỳ vọng thành một kỳ vọng ước lượng được bằng lấy mẫu; đường nền không đổi kỳ vọng nhưng giảm độ lệch chuẩn khoảng 2,3 lần, và PPO dùng hàm lợi thế cùng phép cắt tỉ số xác suất.
- 42Học tăng cường từ phản hồi của con ngườiChương 14 · Biểu diễn & Căn chỉnhHọc từ so sánh vượt được giới hạn của học bắt chước vì đánh giá dễ hơn tạo ra; mô hình thưởng Bradley–Terry là hồi quy logistic trên hiệu điểm, và bài toán có ràng buộc KL có nghiệm dạng đóng khớp với nghiệm số tới 10⁻⁷.
- 43Tối ưu trực tiếp theo sở thích (DPO)Chương 15 · Biểu diễn & Căn chỉnhĐảo ngược nghiệm dạng đóng của RLHF làm hằng số chuẩn hoá triệt tiêu, cho một hàm mất mát tính thẳng từ dữ liệu so sánh; DPO trùng RLHF hai bước tới 4,2 × 10⁻⁸ và đơn giản hơn, nhưng RLHF vẫn có lợi khi cần học trên câu trả lời mới sinh.
Chặng 7 · Ứng dụng LLM
Làm việc với mô hình ngôn ngữ
Công việc của kỹ sư AI, token và chi phí, chọn và triển khai mô hình, thiết kế prompt và quản lý ngữ cảnh.
- 44Nghề kỹ sư AIChương 1 · Ứng dụng LLMKỹ sư AI xây sản phẩm trên một mô hình có sẵn thay vì huấn luyện từ đầu, nên công sức chính dời sang việc đo xem hệ thống tốt tới đâu; chương mô tả công việc đó và các thành phần của một ứng dụng dùng LLM.
- 45Mô hình ngôn ngữ lớn nhìn từ phía ứng dụngChương 2 · Ứng dụng LLMNhững đặc điểm của mô hình ảnh hưởng trực tiếp tới thiết kế: token và tokenizer đo trên văn bản tiếng Việt, cửa sổ ngữ cảnh và KV cache, lấy mẫu, các giai đoạn huấn luyện, chi phí, độ trễ và các giới hạn cố hữu.
- 46Chọn và triển khai mô hìnhChương 3 · Ứng dụng LLMPhân loại mô hình, mô hình đóng và mở trọng số, cách tính bộ nhớ GPU khi tự triển khai, cách gọi mô hình qua API, và thứ tự xét các tiêu chí khi chọn mô hình.
- 47Thiết kế promptChương 4 · Ứng dụng LLMViết prompt như viết một bản đặc tả: cấu trúc của prompt, ví dụ trong prompt, chain-of-thought, đầu ra có cấu trúc, function calling, prompt caching và quản lý prompt như mã nguồn.
- 48Quản lý ngữ cảnhChương 5 · Ứng dụng LLMPhần lớn token mô hình nhận được không do người viết prompt viết ra; chương bàn cách chọn những token đó, đo việc mô hình dùng thông tin kém đi khi ngữ cảnh dài, và các kiểu hỏng của ngữ cảnh.
Chặng 8 · Ứng dụng LLM
Truy xuất và RAG
Embedding trong thực tế, cơ sở dữ liệu vector và retrieval-augmented generation, đo trên văn bản tiếng Việt.
- 49Embedding và tìm kiếm ngữ nghĩaChương 6 · Ứng dụng LLMEmbedding văn bản và cách huấn luyện, độ tương đồng, và một thí nghiệm trên văn bản tiếng Việt cho thấy BM25 thắng một mô hình embedding nhỏ, còn kết hợp hai cách tốt nhất ở câu hỏi khó.
- 50Cơ sở dữ liệu vectorChương 7 · Ứng dụng LLMVì sao tìm kiếm chính xác quá chậm với kho lớn, và ba ý tưởng tìm gần đúng là IVF, product quantization và đồ thị HNSW, đo trên cùng một bộ dữ liệu; kèm lọc theo quyền và cập nhật chỉ mục.
- 51Hệ thống RAGChương 8 · Ứng dụng LLMTruy xuất tài liệu rồi đưa vào ngữ cảnh để mô hình trả lời dựa trên đó; thí nghiệm trên 254 câu trắc nghiệm cho thấy ngữ cảnh đúng giúp còn ngữ cảnh sai làm hại, nên phải đo riêng truy xuất và sinh.
Chặng 9 · Ứng dụng LLM
Agent và MCP
Function calling, ReAct, hệ nhiều agent, độ tin cậy của agent, và Model Context Protocol.
- 52AgentChương 9 · Ứng dụng LLMKhi để mô hình tự chọn bước tiếp theo: workflow và agent, function calling, ReAct, hệ nhiều agent, và phép tính cho thấy độ tin cậy giảm theo cấp số nhân với số bước cùng cách khắc phục bằng kiểm tra và thử lại.
- 53Model Context ProtocolChương 10 · Ứng dụng LLMMột giao thức chung để ứng dụng AI kết nối với tool và dữ liệu: kiến trúc host, client, server, các thành phần, thiết kế phi trạng thái của đặc tả 2026-07-28, cách xây server và các rủi ro an toàn.
Chặng 10 · Ứng dụng LLM
An toàn, đánh giá và quan sát
Prompt injection và các rủi ro trong danh sách OWASP, đánh giá có cơ sở thống kê, kiểm thử hồi quy, trace và giám sát.
- 54An toàn và đạo đứcChương 11 · Ứng dụng LLMDanh sách rủi ro của OWASP, thí nghiệm prompt injection gián tiếp cho thấy các cách phòng thủ bằng prompt không đáng tin, phòng thủ bằng kiến trúc, dữ liệu nhạy cảm, thiên kiến và rào chắn.
- 55Đánh giá ứng dụng LLMChương 12 · Ứng dụng LLMBa cách chấm, các thước đo theo nhiệm vụ, cỡ mẫu cần thiết để một kết luận đáng tin, sức mạnh của so sánh ghép cặp bằng kiểm định McNemar, và kiểm thử hồi quy cho mọi thay đổi.
- 56Quan sát và vận hànhChương 13 · Ứng dụng LLMNhững gì cần ghi lại để tái tạo được lỗi, trace và span theo OpenTelemetry, theo dõi chi phí và độ trễ, ước lượng chất lượng khi không có nhãn, và bảo vệ dữ liệu trong log.
Chặng 11 · Ứng dụng LLM
Đa phương thức và công cụ phát triển
Ảnh, video, tiếng nói trong ứng dụng LLM, và các công cụ lập trình có hỗ trợ AI.
- 57Mô hình đa phương thứcChương 14 · Ứng dụng LLMCách mô hình ngôn ngữ đọc ảnh và vì sao số token tăng theo bình phương độ phân giải, video, sinh ảnh, nhận dạng và tổng hợp tiếng nói.
- 58Lập trình với công cụ AIChương 15 · Ứng dụng LLMCác loại công cụ lập trình dựa trên LLM, hai thí nghiệm có đối chứng cho kết quả trái ngược về hiệu quả, và cách dùng an toàn.
Chặng 12 · Quantization
Tối ưu suy luận
Lượng tử hoá: biểu diễn số, suy luận bằng số nguyên, PTQ, QAT, và các phương pháp riêng cho LLM.
- 59Vì sao cần quantizationChương 1 · QuantizationBốn động cơ: bộ nhớ, năng lượng, tốc độ và cái giá phải trả. Vì sao di chuyển dữ liệu đắt hơn tính toán hàng trăm lần.
- 60Máy tính biểu diễn sốChương 2 · QuantizationSố nguyên bù hai, IEEE 754, FP16/BF16/FP8. Khác biệt cốt lõi: độ chính xác tương đối so với tuyệt đối.
- 61Uniform affine quantizationChương 3 · QuantizationSuy ra công thức S và Z từ đầu, ví dụ tính tay đầy đủ, lượng tử đối xứng so với bất đối xứng.
- 62Phân tích sai sốChương 4 · QuantizationMô hình nhiễu đều, quy tắc mỗi bit đáng giá 6 dB, và đánh đổi giữa sai số làm tròn với sai số cắt.
- 63Độ mịn (granularity)Chương 5 · QuantizationPer-tensor, per-channel, per-group. Vì sao scale chỉ được đặt trên trục không bị lấy tổng.
- 64Suy luận bằng số nguyênChương 6 · QuantizationKhai triển phép nhân ma trận đã lượng tử, bias int32, requantization bằng số học dấu chấm tĩnh.
- 65Lượng tử cả một mạngChương 7 · QuantizationLượng tử cái gì, nút fake-quant, gộp BatchNorm vào tích chập và gộp chuỗi lớp.
- 66CalibrationChương 8 · QuantizationNăm cách chọn dải cho activation — min–max, EMA, percentile, MSE, KL — và một thí nghiệm so sánh trung thực.
- 67PTQ và QATChương 9 · QuantizationStraight-Through Estimator, LSQ, so sánh theo độ rộng bit, và nhóm kỹ thuật PTQ nâng cao: CLE, bias correction, AdaRound.
- 68PyTorch và TFLiteChương 10 · QuantizationMã đã chạy thật: eager mode, QAT, PT2E/torchao, LiteRT, và cách đo kích thước – độ trễ – độ chính xác cho đáng tin.
- 69Quantization cho LLMChương 11 · QuantizationOutlier có hệ thống, LLM.int8(), SmoothQuant, GPTQ, AWQ, NF4/QLoRA, FP8 và microscaling, lượng tử KV cache.
- 70Quy trình làm việcChương 12 · QuantizationSơ đồ chọn phương pháp, phân tích độ nhạy theo lớp, và danh sách kiểm tra tám mục trước khi triển khai.
- 71Những hiểu lầm thường gặpChương 13 · QuantizationChín phát biểu nghe rất hợp lý nhưng sai, kèm đính chính có dẫn chứng từ chính các thí nghiệm trong tài liệu.
Chặng 13 · MLOps
Vận hành hệ thống học máy
Dữ liệu, kiểm thử, phục vụ, ra mắt, giám sát, dịch chuyển phân phối, huấn luyện lại và LLMOps.
- 72Nợ kỹ thuật trong hệ thống học máyChương 1 · MLOpsVì sao hệ thống học máy hỏng theo cách khó thấy và khó bảo trì hơn phần mềm thông thường, giải thích qua khái niệm nợ kỹ thuật của Sculley và cộng sự.
- 73Vòng đời của hệ thống học máyChương 2 · MLOpsMột hệ thống học máy đi qua những giai đoạn nào, những người vận hành nó đánh giá thành công ra sao, và quy trình được tự động hoá tới mức nào.
- 74Dữ liệuChương 3 · MLOpsVì sao dữ liệu là nguồn sự cố phổ biến nhất, cách phân loại lỗi dữ liệu và biến các giả định về dữ liệu thành phép kiểm tra tự động.
- 75Đặc trưngChương 4 · MLOpsHai lỗi khó phát hiện nhất của học máy, lệch giữa huấn luyện và phục vụ và rò rỉ thông tin từ tương lai, cùng cách kho đặc trưng hỗ trợ phòng tránh chúng.
- 76Tính lặp lại của thí nghiệmChương 5 · MLOpsLàm thế nào để huấn luyện lại đúng một mô hình khi cần điều tra sự cố, và cách ghi lại thí nghiệm cùng các mô hình được đưa vào sử dụng.
- 77Đánh giá mô hình trước khi triển khaiChương 6 · MLOpsVì sao một chỉ số trên tập kiểm tra không đủ để quyết định triển khai, và các cách đánh giá bổ sung: theo lát cắt, kiểm thử hành vi, bộ tiêu chí ML Test Score.
- 78Phục vụ mô hìnhChương 7 · MLOpsCác cách đưa mô hình vào phục vụ, ngân sách độ trễ, và vì sao phần đuôi của phân phối độ trễ chi phối thời gian trả lời khi gọi nhiều dịch vụ.
- 79Triển khai mô hình mớiChương 8 · MLOpsĐưa một mô hình mới tới người dùng từng bước, và cách biết chắc nó tốt hơn mô hình cũ bằng A/B test.
- 80Dịch chuyển phân phốiChương 9 · MLOpsDữ liệu thay đổi theo thời gian theo những cách nào, cách nào phát hiện được khi chưa có nhãn, và vì sao không nên dùng thẳng ngưỡng PSI quen thuộc.
- 81Giám sátChương 10 · MLOpsTheo dõi một hệ thống học máy đang chạy: chỉ số nào cần đo, đo ở lớp nào khi nhãn đến chậm, và thiết kế cảnh báo sao cho người nhận còn tin vào nó.
- 82Huấn luyện lạiChương 11 · MLOpsMô hình cũ đi nhanh tới mức nào, khi nào nên huấn luyện lại, và làm sao để việc tự động hoá huấn luyện lại không tạo ra sự cố mới.
- 83Vòng phản hồiChương 12 · MLOpsKhi dự đoán của mô hình quyết định dữ liệu huấn luyện của chính nó: cơ chế, mức thiệt hại đo bằng mô phỏng, và cách phát hiện, khắc phục.
- 84Vận hành ứng dụng dùng mô hình ngôn ngữ lớnChương 13 · MLOpsNhững gì thay đổi khi hệ thống dùng mô hình ngôn ngữ lớn: đánh giá bằng giám khảo LLM, hệ thống RAG, chi phí theo token, rào chắn và quản lý phiên bản.
Đối chiếu với roadmap AI Engineer
Mỗi chủ đề lớn của roadmap và nơi nó được trình bày trong lộ trình.
| Chủ đề trên roadmap | Nội dung | Ở đâu |
|---|---|---|
| Introduction | Kỹ sư AI là gì, vai trò, AI Engineer và ML Engineer, thuật ngữ chung | Chương 1 Ứng dụng LLM |
| How LLMs Work | Token, cửa sổ ngữ cảnh, tham số lấy mẫu, huấn luyện và suy luận | Chương 2 Ứng dụng LLMChương 9 Học sâuChương 11 Học sâuChương 12 Học sâu |
| Prompt Engineering | Cấu trúc prompt, zero-shot, few-shot, chain-of-thought, đầu ra có cấu trúc, prompt caching | Chương 4 Ứng dụng LLM |
| Context Engineering | Nguồn ngữ cảnh, ngân sách token, bộ nhớ, cô lập ngữ cảnh, các kiểu hỏng | Chương 5 Ứng dụng LLM |
| Type of Models | Mô hình gốc, chỉ dẫn, suy luận; đóng và mở trọng số; tự triển khai | Mục 3.1 Ứng dụng LLMMục 3.2 Ứng dụng LLMMục 3.3 Ứng dụng LLM |
| Hugging Face | Hub, model card, Tasks, Transformers, Transformers.js | Mục 3.4 Ứng dụng LLM |
| Choosing the Right Model | Ràng buộc, chất lượng trên dữ liệu của mình, độ trễ, chi phí, định tuyến | Mục 3.6 Ứng dụng LLM |
| Ollama, LM Studio, OpenRouter | Chạy mô hình cục bộ, API tương thích OpenAI, dịch vụ trung gian | Mục 3.3 Ứng dụng LLMMục 3.5 Ứng dụng LLM |
| Fine-tuning | Đóng băng hay tinh chỉnh, LoRA và các phương pháp tiết kiệm tham số | Chương 6 Biểu diễn & Căn chỉnhChương 7 Biểu diễn & Căn chỉnh |
| What are Embeddings | Embedding từ, embedding theo ngữ cảnh, embedding văn bản cho tìm kiếm | Chương 2 Biểu diễn & Căn chỉnhChương 4 Biểu diễn & Căn chỉnhChương 6 Ứng dụng LLM |
| Embedding Models | Chọn mô hình embedding, số chiều, độ dài tối đa, tiền tố, MTEB | Mục 6.2 Ứng dụng LLM |
| Vector Databases | IVF, product quantization, HNSW, lọc theo metadata, chọn công cụ | Chương 7 Ứng dụng LLM |
| What are RAGs? | Quy trình RAG, chia đoạn, tìm kiếm kết hợp, xếp lại, đánh giá RAG | Chương 8 Ứng dụng LLM |
| AI Agents | Workflow và agent, function calling, ReAct, hệ nhiều agent, độ tin cậy | Chương 9 Ứng dụng LLM |
| Model Context Protocol (MCP) | Host, client, server; tools, resources, prompts; truyền tải; an toàn | Chương 10 Ứng dụng LLM |
| AI Safety and Ethics | Prompt injection, dữ liệu nhạy cảm, thiên kiến và công bằng, rào chắn | Chương 11 Ứng dụng LLM |
| LLM Observability | Trace, span, chi phí và độ trễ, giám sát trong sản xuất | Chương 13 Ứng dụng LLMChương 13 MLOps |
| LLM Evaluations | Đánh giá tất định, dựa trên mô hình, bởi con người; cỡ mẫu và so sánh ghép cặp | Chương 12 Ứng dụng LLMChương 13 MLOps |
| Regression Testing | Bộ vàng, cửa kiểm tra trong CI, đổi phiên bản mô hình | Mục 12.5 Ứng dụng LLM |
| Multimodal AI | Hiểu ảnh, sinh ảnh, video, nhận dạng và tổng hợp tiếng nói | Chương 14 Ứng dụng LLMChương 11 Biểu diễn & Căn chỉnh |
| Development Tools | Lập trình với công cụ AI và cách dùng an toàn | Chương 15 Ứng dụng LLM |
Tra cứu trong từng giáo trình
Ký hiệu, bài tập, câu hỏi phỏng vấn, tài liệu tham khảo và phụ lục.
Nền tảng
Học sâu
Biểu diễn & Căn chỉnh
Ứng dụng LLM