1Nợ kỹ thuật trong hệ thống học máy#
1.1Đặt vấn đề#
Ở các giáo trình trước, mỗi bài toán khép lại khi mô hình đạt kết quả tốt trên tập kiểm tra. Trong một sản phẩm thật, đó mới là điểm bắt đầu. Mô hình được đặt vào một hệ thống lớn hơn: nó nhận dữ liệu từ các hệ thống khác, trả kết quả cho người dùng hoặc cho các dịch vụ khác, và phải tiếp tục làm việc đúng trong nhiều tháng, nhiều năm, trong khi mọi thứ xung quanh nó thay đổi.
Hãy hình dung một mô hình phát hiện gian lận đạt AUC 0,94 trên tập kiểm tra. Sáu tháng sau khi triển khai, dịch vụ vẫn chạy bình thường: không có lỗi nào trong log, độ trễ ổn định, không ai phàn nàn. Nhưng số tiền thiệt hại do gian lận tăng dần, và khi kiểm tra lại, độ chính xác của mô hình trên dữ liệu mới thấp hơn nhiều so với lúc đánh giá. Không ai sửa dòng mã nào; thứ đã thay đổi là dữ liệu đi vào mô hình.
Với phần mềm thông thường, sự cố thường lộ ra ngay. Một hàm nhận sai kiểu dữ liệu sẽ báo lỗi, và hệ thống giám sát phát hiện được lỗi đó. Mô hình học máy thì khác: khi đầu vào thay đổi, nó vẫn trả về một con số trong khoảng , đúng định dạng, đúng thời hạn, chỉ có điều con số ấy sai. Các cơ chế kiểm tra của phần mềm thông thường không được thiết kế để nhận ra loại lỗi này. Vì vậy vận hành một hệ thống học máy cần thêm những kỹ thuật riêng, và tập hợp các kỹ thuật đó được gọi là MLOps. Để hiểu vì sao cần chúng, ta bắt đầu từ một câu hỏi rộng hơn: vì sao hệ thống học máy khó bảo trì hơn phần mềm thông thường.
1.2Khái niệm nợ kỹ thuật#
Câu trả lời được biết đến nhiều nhất là bài báo Hidden Technical Debt in Machine Learning Systems của Sculley và cộng sự (2015), một nhóm kỹ sư ở Google. Nhận xét chính của bài báo là: xây dựng và triển khai một hệ thống học máy tương đối nhanh và rẻ, nhưng duy trì nó theo thời gian thì khó và tốn kém.
Để diễn đạt điều này, các tác giả mượn khái niệm nợ kỹ thuật (technical debt) mà Ward Cunningham đưa ra từ đầu những năm 1990. Khi một nhóm phát triển chọn cách làm nhanh thay vì cách làm kỹ, họ giống như vay nợ: được lợi ngay, nhưng sau này phải trả lãi dưới dạng thời gian sửa lỗi và thời gian thay đổi hệ thống. Vay nợ không phải lúc nào cũng sai, miễn là biết mình đang nợ và có kế hoạch trả. Điểm riêng của hệ thống học máy, theo Sculley và cộng sự, là phần lớn khoản nợ nằm ở mức hệ thống chứ không nằm trong mã nguồn. Đọc mã không thấy được chúng, nên lãi cứ tích luỹ mà không ai nhận ra.
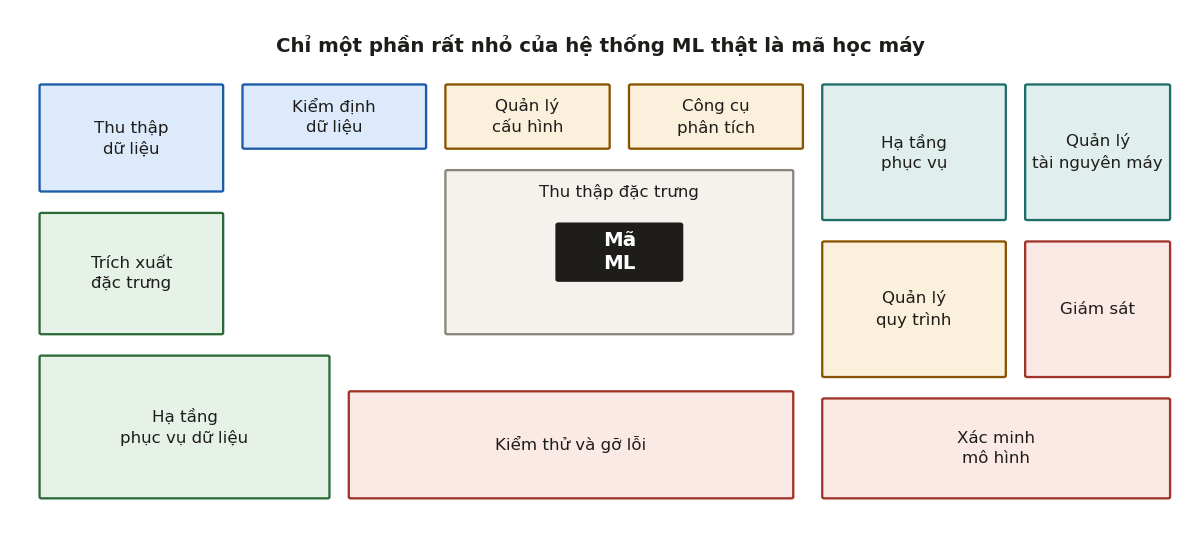
Hình 1 tóm tắt quan điểm đó. Khi học, ta dành gần hết thời gian cho ô ở giữa: chọn mô hình, chọn hàm mất mát, tinh chỉnh siêu tham số. Trong một hệ thống thật, ô đó được bao quanh bởi rất nhiều thành phần khác, và phần lớn sự cố xảy ra ở các thành phần ấy hoặc ở chỗ chúng tiếp xúc với mô hình.
1.3Nguyên lý CACE#
Nguồn nợ đầu tiên mà bài báo chỉ ra nằm ngay trong bản chất của mô hình học máy.
Định nghĩa 1.1 (CACE)
Nguyên lý CACE (Changing Anything Changes Everything) phát biểu rằng trong một hệ thống học máy, thay đổi bất kỳ thành phần nào cũng có thể thay đổi hành vi của toàn bộ hệ thống.
Để thấy vì sao, xét một mô hình hồi quy tuyến tính dự đoán giá nhà từ diện tích và số phòng. Hai đặc trưng này tương quan với nhau, nên trọng số mà mô hình học được cho diện tích phụ thuộc vào việc số phòng có mặt trong mô hình hay không: có số phòng, một phần thông tin về độ lớn của căn nhà đã nằm ở đó và trọng số của diện tích nhỏ đi; bỏ số phòng, trọng số của diện tích phải gánh cả phần ấy. Như vậy thêm hoặc bớt một đặc trưng làm thay đổi trọng số của mọi đặc trưng còn lại, chứ không chỉ thêm hoặc bớt một thành phần. Bài báo nhấn mạnh rằng điều này đúng cho mọi thứ điều chỉnh được: siêu tham số, cách lấy mẫu dữ liệu, ngưỡng hội tụ của thuật toán tối ưu.
Hệ quả là trong học máy không có thay đổi nào thật sự nhỏ và cô lập. Một kỹ sư phần mềm có thể sửa một hàm mà không cần kiểm tra lại toàn bộ chương trình, vì các hàm khác chỉ phụ thuộc vào giao diện của nó. Với một mô hình, mọi thay đổi đều cần được đánh giá lại trên toàn bộ dữ liệu. Mục 6.3 sẽ cho một ví dụ đo được: thêm một đặc trưng làm độ chính xác tổng thể tăng gần 20 điểm phần trăm, nhưng lại làm một nhóm người dùng giảm gần 12 điểm. Bài báo đề xuất một cách giảm nhẹ là tách bài toán thành các bài toán con độc lập, mỗi bài toán một mô hình riêng; cách này chỉ dùng được khi các bài toán con thật sự tách rời nhau.
1.4Các dạng nợ kỹ thuật#
Ngoài CACE, Sculley và cộng sự đặt tên cho nhiều dạng nợ khác. Có thể chia chúng thành ba nhóm theo nơi phát sinh. Riêng vòng phản hồi, một dạng nợ quan trọng mà bài báo cũng nêu, được dành hẳn Chương 12.
Nợ do mô hình làm mờ ranh giới giữa các thành phần. Trong phần mềm thông thường, các thành phần giao tiếp qua những giao diện rõ ràng. Mô hình học máy làm mờ các ranh giới này theo nhiều cách. Ngoài sự rối giữa các đặc trưng mà CACE mô tả (entanglement), còn có hiện tượng thác hiệu chỉnh (correction cascade): đã có mô hình cho bài toán A, giờ cần giải bài toán A' gần giống, và cách nhanh nhất là học một mô hình nhỏ nhận đầu ra của rồi hiệu chỉnh thêm. Cách này nhanh, nhưng mô hình mới phụ thuộc vào , và từ đó việc cải thiện trở nên rất tốn kém vì có thể làm hỏng mô hình phía sau. Một dạng khác là bên sử dụng không khai báo (undeclared consumer): đầu ra của mô hình được ghi ra một nơi không có kiểm soát truy cập, và một hệ thống khác lặng lẽ dùng nó làm đầu vào. Khi mô hình thay đổi, hệ thống kia hỏng theo mà không ai biết nguyên nhân, và hai hệ thống có thể tạo thành một vòng phản hồi ẩn (Chương 12).
Nợ do phụ thuộc vào dữ liệu. Phụ thuộc giữa các đoạn mã có thể được trình biên dịch và các công cụ phân tích tĩnh phát hiện. Phụ thuộc vào dữ liệu thì không có công cụ tương đương, nên rất dễ tích tụ những chuỗi phụ thuộc mà không ai nắm hết. Bài báo nêu hai loại. Loại thứ nhất là phụ thuộc dữ liệu không ổn định (unstable data dependency): một đặc trưng được lấy từ hệ thống khác, và hệ thống đó thay đổi hành vi theo thời gian, chẳng hạn vì bản thân nó cũng là một mô hình được huấn luyện lại định kỳ. Cách xử lý là cố định phiên bản của tín hiệu đầu vào, với cái giá là phải duy trì nhiều phiên bản song song. Loại thứ hai là phụ thuộc dữ liệu ít giá trị (underutilized data dependency): những đặc trưng đóng góp rất ít nhưng vẫn nằm trong mô hình, làm hệ thống dễ hỏng một cách không cần thiết. Chúng thường là đặc trưng cũ đã bị đặc trưng mới thay thế nhưng không ai gỡ, đặc trưng được thêm cả gói vì áp lực thời hạn, đặc trưng chỉ cải thiện độ chính xác rất ít nhưng làm hệ thống phức tạp hơn nhiều, hoặc đặc trưng tương quan mạnh với một đặc trưng khác có quan hệ nhân quả thật. Để phát hiện chúng, bài báo đề xuất định kỳ đánh giá lại mô hình khi bỏ ra từng đặc trưng một (leave-one-feature-out).
Nợ trong kiến trúc, cấu hình và quy trình. Nhóm cuối cùng gần với nợ kỹ thuật của phần mềm thông thường nhất. Mã keo (glue code) là phần mã nối các thư viện đa dụng lại với nhau; Mục 1.5 sẽ quay lại với nó. Pipeline jungle là trường hợp riêng của mã keo ở khâu chuẩn bị dữ liệu: các bước lấy, ghép, lấy mẫu dữ liệu chồng chất qua thời gian, sinh ra nhiều tệp trung gian mà không ai còn nhớ hết mục đích. Các nhánh mã để thử nghiệm còn nằm lại trong mã sản xuất (dead experimental codepaths) làm tăng số trạng thái hệ thống có thể rơi vào. Cấu hình của một hệ thống lớn có thể gồm hàng nghìn dòng và thường ít được kiểm tra kỹ như mã, dù một dòng cấu hình sai gây hại không kém một dòng mã sai (configuration debt). Khó chạy lại một thí nghiệm và nhận được cùng kết quả là một dạng nợ riêng (reproducibility debt, Chương 5). Cuối cùng là nợ về văn hoá làm việc: khi nhóm nghiên cứu và nhóm kỹ thuật tách biệt, hoặc khi chỉ việc tăng độ chính xác được ghi nhận còn việc gỡ bớt đặc trưng, đơn giản hoá hệ thống, cải thiện giám sát thì không.
Bài báo còn nhắc tới vài dấu hiệu trong mã cho thấy hệ thống đang tích nợ. Một là dùng kiểu dữ liệu nguyên thuỷ như số thực cho những đại lượng giàu ý nghĩa, khiến không biết một tham số là log-odds hay là ngưỡng quyết định. Hai là dùng nhiều ngôn ngữ lập trình trong cùng một hệ thống, làm việc kiểm thử và bàn giao khó hơn. Ba là thường xuyên phải thử ý tưởng trên một bản nguyên mẫu thay vì trên hệ thống thật, dấu hiệu cho thấy hệ thống thật khó thay đổi.
1.5Tỉ lệ mã học máy trong hệ thống#
Từ bài báo này có một con số rất hay được trích dẫn: trong một hệ thống học máy, mã học máy chỉ chiếm 5%, còn 95% là mã keo. Con số này thường bị hiểu sai ở ba điểm.
Thứ nhất, nó nằm trong mục bàn về mã keo của bài báo, nói về những hệ thống tái sử dụng các thư viện học máy đa dụng, chứ không phải chú thích của hình vẽ nổi tiếng (Hình 1). Thứ hai, bài báo diễn đạt có giới hạn: một hệ thống trưởng thành có thể chỉ gồm nhiều nhất 5% mã học máy và ít nhất 95% mã keo. Đây là một nhận định định tính kèm độ lớn, không phải kết quả đo trên một tập hệ thống cụ thể. Thứ ba, ít người nhắc tới kết luận mà bài báo rút ra từ đó: vì tỉ lệ này, đôi khi tự viết một giải pháp gọn còn rẻ hơn dùng lại một thư viện đa dụng, và cách hạn chế mã keo là bọc các thư viện sau một giao diện chung của hệ thống.
1.6Tóm tắt#
Hệ thống học máy hỏng theo cách khó thấy hơn phần mềm thông thường, vì mô hình vẫn trả về kết quả hợp lệ khi đầu vào đã thay đổi. Sculley và cộng sự mô tả nguồn gốc của các sự cố đó bằng khái niệm nợ kỹ thuật: nguyên lý CACE khiến mọi thay đổi đều phải đánh giá lại toàn bộ, phụ thuộc vào dữ liệu khó kiểm soát hơn phụ thuộc vào mã, và phần lớn hệ thống là mã keo bao quanh một mô hình nhỏ.
Quay lại mô hình phát hiện gian lận ở Mục 1.1, ta đã có tên cho những nguyên nhân có thể khiến nó suy giảm. Một hệ thống phía trước đổi đơn vị tiền từ đồng sang nghìn đồng mà không báo trước là phụ thuộc dữ liệu không ổn định (Chương 3, Mục 10.4). Một đặc trưng được tính khác nhau lúc huấn luyện và lúc phục vụ là lệch huấn luyện–phục vụ (Chương 4). Phân phối dữ liệu thay đổi mà không ai đo là dịch chuyển phân phối (Chương 9). Một ngưỡng quyết định đặt bằng tay từ năm trước vẫn được dùng sau khi mô hình đã huấn luyện lại là ngưỡng cố định trong hệ thống thay đổi (Mục 10.6). Và mô hình làm sai lệch dữ liệu huấn luyện của chính nó là vòng phản hồi (Chương 12). Các chương sau lần lượt trình bày cách phát hiện và hạn chế từng nguyên nhân. Trước hết, Chương 2 nhìn toàn cảnh: một hệ thống học máy đi qua những giai đoạn nào, và mức độ tự động hoá của nó được đánh giá ra sao.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Nguyên lý CACE phát biểu điều gì?
Vì sao: Changing Anything Changes Everything (Sculley và cộng sự, 2015). Thêm hay bớt một đặc trưng làm trọng số của mọi đặc trưng khác thay đổi; nguyên lý áp dụng cả cho siêu tham số, cách lấy mẫu và ngưỡng hội tụ. Vì vậy không có thay đổi nào là nhỏ và cô lập trong một mô hình.2Nhận định "5% mã học máy, 95% mã keo" nói về điều gì?
Vì sao: Bài báo diễn đạt có giới hạn: nhiều nhất 5% mã học máy và ít nhất 95% mã keo; đây là nhận định định tính. Kết luận đi kèm: đôi khi tự viết một giải pháp gọn còn rẻ hơn dùng lại thư viện đa dụng, và nên bọc các thư viện sau một giao diện chung.3Correction cascade là gì?
Vì sao: Cách này nhanh trước mắt nhưng tạo ra phụ thuộc mới vào mô hình gốc, khiến việc cải thiện mô hình gốc trở nên tốn kém vì có thể làm hỏng mô hình phía sau.4Trường hợp nào không thuộc nhóm phụ thuộc dữ liệu ít giá trị (underutilized data dependency)?
Vì sao: Ba trường hợp đầu là phụ thuộc dữ liệu ít giá trị; trường hợp cuối là phụ thuộc dữ liệu không ổn định, một dạng nợ khác. Cách phát hiện phụ thuộc ít giá trị mà bài báo đề xuất là định kỳ đánh giá lại mô hình khi bỏ từng đặc trưng.5Vì sao lỗi của hệ thống học máy thường khó phát hiện hơn lỗi của phần mềm thông thường?
Đã trả lời 0/5