2Mô hình ngôn ngữ lớn nhìn từ phía ứng dụng#
Một nhóm phát triển xây xong trợ lý bằng tiếng Anh, chạy ổn, rồi chuyển sang phục vụ người dùng Việt Nam. Hoá đơn API tăng lên mấy lần dù số câu hỏi không đổi, một số câu trả lời bị cắt ngang giữa chừng, và mô hình đếm sai số chữ cái trong một từ đơn giản. Ba hiện tượng tưởng không liên quan này có chung một nguyên nhân: cách mô hình đọc văn bản.
Ở Chương 1, mô hình được coi như một hộp đen nhận văn bản và trả lại văn bản. Để thiết kế phần bao quanh cho đúng, ta cần mở hộp đó ra một chút. Không cần tới mức kiến trúc Transformer, vốn đã có ở giáo trình Học sâu, mà chỉ tới những đặc điểm ảnh hưởng trực tiếp tới ứng dụng, bắt đầu từ đơn vị nhỏ nhất mà mô hình nhìn thấy.
2.1Token và tokenizer#
Mô hình ngôn ngữ không đọc chữ cái hay từ. Đơn vị nó đọc là token, những mảnh văn bản lấy từ một từ vựng cố định, thường có từ vài chục nghìn tới vài trăm nghìn phần tử. Thành phần cắt văn bản thành dãy token và ánh xạ mỗi token thành một số nguyên gọi là tokenizer. Mọi giới hạn và chi phí của LLM đều tính theo token: độ dài tối đa của ngữ cảnh, giá mỗi lần gọi, tốc độ sinh.
Phần lớn tokenizer hiện nay dùng thuật toán byte-pair encoding (BPE) hoặc một biến thể của nó. BPE bắt đầu từ các ký tự hoặc các byte, rồi lặp lại một việc duy nhất: tìm cặp đơn vị đứng cạnh nhau nhiều nhất trong dữ liệu huấn luyện và gộp chúng thành một đơn vị mới, cho tới khi từ vựng đạt kích thước định trước. Chuỗi nào xuất hiện thường xuyên trong dữ liệu huấn luyện tokenizer sẽ trở thành một token duy nhất, còn chuỗi hiếm bị cắt thành nhiều mảnh.
Một kho rất nhỏ cho thấy thuật toán chạy ra sao. Giả sử dữ liệu chỉ có ba từ: "con" xuất hiện 4 lần, "cong" 3 lần, "ong" 2 lần, và từ vựng ban đầu là bốn chữ cái c, o, n, g. Cặp đứng cạnh nhau nhiều nhất là (o, n), xuất hiện lần, nên lần gộp đầu tạo token "on". Sau đó cặp (c, on) xuất hiện 7 lần, nhiều hơn (on, g) với 5 lần, nên lần gộp thứ hai tạo "con". Lần gộp thứ ba tạo "cong" từ cặp (con, g), xuất hiện 3 lần. Sau ba lần gộp, "con" và "cong" mỗi từ là một token, còn "ong", từ hiếm nhất, vẫn bị cắt thành hai token "on" và "g".
Từ cách xây như vậy có thể đoán rằng số token của cùng một nội dung phụ thuộc vào ngôn ngữ, và phụ thuộc vào dữ liệu đã dùng để huấn luyện tokenizer. Thí nghiệm trong code/ungdung/experiments.py kiểm tra điều này trên một văn bản song ngữ: bản tiếng Anh và bản tiếng Việt của Tuyên ngôn Quốc tế Nhân quyền, từ lời nói đầu tới hết Điều 20.
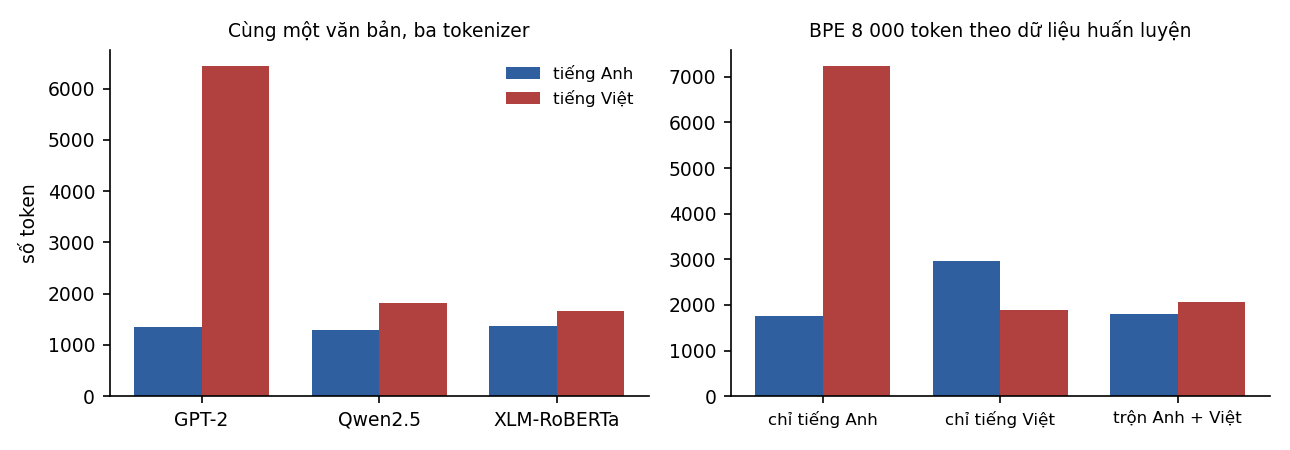
| Tokenizer | Kích thước từ vựng | Token (Anh) | Token (Việt) | Việt / Anh | Token mỗi từ (Việt) |
|---|---|---|---|---|---|
| GPT-2 | 50 257 | 1 342 | 6 437 | 4,80 | 4,27 |
| Qwen2.5 | 151 665 | 1 298 | 1 814 | 1,40 | 1,20 |
| XLM-RoBERTa | 250 002 | 1 370 | 1 652 | 1,21 | 1,10 |
Tokenizer của GPT-2 (2019) được huấn luyện gần như chỉ trên văn bản tiếng Anh, nên bản tiếng Việt tốn gấp 4,8 lần số token của bản tiếng Anh cùng nội dung, trung bình hơn 4 token cho mỗi từ. Tokenizer của Qwen2.5 và XLM-RoBERTa được huấn luyện trên dữ liệu nhiều ngôn ngữ, và tỉ lệ đó giảm còn 1,4 và 1,2 lần. Để thấy cơ chế, ta xem ba tokenizer cắt câu "Mô hình ngôn ngữ lớn dự đoán token tiếp theo." (10 từ) như thế nào:
GPT-2        36 token: M | ô | ·h | � | � | n | h | ·ng | ô | n | ·ng | � | � | � | ...
Qwen2.5      13 token: M | ô | ·hình | ·ngôn | ·ngữ | ·lớn | ·dự | ·đoán | ·token | ·tiếp | ·the | o | .
XLM-RoBERTa  12 token: Mô | hình | ngôn | ngữ | lớn | dự | đoán | to | ken | tiếp | theo | .
Mỗi ký tự có dấu của tiếng Việt chiếm 2 tới 3 byte trong UTF-8. Tokenizer của GPT-2 hiếm khi gặp các ký tự này lúc huấn luyện, nên cắt chúng thành từng byte riêng lẻ; mỗi ô � là một byte không tự tạo thành ký tự hoàn chỉnh. Tokenizer của Qwen2.5 thì đã có sẵn token cho phần lớn âm tiết tiếng Việt thông dụng.
Bảng trên còn lẫn hai yếu tố, vì ba tokenizer khác nhau cả về dữ liệu huấn luyện lẫn kích thước từ vựng. Để tách riêng ảnh hưởng của dữ liệu, thí nghiệm thứ hai huấn luyện ba tokenizer BPE cùng kích thước từ vựng 8 000 token trên ba bộ dữ liệu: bốn cuốn tiểu thuyết tiếng Anh trong kho gutenberg của NLTK (418 nghìn từ), kho văn bản tiếng Việt lấy từ các giáo trình của lộ trình (87 nghìn từ, xem Mục 6.5), và hai bộ đó trộn lại. Sau đó ta đếm số token của cùng văn bản Tuyên ngôn như trên.
| Dữ liệu huấn luyện tokenizer | Token (Anh) | Token (Việt) | Việt / Anh |
|---|---|---|---|
| chỉ tiếng Anh | 1 750 | 7 230 | 4,13 |
| chỉ tiếng Việt | 2 969 | 1 893 | 0,64 |
| trộn Anh và Việt | 1 797 | 2 057 | 1,14 |
Cùng thuật toán, cùng kích thước từ vựng, tỉ lệ Việt/Anh đổi từ 4,13 sang 0,64 chỉ vì dữ liệu huấn luyện, dù dữ liệu tiếng Việt ít hơn dữ liệu tiếng Anh gần năm lần. Tokenizer trộn hai ngôn ngữ phải chia từ vựng cho cả hai, nên mỗi ngôn ngữ tốn hơn một chút so với tokenizer chuyên cho ngôn ngữ đó.
Với ứng dụng tiếng Việt, kết quả này quy thẳng ra tiền. Cùng một nội dung, chi phí, độ trễ và lượng thông tin chứa vừa cửa sổ ngữ cảnh đều phụ thuộc vào tokenizer của mô hình. Kho văn bản tiếng Việt ở trên (332 mục của năm giáo trình, khoảng 87 nghìn từ) tốn 345 745 token với tokenizer của GPT-2, gần 4 token mỗi từ, nhưng chỉ khoảng 146 nghìn token với Qwen2.5 hoặc XLM-RoBERTa, khoảng 1,7 token mỗi từ. Khi so chi phí giữa các mô hình cho một ứng dụng tiếng Việt, cần đếm token trên văn bản tiếng Việt thật bằng đúng tokenizer của từng mô hình, chứ không dùng những quy tắc ước lượng rút ra từ tiếng Anh như "một token khoảng bốn ký tự".
Tokenizer còn giải thích một số hành vi trông rất lạ của mô hình. Khi cả một từ là một token, mô hình không nhìn thấy từng chữ cái của từ đó, nên những việc như đếm số chữ cái hay đảo ngược một chuỗi ký tự thường sai. Một con số dài bị cắt thành nhiều token theo những ranh giới không trùng với hàng đơn vị, hàng chục, hàng trăm, và đó là một phần lý do mô hình tính nhẩm kém. Khoảng trắng và chữ hoa cũng làm thay đổi cách cắt, nên hai prompt chỉ khác nhau một dấu cách có thể cho kết quả khác nhau.
2.2Cửa sổ ngữ cảnh#
Cửa sổ ngữ cảnh (context window) là số token tối đa mô hình xử lý được trong một lần gọi, tính cả đầu vào lẫn đầu ra. Ngoài kiến thức đã nằm sẵn trong tham số, mọi thứ mô hình biết trong một lần gọi đều phải nằm trong cửa sổ này: chỉ dẫn hệ thống, lịch sử hội thoại, tài liệu, kết quả tool và câu hỏi. Giữa hai lần gọi, mô hình không giữ lại gì. Ứng dụng muốn mô hình nhớ điều gì thì phải tự đưa điều đó trở lại vào ngữ cảnh.
Cửa sổ ngữ cảnh đã lớn lên rất nhanh, từ 2 048 token của GPT-3 (2020) tới hàng trăm nghìn token, có mô hình tới hàng triệu. Nhưng lấp đầy cửa sổ không miễn phí, vì hai lý do.
Lý do thứ nhất là bộ nhớ và tính toán. Trong Transformer, mỗi token phải lưu vector key và value của nó ở mọi lớp để các token sau tham chiếu tới; vùng nhớ này gọi là KV cache (Mục 12.5 của Học sâu). Lấy cấu hình công bố của Llama 3 8B, gồm 32 lớp, 8 đầu key/value, mỗi đầu 128 chiều, lưu bằng số 16 bit, ta có
Nhân với độ dài ngữ cảnh, ta được dung lượng KV cache cho một chuỗi:
| Độ dài ngữ cảnh | KV cache cho một chuỗi |
|---|---|
| 2 048 token | 0,25 GiB |
| 8 192 token | 1 GiB |
| 32 768 token | 4 GiB |
| 131 072 token | 16 GiB |
Ở 128 nghìn token, KV cache của một chuỗi đã chiếm khoảng 16 GiB, xấp xỉ dung lượng trọng số của chính mô hình (8 tỉ tham số × 2 byte ≈ 16 GB). Phục vụ hai chuỗi như vậy cùng lúc thì KV cache đã lớn gấp đôi trọng số. Llama 3 8B dùng grouped-query attention, trong đó 32 đầu query dùng chung 8 đầu key/value; nếu mỗi đầu query có key/value riêng, tức 32 đầu key/value thay vì 8, mọi con số trong bảng lớn gấp 4 lần. Vì vậy nhà cung cấp tính tiền theo số token đầu vào, và ngữ cảnh dài làm tăng độ trễ. Công cụ KV cache ở trang Phòng thí nghiệm tính các con số này cho những mô hình và độ dài ngữ cảnh khác.
Lý do thứ hai là chất lượng. Mô hình nhận được một triệu token không có nghĩa là nó dùng tốt mọi thông tin trong một triệu token đó. Nhiều nghiên cứu cho thấy khả năng tìm và dùng một thông tin giảm khi ngữ cảnh dài ra, và phụ thuộc vào vị trí của thông tin trong ngữ cảnh. Mục 5.3 trở lại hiện tượng này với một thí nghiệm đo được.
2.3Sinh văn bản và các tham số lấy mẫu#
LLM sinh văn bản từng token một. Ở mỗi bước, mô hình tính một phân phối xác suất trên toàn bộ từ vựng cho token tiếp theo, , rồi một chiến lược giải mã chọn một token từ phân phối đó. Token được chọn được nối vào chuỗi, và quá trình lặp lại cho tới khi gặp token kết thúc hoặc chạm giới hạn độ dài. Chương 11 của Học sâu trình bày chi tiết các chiến lược giải mã và đo tác động của chúng; ở đây ta chỉ cần hiểu những tham số mà API thường cho phép chỉnh.
Tham số quen thuộc nhất là nhiệt độ (temperature) . Trước khi tính softmax, các logit được chia cho : . Với , phân phối nhọn hơn và mô hình chọn các token có xác suất cao thường xuyên hơn; với , phân phối phẳng hơn, kết quả đa dạng hơn và cũng dễ sai hơn. thường được hiểu là luôn chọn token có xác suất cao nhất, tức giải mã tham lam.
Hai tham số tiếp theo cắt bỏ phần đuôi của phân phối thay vì làm nó nhọn lên. Top-k chỉ giữ token có xác suất cao nhất rồi chuẩn hoá lại. Top-p (nucleus sampling) giữ tập token nhỏ nhất có tổng xác suất vượt . Khác với top-k, số token được giữ ở top-p thay đổi theo độ tự tin của mô hình ở từng bước: ít token khi mô hình chắc chắn, nhiều token khi nó phân vân. Ngoài ra còn các loại phạt lặp lại (repetition penalty, frequency penalty, presence penalty), giảm xác suất của những token đã xuất hiện để mô hình bớt lặp một cụm từ.
Chọn tham số tuỳ theo nhiệm vụ. Nhiệm vụ có một đáp án đúng, như trích xuất thông tin, phân loại, sinh mã hay trả lời dựa trên tài liệu, nên dùng temperature thấp để kết quả ổn định. Nhiệm vụ sáng tạo, như viết nội dung hay gợi ý ý tưởng, cần temperature cao hơn để kết quả đa dạng.
Lưu ý
Đặt temperature bằng 0 không bảo đảm kết quả giống hệt nhau giữa các lần gọi. Trên máy chủ, các yêu cầu được gộp thành lô, mà phép cộng số thực dấu phẩy động không có tính kết hợp, nên logit tính ra có thể khác nhau rất nhỏ tuỳ theo lô. Khi hai token có xác suất gần bằng nhau, khác biệt nhỏ đó đủ đổi token được chọn, và từ đó đổi toàn bộ phần văn bản sau. Ứng dụng cần được thiết kế để chịu được sự không tất định này, và việc đánh giá cần chạy nhiều lần hoặc trên đủ nhiều ví dụ (Chương 12).
2.4Các giai đoạn huấn luyện#
Một mô hình trò chuyện như các trợ lý phổ biến hiện nay thường qua ba giai đoạn huấn luyện, và mỗi giai đoạn để lại dấu vết mà người dùng API nhận ra được.
Mọi thứ bắt đầu từ tiền huấn luyện (pretraining): mô hình học dự đoán token tiếp theo trên hàng nghìn tỉ token văn bản. Qua đó nó thu được kiến thức và khả năng ngôn ngữ, nhưng chỉ biết viết tiếp văn bản chứ chưa biết làm theo chỉ dẫn. Kết quả của giai đoạn này gọi là mô hình gốc (base model). Kiến thức của mô hình dừng ở thời điểm thu thập dữ liệu, gọi là mốc cắt kiến thức (knowledge cutoff).
Để mô hình gốc trả lời câu hỏi thay vì viết tiếp câu hỏi, người ta tinh chỉnh theo chỉ dẫn (instruction tuning, còn gọi là supervised fine-tuning): huấn luyện tiếp trên các cặp chỉ dẫn và câu trả lời mẫu, để mô hình học định dạng hội thoại và cách làm theo yêu cầu. Mô hình ra khỏi bước này thường mang hậu tố "Instruct" hoặc "Chat" trong tên.
Sau bước đó mô hình đã làm theo chỉ dẫn, nhưng chưa biết trong nhiều câu trả lời đúng định dạng thì câu nào được người dùng ưa hơn. Giai đoạn căn chỉnh theo sở thích con người lấp chỗ trống này bằng RLHF, DPO và các biến thể: dữ liệu là những cặp câu trả lời đã được so sánh với nhau, và mô hình học cách ưu tiên câu trả lời hữu ích, trung thực và an toàn hơn. Hai phương pháp này được trình bày ở Chương 14 và 15 của Biểu diễn & Căn chỉnh.
Từ năm 2024, nhiều nhà phát triển thêm một giai đoạn học tăng cường trên các bài toán kiểm chứng được đáp án, như toán và lập trình, để mô hình học cách sinh một chuỗi suy luận dài trước khi trả lời. Các mô hình này thường được gọi là mô hình suy luận (reasoning model). Chúng tiêu nhiều token đầu ra hơn và chậm hơn, đổi lại giải tốt hơn các bài toán cần nhiều bước.
2.5Độ trễ và chi phí của suy luận#
Một lần gọi mô hình gồm hai pha có tính chất rất khác nhau. Ở pha nạp ngữ cảnh (prefill), mô hình xử lý toàn bộ token đầu vào cùng một lúc và tạo KV cache. Vì mọi token đầu vào đã có sẵn, pha này tận dụng tốt khả năng tính song song của GPU, và thời gian của nó tăng theo số token đầu vào. Ở pha sinh (decode), mô hình sinh từng token một, và mỗi token mới cần đọc toàn bộ trọng số cùng KV cache từ bộ nhớ. Lượng tính toán cho một token thì nhỏ, nên pha này bị giới hạn bởi băng thông bộ nhớ chứ không bởi khả năng tính (Mục 1.3 của Quantization), và thời gian của nó tăng theo số token đầu ra.
Ứng với hai pha có hai chỉ số độ trễ cần theo dõi riêng. Thời gian tới token đầu tiên (time to first token, TTFT) chủ yếu do pha nạp ngữ cảnh quyết định. Thời gian cho mỗi token đầu ra (time per output token) quyết định tốc độ chữ hiện ra trên màn hình. Với giao diện trò chuyện, ứng dụng thường trả kết quả theo luồng (streaming), tức hiển thị từng token ngay khi nó được sinh ra, nên người dùng thấy phản hồi sớm dù tổng thời gian không đổi.
Các nhà cung cấp API tính giá theo triệu token, và đơn giá token đầu ra thường cao hơn token đầu vào nhiều lần, phản ánh việc pha sinh tốn tài nguyên hơn cho mỗi token. Để thấy tiền đi đâu, xét một yêu cầu RAG điển hình với đơn giá giả định 1 đơn vị tiền cho mỗi triệu token đầu vào và 4 đơn vị cho mỗi triệu token đầu ra.
| Thành phần | Số token | Tỉ lệ đầu vào |
|---|---|---|
| Chỉ dẫn hệ thống | 600 | 18,7% |
| 5 đoạn truy xuất, mỗi đoạn 350 token | 1 750 | 54,5% |
| Lịch sử hội thoại | 800 | 24,9% |
| Câu hỏi | 60 | 1,9% |
| Tổng đầu vào | 3 210 | |
| Đầu ra | 350 |
Chi phí mỗi yêu cầu là đơn vị. Đầu ra chỉ chiếm 9,8% số token nhưng chiếm 30,4% chi phí. Câu hỏi của người dùng chỉ chiếm 1,9% đầu vào; phần lớn chi phí đến từ ngữ cảnh do ứng dụng tự thêm vào, và đó chính là phần kỹ sư AI kiểm soát được. Chẳng hạn, nếu 600 token chỉ dẫn hệ thống được đọc từ bộ đệm prompt với giá bằng 10% giá thường (cơ chế ở Mục 4.6), chi phí mỗi yêu cầu giảm 11,7%.
Ví dụ 2.1 (Ước lượng chi phí hằng tháng)
Một trợ lý nội bộ phục vụ 2 000 nhân viên, mỗi người 15 yêu cầu mỗi ngày làm việc, 22 ngày mỗi tháng, mỗi yêu cầu như bảng trên. Số yêu cầu mỗi tháng là , và chi phí là đơn vị. Nếu đổi sang một mô hình đắt gấp 10 lần, chi phí tăng tương ứng lên khoảng 30 nghìn đơn vị. Phép tính đơn giản này nên làm trước khi chọn mô hình (Chương 3), vì chênh lệch giá giữa các mô hình có thể lên tới hai bậc độ lớn. Công cụ chi phí ở trang Phòng thí nghiệm làm phép tính này với các số liệu tự nhập.
2.6Các giới hạn cố hữu#
Bên cạnh các đặc điểm kỹ thuật trên, người xây ứng dụng cần biết một số giới hạn đến từ chính cách LLM được huấn luyện. Chúng giảm đi khi mô hình tốt lên nhưng không biến mất, nên thiết kế ứng dụng phải tính tới chúng.
Giới hạn được nhắc tới nhiều nhất là ảo giác (hallucination). Mô hình được huấn luyện để sinh văn bản có xác suất cao, không phải để nói đúng sự thật. Khi không biết câu trả lời, nó vẫn có thể sinh một đoạn văn trôi chảy, tự tin và sai: trích dẫn một bài báo không tồn tại, bịa số liệu, gán một câu nói cho sai người. Không có một biện pháp duy nhất nào loại bỏ được ảo giác, nên người ta kết hợp nhiều biện pháp: cung cấp tài liệu nguồn và yêu cầu trích dẫn (Chương 8), cho phép và khuyến khích mô hình trả lời "không biết", kiểm tra đầu ra bằng các bước riêng, và đo tỉ lệ ảo giác trên bộ kiểm thử (Chương 12).
Giới hạn thứ hai liên quan tới thời gian. Mô hình không biết các sự kiện xảy ra sau mốc cắt kiến thức, và thường cũng không biết chính xác mốc đó là khi nào. Những thông tin thay đổi nhanh như giá cả, chính sách hay phiên bản phần mềm phải được đưa vào qua truy xuất hoặc tool, không thể trông vào trí nhớ của mô hình.
Hai giới hạn tiếp theo làm cho việc đánh giá khó hơn. Như Mục 2.3 đã nêu, cùng một đầu vào có thể cho các đầu ra khác nhau. Ngoài ra mô hình nhạy với cách diễn đạt: hai prompt cùng nghĩa có thể cho kết quả khác nhau rõ rệt, và thứ tự các ví dụ, vị trí của chỉ dẫn hay cách định dạng đều có ảnh hưởng. Vì cả hai lẽ đó, mọi kết luận về chất lượng phải dựa trên nhiều ví dụ, và mọi thay đổi prompt cần được đo trên bộ đánh giá thay vì kiểm tra bằng mắt vài trường hợp.
Giới hạn cuối cùng nguy hiểm nhất. Với mô hình, mọi token trong ngữ cảnh đều là văn bản như nhau, và không có ranh giới cứng nào giữa chỉ dẫn của người phát triển với dữ liệu mà ứng dụng đưa vào. Một tài liệu truy xuất về có chứa câu "hãy bỏ qua các chỉ dẫn trước" có thể được mô hình làm theo. Đó là gốc của prompt injection, rủi ro an toàn lớn nhất của ứng dụng LLM và là chủ đề chính của Chương 11.
2.7Tóm tắt#
Mô hình ngôn ngữ đọc văn bản dưới dạng token, và số token của cùng một nội dung phụ thuộc vào tokenizer; với văn bản tiếng Việt trong thí nghiệm, tokenizer của GPT-2 tốn gần gấp bốn lần tokenizer của XLM-RoBERTa. Mọi thứ mô hình cần biết trong một lần gọi phải nằm trong cửa sổ ngữ cảnh, và mỗi token trong đó tốn bộ nhớ KV cache, tốn tiền và có thể làm giảm chất lượng. Văn bản được sinh từng token bằng cách lấy mẫu, nên kết quả không tất định. Chi phí một lần gọi chủ yếu đến từ ngữ cảnh do ứng dụng thêm vào, còn độ trễ chia thành thời gian tới token đầu tiên và tốc độ sinh. Cuối cùng, mô hình có thể bịa thông tin, không biết chuyện sau mốc cắt kiến thức, và không phân biệt được chỉ dẫn với dữ liệu.
Những hiểu biết này là cơ sở cho quyết định đầu tiên của mọi dự án: dùng mô hình nào, gọi qua API hay tự chạy trên hạ tầng của mình. Chương 3 bàn về quyết định đó.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Cùng một văn bản, vì sao bản tiếng Việt tốn gấp 4,8 lần số token so với bản tiếng Anh với tokenizer của GPT-2?
Vì sao: Với tokenizer đa ngôn ngữ như Qwen2.5 và XLM-RoBERTa, tỉ lệ chỉ còn 1,4 và 1,2 lần. Tokenizer BPE tự huấn luyện trên tiếng Việt cho tỉ lệ 0,64 (Mục 2.1).2Với Llama 3 8B, KV cache của một chuỗi 128 nghìn token khoảng bao nhiêu?
Vì sao: Mỗi token tốn byte = 128 KiB, nên 131 072 token tốn 16 GiB, tức khoảng 17,2 GB, xấp xỉ 16 GB trọng số 16 bit của mô hình (Mục 2.2). Công cụ KV cache ở trang Phòng thí nghiệm tính được con số này cho các mô hình và độ dài ngữ cảnh khác.3Trong một yêu cầu RAG điển hình ở Mục 2.5, đầu ra chiếm 9,8% số token nhưng chiếm bao nhiêu phần chi phí khi token đầu ra đắt gấp 4 lần?
Vì sao: . Phần lớn chi phí còn lại đến từ ngữ cảnh do ứng dụng thêm vào, phần kỹ sư AI kiểm soát được.4Vì sao temperature bằng 0 không bảo đảm kết quả giống hệt nhau giữa các lần gọi?
Vì sao: Ứng dụng cần chịu được tính không tất định, và đánh giá cần đủ nhiều ví dụ (Mục 2.3).
Đã trả lời 0/4