14Mô hình đa phương thức#
Một khách hàng gửi cho trợ lý hỗ trợ ảnh chụp hoá đơn kèm câu hỏi "sao tôi bị tính phí hai lần?". Một nhân viên gửi bản ghi âm cuộc họp và nhờ tóm tắt. Những yêu cầu như vậy cần mô hình làm việc với nhiều loại dữ liệu cùng lúc, gọi là AI đa phương thức (multimodal AI): văn bản, ảnh, âm thanh, video. Phần lớn những gì đã học ở các chương trước vẫn đúng, nhưng có một điều thay đổi rõ rệt là chi phí: một bức ảnh có thể tốn số token bằng vài trang văn bản. Để hiểu vì sao, ta cần xem mô hình ngôn ngữ đọc ảnh như thế nào.
14.1Các bài toán đa phương thức#
Bảng dưới liệt kê các bài toán đa phương thức thường gặp trong ứng dụng, cùng dạng đầu vào và đầu ra của mỗi bài toán.
| Bài toán | Đầu vào → đầu ra | Ví dụ ứng dụng |
|---|---|---|
| Hiểu ảnh | ảnh + văn bản → văn bản | đọc hoá đơn, mô tả ảnh cho người khiếm thị, hỏi đáp về biểu đồ |
| Sinh ảnh | văn bản (± ảnh) → ảnh | minh hoạ, chỉnh sửa ảnh theo mô tả |
| Hiểu video | video + văn bản → văn bản | tóm tắt cuộc họp, tìm đoạn trong video |
| Nhận dạng tiếng nói (speech-to-text) | âm thanh → văn bản | phụ đề, ghi biên bản, trợ lý giọng nói |
| Tổng hợp tiếng nói (text-to-speech) | văn bản → âm thanh | đọc tin tức, trợ lý giọng nói |
14.2Cách mô hình ngôn ngữ đọc ảnh#
Phần lớn mô hình ngôn ngữ hiểu được ảnh hiện nay theo cùng một thiết kế, được phổ biến bởi LLaVA (Liu và cộng sự, 2023). Ảnh trước hết đi qua một bộ mã hoá ảnh, thường là Vision Transformer (ViT; Dosovitskiy và cộng sự, 2021). Bộ mã hoá chia ảnh thành các ô vuông nhỏ (patch), ví dụ 14 × 14 điểm ảnh, và biến mỗi ô thành một vector. Nó thường được khởi tạo từ một mô hình như CLIP (Radford và cộng sự, 2021), vốn được huấn luyện tương phản trên khoảng 400 triệu cặp ảnh và chú thích, theo cùng nguyên lý với embedding văn bản ở Mục 6.1. Sau đó một lớp chiếu biến các vector ảnh sang cùng không gian với embedding token văn bản của mô hình ngôn ngữ. Cuối cùng, các vector ảnh được đưa vào mô hình ngôn ngữ như những "token ảnh", đứng cạnh token văn bản trong cùng một ngữ cảnh.
Từ thiết kế này suy ra ngay hệ quả quan trọng nhất cho ứng dụng: ảnh tốn token, và số token tăng theo bình phương độ phân giải. Với ô 14 × 14 điểm ảnh, một ảnh vuông cạnh điểm ảnh cho ô. Một số mô hình gộp 2 × 2 ô liền nhau thành một token, tương đương ô 28 × 28; Qwen2-VL làm theo cách này để giảm bốn lần số token.
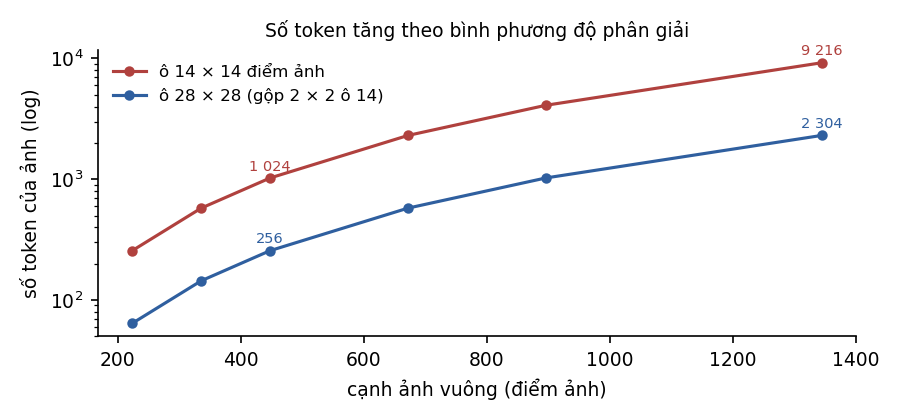
Ảnh 448 × 448 cho 1 024 token với ô 14 và 256 token với ô 28; ảnh 1344 × 1344 cho 2 304 token ngay cả với ô 28. Một ảnh chụp màn hình độ phân giải cao vì vậy có thể tốn số token bằng vài trang văn bản. Ứng dụng xử lý ảnh nên thu nhỏ ảnh về độ phân giải vừa đủ cho nhiệm vụ, và cắt lấy vùng cần thiết thay vì gửi cả ảnh lớn. Nhưng không được thu nhỏ quá mức: với nhiệm vụ cần đọc chữ nhỏ như hoá đơn hay bảng số liệu, ảnh quá nhỏ làm mô hình đọc sai.
Mô hình hiểu ảnh cũng có những giới hạn riêng. Nó thường kém ở việc đếm vật thể, xác định vị trí tương đối và khoảng cách, đọc chữ nhỏ hoặc chữ viết tay, và có thể ảo giác những chi tiết không có trong ảnh. Như với văn bản, cần một bộ đánh giá riêng trên ảnh thật của ứng dụng.
Video thường được xử lý bằng cách lấy mẫu một số khung hình rồi mã hoá như một chuỗi ảnh. Với 1 khung hình mỗi giây và 256 token mỗi khung hình, một phút video tốn khoảng 15 nghìn token, nên video dài cần được lấy mẫu thưa hoặc tóm tắt theo từng đoạn.
14.3Sinh ảnh#
Các mô hình sinh ảnh từ văn bản hiện nay chủ yếu dựa trên mô hình khuếch tán (Chương 11 của Biểu diễn & Căn chỉnh): bắt đầu từ nhiễu và khử nhiễu dần theo hướng dẫn của một bộ mã hoá văn bản. Trong ứng dụng, sinh ảnh thường được dùng qua API của các nhà cung cấp, như các API sinh ảnh của OpenAI và Google được nhắc trong roadmap, hoặc qua mô hình mở tự triển khai. Những vấn đề cần xử lý gồm kiểm duyệt nội dung đầu vào và đầu ra, quyền sở hữu trí tuệ đối với nội dung sinh ra, và gắn thông tin nguồn gốc cho ảnh do AI tạo, chẳng hạn theo chuẩn C2PA, khi sản phẩm cần minh bạch về điều này.
14.4Nhận dạng và tổng hợp tiếng nói#
Nhận dạng tiếng nói (speech-to-text) đã đạt chất lượng cao nhờ các mô hình huấn luyện trên lượng dữ liệu lớn. Whisper (Radford và cộng sự, 2023) được huấn luyện có giám sát yếu trên 680 nghìn giờ âm thanh đa ngôn ngữ thu từ Internet, và nhận dạng được nhiều ngôn ngữ, trong đó có tiếng Việt. Thước đo chuẩn của bài toán này là tỉ lệ lỗi từ (word error rate, WER): số phép thay, xoá, chèn cần để biến bản nhận dạng thành bản chuẩn, chia cho số từ của bản chuẩn. Với tiếng Việt, chất lượng thay đổi theo vùng miền, tạp âm và thuật ngữ chuyên ngành, nên cần đo trên âm thanh thật của ứng dụng.
Chiều ngược lại, tổng hợp tiếng nói (text-to-speech), biến văn bản thành giọng đọc. Một ứng dụng hội thoại bằng giọng nói có thể ghép ba bước nhận dạng, LLM và tổng hợp, hoặc dùng một mô hình xử lý thẳng từ âm thanh sang âm thanh. Chuỗi ba bước dễ ghép và dễ kiểm soát từng phần. Mô hình trực tiếp có độ trễ thấp hơn và giữ được ngữ điệu, nhưng khó kiểm tra nội dung giữa chừng hơn, vì không có bước văn bản trung gian để đặt rào chắn.
14.5Xây dựng ứng dụng đa phương thức#
Có ba cách tiếp cận: gọi API của các mô hình đa phương thức (các API hiểu ảnh, sinh ảnh, nhận dạng tiếng nói của các nhà cung cấp lớn), tự triển khai mô hình mở từ Hugging Face, hoặc dùng các khung như LangChain và LlamaIndex, vốn có thành phần cho dữ liệu đa phương thức. Các nguyên tắc của những chương trước áp dụng nguyên vẹn. Cần đếm token và chi phí trước khi chọn, vì ảnh và âm thanh thường đắt hơn văn bản nhiều. Cần xây bộ đánh giá trên dữ liệu thật. Và cần coi nội dung trong ảnh hay âm thanh là dữ liệu không đáng tin, vì chữ trong ảnh cũng có thể chứa chỉ dẫn prompt injection (Chương 11).
14.6Tóm tắt#
Mô hình ngôn ngữ đọc ảnh bằng cách chia ảnh thành các ô, mã hoá mỗi ô bằng một bộ mã hoá ảnh, rồi chiếu thành token ảnh đặt cạnh token văn bản. Số token tăng theo bình phương độ phân giải: ảnh 448 × 448 tốn 1 024 token với ô 14 điểm ảnh, và một phút video lấy mẫu 1 khung hình mỗi giây tốn khoảng 15 nghìn token. Vì vậy ảnh cần được thu nhỏ hoặc cắt vừa đủ cho nhiệm vụ. Sinh ảnh dựa trên mô hình khuếch tán, nhận dạng tiếng nói được đo bằng tỉ lệ lỗi từ, và ứng dụng giọng nói chọn giữa chuỗi ba bước dễ kiểm soát với mô hình trực tiếp có độ trễ thấp. Mọi nguyên tắc về chi phí, đánh giá và an toàn của các chương trước vẫn áp dụng, kể cả prompt injection qua chữ trong ảnh.
Chương cuối của giáo trình quay về một loại ứng dụng mà kỹ sư AI dùng hằng ngày: các công cụ lập trình dựa trên LLM, nơi agent ở Chương 9 đã trở thành sản phẩm phổ biến.
Tự kiểm tra
2 câu. Chọn đáp án để xem ngay lời giải thích.
1Với ô 14 × 14 điểm ảnh, một ảnh vuông 448 × 448 cho bao nhiêu token ảnh?
Vì sao: . Gộp 2 × 2 ô (tương đương ô 28 × 28) giảm còn 256 token (Mục 14.2).2Thước đo chuẩn cho nhận dạng tiếng nói là gì?
Vì sao: Số phép thay, xoá, chèn cần để biến bản nhận dạng thành bản chuẩn, chia cho số từ của bản chuẩn (Mục 14.4).
Đã trả lời 0/2