12Đánh giá ứng dụng LLM#
Mục 1.3 đặt bộ đánh giá vào trung tâm của quy trình phát triển, và từ đó tới giờ hầu như chương nào cũng kết thúc bằng lời khuyên đo trên bộ đánh giá. Đã tới lúc nói cho rõ: đo bằng cách nào, bằng thước đo gì, và cần bao nhiêu câu hỏi để một con số đáng tin. Câu hỏi cuối thường bị xem nhẹ nhất. Thí nghiệm RAG ở Mục 8.5 đã cho thấy một bộ 254 câu không đủ để khẳng định một cải thiện 3,6 điểm phần trăm, và Mục 12.4 sẽ giải thích vì sao.
12.1Những khó khăn của việc đánh giá#
Với bộ phân loại trong giáo trình Nền tảng, mỗi dự đoán đúng hoặc sai, và độ chính xác là một con số rõ ràng. Ứng dụng LLM khó đánh giá hơn vì bốn lẽ. Đầu ra là văn bản mở: một câu hỏi có nhiều câu trả lời đúng với cách diễn đạt khác nhau, nên so khớp chuỗi không dùng được. Chất lượng có nhiều tiêu chí cùng lúc: một câu trả lời có thể đúng nội dung nhưng quá dài, sai giọng, thiếu trích dẫn, hoặc làm lộ thông tin không được phép. Kết quả không tất định: cùng đầu vào cho đầu ra khác nhau giữa các lần chạy (Mục 2.3). Và phân phối đầu vào thay đổi: người dùng thật hỏi những câu không ai nghĩ tới khi xây bộ đánh giá.
Vì vậy đánh giá ứng dụng LLM thường kết hợp nhiều loại kiểm tra, mỗi loại lo một khía cạnh, và bộ đánh giá phải được bổ sung liên tục từ dữ liệu thật.
12.2Các loại đánh giá#
Các loại đánh giá khác nhau ở chỗ ai chấm. Loại rẻ nhất là đánh giá tất định (deterministic evals), dùng mã để kiểm tra những gì kiểm tra được bằng quy tắc: đầu ra có đúng lược đồ JSON không, có chứa trích dẫn không, có vượt độ dài không, câu trả lời trắc nghiệm có đúng đáp án không, mã sinh ra có chạy qua kiểm thử đơn vị không, câu trả lời có chứa số điện thoại hay số thẻ không. Loại này rẻ, nhanh, lặp lại được, và nên được dùng tối đa. Nhiều tiêu chí tưởng cần "hiểu nghĩa" thực ra chuyển được về dạng kiểm tra được: thay vì hỏi câu trả lời có đúng không, ta thiết kế nhiệm vụ sao cho câu trả lời chứa một giá trị kiểm tra được. Thí nghiệm RAG ở Mục 8.5 làm đúng như vậy khi bắt mô hình chọn một trong bốn chữ cái A, B, C, D.
Khi tiêu chí không đưa được về quy tắc, có thể dùng đánh giá dựa trên mô hình (model-based evals), trong đó một LLM làm giám khảo (LLM-as-a-judge). Mô hình giám khảo nhận câu hỏi, câu trả lời và tiêu chí chấm, có thể kèm câu trả lời tham chiếu, rồi chấm điểm hoặc so sánh hai câu trả lời. Zheng và cộng sự (2023) cho thấy giám khảo mạnh như GPT-4 đạt mức đồng thuận với chuyên gia trên 80%, ngang mức đồng thuận giữa các chuyên gia với nhau. Cùng nghiên cứu cũng chỉ ra các thiên lệch của giám khảo: thiên lệch vị trí (ưu tiên câu trả lời đứng trước hoặc đứng sau), thiên lệch độ dài (ưu tiên câu trả lời dài hơn), và tự đề cao (ưu tiên câu trả lời do chính mô hình đó viết). Mục 13.3 của MLOps trình bày các thiên lệch này cùng cách xử lý khi vận hành. Để giảm thiên lệch, người ta đổi vị trí hai câu trả lời và chấm hai lần, dùng tiêu chí chấm chi tiết, chấm từng tiêu chí riêng thay vì một điểm chung, và định kỳ kiểm tra độ đồng thuận của giám khảo với nhãn do người gán.
Nhãn do người gán chính là loại thứ ba, đánh giá bởi con người (human evals), chuẩn tham chiếu cho những tiêu chí chủ quan như sự hữu ích hay giọng văn. Loại này đắt và chậm, nên thường chỉ dùng trên mẫu nhỏ để hiệu chỉnh hai loại trên. Khi nhiều người cùng gán nhãn, cần đo mức đồng thuận giữa họ, chẳng hạn bằng hệ số kappa của Cohen; nếu chính con người còn không đồng ý với nhau, tiêu chí chấm cần được viết lại cho rõ.
12.3Các thước đo#
Thước đo cụ thể phụ thuộc vào nhiệm vụ. Bảng dưới liệt kê các thước đo thường dùng cho những loại nhiệm vụ đã gặp trong giáo trình.
| Nhiệm vụ | Thước đo thường dùng | Ghi chú |
|---|---|---|
| Phân loại, trích xuất có nhãn | độ chính xác, precision, recall, F1 | như Chương 8 của Nền tảng |
| Hỏi đáp có đáp án ngắn | khớp chính xác (exact match), F1 theo token | cần chuẩn hoá chữ hoa, dấu câu trước khi so |
| Tóm tắt, dịch | BLEU, ROUGE, chấm bằng giám khảo | BLEU và ROUGE đo độ trùng n-gram với bản tham chiếu, tương quan yếu với chất lượng ở văn bản mở |
| Sinh mã | pass@k | tỉ lệ bài có ít nhất một trong lời giải chạy qua kiểm thử |
| RAG | recall@k của truy xuất; độ trung thành với nguồn (faithfulness); mức liên quan của câu trả lời | tách lỗi truy xuất và lỗi sinh (Mục 8.6) |
| Agent | tỉ lệ hoàn thành nhiệm vụ, số bước, chi phí mỗi nhiệm vụ | kiểm tra trạng thái cuối của môi trường, không chỉ câu trả lời |
| An toàn | tỉ lệ tấn công thành công, tỉ lệ từ chối nhầm | đo cả hai chiều: từ chối quá nhiều cũng là lỗi |
Thước đo cho sinh mã cần giải thích thêm, vì cách tính tự nhiên nhất lại cho kết quả chệch. Chen và cộng sự (2021) đưa ra cách ước lượng không chệch cho pass@k: sinh lời giải cho mỗi bài, đếm lời giải đúng, rồi tính
tức xác suất một tập lời giải chọn ngẫu nhiên trong lời giải có ít nhất một lời giải đúng. Cách tính ngây thơ bị chệch khi nhỏ. Với một bài có lời giải, trong đó lời giải đúng, công thức cho pass@2 , còn cách ngây thơ cho . Ở , chọn cả năm lời giải thì chắc chắn có lời giải đúng và công thức cho đúng 1, trong khi cách ngây thơ chỉ cho 0,922: nó coi như các lần thử được rút có hoàn lại.
12.4Cỡ mẫu của bộ đánh giá#
Giả sử bộ đánh giá có câu hỏi và hệ thống đúng ở một tỉ lệ số câu. Tỉ lệ này là ước lượng của độ chính xác thật , với khoảng tin cậy 95% xấp xỉ
Bảng dưới tính nửa độ rộng của khoảng này khi độ chính xác thật là 80%, và so với kết quả mô phỏng 20 000 lần rút mẫu.
| Số câu | Nửa độ rộng khoảng tin cậy 95% (công thức) | Mô phỏng |
|---|---|---|
| 50 | 11,1 điểm % | 11,0 |
| 100 | 7,8 | 8,0 |
| 200 | 5,5 | 5,5 |
| 500 | 3,5 | 3,5 |
| 1 000 | 2,5 | 2,5 |
| 2 000 | 1,8 | 1,7 |
Với 100 câu, độ chính xác đo được 80% chỉ cho biết độ chính xác thật nằm đâu đó trong khoảng 72% tới 88%. Hai phiên bản prompt đo được 78% và 82% trên 100 câu vì thế không cho kết luận gì. Độ rộng giảm theo , nên muốn thu hẹp một nửa thì phải tăng số câu lên bốn lần.
Khi so sánh hai phiên bản A và B, có một cách làm tốt hơn hẳn việc tăng số câu: chấm cả hai trên cùng một bộ câu hỏi thay vì hai bộ khác nhau. Kết quả của hai phiên bản trên cùng một câu tương quan mạnh với nhau, vì câu khó thì cả hai cùng dễ sai, nên phần lớn biến động do độ khó của câu hỏi bị triệt tiêu khi so sánh. Kiểm định phù hợp là kiểm định McNemar. Nó chỉ xét các câu mà hai phiên bản cho kết quả khác nhau: nếu A và B tốt như nhau thì số câu "A sai, B đúng" và số câu "A đúng, B sai" phải xấp xỉ bằng nhau, và độ lệch giữa hai số được kiểm định bằng phân phối nhị thức. Chẳng hạn trên 100 câu, B sửa được 9 câu A sai và làm sai 3 câu A đúng, tức B hơn A 6 điểm phần trăm. Chỉ 12 câu bất đồng mang thông tin. Nếu hai phiên bản tốt như nhau, mỗi câu bất đồng nghiêng về B với xác suất 0,5, và xác suất có từ 9 trên 12 câu trở lên nghiêng về B là . Giá trị hai phía là 0,146, nên với 100 câu, chênh lệch 6 điểm này vẫn chưa đủ để kết luận.
Thí nghiệm mô phỏng một tình huống điển hình. Phiên bản A đúng 80%; phiên bản B giữ đúng 97% số câu A đúng và sửa được 27% số câu A sai, nên B đúng 83%. Với mỗi cỡ bộ đánh giá, ta mô phỏng 2 000 lần và đếm tỉ lệ phát hiện được B tốt hơn ở mức ý nghĩa 5%.
| Số câu mỗi phiên bản | Ghép cặp (McNemar) | Hai bộ câu hỏi độc lập |
|---|---|---|
| 100 | 0,086 | 0,076 |
| 300 | 0,392 | 0,154 |
| 1 000 | 0,919 | 0,410 |
| 3 000 | 1,000 | 0,857 |
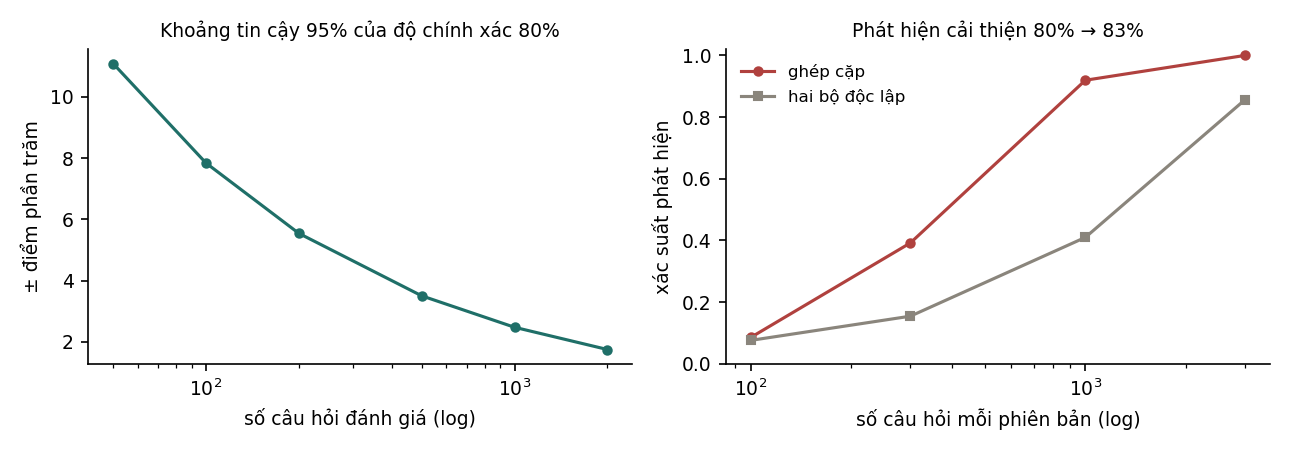
Với 100 câu, một cải thiện thật 3 điểm phần trăm gần như không bao giờ được phát hiện, dưới 9% số lần. Với 1 000 câu, so sánh ghép cặp phát hiện được 92% số lần, trong khi hai bộ độc lập chỉ 41%; ghép cặp tương đương với việc có một bộ đánh giá lớn hơn nhiều lần mà không tốn thêm câu hỏi nào. Công cụ cỡ bộ đánh giá ở trang Phòng thí nghiệm tính chính xác các xác suất này, không qua mô phỏng, cho các tỉ lệ đúng và số câu khác.
Từ đây có một quy tắc thực hành. Bộ đánh giá vài chục câu đủ để phát hiện lỗi lớn và thói quen xấu của một prompt, nhưng không đủ để chọn giữa hai phiên bản gần nhau. Muốn phân biệt cải thiện cỡ vài điểm phần trăm thì cần cỡ nghìn câu và so sánh ghép cặp. Khi không có nhiều câu như vậy, chỉ nên chấp nhận những thay đổi có cải thiện lớn, hoặc có lý do rõ ràng ngoài con số. Cũng cần tránh chạy hàng chục biến thể prompt trên cùng một bộ đánh giá nhỏ rồi chọn biến thể có điểm cao nhất, vì đó là overfitting vào bộ đánh giá (Mục 9.5 của Nền tảng).
12.5Kiểm thử hồi quy#
Kiểm thử hồi quy (regression testing) chạy lại bộ đánh giá mỗi khi hệ thống thay đổi, để phát hiện những gì trước đây đúng nay sai. Với ứng dụng LLM, "thay đổi" gồm cả những thứ không nằm trong mã: sửa prompt, đổi mô hình hoặc phiên bản mô hình, thay mô hình embedding, cập nhật kho tài liệu, sửa mô tả tool.
Trung tâm của kiểm thử hồi quy là một bộ vàng (golden set): các ví dụ có đầu vào và tiêu chí đúng sai rõ ràng, chia theo nhóm tình huống như câu hỏi thường, câu hỏi ngoài phạm vi, câu hỏi cần từ chối, câu có lỗi chính tả. Kết quả nên được báo cáo theo từng nhóm, vì một thay đổi có thể cải thiện tổng thể nhưng làm hỏng một nhóm quan trọng. Bộ vàng được nối vào quy trình CI như một cửa kiểm tra: mỗi thay đổi chạy bộ đánh giá tự động, và bị chặn nếu độ chính xác của một nhóm quan trọng giảm quá ngưỡng, hoặc nếu có ví dụ thuộc loại "không bao giờ được sai", như lộ dữ liệu hay thao tác nguy hiểm, bị sai. Các ví dụ nhạy cảm nên được chạy nhiều lần để phát hiện kết quả không ổn định do tính không tất định. Và bộ vàng phải được bổ sung liên tục: mỗi lỗi phát hiện trong sản xuất (Chương 13) được đưa vào bộ vàng sau khi sửa, để lỗi đó không quay lại.
Đổi phiên bản mô hình là thay đổi cần kiểm thử kỹ nhất. Nhà cung cấp API có thể cập nhật mô hình phía sau cùng một tên, nên khi có thể thì dùng tên phiên bản cố định, và chạy lại toàn bộ bộ đánh giá mỗi khi chuyển phiên bản.
12.6Các công cụ đánh giá#
Các thư viện đánh giá được nhắc tới trong roadmap gồm DeepEval, một khung kiểm thử cho ứng dụng LLM theo phong cách kiểm thử đơn vị với sẵn nhiều thước đo dựa trên giám khảo, và RAGAS (Es và cộng sự, 2023) với các thước đo cho RAG như faithfulness, answer relevancy, context precision và context recall. Ngoài ra có promptfoo, OpenAI Evals, và lm-evaluation-harness cho đánh giá mô hình trên các bộ chuẩn công khai. Thư viện giúp bắt đầu nhanh, nhưng điều quyết định chất lượng của đánh giá là bộ ví dụ và tiêu chí chấm, những thứ không thư viện nào làm thay được. Một bộ đánh giá tự viết đơn giản, gồm một tệp các ví dụ, một hàm chấm cho mỗi loại tiêu chí và một bảng kết quả theo nhóm, thường đủ cho giai đoạn đầu.
12.7Tóm tắt#
Đánh giá ứng dụng LLM khó vì đầu ra mở, nhiều tiêu chí, không tất định và phân phối đầu vào thay đổi. Có ba loại đánh giá: kiểm tra tất định bằng mã, nên dùng tối đa; giám khảo LLM, cần kiểm soát thiên lệch vị trí, độ dài và tự đề cao; và đánh giá bởi con người, dùng làm chuẩn để hiệu chỉnh hai loại kia. Mỗi loại nhiệm vụ có thước đo riêng, và với sinh mã cần ước lượng pass@k không chệch. Khoảng tin cậy của độ chính xác hẹp lại theo : với 100 câu, nửa độ rộng khoảng 8 điểm phần trăm. So sánh ghép cặp bằng kiểm định McNemar mạnh hơn nhiều so với hai bộ độc lập; với 1 000 câu, nó phát hiện một cải thiện 3 điểm ở 92% số lần, so với 41%. Bộ vàng được chia theo nhóm, chạy trong CI ở mỗi thay đổi, kể cả thay đổi mô hình và tài liệu, và được bổ sung từ các lỗi gặp trong sản xuất.
Bộ vàng chỉ chứa những gì ta đã nghĩ tới. Người dùng thật luôn hỏi những câu chưa ai nghĩ tới, và cách duy nhất để biết hệ thống xử lý chúng ra sao là quan sát nó trong lúc chạy. Chương 13 bàn về việc quan sát đó.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Với độ chính xác khoảng 80%, bộ đánh giá 100 câu cho khoảng tin cậy 95% rộng cỡ nào?
Vì sao: Nửa độ rộng giảm theo : 1 000 câu cho ±2,5 điểm (Mục 12.4).2Vì sao nên so sánh hai phiên bản prompt trên cùng một bộ câu hỏi?
Vì sao: Với 1 000 câu, so sánh ghép cặp phát hiện cải thiện 3 điểm phần trăm ở 92% số lần, hai bộ độc lập chỉ 41% (Mục 12.4).3Các thiên lệch đã biết của LLM làm giám khảo gồm những gì?
Vì sao: Biện pháp: đổi vị trí và chấm hai lần, tiêu chí chi tiết, so định kỳ với nhãn do người gán (Mục 12.2).
Đã trả lời 0/3