1Tổng quan#
Giáo trình Học sâu kết thúc với một mô hình ngôn ngữ lớn ở dạng kiến trúc: các khối Transformer, số tham số, lượng bộ nhớ cần để huấn luyện. Từ một kiến trúc như vậy tới một trợ lý trả lời được câu hỏi của người dùng còn nhiều bước, và mỗi bước dùng một nhóm kỹ thuật riêng. Trước khi đi vào chi tiết, ta xếp các bước đó theo thứ tự để thấy mỗi nhóm kỹ thuật trả lời một câu hỏi mà nhóm trước để lại.
1.1Các nhóm kỹ thuật và mối liên hệ giữa chúng#
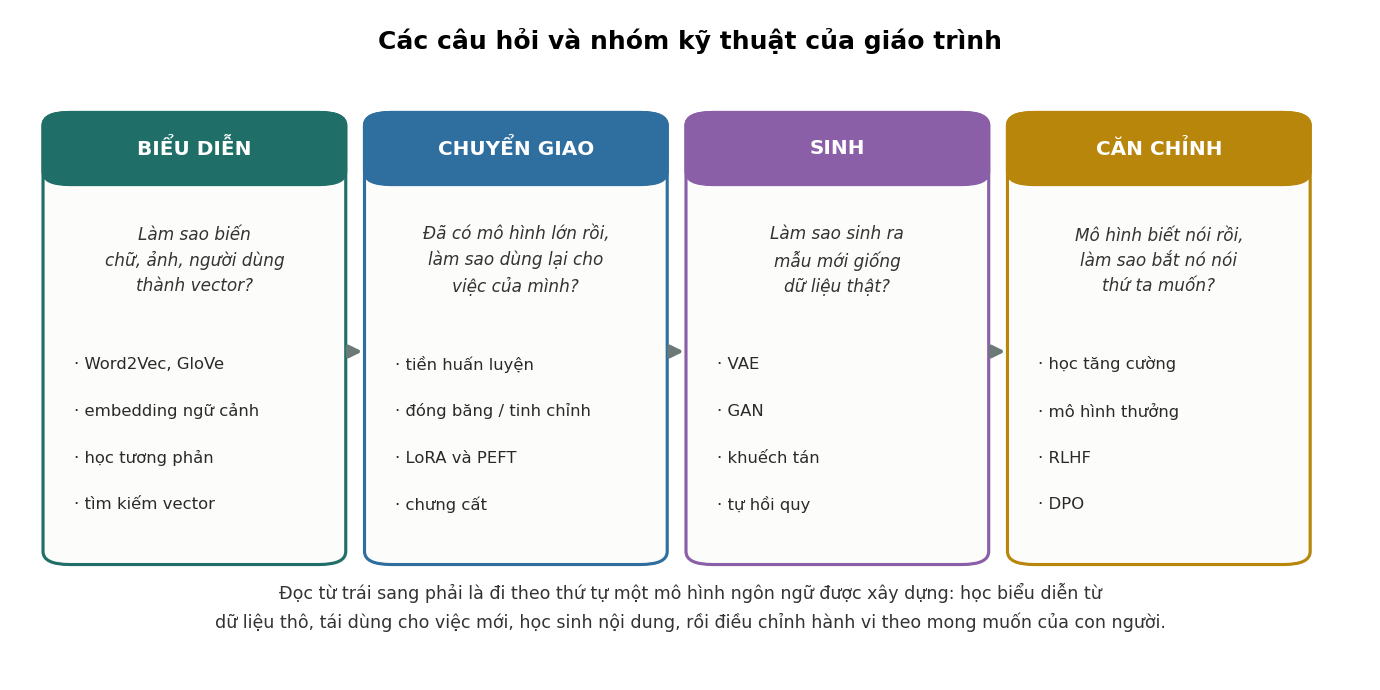
Embedding, học chuyển giao, mô hình sinh và căn chỉnh ra đời ở những thời điểm khác nhau, cho những mục đích khác nhau. Word2Vec (2013) tạo vector cho từ; mô hình khuếch tán (2020) sinh ảnh; RLHF (2017, phổ biến từ 2022) làm cho mô hình ngôn ngữ trả lời hữu ích hơn. Nhưng nếu đi theo quá trình xây dựng một mô hình ngôn ngữ hiện đại, chúng xếp thành một chuỗi: biểu diễn dữ liệu bằng vector, huấn luyện một mô hình lớn trên dữ liệu không nhãn rồi tái sử dụng nó, sinh ra nội dung mới, và cuối cùng điều chỉnh hành vi của mô hình theo mong muốn của con người.
1.2Câu hỏi của từng nhóm kỹ thuật#
Câu hỏi đầu tiên là biểu diễn dữ liệu thô bằng số. Máy tính chỉ xử lý số, nên chữ "mèo" phải trở thành một vector. Gán cho mỗi từ một chỉ số (mèo = 7, chó = 8, tủ lạnh = 9) là đưa vào một quan hệ giả: về mặt số học, mèo gần chó hơn gần tủ lạnh chỉ vì cách đánh số. Mã hoá one-hot, trong đó mỗi từ là một vector toàn số 0 với đúng một số 1, không đưa vào quan hệ giả nào, nhưng cũng không có quan hệ thật nào: mọi cặp từ đều cách nhau . Điều cần có là một không gian trong đó khoảng cách phản ánh sự giống nhau về nghĩa. Chương 2 tới 4 xây dựng không gian đó từ thống kê đồng hiện của các từ, không cần nhãn.
Câu hỏi thứ hai là tái sử dụng một mô hình đã huấn luyện. Huấn luyện một mô hình ngôn ngữ lớn từ đầu tốn hàng triệu đô la và hàng nghìn tỉ token, nên phần lớn ứng dụng lấy một mô hình có sẵn rồi điều chỉnh cho việc của mình. Điều cần biết là điều chỉnh tới đâu, bằng cách nào, với bao nhiêu dữ liệu. Chương 5 tới 7 trả lời các câu hỏi đó, kèm số đo cho thấy ngưỡng dữ liệu mà ở đó tinh chỉnh toàn phần bắt đầu vượt việc chỉ học một lớp tuyến tính trên đặc trưng đóng băng.
Câu hỏi thứ ba là sinh ra nội dung mới. Phân loại đi từ dữ liệu tới nhãn. Sinh đi theo chiều ngược lại và khó hơn nhiều: từ nhiễu ngẫu nhiên, tạo ra một mẫu chưa từng có nhưng trông giống dữ liệu thật. Chương 8 tới 11 trình bày ba họ mô hình: VAE, GAN và mô hình khuếch tán. Cả ba đều biến nhiễu Gauss thành mẫu, và khác nhau chủ yếu ở cách huấn luyện.
Câu hỏi cuối cùng là làm cho mô hình làm theo yêu cầu. Một mô hình vừa tiền huấn luyện biết ngôn ngữ nhưng chưa biết làm theo chỉ dẫn. Hỏi "thủ đô của Pháp là gì?", nó có thể trả lời, nhưng cũng có thể viết tiếp thành một đề kiểm tra gồm mười câu hỏi tương tự, vì trong văn bản trên mạng một câu hỏi thường đi cùng các câu hỏi khác. Chương 12 tới 15 trình bày cách điều chỉnh hành vi này. Giai đoạn căn chỉnh học từ so sánh giữa các câu trả lời thay vì từ câu trả lời mẫu, và việc đánh giá câu trả lời nào tốt hơn dễ hơn nhiều so với tự viết câu trả lời tốt nhất. Nhờ vậy mô hình có thể vượt chất lượng của các câu trả lời mẫu do người viết.
1.3Liên hệ với các giáo trình khác#
Giáo trình dùng lại nhiều kết quả của các giáo trình trước. Bảng dưới ghi nơi trình bày từng nội dung để tra lại khi cần.
| Nội dung cần dùng | Trình bày ở |
|---|---|
| Softmax, cross-entropy, hợp lý cực đại | Chương 6 và Chương 10 của Nền tảng |
| SVD và xấp xỉ hạng thấp | Chương 14 của Nền tảng |
| Tối ưu có ràng buộc, nhân tử Lagrange | Chương 12 của Nền tảng |
| Kiến trúc Transformer, attention | Chương 9 của Học sâu |
| Đếm tham số và bộ nhớ huấn luyện | Chương 12 của Học sâu |
| Embedding và RAG trong ứng dụng | Chương 6 tới 8 của Ứng dụng LLM |
| Vận hành mô hình ngôn ngữ | Chương 13 của MLOps |
Hai chỗ dùng lại nhiều nhất là phép đếm tham số ở Chương 12 của Học sâu, nền của Chương 7, và nhân tử Lagrange ở Chương 12 của Nền tảng, công cụ để giải bài toán ở Chương 14.
1.4Tóm tắt#
Bốn nhóm kỹ thuật của giáo trình ra đời riêng rẽ nhưng xếp thành một chuỗi khi nhìn theo quá trình tạo ra một mô hình ngôn ngữ: biểu diễn dữ liệu bằng vector, tiền huấn luyện rồi tái sử dụng mô hình, sinh nội dung mới, và căn chỉnh hành vi theo mong muốn của con người. Mỗi nhóm trả lời một câu hỏi mà nhóm trước để lại, và các chương đi đúng theo thứ tự đó.
Bước đầu tiên là biểu diễn. Chương 2 bắt đầu từ một việc rất đơn giản, đếm xem hai từ cùng xuất hiện bao nhiêu lần, rồi đi tới word2vec và chỉ ra rằng word2vec thực chất làm cùng một việc với phép đếm đó.