7Lượng tử hóa một mạng nơ-ron hoàn chỉnh#
7.1Những gì được lượng tử#
| Thành phần | Kiểu thường dùng | Cách xác định dải |
|---|---|---|
| Trọng số | int8 đối xứng, per-channel | trực tiếp từ giá trị trọng số |
| Bias | int32, scale | suy ra, không cần dải |
| Activation | uint8/int8 bất đối xứng, per-tensor | cần dữ liệu (calibration) hoặc tính lúc chạy |
| Đầu vào, đầu ra mô hình | tùy cấu hình | đầu vào thường biết trước (ví dụ pixel ) |
Theo cách xử lý activation, có ba chế độ:
- Weight-only: chỉ nén trọng số; lúc chạy giải lượng tử trọng số về FP16/FP32 rồi tính. Lợi về bộ nhớ và băng thông, không lợi về tốc độ tính.
- Dynamic quantization: trọng số lượng tử sẵn; activation được lượng tử lúc chạy với dải tính từ chính tensor đó. Không cần dữ liệu calibration, nhưng tốn chi phí tìm min/max mỗi lần chạy.
- Static quantization: dải activation được cố định trước nhờ calibration. Nhanh nhất và là điều kiện để chạy thuần số nguyên như Hình 9.
7.2Mô phỏng lượng tử bằng nút fake-quant#
Trong thực tế, ta hiếm khi viết kernel số nguyên để thử nghiệm. Thay vào đó, ta chèn các nút FakeQuant vào đồ thị FP32 ở đúng những vị trí sẽ bị lượng tử khi triển khai:
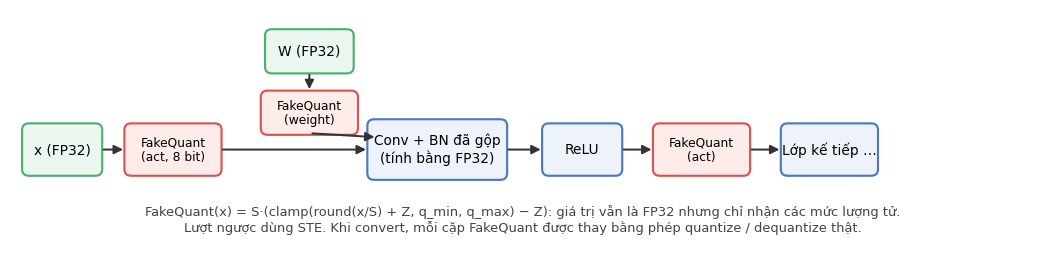
Mục 6.5 đã kiểm chứng rằng cách mô phỏng này cho kết quả trùng khớp với phép tính số nguyên thật. Đồ thị này được dùng cho cả hai việc: đánh giá PTQ và huấn luyện QAT (Chương 9).
7.3Gộp BatchNorm vào tích chập (BN folding)#
Khi suy luận, BatchNorm là một phép biến đổi affine cố định theo từng kênh:
Thế vào và nhóm lại, ta được một phép tích chập mới với trọng số và bias
trong đó phép nhân với áp dụng theo từng kênh đầu ra. Phải gộp BN trước khi lượng tử, vì trên phần cứng BN không tồn tại như một lớp riêng. Nếu lượng tử rồi mới gộp, trọng số thực sự chạy trên thiết bị là với dải khác hẳn. Đây cũng là nguyên nhân khiến dải giữa các kênh trở nên chênh lệch (Mục 5.3): hệ số khác nhau cho từng kênh.
def fold_bn(conv, bn):
    std = torch.sqrt(bn.running_var + bn.eps)
    w = conv.weight * (bn.weight / std).reshape(-1, 1, 1, 1)
    b0 = conv.bias if conv.bias is not None else torch.zeros_like(bn.running_mean)
    b = bn.weight * (b0 - bn.running_mean) / std + bn.bias
    fused = nn.Conv2d(conv.in_channels, conv.out_channels, conv.kernel_size,
                      conv.stride, conv.padding, groups=conv.groups, bias=True)
    fused.weight.data, fused.bias.data = w.detach().clone(), b.detach().clone()
    return fused
Trên mô hình thí nghiệm, sai khác lớn nhất giữa logit của mạng gốc và mạng đã gộp là , đúng bằng mức sai số làm tròn của FP32.
7.4Gộp lớp (layer fusion)#
Tổng quát hơn, các chuỗi như Conv → BN → ReLU hay Linear → ReLU được gộp thành một phép toán. Lợi ích: bớt các cặp quantize/dequantize trung gian (bớt sai số, bớt chi phí), và activation trung gian không bao giờ phải ghi ra bộ nhớ. Framework nào cũng có bước này (fuse_modules trong PyTorch eager mode, hoặc tự động trong trình chuyển đổi TFLite).
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1BatchNorm phải được gộp vào tích chập ở thời điểm nào?
Vì sao: Trên phần cứng BN không tồn tại như một lớp riêng. Nếu lượng tử rồi mới gộp thì trọng số thật sự chạy trên thiết bị là với dải khác hẳn. Đây cũng là nguyên nhân làm dải giữa các kênh chênh lệch, vì khác nhau theo kênh.2Nút fake-quant làm gì?
Vì sao: Đó là hàm hợp quantize → dequantize. Mục 6.5 đã kiểm chứng cách mô phỏng này trùng khớp từng bit với phép tính số nguyên thật, nên nó dự đoán đúng độ chính xác khi triển khai.3Chế độ nào không cần dữ liệu calibration?
Vì sao: Dynamic lượng tử activation lúc chạy với dải tính từ chính tensor đó. Đổi lại phải tốn chi phí tìm min/max mỗi lần chạy, và không chạy thuần số nguyên được như Hình 9.
Đã trả lời 0/3