8Calibration: chọn dải cho activation#
Trọng số đã biết trước, nhưng activation phụ thuộc đầu vào. Calibration là quá trình cho một tập dữ liệu nhỏ, gọi là representative dataset, chạy qua mô hình để thống kê phân phối activation tại từng điểm lượng tử, rồi chọn cho mỗi điểm.
8.1Các phương pháp#
-
Min–max: , trên toàn tập calibration. Không bao giờ cắt, nhưng rất nhạy với outlier (Hình 7).
-
Min–max trung bình trượt (EMA): cập nhật qua từng batch. Mặc định trong QAT.
-
Percentile: chọn bằng phân vị 99,9% hay 99,99%, chấp nhận cắt phần đuôi.
-
Tối thiểu MSE: tìm sao cho nhỏ nhất, thường bằng tìm kiếm lưới trên các ngưỡng ứng viên. Đây chính là bài toán cân bằng ở Mục 4.3.
-
Tối thiểu KL divergence (entropy calibration): phương pháp được NVIDIA TensorRT phổ biến (Migacz, 2017). Với mỗi ngưỡng ứng viên:
- Lập histogram tham chiếu gồm các bin bên trong ngưỡng, dồn toàn bộ phần bị cắt vào bin cuối.
- Gộp các bin của thành đúng số mức lượng tử để được , rồi trải đều lại trên các bin khác 0.
- Tính .
Ngưỡng cho nhỏ nhất được chọn. Ý tưởng là giữ cho phân phối sau lượng tử gần phân phối gốc nhất.
8.2Thí nghiệm#
Dùng 256 ảnh train làm tập calibration, lượng tử W4A4 (trọng số per-channel, lớp đầu và cuối giữ 8 bit):
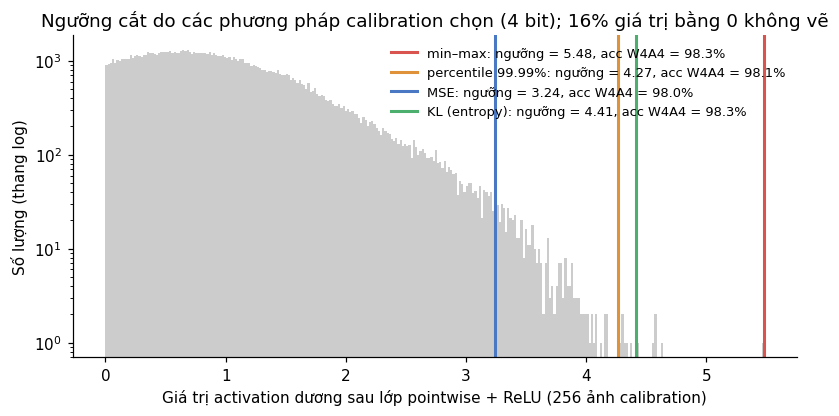
| Phương pháp | Ngưỡng (lớp pointwise, 4 bit) | Độ chính xác W8A8 | Độ chính xác W4A4 |
|---|---|---|---|
| Min–max | 5,48 | 99,26% | 98,33% |
| Percentile 99,99% | 4,27 | 99,26% | 98,15% |
| MSE | 3,24 | 99,26% | 97,96% |
| KL (entropy) | 4,41 | 99,07% | 98,33% |
Kết quả này cần đọc một cách trung thực:
- Các phương pháp chọn ngưỡng rất khác nhau (từ 3,24 đến 5,48), và MSE mạnh tay cắt nhất, đúng như lý thuyết ở Mục 4.3.
- Tuy vậy, với mô hình nhỏ và dễ này, độ chính xác gần như không đổi. Chênh lệch 0,37 điểm phần trăm chỉ tương ứng 2 ảnh trên 540 ảnh test, nằm trong mức dao động ngẫu nhiên.
- Ngưỡng tối ưu theo MSE của từng lớp riêng lẻ không bảo đảm độ chính xác toàn mạng cao nhất, vì sai số của các lớp tương tác với nhau.
Bài học thực hành: không có phương pháp calibration tốt nhất cho mọi trường hợp. Khác biệt trở nên đáng kể khi phân phối activation có đuôi dài (mô hình lớn, Transformer) hoặc khi số bit thấp. Nên thử vài phương pháp và chọn theo độ chính xác trên tập validation.
8.3Kinh nghiệm chuẩn bị tập calibration#
- Khoảng 100–1000 mẫu thường là đủ. Nhiều hơn ít khi cải thiện thêm.
- Mẫu phải đại diện cho phân phối lúc triển khai: đủ các lớp, đủ điều kiện ánh sáng, độ dài câu… Dữ liệu ngẫu nhiên hoặc chỉ một lớp sẽ cho dải sai.
- Tiền xử lý giống hệt lúc suy luận (chuẩn hóa, resize, tokenizer).
- Mô hình phải ở chế độ
eval(), để BatchNorm dùng thống kê đã học và Dropout tắt.
Tự kiểm tra
3 câu. Chọn đáp án để xem ngay lời giải thích.
1Tập calibration thường cần bao nhiêu mẫu?
Vì sao: Nhiều hơn 1000 ít khi cải thiện thêm. Quan trọng hơn số lượng là tính đại diện: đủ các lớp, đủ điều kiện, và tiền xử lý giống hệt lúc suy luận, với mô hình ở chế độeval().2Phương pháp calibration nào nhạy nhất với outlier?
Vì sao: Min–max lấy đúng giá trị lớn nhất nên chỉ một mẫu lạc cũng kéo dải ra rất rộng, làm bước nhảy thô cho toàn bộ phần còn lại.3Ý tưởng của calibration theo KL divergence (entropy) là gì?
Vì sao: Với mỗi ngưỡng ứng viên, ta lập histogram tham chiếu (dồn phần bị cắt vào bin cuối), gộp bin để được , rồi chọn ngưỡng cho nhỏ nhất.
Đã trả lời 0/3