5Độ mịn của tham số lượng tử (granularity)#
5.1Ba mức độ mịn#
Một tensor có thể dùng chung một cặp hoặc chia nhỏ thành nhiều nhóm, mỗi nhóm một cặp riêng:
- Per-tensor: một cặp cho cả tensor. Đơn giản nhất, nhưng một kênh có giá trị lớn sẽ ép mọi kênh khác dùng bước nhảy thô.
- Per-channel (per-axis): mỗi kênh đầu ra của trọng số có riêng. Đây là mặc định cho trọng số của Conv và Linear trong TFLite và PyTorch hiện nay.
- Per-group (per-block): chia mỗi hàng trọng số thành các nhóm liên tiếp 32, 64 hoặc 128 phần tử. Đây là chuẩn cho lượng tử 4 bit của LLM (Chương 11).
Độ mịn càng cao thì sai số càng nhỏ, nhưng phải lưu và xử lý nhiều scale hơn.
5.2Vì sao per-channel phải theo trục đầu ra#
Đây là điểm tinh tế, quyết định việc tính toán có còn thuần số nguyên được hay không. Xét (tổng chạy theo trục đầu vào ).
- Nếu scale trọng số phụ thuộc kênh đầu ra : , thì . Scale đưa được ra ngoài tổng, nên phần tổng là thuần số nguyên.
- Nếu scale phụ thuộc kênh đầu vào : . Scale nằm bên trong tổng, phải nhân số thực cho từng phần tử, và lợi ích số nguyên mất đi.
Cùng lập luận giải thích vì sao activation không được lượng tử theo kênh (kênh của activation chính là trục bị lấy tổng), nhưng lại có thể lượng tử theo token: với ma trận activation có hàng là token , scale đưa ra ngoài tổng được. Chính ràng buộc này sinh ra bài toán outlier trong LLM (Mục 11.2–11.3).
5.3Thí nghiệm#
Tài liệu dùng một CNN nhỏ gồm Conv–BN–ReLU, một lớp depthwise (giống MobileNet), một lớp pointwise và một lớp Linear, huấn luyện trên bộ chữ số viết tay 8×8 của scikit-learn (1257 ảnh train, 540 ảnh test). Độ chính xác FP32 là 99,26%. Sau khi gộp BatchNorm vào Conv (Mục 7.3), ta chỉ lượng tử trọng số, giữ activation ở FP32, để cô lập ảnh hưởng của granularity:
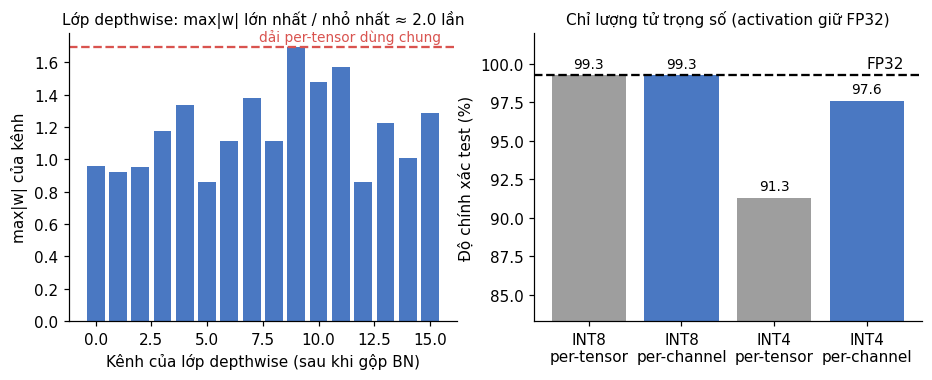
| INT8 per-tensor | INT8 per-channel | INT4 per-tensor | INT4 per-channel | |
|---|---|---|---|---|
| Độ chính xác | 99,26% | 99,26% | 91,30% | 97,59% |
| MSE lớp depthwise |
Ở 8 bit, bước nhảy đủ mịn nên granularity không đáng kể. Ở 4 bit, per-channel giữ lại hơn 6 điểm phần trăm, dù trong mô hình nhỏ này dải giữa các kênh chỉ chênh nhau khoảng 2 lần. Với MobileNetV2 thật, sau khi gộp BN dải trọng số giữa các kênh của lớp depthwise chênh lệch rất lớn, khiến lượng tử per-tensor 8 bit làm độ chính xác sụp đổ. Hiện tượng này được phân tích kỹ trong Nagel và cộng sự (2019, Hình 2) và là động lực cho kỹ thuật cân bằng giữa các lớp ở Mục 9.5.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao scale per-channel của trọng số phải đặt theo trục đầu ra?
Vì sao: Với , scale phụ thuộc thì rút ra ngoài được; phụ thuộc thì nằm kẹt bên trong và phải nhân số thực cho từng phần tử.2Phát biểu nào chặt nhất về việc lượng tử activation theo kênh?
Vì sao: Ràng buộc nằm ở trục, không ở tensor. Chấp nhận tách tổng thành từng nhóm (per-group) là đặt được scale trên trục thu gọn — đó là cách lượng tử 4 bit cho LLM vẫn chạy. Depthwise convolution thì kênh đầu vào không hề bị lấy tổng nên miễn phí luôn. Cái không làm được là có scale activation theo kênh miễn phí trong một GEMM chuẩn — và đúng ràng buộc đó sinh ra bài toán outlier của LLM (Mục 11.1).3Vì sao lượng tử per-group (nhóm 32–128) đặt được scale trên trục thu gọn?
Vì sao: Cái giá phải trả là một phép nhân scale cho mỗi nhóm thay vì mỗi kênh đầu ra — chấp nhận được khi nhóm đủ lớn. Đây là lý do "mô hình 4 bit" của LLM tốn 4,125–4,5 bit mỗi trọng số (Mục 11.8) chứ không phải đúng 4.4Trong thí nghiệm Mục 5.3, granularity ảnh hưởng ra sao ở 8 bit so với 4 bit?
Vì sao: Ở 8 bit bước nhảy đã đủ mịn nên chênh lệch dải giữa các kênh không kịp gây hại. Ở 4 bit (91,30% so với 97,59%) thì có.
Đã trả lời 0/4