Chương này trả lời câu hỏi: vì sao INT8 không chỉ nhẹ hơn mà còn nhanh hơn? Nội dung dựa theo Jacob và cộng sự (2018), nền tảng của cơ chế lượng tử trong TFLite.
Bias được lưu dạng int32 với scale SwSx và zero-point 0: qb=⌊b/(SwSx)⌉. Nhờ cùng scale với bộ cộng dồn, nó được cộng thẳng vào kết quả int32 mà không cần đổi đơn vị. Bias dùng 32 bit vì nó ít tham số nhưng ảnh hưởng trực tiếp lên mọi đầu ra, và vì bước SwSx rất nhỏ.
6.4Requantization: nhân với số thực mà không dùng số thực#
Hệ số M=SwSx/Sy là số thực. Thực nghiệm cho thấy M gần như luôn nằm trong (0,1). Ta viết
M=2−nM0,M0∈[0,5;1),
rồi lưu M0 dưới dạng số nguyên 32 bit dấu chấm tĩnh: M0int=⌊M0⋅231⌉. Phép nhân với M trở thành một phép nhân số nguyên 64 bit và một phép dịch phải có làm tròn:
acc⋅M≈(acc⋅M0int)≫(31+n).
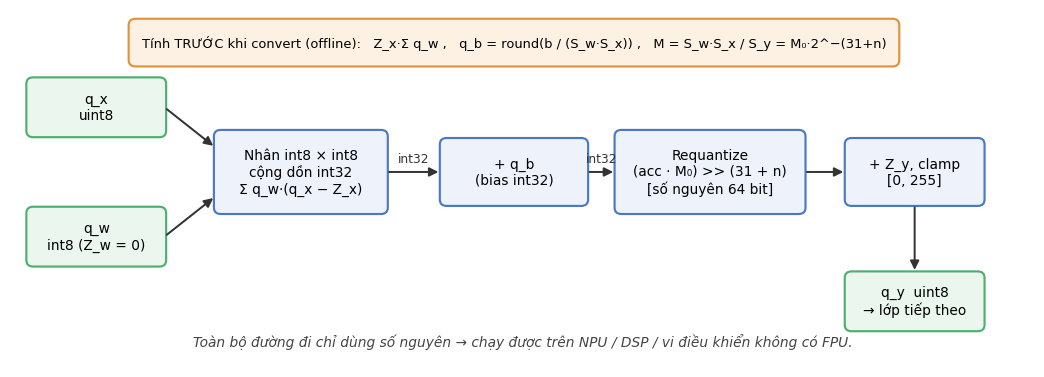
Cuối cùng cộng Zy và cắt về [0,255]. Toàn bộ quy trình được tóm tắt trong Hình 9.
Hình 9. Luồng dữ liệu của một lớp Linear/Conv chạy hoàn toàn bằng số nguyên. Hộp màu cam là các đại lượng tính trước khi triển khai.
Hàm kích hoạt ReLU được "gộp miễn phí": nếu dải đầu ra được calibrate sau ReLU thì αy=0, suy ra Zy=qmin, và phép cắt ở bước cuối tự động thực hiện ReLU. ReLU6 tương tự với cận trên. Các hàm phi tuyến phức tạp hơn (sigmoid, softmax, GELU) thường dùng bảng tra hoặc được tính ở độ chính xác cao hơn.
Đoạn mã sau cài đặt đúng quy trình Hình 9 bằng NumPy cho một lớp Linear 256→64 và so sánh với cách mô phỏng bằng số thực (trích từ code/numpy_experiments.py):
Python
defquantize_multiplier(M):
"""Viết M (0 < M < 1) dưới dạng M0 * 2^-(31 + shift), với M0 là int32 trong [2^30, 2^31)."""
shift = 0while M < 0.5:
M *= 2; shift += 1
M0 = int(round(M * (1 << 31)))
if M0 == (1 << 31):
M0 //= 2; shift -= 1return M0, shift
defrounding_right_shift(x, n): # chia cho 2^n, làm tròn gần nhấtreturn (x + (1 << (n - 1))) >> n
# X: activation (uint8 bất đối xứng), W: trọng số (int8 đối xứng), b: bias
q_x = np.clip(np.round(X / S_x) + Z_x, 0, 255).astype(np.int32)
q_w = np.clip(np.round(W / S_w), -127, 127).astype(np.int32)
q_b = np.round(b / (S_w * S_x)).astype(np.int32)
acc = q_x @ q_w.T - Z_x * q_w.sum(axis=1) + q_b # int32; q_w.sum tính trước được
M0, shift = quantize_multiplier(S_w * S_x / S_y)
q_y = np.clip(Z_y + rounding_right_shift(acc.astype(np.int64) * M0, 31 + shift), 0, 255)
Kết quả (code/numpy_experiments_output.txt):
Kết quả chạy
S_x=0.038963 Z_x=106 | S_w=0.001661 | S_y=0.031995 Z_y=120
M = 0.0020223740 = 1111811840 * 2^-(31+8) -> 0.0020223740
max |q_y(integer) - q_y(float sim)| = 0 LSB; tỉ lệ khác nhau: 0.0000%
sai số tương đối so với FP32: 1.6085%
max |acc| = 66876 ; giới hạn int16 = 32767 ; cận trên lý thuyết 255*127*K = 8290560
Ba điều rút ra:
Đường tính toán thuần số nguyên cho kết quả trùng khớp từng bit với cách mô phỏng bằng số thực. Đây là lý do mô phỏng fake quantization (Chương 7) dự đoán đúng độ chính xác của mô hình khi triển khai.
Sai số so với FP32 khoảng 1,6%, hoàn toàn do lượng tử chứ không do phép tính số nguyên.
Giá trị cộng dồn lên tới 66 876, vượt giới hạn int16. Đó là lý do bộ cộng dồn phải là int32. Cận trên lý thuyết 8,3×10⁶ vẫn nằm rất xa giới hạn int32 (≈2,1×10⁹).
Khi dùng per-channel cho trọng số, mỗi kênh đầu ra j có hệ số Mj=Sw,jSx/Sy riêng, còn lại mọi thứ giữ nguyên.
Tự kiểm tra
7 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao bộ cộng dồn trong phép nhân ma trận INT8 phải là int32?
Vì sao: Giới hạn int16 là 32 767. Cận trên lý thuyết 255×127×K=8,3×10⁶ vẫn nằm rất xa giới hạn int32 (≈2,1×10⁹), nên int32 là lựa chọn vừa đủ.
2Trọng số lượng tử đối xứng (Zw=0) mang lại lợi ích tính toán gì?
Vì sao: Số hạng Zw∑kqx,k phụ thuộc đầu vào nên phải tính lúc chạy; bỏ được nó là bỏ hẳn một lượt quét toàn bộ ma trận activation. Đây là lý do kỹ thuật khiến trọng số gần như luôn đối xứng.
3Bias được lưu như thế nào trong đường tính toán số nguyên?
Vì sao: Nhờ cùng scale với bộ cộng dồn, bias cộng thẳng vào kết quả int32 mà không cần đổi đơn vị. Nó dùng 32 bit vì rất ít tham số nhưng ảnh hưởng trực tiếp lên mọi đầu ra.
4Requantization nhân với hệ số thực M bằng cách nào mà không dùng số thực?
Vì sao:M0int=⌊M0⋅231⌉ và acc⋅M≈(acc⋅M0int)≫(31+n). Toàn bộ đường đi vẫn thuần số nguyên nên chạy được trên NPU/DSP không có FPU.
5Đoạn mã quantize_multiplier ở Mục 6.4 dùng được cho hệ số M nào?
Vì sao: Vòng lặp while M < 0.5 chỉ chuẩn hoá lên. Cài đặt thật (QuantizeMultiplier của gemmlowp/TFLite) cho phép shiftâm, tức một phép dịch trái, nên mọi M>0 đều xử lý được; chỉ cần thêm while M >= 1: M /= 2; shift -= 1. Xem ghi chú Mục 6.4.
6Hàm dịch phải có làm tròn trong Mục 6.4 xử lý giá trị âm theo quy ước nào?
Vì sao:>> của Python là dịch số học, tương đương lấy sàn, nên (x+2n−1)≫n làm tròn nửa lên. Hai quy ước chỉ khác nhau ở đúng điểm giữa của giá trị âm: −6/4 cho −1 ở đây nhưng −2 ở gemmlowp. Lệch tối đa 1 LSB — vô hại với lập luận của chương, nhưng phải khớp nếu bạn cần kết quả trùng từng bit với một backend cụ thể.
7Kết quả "trùng khớp từng bit" ở Mục 6.5 chứng minh điều gì?
Vì sao: Đây là phép tự đối chiếu giữa đường số nguyên và bản mô phỏng số thực của cùng một tác giả, không phải phép đối chiếu với TFLite hay ONNX Runtime. Mức khớp với backend thật còn phụ thuộc quy ước làm tròn, độ chính xác bước requantization, cách gộp lớp và op nào rơi về FP32 — nên mục 8 của danh sách kiểm tra (Mục 12.3) vẫn bắt buộc đo trên thiết bị đích.