9PTQ và QAT#
9.1Post-Training Quantization (PTQ)#
PTQ lượng tử mô hình đã huấn luyện xong, không cập nhật trọng số bằng gradient (hoặc chỉ tối ưu cục bộ một ít như AdaRound). Quy trình: gộp lớp → lượng tử trọng số → calibration activation → chuyển đổi. Ưu điểm là nhanh (vài phút), không cần nhãn, không cần pipeline huấn luyện. Với mô hình đủ lớn, INT8 PTQ thường chỉ làm giảm dưới 1 điểm phần trăm độ chính xác.
9.2Quantization-Aware Training (QAT)#
QAT tiếp tục huấn luyện (fine-tune) mô hình với các nút fake-quant trong đồ thị (Hình 10). Nhờ thấy được sai số lượng tử ngay trong lượt xuôi, mạng học cách điều chỉnh trọng số để bù lại.
Vấn đề gradient. Hàm làm tròn là hàm bậc thang: đạo hàm của nó bằng 0 ở hầu khắp nơi và không xác định tại các bước nhảy. Nếu dùng đạo hàm thật, gradient truyền về trọng số luôn bằng 0 và mạng không học được gì.
Straight-Through Estimator (STE) (Bengio và cộng sự, 2013) giải quyết bằng cách, trong lượt ngược, coi phép làm tròn như hàm đồng nhất:
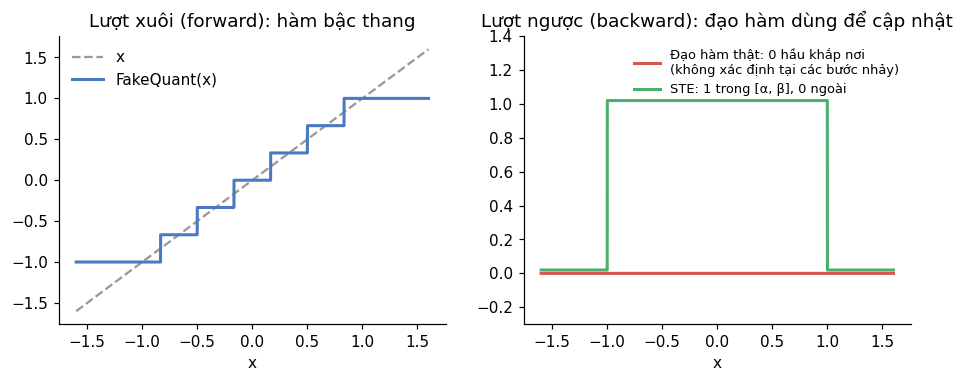
Trong PyTorch, STE viết gọn bằng một dòng: x_hat = x + (fake_quant(x) - x).detach(). Giá trị trả về bằng fake_quant(x), nhưng gradient đi qua như thể hàm là x.
Học cả scale. Thay vì cố định dải bằng EMA, phương pháp LSQ (Esser và cộng sự, 2020) coi là tham số huấn luyện được. Với lượng tử đối xứng , đạo hàm theo (vẫn dùng STE cho phép làm tròn) là
BatchNorm trong QAT. Nếu huấn luyện với BN riêng rồi mới gộp, trọng số được fake-quant không phải trọng số thật sẽ chạy trên thiết bị. Cách chuẩn (Jacob và cộng sự, 2018; Krishnamoorthi, 2018) là mô phỏng việc gộp BN ngay trong lúc huấn luyện, và đóng băng thống kê BN sau một số epoch để ổn định. fuse_modules_qat trong PyTorch thực hiện việc này. Thí nghiệm dưới đây đơn giản hóa bằng cách gộp BN trước rồi fine-tune mạng đã gộp.
9.3Thí nghiệm: PTQ và QAT theo độ rộng bit#
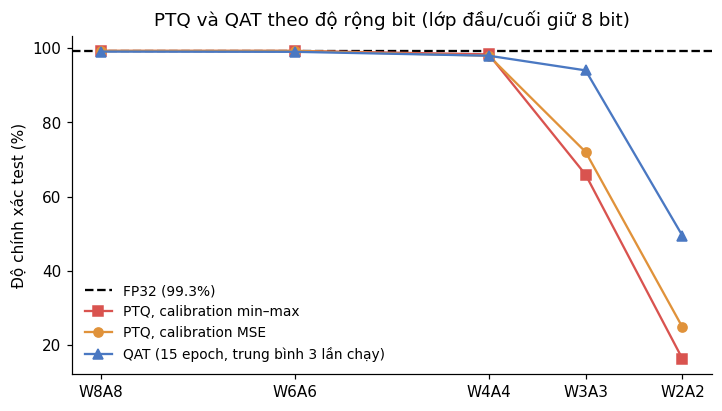
Cấu hình: trọng số per-channel đối xứng, activation per-tensor bất đối xứng, lớp đầu và cuối giữ 8 bit (thực hành phổ biến vì đây là hai lớp nhạy cảm nhất). QAT khởi tạo từ dải của PTQ (MSE), dùng EMA cho dải activation, STE, Adam với learning rate trong 15 epoch, lấy trung bình 3 lần chạy.
| W8A8 | W6A6 | W4A4 | W3A3 | W2A2 | |
|---|---|---|---|---|---|
| PTQ, min–max | 99,26% | 99,26% | 98,33% | 65,93% | 16,30% |
| PTQ, MSE | 99,26% | 99,26% | 97,96% | 72,04% | 24,81% |
| QAT | 99,07% | 99,01% | 97,96% | 94,01% | 49,44% |
(FP32: 99,26%. Mỗi ảnh test tương ứng 0,19 điểm phần trăm.)
Nhận xét:
- Từ 4 bit trở lên, PTQ đã đủ cho mô hình này. QAT không cải thiện thêm; sai khác 0,2 điểm ở 8 bit là 1 ảnh, nằm trong dao động ngẫu nhiên.
- Dưới 4 bit, PTQ sụp đổ (còn 66–72% ở 3 bit), trong khi QAT giữ được 94%. Đây là khoảng mà QAT thực sự đáng giá.
- Ở 2 bit, ngay cả QAT cũng mất nhiều độ chính xác. Muốn đi xa hơn cần kỹ thuật chuyên biệt (học scale kiểu LSQ, huấn luyện lâu hơn, chưng cất tri thức từ mô hình FP32).
Quy luật này khớp với kinh nghiệm chung: mô hình càng nhỏ, càng "gọn" (MobileNet, EfficientNet-Lite) hoặc số bit càng thấp thì càng cần QAT.
9.4Nên chọn PTQ hay QAT#
| Tiêu chí | PTQ | QAT |
|---|---|---|
| Cần dữ liệu có nhãn | Không (chỉ cần vài trăm mẫu calibration) | Có |
| Chi phí | Vài phút | Một phần đáng kể của chi phí huấn luyện |
| Độ chính xác ở INT8 | Thường đủ tốt | Tốt nhất |
| Độ chính xác ở ≤ 4 bit | Thường giảm mạnh (trừ các kỹ thuật chuyên biệt ở Chương 11) | Giữ được tốt hơn nhiều |
Luôn bắt đầu bằng PTQ; chỉ chuyển sang QAT khi PTQ và các cải tiến ở Mục 9.5 không đạt yêu cầu.
9.5Các kỹ thuật PTQ nâng cao#
Giữa PTQ cơ bản và QAT có một nhóm kỹ thuật chỉ cần dữ liệu không nhãn hoặc không cần dữ liệu:
Cân bằng giữa các lớp (Cross-Layer Equalization, CLE) (Nagel và cộng sự, 2019). Với hai lớp liên tiếp có ReLU ở giữa, do với , ta có thể chia kênh của lớp thứ nhất cho và nhân kênh đầu vào của lớp thứ hai với mà đầu ra không đổi. Gọi , là dải trọng số kênh ở hai lớp. Chọn
thì dải của kênh ở cả hai lớp đều bằng , khiến các kênh đồng đều hơn và lượng tử per-tensor tốt hơn hẳn. Kỹ thuật này không cần dữ liệu. SmoothQuant (Mục 11.3) dùng đúng ý tưởng này giữa activation và trọng số.
Bias correction. Sai số lượng tử trọng số làm đầu ra lệch trung bình một lượng . Nếu ước lượng được (từ dữ liệu, hoặc từ tham số BN của lớp trước), ta bù lại: .
AdaRound (Nagel và cộng sự, 2020). Làm tròn đến số gần nhất tối ưu cho từng trọng số nhưng không tối ưu cho đầu ra của lớp. AdaRound học quyết định làm tròn lên hay xuống cho mỗi trọng số bằng cách tối ưu
trong đó là một hàm sigmoid chỉnh sửa, và đẩy về đúng 0 hoặc 1. Chỉ cần vài trăm hoặc vài nghìn mẫu không nhãn, AdaRound thường đưa PTQ 4 bit trọng số tiến gần QAT. GPTQ (Mục 11.4) theo đuổi cùng mục tiêu "tối thiểu sai số đầu ra thay vì sai số trọng số".
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Straight-Through Estimator giải quyết vấn đề gì?
Vì sao: Nếu dùng đạo hàm thật, gradient về trọng số luôn bằng 0 và mạng không học được gì. STE đặt bên trong dải và 0 ở vùng bị cắt. Trong PyTorch viết gọn:x + (fake_quant(x) - x).detach().2Ở W8A8, QAT so với PTQ như thế nào trong thí nghiệm Mục 9.3?
Vì sao: PTQ 99,26% so với QAT 99,07%; chênh 0,19 điểm đúng bằng 1 ảnh trên 540 ảnh test. Quy tắc: luôn bắt đầu bằng PTQ.3Ở W3A3, kết quả ra sao?
Vì sao: Đây chính là khoảng mà QAT thực sự đáng giá. Ở 2 bit thì ngay cả QAT cũng chỉ còn 49,44%, cần thêm kỹ thuật chuyên biệt như học scale kiểu LSQ hoặc chưng cất tri thức.4Cross-Layer Equalization dựa trên tính chất nào của ReLU?
Vì sao: Nhờ tính thuần nhất dương đó, ta chia kênh của lớp trước cho và nhân kênh đầu vào của lớp sau với mà đầu ra không đổi. Chọn khéo thì dải giữa các kênh đồng đều hơn. SmoothQuant dùng đúng ý tưởng này.
Đã trả lời 0/4