Quantization trong Deep Learning: từ nguyên lý đến thực hành
Toàn bộ giáo trình trên một trang — tiện cho Ctrl+F, đọc ngoại tuyến hoặc in ra giấy.
Giáo trình tự học, viết theo lối bài giảng
Mỗi khái niệm được trình bày theo trình tự động cơ → định nghĩa → suy luận → ví dụ số → thí nghiệm kiểm chứng.
Về độ tin cậy của hình và số liệu. Tất cả 17 hình và mọi con số thực nghiệm trong tài liệu được sinh ra bởi mã nguồn trong thư mục
code/, chạy thật và có thể chạy lại. Duy nhất Hình 1 dùng số liệu đã công bố của Horowitz (ISSCC 2014). Hình vẽ lại thay vì lấy từ bài viết khác, để bảo đảm từng chi tiết khớp với công thức trong bài. Môi trường chạy: Python 3.12, NumPy 2.4, PyTorch 2.14 (CPU), torchao 0.18, scikit-learn 1.8, CPU Intel Xeon 2.1 GHz (có AVX-512 VNNI và AMX-INT8), 1 luồng.
0Kiến thức nền và quy ước ký hiệu#
Người đọc cần biết: đại số tuyến tính cơ bản (nhân ma trận), cách một mạng CNN/Transformer tính toán, lan truyền ngược, và Python/NumPy/PyTorch ở mức đọc hiểu.
| Ký hiệu | Ý nghĩa |
|---|---|
| một số thực (FP32) cần lượng tử: trọng số, activation hoặc bias | |
| số nguyên tương ứng sau lượng tử | |
| giá trị thực khôi phục lại từ (dequantize) | |
| số bit của kiểu số nguyên (bit-width) | |
| miền số nguyên, ví dụ cho uint8, cho int8 | |
| dải số thực được ánh xạ (clipping range) | |
| scale: bước nhảy giữa hai mức lượng tử liền kề, | |
| zero-point: số nguyên ứng với số thực 0 | |
| phép làm tròn đến số nguyên gần nhất | |
| W8A8, W4A16… | trọng số 8 bit và activation 8 bit; trọng số 4 bit và activation 16 bit… |
1Vì sao cần quantization#
1.1Chi phí bộ nhớ#
Kích thước lưu trữ của một mô hình xấp xỉ bằng số tham số × số byte mỗi tham số. Số tham số không đổi khi lượng tử hóa; chỉ số byte mỗi tham số thay đổi.
| Mô hình | Số tham số | FP32 | FP16 / BF16 | INT8 | INT4 |
|---|---|---|---|---|---|
| ResNet-50 | 25,6 triệu | 102 MB | 51 MB | 25,6 MB | 12,8 MB |
| LLM 7 tỉ tham số | 7 tỉ | 28 GB | 14 GB | 7 GB | 3,5 GB |
Bảng trên chưa tính phần phụ trội nhỏ để lưu các scale (xem Mục 11.8). Với LLM, con số này quyết định mô hình có vừa bộ nhớ GPU hay điện thoại hay không.
1.2Chi phí năng lượng#
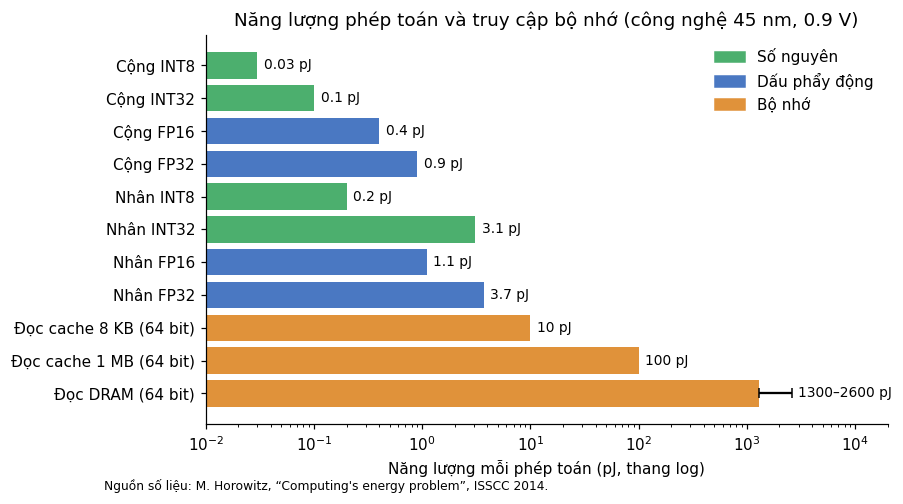
Có hai nhận xét quan trọng từ Hình 1:
- Phép toán số nguyên rẻ hơn dấu phẩy động nhiều lần. Một phép cộng INT8 (0,03 pJ) rẻ hơn khoảng 30 lần so với phép cộng FP32 (0,9 pJ). Một phép nhân INT8 (0,2 pJ) rẻ hơn khoảng 18 lần so với phép nhân FP32 (3,7 pJ).
- Di chuyển dữ liệu đắt hơn tính toán rất nhiều. Đọc 64 bit từ DRAM tốn 1300–2600 pJ, tức gấp hàng trăm lần một phép nhân FP32. Vì vậy, giảm số byte phải đọc từ bộ nhớ thường mang lại lợi ích lớn hơn việc tính toán rẻ hơn.
1.3Tốc độ: bài toán bị giới hạn bởi tính toán hay bởi bộ nhớ#
Một phép toán trên phần cứng bị chặn bởi một trong hai giới hạn:
- Compute-bound (giới hạn bởi tính toán): ví dụ nhân hai ma trận lớn với batch lớn. Lượng tử hóa giúp nhanh hơn vì các đơn vị tính số nguyên có thông lượng cao hơn. Trên nhiều GPU, thông lượng tensor core INT8 gấp đôi FP16.
- Memory-bound (giới hạn bởi băng thông bộ nhớ): ví dụ sinh từng token của LLM với batch nhỏ. Mỗi trọng số được đọc một lần nhưng chỉ tham gia rất ít phép tính. Lúc này, chỉ cần nén trọng số (weight-only quantization) là đã nhanh hơn gần tỉ lệ với mức nén, kể cả khi phép nhân vẫn làm bằng FP16.
Khái niệm định lượng cho sự phân biệt này là cường độ số học (arithmetic intensity) = số phép toán / số byte đọc ghi. Mô hình roofline so sánh đại lượng này với tỉ số giữa thông lượng tính toán và băng thông bộ nhớ của phần cứng.
1.4Cái giá phải trả#
Lượng tử hóa là phép nén có mất mát (lossy). Nó gây sai số, và sai số này có thể làm giảm độ chính xác của mô hình. Ngoài ra, lợi ích tốc độ chỉ xuất hiện khi phần cứng và thư viện có kernel số nguyên tương ứng. Nếu không, mô hình chỉ nhẹ hơn chứ không nhanh hơn, thậm chí chậm hơn (ví dụ thực tế ở Mục 10.1.5). Toàn bộ phần còn lại của tài liệu xoay quanh câu hỏi: làm sao giảm số bit mà sai số gây ra là nhỏ nhất?
2Máy tính biểu diễn số như thế nào#
Để hiểu quantization làm gì, trước hết phải hiểu dữ liệu vốn được lưu thế nào.
2.1Số nguyên#
Với bit:
- Không dấu (unsigned): biểu diễn . Ví dụ uint8: .
- Có dấu, dạng bù hai (two's complement): biểu diễn . Ví dụ int8: ; int4: .
Các số nguyên liền kề cách nhau đúng 1 đơn vị ở mọi vị trí. Ta nói số nguyên có độ chính xác tuyệt đối đều.
2.2Số dấu phẩy động theo chuẩn IEEE 754#
Một số dấu phẩy động gồm ba trường: bit dấu , phần mũ (exponent) và phần định trị (mantissa). Với số chuẩn hóa (normal), giá trị là
Chữ số 1 đứng trước dấu chấm là bit ẩn: nó không được lưu nhưng luôn có mặt, nên mantissa bit cho độ chính xác bit. Khi ta có số dưới chuẩn (subnormal) , cho phép biểu diễn các số rất gần 0.
Đoạn mã sau tách ba trường của một số FP32:
import struct

def fp32_fields(x):
    bits = struct.unpack(">I", struct.pack(">f", x))[0]
    s = f"{bits:032b}"
    return s[0], s[1:9], s[9:], int(s[1:9], 2) - 127   # dấu, exponent, mantissa, số mũ thật

for x in [1993.0, 0.1, -6.5]:
    print(x, fp32_fields(x))
1993.0 ('0', '10001001', '11110010010000000000000', 10)
0.1    ('0', '01111011', '10011001100110011001101', -4)
-6.5   ('1', '10000001', '10100000000000000000000', 2)
Diễn giải kết quả:
- . Exponent lưu ; mantissa lưu 10 chữ số sau dấu chấm, phần còn lại là số 0. Như vậy không có "bit dành cho phần nguyên" hay "bit dành cho dấu phẩy": vị trí dấu chấm được mã hóa gián tiếp qua số mũ.
- có biểu diễn nhị phân vô hạn tuần hoàn (), nên FP32 chỉ lưu được một giá trị xấp xỉ. Bản thân FP32 đã là một phép lượng tử hóa của tập số thực.
2.3Các kiểu dữ liệu dùng trong deep learning#
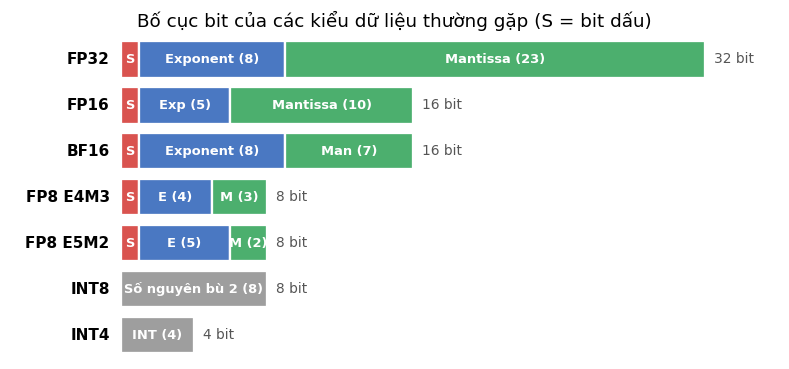
| Kiểu | Exp / Man | Bias | Giá trị lớn nhất | Số chuẩn nhỏ nhất | máy |
|---|---|---|---|---|---|
| FP32 | 8 / 23 | 127 | |||
| FP16 | 5 / 10 | 15 | |||
| BF16 | 8 / 7 | 127 | |||
| FP8 E4M3 (OCP) | 4 / 3 | 7 | |||
| FP8 E5M2 | 5 / 2 | 15 |
máy là khoảng cách từ 1 đến số biểu diễn được kế tiếp lớn hơn 1. Nó đo độ chính xác tương đối.
Nhận xét:
- FP16 có dải hẹp (tối đa 65 504), dễ tràn số khi huấn luyện. BF16 giữ nguyên 8 bit exponent của FP32 nên có cùng dải, đổi lại mantissa ngắn hơn. Đây là lý do BF16 được ưa dùng để huấn luyện.
- FP8 có hai biến thể (Micikevicius và cộng sự, 2022). E4M3 chính xác hơn, thường dùng cho trọng số và activation. E5M2 có dải rộng hơn, thường dùng cho gradient. Biến thể E4M3 của chuẩn OCP bỏ giá trị vô cực và chỉ giữ một mã NaN để nâng giá trị lớn nhất lên 448.
Có thể quan sát trực tiếp hiệu ứng làm tròn và tràn số của FP16:
import numpy as np
print(np.float16(1993.0), np.float16(1993.5), np.float16(2049.0), np.float16(70000.0))
# 1993.0  1994.0  2048.0  inf
Trong khoảng , các số FP16 cách nhau 1, nên được làm tròn về số chẵn gần nhất là . Trong khoảng khoảng cách là 2, nên . Còn vượt quá nên thành vô cực.
2.4Khác biệt cốt lõi: độ chính xác tương đối và tuyệt đối#
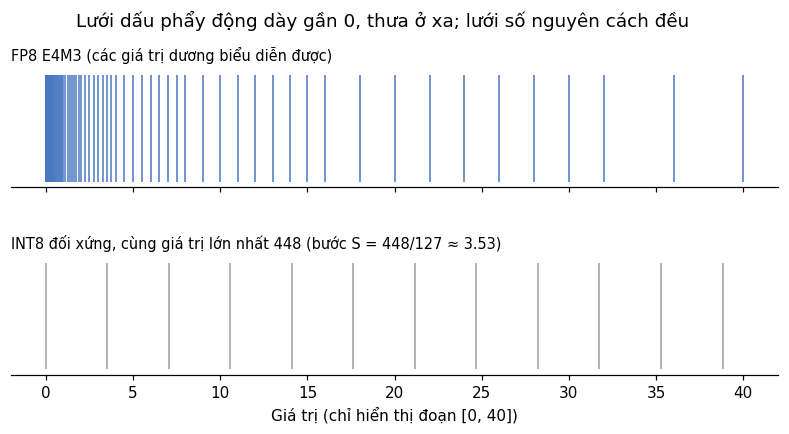
Số dấu phẩy động có lưới dày gần 0 và thưa dần khi ra xa: sai số tương đối xấp xỉ không đổi. Số nguyên có lưới cách đều: sai số tuyệt đối không đổi. Do đó, muốn dùng số nguyên để biểu diễn số thực, ta phải chọn khéo vị trí và độ rộng của lưới cách đều ấy sao cho khớp với dữ liệu. Đó chính là vai trò của hai tham số và trong chương sau.
3Uniform affine quantization: công thức cốt lõi#
3.1Định nghĩa#
Trong xử lý tín hiệu, lượng tử hóa là ánh xạ từ một tập giá trị lớn (thường liên tục) vào một tập hữu hạn nhỏ hơn. Trong deep learning, dạng phổ biến nhất là lượng tử hóa đều (uniform): tập đích gồm các điểm cách đều nhau. Dạng đều được ưa chuộng vì nó cho phép tính toán trực tiếp bằng phép toán số nguyên (Chương 6). Các dạng không đều như NF4 (Mục 11.5) cho sai số nhỏ hơn với cùng số bit, nhưng thường phải giải mã về số thực trước khi tính.
3.2Suy ra công thức#
Ta muốn một ánh xạ tuyến tính từ đoạn số thực vào đoạn số nguyên , với và . Mọi ánh xạ tuyến tính (chính xác hơn là affine) một biến có dạng . Thế hai điều kiện đầu mút vào:
Trừ vế theo vế rồi giải ra , sau đó thế lại để tìm :
được làm tròn để là số nguyên (lý do ở Mục 3.4). Thêm phép làm tròn cho và phép cắt cho các giá trị nằm ngoài dải, ta được cặp công thức cơ bản:
Hàm hợp gọi là fake quantization (hay quantize–dequantize). Nó cho giá trị vẫn là số thực nhưng chỉ nhận các giá trị trên lưới lượng tử. Hàm này đóng vai trò trung tâm trong mô phỏng và huấn luyện (Chương 7, 9).
3.3Ví dụ tính tay#
Lượng tử hóa dải sang uint8, tức :
- .
- .
- Lấy : .
- Khôi phục: . Sai số , nhỏ hơn .
- Lấy : , và chính xác tuyệt đối.
Để nhìn rõ hình dạng của phép lượng tử hóa, Hình 4 dùng cùng dải nhưng chỉ 3 bit (), để các bậc thang đủ lớn.
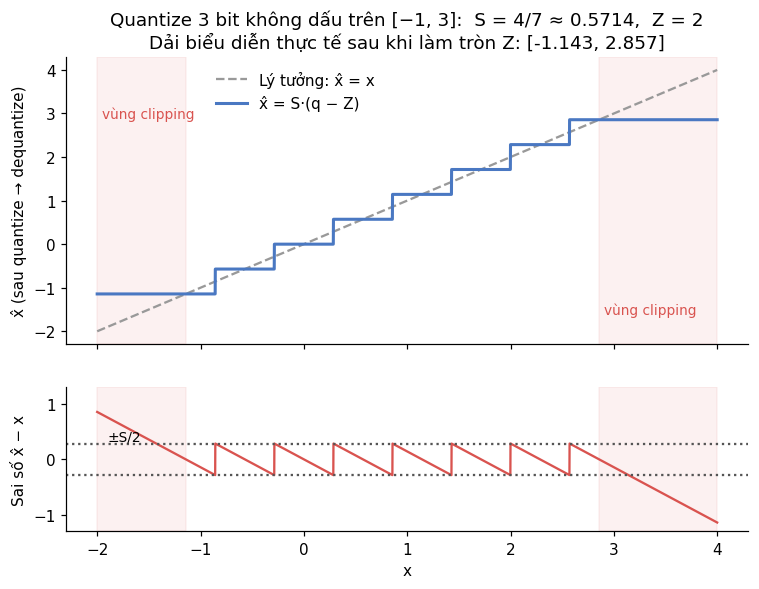
Hình 4 còn cho thấy một chi tiết hay bị bỏ qua. Vì bị làm tròn, dải thực sự biểu diễn được là , lệch nhẹ so với dải ban đầu. Với 8 bit, độ lệch này nhỏ hơn nhiều nhưng vẫn tồn tại.
3.4Vì sao số 0 phải được biểu diễn chính xác#
Số 0 xuất hiện với tần suất rất cao trong mạng nơ-ron: vùng zero-padding của phép tích chập, đầu ra âm bị ReLU đưa về 0, các phần tử bị mask trong attention. Nếu số 0 bị biểu diễn lệch thành một giá trị , sai số này không ngẫu nhiên mà có hệ thống và cộng dồn qua hàng nghìn phần tử trong một tổng. Bắt là số nguyên bảo đảm . Cũng vì lý do này, dải luôn được mở rộng để chứa số 0: .
3.5Lượng tử đối xứng và bất đối xứng#
Bất đối xứng (asymmetric, affine): dùng đúng công thức ở trên, tùy ý.
Đối xứng (symmetric): ép và dùng dải đối xứng quanh 0, với . Thường dùng miền số nguyên hạn chế , ví dụ cho int8, bỏ giá trị để lưới đối xứng hoàn hảo:
| Bất đối xứng | Đối xứng | |
|---|---|---|
| Tham số | và | chỉ () |
| Phù hợp | dữ liệu lệch một phía, ví dụ activation sau ReLU | dữ liệu phân bố quanh 0, ví dụ trọng số |
| Chi phí tính toán | phải xử lý thêm các số hạng chứa | rẻ hơn (xem Mục 6.2) |
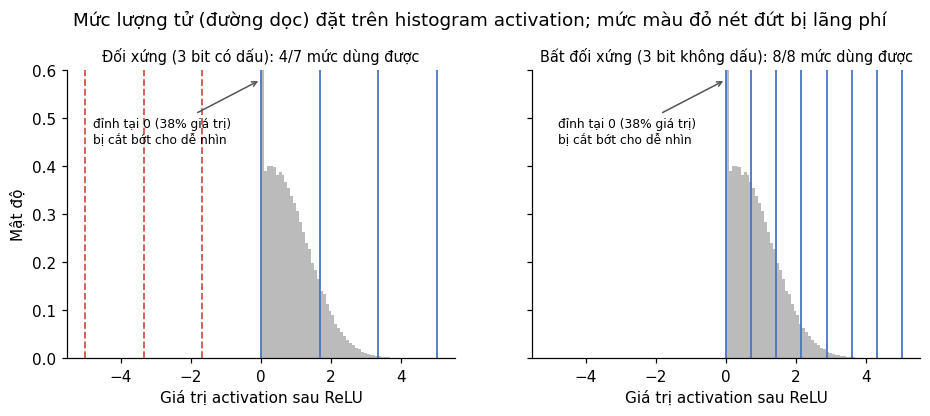
Đo trên chính dữ liệu của Hình 5 (200 000 giá trị sau ReLU), MSE của lượng tử đối xứng so với bất đối xứng là so với ở 4 bit (gấp 4,6 lần), và so với ở 8 bit. Quy ước phổ biến trong TFLite và PyTorch vì thế là trọng số đối xứng, activation bất đối xứng.
3.6Cài đặt#
import numpy as np

def affine_params(alpha, beta, qmin, qmax):
    alpha, beta = min(alpha, 0.0), max(beta, 0.0)       # dải luôn chứa 0 (Mục 3.4)
    S = (beta - alpha) / (qmax - qmin)
    Z = int(np.clip(np.round(qmin - alpha / S), qmin, qmax))
    return S, Z

def quantize(x, S, Z, qmin, qmax):
    return np.clip(np.round(x / S) + Z, qmin, qmax).astype(np.int32)

def dequantize(q, S, Z):
    return S * (q.astype(np.float32) - Z)

S, Z = affine_params(-1.0, 3.0, 0, 255)
x = np.array([-1.0, 0.0, 1.5, 3.0, 5.0])
q = quantize(x, S, Z, 0, 255)
print(S, Z, q, dequantize(q, S, Z))
# 0.01568627...  64  [  0  64 160 255 255]  [-1.0039  0.  1.5059  2.9961  2.9961]
Lưu ý giá trị nằm ngoài dải nên bị cắt về . Đó là sai số cắt (clipping error), chủ đề của chương sau.
4Phân tích sai số lượng tử#
4.1Hai nguồn sai số#
Với dải đã chọn, mỗi giá trị chịu đúng một trong hai loại sai số:
- Sai số làm tròn (rounding error) khi nằm trong dải. Độ lớn luôn .
- Sai số cắt (clipping error) khi nằm ngoài dải. Độ lớn bằng khoảng cách từ đến mép dải, không bị chặn.
Mô hình nhiễu đều. Nếu nhỏ so với độ biến thiên của phân phối dữ liệu, sai số làm tròn xấp xỉ phân phối đều trên . Khi đó:
Kết quả này cho thấy sai số làm tròn tỉ lệ với bình phương bước nhảy , tức tỉ lệ với bình phương độ rộng dải.
4.2Mỗi bit đáng giá khoảng 6 dB#
Đại lượng chuẩn để đo chất lượng lượng tử là tỉ số tín hiệu trên nhiễu lượng tử (SQNR):
Xét trường hợp lý tưởng: phân phối đều trên , dùng lưới đối xứng hạn chế với mức mỗi phía, . Công suất tín hiệu là , công suất nhiễu là , nên
Kết luận: mỗi bit thêm vào giảm một nửa, giảm công suất nhiễu 4 lần, tức tăng SQNR khoảng 6 dB.
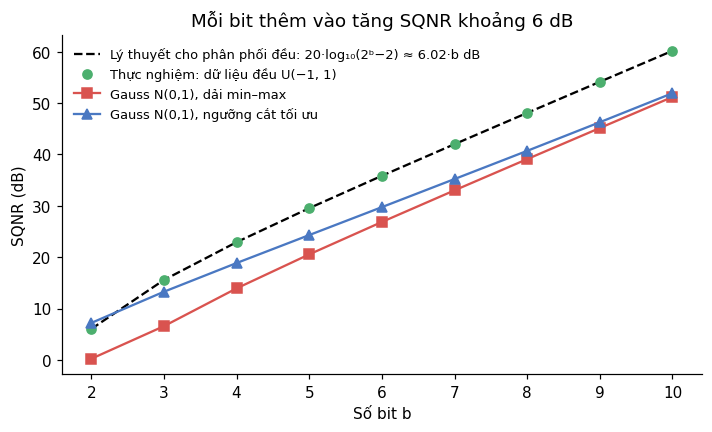
| Đều, lý thuyết | Đều, thực nghiệm | Gauss, min–max | Gauss, ngưỡng tối ưu | |
|---|---|---|---|---|
| 4 | 22,92 dB | 22,92 dB | 13,93 dB | 18,86 dB |
| 8 | 48,09 dB | 48,09 dB | 39,10 dB | 40,71 dB |
Vì sao dữ liệu Gauss kém hơn? Với mẫu , giá trị lớn nhất vào khoảng , trong khi phần lớn dữ liệu nằm trong . Dùng dải min–max nghĩa là "trả tiền" cho cả một vùng rộng gần như không có dữ liệu.
4.3Đánh đổi giữa làm tròn và cắt#
Thu hẹp dải làm nhỏ đi (giảm sai số làm tròn) nhưng khiến nhiều giá trị bị cắt hơn (tăng sai số cắt). Tổng MSE vì thế có một điểm cực tiểu.
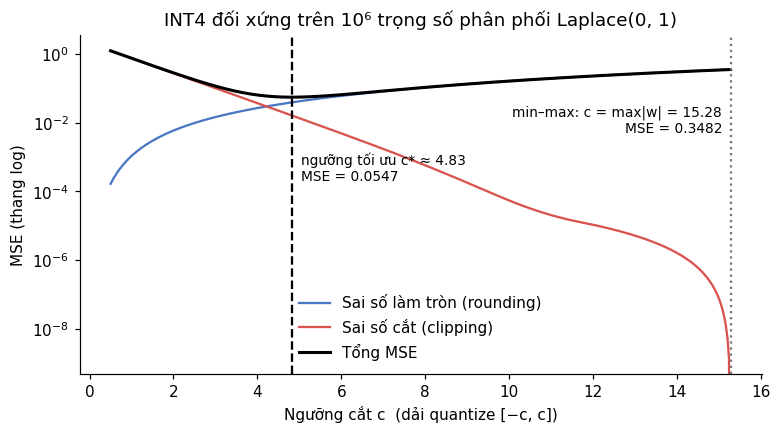
Phân phối Laplace được chọn vì trọng số của mạng nơ-ron đã huấn luyện thường có dạng "nhọn đỉnh, đuôi dày" giống Laplace hơn là Gauss. Đuôi càng dày, cái giá của dải min–max càng lớn và việc chọn ngưỡng cắt càng quan trọng. Chương 8 sẽ trình bày các phương pháp tự động tìm ngưỡng này cho activation.
Câu hỏi suy ngẫm. Vì sao ngưỡng tối ưu tăng khi số bit tăng? (Gợi ý: khi tăng, sai số làm tròn giảm theo còn sai số cắt không phụ thuộc , nên ta "đủ khả năng" mở rộng dải để giảm clipping.)
5Độ mịn của tham số lượng tử (granularity)#
5.1Ba mức độ mịn#
Một tensor có thể dùng chung một cặp hoặc chia nhỏ thành nhiều nhóm, mỗi nhóm một cặp riêng:
- Per-tensor: một cặp cho cả tensor. Đơn giản nhất, nhưng một kênh có giá trị lớn sẽ ép mọi kênh khác dùng bước nhảy thô.
- Per-channel (per-axis): mỗi kênh đầu ra của trọng số có riêng. Đây là mặc định cho trọng số của Conv và Linear trong TFLite và PyTorch hiện nay.
- Per-group (per-block): chia mỗi hàng trọng số thành các nhóm liên tiếp 32, 64 hoặc 128 phần tử. Đây là chuẩn cho lượng tử 4 bit của LLM (Chương 11).
Độ mịn càng cao thì sai số càng nhỏ, nhưng phải lưu và xử lý nhiều scale hơn.
5.2Vì sao per-channel phải theo trục đầu ra#
Đây là điểm tinh tế, quyết định việc tính toán có còn thuần số nguyên được hay không. Xét (tổng chạy theo trục đầu vào ).
- Nếu scale trọng số phụ thuộc kênh đầu ra : , thì . Scale đưa được ra ngoài tổng, nên phần tổng là thuần số nguyên.
- Nếu scale phụ thuộc kênh đầu vào : . Scale nằm bên trong tổng, phải nhân số thực cho từng phần tử, và lợi ích số nguyên mất đi.
Cùng lập luận giải thích vì sao activation không được lượng tử theo kênh (kênh của activation chính là trục bị lấy tổng), nhưng lại có thể lượng tử theo token: với ma trận activation có hàng là token , scale đưa ra ngoài tổng được. Chính ràng buộc này sinh ra bài toán outlier trong LLM (Mục 11.2–11.3).
5.3Thí nghiệm#
Tài liệu dùng một CNN nhỏ gồm Conv–BN–ReLU, một lớp depthwise (giống MobileNet), một lớp pointwise và một lớp Linear, huấn luyện trên bộ chữ số viết tay 8×8 của scikit-learn (1257 ảnh train, 540 ảnh test). Độ chính xác FP32 là 99,26%. Sau khi gộp BatchNorm vào Conv (Mục 7.3), ta chỉ lượng tử trọng số, giữ activation ở FP32, để cô lập ảnh hưởng của granularity:
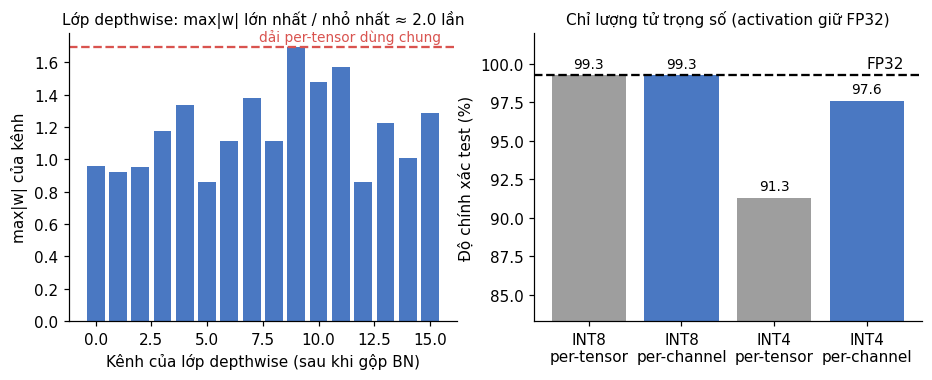
| INT8 per-tensor | INT8 per-channel | INT4 per-tensor | INT4 per-channel | |
|---|---|---|---|---|
| Độ chính xác | 99,26% | 99,26% | 91,30% | 97,59% |
| MSE lớp depthwise |
Ở 8 bit, bước nhảy đủ mịn nên granularity không đáng kể. Ở 4 bit, per-channel giữ lại hơn 6 điểm phần trăm, dù trong mô hình nhỏ này dải giữa các kênh chỉ chênh nhau khoảng 2 lần. Với MobileNetV2 thật, sau khi gộp BN dải trọng số giữa các kênh của lớp depthwise chênh lệch rất lớn, khiến lượng tử per-tensor 8 bit làm độ chính xác sụp đổ. Hiện tượng này được phân tích kỹ trong Nagel và cộng sự (2019, Hình 2) và là động lực cho kỹ thuật cân bằng giữa các lớp ở Mục 9.5.
6Suy luận hoàn toàn bằng số nguyên#
Chương này trả lời câu hỏi: vì sao INT8 không chỉ nhẹ hơn mà còn nhanh hơn? Nội dung dựa theo Jacob và cộng sự (2018), nền tảng của cơ chế lượng tử trong TFLite.
6.1Nhân ma trận với các đại lượng đã lượng tử#
Xét (một phần tử của phép nhân ma trận hay tích chập). Thay mọi đại lượng bằng biểu diễn lượng tử :
Giải ra :
6.2Khai triển và những gì tính trước được#
Khai triển tích trong tổng:
Phân tích từng số hạng:
- là phần việc chính, gồm phép nhân int8×int8, cộng dồn vào thanh ghi int32.
- chỉ phụ thuộc trọng số và hằng , nên tính trước được lúc chuyển đổi mô hình.
- phụ thuộc đầu vào, phải tính lúc chạy, tốn thêm phép cộng.
- là hằng số.
Nếu trọng số lượng tử đối xứng (), hai số hạng 3 và 4 biến mất. Đây là lý do kỹ thuật khiến trọng số gần như luôn được lượng tử đối xứng.
6.3Bias#
Bias được lưu dạng int32 với scale và zero-point 0: . Nhờ cùng scale với bộ cộng dồn, nó được cộng thẳng vào kết quả int32 mà không cần đổi đơn vị. Bias dùng 32 bit vì nó ít tham số nhưng ảnh hưởng trực tiếp lên mọi đầu ra, và vì bước rất nhỏ.
6.4Requantization: nhân với số thực mà không dùng số thực#
Hệ số là số thực. Thực nghiệm cho thấy gần như luôn nằm trong . Ta viết
rồi lưu dưới dạng số nguyên 32 bit dấu chấm tĩnh: . Phép nhân với trở thành một phép nhân số nguyên 64 bit và một phép dịch phải có làm tròn:
Cuối cùng cộng và cắt về . Toàn bộ quy trình được tóm tắt trong Hình 9.
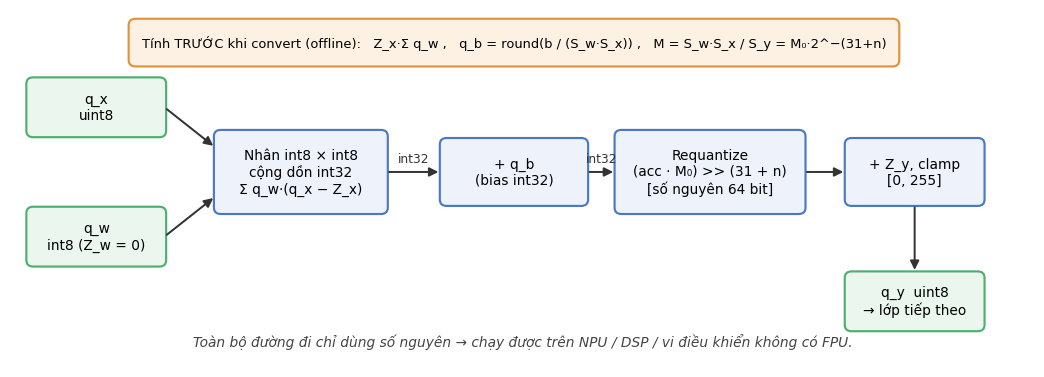
Hàm kích hoạt ReLU được "gộp miễn phí": nếu dải đầu ra được calibrate sau ReLU thì , suy ra , và phép cắt ở bước cuối tự động thực hiện ReLU. ReLU6 tương tự với cận trên. Các hàm phi tuyến phức tạp hơn (sigmoid, softmax, GELU) thường dùng bảng tra hoặc được tính ở độ chính xác cao hơn.
6.5Kiểm chứng bằng mã#
Đoạn mã sau cài đặt đúng quy trình Hình 9 bằng NumPy cho một lớp Linear và so sánh với cách mô phỏng bằng số thực (trích từ code/numpy_experiments.py):
def quantize_multiplier(M):
    """Viết M (0 < M < 1) dưới dạng M0 * 2^-(31 + shift), với M0 là int32 trong [2^30, 2^31)."""
    shift = 0
    while M < 0.5:
        M *= 2; shift += 1
    M0 = int(round(M * (1 << 31)))
    if M0 == (1 << 31):
        M0 //= 2; shift -= 1
    return M0, shift

def rounding_right_shift(x, n):          # chia cho 2^n, làm tròn gần nhất
    return (x + (1 << (n - 1))) >> n

# X: activation (uint8 bất đối xứng), W: trọng số (int8 đối xứng), b: bias
q_x = np.clip(np.round(X / S_x) + Z_x, 0, 255).astype(np.int32)
q_w = np.clip(np.round(W / S_w), -127, 127).astype(np.int32)
q_b = np.round(b / (S_w * S_x)).astype(np.int32)

acc = q_x @ q_w.T - Z_x * q_w.sum(axis=1) + q_b          # int32; q_w.sum tính trước được
M0, shift = quantize_multiplier(S_w * S_x / S_y)
q_y = np.clip(Z_y + rounding_right_shift(acc.astype(np.int64) * M0, 31 + shift), 0, 255)
Kết quả (code/numpy_experiments_output.txt):
S_x=0.038963 Z_x=106 | S_w=0.001661 | S_y=0.031995 Z_y=120
M = 0.0020223740 = 1111811840 * 2^-(31+8) -> 0.0020223740
max |q_y(integer) - q_y(float sim)| = 0 LSB; tỉ lệ khác nhau: 0.0000%
sai số tương đối so với FP32: 1.6085%
max |acc| = 66876 ; giới hạn int16 = 32767 ; cận trên lý thuyết 255*127*K = 8290560
Ba điều rút ra:
- Đường tính toán thuần số nguyên cho kết quả trùng khớp từng bit với cách mô phỏng bằng số thực. Đây là lý do mô phỏng fake quantization (Chương 7) dự đoán đúng độ chính xác của mô hình khi triển khai.
- Sai số so với FP32 khoảng 1,6%, hoàn toàn do lượng tử chứ không do phép tính số nguyên.
- Giá trị cộng dồn lên tới 66 876, vượt giới hạn int16. Đó là lý do bộ cộng dồn phải là int32. Cận trên lý thuyết vẫn nằm rất xa giới hạn int32 ().
Khi dùng per-channel cho trọng số, mỗi kênh đầu ra có hệ số riêng, còn lại mọi thứ giữ nguyên.
7Lượng tử hóa một mạng nơ-ron hoàn chỉnh#
7.1Những gì được lượng tử#
| Thành phần | Kiểu thường dùng | Cách xác định dải |
|---|---|---|
| Trọng số | int8 đối xứng, per-channel | trực tiếp từ giá trị trọng số |
| Bias | int32, scale | suy ra, không cần dải |
| Activation | uint8/int8 bất đối xứng, per-tensor | cần dữ liệu (calibration) hoặc tính lúc chạy |
| Đầu vào, đầu ra mô hình | tùy cấu hình | đầu vào thường biết trước (ví dụ pixel ) |
Theo cách xử lý activation, có ba chế độ:
- Weight-only: chỉ nén trọng số; lúc chạy giải lượng tử trọng số về FP16/FP32 rồi tính. Lợi về bộ nhớ và băng thông, không lợi về tốc độ tính.
- Dynamic quantization: trọng số lượng tử sẵn; activation được lượng tử lúc chạy với dải tính từ chính tensor đó. Không cần dữ liệu calibration, nhưng tốn chi phí tìm min/max mỗi lần chạy.
- Static quantization: dải activation được cố định trước nhờ calibration. Nhanh nhất và là điều kiện để chạy thuần số nguyên như Hình 9.
7.2Mô phỏng lượng tử bằng nút fake-quant#
Trong thực tế, ta hiếm khi viết kernel số nguyên để thử nghiệm. Thay vào đó, ta chèn các nút FakeQuant vào đồ thị FP32 ở đúng những vị trí sẽ bị lượng tử khi triển khai:
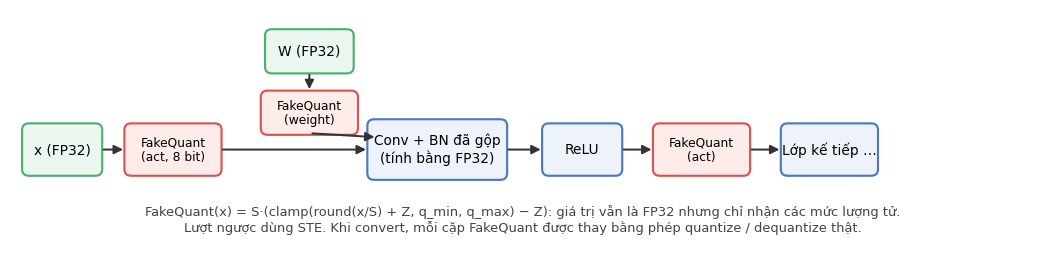
Mục 6.5 đã kiểm chứng rằng cách mô phỏng này cho kết quả trùng khớp với phép tính số nguyên thật. Đồ thị này được dùng cho cả hai việc: đánh giá PTQ và huấn luyện QAT (Chương 9).
7.3Gộp BatchNorm vào tích chập (BN folding)#
Khi suy luận, BatchNorm là một phép biến đổi affine cố định theo từng kênh:
Thế vào và nhóm lại, ta được một phép tích chập mới với trọng số và bias
trong đó phép nhân với áp dụng theo từng kênh đầu ra. Phải gộp BN trước khi lượng tử, vì trên phần cứng BN không tồn tại như một lớp riêng. Nếu lượng tử rồi mới gộp, trọng số thực sự chạy trên thiết bị là với dải khác hẳn. Đây cũng là nguyên nhân khiến dải giữa các kênh trở nên chênh lệch (Mục 5.3): hệ số khác nhau cho từng kênh.
def fold_bn(conv, bn):
    std = torch.sqrt(bn.running_var + bn.eps)
    w = conv.weight * (bn.weight / std).reshape(-1, 1, 1, 1)
    b0 = conv.bias if conv.bias is not None else torch.zeros_like(bn.running_mean)
    b = bn.weight * (b0 - bn.running_mean) / std + bn.bias
    fused = nn.Conv2d(conv.in_channels, conv.out_channels, conv.kernel_size,
                      conv.stride, conv.padding, groups=conv.groups, bias=True)
    fused.weight.data, fused.bias.data = w.detach().clone(), b.detach().clone()
    return fused
Trên mô hình thí nghiệm, sai khác lớn nhất giữa logit của mạng gốc và mạng đã gộp là , đúng bằng mức sai số làm tròn của FP32.
7.4Gộp lớp (layer fusion)#
Tổng quát hơn, các chuỗi như Conv → BN → ReLU hay Linear → ReLU được gộp thành một phép toán. Lợi ích: bớt các cặp quantize/dequantize trung gian (bớt sai số, bớt chi phí), và activation trung gian không bao giờ phải ghi ra bộ nhớ. Framework nào cũng có bước này (fuse_modules trong PyTorch eager mode, hoặc tự động trong trình chuyển đổi TFLite).
8Calibration: chọn dải cho activation#
Trọng số đã biết trước, nhưng activation phụ thuộc đầu vào. Calibration là quá trình cho một tập dữ liệu nhỏ, gọi là representative dataset, chạy qua mô hình để thống kê phân phối activation tại từng điểm lượng tử, rồi chọn cho mỗi điểm.
8.1Các phương pháp#
-
Min–max: , trên toàn tập calibration. Không bao giờ cắt, nhưng rất nhạy với outlier (Hình 7).
-
Min–max trung bình trượt (EMA): cập nhật qua từng batch. Mặc định trong QAT.
-
Percentile: chọn bằng phân vị 99,9% hay 99,99%, chấp nhận cắt phần đuôi.
-
Tối thiểu MSE: tìm sao cho nhỏ nhất, thường bằng tìm kiếm lưới trên các ngưỡng ứng viên. Đây chính là bài toán cân bằng ở Mục 4.3.
-
Tối thiểu KL divergence (entropy calibration): phương pháp được NVIDIA TensorRT phổ biến (Migacz, 2017). Với mỗi ngưỡng ứng viên:
- Lập histogram tham chiếu gồm các bin bên trong ngưỡng, dồn toàn bộ phần bị cắt vào bin cuối.
- Gộp các bin của thành đúng số mức lượng tử để được , rồi trải đều lại trên các bin khác 0.
- Tính .
Ngưỡng cho nhỏ nhất được chọn. Ý tưởng là giữ cho phân phối sau lượng tử gần phân phối gốc nhất.
8.2Thí nghiệm#
Dùng 256 ảnh train làm tập calibration, lượng tử W4A4 (trọng số per-channel, lớp đầu và cuối giữ 8 bit):
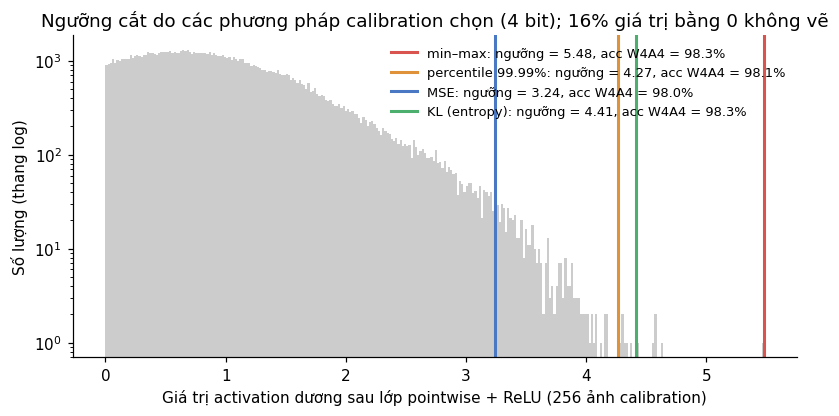
| Phương pháp | Ngưỡng (lớp pointwise, 4 bit) | Độ chính xác W8A8 | Độ chính xác W4A4 |
|---|---|---|---|
| Min–max | 5,48 | 99,26% | 98,33% |
| Percentile 99,99% | 4,27 | 99,26% | 98,15% |
| MSE | 3,24 | 99,26% | 97,96% |
| KL (entropy) | 4,41 | 99,07% | 98,33% |
Kết quả này cần đọc một cách trung thực:
- Các phương pháp chọn ngưỡng rất khác nhau (từ 3,24 đến 5,48), và MSE mạnh tay cắt nhất, đúng như lý thuyết ở Mục 4.3.
- Tuy vậy, với mô hình nhỏ và dễ này, độ chính xác gần như không đổi. Chênh lệch 0,37 điểm phần trăm chỉ tương ứng 2 ảnh trên 540 ảnh test, nằm trong mức dao động ngẫu nhiên.
- Ngưỡng tối ưu theo MSE của từng lớp riêng lẻ không bảo đảm độ chính xác toàn mạng cao nhất, vì sai số của các lớp tương tác với nhau.
Bài học thực hành: không có phương pháp calibration tốt nhất cho mọi trường hợp. Khác biệt trở nên đáng kể khi phân phối activation có đuôi dài (mô hình lớn, Transformer) hoặc khi số bit thấp. Nên thử vài phương pháp và chọn theo độ chính xác trên tập validation.
8.3Kinh nghiệm chuẩn bị tập calibration#
- Khoảng 100–1000 mẫu thường là đủ. Nhiều hơn ít khi cải thiện thêm.
- Mẫu phải đại diện cho phân phối lúc triển khai: đủ các lớp, đủ điều kiện ánh sáng, độ dài câu… Dữ liệu ngẫu nhiên hoặc chỉ một lớp sẽ cho dải sai.
- Tiền xử lý giống hệt lúc suy luận (chuẩn hóa, resize, tokenizer).
- Mô hình phải ở chế độ
eval(), để BatchNorm dùng thống kê đã học và Dropout tắt.
9PTQ và QAT#
9.1Post-Training Quantization (PTQ)#
PTQ lượng tử mô hình đã huấn luyện xong, không cập nhật trọng số bằng gradient (hoặc chỉ tối ưu cục bộ một ít như AdaRound). Quy trình: gộp lớp → lượng tử trọng số → calibration activation → chuyển đổi. Ưu điểm là nhanh (vài phút), không cần nhãn, không cần pipeline huấn luyện. Với mô hình đủ lớn, INT8 PTQ thường chỉ làm giảm dưới 1 điểm phần trăm độ chính xác.
9.2Quantization-Aware Training (QAT)#
QAT tiếp tục huấn luyện (fine-tune) mô hình với các nút fake-quant trong đồ thị (Hình 10). Nhờ thấy được sai số lượng tử ngay trong lượt xuôi, mạng học cách điều chỉnh trọng số để bù lại.
Vấn đề gradient. Hàm làm tròn là hàm bậc thang: đạo hàm của nó bằng 0 ở hầu khắp nơi và không xác định tại các bước nhảy. Nếu dùng đạo hàm thật, gradient truyền về trọng số luôn bằng 0 và mạng không học được gì.
Straight-Through Estimator (STE) (Bengio và cộng sự, 2013) giải quyết bằng cách, trong lượt ngược, coi phép làm tròn như hàm đồng nhất:
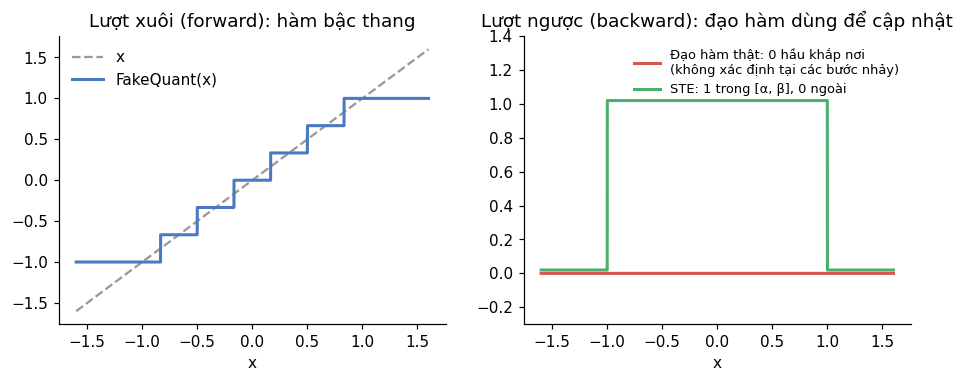
Trong PyTorch, STE viết gọn bằng một dòng: x_hat = x + (fake_quant(x) - x).detach(). Giá trị trả về bằng fake_quant(x), nhưng gradient đi qua như thể hàm là x.
Học cả scale. Thay vì cố định dải bằng EMA, phương pháp LSQ (Esser và cộng sự, 2020) coi là tham số huấn luyện được. Với lượng tử đối xứng , đạo hàm theo (vẫn dùng STE cho phép làm tròn) là
BatchNorm trong QAT. Nếu huấn luyện với BN riêng rồi mới gộp, trọng số được fake-quant không phải trọng số thật sẽ chạy trên thiết bị. Cách chuẩn (Jacob và cộng sự, 2018; Krishnamoorthi, 2018) là mô phỏng việc gộp BN ngay trong lúc huấn luyện, và đóng băng thống kê BN sau một số epoch để ổn định. fuse_modules_qat trong PyTorch thực hiện việc này. Thí nghiệm dưới đây đơn giản hóa bằng cách gộp BN trước rồi fine-tune mạng đã gộp.
9.3Thí nghiệm: PTQ và QAT theo độ rộng bit#
Cấu hình: trọng số per-channel đối xứng, activation per-tensor bất đối xứng, lớp đầu và cuối giữ 8 bit (thực hành phổ biến vì đây là hai lớp nhạy cảm nhất). QAT khởi tạo từ dải của PTQ (MSE), dùng EMA cho dải activation, STE, Adam với learning rate trong 15 epoch, lấy trung bình 3 lần chạy.
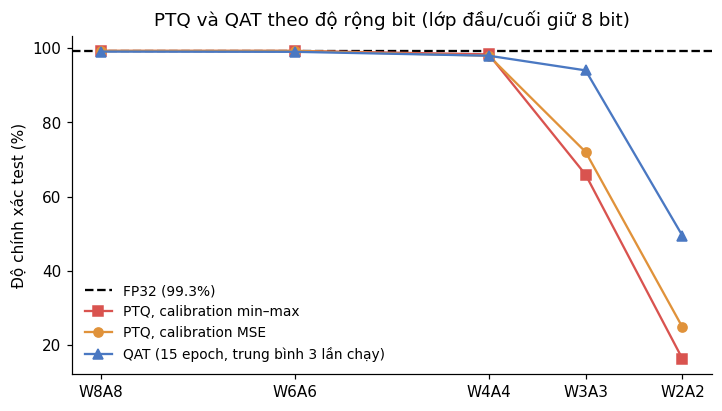
| W8A8 | W6A6 | W4A4 | W3A3 | W2A2 | |
|---|---|---|---|---|---|
| PTQ, min–max | 99,26% | 99,26% | 98,33% | 65,93% | 16,30% |
| PTQ, MSE | 99,26% | 99,26% | 97,96% | 72,04% | 24,81% |
| QAT | 99,07% | 99,01% | 97,96% | 94,01% | 49,44% |
(FP32: 99,26%. Mỗi ảnh test tương ứng 0,19 điểm phần trăm.)
Nhận xét:
- Từ 4 bit trở lên, PTQ đã đủ cho mô hình này. QAT không cải thiện thêm; sai khác 0,2 điểm ở 8 bit là 1 ảnh, nằm trong dao động ngẫu nhiên.
- Dưới 4 bit, PTQ sụp đổ (còn 66–72% ở 3 bit), trong khi QAT giữ được 94%. Đây là khoảng mà QAT thực sự đáng giá.
- Ở 2 bit, ngay cả QAT cũng mất nhiều độ chính xác. Muốn đi xa hơn cần kỹ thuật chuyên biệt (học scale kiểu LSQ, huấn luyện lâu hơn, chưng cất tri thức từ mô hình FP32).
Quy luật này khớp với kinh nghiệm chung: mô hình càng nhỏ, càng "gọn" (MobileNet, EfficientNet-Lite) hoặc số bit càng thấp thì càng cần QAT.
9.4Nên chọn PTQ hay QAT#
| Tiêu chí | PTQ | QAT |
|---|---|---|
| Cần dữ liệu có nhãn | Không (chỉ cần vài trăm mẫu calibration) | Có |
| Chi phí | Vài phút | Một phần đáng kể của chi phí huấn luyện |
| Độ chính xác ở INT8 | Thường đủ tốt | Tốt nhất |
| Độ chính xác ở ≤ 4 bit | Thường giảm mạnh (trừ các kỹ thuật chuyên biệt ở Chương 11) | Giữ được tốt hơn nhiều |
Luôn bắt đầu bằng PTQ; chỉ chuyển sang QAT khi PTQ và các cải tiến ở Mục 9.5 không đạt yêu cầu.
9.5Các kỹ thuật PTQ nâng cao#
Giữa PTQ cơ bản và QAT có một nhóm kỹ thuật chỉ cần dữ liệu không nhãn hoặc không cần dữ liệu:
Cân bằng giữa các lớp (Cross-Layer Equalization, CLE) (Nagel và cộng sự, 2019). Với hai lớp liên tiếp có ReLU ở giữa, do với , ta có thể chia kênh của lớp thứ nhất cho và nhân kênh đầu vào của lớp thứ hai với mà đầu ra không đổi. Gọi , là dải trọng số kênh ở hai lớp. Chọn
thì dải của kênh ở cả hai lớp đều bằng , khiến các kênh đồng đều hơn và lượng tử per-tensor tốt hơn hẳn. Kỹ thuật này không cần dữ liệu. SmoothQuant (Mục 11.3) dùng đúng ý tưởng này giữa activation và trọng số.
Bias correction. Sai số lượng tử trọng số làm đầu ra lệch trung bình một lượng . Nếu ước lượng được (từ dữ liệu, hoặc từ tham số BN của lớp trước), ta bù lại: .
AdaRound (Nagel và cộng sự, 2020). Làm tròn đến số gần nhất tối ưu cho từng trọng số nhưng không tối ưu cho đầu ra của lớp. AdaRound học quyết định làm tròn lên hay xuống cho mỗi trọng số bằng cách tối ưu
trong đó là một hàm sigmoid chỉnh sửa, và đẩy về đúng 0 hoặc 1. Chỉ cần vài trăm hoặc vài nghìn mẫu không nhãn, AdaRound thường đưa PTQ 4 bit trọng số tiến gần QAT. GPTQ (Mục 11.4) theo đuổi cùng mục tiêu "tối thiểu sai số đầu ra thay vì sai số trọng số".
10Thực hành với PyTorch và TensorFlow Lite#
10.1PyTorch#
10.1.1Tình trạng API (cập nhật 2026)#
PyTorch có hai thế hệ công cụ lượng tử:
torch.ao.quantization(eager mode và FX graph mode): API "cổ điển" mà phần lớn bài hướng dẫn trên mạng đang dùng. Ở PyTorch 2.14, chỉ cần gọi là thấy cảnh báoDeprecationWarning: torch.ao.quantization is deprecated. Cảnh báo này khuyên chuyển eager mode sang APIquantize_của torchao, và chuyển FX sang PT2E (nay cũng nằm trong torchao). API cũ vẫn chạy được, nên vẫn hữu ích để học cơ chế.- torchao (
pip install torchao): thư viện chính thức hiện nay, gồmquantize_cho mô hình (đặc biệt là LLM) và luồng PT2E dựa trêntorch.export.
Mọi đoạn mã PyTorch dưới đây đều đã chạy thật trên môi trường nêu ở đầu tài liệu. Kết quả in ra nằm trong code/torch_experiments_output.txt.
10.1.2Static quantization với eager mode#
Eager mode đòi hỏi viết lại mô hình theo ba quy tắc: có QuantStub/DeQuantStub đánh dấu nơi bắt đầu và kết thúc vùng lượng tử; mỗi ReLU là một module riêng (không dùng F.relu) để gộp được; và các phép như cộng skip-connection phải dùng FloatFunctional.
import torch, torch.nn as nn
import torch.ao.quantization as tq

class QNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.quant = tq.QuantStub()                        # FP32 -> INT8 ở đầu vào
        self.conv1, self.bn1, self.relu1 = nn.Conv2d(1, 16, 3, padding=1, bias=False), nn.BatchNorm2d(16), nn.ReLU()
        self.dw, self.bn2, self.relu2 = nn.Conv2d(16, 16, 3, padding=1, groups=16, bias=False), nn.BatchNorm2d(16), nn.ReLU()
        self.pw, self.bn3, self.relu3 = nn.Conv2d(16, 32, 1, bias=False), nn.BatchNorm2d(32), nn.ReLU()
        self.pool = nn.MaxPool2d(2)
        self.conv4, self.bn4, self.relu4 = nn.Conv2d(32, 32, 3, padding=1, bias=False), nn.BatchNorm2d(32), nn.ReLU()
        self.gap = nn.AdaptiveAvgPool2d(1)
        self.fc = nn.Linear(32, 10)
        self.dequant = tq.DeQuantStub()                    # INT8 -> FP32 ở đầu ra

    def forward(self, x):
        x = self.quant(x)
        x = self.relu1(self.bn1(self.conv1(x)))
        x = self.relu2(self.bn2(self.dw(x)))
        x = self.pool(self.relu3(self.bn3(self.pw(x))))
        x = self.relu4(self.bn4(self.conv4(x)))
        x = self.fc(torch.flatten(self.gap(x), 1))
        return self.dequant(x)

model = QNet(); model.load_state_dict(fp32_state_dict, strict=False); model.eval()

torch.backends.quantized.engine = "x86"                  # ARM / điện thoại: "qnnpack"
model.qconfig = tq.get_default_qconfig("x86")            # trọng số per-channel đối xứng, activation per-tensor
tq.fuse_modules(model, [["conv1", "bn1", "relu1"], ["dw", "bn2", "relu2"],
                        ["pw", "bn3", "relu3"], ["conv4", "bn4", "relu4"]], inplace=True)   # Mục 7.3–7.4
tq.prepare(model, inplace=True)                          # chèn observer
with torch.no_grad():
    model(X_calib)                                       # calibration (Chương 8)
tq.convert(model, inplace=True)                          # thay bằng kernel INT8 thật
print(model.conv1)
QuantizedConvReLU2d(1, 16, kernel_size=(3, 3), stride=(1, 1), scale=0.0270916..., zero_point=0, padding=(1, 1))
Để ý zero_point=0: vì dải đầu ra được đo sau ReLU nên , và phép cắt thực hiện luôn ReLU như đã nói ở Mục 6.4.
Kết quả: độ chính xác 99,07% (FP32: 99,26%), kích thước state_dict từ 48,5 KB xuống 20,5 KB. Tỉ lệ nén chỉ khoảng 2,4 lần chứ không phải 4 lần, vì với mô hình nhỏ như vậy, phần siêu dữ liệu khi tuần tự hóa (tên tensor, scale, zero-point, cấu trúc) chiếm tỉ trọng lớn. Với mô hình lớn, tỉ lệ tiến gần 4.
10.1.3QAT với eager mode#
import torch.ao.nn.intrinsic.qat as nniqat

model = QNet(); model.load_state_dict(fp32_state_dict, strict=False)   # BẮT ĐẦU TỪ MÔ HÌNH ĐÃ HUẤN LUYỆN
model.train()
model.qconfig = tq.get_default_qat_qconfig("x86")
tq.fuse_modules_qat(model, [["conv1", "bn1", "relu1"], ["dw", "bn2", "relu2"],
                            ["pw", "bn3", "relu3"], ["conv4", "bn4", "relu4"]], inplace=True)
tq.prepare_qat(model, inplace=True)                      # chèn FakeQuantize, mô phỏng gộp BN

opt = torch.optim.Adam(model.parameters(), lr=5e-4)     # learning rate nhỏ: đây là fine-tune
for epoch in range(10):
    if epoch == 6: model.apply(tq.disable_observer)      # cố định dải lượng tử
    if epoch == 7: model.apply(nniqat.freeze_bn_stats)   # cố định thống kê BatchNorm
    train_one_epoch(model, opt)

model.eval()
qmodel = tq.convert(model)
Độ chính xác sau khi convert: 98,33% (xem code/torch_qat_eager.py). Ở INT8, con số này ngang PTQ trong phạm vi dao động (4 ảnh trên 540), đúng như kết luận ở Mục 9.3: QAT chỉ đáng dùng khi PTQ không đủ.
Một bài học từ chính quá trình viết tài liệu. Phiên bản đầu tiên của đoạn mã trên huấn luyện QAT từ đầu với learning rate và chỉ đạt 87,2%. QAT là fine-tune một mô hình đã hội tụ, với learning rate nhỏ và vài epoch. Không nên coi nó là cách huấn luyện từ đầu.
10.1.4PT2E với torchao#
Luồng PT2E xuất mô hình thành đồ thị bằng torch.export, nên không cần sửa mã mô hình (không cần QuantStub, không cần ReLU riêng):
from torchao.quantization.pt2e.quantize_pt2e import prepare_pt2e, convert_pt2e
import torchao.quantization.pt2e.quantizer.x86_inductor_quantizer as xiq

m = fp32_model.eval()                                        # mô hình gốc, viết bằng F.relu cũng được
exported = torch.export.export(
    m, (X_calib[:4],),
    dynamic_shapes={"x": {0: torch.export.Dim("batch")}}     # cho phép batch size thay đổi
).module()

quantizer = xiq.X86InductorQuantizer().set_global(xiq.get_default_x86_inductor_quantization_config())
prepared = prepare_pt2e(exported, quantizer)                 # chèn observer
with torch.no_grad():
    prepared(X_calib)                                        # calibration
quantized = convert_pt2e(prepared)                           # đồ thị có các cặp quantize/dequantize
# Để có kernel INT8 nhanh: torch.compile(quantized)
Độ chính xác: 99,26%, bằng FP32. Lưu ý thực tế: nếu bỏ tham số dynamic_shapes, đồ thị bị cố định batch size 4 và lỗi ngay khi chạy với batch khác (Guard failed: x.size()[0] == 4). Mình đã gặp lỗi này khi chạy thử.
Mỗi phần cứng có quantizer riêng: X86InductorQuantizer cho CPU x86, ArmInductorQuantizer cho ARM, và các quantizer của ExecuTorch (XNNPACK, Qualcomm, Core ML…) cho thiết bị di động. Quantizer quyết định op nào được lượng tử và theo cấu hình nào, cho khớp với kernel mà backend đó có.
10.1.5Dynamic và weight-only: đo độ trễ#
Thí nghiệm trên một MLP 1024→4096→4096→1024 (96 MB ở FP32), batch 16, một luồng CPU:
import torch.ao.quantization as tq
from torchao.quantization import quantize_, Int8WeightOnlyConfig, Int8DynamicActivationInt8WeightConfig

m1 = tq.quantize_dynamic(copy.deepcopy(base), {nn.Linear}, dtype=torch.qint8)     # API cũ
m2 = copy.deepcopy(base); quantize_(m2, Int8WeightOnlyConfig())                   # torchao
m3 = copy.deepcopy(base); quantize_(m3, Int8DynamicActivationInt8WeightConfig())  # torchao
| Cách | Kích thước | Độ trễ | Sai số tương đối đầu ra |
|---|---|---|---|
| FP32 | 96,0 MB | 14,3 ms | 0 |
torch.ao quantize_dynamic |
24,0 MB | 2,3 ms | |
torchao Int8WeightOnly (eager) |
24,1 MB | 33,9 ms | |
torchao Int8DynamicActivationInt8Weight (eager) |
24,1 MB | 4,2 ms |
Cách đọc bảng:
- Kích thước giảm đúng 4 lần như lý thuyết.
- Tăng tốc khoảng 6 lần của
quantize_dynamiclà đặc thù phần cứng. CPU thử nghiệm có lệnh AVX-512 VNNI và AMX-INT8 chuyên cho phép nhân int8. Trên CPU không có các lệnh này, mức tăng tốc nhỏ hơn nhiều. Int8WeightOnlychạy eager chậm hơn FP32 hơn 2 lần. Nếu không cótorch.compileđể sinh kernel hợp nhất, trọng số bị giải lượng tử về số thực ở mỗi lần gọi, tốn thêm công mà không bớt được phép tính nào. torchao được thiết kế để dùng cùngtorch.compile. Đây là minh chứng cụ thể cho nhận định ở Mục 1.4: lượng tử hóa chỉ nhanh khi có kernel phù hợp.- Độ trễ dao động vài chục phần trăm giữa các lần chạy (FP32 đo được từ 14 đến 17 ms), nên luôn cần khởi động (warm-up) và lấy trung bình nhiều lần.
Dynamic quantization trong torch.ao chỉ hỗ trợ nn.Linear, nn.LSTM, nn.GRU và một số lớp hồi quy khác, không hỗ trợ nn.Conv2d. Mô hình tích chập cần static quantization.
10.2TensorFlow Lite / LiteRT#
TensorFlow Lite đã được Google đổi tên thành LiteRT (2024); trình thông dịch có thể cài riêng qua gói ai-edge-litert. API chuyển đổi tf.lite.TFLiteConverter vẫn giữ nguyên.
Lưu ý
môi trường dựng tài liệu này không cài TensorFlow, nên các đoạn mã TF dưới đây không được chạy kiểm chứng như phần PyTorch. Chúng viết theo tài liệu chính thức về post-training quantization của TensorFlow.
import tensorflow as tf

def make_converter():                       # tạo converter MỚI cho mỗi cấu hình để tránh cấu hình cũ dính lại
    return tf.lite.TFLiteConverter.from_keras_model(model)

def representative_data_gen():              # dùng cho calibration (Chương 8)
    for x in tf.data.Dataset.from_tensor_slices(calib_images).batch(1).take(300):
        yield [x]

# 1) Dynamic range: trọng số INT8 lượng tử sẵn; activation lượng tử lúc chạy ở các op hỗ trợ
c = make_converter()
c.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_dynamic = c.convert()

# 2) Float16: trọng số lưu FP16
c = make_converter()
c.optimizations = [tf.lite.Optimize.DEFAULT]
c.target_spec.supported_types = [tf.float16]
tflite_fp16 = c.convert()

# 3) Full integer INT8: bắt buộc có representative dataset
c = make_converter()
c.optimizations = [tf.lite.Optimize.DEFAULT]
c.representative_dataset = representative_data_gen
c.target_spec.supported_ops = [tf.lite.OpsSet.TFLITE_BUILTINS_INT8]   # op không có bản INT8 -> báo lỗi, không lặng lẽ chạy FP32
c.inference_input_type = tf.int8
c.inference_output_type = tf.int8
tflite_int8 = c.convert()

# 4) 16x8: activation INT16, trọng số INT8; cho mô hình nhạy với sai số activation
c = make_converter()
c.optimizations = [tf.lite.Optimize.DEFAULT]
c.representative_dataset = representative_data_gen
c.target_spec.supported_ops = [tf.lite.OpsSet.EXPERIMENTAL_TFLITE_BUILTINS_ACTIVATIONS_INT16_WEIGHTS_INT8]
tflite_16x8 = c.convert()
Khi chạy mô hình full-integer, đầu vào phải được lượng tử bằng đúng mà mô hình khai báo:
interpreter = tf.lite.Interpreter(model_content=tflite_int8)
interpreter.allocate_tensors()
inp, out = interpreter.get_input_details()[0], interpreter.get_output_details()[0]
S, Z = inp["quantization"]
x_q = np.clip(np.round(x / S + Z), -128, 127).astype(np.int8)            # công thức Mục 3.2
interpreter.set_tensor(inp["index"], x_q[None])
interpreter.invoke()
y_q = interpreter.get_tensor(out["index"])
S_o, Z_o = out["quantization"]
y = S_o * (y_q.astype(np.float32) - Z_o)                                  # dequantize
QAT trong TensorFlow dùng gói tensorflow-model-optimization. Từ TensorFlow 2.16, Keras mặc định là Keras 3, còn gói này vẫn dựa trên Keras 2, nên thường phải cài tf_keras và đặt biến môi trường TF_USE_LEGACY_KERAS=1. Ngoài ra, quantize_model chỉ nhận mô hình Sequential hoặc Functional gồm các lớp Keras chuẩn; các lớp đóng gói như hub.KerasLayer không lượng tử được.
import tensorflow_model_optimization as tfmot

q_aware = tfmot.quantization.keras.quantize_model(model)   # chèn fake-quant (Hình 10)
q_aware.compile(optimizer=tf.keras.optimizers.Adam(1e-4),
                loss=tf.keras.losses.SparseCategoricalCrossentropy(from_logits=False),
                metrics=["accuracy"])
q_aware.fit(train_images, train_labels, epochs=2, validation_split=0.1)

c = tf.lite.TFLiteConverter.from_keras_model(q_aware)
c.optimizations = [tf.lite.Optimize.DEFAULT]
tflite_qat = c.convert()
10.3Đo lường đúng cách#
Một báo cáo lượng tử hóa đáng tin phải có đủ ba con số, đo trên thiết bị đích:
- Kích thước của file sẽ triển khai (không phải
state_dicttrong bộ nhớ). - Độ trễ: có warm-up, cố định số luồng, báo cáo trung bình hoặc trung vị qua nhiều lần chạy, ghi rõ batch size.
- Độ chính xác trên đúng tập kiểm tra và đúng pipeline tiền xử lý của mô hình FP32 gốc.
import os, time, torch

def size_mb(model):
    torch.save(model.state_dict(), "/tmp/_m.pt")
    s = os.path.getsize("/tmp/_m.pt") / 2**20
    os.remove("/tmp/_m.pt")
    return s

@torch.no_grad()
def latency_ms(model, x, n=100, warmup=10):
    for _ in range(warmup):
        model(x)
    t = time.perf_counter()
    for _ in range(n):
        model(x)
    return (time.perf_counter() - t) / n * 1000
11Quantization cho mô hình ngôn ngữ lớn (LLM)#
Từ năm 2022, LLM là nơi lượng tử hóa phát triển nhanh nhất. Chương này giải thích vì sao LLM cần những kỹ thuật riêng và ý tưởng cốt lõi của từng kỹ thuật.
11.1Vì sao LLM đặc biệt#
- Bộ nhớ là nút thắt. Mô hình 70 tỉ tham số cần 140 GB chỉ để chứa trọng số BF16, vượt dung lượng một GPU.
- Sinh văn bản là bài toán memory-bound. Mỗi token mới phải đọc toàn bộ trọng số một lần, nhưng với batch nhỏ, mỗi trọng số chỉ tham gia vài phép nhân (Mục 1.3). Vì vậy, weight-only 4 bit (W4A16) gần như tăng tốc tỉ lệ với mức nén dù phép nhân vẫn làm ở FP16.
- Activation có outlier có hệ thống. Dettmers và cộng sự (2022) quan sát thấy, khi mô hình đủ lớn (từ khoảng 6,7 tỉ tham số), xuất hiện một số ít chiều ẩn cố định có biên độ lớn gấp hàng chục lần phần còn lại, lặp lại ở hầu hết token và hầu hết lớp. Theo Mục 5.2, activation chỉ lượng tử được theo tensor hoặc theo token, không theo kênh, nên vài kênh outlier này làm hỏng scale của mọi kênh khác.
11.2LLM.int8(): tách riêng outlier#
LLM.int8() (Dettmers và cộng sự, 2022) kết hợp hai ý:
- Lượng tử theo vector: activation theo từng token (hàng), trọng số theo từng kênh đầu ra (cột). Cả hai scale đều đưa được ra ngoài tổng (Mục 5.2).
- Phân rã hỗn hợp độ chính xác: các chiều có ít nhất một giá trị với được tách ra và nhân bằng FP16; phần còn lại, chiếm tuyệt đại đa số, nhân bằng INT8. Hai kết quả được cộng lại.
11.3SmoothQuant: chuyển độ khó từ activation sang trọng số#
Activation khó lượng tử (có outlier theo kênh), còn trọng số dễ. SmoothQuant (Xiao và cộng sự, 2023) dùng một phép biến đổi tương đương toán học để san bớt độ khó:
với là chỉ số kênh đầu vào và điều chỉnh mức chuyển giao ( là lựa chọn mặc định của bài báo). Phép chia cho được gộp sẵn vào lớp LayerNorm đứng trước, nên lúc chạy không tốn thêm gì. Đây chính là ý tưởng CLE (Mục 9.5) áp dụng giữa activation và trọng số.
Thí nghiệm mô phỏng (dữ liệu tổng hợp: 2048 token, 512 kênh, trong đó 6 kênh có biên độ gấp 60 lần; trọng số per-channel INT8):
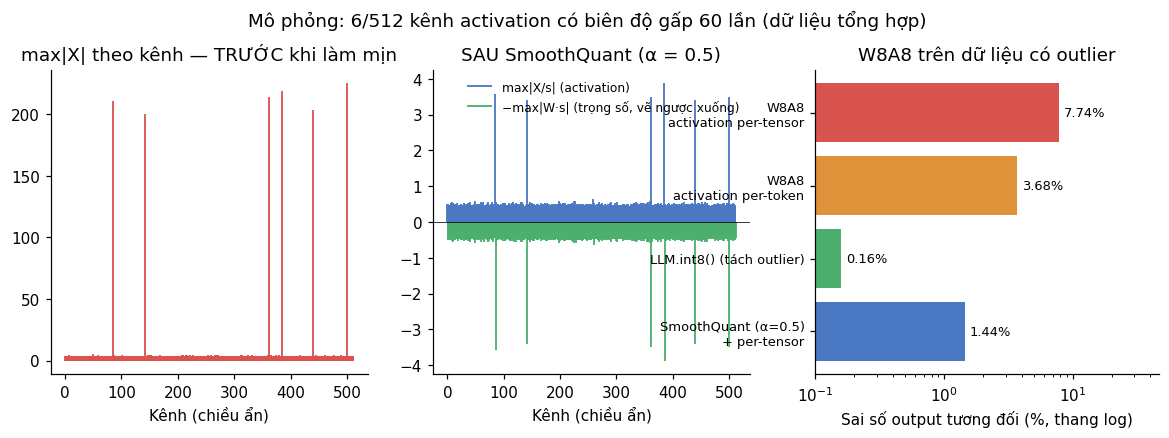
| Cách lượng tử activation | Sai số đầu ra tương đối |
|---|---|
| Per-tensor | 7,74% |
| Per-token | 3,68% |
| SmoothQuant () + per-tensor | 1,44% |
| LLM.int8() (tách 6 cột outlier sang FP16) | 0,16% |
LLM.int8() chính xác nhất nhưng cần một phép nhân FP16 riêng và thao tác gom tách cột, nên chậm hơn. SmoothQuant cho phép chạy W8A8 thuần INT8 với kernel chuẩn, nên nhanh. Lại một lần nữa là đánh đổi giữa độ chính xác và tốc độ.
11.4Lượng tử chỉ trọng số xuống 4 bit: GPTQ và AWQ#
GPTQ (Frantar và cộng sự, 2023) tối thiểu sai số đầu ra của lớp thay vì sai số trọng số. Hàm mục tiêu này có Hessian theo mỗi hàng trọng số. GPTQ lượng tử lần lượt từng cột. Sau khi lượng tử cột , sai số của nó được bù vào các cột chưa lượng tử theo công thức kế thừa từ Optimal Brain Surgeon:
Để ổn định số và nhanh, GPTQ dùng phân tích Cholesky của và xử lý theo khối cột. Nhờ vậy nó lượng tử được mô hình hàng trăm tỉ tham số trong vài giờ GPU.
Cài đặt tối giản (trích code/numpy_experiments.py):
def gptq(W, H, scales, qmax=7, damp=0.01):
    W = W.copy(); d = W.shape[1]
    H = H + damp * np.mean(np.diag(H)) * np.eye(d)          # damping cho ổn định số
    Hinv = np.linalg.cholesky(np.linalg.inv(H)).T            # Cholesky trên của H^-1
    Q = np.zeros_like(W)
    for i in range(d):
        w = W[:, i]
        q = np.clip(np.round(w / scales), -qmax, qmax) * scales
        Q[:, i] = q
        err = (w - q) / Hinv[i, i]
        W[:, i + 1:] -= np.outer(err, Hinv[i, i + 1:])       # bù sai số vào các cột phía sau
    return Q
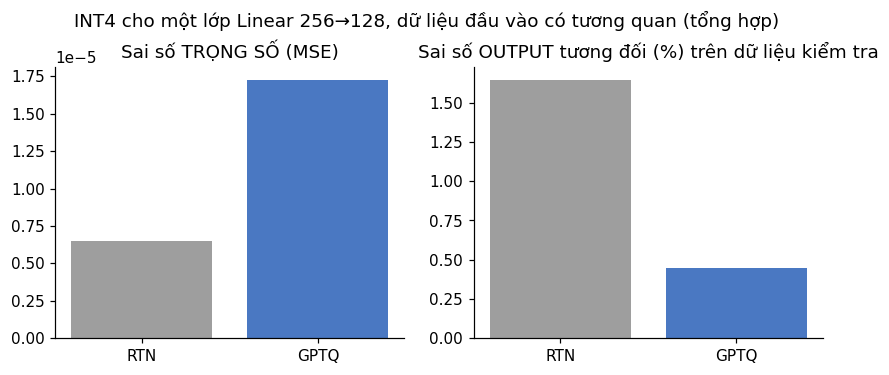
| Sai số trọng số (MSE) | Sai số đầu ra tương đối (dữ liệu kiểm tra) | |
|---|---|---|
| RTN (làm tròn thường) | 1,64% | |
| GPTQ | 0,45% |
Kết quả có vẻ nghịch lý nhưng rất đáng suy ngẫm: GPTQ làm sai số trọng số tăng 2,7 lần nhưng sai số đầu ra giảm 3,7 lần. Các sai số được sắp xếp để triệt tiêu nhau theo những hướng mà dữ liệu thực sự đi qua. Cái ta cần bảo toàn là hàm số mà lớp biểu diễn, không phải từng con số trong ma trận.
AWQ (Lin và cộng sự, 2024) xuất phát từ quan sát rằng khoảng 1% kênh trọng số là "quan trọng", và độ quan trọng được xác định bởi biên độ activation đi vào kênh đó chứ không phải bởi độ lớn trọng số. Thay vì giữ các kênh này ở FP16 (khó cho phần cứng), AWQ nhân chúng lên với hệ số trước khi lượng tử và chia lại ở activation. Sai số tương đối của kênh quan trọng nhờ đó giảm. Hệ số có dạng , với là biên độ trung bình activation theo kênh và được tìm bằng tìm kiếm lưới. AWQ không cần lan truyền ngược hay tái tạo từng cột như GPTQ, nên ít bị quá khớp vào tập calibration.
11.5NF4 và QLoRA#
NormalFloat 4 bit (NF4) (Dettmers và cộng sự, 2023) là kiểu dữ liệu không đều. Trọng số đã huấn luyện xấp xỉ phân phối chuẩn; sau khi chia mỗi khối 64 phần tử cho giá trị tuyệt đối lớn nhất của khối (absmax), chúng nằm trong . NF4 đặt 16 mức lượng tử tại các phân vị của phân phối chuẩn, sao cho mỗi mức "gánh" một lượng dữ liệu xấp xỉ bằng nhau. Cách dựng (theo mã nguồn thư viện bitsandbytes):
import numpy as np
from scipy.stats import norm

offset = 0.9677083
pos = norm.ppf(np.linspace(offset, 0.5, 9)[:-1])        # 8 mức dương
neg = -norm.ppf(np.linspace(offset, 0.5, 8)[:-1])       # 7 mức âm
nf4 = np.sort(np.concatenate([pos, [0.0], neg]))
nf4 /= nf4.max()
# [-1. -0.6962 -0.5251 -0.3949 -0.2844 -0.1848 -0.091  0.  0.0796 0.1609 0.2461 0.3379 0.4407 0.5626 0.723  1.]
Tập mức bất đối xứng (8 mức dương, 7 mức âm) để vừa có số 0 chính xác vừa dùng hết 16 mã. Các giá trị trên khớp với bảng trong bài báo QLoRA.
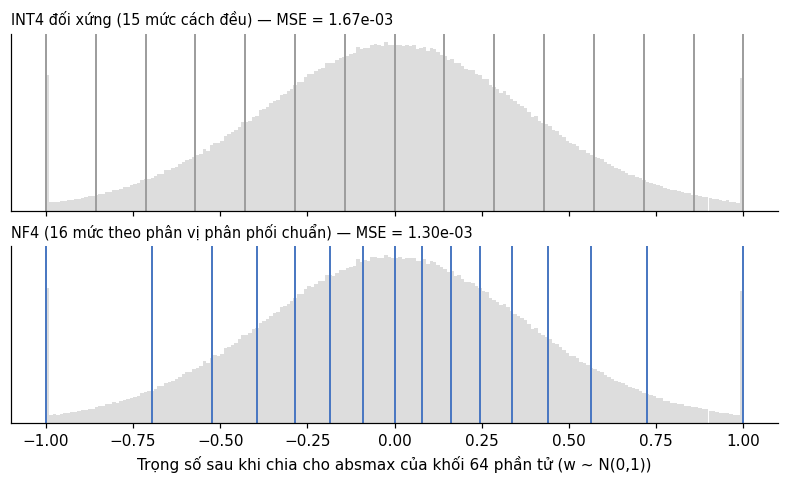
Double quantization. Mỗi khối 64 trọng số cần một hằng số absmax FP32, tốn thêm bit mỗi tham số. QLoRA lượng tử tiếp chính các hằng số này sang FP8 theo khối 256. Chi phí giảm còn bit mỗi tham số, tiết kiệm khoảng 0,373 bit.
QLoRA giữ mô hình gốc đông cứng ở NF4 và chỉ huấn luyện các adapter LoRA ở BF16. Khi tính, trọng số NF4 được giải lượng tử về BF16 ngay trước phép nhân. Vì vậy NF4 là định dạng lưu trữ chứ không phải định dạng tính toán. Nhờ đó, fine-tune mô hình hàng chục tỉ tham số vừa trên một GPU.
11.6FP8 và các định dạng microscaling#
- FP8 (Micikevicius và cộng sự, 2022) được hỗ trợ phần cứng từ thế hệ NVIDIA Hopper, dùng cho cả huấn luyện lẫn suy luận. Khuyến nghị thường gặp: E4M3 cho trọng số và activation, E5M2 cho gradient. Vì dải của FP8 hẹp (Mục 2.3), tensor vẫn cần một hệ số scale (thường theo tensor) để đưa giá trị vào dải biểu diễn được.
- Microscaling (MX) (Rouhani và cộng sự, 2023; chuẩn OCP): mỗi khối 32 phần tử dùng chung một hệ số scale là lũy thừa của 2, lưu 8 bit (E8M0). Các biến thể gồm MXFP8, MXFP6, MXFP4, MXINT8. Đây là per-group quantization (Mục 5.1) được chuẩn hóa ở mức phần cứng.
- NVFP4 của NVIDIA (thế hệ Blackwell) dùng phần tử FP4 (E2M1), khối 16 phần tử với scale FP8 E4M3, cộng thêm một scale FP32 cho cả tensor.
Xu hướng chung: số bit của phần tử giảm dần, bù lại bằng scale ở độ mịn cao hơn.
11.7Lượng tử KV cache#
Khi sinh văn bản, các vector key và value của mọi token trước đó được lưu lại (KV cache). Dung lượng của nó là
Ví dụ một mô hình 7B kiểu Llama-2 (32 lớp, 32 head, , không dùng GQA) ở FP16 cần byte, tức 0,5 MB cho mỗi token. Một chuỗi 4096 token chiếm 2 GB, và với batch lớn hoặc ngữ cảnh dài, KV cache có thể vượt cả trọng số. Lượng tử KV cache sang FP8/INT8 (hoặc thấp hơn) vì thế quan trọng không kém lượng tử trọng số. Nghiên cứu KIVI (Liu và cộng sự, 2024) cho thấy key nên lượng tử theo kênh (vì key có outlier theo kênh), còn value nên lượng tử theo token.
11.8Tính số bit thực tế mỗi trọng số#
Lượng tử theo nhóm phải trả thêm chi phí cho scale (và zero-point nếu có):
| Định dạng | Cấu trúc | Số bit mỗi trọng số |
|---|---|---|
| INT4 đối xứng, nhóm 128, scale FP16 | 4,125 | |
GGUF Q4_0 (llama.cpp) |
khối 32, mỗi khối một scale FP16 | |
GGUF Q8_0 |
khối 32, mỗi khối một scale FP16 | |
GGUF Q4_K |
siêu khối 256 = 8 khối con × 32; scale và min của khối con lượng tử 6 bit; siêu khối có 2 hệ số FP16 | |
| NF4 + double quantization (QLoRA) | khối 64, absmax lượng tử FP8 theo khối 256 |
Vì vậy, "mô hình 4 bit" trong thực tế thường là 4,1–4,5 bit mỗi trọng số, cộng thêm một số lớp (embedding, lớp đầu ra) giữ ở độ chính xác cao hơn.
11.9Công cụ thường gặp#
- bitsandbytes: LLM.int8(), NF4/FP4, tích hợp sẵn trong Hugging Face Transformers.
- llama.cpp: định dạng GGUF với nhiều mức lượng tử (
Q4_K_M,Q5_K_M,Q8_0…), chạy tốt trên CPU và máy cá nhân. - vLLM kèm llm-compressor, NVIDIA TensorRT Model Optimizer: phục vụ mô hình ở quy mô sản xuất với GPTQ, AWQ, SmoothQuant, FP8.
- torchao: API
quantize_cho PyTorch thuần (Mục 10.1).
12Quy trình làm việc và danh sách kiểm tra#
12.1Quy trình chọn phương pháp#
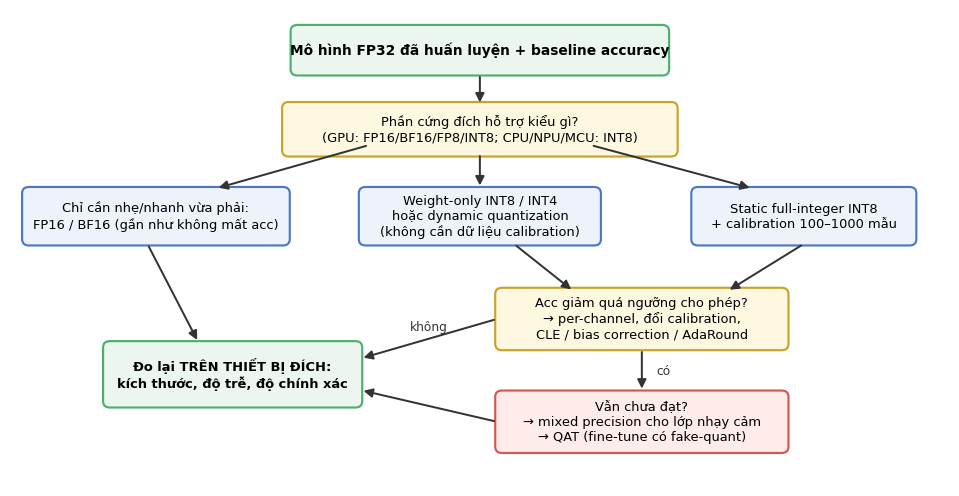
12.2Phân tích độ nhạy theo lớp#
Khi độ chính xác giảm, câu hỏi đầu tiên là: lớp nào gây ra? Cách làm đơn giản và hiệu quả nhất là lượng tử từng lớp một trong khi giữ các lớp khác ở FP32, rồi đo độ chính xác. Kết quả trên mô hình thí nghiệm, mỗi lớp lượng tử xuống 3 bit cả trọng số lẫn activation đầu ra (code/sensitivity.py):
| Lớp được lượng tử 3 bit | Độ chính xác | Giảm so với FP32 |
|---|---|---|
| conv1 (3×3, lớp đầu) | 95,19% | 4,07 điểm |
| dw (depthwise 3×3) | 96,30% | 2,96 điểm |
| pw (pointwise 1×1) | 87,96% | 11,30 điểm |
| conv4 (3×3) | 98,70% | 0,56 điểm |
| fc (Linear, lớp cuối) | 99,26% | 0,00 điểm |
Lớp nhạy nhất ở đây là lớp pointwise, trong khi lớp cuối gần như không nhạy. Điều này trái với quy tắc kinh nghiệm "lớp đầu và cuối nhạy nhất". Quy tắc kinh nghiệm chỉ là điểm xuất phát; đo trên chính mô hình của mình mới là căn cứ. Với kết quả trên, cấu hình hỗn hợp hợp lý là giữ pw ở 8 bit và hạ các lớp còn lại.
12.3Danh sách kiểm tra#
- Có baseline FP32 trên đúng tập kiểm tra và đúng pipeline tiền xử lý.
- Đã gộp BatchNorm và các chuỗi Conv–BN–ReLU trước khi lượng tử.
- Trọng số dùng per-channel đối xứng; activation dùng bất đối xứng (hoặc per-token với LLM).
- Tập calibration đại diện, 100–1000 mẫu, mô hình ở chế độ
eval(). - Thử ít nhất hai phương pháp calibration nếu độ chính xác giảm.
- Kiểm tra mọi op đều chạy ở kiểu mong muốn. Op không có kernel INT8 sẽ rơi về FP32, sinh các cặp quantize/dequantize thừa và có thể làm mô hình chậm hơn. Công cụ như Netron (xem đồ thị TFLite/ONNX) hoặc in mô hình PyTorch sau
convertgiúp kiểm tra điều này. - Làm phân tích độ nhạy theo lớp trước khi quyết định mixed precision hay QAT.
- Đo kích thước, độ trễ, độ chính xác trên thiết bị đích, không chỉ trên máy phát triển.
13Những hiểu lầm thường gặp#
| Hiểu lầm | Thực tế |
|---|---|
| "Lượng tử hóa luôn làm mô hình nhanh hơn." | Chỉ khi phần cứng và thư viện có kernel phù hợp. Mục 10.1.5 cho thấy weight-only INT8 chạy eager chậm hơn FP32 hơn 2 lần. |
| "INT8 luôn giảm kích thước đúng 4 lần." | Đúng với phần trọng số. File thực tế còn chứa siêu dữ liệu, scale và các lớp giữ FP32; mô hình nhỏ ở Mục 10.1.2 chỉ giảm 2,4 lần. |
| "FP32 dùng một số bit cho phần nguyên và số bit còn lại cho phần thập phân." | Sai. FP32 gồm 1 bit dấu, 8 bit exponent, 23 bit mantissa (Mục 2.2); vị trí dấu chấm được mã hóa qua exponent. |
| "Dynamic quantization lượng tử activation dựa trên thống kê một batch lúc chuyển đổi." | Trọng số được lượng tử sẵn lúc chuyển đổi; activation được lượng tử lúc chạy từ min/max của chính tensor đó, nên không cần dữ liệu calibration. |
"quantize_dynamic của PyTorch lượng tử cả Conv2d." |
Không. Chỉ Linear và các lớp hồi quy (LSTM, GRU…); tích chập cần static quantization. |
| "Sai số trọng số càng nhỏ thì mô hình càng chính xác." | Cái cần bảo toàn là đầu ra. GPTQ tăng sai số trọng số 2,7 lần nhưng giảm sai số đầu ra 3,7 lần (Mục 11.4). |
| "Dải min–max là an toàn nhất vì không cắt giá trị nào." | Min–max thường cho MSE lớn hơn nhiều so với ngưỡng tối ưu: 6,4 lần trong thí nghiệm Mục 4.3. |
| "QAT lúc nào cũng tốt hơn PTQ." | Ở 8 bit, PTQ thường ngang QAT với chi phí nhỏ hơn rất nhiều (Mục 9.3). QAT đáng giá ở số bit thấp hoặc với mô hình nhỏ, nhạy cảm. |
| "Lớp đầu và lớp cuối luôn là lớp nhạy nhất." | Chỉ là kinh nghiệm. Ở Mục 12.2, lớp cuối lại không nhạy chút nào; phải đo trên chính mô hình. |
14Bài tập#
Bài 1 (tính tay). Lượng tử dải sang uint8. Tính , , rồi lượng tử và giải lượng tử các giá trị ; ; ; . Giá trị nào chịu sai số cắt? Gợi ý: , . Chú ý quy tắc làm tròn nửa về số chẵn của NumPy.
Bài 2 (FP16). Hãy giải thích vì sao np.float16(2049.0) bằng 2048, và tìm số nguyên dương nhỏ nhất không biểu diễn chính xác được bằng FP16.
Gợi ý: FP16 có 11 bit độ chính xác kể cả bit ẩn. Đáp số: 2049.
Bài 3 (SQNR). Chứng minh rằng với lưới đối xứng đầy đủ và dữ liệu đều trên đúng dải biểu diễn, SQNR bằng dB. So sánh với kết quả ở Mục 4.2 và giải thích sự khác biệt.
Bài 4 (granularity). Viết lại lập luận ở Mục 5.2 cho phép tích chập 2D và chỉ ra trục nào của tensor trọng số có thể mang scale riêng mà vẫn tính được bằng số nguyên. Riêng với depthwise convolution (), điều gì thay đổi?
Bài 5 (số học số nguyên). Trong code/numpy_experiments.py, đổi trọng số sang lượng tử bất đối xứng (). Bổ sung đúng các số hạng ở Mục 6.2 để kết quả số nguyên vẫn trùng khớp từng bit với mô phỏng. Đếm số phép toán phát sinh thêm.
Bài 6 (calibration). Chạy lại thí nghiệm Mục 8.2 nhưng thêm vào tập calibration 1% ảnh nhiễu có biên độ lớn gấp 10 lần bình thường. Phương pháp nào bị ảnh hưởng nhiều nhất? Vì sao?
Bài 7 (QAT). Thay dải activation cố định bằng EMA trong qat() của code/torch_experiments.py bằng scale học được theo LSQ (Mục 9.2). So sánh độ chính xác ở W3A3 và W2A2.
Bài 8 (LLM). Trong mô phỏng ở Mục 11.3, quét từ 0 đến 1 với bước 0,1 và vẽ sai số đầu ra theo . Giải thích vì sao cả hai đầu và đều không tốt.
Bài 9 (tính dung lượng). Một mô hình 13 tỉ tham số, 40 lớp, 40 head, , không dùng GQA. Tính dung lượng trọng số ở dạng GGUF Q4_K và dung lượng KV cache FP16 cho batch 4, ngữ cảnh 8192 token. Thành phần nào lớn hơn?
15Tài liệu tham khảo#
Nền tảng
- M. Horowitz. Computing's energy problem (and what we can do about it). ISSCC 2014.
- B. Jacob et al. Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference. CVPR 2018. arXiv:1712.05877.
- R. Krishnamoorthi. Quantizing deep convolutional networks for efficient inference: A whitepaper. arXiv:1806.08342, 2018.
- M. Nagel et al. A White Paper on Neural Network Quantization. arXiv:2106.08295, 2021.
- A. Gholami et al. A Survey of Quantization Methods for Efficient Neural Network Inference. arXiv:2103.13630, 2021.
- S. Migacz. 8-bit Inference with TensorRT. NVIDIA GTC 2017.
Huấn luyện và PTQ nâng cao
- Y. Bengio, N. Léonard, A. Courville. Estimating or Propagating Gradients Through Stochastic Neurons for Conditional Computation. arXiv:1308.3432, 2013.
- S. K. Esser et al. Learned Step Size Quantization. ICLR 2020. arXiv:1902.08153.
- M. Nagel et al. Data-Free Quantization Through Weight Equalization and Bias Correction. ICCV 2019. arXiv:1906.04721.
- M. Nagel et al. Up or Down? Adaptive Rounding for Post-Training Quantization. ICML 2020. arXiv:2004.10568.
LLM và định dạng số mới
- T. Dettmers et al. LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale. NeurIPS 2022. arXiv:2208.07339.
- G. Xiao et al. SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models. ICML 2023. arXiv:2211.10438.
- E. Frantar et al. GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers. ICLR 2023. arXiv:2210.17323.
- J. Lin et al. AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration. MLSys 2024. arXiv:2306.00978.
- T. Dettmers et al. QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 2023. arXiv:2305.14314.
- Z. Liu et al. KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache. ICML 2024. arXiv:2402.02750.
- P. Micikevicius et al. FP8 Formats for Deep Learning. arXiv:2209.05433, 2022.
- B. D. Rouhani et al. Microscaling Data Formats for Deep Learning. arXiv:2310.10537, 2023.
Tài liệu công cụ
- PyTorch, Quantization (docs.pytorch.org) và torchao (github.com/pytorch/ao).
- TensorFlow / LiteRT, Post-training quantization (ai.google.dev/edge/litert).
Phụ lục: chạy lại toàn bộ thí nghiệm#
quantization/
├── quantization.md                     # tài liệu này
├── figs/                               # 17 hình, sinh bởi các script dưới
└── code/
    ├── fig_basics.py                   # Hình 1–7, 12, 16
    ├── fig_diagrams.py                 # Hình 9, 10, 17
    ├── numpy_experiments.py            # Mục 6.5, 11.3, 11.4; Hình 14, 15
    ├── torch_experiments.py            # Mục 5.3, 7.3, 8.2, 9.3, 10.1; Hình 8, 11, 13
    ├── torch_qat_eager.py              # Mục 10.1.3
    ├── sensitivity.py                  # Mục 12.2
    └── *_output.txt                    # kết quả in ra của từng script
pip install numpy scipy matplotlib scikit-learn torch torchao
python code/fig_basics.py
python code/fig_diagrams.py
python code/numpy_experiments.py
python code/torch_experiments.py        # vài phút trên CPU; huấn luyện mô hình, PTQ, QAT, backend INT8
python code/torch_qat_eager.py
python code/sensitivity.py
Các script đặt seed cố định nên kết quả độ chính xác lặp lại được trên cùng phiên bản thư viện. Riêng độ trễ phụ thuộc phần cứng và dao động giữa các lần chạy.