11Quantization cho mô hình ngôn ngữ lớn (LLM)#
Từ năm 2022, LLM là nơi lượng tử hóa phát triển nhanh nhất. Chương này giải thích vì sao LLM cần những kỹ thuật riêng và ý tưởng cốt lõi của từng kỹ thuật.
11.1Vì sao LLM đặc biệt#
- Bộ nhớ là nút thắt. Mô hình 70 tỉ tham số cần 140 GB chỉ để chứa trọng số BF16, vượt dung lượng một GPU.
- Sinh văn bản là bài toán memory-bound. Mỗi token mới phải đọc toàn bộ trọng số một lần, nhưng với batch nhỏ, mỗi trọng số chỉ tham gia vài phép nhân (Mục 1.3). Vì vậy, weight-only 4 bit (W4A16) gần như tăng tốc tỉ lệ với mức nén dù phép nhân vẫn làm ở FP16.
- Activation có outlier có hệ thống. Dettmers và cộng sự (2022) quan sát thấy, khi mô hình đủ lớn (từ khoảng 6,7 tỉ tham số), xuất hiện một số ít chiều ẩn cố định có biên độ lớn gấp hàng chục lần phần còn lại, lặp lại ở hầu hết token và hầu hết lớp. Theo Mục 5.2, activation chỉ lượng tử được theo tensor hoặc theo token, không theo kênh, nên vài kênh outlier này làm hỏng scale của mọi kênh khác.
11.2LLM.int8(): tách riêng outlier#
LLM.int8() (Dettmers và cộng sự, 2022) kết hợp hai ý:
- Lượng tử theo vector: activation theo từng token (hàng), trọng số theo từng kênh đầu ra (cột). Cả hai scale đều đưa được ra ngoài tổng (Mục 5.2).
- Phân rã hỗn hợp độ chính xác: các chiều có ít nhất một giá trị với được tách ra và nhân bằng FP16; phần còn lại, chiếm tuyệt đại đa số, nhân bằng INT8. Hai kết quả được cộng lại.
11.3SmoothQuant: chuyển độ khó từ activation sang trọng số#
Activation khó lượng tử (có outlier theo kênh), còn trọng số dễ. SmoothQuant (Xiao và cộng sự, 2023) dùng một phép biến đổi tương đương toán học để san bớt độ khó:
với là chỉ số kênh đầu vào và điều chỉnh mức chuyển giao ( là lựa chọn mặc định của bài báo). Phép chia cho được gộp sẵn vào lớp LayerNorm đứng trước, nên lúc chạy không tốn thêm gì. Đây chính là ý tưởng CLE (Mục 9.5) áp dụng giữa activation và trọng số.
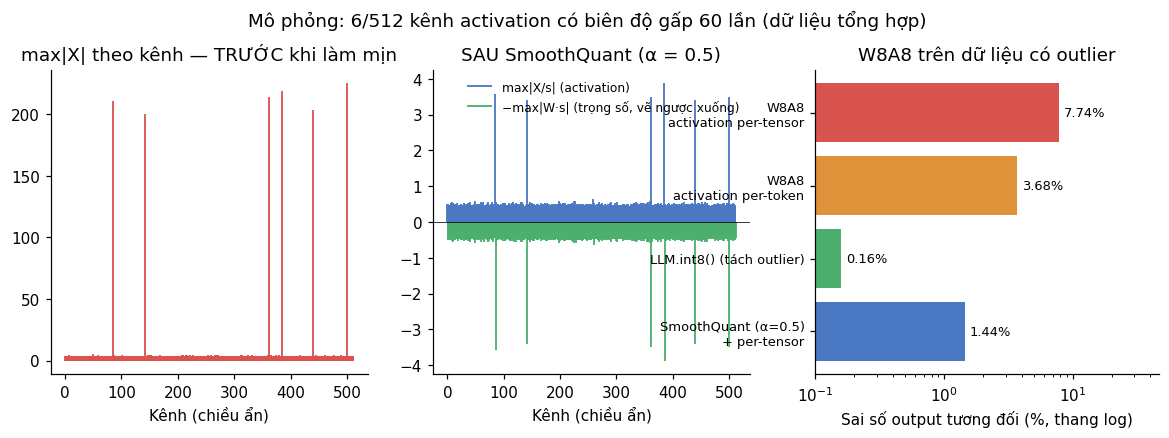
Thí nghiệm mô phỏng (dữ liệu tổng hợp: 2048 token, 512 kênh, trong đó 6 kênh có biên độ gấp 60 lần; trọng số per-channel INT8):
| Cách lượng tử activation | Sai số đầu ra tương đối |
|---|---|
| Per-tensor | 7,74% |
| Per-token | 3,68% |
| SmoothQuant () + per-tensor | 1,44% |
| LLM.int8() (tách 6 cột outlier sang FP16) | 0,16% |
LLM.int8() chính xác nhất nhưng cần một phép nhân FP16 riêng và thao tác gom tách cột, nên chậm hơn. SmoothQuant cho phép chạy W8A8 thuần INT8 với kernel chuẩn, nên nhanh. Lại một lần nữa là đánh đổi giữa độ chính xác và tốc độ.
11.4Lượng tử chỉ trọng số xuống 4 bit: GPTQ và AWQ#
GPTQ (Frantar và cộng sự, 2023) tối thiểu sai số đầu ra của lớp thay vì sai số trọng số. Hàm mục tiêu này có Hessian theo mỗi hàng trọng số. GPTQ lượng tử lần lượt từng cột. Sau khi lượng tử cột , sai số của nó được bù vào các cột chưa lượng tử theo công thức kế thừa từ Optimal Brain Surgeon:
Để ổn định số và nhanh, GPTQ dùng phân tích Cholesky của và xử lý theo khối cột. Nhờ vậy nó lượng tử được mô hình hàng trăm tỉ tham số trong vài giờ GPU.
Cài đặt tối giản (trích code/numpy_experiments.py):
def gptq(W, H, scales, qmax=7, damp=0.01):
    W = W.copy(); d = W.shape[1]
    H = H + damp * np.mean(np.diag(H)) * np.eye(d)          # damping cho ổn định số
    Hinv = np.linalg.cholesky(np.linalg.inv(H)).T            # Cholesky trên của H^-1
    Q = np.zeros_like(W)
    for i in range(d):
        w = W[:, i]
        q = np.clip(np.round(w / scales), -qmax, qmax) * scales
        Q[:, i] = q
        err = (w - q) / Hinv[i, i]
        W[:, i + 1:] -= np.outer(err, Hinv[i, i + 1:])       # bù sai số vào các cột phía sau
    return Q
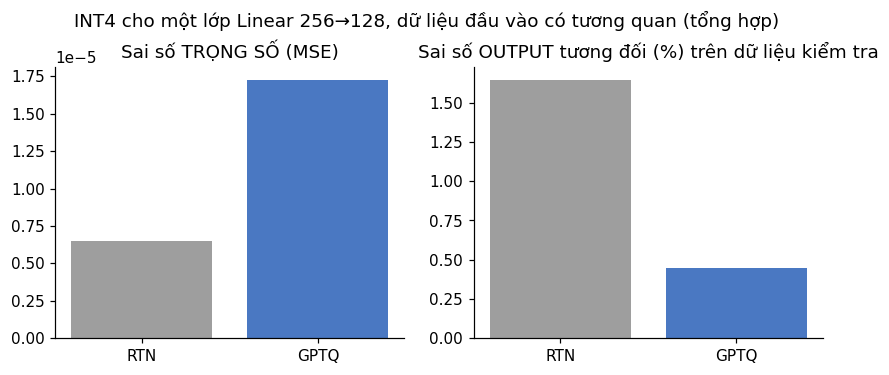
| Sai số trọng số (MSE) | Sai số đầu ra tương đối (dữ liệu kiểm tra) | |
|---|---|---|
| RTN (làm tròn thường) | 1,64% | |
| GPTQ | 0,45% |
Kết quả có vẻ nghịch lý nhưng rất đáng suy ngẫm: GPTQ làm sai số trọng số tăng 2,7 lần nhưng sai số đầu ra giảm 3,7 lần. Các sai số được sắp xếp để triệt tiêu nhau theo những hướng mà dữ liệu thực sự đi qua. Cái ta cần bảo toàn là hàm số mà lớp biểu diễn, không phải từng con số trong ma trận.
AWQ (Lin và cộng sự, 2024) xuất phát từ quan sát rằng khoảng 1% kênh trọng số là "quan trọng", và độ quan trọng được xác định bởi biên độ activation đi vào kênh đó chứ không phải bởi độ lớn trọng số. Thay vì giữ các kênh này ở FP16 (khó cho phần cứng), AWQ nhân chúng lên với hệ số trước khi lượng tử và chia lại ở activation. Sai số tương đối của kênh quan trọng nhờ đó giảm. Hệ số có dạng , với là biên độ trung bình activation theo kênh và được tìm bằng tìm kiếm lưới. AWQ không cần lan truyền ngược hay tái tạo từng cột như GPTQ, nên ít bị quá khớp vào tập calibration.
11.5NF4 và QLoRA#
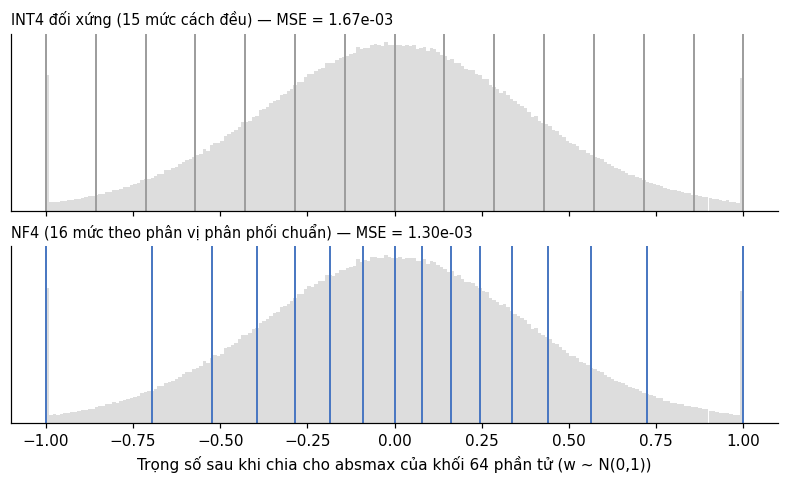
NormalFloat 4 bit (NF4) (Dettmers và cộng sự, 2023) là kiểu dữ liệu không đều. Trọng số đã huấn luyện xấp xỉ phân phối chuẩn; sau khi chia mỗi khối 64 phần tử cho giá trị tuyệt đối lớn nhất của khối (absmax), chúng nằm trong . NF4 đặt 16 mức lượng tử tại các phân vị của phân phối chuẩn, sao cho mỗi mức "gánh" một lượng dữ liệu xấp xỉ bằng nhau. Cách dựng (theo mã nguồn thư viện bitsandbytes):
import numpy as np
from scipy.stats import norm

offset = 0.9677083
pos = norm.ppf(np.linspace(offset, 0.5, 9)[:-1])        # 8 mức dương
neg = -norm.ppf(np.linspace(offset, 0.5, 8)[:-1])       # 7 mức âm
nf4 = np.sort(np.concatenate([pos, [0.0], neg]))
nf4 /= nf4.max()
# [-1. -0.6962 -0.5251 -0.3949 -0.2844 -0.1848 -0.091  0.  0.0796 0.1609 0.2461 0.3379 0.4407 0.5626 0.723  1.]
Tập mức bất đối xứng (8 mức dương, 7 mức âm) để vừa có số 0 chính xác vừa dùng hết 16 mã. Các giá trị trên khớp với bảng trong bài báo QLoRA.
Double quantization. Mỗi khối 64 trọng số cần một hằng số absmax FP32, tốn thêm bit mỗi tham số. QLoRA lượng tử tiếp chính các hằng số này sang FP8 theo khối 256. Chi phí giảm còn bit mỗi tham số, tiết kiệm khoảng 0,373 bit.
QLoRA giữ mô hình gốc đông cứng ở NF4 và chỉ huấn luyện các adapter LoRA ở BF16. Khi tính, trọng số NF4 được giải lượng tử về BF16 ngay trước phép nhân. Vì vậy NF4 là định dạng lưu trữ chứ không phải định dạng tính toán. Nhờ đó, fine-tune mô hình hàng chục tỉ tham số vừa trên một GPU.
11.6FP8 và các định dạng microscaling#
- FP8 (Micikevicius và cộng sự, 2022) được hỗ trợ phần cứng từ thế hệ NVIDIA Hopper, dùng cho cả huấn luyện lẫn suy luận. Khuyến nghị thường gặp: E4M3 cho trọng số và activation, E5M2 cho gradient. Vì dải của FP8 hẹp (Mục 2.3), tensor vẫn cần một hệ số scale (thường theo tensor) để đưa giá trị vào dải biểu diễn được.
- Microscaling (MX) (Rouhani và cộng sự, 2023; chuẩn OCP): mỗi khối 32 phần tử dùng chung một hệ số scale là lũy thừa của 2, lưu 8 bit (E8M0). Các biến thể gồm MXFP8, MXFP6, MXFP4, MXINT8. Đây là per-group quantization (Mục 5.1) được chuẩn hóa ở mức phần cứng.
- NVFP4 của NVIDIA (thế hệ Blackwell) dùng phần tử FP4 (E2M1), khối 16 phần tử với scale FP8 E4M3, cộng thêm một scale FP32 cho cả tensor.
Xu hướng chung: số bit của phần tử giảm dần, bù lại bằng scale ở độ mịn cao hơn.
11.7Lượng tử KV cache#
Khi sinh văn bản, các vector key và value của mọi token trước đó được lưu lại (KV cache). Dung lượng của nó là
Ví dụ một mô hình 7B kiểu Llama-2 (32 lớp, 32 head, , không dùng GQA) ở FP16 cần byte, tức 0,5 MB cho mỗi token. Một chuỗi 4096 token chiếm 2 GB, và với batch lớn hoặc ngữ cảnh dài, KV cache có thể vượt cả trọng số. Lượng tử KV cache sang FP8/INT8 (hoặc thấp hơn) vì thế quan trọng không kém lượng tử trọng số. Nghiên cứu KIVI (Liu và cộng sự, 2024) cho thấy key nên lượng tử theo kênh (vì key có outlier theo kênh), còn value nên lượng tử theo token.
11.8Tính số bit thực tế mỗi trọng số#
Lượng tử theo nhóm phải trả thêm chi phí cho scale (và zero-point nếu có):
| Định dạng | Cấu trúc | Số bit mỗi trọng số |
|---|---|---|
| INT4 đối xứng, nhóm 128, scale FP16 | 4,125 | |
GGUF Q4_0 (llama.cpp) |
khối 32, mỗi khối một scale FP16 | |
GGUF Q8_0 |
khối 32, mỗi khối một scale FP16 | |
GGUF Q4_K |
siêu khối 256 = 8 khối con × 32; scale và min của khối con lượng tử 6 bit; siêu khối có 2 hệ số FP16 | |
| NF4 + double quantization (QLoRA) | khối 64, absmax lượng tử FP8 theo khối 256 |
Vì vậy, "mô hình 4 bit" trong thực tế thường là 4,1–4,5 bit mỗi trọng số, cộng thêm một số lớp (embedding, lớp đầu ra) giữ ở độ chính xác cao hơn.
11.9Công cụ thường gặp#
- bitsandbytes: LLM.int8(), NF4/FP4, tích hợp sẵn trong Hugging Face Transformers.
- llama.cpp: định dạng GGUF với nhiều mức lượng tử (
Q4_K_M,Q5_K_M,Q8_0…), chạy tốt trên CPU và máy cá nhân. - vLLM kèm llm-compressor, NVIDIA TensorRT Model Optimizer: phục vụ mô hình ở quy mô sản xuất với GPTQ, AWQ, SmoothQuant, FP8.
- torchao: API
quantize_cho PyTorch thuần (Mục 10.1).
Tự kiểm tra
7 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao weight-only 4 bit (W4A16) tăng tốc LLM gần tỉ lệ với mức nén?
Vì sao: Phép nhân vẫn làm ở FP16. Cái được cải thiện là số byte phải kéo từ bộ nhớ về — đúng nhận định ở Mục 1.3.2SmoothQuant làm gì?
Vì sao: . Phép chia cho được gộp sẵn vào LayerNorm đứng trước nên lúc chạy không tốn thêm gì. Phương án "tách outlier sang FP16" là LLM.int8().3Kết quả nào của GPTQ nghe nghịch lý nhưng rất đáng suy ngẫm?
Vì sao: Các sai số được sắp xếp để triệt tiêu nhau theo những hướng mà dữ liệu thực sự đi qua. Cái cần bảo toàn là hàm số mà lớp biểu diễn, không phải từng con số trong ma trận.4NF4 đặt 16 mức lượng tử ở đâu?
Vì sao: Trọng số đã huấn luyện xấp xỉ phân phối chuẩn; sau khi chia mỗi khối 64 phần tử cho absmax, chúng nằm trong . Tập mức bất đối xứng (8 dương, 7 âm) để vừa có số 0 chính xác vừa dùng hết 16 mã. NF4 là định dạng lưu trữ, không phải định dạng tính toán.5"Mô hình 4 bit" trong thực tế tốn bao nhiêu bit mỗi trọng số?
Vì sao: Ví dụ: INT4 nhóm 128 scale FP16 là ; GGUFQ4_0vàQ4_Kđều là 4,5. Cộng thêm một số lớp (embedding, lớp đầu ra) thường giữ ở độ chính xác cao hơn.6Quét của SmoothQuant trên chính dữ liệu của Mục 11.3 cho kết quả nào?
Vì sao: Đo thật bằngcode/sweep_alpha.py: 8,02% tại , 1,44% tại 0,5, 1,34% tại 0,60, 3,64% tại 1,0. Biến đổi tuy tương đương về mặt toán học nhưng nó đổi dữ liệu đem đi lượng tử, nên sai số đổi theo. Xem Bài 8.7Vì sao cực tiểu lại lệch sang phải điểm cân bằng ?
Vì sao: Đo riêng từng nguồn ở : sai số do trọng số 0,60%, do activation 1,31%. Vế có 512 scale hấp thụ cùng một mức chênh lệch rẻ hơn hẳn vế chỉ có 1 scale, nên đẩy thêm độ khó sang trọng số vẫn còn lợi. Quy tắc mang đi được: cực tiểu lệch về phía tensor có granularity mịn hơn.
Đã trả lời 0/7