9Attention và Transformer#
Mục 8.4 kết thúc ở bảng so sánh một lớp RNN với một lớp self-attention: self-attention tốn nhiều phép tính hơn nhưng không có bước tuần tự nào, và mọi cặp vị trí chỉ cách nhau một bước. Transformer (Vaswani và cộng sự, 2017) xây toàn bộ kiến trúc quanh phép toán đó, và ngày nay là kiến trúc của gần như mọi mô hình ngôn ngữ lớn. Ta bắt đầu từ attention như một phép tra cứu, rồi lần lượt ghép các thành phần lại thành một khối Transformer hoàn chỉnh.
9.1Attention như phép tra cứu mềm#
Một từ điển trả về giá trị ứng với khoá khớp đúng truy vấn. Attention làm việc tương tự nhưng mềm hơn: nó so truy vấn với mọi khoá, biến các độ giống nhau thành trọng số dương có tổng bằng 1, rồi trả về trung bình có trọng số của các giá trị. Vì mọi bước đều khả vi, cả phép tra cứu có thể học bằng gradient descent.
Định nghĩa 9.1 (Scaled dot-product attention)
Cho ma trận truy vấn , khoá và giá trị ,
trong đó softmax áp dụng cho từng hàng. Ma trận gọi là ma trận trọng số attention; mỗi hàng của nó không âm và có tổng bằng 1.
Ba ma trận đóng ba vai khác nhau trong phép tra cứu, như bảng dưới tóm tắt. Alammar (2019) ví chúng với một tủ hồ sơ: truy vấn là tờ giấy ghi điều cần tìm, khoá là nhãn dán trên từng tập hồ sơ, còn giá trị là nội dung bên trong; attention so tờ giấy với mọi nhãn rồi lấy về một hỗn hợp nội dung theo mức khớp.
| Ký hiệu | Vai trò |
|---|---|
| (query, truy vấn) | thông tin mà vị trí đang xét cần tìm |
| (key, khoá) | đặc điểm để so khớp của từng vị trí |
| (value, giá trị) | nội dung được lấy về từ từng vị trí |
Trong self-attention, cả ba ma trận là phép chiếu tuyến tính của cùng một chuỗi đầu vào : , , . Trong cross-attention, lấy từ một chuỗi còn và lấy từ chuỗi khác, chẳng hạn câu đang dịch và câu nguồn. Cơ chế attention được Bahdanau, Cho và Bengio (2015) đưa vào dịch máy trước khi có Transformer, dùng kết hợp với RNN.
Bài giảng CS224n dựng Transformer theo một trình tự đáng theo: bắt đầu từ self-attention thuần, chỉ ra từng thiếu sót của nó, rồi thêm đúng một thành phần để sửa mỗi thiếu sót. Self-attention thuần không biết thứ tự của các token, nên cần mã hoá vị trí (Mục 9.6). Nó chỉ lấy trung bình có trọng số, nên cần thêm một khối phi tuyến cho từng vị trí (Mục 9.5). Và khi sinh văn bản, nó nhìn thấy cả các token tương lai, nên cần mặt nạ (Mục 9.4). Các mục dưới đi qua từng thành phần đó, sau khi xét kỹ phép tính attention.
Ví dụ 9.1
Truy vấn , ba khoá , , và ba giá trị , , , với . Điểm số là ; chia cho được . Softmax cho trọng số : truy vấn "giống" khoá 1 và khoá 3 như nhau và giống khoá 2 ít hơn. Đầu ra là .
9.2Phép chia cho #
Trong Định nghĩa 9.1, điểm số được chia cho trước softmax. Phép chia này trông như một chi tiết nhỏ, nhưng thiếu nó thì attention gần như không học được khi lớn.
Mệnh đề 9.1
Nếu các thành phần của là các biến ngẫu nhiên độc lập, có trung bình 0 và phương sai 1, thì có trung bình 0 và phương sai .
Chứng minh
. Mỗi số hạng có và . Các số hạng độc lập với nhau, nên phương sai của tổng bằng tổng các phương sai, tức .
Như vậy độ lệch chuẩn của điểm số tăng theo : với , các điểm số trải trong khoảng cỡ ; với là . Softmax của các số chênh nhau hàng chục đơn vị gần như là một vector one-hot. Karpathy (2023) cho thấy điều này bằng một phép thử nhỏ, có thể làm lại với số riêng: softmax của bốn điểm số 0,2; ; 0,4; 0 là , khá đều; nhân cả bốn với 8, như khi độ lệch chuẩn của điểm số lớn gấp 8 lần, softmax thành , gần như dồn hết vào một khoá. Đạo hàm của softmax là , và khi gần one-hot thì mọi phần tử của ma trận này đều gần 0, nên gradient gần như không truyền qua được. Chia điểm số cho đưa phương sai về 1 với mọi . Vaswani và cộng sự (2017) nêu lập luận này trong chú thích 4 của bài báo.
Thí nghiệm trong code/models/experiments.py kiểm tra cả hai vế của lập luận: tạo 4 000 truy vấn và 64 khoá ngẫu nhiên theo phân phối chuẩn tắc, đo phương sai của điểm số và entropy của phân phối attention trên 64 khoá, có và không có phép chia.
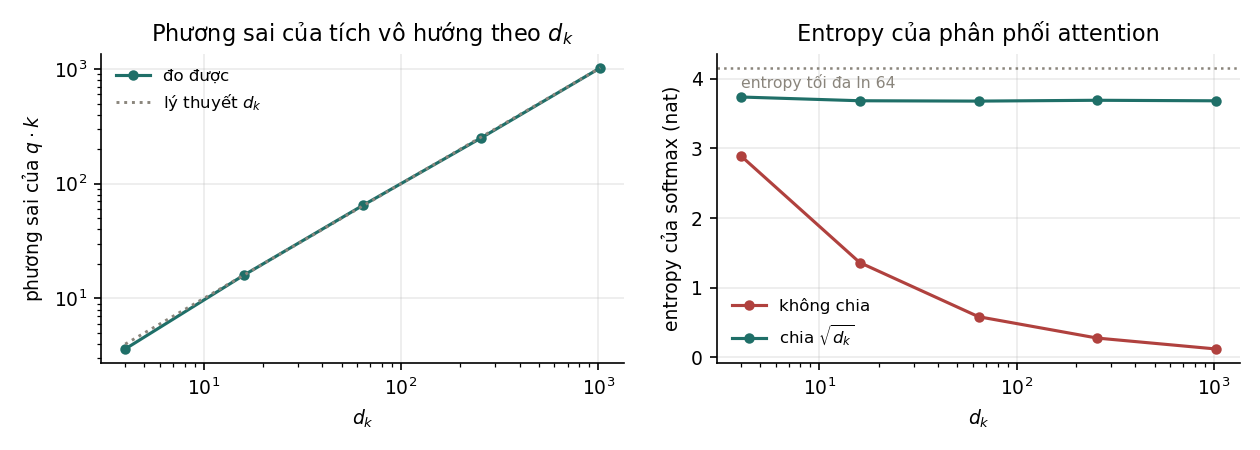
| đo được | Lý thuyết | Entropy, không chia | Entropy, có chia | Trọng số lớn nhất, không chia | |
|---|---|---|---|---|---|
| 4 | 3,63 | 4 | 2,892 | 3,739 | 0,258 |
| 16 | 15,99 | 16 | 1,360 | 3,685 | 0,584 |
| 64 | 64,66 | 64 | 0,582 | 3,680 | 0,791 |
| 256 | 251,67 | 256 | 0,275 | 3,692 | 0,894 |
| 1 024 | 1 021,97 | 1 024 | 0,118 | 3,685 | 0,953 |
Phương sai đo được khớp lý thuyết ở mọi . Không chia thì entropy giảm dần về 0: ở , entropy chỉ còn 0,118 nat, trong khi giá trị lớn nhất có thể là nat khi trọng số chia đều, và trọng số lớn nhất trung bình là 0,953, tức attention gần như chỉ chọn một khoá. Có chia thì entropy giữ quanh 3,68 với mọi , nghĩa là hành vi của attention không còn phụ thuộc vào số chiều được chọn cho mỗi đầu.
9.3Attention nhiều đầu#
Thay vì một phép attention trên chiều, attention nhiều đầu (multi-head attention) chiếu đầu vào xuống không gian con, mỗi không gian chiều, thực hiện phép attention song song, rồi nối kết quả và chiếu lại:
Bài báo gốc dùng , , . Phép chia ở Mục 9.2 dùng số chiều của mỗi đầu, , không phải , vì phương sai cần đưa về 1 là phương sai của tích vô hướng trong từng đầu. Về cài đặt, đầu được tính cùng lúc như thêm một trục lô, nên chi phí gần như bằng một đầu trên đủ chiều. Vì mỗi đầu hẹp đi lần, tổng số tham số, cho , , , , và tổng số phép tính gần như bằng attention một đầu trên đủ chiều. Nhiều đầu không mua thêm khả năng tính toán mà cho phép mô hình cùng lúc chú ý tới những loại quan hệ khác nhau ở những vị trí khác nhau, chẳng hạn một đầu theo quan hệ cú pháp, một đầu theo từ đồng tham chiếu. Với một đầu duy nhất, phép lấy trung bình có trọng số sẽ trộn lẫn các quan hệ đó.
Không phải đầu nào cũng quan trọng như nhau. Michel, Levy và Neubig (2019) cho thấy có thể bỏ phần lớn các đầu của một mô hình đã huấn luyện mà chất lượng giảm rất ít, dù một số ít đầu là thiết yếu. Nhận xét này là cơ sở cho các cách chia sẻ khoá và giá trị giữa các đầu ở Mục 10.4.
9.4Mặt nạ#
Đôi khi một vị trí không được phép nhìn một số vị trí khác. Hai loại mặt nạ thường gặp có mục đích khác nhau.
| Loại | Che các vị trí nào | Mục đích |
|---|---|---|
| Mặt nạ nhân quả (causal mask) | mọi vị trí khi tính đầu ra tại vị trí | mô hình sinh văn bản không được nhìn thấy các token phía sau |
| Mặt nạ đệm (padding mask) | các vị trí đệm thêm để các chuỗi trong lô dài bằng nhau | phần đệm không đóng góp vào kết quả |
Mặt nạ được cài đặt bằng cách cộng , trong thực tế là một số âm rất lớn, vào điểm số của các vị trí bị che trước khi tính softmax, để sau softmax trọng số của chúng bằng đúng 0. Chẳng hạn với ba token có điểm số bằng nhau ở mọi cặp, không có mặt nạ thì mỗi hàng của ma trận trọng số là . Có mặt nạ nhân quả, hàng thứ nhất chỉ còn chính nó, ; hàng thứ hai chia đều cho hai vị trí đầu, ; hàng thứ ba giữ nguyên . Ba hàng đó là ma trận tam giác dưới chuẩn hoá theo hàng, và nhân nó với dãy vector giá trị , , cho , , : mỗi vị trí lấy trung bình của chính nó và mọi vị trí trước nó. Karpathy (2023) giới thiệu self-attention nhân quả bằng đúng phép nhân này, rồi thay các điểm số bằng nhau bằng các điểm số học được từ truy vấn và khoá. Lý do dùng một số âm rất lớn thay cho thật là nếu cả một hàng bị che, softmax trên toàn cho kết quả NaN.
Mặt nạ nhân quả còn cho phép một điều quan trọng khi huấn luyện. Với một chuỗi token, một lượt xuôi duy nhất tính được dự đoán cho cả vị trí cùng lúc, và vị trí nào cũng chỉ thấy các token phía trước nó. Mỗi chuỗi huấn luyện vì vậy cho bài toán dự đoán token tiếp theo, tính song song. RNN cũng cho dự đoán, nhưng phải tính tuần tự.
9.5Cấu trúc một khối Transformer#
Attention nhiều đầu, mặt nạ, chuẩn hoá và kết nối tắt ở Chương 6 ghép lại thành một khối Transformer.
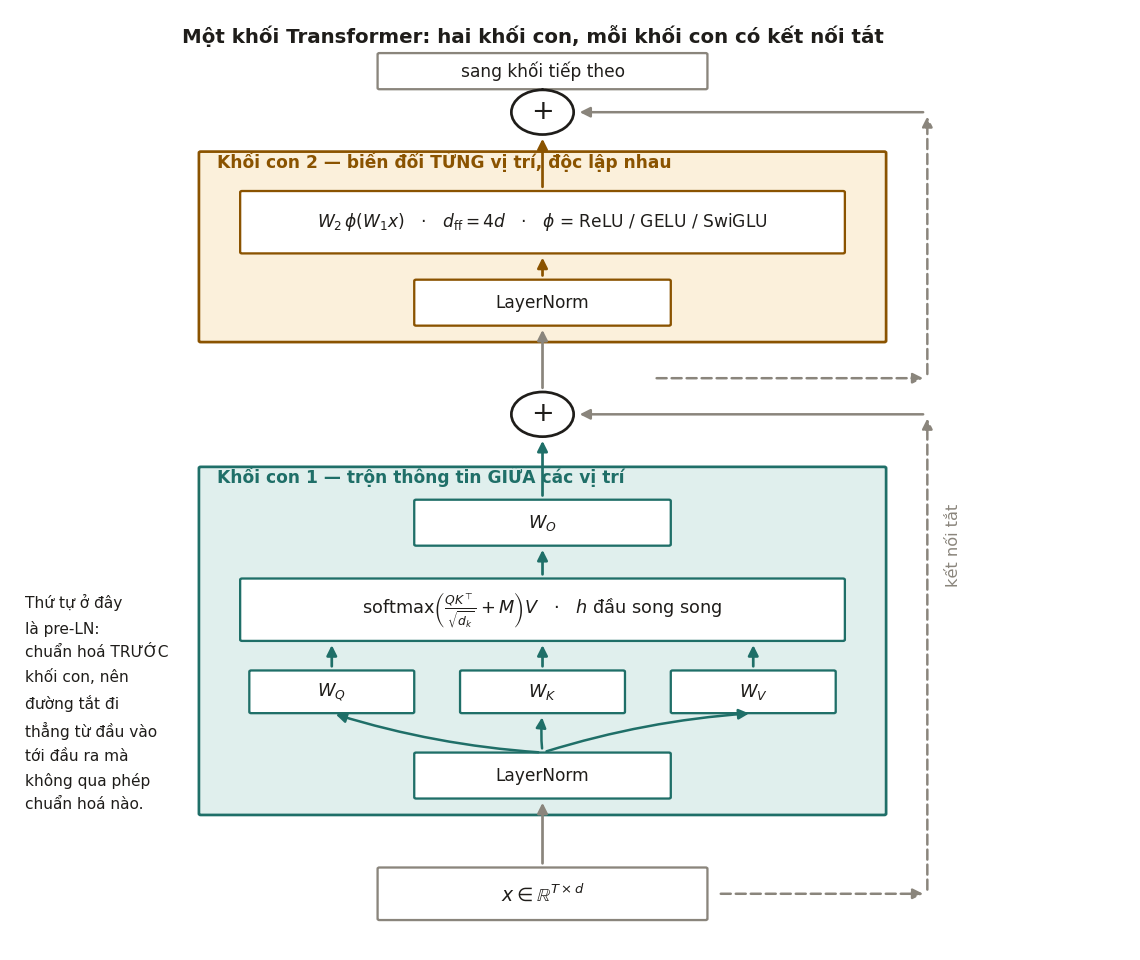
Một khối Transformer theo thứ tự pre-LN tính
trong đó là một MLP hai lớp áp dụng riêng cho từng vị trí, thường với . Một mô hình gồm nhiều khối như vậy xếp chồng, cộng với lớp embedding ở đầu và lớp chiếu ra từ vựng ở cuối. Hai khối con phân công rõ ràng, như bảng dưới cho thấy.
| Khối con attention | Khối con FFN | |
|---|---|---|
| Kết hợp thông tin theo trục nào | giữa các vị trí | giữa các chiều đặc trưng của cùng một vị trí |
| Các vị trí có được xử lý độc lập không | không: mỗi vị trí nhìn thấy các vị trí khác | có: từng vị trí xử lý riêng |
| Số tham số, với , bỏ qua hệ số chặn | ||
| Số phép tính theo độ dài chuỗi |
Từ bảng rút ra hai điều mà người mới thường không để ý. FFN chiếm hai phần ba số tham số của mỗi khối, dù attention là phần được nói tới nhiều hơn; Chương 12 kiểm chứng con số này trên GPT-2. Và attention là thành phần duy nhất kết hợp thông tin giữa các vị trí: bỏ attention đi, Transformer chỉ còn là một MLP áp dụng độc lập cho từng token. Chiều ngược lại cũng đáng nhớ: bỏ FFN đi thì đầu ra của mỗi lớp chỉ là trung bình có trọng số của các phép biến đổi tuyến tính của đầu vào, và ghi chú CS224n của Hewitt chỉ ra rằng thiếu phần phi tuyến theo từng vị trí, mô hình không biến đổi được đặc trưng của từng token. Karpathy (2023) tóm gọn sự phân công này: attention là cơ chế để các token trao đổi thông tin với nhau, còn FFN là nơi mỗi token xử lý thông tin vừa nhận được.
9.6Mã hoá vị trí#
Self-attention không có khái niệm thứ tự. Nếu hoán vị các token đầu vào, khi không có mặt nạ, thì các vector đầu ra chỉ hoán vị theo, giá trị của từng vector không đổi. Hai câu "chó cắn người" và "người cắn chó" vì vậy sẽ cho cùng một tập biểu diễn. Ví dụ 9.1 cho thấy điều này ở quy mô nhỏ: đổi thứ tự ba cặp khoá–giá trị thì ba trọng số đổi chỗ theo, còn đầu ra vẫn là , vì trung bình có trọng số không phụ thuộc thứ tự cộng. Thông tin vị trí phải được đưa vào riêng, và có ba cách chính.
Cách đầu tiên, dùng trong bài báo gốc (Vaswani và cộng sự, 2017), là mã hoá sin–cos cố định: cộng vào embedding của token ở vị trí vector với và . Cách này không có tham số học, và bài báo gốc thấy embedding vị trí học được cho kết quả gần như như nhau. Các tần số khác nhau cho phép biểu diễn cả khoảng cách gần lẫn xa, và là một phép biến đổi tuyến tính của , nên mô hình có thể học quan hệ theo khoảng cách tương đối.
Cách thứ hai, dùng trong BERT và GPT-2, là embedding vị trí học được: một bảng tra kích thước , học như embedding của từ. Cách này đơn giản, nhưng không dùng được cho vị trí vượt quá , tức 512 với BERT và 1 024 với GPT-2.
Cách thứ ba đưa khoảng cách giữa hai vị trí trực tiếp vào điểm số attention thay vì cộng vào embedding. RoPE (Mục 10.3) xoay truy vấn và khoá theo vị trí; ALiBi (Press, Smith và Lewis, 2022) cộng vào điểm số một đại lượng tỉ lệ với khoảng cách. Đây là hướng mà phần lớn mô hình ngôn ngữ hiện nay đi theo.
9.7Encoder, decoder và encoder–decoder#
Bài báo gốc của Transformer dùng kiến trúc encoder–decoder cho dịch máy. Các mô hình về sau dùng một trong ba kiểu, khác nhau ở loại attention và mục tiêu tiền huấn luyện.
| Kiểu | Attention | Mục tiêu tiền huấn luyện | Mô hình tiêu biểu | Dùng cho |
|---|---|---|---|---|
| Chỉ encoder | hai chiều: mỗi token thấy mọi token | đoán các token bị che (masked language modeling) | BERT (Devlin và cộng sự, 2019), 110 triệu tham số với bản base | phân loại, trích xuất thông tin, embedding cho tìm kiếm |
| Chỉ decoder | nhân quả: mỗi token chỉ thấy các token phía trước | đoán token tiếp theo | GPT-2 (Radford và cộng sự, 2019), các mô hình ngôn ngữ lớn hiện nay | sinh văn bản, và qua sinh văn bản là hầu hết các nhiệm vụ khác |
| Encoder–decoder | encoder hai chiều; decoder nhân quả, thêm cross-attention tới đầu ra của encoder | khôi phục các đoạn văn bị che | T5 (Raffel và cộng sự, 2020) | dịch máy, tóm tắt, các bài toán biến chuỗi thành chuỗi |
BERT che ngẫu nhiên 15% số token và học đoán lại chúng từ cả hai phía, nên biểu diễn của mỗi token chứa thông tin của toàn câu; vì vậy các mô hình embedding văn bản thường dựa trên encoder (Chương 4 của Biểu diễn & Căn chỉnh). Mô hình chỉ decoder học từ mọi vị trí của mọi chuỗi (Mục 9.4), dùng một mục tiêu duy nhất, và sinh văn bản một cách tự nhiên; khi mở rộng quy mô, kiểu kiến trúc này trở thành lựa chọn của gần như mọi mô hình ngôn ngữ lớn. Các chương tiếp theo tập trung vào kiểu chỉ decoder.
9.8Tóm tắt#
Attention là một phép tra cứu mềm: so truy vấn với mọi khoá, biến độ giống nhau thành trọng số bằng softmax, rồi lấy trung bình có trọng số của các giá trị. Điểm số phải chia cho , vì phương sai của tích vô hướng bằng ; thí nghiệm cho thấy không chia thì entropy của attention ở chỉ còn 0,118 nat và attention gần như chỉ chọn một khoá. Nhiều đầu cho phép chú ý tới nhiều loại quan hệ cùng lúc với cùng số tham số, mặt nạ nhân quả cho phép huấn luyện song song trên mọi vị trí, và mã hoá vị trí đưa thứ tự vào một phép toán vốn không có thứ tự. Một khối Transformer gồm attention và FFN, mỗi phần có kết nối tắt và chuẩn hoá, trong đó FFN chiếm hai phần ba tham số còn attention là phần duy nhất trộn thông tin giữa các vị trí. Kiểu chỉ decoder trở thành kiến trúc của các mô hình ngôn ngữ lớn.
Khung của khối Transformer gần như giữ nguyên tới nay, nhưng các thành phần bên trong đã được thay gần hết kể từ bài báo gốc: vị trí của lớp chuẩn hoá, cách mã hoá vị trí, cách chia sẻ khoá và giá trị giữa các đầu, hàm kích hoạt của FFN, và cả cách tính attention trên phần cứng. Chương 10 xét từng thay đổi đó.
Tự kiểm tra
6 câu. Chọn đáp án để xem ngay lời giải thích.
1Nếu các thành phần của độc lập, trung bình 0, phương sai 1, thì có phương sai bao nhiêu?
Vì sao: là tổng của số hạng độc lập, mỗi số hạng có phương sai 1. Ở Mục 9.2, với phương sai đo được là 1 022.2Không chia điểm số cho thì điều gì xảy ra khi lớn?
Vì sao: Trọng số lớn nhất trung bình đạt 0,953. Đạo hàm của softmax là , gần bằng 0 khi gần one-hot. Có chia thì entropy giữ quanh 3,68 với mọi .3Attention nhiều đầu mang lại điều gì?
Vì sao: Một đầu duy nhất phải lấy trung bình có trọng số, trộn lẫn các loại quan hệ khác nhau (Mục 9.3).4Thành phần nào trong một khối Transformer kết hợp thông tin giữa các vị trí?
Vì sao: FFN là cùng một MLP áp dụng riêng cho từng token. Bỏ attention đi, Transformer chỉ còn là một MLP áp dụng cho từng token (Mục 9.5).5Vì sao self-attention cần thông tin vị trí?
Vì sao: Không có thông tin vị trí thì "chó cắn người" và "người cắn chó" cho cùng một tập biểu diễn (Mục 9.6).6Mô hình chỉ decoder khác mô hình chỉ encoder ở điểm nào?
Vì sao: BERT là mô hình chỉ encoder, phù hợp cho phân loại và embedding; GPT và phần lớn mô hình ngôn ngữ lớn là mô hình chỉ decoder (Mục 9.7).
Đã trả lời 0/6