9Overfitting và regularization#
Chương 8 nhấn mạnh việc đo trên dữ liệu mà mô hình chưa thấy. Lý do của yêu cầu đó là hiện tượng quan trọng nhất của học máy: một mô hình có thể khớp dữ liệu huấn luyện rất tốt mà vẫn dự đoán dữ liệu mới rất tệ. Bốn căn hộ của Chương 4 đủ để thấy điều này. Đường thẳng ở Chương 4 có sai số huấn luyện 0,0045; một đa thức bậc ba đi qua đúng cả bốn căn nên có sai số huấn luyện bằng 0, nhưng lại đoán một căn 20 m² có giá 0 đồng. Ta gọi tên hiện tượng đó trước, rồi xét công cụ chính để kiểm soát nó là regularization. Hồi quy tuyến tính một lần nữa là nơi thấy cơ chế rõ nhất, vì ridge và lasso đều phân tích được chính xác, và trên bốn căn hộ chúng tính được bằng tay. Cuối cùng là câu hỏi chọn cường độ regularization, và câu trả lời là cross-validation.
9.1Overfitting và underfitting#
Định nghĩa 9.1 (Overfitting, underfitting)
Mô hình bị overfitting (quá khớp) khi nó khớp tốt dữ liệu huấn luyện nhưng dự đoán kém trên dữ liệu mới: sai số huấn luyện nhỏ, sai số trên tập xác thực lớn hơn nhiều. Mô hình bị underfitting (chưa khớp) khi nó quá đơn giản để nắm được quan hệ trong dữ liệu: cả sai số huấn luyện lẫn sai số xác thực đều lớn.
Ví dụ 9.1 (Đa thức bậc ba qua bốn căn hộ)
Dùng lại biến của Mục 5.2, bốn căn hộ có và giá 1,5; 2,1; 2,4; 3,0 tỉ. Đa thức bậc ba có bốn hệ số, đủ để đi qua đúng bốn điểm; giải hệ bốn phương trình được
Sai số huấn luyện bằng 0. Với căn 120 m², tức , đa thức dự đoán 4,5 tỉ, còn đường thẳng của Chương 4 dự đoán 3,45 tỉ. Với căn 20 m², tức , đa thức dự đoán đúng 0 đồng, và với căn 10 m² nó cho giá âm, tỉ.
Đa thức bậc ba khớp cả phần nhiễu trong bốn mức giá, và vì vậy nó rất nhạy với nhiễu. Tăng giá căn 80 m² thêm 0,1 tỉ, dự đoán của đường thẳng cho căn 120 m² chỉ đổi 0,05 tỉ, từ 3,45 lên 3,5, còn dự đoán của đa thức bậc ba đổi 0,6 tỉ, từ 4,5 xuống 3,9.
Ví dụ kinh điển cho thấy cùng hiện tượng với nhiều điểm hơn: khớp đa thức vào 10 điểm dữ liệu có nhiễu sinh từ một đường cong trơn. Đa thức bậc 1 là đường thẳng, không theo được độ cong, nên underfitting. Đa thức bậc 3 theo được hình dạng chung mà bỏ qua nhiễu. Đa thức bậc 9 có đủ 10 hệ số để đi qua chính xác mọi điểm, kể cả phần nhiễu, và dao động mạnh giữa các điểm: sai số huấn luyện bằng 0 nhưng dự đoán ở các điểm mới rất tệ.
Theo ngôn ngữ của Mục 3.6, overfitting là tình trạng phương sai cao: mô hình thay đổi nhiều khi tập huấn luyện thay đổi, như đa thức bậc ba ở trên, vì nó đủ linh hoạt để khớp cả nhiễu của từng tập. Underfitting là tình trạng độ chệch cao: dù có bao nhiêu dữ liệu, mô hình vẫn sai theo cùng một cách vì họ hàm của nó không chứa quan hệ thật. Chương 2 của Học sâu trình bày phân tích độ chệch – phương sai đầy đủ và đo từng thành phần trên dữ liệu.
Cách chẩn đoán thông dụng là so sánh sai số trên tập huấn luyện và tập xác thực, như bảng dưới.
| Sai số huấn luyện | Sai số xác thực | Chẩn đoán | Hướng xử lý |
|---|---|---|---|
| lớn | lớn, gần sai số huấn luyện | underfitting | mô hình linh hoạt hơn, thêm đặc trưng, giảm regularization |
| nhỏ | lớn hơn nhiều | overfitting | thêm dữ liệu, mô hình đơn giản hơn, tăng regularization |
| nhỏ | nhỏ, gần sai số huấn luyện | phù hợp |
Regularization là cách xử lý overfitting mà không cần đổi họ mô hình: giữ nguyên mô hình, nhưng thêm vào hàm mất mát một thành phần phạt các tham số lớn, để mô hình ưu tiên các nghiệm "đơn giản" hơn.
9.2Hồi quy ridge#
Định nghĩa 9.2 (Hồi quy ridge)
Hồi quy ridge thêm thành phần phạt bình phương chuẩn của trọng số vào bình phương tối thiểu:
Cho gradient bằng 0 được nghiệm
Gradient của thành phần phạt là (Mục 2.7), nên phương trình chuẩn chỉ thay đổi một chỗ: được cộng thêm . Thay đổi nhỏ này có ba tác dụng. Trước hết, ridge luôn có nghiệm duy nhất: theo Mục 2.5, xác định dương với mọi , kể cả khi không đủ hạng cột, nên ridge giải được cả những bài toán mà bình phương tối thiểu thông thường không có nghiệm duy nhất, như hoặc đặc trưng trùng lặp (Mục 4.3). Tiếp theo, số điều kiện được cải thiện: trị riêng của là , nên số điều kiện giảm từ xuống , và gradient descent trên hàm mất mát ridge hội tụ nhanh hơn (Mục 5.3). Cuối cùng, ridge co các hệ số về phía 0, qua đó giảm phương sai của ước lượng; Mục 9.3 chỉ ra việc co này diễn ra không đều giữa các hướng.
Khi , nghiệm ridge tiến tới nghiệm có chuẩn nhỏ nhất của bình phương tối thiểu, tức nghiệm của giả nghịch đảo ở Mục 4.3. Khi , mọi hệ số tiến về 0.
Bốn căn hộ cho thấy sự co này bằng số. Với biến , ta có và . Không phạt hệ số chặn, phương trình chuẩn của ridge cho độ dốc theo là
Với ta được lại độ dốc 0,24 của Chương 5; với , độ dốc giảm một nửa còn 0,12; độ dốc chỉ tiến về 0 khi . Hệ số chặn vẫn là giá trung bình 2,25 tỉ, vì có trung bình bằng 0.
Lưu ý
Thành phần phạt phụ thuộc vào thang đo của các đặc trưng: một đặc trưng đo bằng milimét có hệ số nhỏ hơn 1 000 lần so với khi đo bằng mét, nên bị phạt ít hơn hẳn. Vì vậy cần chuẩn hoá đặc trưng trước khi dùng ridge hoặc lasso. Ngoài ra, hệ số chặn thường không bị phạt, vì dịch toàn bộ đi một hằng số không nên làm thay đổi mô hình.
9.3Hồi quy ridge nhìn qua SVD#
Để thấy ridge co các hệ số như thế nào, ta viết dưới dạng SVD, (Mục 2.6), với , là các cột của , và là các giá trị suy biến. Thay vào công thức nghiệm và rút gọn, ta được
So sánh từng số hạng, ridge nhân thành phần theo hướng của nghiệm bình phương tối thiểu với hệ số co
Với bốn căn hộ, khi hệ số chặn không bị phạt và có trung bình 0, phần bị phạt chỉ gồm một cột , nên chỉ có một giá trị suy biến, . Hệ số co là , đúng tỉ lệ giữa độ dốc ridge ở Mục 9.2 và độ dốc 0,24 của bình phương tối thiểu. Với nhiều đặc trưng, mỗi hướng có một hệ số co riêng.
Thí nghiệm dùng 80 điểm dữ liệu với 12 đặc trưng và ; nghiệm tính qua SVD khớp với nghiệm dạng đóng tới . Bảng liệt kê năm trong mười hai giá trị suy biến, gồm hai lớn nhất, một ở giữa và hai nhỏ nhất, cùng hệ số co tương ứng.
| Giá trị suy biến | Hệ số co |
|---|---|
| 12,2680 | 0,9377 |
| 12,0678 | 0,9357 |
| 8,3651 | 0,8750 |
| 6,4450 | 0,8060 |
| 6,1730 | 0,7921 |
Hướng có giá trị suy biến lớn gần như giữ nguyên; hướng có giá trị suy biến nhỏ bị co mạnh hơn. Giá trị suy biến nhỏ nghĩa là dữ liệu trải rất ít theo hướng đó, nên dữ liệu cung cấp ít thông tin về thành phần của theo hướng đó, và ước lượng bình phương tối thiểu có phương sai lớn, vì chia cho số nhỏ khuếch đại nhiễu. Ridge co mạnh nhất đúng những hướng ước lượng kém tin cậy nhất. Đây cũng là mối liên hệ với Mục 4.4: đa cộng tuyến tạo ra giá trị suy biến rất nhỏ, và ridge là một cách xử lý đa cộng tuyến.
Tổng các hệ số co, , gọi là số bậc tự do hiệu dụng của mô hình ridge. Nó bằng số đặc trưng khi và giảm dần về 0 khi tăng, cho một cách đo độ phức tạp của mô hình liên tục theo (Hastie, Tibshirani và Friedman, 2009).
9.4Lasso#
Định nghĩa 9.3 (Lasso)
Lasso (Tibshirani, 1996) dùng chuẩn trong thành phần phạt:
Hệ số trước bình phương sai số là quy ước thường dùng cho lasso, và cũng là quy ước của thư viện scikit-learn sau khi nhân hàm mục tiêu của thư viện với ; nó chỉ làm thay đổi thang đo của . Khác với ridge, lasso không có nghiệm dạng đóng tổng quát và được giải bằng các thuật toán lặp như coordinate descent.
Đổi thành nghe như một thay đổi nhỏ, nhưng hành vi của nghiệm khác hẳn, như Hình 7 cho thấy.
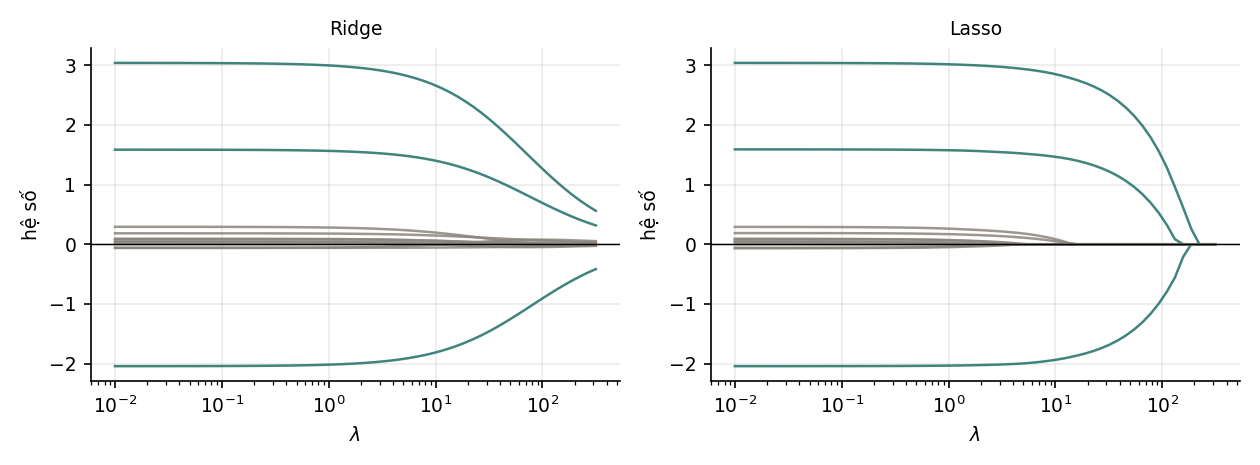
Thí nghiệm dùng dữ liệu 80 điểm, 12 đặc trưng, trong đó mô hình sinh dữ liệu chỉ có 3 hệ số khác 0 và 9 hệ số bằng 0.
| của ridge | Số hệ số bằng 0, ridge | Số hệ số bằng 0, lasso | |
|---|---|---|---|
| 0,01 | 4,0106 | 0 | 0 |
| 0,10 | 4,0056 | 0 | 1 |
| 1,00 | 3,9559 | 0 | 1 |
| 10,00 | 3,5234 | 0 | 7 |
| 100,00 | 1,7090 | 0 | 9 |
Ở , lasso đưa đúng 9 hệ số về 0, trùng với 9 hệ số bằng 0 của mô hình thật. Ridge không đưa hệ số nào về 0 ở bất kỳ giá trị nào, dù chuẩn của vector trọng số giảm dần.
Có hai cách giải thích vì sao lasso cho nghiệm thưa, tức nhiều hệ số bằng đúng 0. Cách thứ nhất là giải tích. Xét trường hợp đơn giản các cột của trực chuẩn, , và gọi là nghiệm bình phương tối thiểu của hệ số thứ . Bài toán tách thành từng toạ độ, và nghiệm là
Ridge nhân mọi hệ số với cùng một số nhỏ hơn 1, nên hệ số nào khác 0 vẫn khác 0. Lasso trừ mỗi hệ số đi một lượng và cắt về 0 những hệ số có trị tuyệt đối nhỏ hơn ; phép toán này gọi là ngưỡng mềm (soft thresholding). Nguồn gốc của khác biệt nằm ở đạo hàm. Đạo hàm của là , tiến về 0 khi tiến về 0, nên lực kéo về 0 yếu dần và không bao giờ kéo được tới đúng 0. Còn không khả vi tại 0, và dưới vi phân của nó tại 0 là cả đoạn ; muốn một hệ số rời khỏi 0, gradient của phần bình phương sai số phải lớn hơn , nếu không thì hệ số nằm yên ở 0.
Bốn căn hộ cho thấy hai công thức này bằng số. Cột có chứ không bằng 1, và . Cùng lập luận cho độ dốc ridge như ở Mục 9.2, và độ dốc lasso
Ngưỡng 4,8 chính là độ lớn gradient của phần bình phương sai số tại độ dốc bằng 0. Với , lasso cho độ dốc 0,12, bằng độ dốc ridge ở . Với mọi , lasso cho độ dốc đúng bằng 0: mô hình bỏ hẳn diện tích và đoán mọi căn hộ có giá 2,25 tỉ. Ridge không có giá trị hữu hạn nào cho độ dốc bằng 0.
Cách thứ hai là hình học. Bài toán có phạt tương đương với cực tiểu bình phương sai số trong một quả cầu chuẩn có bán kính phụ thuộc . Các đường mức của bình phương sai số là những elip quanh nghiệm bình phương tối thiểu, và nghiệm có ràng buộc là điểm đầu tiên elip chạm vào quả cầu. Quả cầu tròn nên điểm chạm thường nằm ở vị trí bất kỳ. Quả cầu là hình thoi có các đỉnh nhọn nằm trên trục toạ độ (Mục 2.3), nên elip hay chạm vào đúng các đỉnh, nơi một số toạ độ bằng 0.
Từ đó có thể chọn giữa hai phương pháp. Khi cần chọn đặc trưng, hoặc khi tin rằng chỉ một số ít đặc trưng thật sự có ảnh hưởng, nên dùng lasso. Khi nhiều đặc trưng đều có ảnh hưởng nhỏ, hoặc có các nhóm đặc trưng tương quan cao, nên dùng ridge. Với một nhóm đặc trưng tương quan cao, lasso có xu hướng chọn một đặc trưng đại diện và đưa các đặc trưng còn lại về 0, và đặc trưng được chọn phụ thuộc vào nhiễu. Elastic net (Zou và Hastie, 2005) kết hợp cả hai thành phần phạt, , để vừa cho nghiệm thưa vừa giữ ổn định với các nhóm đặc trưng tương quan.
9.5Cross-validation#
Cường độ regularization không thể học từ tập huấn luyện: tăng luôn làm sai số huấn luyện tăng, nên cực tiểu sai số huấn luyện luôn chọn . Ta cần ước lượng sai số trên dữ liệu mới cho từng giá trị rồi chọn giá trị tốt nhất. Nếu dữ liệu nhiều, một tập xác thực riêng là đủ. Nếu dữ liệu ít, giữ riêng một phần lớn cho xác thực làm lãng phí dữ liệu huấn luyện, và kết quả phụ thuộc nhiều vào cách chia. Cross-validation giải quyết vấn đề này.
Định nghĩa 9.4 (k-fold cross-validation)
Chia dữ liệu thành phần có kích thước gần bằng nhau. Lần lượt với : huấn luyện mô hình trên phần, đo sai số trên phần thứ . Ước lượng cross-validation là trung bình của sai số đó.
Mỗi điểm dữ liệu được dùng để đánh giá đúng một lần và để huấn luyện lần. Để chọn , ta tính ước lượng cross-validation cho mỗi giá trị trong một lưới, chẳng hạn , chọn giá trị cho sai số nhỏ nhất, rồi huấn luyện lại trên toàn bộ dữ liệu với giá trị đó. Cùng cách làm chọn được cả bậc của đa thức.
Ví dụ 9.2 (Leave-one-out trên bốn căn hộ)
Lấy : mỗi lần bỏ ra một căn, khớp mô hình trên ba căn còn lại rồi dự đoán căn bị bỏ ra. Ta so sánh đường thẳng với đa thức bậc hai. Trên cả bốn căn, hai mô hình có cùng sai số huấn luyện 0,0045, vì hệ số bậc hai khớp được bằng 0.
Căn bị bỏ ra Giá thật Đường thẳng dự đoán Đa thức bậc hai dự đoán 40 m² 1,5 1,600 2,100 60 m² 2,1 1,971 1,900 80 m² 2,4 2,529 2,600 100 m² 3,0 2,900 2,400 Trung bình bình phương sai số 0,0133 0,2000 Với ba điểm, đa thức bậc hai đi qua đúng cả ba và cong mạnh ở hai đầu, nên đoán sai 0,6 tỉ cho căn nhỏ nhất và căn lớn nhất.
Sai số huấn luyện không phân biệt được hai mô hình, còn cross-validation cho thấy đường thẳng tốt hơn khoảng 15 lần. Trường hợp như trên gọi là leave-one-out; bảng dưới liệt kê nó cùng các biến thể thường dùng khác.
| Biến thể | Dùng khi |
|---|---|
| k-fold với hoặc 10 | lựa chọn mặc định |
| Stratified k-fold | phân loại, nhất là khi lớp mất cân bằng: giữ tỉ lệ các lớp trong mỗi phần |
| Leave-one-out () | dữ liệu rất ít; tốn lần huấn luyện và ước lượng có phương sai cao |
| Chia theo thời gian | chuỗi thời gian: luôn huấn luyện trên quá khứ, đánh giá trên tương lai |
| Chia theo nhóm | dữ liệu có nhóm tự nhiên như bệnh nhân hay người dùng (Mục 8.5) |
Khi nhiều giá trị cho sai số cross-validation gần như nhau, một quy tắc thường dùng là quy tắc một độ lệch chuẩn: chọn mô hình đơn giản nhất, tức regularization mạnh nhất, có sai số không vượt quá sai số nhỏ nhất cộng một độ lệch chuẩn của ước lượng.
Lưu ý
Không dùng cùng một vòng cross-validation vừa để chọn siêu tham số vừa để báo cáo hiệu năng cuối cùng. Vì cấu hình được chọn là cấu hình tốt nhất trên chính các phần dữ liệu đó, sai số báo cáo sẽ lạc quan một cách có hệ thống, và càng thử nhiều cấu hình thì càng lạc quan. Cách đúng là dùng cross-validation lồng nhau (vòng trong chọn siêu tham số, vòng ngoài đánh giá), hoặc giữ riêng một tập kiểm tra chỉ dùng một lần ở bước cuối cùng.
9.6Tóm tắt#
Overfitting là khi mô hình khớp cả nhiễu của dữ liệu huấn luyện, tức phương sai cao: đa thức bậc ba đi qua đúng bốn căn hộ nhưng đoán căn 20 m² có giá 0 đồng, và chỉ 0,1 tỉ nhiễu ở một căn làm dự đoán của nó đổi 0,6 tỉ. Underfitting là khi họ hàm quá hẹp, tức độ chệch cao; so sánh sai số huấn luyện với sai số xác thực cho biết đang ở tình huống nào. Ridge cộng vào , nên luôn có nghiệm duy nhất, cải thiện số điều kiện, và nhân thành phần theo mỗi hướng với , co mạnh nhất những hướng có giá trị suy biến nhỏ, nơi ước lượng kém tin cậy nhất. Lasso dùng chuẩn nên cho nghiệm thưa: với bốn căn hộ, độ dốc lasso bằng đúng 0 khi , còn độ dốc ridge không bao giờ bằng 0; trong thí nghiệm 12 đặc trưng, lasso đưa đúng 9 hệ số về 0 như mô hình thật. Cường độ regularization, cũng như bậc của mô hình, được chọn bằng cross-validation, và hiệu năng cuối cùng phải được báo cáo trên dữ liệu không tham gia vào việc chọn.
Ridge thêm , lasso thêm , Naive Bayes cộng vào mọi ô đếm. Tới đây, các thành phần phạt này trông như những mẹo có tác dụng. Chương 10 cho thấy chúng, cùng với bình phương sai số và cross-entropy, đều suy ra được từ hai nguyên lý thống kê.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Dấu hiệu nào cho thấy mô hình bị overfitting?
Vì sao: Sai số huấn luyện và xác thực cùng lớn là dấu hiệu underfitting. Overfitting tương ứng với phương sai cao: mô hình khớp cả nhiễu của tập huấn luyện.2Hồi quy ridge co các hướng riêng như thế nào?
Vì sao: Ở Mục 9.3 với , hướng có giữ lại 0,938, hướng có giữ lại 0,792. Hướng có giá trị suy biến nhỏ là hướng ước lượng kém tin cậy nhất, nên ridge xử lý được đa cộng tuyến.3Khi các cột của trực chuẩn, lasso làm gì với nghiệm bình phương tối thiểu ?
Vì sao: Nghiệm là với quy ước . Ridge thì nhân với nên không bao giờ cho hệ số bằng 0.4Lỗi nghiêm trọng nhất khi dùng cross-validation là gì?
Vì sao: Cấu hình được chọn là cấu hình tốt nhất trên chính các phần dữ liệu đó, nên con số báo cáo lạc quan một cách có hệ thống. Cách đúng là cross-validation lồng nhau, hoặc giữ riêng một tập kiểm tra chỉ dùng một lần.
Đã trả lời 0/4