11Mô hình khuếch tán#
Mô hình khuếch tán phá dần dữ liệu bằng nhiễu cho tới khi chỉ còn nhiễu, rồi học cách đảo ngược từng bước. Mỗi bước đảo ngược là một bài khử nhiễu nhỏ, và như ta sẽ thấy, huấn luyện cả mô hình quy về một bài hồi quy thông thường: không có trò chơi giữa hai mạng như GAN, và mất mát giảm nghĩa là mô hình tốt lên.
11.1Sinh mẫu bằng nhiều bước khử nhiễu#
Sinh một ảnh từ nhiễu trong một bước là bài toán rất khó. Nhưng khử một chút nhiễu khỏi một ảnh đã hơi nhiễu là bài toán khử nhiễu quen thuộc, tức một bài hồi quy. Mô hình khuếch tán (Sohl-Dickstein và cộng sự, 2015; Ho, Jain và Abbeel, 2020) ghép nhiều bước khử nhiễu nhỏ, thường 1 000 bước, thành một quá trình sinh. Cách tư duy này dùng được ở nhiều nơi: khi một phép biến đổi quá khó để học trực tiếp, tìm cách viết nó thành một chuỗi nhiều phép biến đổi dễ.
11.2Quá trình thuận và dạng đóng#
Quá trình thuận thêm nhiễu Gauss từng chút một:
với nhỏ, tăng dần theo một lịch định trước. Hệ số thu nhỏ tín hiệu một chút ở mỗi bước, vừa đủ để nếu có phương sai 1 thì cũng có phương sai 1.
Mệnh đề 11.1 (Dạng đóng của quá trình thuận)
Đặt và . Khi đó
tức với .
Chứng minh
Quy nạp theo . Với mệnh đề là định nghĩa. Giả sử . Khi đó . Tổng của hai biến Gauss độc lập có trung bình 0 là biến Gauss có phương sai bằng tổng các phương sai: .
Dạng đóng là điều làm cho huấn luyện khả thi: muốn có với bất kỳ, lấy trực tiếp từ trong một bước, không phải mô phỏng bước trung gian.
Dạng đóng kiểm chứng được bằng mô phỏng. Thí nghiệm dùng lịch tuyến tính từ tới qua 1 000 bước, giá trị ban đầu , mô phỏng 200 000 quỹ đạo đi từng bước rồi so trung bình và phương sai với dạng đóng. Chỉ số bước đánh từ 0 như trong mã, tức là sau bước nhiễu đầu tiên.
| Trung bình, mô phỏng | Trung bình, dạng đóng | Phương sai, mô phỏng | Phương sai, dạng đóng | |
|---|---|---|---|---|
| 1 | 1,99984 | 1,99978 | 0,00022 | 0,00022 |
| 10 | 1,99763 | 1,99781 | 0,00219 | 0,00219 |
| 100 | 1,89199 | 1,89224 | 0,10485 | 0,10486 |
| 400 | 0,88021 | 0,87994 | 0,80511 | 0,80643 |
| 999 | 0,00936 | 0,01271 | 1,00484 | 0,99996 |
Hai cách tính khớp nhau trong phạm vi sai số lấy mẫu của 200 000 quỹ đạo.
11.3Lịch nhiễu và tỉ số tín hiệu trên nhiễu#
cho biết phần tín hiệu còn lại sau bước. Đại lượng thường dùng hơn là tỉ số tín hiệu trên nhiễu
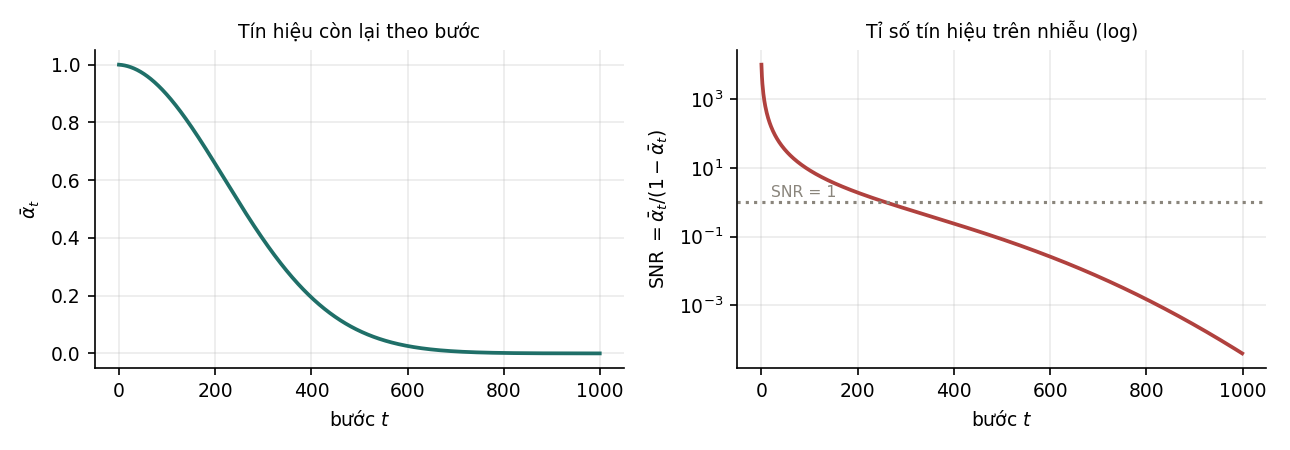
| SNR | Biên độ tín hiệu còn lại | ||
|---|---|---|---|
| 0 | 0,999900 | 9 999 | 99,99% |
| 50 | 0,969951 | 32,28 | 98,49% |
| 200 | 0,656347 | 1,91 | 81,02% |
| 500 | 0,077797 | 0,0844 | 27,89% |
| 800 | 0,001508 | 0,0015 | 3,88% |
| 999 | 0,64% |
Ở bước cuối chỉ còn 0,64% biên độ tín hiệu, tức gần như là nhiễu Gauss thuần tuý. Điều này cần thiết vì khi sinh mẫu, quá trình bắt đầu từ , và điểm xuất phát đó phải khớp với điểm kết thúc của quá trình thuận.
SNR cũng cho biết mô hình học gì ở mỗi bước. Ở nhỏ, SNR rất cao, ảnh gần như nguyên vẹn, và việc khử nhiễu liên quan tới các chi tiết nhỏ. Ở lớn, SNR rất thấp, gần như chỉ còn nhiễu, và việc khử nhiễu liên quan tới bố cục và màu sắc tổng thể. Khi sinh mẫu đi ngược từ về , mô hình vì vậy quyết định bố cục trước rồi mới thêm chi tiết. Nichol và Dhariwal (2021) chỉ ra lịch tuyến tính làm SNR giảm quá nhanh ở cuối, khiến nhiều bước cuối gần như lãng phí, và đề xuất lịch cosine.
11.4Huấn luyện bằng hồi quy#
Từ dạng đóng, . Mô hình khuếch tán huấn luyện một mạng để dự đoán lại nhiễu từ và :
Đây là bình phương sai số, một bài hồi quy thông thường như ở Chương 4 của Nền tảng. Không có trò chơi giữa hai mạng, không có điểm yên ngựa; mất mát giảm nghĩa là mô hình tốt lên. Thủ tục huấn luyện gồm bốn bước:
- Lấy một mẫu thật .
- Chọn ngẫu nhiên một bước .
- Lấy và tính bằng dạng đóng.
- Tính bình phương sai số giữa và , cập nhật tham số.
Hàm mất mát này là dạng đơn giản hoá của một chặn dưới biến phân cho log hợp lý, tương tự ELBO của VAE; Ho, Jain và Abbeel (2020) thấy bỏ các trọng số theo của chặn dưới cho chất lượng mẫu tốt hơn. Vì biết thì suy ra được từ dạng đóng, dự đoán và dự đoán tương đương về mặt toán học; dự đoán là một lựa chọn thực nghiệm. Chẳng hạn với ở bước 200 của lịch tuyến tính, và . Nếu nhiễu rút ra là thì , và đó là đầu vào của mạng, còn đáp án mạng phải đoán là 0,5. Biết đáp án đó thì . Khi sinh mẫu, mỗi bước dùng để ước lượng giá trị trung bình của , rồi cộng thêm một lượng nhiễu nhỏ.
11.5Tăng tốc lấy mẫu#
Nhược điểm chính của mô hình khuếch tán là lấy mẫu chậm: sinh một mẫu cần chạy mạng lần, và với là chậm hơn GAN khoảng một nghìn lần. Bảng dưới tóm tắt các cách khắc phục chính.
| Cách | Ý tưởng | Kết quả điển hình |
|---|---|---|
| DDIM (Song, Meng và Ermon, 2021) | quá trình ngược tất định, cho phép nhảy cách nhiều bước | từ 1 000 xuống vài chục bước |
| Lịch nhiễu tốt hơn | phân bố các bước theo SNR thay vì đều theo | ít bước hơn với cùng chất lượng |
| Chưng cất (Salimans và Ho, 2022) | huấn luyện một mô hình học gộp nhiều bước thành một | còn khoảng 4 tới 8 bước |
| Khuếch tán trong không gian ẩn (Rombach và cộng sự, 2022) | nén ảnh bằng một bộ tự mã hoá rồi chạy khuếch tán trong không gian ẩn nhỏ hơn | mỗi bước rẻ hơn nhiều |
Dòng cuối là cơ sở của nhiều mô hình sinh ảnh chạy được trên máy cá nhân, và là một ví dụ kết hợp hai họ mô hình: bộ tự mã hoá lo việc nén ảnh xuống không gian ẩn nhỏ, mô hình khuếch tán lo việc sinh trong không gian đó.
11.6Sinh có điều kiện#
Các ứng dụng như sinh ảnh từ mô tả văn bản cần mô hình với là điều kiện. Mạng nhận thêm , thường là embedding của câu mô tả do một bộ mã hoá văn bản tạo ra, đưa vào qua cross-attention (Mục 9.1 của Học sâu).
Kỹ thuật classifier-free guidance (Ho và Salimans, 2022) làm cho mẫu bám điều kiện chặt hơn: huấn luyện cùng một mạng với cả và với điều kiện rỗng (bỏ ngẫu nhiên khoảng 10% số lần), rồi khi sinh dùng
với đẩy mẫu theo hướng mà điều kiện tạo ra. Chẳng hạn nếu ở một toạ độ, dự đoán không điều kiện là 0,2 và dự đoán có điều kiện là 0,5, thì với ta dùng : không dừng ở dự đoán có điều kiện mà đi xa hơn theo cùng hướng. lớn cho mẫu khớp mô tả hơn nhưng kém đa dạng hơn. Chương 14 của Ứng dụng LLM bàn về việc dùng các mô hình sinh ảnh trong ứng dụng.
11.7Tóm tắt#
Quá trình thuận thêm nhiễu Gauss từng chút một, và nhờ dạng đóng , ta lấy được ở bước bất kỳ trong một phép tính; mô phỏng 200 000 quỹ đạo khớp với dạng đóng trong phạm vi sai số lấy mẫu. Với lịch tuyến tính, ở bước cuối chỉ còn 0,64% biên độ tín hiệu, nên quá trình sinh xuất phát được từ nhiễu Gauss thuần tuý. SNR giảm dần theo bước, nên khi sinh, mô hình quyết định bố cục trước rồi mới thêm chi tiết. Huấn luyện là hồi quy dự đoán nhiễu, ổn định như mọi bài hồi quy. Lấy mẫu chậm được khắc phục bằng DDIM, chưng cất và khuếch tán trong không gian ẩn, còn classifier-free guidance làm mẫu bám điều kiện chặt hơn.
Với ba họ mô hình sinh, ta đã biết cách tạo ra nội dung mới. Nhưng một mô hình ngôn ngữ sinh văn bản trôi chảy chưa chắc làm đúng điều người dùng muốn, như ví dụ câu hỏi về thủ đô của Pháp ở Chương 1. Phần cuối giáo trình bàn về việc điều chỉnh hành vi đó, và công cụ đầu tiên cần có là học tăng cường, cách học từ phần thưởng thay vì từ đáp án đúng (Chương 12).
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Dạng đóng của quá trình thuận cho biết gì, và vì sao nó quan trọng?
Vì sao: Không có dạng đóng thì mỗi mẫu huấn luyện phải mô phỏng bước. Ở Mục 11.2, dạng đóng khớp với mô phỏng 200 000 quỹ đạo.2Ở các bước lớn (SNR rất thấp), việc khử nhiễu liên quan tới điều gì?
Vì sao: Ở lớn gần như chỉ còn nhiễu, nên việc khử nhiễu quyết định các thành phần biên độ lớn. Khi sinh mẫu đi từ về 0, mô hình quyết định bố cục trước rồi mới thêm chi tiết.3Huấn luyện mô hình khuếch tán thực chất là bài toán gì?
Vì sao: Mất mát giảm nghĩa là mô hình tốt lên, không có điểm yên ngựa hay hai mạng cạnh tranh. Nhờ vậy mô hình khuếch tán dễ huấn luyện hơn GAN nhiều.4Vì sao mô hình khuếch tán thường dự đoán nhiễu thay vì dự đoán ?
Vì sao: Biết thì suy ra được từ dạng đóng và ngược lại. Ho, Jain và Abbeel (2020) thấy dạng đơn giản hoá với dự đoán nhiễu cho kết quả tốt nhất.
Đã trả lời 0/4