11Các chiến lược giải mã#
Sau mỗi lượt xuôi, mô hình ngôn ngữ cho ra một phân phối xác suất trên toàn bộ từ vựng cho token tiếp theo. Để có văn bản, cần một quy tắc chọn token từ phân phối đó, gọi là chiến lược giải mã. Quy tắc này nằm hoàn toàn ngoài mô hình, nhưng ảnh hưởng của nó lớn hơn nhiều người nghĩ: cùng một mô hình với hai chiến lược khác nhau cho ra hai hệ thống có hành vi rất khác nhau, một bên lặp lại nhạt nhẽo, một bên lan man khó kiểm soát.
11.1Bài toán giải mã#
Tại mỗi bước, mô hình cho vector logit trên toàn bộ từ vựng, và phân phối của token tiếp theo là . Giải mã (decoding) là quy tắc chọn một token từ , nối vào chuỗi, rồi lặp lại cho tới khi gặp token kết thúc hoặc đạt độ dài tối đa.
Để so sánh các chiến lược, ta dùng hai đại lượng mô tả một phân phối. Đại lượng thứ nhất là entropy , tính bằng nat, đo mức không chắc chắn. Giá trị gọi là perplexity của phân phối, và có thể hiểu là số lựa chọn hiệu dụng: phân phối đều trên token có . Đại lượng thứ hai là số token phủ 90% xác suất, tức số token ít nhất, lấy theo thứ tự xác suất giảm dần, có tổng xác suất đạt 0,9.
11.2Các chiến lược#
Bảng dưới tóm tắt các chiến lược giải mã phổ biến và trường hợp dùng của mỗi chiến lược.
| Chiến lược | Quy tắc | Phù hợp với |
|---|---|---|
| Greedy | luôn chọn token có xác suất cao nhất | bài toán có một đáp án đúng: trích xuất, phân loại, trả lời ngắn |
| Beam search | giữ chuỗi có xác suất cao nhất ở mỗi bước, mở rộng song song | dịch máy, nhận dạng tiếng nói |
| Lấy mẫu với nhiệt độ | lấy mẫu từ | văn bản mở, hội thoại |
| Top- (Fan, Lewis và Dauphin, 2018) | chỉ giữ token có xác suất cao nhất, chuẩn hoá lại rồi lấy mẫu | cắt đuôi phân phối với ngưỡng cố định |
| Top-, hay nucleus (Holtzman và cộng sự, 2020) | giữ tập nhỏ nhất các token có tổng xác suất ít nhất , chuẩn hoá lại rồi lấy mẫu | cắt đuôi với ngưỡng thích ứng theo phân phối |
Nhiệt độ làm phân phối nhọn hơn, làm phân phối phẳng hơn; cho greedy, giữ nguyên phân phối của mô hình. Các biến thể mới hơn tiếp tục điều chỉnh cách cắt đuôi, chẳng hạn min- (Nguyen và cộng sự, 2025) chỉ giữ các token có xác suất ít nhất một tỉ lệ cố định của xác suất lớn nhất.
Một từ vựng chỉ có bốn token đủ để thấy mỗi chiến lược làm gì. Với logit , softmax cho phân phối ở dòng đầu của bảng dưới, có entropy 0,948 nat, tức khoảng 2,6 lựa chọn hiệu dụng.
| Chiến lược | Token 1 | Token 2 | Token 3 | Token 4 | Entropy (nat) |
|---|---|---|---|---|---|
| Phân phối gốc, | 0,644 | 0,237 | 0,087 | 0,032 | 0,948 |
| 0,865 | 0,117 | 0,016 | 0,002 | 0,455 | |
| 0,455 | 0,276 | 0,167 | 0,102 | 1,245 | |
| Top-, | 0,731 | 0,269 | 0 | 0 | 0,582 |
| Top-, | 0,665 | 0,245 | 0,090 | 0 | 0,832 |
Greedy luôn chọn token 1. Nhiệt độ chia mọi logit cho nên đổi xác suất của cả bốn token: dồn 86,5% vào token 1, làm phân phối phẳng hơn, nhưng không token nào bị loại hẳn. Top- với bỏ hai token cuối rồi chuẩn hoá lại. Top- với cộng dồn xác suất theo thứ tự giảm dần, 0,644 rồi 0,881 rồi 0,968, nên giữ ba token đầu, tập nhỏ nhất có tổng đạt 0,9.
11.3Ảnh hưởng của các chiến lược tới phân phối#
Để thấy các chiến lược khác nhau ra sao, thí nghiệm trong code/models/experiments.py dựng một phân phối trên 50 000 token có đuôi dài, với logit lấy từ phân phối chuẩn có độ lệch chuẩn 2,2, rồi đo entropy, số token phủ 90% xác suất và xác suất của token đứng đầu sau mỗi phép biến đổi.
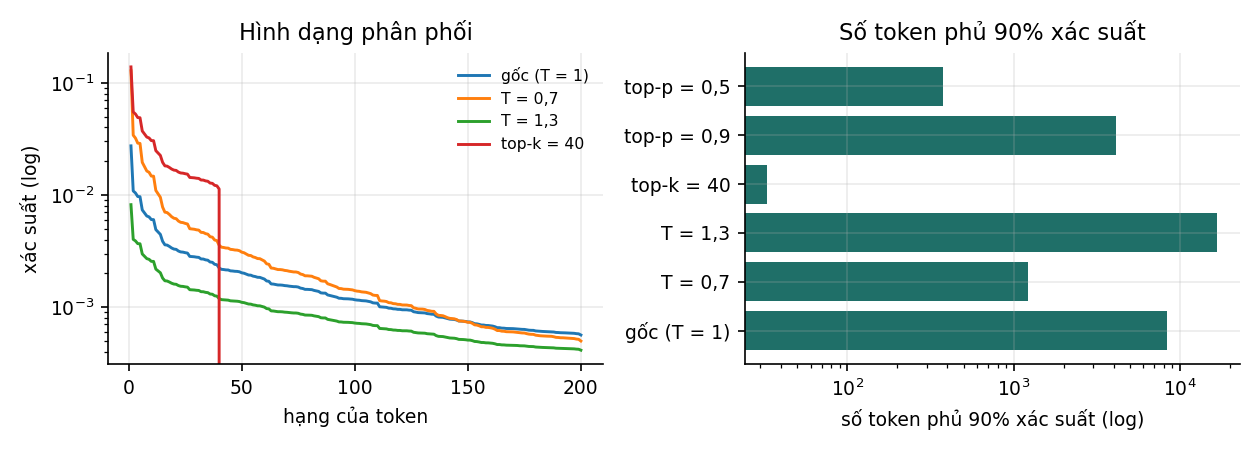
| Chiến lược | Entropy (nat) | Số lựa chọn hiệu dụng | Số token phủ 90% | Xác suất token đầu |
|---|---|---|---|---|
| Phân phối gốc, | 8,223 | 3 726 | 8 362 | 0,027 |
| 5,886 | 360 | 1 215 | 0,128 | |
| 9,305 | 10 993 | 16 766 | 0,008 | |
| Top-, | 3,449 | 31 | 33 | 0,139 |
| Top-, | 7,669 | 2 141 | 4 141 | 0,030 |
| Top-, | 5,673 | 291 | 376 | 0,055 |
Dòng đầu cho thấy phân phối gốc có đuôi rất dài: cần 8 362 token để phủ 90% xác suất. Lấy mẫu trực tiếp từ phân phối này nghĩa là ở mỗi bước có một xác suất đáng kể chọn phải một token rất ít khả năng, và một token sai có thể kéo lệch cả phần văn bản sau đó.
So các dòng còn lại, ta thấy hai cơ chế khác nhau. Nhiệt độ co giãn cả phân phối, còn top- và top- cắt bỏ phần đuôi. Với , vẫn còn 1 215 token trong vùng 90%, trong khi top- với chỉ còn 33. Vì hai cơ chế khác nhau, chúng thường được dùng cùng nhau: cắt đuôi bằng top-, rồi điều chỉnh độ tập trung bằng nhiệt độ.
Giữa hai cách cắt đuôi, top- thích ứng theo phân phối, còn top- thì không. Khi mô hình rất chắc chắn, gần như toàn bộ xác suất nằm ở một vài token, nhưng top- với vẫn giữ 40 lựa chọn; khi mô hình không chắc chắn, hàng trăm token đều hợp lý, nhưng top- cắt bớt còn 40. Top- giữ ít token ở trường hợp đầu và nhiều token ở trường hợp sau.
Số lựa chọn hiệu dụng còn được dùng để đo độ đa dạng của mẫu sinh ra, chẳng hạn số chế độ dữ liệu mà một mạng đối sinh phủ được (Chương 10 của Biểu diễn & Căn chỉnh).
11.4Beam search và văn bản mở#
Greedy chọn token tốt nhất ở từng bước, nhưng chuỗi gồm các lựa chọn tốt nhất từng bước chưa chắc là chuỗi có xác suất cao nhất; đây là cùng kiểu hạn chế của thuật toán tham lam khi xây cây ở Mục 3.2. Tìm chính xác chuỗi có xác suất cao nhất thì không khả thi: với từ vựng 50 000 token, riêng số chuỗi dài 10 token đã là . Beam search nằm giữa hai cực đó. Nó giữ ứng viên ở mỗi bước, mở rộng mỗi ứng viên bằng mọi token, rồi chỉ giữ lại chuỗi có xác suất cao nhất.
Andrew Ng và d2l.ai đều giải thích beam search bằng một ví dụ tính tay; một ví dụ cùng kiểu với số riêng như sau. Sau câu mở đầu "Trời hôm nay", giả sử mô hình cho token tiếp theo là "đẹp" với xác suất 0,6, "mưa" với 0,3 và "lạnh" với 0,1. Sau "đẹp", token tiếp theo là "quá" với xác suất 0,4, "lắm" với 0,35 và "và" với 0,25; sau "mưa", là "to" với 0,9 và "nhỏ" với 0,1. Greedy chọn "đẹp" rồi "quá", được chuỗi có xác suất . Beam search với giữ cả "đẹp" và "mưa" sau bước đầu. Ở bước hai, nó so năm chuỗi "đẹp quá" 0,24, "đẹp lắm" 0,21, "đẹp và" 0,15, "mưa to" và "mưa nhỏ" 0,03, rồi giữ "mưa to" và "đẹp quá". Chuỗi "mưa to" có xác suất cao hơn chuỗi của greedy, dù token đầu của nó chỉ đứng thứ hai. Beam search vẫn là một phép tìm kiếm gần đúng: với nhỏ, nó vẫn có thể bỏ sót chuỗi tốt nhất, và chi phí của nó gấp khoảng lần greedy.
Beam search còn một khuyết điểm mà các bài giảng đều nhắc. Điểm số của một chuỗi là tổng log-xác suất của các token, mỗi số hạng đều âm, nên chuỗi càng dài điểm càng thấp và beam search thiên về câu ngắn. Cách sửa thông dụng là chia tổng cho , với là độ dài chuỗi: là không chuẩn hoá, là lấy trung bình theo token, còn Andrew Ng và d2l.ai dùng khoảng 0,7 đến 0,75. Chẳng hạn một chuỗi 3 token có tổng log-xác suất và một chuỗi 6 token có tổng . Không chuẩn hoá thì chuỗi ngắn thắng. Với , điểm số của chúng là và , và chuỗi dài thắng.
Khi kết quả của beam search tệ, Andrew Ng gợi ý một phép phân tích lỗi để biết nên sửa phần nào. Gọi là kết quả của beam search và là một kết quả tốt, chẳng hạn bản dịch của người, rồi dùng chính mô hình để tính và . Nếu , mô hình đã đánh giá cao hơn nhưng beam search không tìm thấy, nên tăng có thể giúp. Nếu ngược lại, lỗi nằm ở mô hình, và tăng không giúp được gì. Đếm hai trường hợp trên nhiều ví dụ lỗi cho biết nên dành công sức cho bộ giải mã hay cho mô hình, theo đúng tinh thần phân tích lỗi ở Mục 1.3.
Với văn bản mở, beam search lại cho kết quả kém: văn bản thường lặp lại, nhạt và chung chung. Holtzman và cộng sự (2020) giải thích rằng văn bản do con người viết không có xác suất cao một cách đều đặn theo mô hình, mà thường có những lựa chọn ít khả năng. Tối đa hoá xác suất của cả chuỗi vì vậy đẩy kết quả về phía văn bản an toàn và đơn điệu. Các con số của họ trên GPT-2 Large cho thấy rõ điều này. Văn bản do người viết có perplexity 12,38 theo mô hình, còn văn bản sinh bằng greedy và bằng beam search với chỉ có 1,50 và 1,48, tức dễ đoán hơn nhiều so với văn bản thật. Tỉ lệ đoạn sinh ra rơi vào vòng lặp là 73,66% với greedy và 28,94% với beam search, so với 0,28% ở văn bản của người. Lấy mẫu top- với cho perplexity 13,13 và tỉ lệ lặp 0,36%, gần với văn bản thật hơn hẳn. Do đó sinh văn bản mở thường dùng lấy mẫu, còn các bài toán có một đáp án đúng rõ ràng như dịch máy vẫn dùng beam search.
Hai kỹ thuật thường dùng để giảm lặp là phạt lặp, tức giảm logit của các token đã xuất hiện (Keskar và cộng sự, 2019), và cấm lặp lại một cụm token đã có. Phạt lặp có một chi tiết cài đặt hay gây nhầm. Công thức của CTRL chia logit của các token đã xuất hiện cho một hệ số, thường khoảng 1,2. Với logit dương, phép chia làm giảm đúng như ý muốn, 2,4 thành 2,0; nhưng với logit âm, nó lại làm tăng, thành . Thư viện Transformers của Hugging Face vì vậy nhân logit âm với hệ số thay vì chia, nên thành . API của OpenAI dùng cách trừ: presence penalty trừ một hằng số khỏi logit của mọi token đã xuất hiện, còn frequency penalty trừ một lượng tỉ lệ với số lần token đó đã xuất hiện. Cả hai là biện pháp điều chỉnh bên ngoài, không giải quyết nguyên nhân từ phía mô hình.
11.5Giải mã trong hệ thống thực tế#
Khi đưa vào hệ thống thật, giải mã có mấy điểm cần biết. Điểm đầu tiên là nhiệt độ 0 chưa chắc cho kết quả tất định. Với , quy tắc là greedy, nhưng phép cộng số thực không có tính kết hợp, và thứ tự cộng trong các kernel trên GPU có thể phụ thuộc vào kích thước lô, tức vào những yêu cầu khác đang được xử lý cùng lúc. Hai lần gọi giống hệt nhau vì vậy có thể cho kết quả khác nhau khi hai logit gần bằng nhau (He, 2025). Trong thí nghiệm của He, 1 000 lần gọi mô hình Qwen3-235B với cùng một câu lệnh và nhiệt độ 0 cho 80 kết quả khác nhau; mọi kết quả trùng nhau ở 102 token đầu và bắt đầu khác nhau từ token thứ 103. Sau khi thay các kernel bằng phiên bản cho kết quả không phụ thuộc kích thước lô, cả 1 000 kết quả giống hệt nhau, đổi lại hệ thống chạy chậm hơn. Không nên hứa với người dùng rằng đầu ra là tất định nếu hệ thống không được thiết kế riêng cho điều đó.
Điểm thứ hai là độ trễ. Mỗi token đầu ra cần một lượt xuôi qua toàn bộ mô hình, nên chi phí tỉ lệ với số token sinh ra, và yêu cầu mô hình trả lời ngắn gọn giảm chi phí và độ trễ một cách trực tiếp. Giải mã suy đoán (speculative decoding; Leviathan, Kalman và Matias, 2023; Chen và cộng sự, 2023) giảm độ trễ theo một cách khác: một mô hình nhỏ đề xuất trước vài token, mô hình lớn kiểm tra tất cả trong một lượt xuôi, và một quy tắc chấp nhận–từ chối bảo đảm phân phối của đầu ra đúng bằng phân phối của mô hình lớn. Kỹ thuật này giảm độ trễ mà không thay đổi chất lượng.
Quy tắc chấp nhận–từ chối đủ đơn giản để kiểm tra bằng tay. Gọi là phân phối của mô hình nhỏ và là phân phối của mô hình lớn tại cùng một vị trí. Token do mô hình nhỏ đề xuất được nhận với xác suất ; nếu bị từ chối, token được lấy mẫu lại từ phần dư sau khi chuẩn hoá. Xét hai token A, B với và . A được đề xuất với xác suất 0,8 và được nhận với xác suất , nên đầu ra là A với xác suất 0,6. B được đề xuất với xác suất 0,2 và luôn được nhận. A bị từ chối với xác suất , và khi đó phần dư chỉ còn B. Tổng cộng, đầu ra là B với xác suất , đúng bằng .
Tỉ lệ chấp nhận trung bình trong ví dụ trên là , và nó quyết định kỹ thuật này nhanh tới đâu. Nếu mỗi token được nhận với xác suất và mô hình nhỏ đề xuất token mỗi lượt, số token sinh được sau một lượt xuôi của mô hình lớn có kỳ vọng (Leviathan, Kalman và Matias, 2023); với và , con số này là 3,36 thay vì 1. Tốc độ thực tế thấp hơn vì mô hình nhỏ cũng tốn thời gian: Leviathan và cộng sự đo được mức tăng tốc 2 đến 3 lần với T5-XXL, còn Chen và cộng sự đo được 2 đến 2,5 lần với Chinchilla 70B.
Điểm cuối cùng là giải mã có thể được dùng để ép định dạng. Giải mã có ràng buộc đặt xác suất bằng 0 cho các token làm đầu ra vi phạm một cú pháp cho trước, chẳng hạn một lược đồ JSON, nên bảo đảm đầu ra đúng định dạng. Kỹ thuật này bảo đảm định dạng nhưng không giữ nguyên phân phối: Park và cộng sự (2024) chỉ ra rằng che token theo từng bước làm lệch phân phối của đầu ra so với phân phối của chính mô hình khi chỉ xét các chuỗi hợp lệ. Xét một ví dụ nhỏ. Mô hình sinh chuỗi gồm hai token, mỗi token là A hoặc B; cú pháp chỉ cấm chuỗi AB, và mô hình cho , , còn sau B thì A và B đều có xác suất 0,5. Theo chính mô hình, ba chuỗi hợp lệ AA, BA, BB có xác suất 0,06; 0,2; 0,2, tức 0,13; 0,43; 0,43 sau khi chuẩn hoá. Giải mã có ràng buộc vẫn cho phép A ở bước đầu, vì AA hợp lệ, rồi buộc token thứ hai là A, nên sinh ra AA với xác suất 0,6, gần gấp năm lần. Sai lệch chỉ lớn khi cú pháp cấm đúng những đường mà mô hình ưa thích; nếu mô hình vốn đã dồn xác suất vào các đầu ra hợp lệ, chẳng hạn vì định dạng được mô tả và cho ví dụ ngay trong câu lệnh, thì phép che gần như không thay đổi gì. Mục 4.4 của Ứng dụng LLM trình bày cách dùng kỹ thuật này.
11.6Tóm tắt#
Giải mã là quy tắc chọn token từ phân phối mà mô hình cho ra, và nó quyết định hành vi của hệ thống không kém gì mô hình. Greedy và beam search hợp với bài toán có một đáp án đúng. Beam search tìm được chuỗi có xác suất cao hơn greedy, như "mưa to" với 0,27 so với "đẹp quá" với 0,24 trong ví dụ, nhưng cần chuẩn hoá theo độ dài để khỏi thiên về câu ngắn. Văn bản mở dùng lấy mẫu, vì tối đa hoá xác suất của cả chuỗi cho văn bản nhạt và lặp: trên GPT-2 Large, 73,66% số đoạn sinh bằng greedy rơi vào vòng lặp. Trên một phân phối có đuôi dài, cần 8 362 token để phủ 90% xác suất; nhiệt độ co giãn cả phân phối, còn top- và top- cắt đuôi, với top- thích ứng theo mức chắc chắn của mô hình. Trong hệ thống thật, nhiệt độ 0 chưa chắc cho kết quả tất định, chi phí tỉ lệ với số token sinh ra, giải mã suy đoán giảm độ trễ mà không đổi phân phối nhờ quy tắc chấp nhận với xác suất , còn giải mã có ràng buộc bảo đảm định dạng nhưng có thể làm lệch phân phối.
Cả giải mã lẫn các cải tiến ở Chương 10 đều quay về cùng một câu hỏi thực tế: mô hình tốn bao nhiêu bộ nhớ và bao nhiêu phép tính. Chương 12 trả lời câu hỏi đó bằng các công thức tính được trên giấy, và kiểm chứng chúng với các mô hình thật.
Tự kiểm tra
2 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao beam search thường cho văn bản mở nhạt và lặp?
Vì sao: Nhận xét của Holtzman và cộng sự (2020). Beam search vẫn phù hợp với dịch máy, nơi đầu ra bị ràng buộc chặt bởi đầu vào (Mục 11.4).2Top-p khác top-k ở điểm cơ bản nào?
Vì sao: Ở Mục 11.3, với phân phối đuôi dài, top-p với giữ 4 141 token, còn top-k với luôn giữ 40 token dù mô hình chắc chắn hay không.
Đã trả lời 0/2