14Học tăng cường từ phản hồi của con người#
Sau tiền huấn luyện và tinh chỉnh có giám sát, mô hình ngôn ngữ làm theo chỉ dẫn nhưng chỉ tốt bằng các câu trả lời mẫu nó được học. RLHF (reinforcement learning from human feedback) cải thiện tiếp bằng dữ liệu so sánh giữa các câu trả lời. Cách làm này dựa trên một quan sát đơn giản về con người: chọn câu trả lời tốt hơn trong hai câu dễ hơn nhiều so với tự viết ra câu trả lời tốt nhất. Từ dữ liệu so sánh, ta học một hàm thưởng, rồi dùng học tăng cường ở Chương 12 và 13 để tối ưu mô hình theo hàm thưởng đó.
14.1Các giai đoạn huấn luyện một trợ lý#
Quy trình phổ biến, theo InstructGPT (Ouyang và cộng sự, 2022), gồm ba giai đoạn (Hình 14). Giai đoạn đầu là tiền huấn luyện trên hàng nghìn tỉ token không nhãn bằng cách dự đoán token tiếp theo (Chương 5). Giai đoạn thứ hai là tinh chỉnh có giám sát (supervised fine-tuning, SFT) trên hàng chục nghìn cặp (yêu cầu, câu trả lời tốt) do người viết; sau bước này, mô hình trả lời câu hỏi thay vì viết tiếp văn bản. Giai đoạn thứ ba học từ so sánh và gồm hai bước, ký hiệu 3a và 3b trên hình. Ở bước 3a, người đánh giá chọn câu trả lời tốt hơn trong các cặp câu trả lời của mô hình, và dữ liệu đó được dùng để huấn luyện một mô hình thưởng. Ở bước 3b, mô hình ngôn ngữ được tối ưu theo mô hình thưởng bằng học tăng cường, thường là PPO.
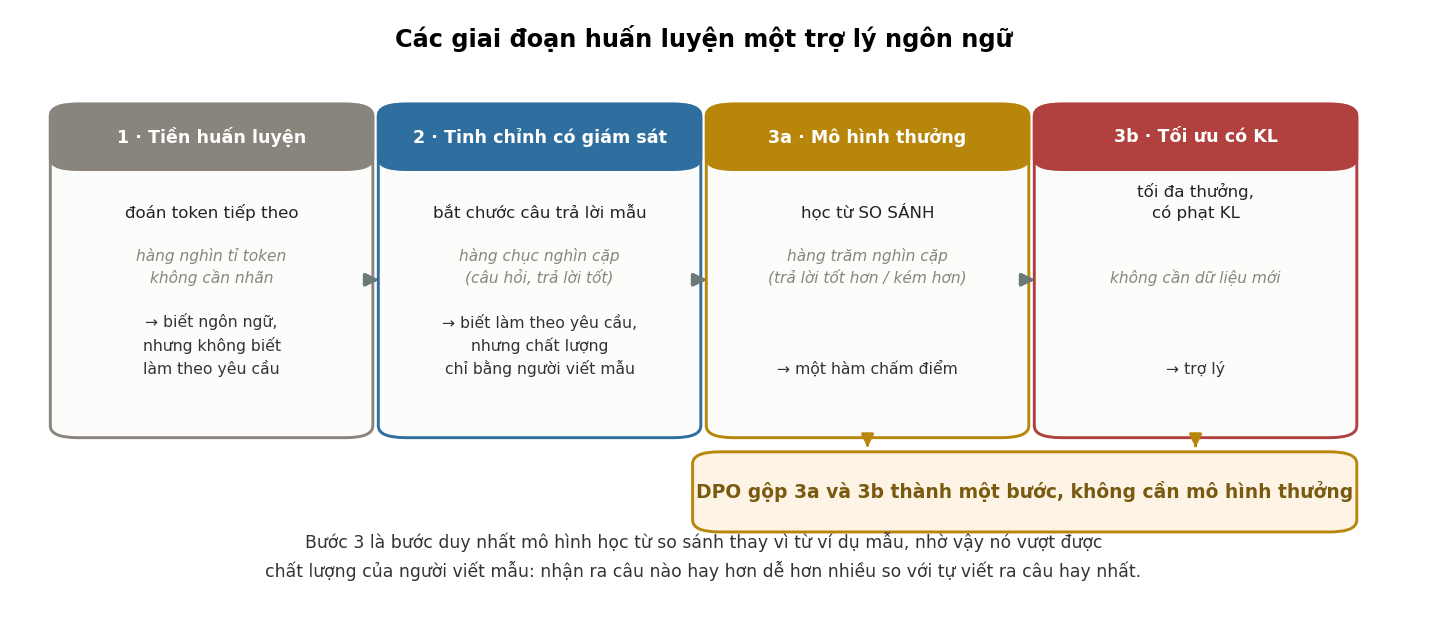
Giai đoạn thứ hai có một giới hạn: học bắt chước chỉ đưa mô hình tới chất lượng của các câu trả lời mẫu. Giai đoạn thứ ba được thiết kế để vượt giới hạn đó.
14.2Học từ so sánh#
Lý do chính là một sự bất đối xứng: đánh giá dễ hơn tạo ra. Nhiều người không viết được một bài thơ hay, nhưng chỉ ra được bài nào hay hơn trong hai bài. Viết một đoạn mã tối ưu thì khó, nhưng so sánh hai đoạn mã và nói đoạn nào rõ ràng hơn thì dễ hơn nhiều. Thu thập so sánh thay cho câu trả lời mẫu vì vậy cho tín hiệu về chất lượng cao hơn mức người gán nhãn tự viết ra được.
Lý do thứ hai mang tính thực tế: so sánh nhất quán giữa những người gán nhãn hơn chấm điểm tuyệt đối. Hỏi mười người "câu trả lời này bao nhiêu điểm trên thang 10" thường cho những con số rất khác nhau, vì mỗi người dùng thang đo theo cách riêng; hỏi "câu nào tốt hơn" cho mức đồng thuận cao hơn.
Christiano và cộng sự (2017) dùng học từ so sánh để huấn luyện tác tử trong các môi trường mô phỏng; Stiennon và cộng sự (2020) và Ouyang và cộng sự (2022) áp dụng cho mô hình ngôn ngữ. Trong InstructGPT, người đánh giá ưa thích câu trả lời của mô hình 1,3 tỉ tham số đã qua RLHF hơn câu trả lời của GPT-3 175 tỉ tham số chưa qua RLHF.
14.3Mô hình thưởng Bradley–Terry#
Từ dữ liệu so sánh, cần một hàm cho điểm câu trả lời của câu hỏi . Mô hình Bradley–Terry (Bradley và Terry, 1952) giả định xác suất người đánh giá chọn hơn là
Đây là hồi quy logistic trên hiệu của hai điểm thưởng (Mục 6.3 của Nền tảng), và mô hình thưởng được huấn luyện bằng hợp lý cực đại, tức cực tiểu trên các cặp. Trong thực tế, là một mô hình ngôn ngữ đã tinh chỉnh, thay lớp chiếu ra từ vựng bằng một đầu ra vô hướng.
Chẳng hạn nếu mô hình thưởng cho câu được chọn 1,5 điểm và câu bị loại 0,5 điểm, xác suất mô hình gán cho lựa chọn của người đánh giá là , và mất mát của cặp này là . Cần lưu ý rằng chỉ xác định được sai khác một hằng số cộng cho mỗi câu hỏi. Cộng cùng một hằng số vào điểm của mọi câu trả lời cho cùng một câu hỏi không thay đổi hiệu, nên không thay đổi hợp lý: 11,5 và 10,5 điểm cho đúng xác suất 0,731. Điều này vô hại vì bước sau chỉ dùng qua hàm mũ rồi chuẩn hoá (Mục 14.4), nên hằng số bị hằng số chuẩn hoá hấp thụ.
14.4Tối ưu có ràng buộc KL và nghiệm dạng đóng#
Có mô hình thưởng rồi, cần tìm chính sách cho phần thưởng cao. Nhưng nếu chỉ cực đại phần thưởng, mô hình sẽ khai thác mọi điểm yếu của mô hình thưởng, vốn chỉ là một xấp xỉ học từ dữ liệu hữu hạn; hiện tượng này gọi là lách phần thưởng (reward hacking; Gao, Schulman và Hilton, 2023). Cách hạn chế là phạt độ lệch khỏi chính sách tham chiếu , thường là mô hình sau bước SFT:
Mệnh đề 14.1
Nghiệm của bài toán trên là
Chứng minh
Với cố định, viết mục tiêu dưới dạng tổng trên các câu trả lời và thêm nhân tử Lagrange cho ràng buộc (Chương 12 của Nền tảng):
Đạo hàm theo bằng 0: , suy ra . Chuẩn hoá để tổng bằng 1 được . Hàm mục tiêu lõm theo nên điểm dừng này là cực đại.
Nghiệm có ý nghĩa rõ ràng: chính sách tối ưu là chính sách tham chiếu, đánh trọng số lại theo hàm mũ của phần thưởng. Câu trả lời có phần thưởng cao được tăng xác suất, phần thưởng thấp bị giảm. Nếu thì bất kể lớn tới đâu. điều chỉnh mức đánh trọng số lại: dồn toàn bộ xác suất vào câu trả lời có phần thưởng cao nhất, giữ nguyên . Với hai câu trả lời có và phần thưởng , công thức cho : xác suất của câu tốt hơn là 0,881 với , 0,731 với và chỉ 0,55 với .
Nghiệm dạng đóng kiểm chứng được bằng số. Trên một không gian nhỏ gồm 8 câu trả lời, bài toán được giải theo hai cách độc lập: thay vào công thức dạng đóng, và tối ưu trực tiếp bằng BFGS trên đơn hình xác suất mà không dùng công thức.
| Chênh lệch giữa hai cách | Phần thưởng kỳ vọng đạt được | ||
|---|---|---|---|
| 0,05 | 4,741 | 2,438 | |
| 0,20 | 4,658 | 2,424 | |
| 1,00 | 0,417 | 0,303 | |
| 5,00 | 0,017 |
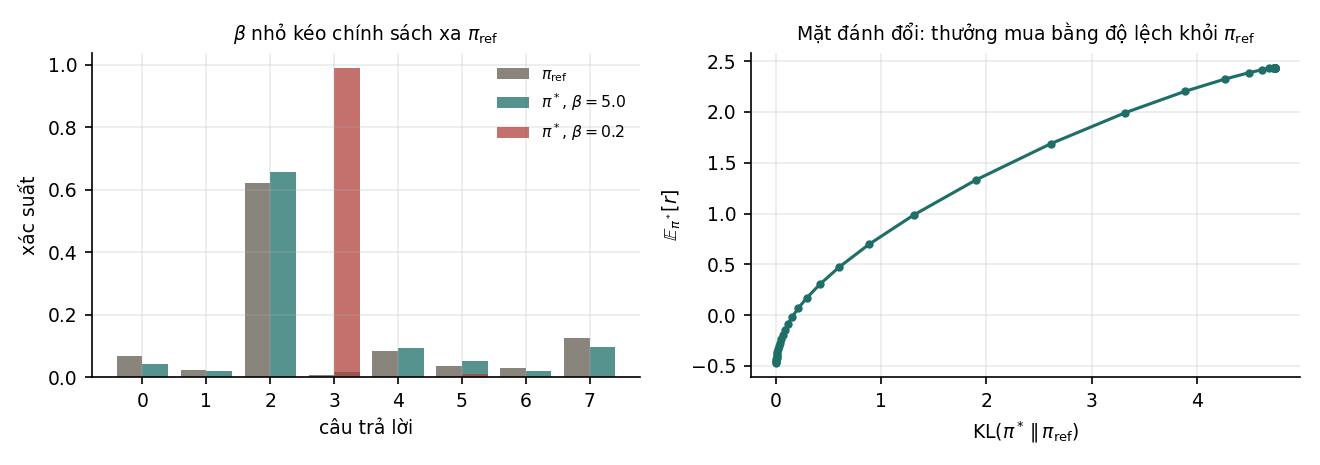
Hình bên phải cho cách hiểu phù hợp về : nó không có một giá trị "đúng" cần tìm, mà chọn một điểm trên đường đánh đổi. Muốn phần thưởng theo mô hình thưởng cao hơn thì phải chấp nhận đi xa hơn, và đi xa hơn thì nguy cơ lách phần thưởng cao hơn. Trong thực tế, được chọn bằng cách theo dõi chất lượng theo đánh giá của người hoặc của một mô hình thưởng độc lập khi KL tăng.
14.5Hạn chế của quy trình RLHF#
Quy trình RLHF với PPO cần huấn luyện một mô hình thưởng riêng, rồi giữ bốn mô hình trong bộ nhớ cùng lúc khi tối ưu: chính sách đang học, chính sách tham chiếu để tính KL, mô hình thưởng, và mô hình giá trị (critic) của PPO. Quy trình tốn bộ nhớ và nhạy với siêu tham số, vì kế thừa các khó khăn của học tăng cường ở Chương 12 và 13. Câu hỏi tự nhiên là có thể bỏ bớt thành phần nào mà vẫn tối ưu cùng một mục tiêu không.
14.6Tóm tắt#
Tinh chỉnh có giám sát chỉ đưa mô hình tới chất lượng của câu trả lời mẫu. RLHF vượt giới hạn đó bằng dữ liệu so sánh, vì đánh giá dễ hơn tạo ra và so sánh nhất quán giữa người gán nhãn hơn chấm điểm tuyệt đối. Mô hình thưởng Bradley–Terry là hồi quy logistic trên hiệu hai điểm thưởng. Tối ưu phần thưởng có phạt KL với hệ số có nghiệm dạng đóng: chính sách tham chiếu đánh trọng số lại theo , và trên không gian 8 câu trả lời, nghiệm này khớp với nghiệm tìm bằng BFGS với chênh lệch không quá . chọn một điểm trên đường đánh đổi giữa phần thưởng và độ lệch khỏi chính sách tham chiếu. Quy trình với PPO giữ bốn mô hình trong bộ nhớ và nhạy với siêu tham số.
Nghiệm dạng đóng ở Mục 14.4 còn dùng được theo chiều ngược lại: biết chính sách thì suy ra được hàm thưởng. Chương 15 khai thác điều đó để bỏ cả mô hình thưởng lẫn học tăng cường mà vẫn tối ưu cùng một mục tiêu.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Nghiệm của bài toán là gì?
Vì sao: Suy ra bằng nhân tử Lagrange với ràng buộc tổng xác suất bằng 1. Ở Mục 14.4, công thức khớp với nghiệm tìm bằng BFGS tới cỡ .2Nếu thì bằng bao nhiêu?
Vì sao: Nhân với 0 vẫn bằng 0. Điều này giữ mô hình trong phạm vi hành vi của mô hình tham chiếu, nhưng không ngăn được những hành vi mà mô hình tham chiếu đã có xác suất dương.3Vì sao học từ so sánh có thể vượt chất lượng của học bắt chước?
Vì sao: Học bắt chước chỉ đưa mô hình tới chất lượng của câu trả lời mẫu; so sánh cho tín hiệu về chất lượng cao hơn mức người gán nhãn tự viết ra.4Nên hiểu hệ số trong RLHF thế nào?
Vì sao: nhỏ cho phần thưởng theo mô hình thưởng cao hơn nhưng đi xa hơn, tăng nguy cơ lách phần thưởng.
Đã trả lời 0/4