9Dịch chuyển phân phối#
Một giả định ngầm của mọi phương pháp học có giám sát là dữ liệu lúc sử dụng có cùng phân phối với dữ liệu lúc huấn luyện. Trong sản xuất, giả định đó chỉ đúng trong một thời gian. Người dùng thay đổi, sản phẩm thay đổi, thị trường thay đổi, và dữ liệu đi vào mô hình khác dần với dữ liệu nó đã học. Hiện tượng này gọi là dịch chuyển phân phối (distribution shift). Để phát hiện và xử lý nó, trước hết cần phân biệt các loại dịch chuyển, vì chúng có hậu quả rất khác nhau và không phải loại nào cũng phát hiện được bằng cùng một cách.
9.1Các loại dịch chuyển#
Mô hình học quan hệ giữa đầu vào và nhãn từ phân phối chung . Theo quy tắc nhân của xác suất, phân phối chung có thể tách theo hai cách:
Mỗi cách tách cho một cách mô tả sự thay đổi (Quiñonero-Candela và cộng sự, 2009). Theo cách tách thứ nhất, có thể chỉ thay đổi trong khi giữ nguyên; trường hợp này gọi là covariate shift. Ví dụ, một chiến dịch quảng cáo thu hút nhiều khách hàng trẻ hơn: quan hệ giữa tuổi và hành vi mua hàng không đổi, chỉ có tỉ lệ người trẻ trong dữ liệu tăng lên. Cũng theo cách tách đó, có thể thay đổi; trường hợp này gọi là concept drift. Ví dụ, ngân hàng thay đổi chính sách tín dụng, nên cùng một hồ sơ khách hàng giờ được đánh giá rủi ro khác trước. Theo cách tách thứ hai, có thể chỉ thay đổi trong khi giữ nguyên; trường hợp này gọi là label shift (hay prior probability shift). Ví dụ, tỉ lệ giao dịch gian lận tăng gấp đôi trong dịp lễ, nhưng một giao dịch gian lận vẫn có đặc điểm như trước.
Vì covariate shift và concept drift là hai thành phần của cùng một cách tách, còn label shift thuộc cách tách kia, câu hỏi "đây là covariate shift hay label shift" không phải lúc nào cũng có câu trả lời duy nhất. Nó phụ thuộc vào việc ta coi gây ra , như đặc điểm khách hàng quyết định hành vi, hay gây ra , như bệnh gây ra triệu chứng. Trong thực tế, nhiều loại dịch chuyển thường xảy ra cùng lúc.
9.2Phát hiện dịch chuyển khi chưa có nhãn#
Trong sản xuất, đầu vào có ngay khi mô hình nhận yêu cầu, còn nhãn thường đến muộn hoặc không bao giờ đến (Mục 3.5). Vì vậy câu hỏi thực tế là: chỉ nhìn vào , ta phát hiện được loại dịch chuyển nào? Thí nghiệm trong code/mlops/experiments.py trả lời câu hỏi đó.
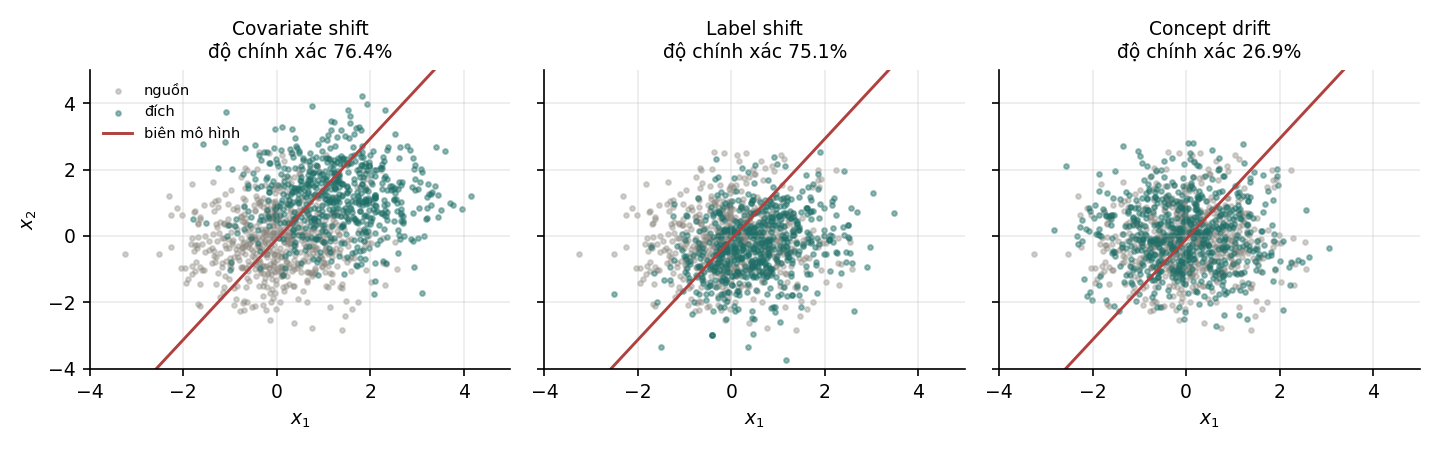
Dữ liệu có hai đặc trưng, , và nhãn sinh theo mô hình logistic với trọng số . Một hồi quy logistic được huấn luyện trên 4 000 mẫu, rồi được đánh giá trên ba tập dữ liệu mới, mỗi tập 4 000 mẫu, ứng với ba loại dịch chuyển. Với covariate shift, được lấy từ trên mỗi trục, còn nhãn vẫn sinh theo quy tắc cũ. Với label shift, dữ liệu được lấy mẫu lại sao cho 80% mẫu có nhãn dương thay vì khoảng 50%, giữ nguyên . Với concept drift, có cùng phân phối như lúc huấn luyện nhưng nhãn sinh theo trọng số mới . Với mỗi tập, ta đo hai đại lượng: độ chính xác của mô hình, cần có nhãn; và p-value của kiểm định Kolmogorov–Smirnov (KS) hai mẫu trên từng đặc trưng so với dữ liệu huấn luyện, không cần nhãn. Một dịch chuyển được coi là phát hiện được nếu p-value nhỏ nhất trong hai đặc trưng dưới .
| Trường hợp | Độ chính xác | p-value KS trên | p-value KS trên | Phát hiện được chỉ từ |
|---|---|---|---|---|
| Không dịch chuyển | 75,6% | |||
| Covariate shift | 76,4% | có | ||
| Label shift | 75,1% | có | ||
| Concept drift | 26,9% | không |
Bảng kết quả cho thấy hai điều trái ngược nhau. Ở hai trường hợp giữa, kiểm định KS phát hiện thay đổi rất rõ, với p-value gần như bằng 0, nhưng độ chính xác gần như không đổi. Với covariate shift, lý do là mô hình logistic có dạng đúng với quy tắc sinh nhãn, nên dữ liệu dịch sang vùng khác không làm nó sai; covariate shift chỉ gây hại khi mô hình phải ngoại suy sang vùng có ít dữ liệu huấn luyện mà nó mô tả sai. Với label shift, thay đổi vì mang thông tin về : tỉ lệ nhãn thay đổi thì phân phối của cũng thay đổi theo. Nếu hệ thống cảnh báo dựa trên thay đổi của , cả hai trường hợp này đều thành báo động giả, đúng loại khó khăn được nhắc nhiều nhất ở Mục 3.2.
Ở dòng cuối thì ngược lại: độ chính xác giảm từ 75,6% xuống 26,9%, thấp hơn cả đoán ngẫu nhiên, trong khi các kiểm định trên không thấy gì bất thường. Giá trị trên chỉ là dao động ngẫu nhiên, vì phân phối của không hề đổi; nếu dùng ngưỡng 0,05 quen thuộc, nó sẽ bị tính là phát hiện được, một ví dụ của vấn đề kiểm định nhiều lần mà Mục 9.3 sẽ bàn.
Kết quả này không phải ngẫu nhiên mà suy ra được từ định nghĩa: concept drift có thể giữ nguyên , nên không phép kiểm tra nào chỉ dựa trên phát hiện được nó. Muốn phát hiện concept drift phải có tín hiệu về nhãn: nhãn thật, nhãn đến trễ, nhãn thay thế, hoặc phản hồi gián tiếp của người dùng. Đây là lý do Mục 3.5 nói độ trễ nhãn quyết định khả năng giám sát của hệ thống: nó quyết định ta có phát hiện được loại dịch chuyển gây hại nhiều nhất hay không.
9.3Các kiểm định thống kê#
Với dữ liệu thật, có nhiều cách so sánh phân phối hiện tại với phân phối tham chiếu. Kiểm định Kolmogorov–Smirnov hai mẫu dùng cho biến liên tục một chiều; nó không giả định dạng phân phối và cho p-value, nhưng với cỡ mẫu rất lớn thì những khác biệt nhỏ không đáng kể cũng thành có ý nghĩa thống kê. Kiểm định khi bình phương dùng cho biến rời rạc hoặc đã chia bin; nó có lý thuyết rõ ràng nhưng phụ thuộc vào cách chia bin và kém chính xác khi có bin ít mẫu. PSI, trình bày ở Mục 9.4, cho một con số dễ báo cáo nhưng không có p-value. Với dữ liệu nhiều chiều có MMD (maximum mean discrepancy), đo khoảng cách giữa hai phân phối qua một hàm kernel và kiểm định bằng hoán vị, và cách dùng một bộ phân loại miền (domain classifier): huấn luyện một mô hình phân biệt dữ liệu cũ với dữ liệu mới; nếu nó làm tốt hơn đoán ngẫu nhiên thì dữ liệu đã thay đổi, và AUC của nó đo mức độ thay đổi.
Rabanser và cộng sự (2019) so sánh có hệ thống các phương pháp này và thấy một cách đơn giản cho kết quả tốt: áp dụng kiểm định KS lên đầu ra của mô hình (xác suất dự đoán cho từng lớp) thay vì lên từng đặc trưng đầu vào, kèm hiệu chỉnh Bonferroni. Đầu ra có ít chiều hơn đầu vào nhiều, và tập trung đúng vào những thay đổi có ảnh hưởng tới dự đoán. Mục 10.3 sẽ dùng một ý tưởng gần với cách này.
Khi áp dụng các kiểm định trên cho nhiều đặc trưng, cần nhớ hai điều. Điều thứ nhất là kiểm định nhiều lần: chạy KS trên 200 đặc trưng ở mức thì trung bình có 2 đặc trưng báo động ở mỗi lần kiểm tra dù không có gì thay đổi, nên cần hiệu chỉnh (Bonferroni, Benjamini–Hochberg) hoặc dùng một phép kiểm tra nhiều chiều. Điều thứ hai là nhiều dịch chuyển nằm ở quan hệ giữa các đặc trưng chứ không ở từng đặc trưng: mỗi đặc trưng vẫn giữ phân phối cũ nhưng tương quan giữa chúng thay đổi, và chỉ các phép kiểm tra nhiều chiều mới phát hiện được.
9.4Chỉ số PSI#
Trong các phép đo dịch chuyển, PSI (population stability index) được dùng rộng rãi nhất trong công nghiệp, đặc biệt trong lĩnh vực chấm điểm tín dụng nơi nó ra đời. PSI được tính trên hai phân phối đã chia thành bin. Gọi là tỉ lệ mẫu rơi vào bin trong tập tham chiếu và là tỉ lệ đó trong tập hiện tại:
Công thức này có một cách hiểu gọn hơn. Tách tổng thành hai phần:
Vậy PSI là tổng hai chiều của phân kỳ KL, còn gọi là phân kỳ Jeffreys; khác với phân kỳ KL, nó đối xứng giữa hai phân phối. Chẳng hạn với hai bin, tập tham chiếu chia đều còn tập hiện tại là : PSI bằng , và cũng bằng tổng của và . Một thay đổi 10 điểm phần trăm ở mỗi bin vẫn nằm dưới ngưỡng 0,10 thường dùng. Vì có , PSI không xác định khi một bin không có mẫu nào, nên các cài đặt thường thay tỉ lệ 0 bằng một số dương rất nhỏ.
Đi kèm PSI là một bộ ngưỡng quy ước được trích dẫn rất nhiều: PSI dưới 0,10 coi như phân phối ổn định, từ 0,10 tới 0,25 là có dịch chuyển nhỏ nên xem xét, trên 0,25 là dịch chuyển đáng kể cần hành động. Mục tiếp theo cho thấy vì sao không nên dùng thẳng bộ ngưỡng này.
9.5Ngưỡng của PSI#
Ba ngưỡng 0,10 và 0,25 là quy tắc kinh nghiệm, không phải kết quả thống kê. Yurdakul và Naranjo (2020) chỉ ra rằng khi hai mẫu có cùng phân phối, PSI nhân với một hệ số phụ thuộc cỡ mẫu có phân phối tiệm cận khi bình phương, và đề xuất dùng giá trị tới hạn tính từ phân phối đó thay cho quy tắc kinh nghiệm, vì giá trị tới hạn phụ thuộc cả vào cỡ mẫu lẫn số bin.
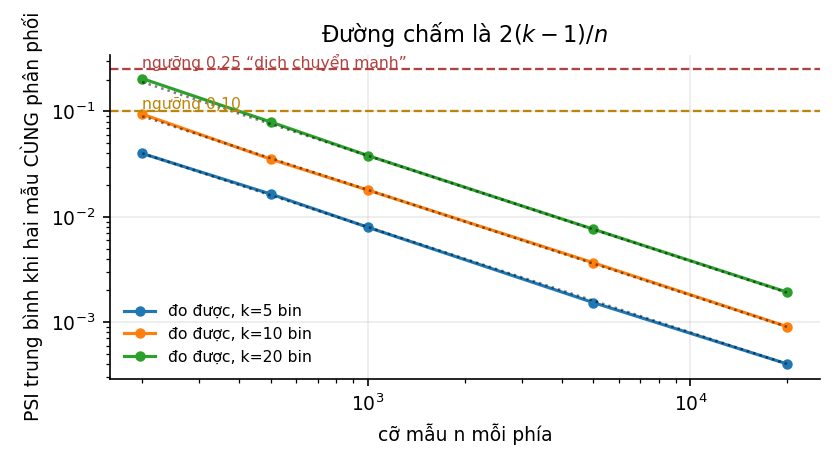
Có thể thấy điều này bằng một mô phỏng đơn giản. Lấy hai mẫu từ cùng một phân phối chuẩn, tức không có dịch chuyển nào, chia bin theo phân vị của mẫu tham chiếu, rồi tính PSI; lặp lại 300 lần và lấy trung bình:
| mỗi mẫu | Lý thuyết , | |||
|---|---|---|---|---|
| 200 | 0,0399 | 0,0943 | 0,2050 | 0,0900 |
| 500 | 0,0164 | 0,0353 | 0,0795 | 0,0360 |
| 1 000 | 0,0080 | 0,0179 | 0,0381 | 0,0180 |
| 5 000 | 0,0015 | 0,0037 | 0,0076 | 0,0036 |
| 20 000 | 0,0004 | 0,0009 | 0,0019 | 0,0009 |
PSI trung bình bám sát giá trị . Có thể giải thích con số này như sau. Khi hai mẫu cùng phân phối, và đều gần xác suất thật của bin , và chênh lệch giữa chúng có độ lớn cỡ . Dùng xấp xỉ , ta được
Với hai mẫu độc lập cùng cỡ , , nên có phân phối xấp xỉ khi bình phương với bậc tự do, đúng với kết quả tiệm cận nêu trên. Lấy kỳ vọng hai vế:
Hai đầu của bảng cho thấy vấn đề của ngưỡng cố định. Với và 20 bin, PSI trung bình là 0,205 khi không có dịch chuyển nào, đã rất gần ngưỡng 0,25. Với , PSI trung bình chỉ là 0,0009, nên ngưỡng 0,25 khó bị vượt ngay cả khi có dịch chuyển thật. Cùng một ngưỡng vì thế vừa gây báo động giả ở mẫu nhỏ, vừa bỏ sót dịch chuyển ở mẫu lớn.
Thí nghiệm tiếp theo đo trực tiếp hai hiện tượng đó. Với mỗi cỡ mẫu và mỗi độ dịch chuyển (mẫu mới có trung bình dịch đi lần độ lệch chuẩn), ta lặp lại 400 lần và đếm tỉ lệ số lần mỗi quy tắc báo động. Quy tắc thứ nhất là PSI lớn hơn 0,25 với 10 bin; quy tắc thứ hai là kiểm định KS với .
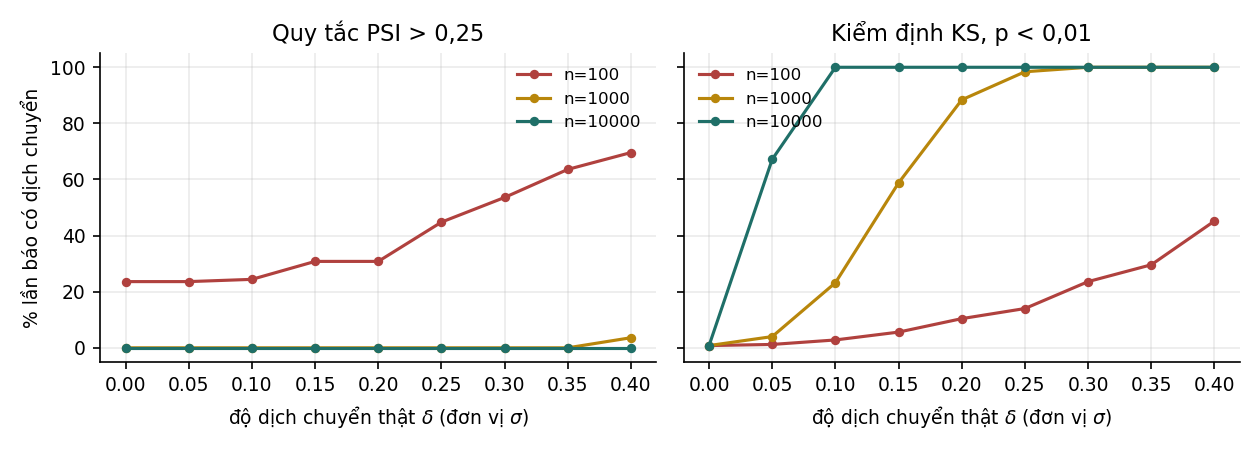
Mỗi ô ghi tỉ lệ báo động của quy tắc PSI, rồi của kiểm định KS:
| (không dịch chuyển) | |||
|---|---|---|---|
| 50 | 73% / 0% | 78% / 1% | 82% / 5% |
| 100 | 24% / 1% | 24% / 2% | 54% / 24% |
| 200 | 0% / 0% | 0% / 5% | 17% / 49% |
| 1 000 | 0% / 2% | 0% / 22% | 0% / 100% |
| 10 000 | 0% / 0% | 0% / 100% | 0% / 100% |
Cột là tỉ lệ báo động giả. Với , quy tắc PSI báo động 73% số lần dù không có gì thay đổi, còn kiểm định KS giữ tỉ lệ báo động giả quanh mức danh nghĩa 1% ở mọi cỡ mẫu. Hai cột còn lại là độ nhạy. Với và dịch chuyển thật 0,3 độ lệch chuẩn, quy tắc PSI không báo động lần nào, trong khi KS báo động ở cả 400 lần. Ở cỡ mẫu nhỏ, tỉ lệ báo động của PSI gần như không phụ thuộc vào việc có dịch chuyển hay không: 73% khi không có dịch chuyển, 78% với .
Từ đó có ba cách làm tốt hơn, theo thứ tự ưu tiên. Cách tốt nhất là dùng kiểm định có p-value (KS, khi bình phương, MMD với kiểm định hoán vị) kèm hiệu chỉnh cho kiểm định nhiều lần; ngưỡng khi đó tự điều chỉnh theo cỡ mẫu. Nếu buộc phải dùng PSI, chẳng hạn vì quy định của ngành hoặc vì báo cáo đã quen dùng, hãy tính ngưỡng theo đúng và của mình. Với hai mẫu cùng cỡ , kết quả ở trên cho ngưỡng ở mức ý nghĩa là . Ví dụ với và , , nên ngưỡng là 0,217 khi , 0,043 khi và 0,0043 khi . Cũng có thể xác định ngưỡng bằng mô phỏng: lấy nhiều cặp mẫu từ dữ liệu tham chiếu, tính PSI và dùng phân vị 99% làm ngưỡng. Cuối cùng, dù dùng cách nào, cần giữ cố định và giữa các lần đo; nếu cỡ lô thay đổi theo ngày thì PSI của hai ngày không so sánh được với nhau.
9.6Cửa sổ thời gian và tập tham chiếu#
Mọi phép kiểm tra dịch chuyển đều so sánh dữ liệu trong một cửa sổ hiện tại với một tập tham chiếu, và cả hai đều phải được chọn.
Cửa sổ hiện tại ngắn, ví dụ một giờ, cho phép phát hiện thay đổi nhanh nhưng nhiễu lớn và sinh nhiều báo động giả. Cửa sổ dài, ví dụ một tuần, ổn định hơn nhưng làm loãng các thay đổi đột ngột và phát hiện chúng muộn.
Với tập tham chiếu, nếu dùng cố định dữ liệu huấn luyện, phép kiểm tra trả lời đúng câu hỏi "dữ liệu hiện tại đã khác dữ liệu huấn luyện tới đâu", nhưng sẽ tiếp tục báo động cả khi dịch chuyển đã ổn định thành trạng thái bình thường mới. Nếu dùng tham chiếu trượt, ví dụ 30 ngày gần nhất, phép kiểm tra thích ứng với trạng thái bình thường mới, nhưng không phát hiện được dịch chuyển chậm, vì tập tham chiếu trôi theo dữ liệu. Điều này nguy hiểm, vì Chương 11 sẽ cho thấy dịch chuyển chậm có thể gây thiệt hại lớn. Cách làm hợp lý là dùng cả hai: tham chiếu cố định để biết dữ liệu đã cách xa dữ liệu huấn luyện bao nhiêu, tham chiếu trượt để phát hiện thay đổi đột ngột.
Một khó khăn khác là tính mùa vụ. Lưu lượng ngày thứ Bảy khác ngày thứ Ba, tháng Chạp khác tháng Ba. So dữ liệu thứ Bảy với tham chiếu tính trên các ngày thường sẽ báo động đều đặn mỗi tuần mà không có ý nghĩa gì. Cách xử lý tối thiểu là so sánh cùng kỳ, chẳng hạn thứ Bảy với các thứ Bảy trước.
9.7Tóm tắt#
Dịch chuyển phân phối có ba loại chính: covariate shift thay đổi , label shift thay đổi , và concept drift thay đổi . Chỉ hai loại đầu phát hiện được khi chỉ có , và trong thí nghiệm ở Mục 9.2, chúng gần như không làm giảm độ chính xác; concept drift làm độ chính xác giảm từ 75,6% xuống 26,9% mà không phép kiểm tra nào trên nhận ra. Để đo dịch chuyển nên dùng kiểm định có p-value kèm hiệu chỉnh cho kiểm định nhiều lần; ngưỡng PSI 0,25 không dùng được cho mọi cỡ mẫu vì PSI trung bình khi không có dịch chuyển xấp xỉ . Cửa sổ thời gian và tập tham chiếu cũng cần được chọn cẩn thận để không bỏ sót dịch chuyển chậm.
Phát hiện dịch chuyển chỉ là một phần của việc theo dõi mô hình trong sản xuất. Chương 10 đặt các phép kiểm tra này vào một hệ thống giám sát đầy đủ.
Tự kiểm tra
7 câu. Chọn đáp án để xem ngay lời giải thích.
1Loại dịch chuyển nào không phát hiện được bằng cách chỉ giám sát ?
Vì sao: Concept drift thay đổi và có thể giữ nguyên . Trong thí nghiệm ở Mục 9.2, độ chính xác giảm từ 75,6% xuống 26,9% trong khi kiểm định KS trên đặc trưng cho .2Vì sao label shift phát hiện được qua phân phối của ?
Vì sao: Điều này đúng khi mang thông tin về . Trong thí nghiệm ở Mục 9.2, label shift cho p-value KS trong khi độ chính xác gần như không đổi.3PSI là đại lượng gì?
Vì sao: . Khác với phân kỳ KL, PSI đối xứng.4Vì sao không nên dùng ngưỡng PSI 0,25 cho mọi cỡ mẫu?
Vì sao: Mô phỏng ở Mục 9.5: với , quy tắc PSI > 0,25 báo động 73% số lần khi không có dịch chuyển; với và dịch chuyển thật 0,3 độ lệch chuẩn, quy tắc này không báo động lần nào, trong khi kiểm định KS báo động ở mọi lần.5Với hai mẫu cùng cỡ và bin, ngưỡng PSI ở mức ý nghĩa 1% xấp xỉ bằng bao nhiêu?
Vì sao: Ngưỡng là . Giá trị 0,0043 ứng với .6Theo Rabanser và cộng sự (2019), một cách đơn giản mà hiệu quả để phát hiện dịch chuyển là gì?
Vì sao: Đầu ra của mô hình có ít chiều hơn đầu vào nhiều và tập trung vào những thay đổi ảnh hưởng tới dự đoán.7Dùng tham chiếu trượt 30 ngày để phát hiện dịch chuyển có nhược điểm gì?
Vì sao: Cách hợp lý là dùng cả hai: tham chiếu cố định để biết dữ liệu đã cách xa dữ liệu huấn luyện bao nhiêu, tham chiếu trượt để phát hiện thay đổi đột ngột.
Đã trả lời 0/7