7Phục vụ mô hình#
Phục vụ (serving) mô hình là đưa mô hình vào một hệ thống để nó nhận đầu vào và trả về dự đoán cho người dùng hoặc cho các dịch vụ khác. Có nhiều cách làm việc này, và cách nào phù hợp phụ thuộc vào việc kết quả cần nhanh tới đâu. Với các hệ thống trả lời trực tiếp cho người dùng, độ trễ trở thành ràng buộc chính, và cách đo độ trễ đúng không hiển nhiên như ta tưởng.
7.1Các chế độ phục vụ#
Có ba chế độ phục vụ chính. Ở chế độ theo lô (batch), mô hình chạy định kỳ, ví dụ mỗi đêm, chấm điểm cho toàn bộ người dùng hoặc sản phẩm rồi ghi kết quả vào một bảng; ứng dụng chỉ việc đọc bảng đó. Chế độ này phù hợp với gợi ý hằng ngày hay chấm điểm rủi ro tín dụng, và khó khăn chính của nó là dự đoán có thể đã cũ khi người dùng vừa thay đổi hành vi. Ở chế độ trực tuyến (online, hay request–response), mỗi yêu cầu gọi mô hình đồng bộ và nhận kết quả trong vài chục mili giây; chế độ này cần cho xếp hạng kết quả tìm kiếm hay chống gian lận khi thanh toán, và khó khăn chính là độ trễ. Ở chế độ luồng (streaming), mô hình xử lý từng sự kiện khi nó tới và cập nhật trạng thái liên tục, như khi phát hiện bất thường hay cá nhân hoá theo phiên; khó khăn chính là giữ trạng thái đúng và xử lý các sự kiện đến muộn.
Chi phí vận hành tăng nhanh theo thứ tự đó, nên nguyên tắc là chọn chế độ rẻ nhất vẫn đáp ứng được yêu cầu của sản phẩm. Một sai lầm hay gặp là chọn phục vụ trực tuyến khi nghiệp vụ không cần. Chế độ phục vụ cũng quyết định cách giám sát: với chấm điểm theo lô, có thể kiểm tra toàn bộ kết quả trước khi đưa vào sử dụng; với phục vụ trực tuyến, dự đoán đã tới người dùng trước khi ai kịp kiểm tra.
7.2Ngân sách độ trễ#
Thiết kế một dịch vụ phục vụ trực tuyến bắt đầu bằng việc chia tổng thời gian cho phép của một yêu cầu cho từng thành phần, gọi là ngân sách độ trễ. Ví dụ, giả sử một lượt xếp hạng kết quả tìm kiếm phải trả lời trong 150 ms, và được chia như sau:
| Thành phần | Ngân sách |
|---|---|
| Mạng, chiều đi và chiều về | 20 ms |
| Tra cứu đặc trưng ở kho trực tuyến | 25 ms |
| Tiền xử lý đặc trưng | 10 ms |
| Suy luận mô hình | 60 ms |
| Hậu xử lý, ghi log | 15 ms |
| Dự phòng | 20 ms |
Trong ví dụ này, suy luận mô hình chiếm chưa tới một nửa ngân sách. Nếu tối ưu mô hình để thời gian suy luận giảm từ 60 ms xuống 30 ms, tổng thời gian chỉ giảm 20%; trong khi bỏ được một lần tra cứu đặc trưng thừa có thể giảm nhiều hơn. Đây là phiên bản về độ trễ của Hình 1: mô hình chỉ là một phần của hệ thống. Các kỹ thuật giảm thời gian suy luận như lượng tử hoá được trình bày ở giáo trình Quantization.
7.3Phân vị độ trễ khi gọi nhiều dịch vụ#
Khi giám sát độ trễ, con số đầu tiên người ta nghĩ tới là độ trễ trung bình. Con số này ít có giá trị, vì phân phối độ trễ thường lệch phải rất mạnh: phần lớn yêu cầu nhanh, một số ít rất chậm, và người dùng nhớ những lần chậm. Vì vậy các mục tiêu mức dịch vụ (SLO) thường đặt trên phân vị cao như p95 hay p99, tức giá trị mà 95% hay 99% số yêu cầu không vượt quá.
Có một lý do sâu hơn để chú ý tới phân vị cao, được Dean và Barroso (2013) phân tích trong bài The Tail at Scale. Một yêu cầu tới hệ thống lớn thường phải gọi nhiều dịch vụ phía sau song song, chẳng hạn tra đặc trưng từ nhiều kho khác nhau, và chỉ trả lời được khi mọi lời gọi đã xong. Thời gian trả lời khi đó là giá trị lớn nhất của thời gian các lời gọi. Nếu có lời gọi độc lập, cùng hàm phân phối , thì
Như vậy, để cả yêu cầu đạt phân vị 99 như của một dịch vụ, mỗi dịch vụ phải đạt phân vị ; với , đó là phân vị 99,99.
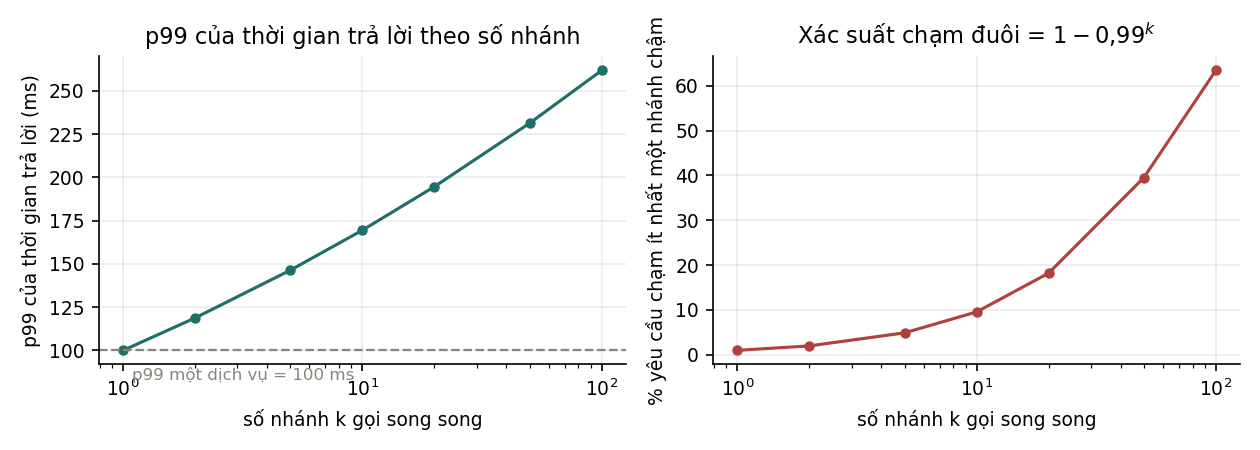
Để thấy độ lớn của hiệu ứng, thí nghiệm trong code/mlops/experiments.py dùng một dịch vụ có độ trễ phân phối log-chuẩn với trung vị 20 ms và p99 bằng 100 ms, rồi tính thời gian trả lời khi gọi song song nhiều bản của nó:
| Số dịch vụ | p99 của thời gian trả lời | Tỉ lệ yêu cầu gặp ít nhất một dịch vụ chậm |
|---|---|---|
| 1 | 100,0 ms | 1,0% |
| 10 | 169,5 ms | 9,6% |
| 50 | 231,4 ms | 39,5% |
| 100 | 261,9 ms | 63,4% |
Với 100 dịch vụ, mỗi dịch vụ chỉ chậm hơn 100 ms ở 1% số lần gọi, nhưng 63% số yêu cầu gặp ít nhất một lời gọi chậm như vậy. Giảm độ trễ trung bình của từng dịch vụ không giải quyết được vấn đề này, vì vấn đề nằm ở phần đuôi. Dean và Barroso đề xuất các cách tác động trực tiếp vào phần đuôi: giảm số dịch vụ phải gọi; đặt thời hạn chờ (timeout) và trả lời với kết quả một phần; và gửi yêu cầu dự phòng (hedged request), tức là nếu sau một khoảng thời gian bản đầu tiên chưa trả lời thì gửi thêm yêu cầu tới một bản sao khác, rồi dùng kết quả nào về trước.
7.4Đóng gói mô hình#
Nghiên cứu của Shankar và cộng sự ghi nhận một khó khăn mà nhiều kỹ sư gặp: môi trường phát triển và môi trường sản xuất khác nhau. Hai môi trường có yêu cầu trái ngược: môi trường phát triển cần linh hoạt để thử nghiệm nhanh, môi trường sản xuất cần chặt chẽ. Nhưng hai môi trường càng khác nhau thì càng khó phát hiện lỗi sớm, vì nhiều lỗi chỉ xuất hiện trong môi trường sản xuất.
Có ba thực hành giúp thu hẹp khoảng cách đó. Thứ nhất là dùng cùng một ảnh container cho huấn luyện và phục vụ, chỉ khác điểm vào (entrypoint). Thứ hai là dùng cùng một hàm biến đổi đặc trưng, đóng gói cùng mô hình thay vì cài đặt lại trong dịch vụ phục vụ, đúng tinh thần của Mục 4.4. Thứ ba là chạy kiểm thử tích hợp cho toàn bộ pipeline trong CI, trên một tập dữ liệu nhỏ nhưng thật, đúng như mục Infra 3 của ML Test Score.
Về định dạng lưu mô hình, có hai lựa chọn với ưu nhược điểm ngược nhau. Lưu bằng pickle hay state_dict của PyTorch đơn giản và giữ nguyên hệ sinh thái, nhưng phụ thuộc chặt vào phiên bản thư viện, và việc nạp một tệp pickle không đáng tin cậy có thể chạy mã tuỳ ý. Xuất mô hình thành đồ thị tính toán (ONNX, TorchScript, SavedModel) cho một tạo tác độc lập với ngôn ngữ, tối ưu được và có ranh giới rõ, nhưng kém linh hoạt và cần kiểm tra rằng đồ thị xuất ra cho cùng kết quả với bản gốc.
Với cách thứ hai, luôn cần một kiểm thử so sánh: chạy bản gốc và bản đã xuất trên cùng một lô đầu vào và so sánh đầu ra. Hai bản có thể dùng các kernel khác nhau, với thứ tự phép tính khác nhau, nên phép so sánh thường dùng một dung sai (ví dụ sai số tương đối ) thay vì đòi trùng khớp từng bit. Mục 6.5 của giáo trình Quantization là một ví dụ của cùng cách làm: kiểm tra bằng mã rằng phép tính số nguyên cho cùng kết quả với phép mô phỏng bằng số thực.
7.5Tóm tắt#
Có ba chế độ phục vụ, theo lô, trực tuyến và luồng, với chi phí và độ phức tạp tăng dần; nên chọn chế độ rẻ nhất đáp ứng được yêu cầu. Với phục vụ trực tuyến, ngân sách độ trễ cho thấy suy luận mô hình thường chỉ chiếm một phần thời gian, và khi một yêu cầu gọi nhiều dịch vụ song song, phần đuôi của phân phối độ trễ chi phối thời gian trả lời: với 100 dịch vụ, 63% số yêu cầu gặp ít nhất một lời gọi chậm. Đóng gói mô hình cùng hàm biến đổi đặc trưng trong cùng một container, và kiểm tra bản đã xuất bằng phép so sánh có dung sai, giúp môi trường sản xuất khớp với môi trường phát triển.
Một mô hình đã được đóng gói vẫn chưa nên được đưa ngay tới mọi người dùng. Chương 8 bàn về cách triển khai một mô hình mới từng bước, và cách biết chắc nó tốt hơn mô hình cũ.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao theo dõi p99 thay vì độ trễ trung bình?
Vì sao: Với nhánh độc lập, phân vị của giá trị lớn nhất là : để cả yêu cầu đạt p99 với , mỗi nhánh phải đạt phân vị 99,99.2Một yêu cầu gọi 100 dịch vụ song song, mỗi dịch vụ chậm hơn p99 của nó ở 1% số lần gọi. Bao nhiêu phần trăm yêu cầu gặp ít nhất một dịch vụ chậm?
Vì sao: . Giảm độ trễ trung bình không giải quyết được; các cách xử lý là giảm số nhánh, đặt thời hạn chờ và trả lời với kết quả một phần, hoặc gửi yêu cầu dự phòng (Dean và Barroso, 2013).3Trong ví dụ ngân sách độ trễ 150 ms ở Mục 7.2, giảm thời gian suy luận từ 60 ms xuống 30 ms làm tổng thời gian giảm bao nhiêu?
Vì sao: 30 ms trên tổng 150 ms. Suy luận mô hình chỉ là một phần của ngân sách; bỏ một lần tra cứu đặc trưng thừa có thể giảm nhiều hơn.4Khi so sánh mô hình gốc với mô hình đã xuất sang ONNX, vì sao thường dùng dung sai thay vì đòi trùng khớp từng bit?
Vì sao: Phép cộng số thực dấu phẩy động không có tính kết hợp, nên thứ tự tính khác nhau cho kết quả khác nhau ở những chữ số cuối. Kiểm thử so sánh vẫn bắt buộc, chỉ là với một dung sai hợp lý.
Đã trả lời 0/4