12Vòng phản hồi#
Trong các chương trước, dữ liệu đến từ thế giới bên ngoài và mô hình chỉ quan sát nó. Ở nhiều hệ thống, điều đó không đúng. Một hệ thống gợi ý quyết định sản phẩm nào được hiển thị, và người dùng chỉ nhấp được vào những sản phẩm đã được hiển thị. Một mô hình chống gian lận chặn một số giao dịch, và ta không bao giờ biết các giao dịch bị chặn có thật sự gian lận không. Khi dự đoán của mô hình ảnh hưởng tới dữ liệu mà nó sẽ được huấn luyện lần sau, hệ thống có một vòng phản hồi (feedback loop).
12.1Vòng phản hồi trực tiếp và vòng phản hồi ẩn#
Sculley và cộng sự (2015) phân biệt hai loại vòng phản hồi. Trong vòng phản hồi trực tiếp (direct feedback loop), mô hình ảnh hưởng trực tiếp tới việc chọn dữ liệu huấn luyện tương lai của chính nó, như hệ thống gợi ý ở trên. Bài báo ghi nhận rằng về lý thuyết, cách giải đúng cho tình huống này là dùng thuật toán bandit, ví dụ contextual bandit, nhưng các thuật toán đó không phải lúc nào cũng mở rộng được tới kích thước không gian hành động của bài toán thực tế. Các cách giảm nhẹ khả thi hơn là thêm một mức ngẫu nhiên hoá vào quyết định của mô hình, hoặc tách riêng một phần dữ liệu không chịu ảnh hưởng của mô hình.
Trong vòng phản hồi ẩn (hidden feedback loop), hai hệ thống ảnh hưởng lẫn nhau một cách gián tiếp, qua thế giới bên ngoài. Ví dụ trong bài báo là hai hệ thống cùng quyết định nội dung của một trang web: một hệ thống chọn sản phẩm để hiển thị, hệ thống kia chọn các đánh giá liên quan. Cải thiện hệ thống thứ nhất làm người dùng nhấp nhiều hơn hoặc ít hơn vào phần của hệ thống thứ hai, và làm thay đổi dữ liệu huấn luyện của nó. Loại vòng phản hồi này khó phát hiện hơn nhiều, vì không có đường dữ liệu nào trong sơ đồ hệ thống cho thấy mối liên hệ giữa hai mô hình.
12.2Vòng phản hồi thoái hoá#
Trong thực tế, trường hợp gây hại nhiều nhất là vòng phản hồi thoái hoá (degenerate feedback loop), theo cách gọi của Huyen (2022): dự đoán ảnh hưởng tới phản hồi của người dùng, phản hồi được dùng làm nhãn cho lần huấn luyện sau, nên hệ thống tự củng cố những gì nó đã tin, kể cả khi điều đó sai.
Cơ chế này dễ thấy qua một hệ thống gợi ý. Giả sử ở vòng đầu, món A tình cờ được xếp cao hơn món B, dù chất lượng thật của hai món tương đương. A được hiển thị nhiều hơn nên nhận nhiều lượt nhấp hơn, chỉ vì được nhìn thấy nhiều hơn. Lần huấn luyện sau thấy A có nhiều lượt nhấp, nên xếp A cao hơn nữa. Dần dần B không còn được hiển thị, và vì không được hiển thị, B không có lượt nhấp nào để chứng tỏ nó cũng tốt.
Điều làm vòng phản hồi thoái hoá khó phát hiện là dữ liệu vẫn trông tốt. Tỉ lệ nhấp trên những gì được hiển thị vẫn cao, vì hệ thống chỉ hiển thị những gì nó tin là tốt, và các chỉ số ngoại tuyến tính trên dữ liệu log không cho thấy vấn đề gì.
12.3Mô phỏng một hệ thống gợi ý#
Để đo thiệt hại của vòng phản hồi, thí nghiệm trong code/mlops/experiments.py mô phỏng một hệ thống gợi ý với danh mục 2 000 món. Mỗi món có một chất lượng thật, tức xác suất người dùng nhấp khi thấy nó, lấy từ phân phối Beta(1,6; 9): phần lớn các món bình thường, chỉ ít món thật sự tốt. Hệ thống không biết các giá trị này. Nó khởi động bằng 200 lượt hiển thị ngẫu nhiên, sau đó lặp lại 30 vòng: xếp các món theo tỉ lệ nhấp đã quan sát, chọn 10 món đầu, hiển thị cho 3 000 người dùng, rồi cập nhật số liệu từ log nhấp của chính nó. Để so sánh, chiến lược ngẫu nhiên hoá với tham số thay vị trí trong danh sách bằng các món chọn ngẫu nhiên từ toàn bộ danh mục. Kết quả là trung bình của 20 lần chạy.
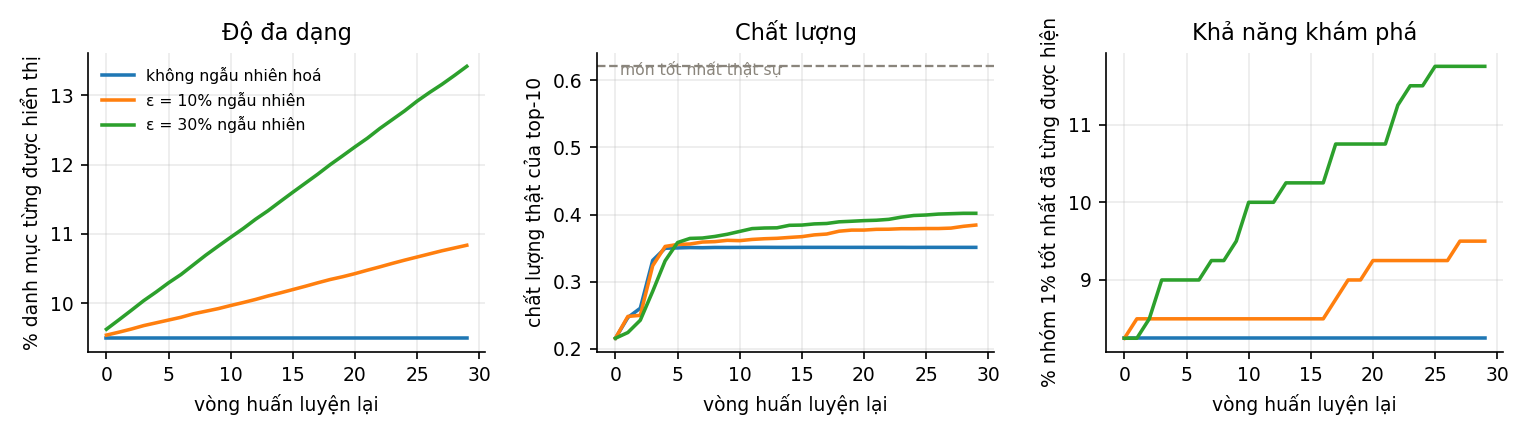
| Chiến lược | Tỉ lệ danh mục từng được hiển thị | Chất lượng thật của 10 món xếp đầu | Tỉ lệ nhóm 1% tốt nhất từng được hiển thị |
|---|---|---|---|
| Không ngẫu nhiên hoá | 9,5% | 0,351 | 8% |
| ε = 10% | 10,8% | 0,384 | 10% |
| ε = 30% | 13,4% | 0,402 | 12% |
Để có điểm so sánh: chất lượng trung bình của 10 món tốt nhất thật sự là 0,555, và chất lượng trung bình của toàn danh mục là 0,153.
Không ngẫu nhiên hoá, hệ thống đạt chất lượng 0,351, khoảng 63% mức tối đa, và trong suốt 30 vòng chỉ hiển thị 9,5% danh mục, đúng những món đã xuất hiện trong 200 lượt khởi động. Lý do nằm ở cách xếp hạng: những món chưa từng được hiển thị có tỉ lệ nhấp quan sát bằng 0, nên không bao giờ lọt vào danh sách. Hệ thống không hỏng theo nghĩa thông thường; nó chỉ không thể tốt hơn.
Dành 30% vị trí cho các món ngẫu nhiên nâng tỉ lệ danh mục được hiển thị từ 9,5% lên 13,4%, tức tăng 41% theo tỉ lệ tương đối, và nâng chất lượng của danh sách từ 0,351 lên 0,402, tức tăng khoảng 15%. Đổi lại, 30% số lượt hiển thị dành cho các món ngẫu nhiên có chất lượng trung bình chỉ 0,153. Đây là đánh đổi giữa khai thác (dùng những gì đã biết là tốt) và khám phá (thử những gì chưa biết), và cũng chính là "thêm một mức ngẫu nhiên hoá" mà Sculley và cộng sự đề xuất.
Mức cải thiện vẫn nhỏ so với khoảng cách tới mức tối đa. Với 30 vòng và chỉ 1 tới 3 vị trí ngẫu nhiên mỗi vòng, khám phá ngẫu nhiên đi rất chậm: sau 30 vòng, chiến lược mới gặp được 12% nhóm món tốt nhất. Các thuật toán bandit như UCB hay Thompson sampling hướng việc khám phá vào những món còn chưa chắc chắn thay vì chọn đều trên toàn danh mục, nên hiệu quả hơn nhiều. Bài 8 ở Chương 14 khảo sát thêm cách chọn khi tính cả chất lượng mà người dùng thực sự nhận được.
12.4Phát hiện và khắc phục#
Vòng phản hồi không để lại dấu vết trong các chỉ số chất lượng thông thường, nên cần theo dõi những tín hiệu khác. Tín hiệu thứ nhất là độ đa dạng giảm dần qua các vòng: entropy của phân phối hiển thị, số món khác nhau được hiển thị, tỉ lệ danh mục được hiển thị. Tín hiệu thứ hai là phân phối hiển thị lệch dần về một nhóm nhỏ, chẳng hạn tỉ trọng của 1% món được hiển thị nhiều nhất tăng đều. Tín hiệu thứ ba là các món mới thêm vào danh mục không bao giờ vào được danh sách đầu.
Có bốn cách khắc phục, xếp theo chi phí tăng dần. Cách rẻ nhất là ngẫu nhiên hoá một phần vị trí hiển thị như trong mô phỏng ở trên, hoặc dùng một thuật toán bandit. Cách thứ hai là giữ một nhóm đối chứng: một tỉ lệ nhỏ lưu lượng nhận kết quả ngẫu nhiên hoặc theo quy tắc đơn giản, không chịu ảnh hưởng của mô hình. Dữ liệu từ nhóm này không bị mô hình làm sai lệch, nên vừa dùng được để huấn luyện, vừa cho một thước đo đáng tin cậy về giá trị thật của hệ thống. Cách thứ ba là hiệu chỉnh theo xác suất hiển thị (inverse propensity weighting): khi huấn luyện, gán cho mỗi mẫu trọng số bằng nghịch đảo xác suất nó được hiển thị, để bù cho việc một số món được hiển thị nhiều hơn các món khác (Joachims và cộng sự, 2017). Cách này đòi hỏi ghi lại xác suất hiển thị ngay tại thời điểm hiển thị; nếu không ghi lại từ đầu thì không thể khôi phục về sau. Cách thứ tư dùng cho thiên lệch vị trí: khi huấn luyện, thêm vị trí hiển thị làm một đặc trưng để mô hình tách được phần lượt nhấp do vị trí gây ra; khi phục vụ, đặt vị trí bằng cùng một hằng số cho mọi món.
Trong bốn cách, nhóm đối chứng đáng được ưu tiên vì một nhóm nhỏ, duy trì thường xuyên, mang lại cả dữ liệu không bị sai lệch lẫn một thước đo trung thực.
12.5Tóm tắt#
Khi dự đoán của mô hình ảnh hưởng tới dữ liệu huấn luyện sau này, hệ thống có vòng phản hồi, trực tiếp hoặc ẩn. Vòng phản hồi thoái hoá làm hệ thống tự củng cố những gì nó đã tin: trong mô phỏng ở Mục 12.3, không ngẫu nhiên hoá thì hệ thống chỉ hiển thị 9,5% danh mục trong suốt 30 vòng và đạt 63% chất lượng tối đa. Vì dữ liệu vẫn trông tốt, cần theo dõi độ đa dạng của những gì được hiển thị. Ngẫu nhiên hoá, nhóm đối chứng, hiệu chỉnh theo xác suất hiển thị và đặc trưng vị trí là các cách khắc phục, trong đó nhóm đối chứng là cách đáng làm sớm nhất.
Mười hai chương đầu áp dụng cho mọi hệ thống học máy. Chương cuối xét một loại hệ thống đang phổ biến nhanh: ứng dụng dùng mô hình ngôn ngữ lớn, nơi nhiều giả định của các chương trước không còn đúng.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao vòng phản hồi thoái hoá khó phát hiện?
Vì sao: Các chỉ số ngoại tuyến tính trên dữ liệu log không cho thấy vấn đề, trong khi hệ thống chỉ còn hiển thị một phần nhỏ của danh mục.2Trong thí nghiệm ở Mục 12.3, hệ thống không ngẫu nhiên hoá hiển thị bao nhiêu phần danh mục?
Vì sao: Những món chưa từng được hiển thị có tỉ lệ nhấp quan sát bằng 0 nên không bao giờ vào danh sách. Hệ thống đạt chất lượng 0,351, khoảng 63% mức tối đa 0,555. Dành 30% vị trí cho món ngẫu nhiên nâng chất lượng lên 0,402 và tỉ lệ danh mục được hiển thị lên 13,4%.3Cách khắc phục nào vừa cung cấp dữ liệu không bị mô hình làm sai lệch, vừa cho thước đo đáng tin cậy về giá trị của hệ thống?
Vì sao: Cả bốn cách đều hợp lệ, nhưng nhóm đối chứng là cách duy nhất cho cả hai lợi ích cùng lúc.4Muốn dùng hiệu chỉnh theo xác suất hiển thị thì phải chuẩn bị gì trước?
Vì sao: Đây là loại quyết định phải đưa ra từ đầu, giống như việc lưu định danh các đoạn đã truy xuất trong hệ thống RAG (Mục 13.5).
Đã trả lời 0/4