MLOps: vận hành hệ thống học máy
Toàn bộ giáo trình trên một trang — tiện cho Ctrl+F, đọc ngoại tuyến hoặc in ra giấy.
Giáo trình 6 của lộ trình
Các giáo trình trước dừng lại khi mô hình đạt kết quả tốt trên tập kiểm tra. Giáo trình này bắt đầu từ chỗ đó: mô hình được đưa vào một hệ thống thật, nhận dữ liệu thật, và phải tiếp tục làm việc đúng trong khi dữ liệu, người dùng và các hệ thống xung quanh thay đổi. Nội dung đi theo trình tự một mô hình đi qua trong đời sống của nó: chuẩn bị dữ liệu và đặc trưng, huấn luyện sao cho lặp lại được, đánh giá trước khi triển khai, phục vụ và ra mắt, theo dõi khi đang chạy, huấn luyện lại, và cuối cùng là những điều thay đổi khi hệ thống dùng mô hình ngôn ngữ lớn.
Kiến thức cần có. Cách huấn luyện và đánh giá một mô hình có giám sát (Nền tảng), kiểm định giả thuyết ở mức cơ bản, và đọc được mã Python. Không cần biết trước công cụ MLOps nào. Tên công cụ thay đổi nhanh, còn những vấn đề mà công cụ sinh ra để giải quyết thì gần như giữ nguyên, nên giáo trình tập trung vào các vấn đề đó.
Về số liệu. Các con số trong giáo trình có hai nguồn. Một phần lấy từ bài báo và tài liệu gốc, có ghi nguồn tại chỗ và trong Chương 16. Phần còn lại được đo bằng mô phỏng trong chính repo này:
code/mlops/experiments.pysinh số liệu trong bài,code/mlops/bai_tap.pysinh số liệu trong lời giải bài tập, cả hai đặt hạt giống cố định nên chạy lại cho kết quả y hệt. Những chỗ chỉ là kinh nghiệm của ngành, chưa có cơ sở đo đạc, được ghi rõ là quy tắc kinh nghiệm.
0Ký hiệu và quy ước#
0.1Ký hiệu#
Phần lớn giáo trình được viết bằng lời, nhưng một số chương dùng ký hiệu xác suất và thống kê. Bảng dưới liệt kê các ký hiệu đó.
| Ký hiệu | Ý nghĩa |
|---|---|
| đặc trưng đầu vào | |
| nhãn, biến mục tiêu | |
| phân phối của đầu vào | |
| quan hệ giữa đầu vào và nhãn, tức điều mô hình học | |
| dự đoán của mô hình | |
| , | thời điểm; thời điểm phải đưa ra dự đoán |
| cỡ mẫu | |
| số bin (Chương 9) hoặc số dịch vụ gọi song song (Chương 7) | |
| p50, p95, p99 | phân vị 50, 95, 99 của độ trễ |
| SLI, SLO | chỉ số mức dịch vụ, mục tiêu mức dịch vụ |
| CI, CD, CT | tích hợp liên tục, bàn giao liên tục, huấn luyện liên tục |
| PSI | population stability index, một đại lượng đo mức thay đổi của phân phối |
0.2Thuật ngữ#
Nhiều thuật ngữ của MLOps chưa có cách dịch thống nhất. Giáo trình dùng các cách gọi dưới đây; tên tiếng Anh được giữ cho những khái niệm mà người làm nghề ở Việt Nam vẫn gọi bằng tiếng Anh.
| Tiếng Anh | Dùng trong giáo trình |
|---|---|
| production | môi trường sản xuất, tức môi trường vận hành thật |
| deployment, rollout | triển khai, ra mắt |
| serving | phục vụ (mô hình) |
| latency, throughput | độ trễ, thông lượng |
| distribution shift, drift | dịch chuyển phân phối |
| covariate shift, label shift, concept drift | giữ nguyên tiếng Anh |
| training–serving skew | lệch giữa huấn luyện và phục vụ |
| data leakage | rò rỉ dữ liệu |
| point-in-time correctness | tính đúng theo thời điểm |
| feature store | kho đặc trưng |
| model registry | sổ đăng ký mô hình |
| shadow, canary, A/B test, blue–green | giữ nguyên tiếng Anh |
| monitoring, alerting | giám sát, cảnh báo |
| feedback loop | vòng phản hồi |
| technical debt | nợ kỹ thuật |
| guardrail | rào chắn |
Bảng đối chiếu đầy đủ, kèm định nghĩa ngắn của từng thuật ngữ, nằm ở trang Từ điển thuật ngữ.
1Nợ kỹ thuật trong hệ thống học máy#
1.1Đặt vấn đề#
Ở các giáo trình trước, mỗi bài toán khép lại khi mô hình đạt kết quả tốt trên tập kiểm tra. Trong một sản phẩm thật, đó mới là điểm bắt đầu. Mô hình được đặt vào một hệ thống lớn hơn: nó nhận dữ liệu từ các hệ thống khác, trả kết quả cho người dùng hoặc cho các dịch vụ khác, và phải tiếp tục làm việc đúng trong nhiều tháng, nhiều năm, trong khi mọi thứ xung quanh nó thay đổi.
Hãy hình dung một mô hình phát hiện gian lận đạt AUC 0,94 trên tập kiểm tra. Sáu tháng sau khi triển khai, dịch vụ vẫn chạy bình thường: không có lỗi nào trong log, độ trễ ổn định, không ai phàn nàn. Nhưng số tiền thiệt hại do gian lận tăng dần, và khi kiểm tra lại, độ chính xác của mô hình trên dữ liệu mới thấp hơn nhiều so với lúc đánh giá. Không ai sửa dòng mã nào; thứ đã thay đổi là dữ liệu đi vào mô hình.
Với phần mềm thông thường, sự cố thường lộ ra ngay. Một hàm nhận sai kiểu dữ liệu sẽ báo lỗi, và hệ thống giám sát phát hiện được lỗi đó. Mô hình học máy thì khác: khi đầu vào thay đổi, nó vẫn trả về một con số trong khoảng , đúng định dạng, đúng thời hạn, chỉ có điều con số ấy sai. Các cơ chế kiểm tra của phần mềm thông thường không được thiết kế để nhận ra loại lỗi này. Vì vậy vận hành một hệ thống học máy cần thêm những kỹ thuật riêng, và tập hợp các kỹ thuật đó được gọi là MLOps. Để hiểu vì sao cần chúng, ta bắt đầu từ một câu hỏi rộng hơn: vì sao hệ thống học máy khó bảo trì hơn phần mềm thông thường.
1.2Khái niệm nợ kỹ thuật#
Câu trả lời được biết đến nhiều nhất là bài báo Hidden Technical Debt in Machine Learning Systems của Sculley và cộng sự (2015), một nhóm kỹ sư ở Google. Nhận xét chính của bài báo là: xây dựng và triển khai một hệ thống học máy tương đối nhanh và rẻ, nhưng duy trì nó theo thời gian thì khó và tốn kém.
Để diễn đạt điều này, các tác giả mượn khái niệm nợ kỹ thuật (technical debt) mà Ward Cunningham đưa ra từ đầu những năm 1990. Khi một nhóm phát triển chọn cách làm nhanh thay vì cách làm kỹ, họ giống như vay nợ: được lợi ngay, nhưng sau này phải trả lãi dưới dạng thời gian sửa lỗi và thời gian thay đổi hệ thống. Vay nợ không phải lúc nào cũng sai, miễn là biết mình đang nợ và có kế hoạch trả. Điểm riêng của hệ thống học máy, theo Sculley và cộng sự, là phần lớn khoản nợ nằm ở mức hệ thống chứ không nằm trong mã nguồn. Đọc mã không thấy được chúng, nên lãi cứ tích luỹ mà không ai nhận ra.
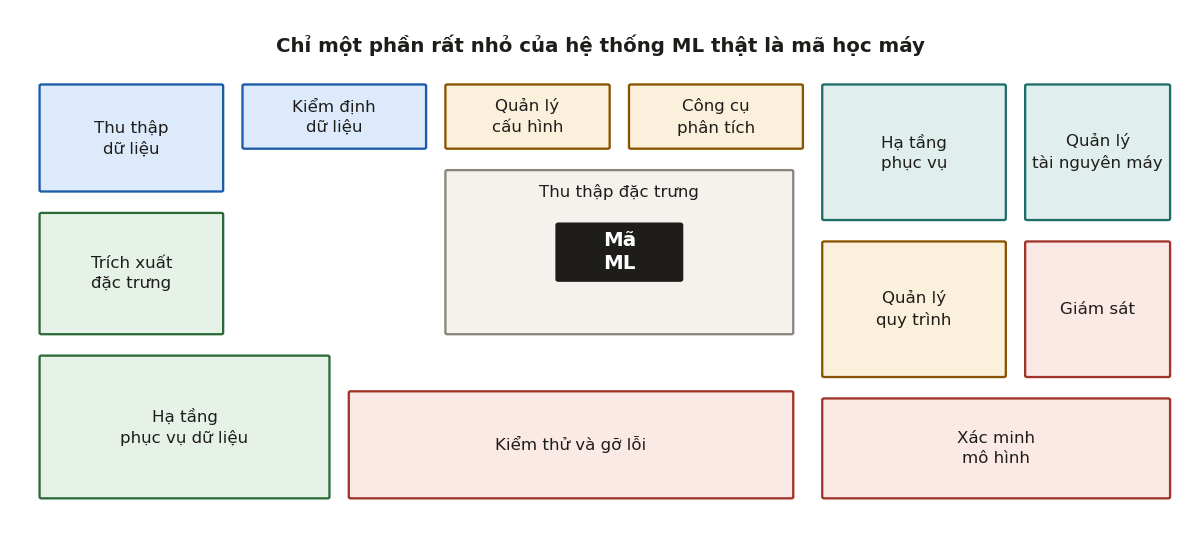
Hình 1 tóm tắt quan điểm đó. Khi học, ta dành gần hết thời gian cho ô ở giữa: chọn mô hình, chọn hàm mất mát, tinh chỉnh siêu tham số. Trong một hệ thống thật, ô đó được bao quanh bởi rất nhiều thành phần khác, và phần lớn sự cố xảy ra ở các thành phần ấy hoặc ở chỗ chúng tiếp xúc với mô hình.
1.3Nguyên lý CACE#
Nguồn nợ đầu tiên mà bài báo chỉ ra nằm ngay trong bản chất của mô hình học máy.
Định nghĩa 1.1 (CACE)
Nguyên lý CACE (Changing Anything Changes Everything) phát biểu rằng trong một hệ thống học máy, thay đổi bất kỳ thành phần nào cũng có thể thay đổi hành vi của toàn bộ hệ thống.
Để thấy vì sao, xét một mô hình hồi quy tuyến tính dự đoán giá nhà từ diện tích và số phòng. Hai đặc trưng này tương quan với nhau, nên trọng số mà mô hình học được cho diện tích phụ thuộc vào việc số phòng có mặt trong mô hình hay không: có số phòng, một phần thông tin về độ lớn của căn nhà đã nằm ở đó và trọng số của diện tích nhỏ đi; bỏ số phòng, trọng số của diện tích phải gánh cả phần ấy. Như vậy thêm hoặc bớt một đặc trưng làm thay đổi trọng số của mọi đặc trưng còn lại, chứ không chỉ thêm hoặc bớt một thành phần. Bài báo nhấn mạnh rằng điều này đúng cho mọi thứ điều chỉnh được: siêu tham số, cách lấy mẫu dữ liệu, ngưỡng hội tụ của thuật toán tối ưu.
Hệ quả là trong học máy không có thay đổi nào thật sự nhỏ và cô lập. Một kỹ sư phần mềm có thể sửa một hàm mà không cần kiểm tra lại toàn bộ chương trình, vì các hàm khác chỉ phụ thuộc vào giao diện của nó. Với một mô hình, mọi thay đổi đều cần được đánh giá lại trên toàn bộ dữ liệu. Mục 6.3 sẽ cho một ví dụ đo được: thêm một đặc trưng làm độ chính xác tổng thể tăng gần 20 điểm phần trăm, nhưng lại làm một nhóm người dùng giảm gần 12 điểm. Bài báo đề xuất một cách giảm nhẹ là tách bài toán thành các bài toán con độc lập, mỗi bài toán một mô hình riêng; cách này chỉ dùng được khi các bài toán con thật sự tách rời nhau.
1.4Các dạng nợ kỹ thuật#
Ngoài CACE, Sculley và cộng sự đặt tên cho nhiều dạng nợ khác. Có thể chia chúng thành ba nhóm theo nơi phát sinh. Riêng vòng phản hồi, một dạng nợ quan trọng mà bài báo cũng nêu, được dành hẳn Chương 12.
Nợ do mô hình làm mờ ranh giới giữa các thành phần. Trong phần mềm thông thường, các thành phần giao tiếp qua những giao diện rõ ràng. Mô hình học máy làm mờ các ranh giới này theo nhiều cách. Ngoài sự rối giữa các đặc trưng mà CACE mô tả (entanglement), còn có hiện tượng thác hiệu chỉnh (correction cascade): đã có mô hình cho bài toán A, giờ cần giải bài toán A' gần giống, và cách nhanh nhất là học một mô hình nhỏ nhận đầu ra của rồi hiệu chỉnh thêm. Cách này nhanh, nhưng mô hình mới phụ thuộc vào , và từ đó việc cải thiện trở nên rất tốn kém vì có thể làm hỏng mô hình phía sau. Một dạng khác là bên sử dụng không khai báo (undeclared consumer): đầu ra của mô hình được ghi ra một nơi không có kiểm soát truy cập, và một hệ thống khác lặng lẽ dùng nó làm đầu vào. Khi mô hình thay đổi, hệ thống kia hỏng theo mà không ai biết nguyên nhân, và hai hệ thống có thể tạo thành một vòng phản hồi ẩn (Chương 12).
Nợ do phụ thuộc vào dữ liệu. Phụ thuộc giữa các đoạn mã có thể được trình biên dịch và các công cụ phân tích tĩnh phát hiện. Phụ thuộc vào dữ liệu thì không có công cụ tương đương, nên rất dễ tích tụ những chuỗi phụ thuộc mà không ai nắm hết. Bài báo nêu hai loại. Loại thứ nhất là phụ thuộc dữ liệu không ổn định (unstable data dependency): một đặc trưng được lấy từ hệ thống khác, và hệ thống đó thay đổi hành vi theo thời gian, chẳng hạn vì bản thân nó cũng là một mô hình được huấn luyện lại định kỳ. Cách xử lý là cố định phiên bản của tín hiệu đầu vào, với cái giá là phải duy trì nhiều phiên bản song song. Loại thứ hai là phụ thuộc dữ liệu ít giá trị (underutilized data dependency): những đặc trưng đóng góp rất ít nhưng vẫn nằm trong mô hình, làm hệ thống dễ hỏng một cách không cần thiết. Chúng thường là đặc trưng cũ đã bị đặc trưng mới thay thế nhưng không ai gỡ, đặc trưng được thêm cả gói vì áp lực thời hạn, đặc trưng chỉ cải thiện độ chính xác rất ít nhưng làm hệ thống phức tạp hơn nhiều, hoặc đặc trưng tương quan mạnh với một đặc trưng khác có quan hệ nhân quả thật. Để phát hiện chúng, bài báo đề xuất định kỳ đánh giá lại mô hình khi bỏ ra từng đặc trưng một (leave-one-feature-out).
Nợ trong kiến trúc, cấu hình và quy trình. Nhóm cuối cùng gần với nợ kỹ thuật của phần mềm thông thường nhất. Mã keo (glue code) là phần mã nối các thư viện đa dụng lại với nhau; Mục 1.5 sẽ quay lại với nó. Pipeline jungle là trường hợp riêng của mã keo ở khâu chuẩn bị dữ liệu: các bước lấy, ghép, lấy mẫu dữ liệu chồng chất qua thời gian, sinh ra nhiều tệp trung gian mà không ai còn nhớ hết mục đích. Các nhánh mã để thử nghiệm còn nằm lại trong mã sản xuất (dead experimental codepaths) làm tăng số trạng thái hệ thống có thể rơi vào. Cấu hình của một hệ thống lớn có thể gồm hàng nghìn dòng và thường ít được kiểm tra kỹ như mã, dù một dòng cấu hình sai gây hại không kém một dòng mã sai (configuration debt). Khó chạy lại một thí nghiệm và nhận được cùng kết quả là một dạng nợ riêng (reproducibility debt, Chương 5). Cuối cùng là nợ về văn hoá làm việc: khi nhóm nghiên cứu và nhóm kỹ thuật tách biệt, hoặc khi chỉ việc tăng độ chính xác được ghi nhận còn việc gỡ bớt đặc trưng, đơn giản hoá hệ thống, cải thiện giám sát thì không.
Bài báo còn nhắc tới vài dấu hiệu trong mã cho thấy hệ thống đang tích nợ. Một là dùng kiểu dữ liệu nguyên thuỷ như số thực cho những đại lượng giàu ý nghĩa, khiến không biết một tham số là log-odds hay là ngưỡng quyết định. Hai là dùng nhiều ngôn ngữ lập trình trong cùng một hệ thống, làm việc kiểm thử và bàn giao khó hơn. Ba là thường xuyên phải thử ý tưởng trên một bản nguyên mẫu thay vì trên hệ thống thật, dấu hiệu cho thấy hệ thống thật khó thay đổi.
1.5Tỉ lệ mã học máy trong hệ thống#
Từ bài báo này có một con số rất hay được trích dẫn: trong một hệ thống học máy, mã học máy chỉ chiếm 5%, còn 95% là mã keo. Con số này thường bị hiểu sai ở ba điểm.
Thứ nhất, nó nằm trong mục bàn về mã keo của bài báo, nói về những hệ thống tái sử dụng các thư viện học máy đa dụng, chứ không phải chú thích của hình vẽ nổi tiếng (Hình 1). Thứ hai, bài báo diễn đạt có giới hạn: một hệ thống trưởng thành có thể chỉ gồm nhiều nhất 5% mã học máy và ít nhất 95% mã keo. Đây là một nhận định định tính kèm độ lớn, không phải kết quả đo trên một tập hệ thống cụ thể. Thứ ba, ít người nhắc tới kết luận mà bài báo rút ra từ đó: vì tỉ lệ này, đôi khi tự viết một giải pháp gọn còn rẻ hơn dùng lại một thư viện đa dụng, và cách hạn chế mã keo là bọc các thư viện sau một giao diện chung của hệ thống.
1.6Tóm tắt#
Hệ thống học máy hỏng theo cách khó thấy hơn phần mềm thông thường, vì mô hình vẫn trả về kết quả hợp lệ khi đầu vào đã thay đổi. Sculley và cộng sự mô tả nguồn gốc của các sự cố đó bằng khái niệm nợ kỹ thuật: nguyên lý CACE khiến mọi thay đổi đều phải đánh giá lại toàn bộ, phụ thuộc vào dữ liệu khó kiểm soát hơn phụ thuộc vào mã, và phần lớn hệ thống là mã keo bao quanh một mô hình nhỏ.
Quay lại mô hình phát hiện gian lận ở Mục 1.1, ta đã có tên cho những nguyên nhân có thể khiến nó suy giảm. Một hệ thống phía trước đổi đơn vị tiền từ đồng sang nghìn đồng mà không báo trước là phụ thuộc dữ liệu không ổn định (Chương 3, Mục 10.4). Một đặc trưng được tính khác nhau lúc huấn luyện và lúc phục vụ là lệch huấn luyện–phục vụ (Chương 4). Phân phối dữ liệu thay đổi mà không ai đo là dịch chuyển phân phối (Chương 9). Một ngưỡng quyết định đặt bằng tay từ năm trước vẫn được dùng sau khi mô hình đã huấn luyện lại là ngưỡng cố định trong hệ thống thay đổi (Mục 10.6). Và mô hình làm sai lệch dữ liệu huấn luyện của chính nó là vòng phản hồi (Chương 12). Các chương sau lần lượt trình bày cách phát hiện và hạn chế từng nguyên nhân. Trước hết, Chương 2 nhìn toàn cảnh: một hệ thống học máy đi qua những giai đoạn nào, và mức độ tự động hoá của nó được đánh giá ra sao.
2Vòng đời của hệ thống học máy#
Chương 1 cho thấy mô hình chỉ là một phần nhỏ của hệ thống. Chương này nhìn vào các phần còn lại theo trình tự thời gian: một hệ thống học máy được xây dựng, đưa vào sử dụng và cải tiến như thế nào, những người vận hành nó đánh giá thành công ra sao, và quy trình đó được tự động hoá tới mức nào.
2.1Các giai đoạn của vòng đời#
Khi mô tả việc làm một sản phẩm học máy, người ta thường kể ba bước: thu thập dữ liệu, huấn luyện mô hình, triển khai. Cách kể này là một đường thẳng, và nó bỏ qua phần tốn công nhất. Trên thực tế, công việc đi theo vòng lặp với nhiều đường quay lại: kết quả đánh giá cho thấy cần thêm dữ liệu, việc giám sát trong sản xuất cho thấy cần huấn luyện lại, một sự cố cho thấy một đặc trưng đang được tính sai.
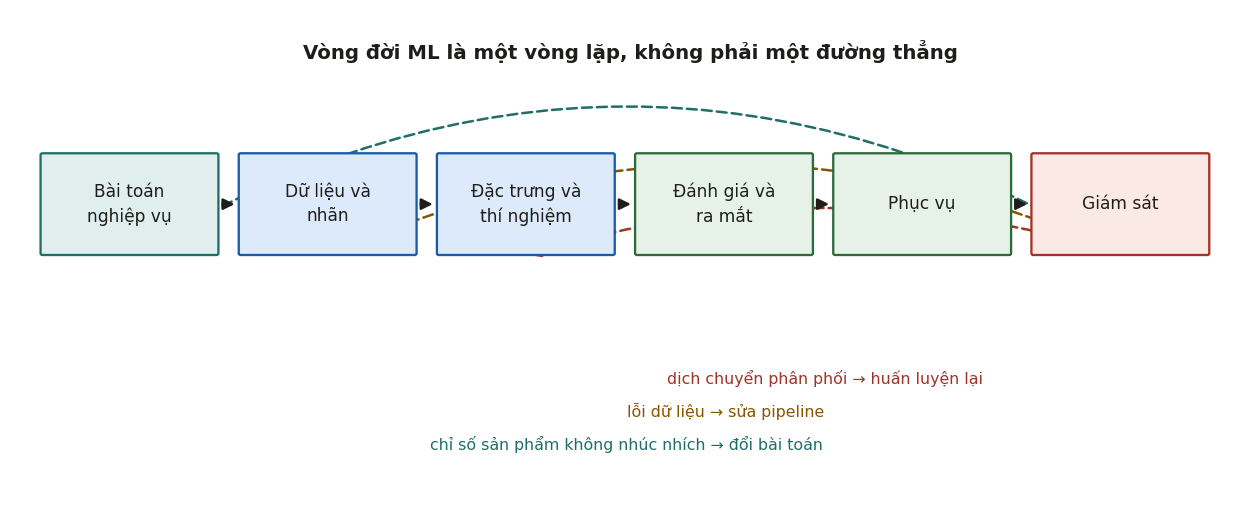
Shankar và cộng sự (2022) phỏng vấn 18 kỹ sư học máy đang vận hành hệ thống thật ở nhiều công ty, và gom công việc của họ thành bốn nhiệm vụ. Nhiệm vụ đầu tiên là thu thập và gán nhãn dữ liệu: tìm nguồn dữ liệu, đưa về một kho tập trung, làm sạch và gán nhãn. Nhiệm vụ thứ hai là tạo đặc trưng và thí nghiệm với mô hình, bằng cách thay đổi dữ liệu hoặc thay đổi mô hình để cải thiện một chỉ số. Nhiệm vụ thứ ba là đánh giá và triển khai: so sánh mô hình mới với mô hình đang chạy, rồi đưa thay đổi ra dần cho người dùng. Nhiệm vụ thứ tư là giám sát pipeline trong sản xuất và xử lý khi chất lượng suy giảm. Các chương của giáo trình này đi theo đúng bốn nhiệm vụ đó.
2.2Tốc độ, kiểm định và phiên bản#
Từ các cuộc phỏng vấn, Shankar và cộng sự rút ra ba yếu tố quyết định việc đưa mô hình vào sản xuất có thành công hay không. Các tác giả gọi chúng là ba chữ V: velocity, validation và versioning.
Yếu tố thứ nhất là tốc độ (velocity). Học máy mang tính thực nghiệm: không ai biết trước một ý tưởng có tác dụng hay không cho tới khi thử. Vì vậy năng suất của một nhóm phụ thuộc vào việc họ thử được bao nhiêu ý tưởng trong một khoảng thời gian. Các kỹ sư được phỏng vấn mong muốn đi được từ một ý tưởng mới tới một mô hình đã huấn luyện trong vòng một ngày.
Yếu tố thứ hai là kiểm định (validation): kiểm tra thay đổi, loại bỏ ý tưởng kém và phát hiện lỗi càng sớm càng tốt. Lỗi càng được phát hiện muộn thì càng tốn kém, và tốn kém nhất là khi người dùng đã nhìn thấy nó.
Yếu tố thứ ba là phiên bản (versioning): lưu và quản lý nhiều phiên bản của mô hình và dữ liệu. Không ai lường trước được mọi lỗi, nên khi lỗi xảy ra phải quay lại được phiên bản trước.
Thoạt nhìn, tốc độ và kiểm định kéo về hai phía: thêm một bước kiểm định thì quy trình chậm đi. Nhưng chúng cũng hỗ trợ nhau, vì loại được một ý tưởng kém ở giai đoạn sớm thì không tốn thời gian đưa nó qua các giai đoạn sau. Câu hỏi thực sự không phải là kiểm định nhiều hay ít, mà là đặt các bước kiểm định ở đâu trong quy trình.
2.3Các mức tự động hoá#
Một quy trình học máy có thể được tự động hoá tới những mức khác nhau. Kiến trúc tham chiếu được trích dẫn nhiều nhất là tài liệu MLOps: Continuous delivery and automation pipelines in machine learning của Google Cloud, chia thành ba mức.
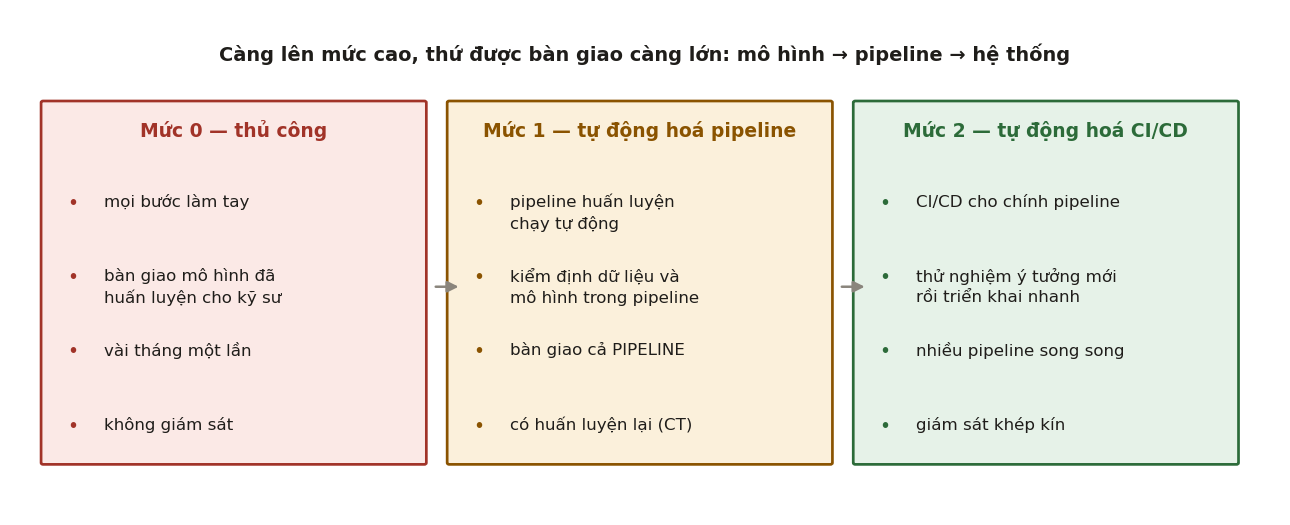
Ở mức 0, mọi bước đều làm bằng tay, từ phân tích và chuẩn bị dữ liệu tới huấn luyện và kiểm định. Nhóm khoa học dữ liệu huấn luyện mô hình rồi bàn giao tệp mô hình cho nhóm kỹ thuật triển khai; hai nhóm làm việc tách rời. Mô hình ít khi được cập nhật và thường không được theo dõi sau khi triển khai. Đây là trạng thái của phần lớn dự án học máy ở giai đoạn đầu.
Ở mức 1, toàn bộ pipeline huấn luyện được tự động hoá, nên mô hình có thể được huấn luyện lại trên dữ liệu mới mà không cần người làm từng bước. Pipeline có các bước kiểm định dữ liệu và kiểm định mô hình tự động. Thay đổi quan trọng nhất so với mức 0 là thứ được triển khai: không còn là một mô hình, mà là cả pipeline sinh ra mô hình.
Ở mức 2, bản thân pipeline cũng có hệ thống CI/CD, để các ý tưởng mới được kiểm thử và đưa vào sản xuất nhanh chóng. Tài liệu của Google chia mức này thành sáu giai đoạn: phát triển và thí nghiệm, tích hợp liên tục cho pipeline, bàn giao liên tục cho pipeline, kích hoạt tự động, bàn giao liên tục cho mô hình, và giám sát.
Cũng tài liệu đó liệt kê tám bước của một pipeline học máy: trích xuất dữ liệu, phân tích dữ liệu, chuẩn bị dữ liệu, huấn luyện, đánh giá mô hình, kiểm định mô hình, phục vụ và giám sát. Việc đánh giá và kiểm định được tách thành hai bước riêng có lý do, và Mục 11.4 sẽ trình bày lý do đó.
2.4Huấn luyện liên tục#
Trong phần mềm thông thường, hệ thống chỉ thay đổi khi có người sửa mã, và CI/CD được xây dựng quanh sự thay đổi đó: mỗi lần mã thay đổi thì kiểm thử, đóng gói và triển khai lại. Hệ thống học máy có thêm một nguồn thay đổi không đi qua kho mã: thế giới bên ngoài thay đổi, dữ liệu thay đổi theo, và mô hình cũ dần đi dù không ai đụng vào nó. Vì vậy học máy cần thêm huấn luyện liên tục (continuous training, CT): tự động huấn luyện lại và triển khai lại mô hình, được kích hoạt bởi dữ liệu mới, bởi chất lượng suy giảm hoặc bởi dịch chuyển phân phối (Chương 11).
Cũng vì vậy, tạo tác (artifact) mà một hệ thống học máy phải quản lý gồm ba thứ thay đổi theo ba nhịp khác nhau: mã thay đổi khi có người sửa, dữ liệu thay đổi hằng ngày, còn mô hình thay đổi mỗi lần huấn luyện lại. Quản lý đồng thời cả ba nhịp là điều làm cho MLOps khác với DevOps.
2.5Một số thói quen cần tránh#
Shankar và cộng sự cũng ghi nhận bốn thói quen làm việc không tốt mà họ gặp lặp đi lặp lại. Thói quen thứ nhất là khoảng cách giữa những gì học ở trường và những vấn đề gặp khi vận hành: người mới phải học lại qua chính các sự cố, trong khi phần lớn kiến thức đó có thể được truyền lại bằng tài liệu và quy trình. Thói quen thứ hai mà các tác giả gọi là "giữ cho GPU luôn nóng" (keeping GPUs warm): chạy càng nhiều thí nghiệm càng tốt để không lãng phí tài nguyên tính toán. Nghe như một cách làm việc hiệu quả, nhưng nó nhầm về thứ cần tiết kiệm. Tài nguyên khan hiếm thường không phải là GPU, mà là số giả thuyết đáng thử và thời gian của con người để đọc, hiểu kết quả; thí nghiệm không có giả thuyết rõ ràng tạo ra nhiều kết quả khó diễn giải và nhiều phiên bản phải quản lý.
Thói quen thứ ba là giải thích sau khi đã thấy kết quả (retrofitting an explanation): thấy một thay đổi cho kết quả tốt, đưa vào sản xuất, rồi mới đi tìm lý do vì sao nó tốt. Lời giải thích dựng lên sau có thể sai, và dễ dẫn các quyết định tiếp theo đi sai hướng. Thói quen thứ tư là hiểu biết về hệ thống chỉ nằm trong đầu vài người (undocumented tribal knowledge); khi họ rời nhóm, hiểu biết đó mất theo.
2.6Tóm tắt#
Vòng đời của một hệ thống học máy là một vòng lặp gồm bốn nhiệm vụ: thu thập dữ liệu, thí nghiệm, đánh giá và triển khai, giám sát. Theo các kỹ sư đang vận hành hệ thống thật, thành công phụ thuộc vào tốc độ thử nghiệm, việc kiểm định sớm và khả năng quay lại phiên bản cũ. Quy trình có thể được tự động hoá từ mức thủ công hoàn toàn tới mức có CI/CD cho cả pipeline, và khác với phần mềm thông thường, nó cần thêm huấn luyện liên tục vì dữ liệu thay đổi mà không đi qua kho mã.
Nhiệm vụ đầu tiên của vòng lặp là dữ liệu, và đó cũng là nơi phát sinh nhiều sự cố nhất. Chương 3 bắt đầu từ đây.
3Dữ liệu#
Khi một mô hình hoạt động không như mong đợi, phản xạ tự nhiên của người học là xem lại mô hình: thử kiến trúc khác, chỉnh siêu tham số. Người vận hành hệ thống lâu năm thường làm ngược lại: họ xem dữ liệu trước. Chương này giải thích vì sao, phân loại các lỗi dữ liệu thường gặp, và trình bày cách biến những giả định ngầm về dữ liệu thành các phép kiểm tra tự động.
3.1Vai trò của dữ liệu#
Trong nghiên cứu phỏng vấn của Shankar và cộng sự, nhiều kỹ sư cho biết họ cải thiện hệ thống bằng cách thay đổi dữ liệu thường xuyên hơn là thay đổi mô hình. Điều này khớp với một quy tắc kinh nghiệm đã nêu ở Mục 1.3 của Học sâu: với cùng công sức, sửa dữ liệu và nhãn thường cải thiện kết quả nhiều hơn đổi kiến trúc.
Có một lý do khác khiến dữ liệu cần được chú ý đặc biệt: lỗi dữ liệu thường không làm chương trình báo lỗi. Một cột bị đổi đơn vị hay một nguồn dữ liệu bị thiếu một nửa số dòng vẫn cho ra một bảng hợp lệ, mô hình vẫn chạy, và chỉ có kết quả là sai. Những lỗi như vậy chỉ được phát hiện khi có người chủ động kiểm tra.
3.2Phân loại lỗi dữ liệu#
Không phải lỗi dữ liệu nào cũng giống nhau, và cách phản ứng phù hợp với lỗi này có thể là sai với lỗi khác. Shankar và cộng sự phân biệt ba loại, xếp từ dễ thấy tới khó thấy.
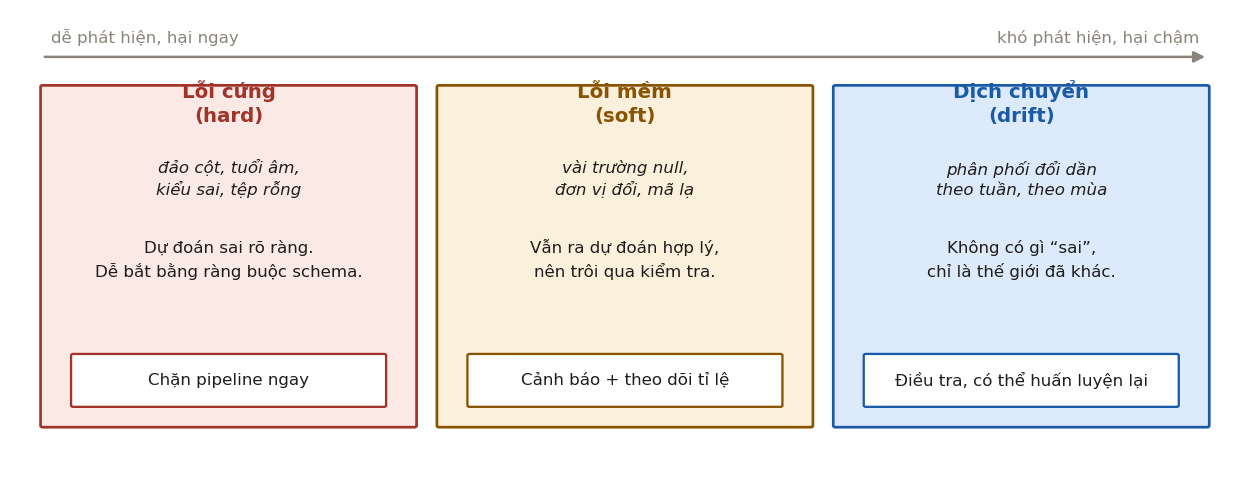
Lỗi cứng (hard error) là lỗi vi phạm một ràng buộc kiểm tra được: hai cột bị đảo chỗ, tuổi mang giá trị âm, sai kiểu dữ liệu, một tệp rỗng. Dự đoán dựa trên dữ liệu như vậy sai một cách rõ ràng, nên cách xử lý đúng là dừng pipeline lại; không có dự đoán còn hơn có một dự đoán sai.
Lỗi mềm (soft error) khó thấy hơn: một số trường bị thiếu, một cột đổi đơn vị tính, xuất hiện một giá trị danh mục chưa từng gặp. Dự đoán vẫn trông hợp lý nên vượt qua các phép kiểm tra đơn giản, và mức độ ảnh hưởng khó định lượng. Với loại lỗi này, dừng pipeline thường là phản ứng quá mạnh; cách hợp lý hơn là cảnh báo và theo dõi tỉ lệ dữ liệu bị ảnh hưởng.
Dịch chuyển (drift) là khi dữ liệu thay đổi dần theo thời gian, theo tuần hay theo mùa. Về mặt kỹ thuật không có gì sai cả; chỉ là thế giới đã khác so với lúc huấn luyện. Phản ứng phù hợp là điều tra nguyên nhân và có thể phải huấn luyện lại mô hình (Chương 9 và 11).
Những người được phỏng vấn cho biết hai khó khăn quanh việc kiểm tra dữ liệu. Khó khăn thứ nhất là các ràng buộc chất lượng dữ liệu thường do người đặt bằng tay, và cách làm này không bền vững: người biết vì sao một ngưỡng là 0,3 có thể rời công ty, còn ngưỡng thì ở lại. Khó khăn thứ hai, được nhắc tới nhiều nhất, là báo động giả: cảnh báo kích hoạt trong khi chất lượng của mô hình vẫn ổn. Khi báo động giả xảy ra thường xuyên, người vận hành mất niềm tin vào cảnh báo và bỏ qua cả những cảnh báo về sự cố thật (Mục 10.5). Một nguyên nhân phổ biến của báo động giả là dùng cùng một cơ chế phản ứng cho cả ba loại lỗi ở trên.
3.3Hợp đồng dữ liệu#
Với lỗi cứng, cách xử lý gốc rễ là viết ra những giả định về dữ liệu dưới dạng các ràng buộc mà máy kiểm tra được. Tập ràng buộc đó thường được gọi là hợp đồng dữ liệu (data contract), vì nó là thoả thuận giữa bên cung cấp dữ liệu và bên sử dụng. Một hợp đồng đầy đủ có bốn tầng ràng buộc, từ đơn giản tới phức tạp. Đoạn mã dưới đây minh hoạ cả bốn tầng cho một bảng giao dịch:
# Tầng 1: lược đồ (schema) - tên cột, kiểu, cột nào được phép thiếu
schema = {
    "user_id":    {"type": "int64",    "nullable": False},
    "amount_vnd": {"type": "float64",  "nullable": False},
    "country":    {"type": "category", "nullable": False},
    "event_time": {"type": "datetime", "nullable": False},
}

# Tầng 2: miền giá trị - ràng buộc trên từng giá trị
domain = {
    "amount_vnd": {"min": 0, "max": 5e9},
    "country":    {"allowed": {"VN", "SG", "TH", "ID"}},
}

# Tầng 3: thống kê - ràng buộc trên phân phối của cả lô
batch_stats = {
    "amount_vnd": {"null_rate_max": 0.001, "mean_shift_max_sigma": 3},
    "country":    {"new_category_rate_max": 0.005},
}

# Tầng 4: quan hệ giữa các cột và giữa các bảng
invariants = [
    "event_time <= ingest_time",       # không có sự kiện từ tương lai
    "refund_amount <= amount_vnd",
    "count(rows) between 0.7*d7_median and 1.4*d7_median",   # số dòng không hụt, không phình bất thường
]
Hai tầng đầu kiểm tra từng dòng dữ liệu, nên phát hiện được lỗi cứng; khi chúng bị vi phạm, pipeline nên dừng. Hai tầng sau kiểm tra cả lô dữ liệu và quan hệ giữa các bảng, nên phát hiện được phần lớn lỗi mềm; khi chúng bị vi phạm, cảnh báo thường là đủ. Ví dụ, ở tầng 4, mỗi dòng của một lô chỉ có một nửa số dòng bình thường vẫn hoàn toàn hợp lệ; chỉ khi so với các lô trước mới thấy thiếu dữ liệu.
Viết tay hàng trăm ràng buộc như vậy vừa tốn công vừa dễ sai. Cách làm phổ biến hơn là suy ra lược đồ và khoảng giá trị từ một tập dữ liệu tham chiếu đã được kiểm tra kỹ, rồi để người xem lại và chỉnh. Hợp đồng khi đó không phụ thuộc vào trí nhớ của một người cụ thể, giải quyết được khó khăn thứ nhất ở Mục 3.2. Các thư viện như TensorFlow Data Validation (Breck và cộng sự, 2019) và Great Expectations hỗ trợ cách làm này.
Ràng buộc "không có sự kiện từ tương lai" ở tầng 4 đáng được chú ý riêng. Nó là lớp phòng thủ đầu tiên chống lại rò rỉ dữ liệu theo thời gian, một lỗi khó phát hiện mà Chương 4 sẽ phân tích kỹ.
3.4Kiểm định tại ranh giới của pipeline#
Một thực hành được nhiều người phỏng vấn nhắc lại là kiểm định dữ liệu cả khi nó đi vào lẫn khi nó đi ra khỏi mỗi pipeline. Lý do nằm ở cách một pipeline nhiều bước hỏng. Nếu bước thứ ba tạo ra dữ liệu sai, bước thứ tư và thứ năm vẫn chạy bình thường trên dữ liệu sai đó, và chỉ khi nhìn vào kết quả cuối cùng mới thấy một con số bất thường. Lúc đó phải lần ngược qua từng bước để tìm nơi phát sinh lỗi, mất nhiều thời gian. Nếu mỗi bước kiểm tra đầu vào và đầu ra của mình, lỗi được phát hiện ngay tại bước gây ra nó.
Nguyên tắc này được mượn từ thiết kế hệ thống phân tán: phát hiện lỗi càng sớm càng tốt, báo lỗi rõ ràng, và đặt các phép kiểm tra tại ranh giới giữa các thành phần, nơi trách nhiệm chuyển từ nhóm này sang nhóm khác.
3.5Các vấn đề về nhãn#
Nhãn là phần dữ liệu ít được kiểm tra nhất, vì người ta thường mặc định nó đúng. Có ba vấn đề cần biết.
Vấn đề thứ nhất là độ trễ nhãn (label lag), tức khoảng thời gian từ lúc mô hình đưa ra dự đoán tới lúc biết đáp án thật. Với mô hình dự đoán người dùng có nhấp vào quảng cáo hay không, độ trễ chỉ vài phút. Với mô hình dự đoán một khoản vay có bị vỡ nợ hay không, độ trễ có thể là nhiều tháng hoặc nhiều năm. Độ trễ nhãn quyết định ta giám sát được gì (Chương 10) và huấn luyện lại được nhanh tới đâu (Chương 11). Mục 9.2 sẽ cho thấy nó còn quyết định ta có phát hiện được loại dịch chuyển gây hại nhiều nhất hay không.
Vấn đề thứ hai là nhãn có nhiễu, thể hiện qua việc những người gán nhãn không đồng ý với nhau. Mức đồng thuận giữa những người gán nhãn đặt ra giới hạn trên thực tế cho độ chính xác đo được. Nếu hai người gán nhãn chỉ đồng ý với nhau ở 90% số mẫu mà mô hình lại đạt 95% so với nhãn của một người, kết quả đó đáng nghi hơn là đáng mừng: có thể đã có rò rỉ dữ liệu, hoặc cách đo có vấn đề.
Vấn đề thứ ba là nhãn bị chính hệ thống làm sai lệch. Khi nhãn lấy từ hành vi của người dùng trên những kết quả mà mô hình đã chọn để hiển thị, nhãn đó không còn là quan sát khách quan về thế giới. Chương 12 sẽ phân tích hiện tượng này.
3.6Phiên bản hoá dữ liệu#
Yếu tố phiên bản ở Mục 2.2 áp dụng cho dữ liệu cũng như cho mô hình. Câu hỏi cần trả lời được bất cứ lúc nào là: mô hình đang chạy trong sản xuất được huấn luyện từ chính xác tập dữ liệu nào?
Có ba mức trả lời, chi phí tăng dần. Ở mức đơn giản nhất, ta ghi lại đường dẫn tới dữ liệu và thời điểm huấn luyện. Cách này chỉ cho biết dữ liệu nằm ở thư mục nào vào ngày nào, và vô dụng nếu thư mục đó đã bị ghi đè. Ở mức thứ hai, ta lưu mã băm (hash) của nội dung tập dữ liệu cùng với mô hình. Khi đó biết chắc một tập dữ liệu có phải đúng là tập đã dùng hay không, nhưng vẫn chưa dựng lại được nó nếu đã mất. Ở mức đầy đủ, dữ liệu được lưu theo kiểu bất biến, chỉ được thêm vào chứ không bị sửa (append-only), kèm theo ghi chép về nguồn gốc của từng tập (lineage). Khi đó dựng lại được đúng tập huấn luyện của bất kỳ mô hình nào trong quá khứ.
Mức đầy đủ tốn kém, nhưng nó là điều kiện để điều tra sự cố. Khi một mô hình hoạt động bất thường, câu hỏi đầu tiên thường là dữ liệu huấn luyện của nó có gì khác thường không. Nếu không dựng lại được tập dữ liệu đó, việc điều tra dừng lại ngay ở câu hỏi đầu tiên.
3.7Tóm tắt#
Lỗi dữ liệu là nguồn sự cố phổ biến nhất của hệ thống học máy, và chúng thường không làm chương trình báo lỗi. Có ba loại lỗi cần ba cách phản ứng khác nhau: dừng pipeline với lỗi cứng, cảnh báo với lỗi mềm, điều tra và huấn luyện lại với dịch chuyển. Hợp đồng dữ liệu bốn tầng biến các giả định về dữ liệu thành phép kiểm tra tự động, và các phép kiểm tra nên đặt ở ranh giới giữa các bước của pipeline. Nhãn cần được chú ý riêng vì độ trễ, độ nhiễu và việc bị chính hệ thống làm sai lệch, còn dữ liệu cần được quản lý phiên bản để điều tra được sự cố.
Dữ liệu sạch vẫn chưa đủ. Từ dữ liệu, ta tính ra đặc trưng, và chính bước này sinh ra hai lỗi khó phát hiện nhất trong học máy: đặc trưng lúc huấn luyện khác lúc phục vụ, và đặc trưng chứa thông tin từ tương lai. Đó là nội dung của Chương 4.
4Đặc trưng#
Một mô hình không học trực tiếp từ bảng dữ liệu gốc mà từ các đặc trưng được tính từ đó: tổng chi tiêu trong 30 ngày, số lần đăng nhập trong tuần, tỉ lệ đơn hàng bị huỷ. Việc tính đặc trưng nghe đơn giản, nhưng nó là nơi phát sinh hai lỗi khó phát hiện nhất của học máy. Cả hai đều có chung một đặc điểm: mô hình vẫn chạy, kết quả đánh giá vẫn tốt, và lỗi chỉ lộ ra khi mô hình đã phục vụ người dùng thật.
4.1Lệch giữa huấn luyện và phục vụ#
Xét đặc trưng "tổng chi tiêu trong 30 ngày qua" của một khách hàng. Khi chuẩn bị dữ liệu huấn luyện, nhóm khoa học dữ liệu tính nó bằng một truy vấn SQL trên kho dữ liệu. Khi đưa mô hình vào phục vụ, truy vấn đó quá chậm để chạy cho mỗi yêu cầu, nên nhóm kỹ thuật viết lại phép tính bằng Python trong dịch vụ phục vụ. Hai đoạn mã do hai người viết ở hai thời điểm, và rất hiếm khi chúng khớp nhau hoàn toàn: một bên tính 30 ngày theo lịch, bên kia tính 720 giờ tính lùi từ lúc có yêu cầu; một bên đã loại các giao dịch được hoàn tiền, bên kia thì chưa.
Hiện tượng đặc trưng lúc phục vụ khác với đặc trưng lúc huấn luyện được gọi là lệch giữa huấn luyện và phục vụ (training–serving skew). Tài liệu của Google Cloud định nghĩa nó đúng như vậy, và lưu ý rằng hậu quả là chất lượng mô hình giảm sau khi triển khai. Lỗi này không làm chương trình báo lỗi nào. Mô hình vẫn nhận đủ đặc trưng, chỉ có điều giá trị của chúng hơi khác so với những gì nó đã học, và độ chính xác mất đi vài điểm phần trăm mà không ai biết vì sao.
4.2Tính đúng theo thời điểm#
Lỗi thứ hai xảy ra ngay lúc dựng tập huấn luyện, trước khi mô hình được triển khai. Để hiểu nó, cần một khái niệm.
Định nghĩa 4.1 (Tính đúng theo thời điểm)
Một tập huấn luyện có tính đúng theo thời điểm (point-in-time correctness) nếu với mỗi dòng có thời điểm dự đoán , giá trị của mọi đặc trưng là giá trị quan sát được tại , không phải giá trị tại thời điểm dựng tập dữ liệu.
Định nghĩa nghe hiển nhiên: lúc dự đoán thật, mô hình chỉ biết những gì đã xảy ra trước đó, nên lúc huấn luyện cũng phải như vậy. Nhưng vi phạm nó rất dễ, vì cách viết truy vấn tự nhiên nhất lại cho kết quả sai.
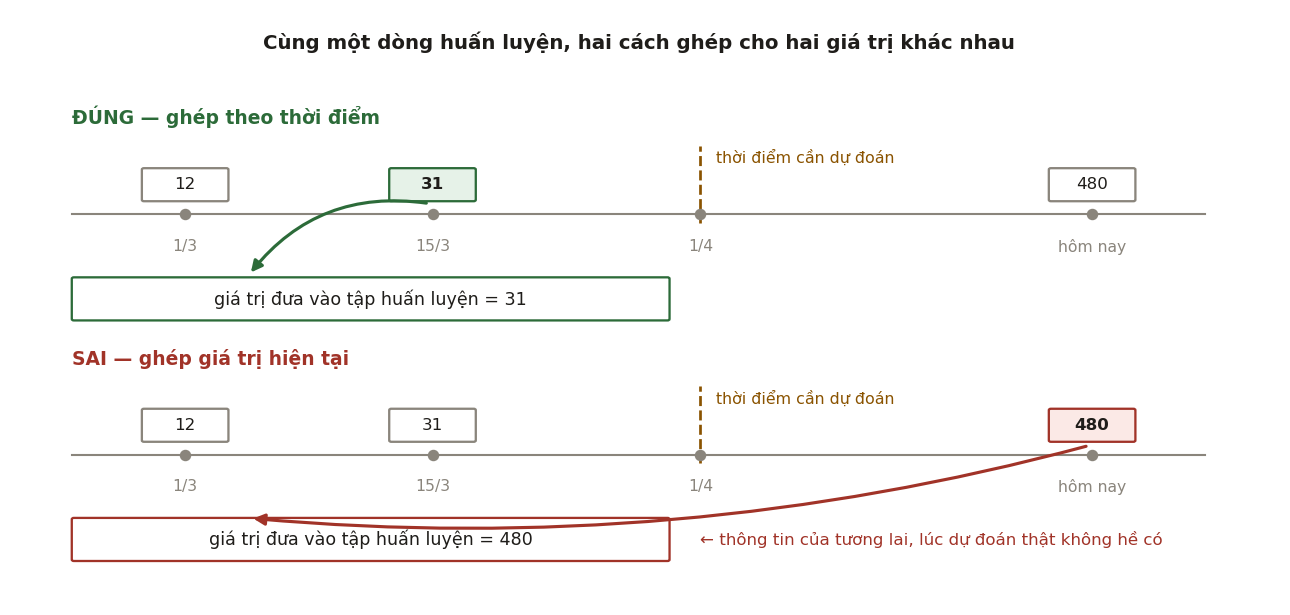
Giả sử ta có bảng nhãn (mỗi dòng là một khách hàng tại một thời điểm, kèm nhãn có rời bỏ dịch vụ hay không) và một bảng đặc trưng của khách hàng. Cách ghép hai bảng mà ai cũng viết đầu tiên là:
-- SAI: lấy giá trị đặc trưng HIỆN TẠI cho mọi dòng lịch sử
SELECT  l.user_id, l.event_time, l.label,
        f.total_orders                  -- giá trị của hôm nay
FROM    labels l
JOIN    user_features f ON f.user_id = l.user_id;
Truy vấn này đúng cú pháp và chạy nhanh, nhưng nó gán cho mọi dòng lịch sử giá trị đặc trưng của ngày hôm nay. Cách ghép đúng phải xét thêm trục thời gian: với mỗi dòng nhãn, lấy bản ghi đặc trưng mới nhất nhưng không muộn hơn thời điểm dự đoán của dòng đó. Phép ghép này được gọi là ghép theo thời điểm (point-in-time join hoặc as-of join):
-- ĐÚNG: ghép theo thời điểm (point-in-time join, as-of join)
SELECT  l.user_id, l.event_time, l.label, f.total_orders
FROM    labels l
LEFT JOIN LATERAL (
    SELECT total_orders
    FROM   user_features_history h
    WHERE  h.user_id    = l.user_id
      AND  h.valid_from <= l.event_time      -- chỉ nhìn về quá khứ
    ORDER BY h.valid_from DESC
    LIMIT 1
) f ON TRUE;
Điều làm lỗi này nguy hiểm là nó không làm kết quả đánh giá xấu đi mà làm chúng tốt lên. Với truy vấn sai, mô hình học được rằng khách hàng có 480 đơn hàng thì không rời bỏ dịch vụ. Quan hệ đó có thật trong dữ liệu, nhưng con số 480 chỉ tồn tại vì khách hàng đã ở lại. Khi dự đoán thật cho một khách hàng vào tháng 3, con số mô hình nhận được là 12 hoặc 31, không phải 480, và mô hình hoạt động kém hơn hẳn so với lúc đánh giá. Vì kết quả ngoại tuyến tốt nên không ai nghi ngờ trước khi triển khai. Shankar và cộng sự ghi nhận đúng điều này: rò rỉ dữ liệu, tức giả định lúc huấn luyện rằng có những dữ liệu mà lúc phục vụ không có, thường chỉ bị phát hiện sau khi mô hình đã được triển khai và đã đưa ra một số dự đoán sai. Mục 8.5 của Nền tảng trình bày các dạng rò rỉ khi chia dữ liệu huấn luyện và kiểm tra.
4.3Các dạng rò rỉ dữ liệu#
Rò rỉ theo thời gian như ở Mục 4.2 là dạng phổ biến nhất, nhưng không phải dạng duy nhất. Có thể phân biệt ba dạng, xếp theo mức độ khó phát hiện tăng dần.
Dạng thứ nhất là rò rỉ theo thời gian vừa trình bày. Cách phòng là ghép theo thời điểm, cộng với ràng buộc "không có sự kiện từ tương lai" trong hợp đồng dữ liệu (Mục 3.3).
Dạng thứ hai là rò rỉ theo thực thể. Khi chia dữ liệu ngẫu nhiên theo dòng, cùng một người dùng có thể có dữ liệu ở cả tập huấn luyện lẫn tập kiểm tra, và mô hình được kiểm tra trên chính những người nó đã thấy. Kết quả kiểm tra khi đó đánh giá quá cao khả năng của mô hình với người dùng mới. Cách phòng là chia theo nhóm thực thể (mỗi người dùng nằm trọn trong một tập), và với dữ liệu có yếu tố thời gian thì chia theo thời gian.
Dạng thứ ba khó nhất: đặc trưng là hệ quả của nhãn. Ví dụ, khi dự đoán một khách hàng có gặp sự cố với dịch vụ hay không, đặc trưng "số lần gọi tổng đài trong tuần" có thể rất mạnh, vì người gặp sự cố thì gọi tổng đài. Về mặt thời gian, đặc trưng này có thể hợp lệ, nhưng nó là hậu quả của điều cần dự đoán chứ không phải nguyên nhân, và vào lúc cần dự đoán (trước khi khách gọi) nó chưa tồn tại. Không phép kiểm tra tự động nào phát hiện được dạng rò rỉ này. Cách duy nhất là xem xét từng đặc trưng với hai câu hỏi: tại thời điểm cần dự đoán, giá trị này đã tồn tại chưa, và nó có tồn tại chỉ vì nhãn hay không.
4.4Kho đặc trưng#
Cả hai lỗi ở đầu chương đều liên quan tới việc đặc trưng được tính ở nhiều nơi khác nhau và không lưu lịch sử. Kho đặc trưng (feature store) là lớp hạ tầng được xây dựng để giải quyết chúng. Một kho đặc trưng thường gồm ba thành phần.
Thành phần thứ nhất là kho ngoại tuyến (offline store), lưu toàn bộ lịch sử giá trị của các đặc trưng kèm thời điểm có hiệu lực. Nó cần thông lượng cao và hỗ trợ ghép theo thời điểm trên dữ liệu lớn, để dựng tập huấn luyện đúng như Mục 4.2. Thành phần thứ hai là kho trực tuyến (online store), chỉ lưu giá trị mới nhất của mỗi thực thể và trả về trong vài mili giây khi tra theo khoá, để phục vụ các yêu cầu dự đoán. Thành phần thứ ba là sổ đăng ký đặc trưng (feature registry), nơi mỗi đặc trưng có một định nghĩa duy nhất, dùng chung cho cả hai kho.
Sổ đăng ký là thành phần quan trọng nhất, vì nó giải quyết lệch huấn luyện–phục vụ bằng cách buộc hai đường huấn luyện và phục vụ dùng chung một định nghĩa thay vì hai bản cài đặt. Kho ngoại tuyến giải quyết rò rỉ theo thời gian bằng cách giữ lịch sử để ghép được theo thời điểm.
Cần lưu ý rằng kho đặc trưng chỉ tạo điều kiện chứ không tự động loại bỏ lệch huấn luyện–phục vụ. Nếu vì lý do độ trễ mà nhóm vẫn viết một đường tính riêng cho phục vụ, sự lệch sẽ quay lại. Các công cụ khác nhau ở điểm này: có công cụ chỉ cung cấp hạ tầng lưu trữ và để nhóm tự giữ kỷ luật, có công cụ buộc mọi đặc trưng phải đi qua một định nghĩa duy nhất.
4.5Phạm vi áp dụng của kho đặc trưng#
Kho đặc trưng là một hạ tầng phức tạp, và không phải hệ thống nào cũng cần. Nó chỉ đáng đầu tư khi có đồng thời ba điều kiện. Điều kiện thứ nhất là có nhiều mô hình dùng chung đặc trưng; với một mô hình duy nhất, lợi ích tái sử dụng gần như bằng không. Điều kiện thứ hai là phải phục vụ trực tuyến với độ trễ thấp; nếu chỉ chấm điểm theo lô mỗi đêm, đọc thẳng từ kho dữ liệu là đủ. Điều kiện thứ ba là đặc trưng phụ thuộc thời gian và được cập nhật thường xuyên; nếu đặc trưng gần như cố định, vấn đề ghép theo thời điểm không còn nữa.
Khi thiếu các điều kiện đó, một bảng trong kho dữ liệu cộng với kỷ luật dùng chung một hàm biến đổi đặc trưng cho cả huấn luyện lẫn phục vụ đạt cùng mục tiêu với chi phí thấp hơn nhiều.
4.6Tóm tắt#
Lệch huấn luyện–phục vụ xảy ra khi đặc trưng được tính bằng hai bản cài đặt khác nhau; rò rỉ dữ liệu xảy ra khi tập huấn luyện chứa thông tin mà lúc dự đoán thật chưa có. Cả hai đều không làm chương trình báo lỗi, và rò rỉ còn làm kết quả đánh giá tốt lên, nên chỉ được phát hiện sau khi triển khai. Cách phòng chung là một định nghĩa đặc trưng duy nhất cho mọi nơi, ghép dữ liệu theo thời điểm, và xem xét từng đặc trưng xem nó có phải là hệ quả của nhãn không. Kho đặc trưng hỗ trợ những việc đó, nhưng chỉ đáng đầu tư khi có nhiều mô hình, phục vụ trực tuyến và đặc trưng thay đổi theo thời gian.
Đến đây ta có dữ liệu và đặc trưng đáng tin cậy để huấn luyện. Bước tiếp theo là huấn luyện sao cho khi cần, ta dựng lại được đúng mô hình đã huấn luyện. Chương 5 bàn về điều đó.
5Tính lặp lại của thí nghiệm#
Giả sử mô hình đang chạy trong sản xuất bắt đầu cho kết quả lạ, và ta muốn biết nguyên nhân. Việc đầu tiên là dựng lại đúng mô hình đó từ cùng mã, cùng dữ liệu và cùng cấu hình, rồi so sánh với các phiên bản khác. Nếu chạy lại huấn luyện mà ra một mô hình khác, việc điều tra gần như không thể bắt đầu. Chương này bàn về những gì cần làm để kết quả huấn luyện lặp lại được, và hai công cụ để ghi lại quá trình đó: theo dõi thí nghiệm và sổ đăng ký mô hình.
5.1Tái lập, tái tạo và tính bền#
Cụm từ "lặp lại được" thường được dùng cho ba yêu cầu khác nhau, nên cần tách chúng ra.
Yêu cầu chặt nhất là tái lập (reproducibility): chạy lại với cùng mã, cùng dữ liệu, cùng môi trường thì được cùng kết quả. Đây là yêu cầu bắt buộc để điều tra sự cố. Yêu cầu thứ hai là tái tạo (replicability): một người khác, trong một môi trường khác, làm lại được một kết quả tương tự; điều này cần cho hợp tác và kiểm toán. Yêu cầu thứ ba là tính bền (robustness) của kết luận: đổi hạt giống ngẫu nhiên hoặc đổi cách chia dữ liệu mà kết luận vẫn giữ nguyên. Các tài liệu dùng hai từ reproducibility và replicability không thống nhất, có nơi dùng theo nghĩa ngược lại; giáo trình dùng theo nghĩa vừa nêu.
Sculley và cộng sự (2015) gọi việc không đạt được yêu cầu thứ nhất là một dạng nợ (reproducibility debt) và chỉ ra bốn nguyên nhân: thuật toán có yếu tố ngẫu nhiên, tính bất định vốn có của huấn luyện song song, sự phụ thuộc vào điều kiện khởi tạo, và tương tác với thế giới bên ngoài.
Yêu cầu thứ ba hay bị bỏ qua nhất, dù nó ảnh hưởng trực tiếp tới các quyết định. Giả sử một thay đổi làm độ chính xác tăng 0,3 điểm phần trăm. Nếu hai lần chạy chỉ khác hạt giống ngẫu nhiên đã chênh nhau 0,5 điểm, mức cải thiện 0,3 điểm không nói lên điều gì. Trước khi kết luận mô hình mới tốt hơn, cần chạy vài hạt giống cho cả hai mô hình và so sánh mức chênh lệch với độ dao động đó. Khi hai mô hình được chấm trên cùng một tập kiểm tra, nên dùng so sánh ghép cặp, như kiểm định McNemar trình bày ở Mục 12.4 của Ứng dụng LLM.
5.2Cố định nguồn ngẫu nhiên và môi trường#
Để đạt được tái lập, phải cố định đủ sáu nhóm yếu tố; chỉ cần thiếu một nhóm là hai lần chạy có thể cho kết quả khác nhau. Với PyTorch, phần cố định trong mã trông như sau:
import os, random
import numpy as np
import torch

S = 1207

# 1. Hạt giống cho mọi nguồn ngẫu nhiên, không chỉ một
random.seed(S); np.random.seed(S); torch.manual_seed(S)
torch.cuda.manual_seed_all(S)

# 2. Phép toán tất định (chậm hơn)
os.environ["CUBLAS_WORKSPACE_CONFIG"] = ":4096:8"   # cần cho một số phép cuBLAS
torch.use_deterministic_algorithms(True)            # báo lỗi nếu phép toán không có bản tất định
torch.backends.cudnn.benchmark = False              # không chọn thuật toán theo đo thời gian

# 3. Thứ tự dữ liệu và các tiến trình con của DataLoader
def seed_worker(worker_id):
    s = torch.initial_seed() % 2**32
    np.random.seed(s); random.seed(s)

g = torch.Generator(); g.manual_seed(S)
loader = torch.utils.data.DataLoader(ds, shuffle=True, num_workers=4,
                                     worker_init_fn=seed_worker, generator=g)

# 4. Phiên bản: mã (commit), dữ liệu (hash), thư viện (lockfile), ảnh container (digest)
# 5. Cấu hình: một tệp duy nhất, lưu cùng kết quả
# 6. Phần cứng: loại GPU và số GPU
Ba chi tiết trong đoạn mã này thường bị bỏ sót. Chi tiết đầu tiên là các tiến trình con của DataLoader. Khi num_workers > 0, mỗi worker là một tiến trình riêng. PyTorch tự đặt hạt giống cho bộ sinh số ngẫu nhiên của torch trong mỗi worker, nhưng các thư viện khác mà hàm tăng cường dữ liệu dùng tới, như NumPy hay random, thì không chắc được đặt đúng. Tài liệu của PyTorch khuyến nghị đặt hạt giống cho chúng trong worker_init_fn, như hàm seed_worker ở trên.
Chi tiết thứ hai là số GPU. Đổi từ 4 sang 8 GPU mà giữ nguyên kích thước lô trên mỗi GPU thì kích thước lô hiệu dụng tăng gấp đôi, tức là đã thay đổi bài toán tối ưu. Ngay cả khi điều chỉnh để giữ nguyên kích thước lô hiệu dụng, thứ tự cộng gradient giữa các GPU thay đổi, và vì phép cộng số thực dấu phẩy động không có tính kết hợp, kết quả khác đi ở những chữ số cuối. Vì vậy số GPU nên được coi như một siêu tham số và được ghi lại.
Chi tiết thứ ba là cudnn.benchmark. Khi bật, cuDNN chọn thuật toán tích chập nhanh nhất bằng cách đo thời gian chạy thử, và kết quả đo phụ thuộc vào tải của máy lúc đó, nên hai lần chạy có thể dùng hai thuật toán khác nhau.
Tính tất định hoàn toàn trên GPU không miễn phí: nhiều phép toán có phiên bản tất định chậm hơn đáng kể. Cách làm phổ biến là bật chế độ tất định khi điều tra sự cố hoặc khi chạy kiểm thử hồi quy, còn khi huấn luyện thường ngày thì chấp nhận dao động nhỏ và kiểm tra tính bền bằng cách chạy nhiều hạt giống (Mục 5.1).
5.3Theo dõi thí nghiệm#
Theo dõi thí nghiệm (experiment tracking) là việc ghi lại mỗi lần huấn luyện cùng mọi thông tin liên quan. Nguyên tắc là ghi đủ để dựng lại được thí nghiệm, chứ không chỉ đủ để so sánh các thí nghiệm với nhau. Tối thiểu cần ghi bốn nhóm thông tin: đầu vào (commit của mã, hash của dữ liệu, tệp cấu hình đầy đủ, ảnh container); quá trình (đường cong hàm mất mát, learning rate theo từng bước, tài nguyên sử dụng, thời gian chạy); đầu ra (các chỉ số tính theo lát cắt như ở Mục 6.3, ma trận nhầm lẫn, tệp mô hình kèm hash); và ngữ cảnh (ai chạy, khi nào, để kiểm tra giả thuyết gì).
Các công cụ như MLflow hay Weights & Biases tự động ghi được ba nhóm đầu. Nhóm thứ tư thường bị bỏ trống vì không công cụ nào điền thay con người được, nhưng nó lại có giá trị riêng: nếu giả thuyết được viết ra trước khi chạy, không thể dựng lên một lời giải thích sau khi đã thấy kết quả, thói quen mà Mục 2.5 đã nhắc tới.
5.4Sổ đăng ký mô hình#
Theo dõi thí nghiệm ghi lại mọi lần huấn luyện, kể cả những lần thất bại. Sổ đăng ký mô hình (model registry) chỉ ghi những mô hình có khả năng được đưa vào sử dụng, và quản lý vòng đời của chúng. Mỗi mô hình trong sổ có một định danh, và sổ phải trả lời được các câu hỏi: mô hình này được huấn luyện từ commit nào, dữ liệu nào, cấu hình nào; nó đã qua những bước kiểm định nào, với kết quả ra sao; nó đang ở trạng thái nào (ví dụ staging, production hay archived) và ai đã duyệt; phiên bản nào đang thực sự chạy trong sản xuất, và nếu cần quay lui thì quay về phiên bản nào.
Câu hỏi cuối cùng là lý do chính để có sổ đăng ký, vì yếu tố phiên bản ở Mục 2.2 tồn tại để quay lui được. Shankar và cộng sự ghi nhận hai thực hành đi kèm: giữ các phiên bản cũ làm mô hình dự phòng, và duy trì một lớp quy tắc đơn giản (heuristic) phía sau mô hình, để khi mô hình hỏng thì hệ thống chuyển sang một hành vi tuy đơn giản nhưng đoán trước được.
Mỗi mô hình trong sổ đăng ký nên kèm một thẻ mô hình (model card), theo đề xuất của Mitchell và cộng sự (2019). Thẻ mô hình ghi mục đích sử dụng, những trường hợp không nên dùng, dữ liệu huấn luyện, và kết quả đánh giá tách theo các nhóm liên quan. Nó biến những hiểu biết vốn chỉ nằm trong đầu người huấn luyện thành tài liệu đi cùng mô hình.
5.5Tóm tắt#
Để điều tra sự cố, phải dựng lại được đúng mô hình đã huấn luyện. Điều đó đòi hỏi cố định hạt giống của mọi nguồn ngẫu nhiên, dùng phép toán tất định khi cần, và ghi lại phiên bản của mã, dữ liệu, thư viện, cấu hình và phần cứng. Theo dõi thí nghiệm ghi lại mọi lần chạy kèm giả thuyết của nó, còn sổ đăng ký mô hình quản lý các mô hình được đưa vào sử dụng và cho phép quay lui. Ngoài ra, trước khi tin vào một cải thiện nhỏ, cần kiểm tra nó có bền với hạt giống và cách chia dữ liệu không.
Có một mô hình tái lập được vẫn chưa có nghĩa là nó đủ tốt để triển khai. Chương 6 bàn về cách đánh giá một mô hình trước khi đưa nó tới người dùng.
6Đánh giá mô hình trước khi triển khai#
Trong các giáo trình trước, đánh giá một mô hình thường kết thúc bằng một con số: độ chính xác, AUC hay F1 trên tập kiểm tra. Con số đó cần thiết, nhưng trước khi đưa mô hình tới người dùng thật, nó không đủ để quyết định. Chương này giải thích vì sao, rồi giới thiệu ba cách đánh giá bổ sung và một bộ tiêu chí để kiểm tra mức sẵn sàng của cả hệ thống.
6.1Giới hạn của một chỉ số tổng hợp#
Một chỉ số duy nhất trên tập kiểm tra có ba giới hạn. Giới hạn thứ nhất là nó đo trên tập kiểm tra chứ không đo trên sản phẩm: một mô hình tốt hơn theo AUC chưa chắc làm doanh thu hay mức hài lòng của người dùng tăng lên (Mục 6.2). Giới hạn thứ hai là nó là trung bình trên toàn bộ dữ liệu, nên nhóm chiếm đa số quyết định kết quả; một nhóm nhỏ có thể tệ đi trong khi con số tổng thể vẫn tăng (Mục 6.3). Giới hạn thứ ba là nó không nói gì về từng trường hợp cụ thể: mô hình mới có thể đúng hơn trung bình một điểm, nhưng lại sai ở một trường hợp hiển nhiên mà mô hình cũ làm đúng (Mục 6.4).
6.2Chỉ số ngoại tuyến và chỉ số sản phẩm#
Shankar và cộng sự ghi nhận rằng các nhóm vận hành thành công thường gắn chỉ số đánh giá mô hình với chỉ số của sản phẩm. Bộ tiêu chí ML Test Score mà ta sẽ gặp ở Mục 6.5 cũng có một mục riêng cho yêu cầu này: chỉ số ngoại tuyến phải tương quan với chỉ số đo trực tuyến.
Quan hệ giữa hai loại chỉ số hiếm khi là tuyến tính. Với một mô hình phát hiện gian lận, khi AUC đã đủ cao, tăng thêm AUC có thể không làm số tiền thiệt hại giảm thêm, vì nhóm điều tra đã hết khả năng xử lý các giao dịch bị đánh dấu. Với một hệ thống xếp hạng, xếp hạng quá sát với sở thích cũ của người dùng có thể làm họ ít khám phá nội dung mới và rời đi sớm hơn, dù chỉ số NDCG tăng (Chương 12 phân tích hiện tượng này). Với một mô hình ngôn ngữ, perplexity thấp hơn chỉ tương quan yếu với việc người dùng có chấp nhận câu trả lời hay không, và tương quan càng yếu khi mô hình đã đủ tốt. Các ví dụ này minh hoạ những dạng quan hệ thường gặp, không phải số đo cụ thể.
Từ đó có một quy tắc thực hành: dùng một chỉ số ngoại tuyến rẻ để lặp nhanh trong quá trình phát triển, nhưng định kỳ kiểm tra xem nó còn tương quan với chỉ số sản phẩm không. Khi tương quan không còn, cải thiện chỉ số ngoại tuyến không mang lại giá trị cho sản phẩm nữa.
6.3Đánh giá theo lát cắt#
Đánh giá theo lát cắt (slice-based evaluation) là tính chỉ số riêng cho từng nhóm con của dữ liệu, thay vì chỉ một con số trên toàn bộ tập kiểm tra. Đây là một trong những kỹ thuật cho lợi ích lớn nhất so với công sức bỏ ra. Ví dụ dưới đây cho thấy vì sao.
Một cửa hàng trực tuyến có 85% khách hàng cũ (nhóm A) và 15% khách hàng mới (nhóm B). Mô hình v1 dự đoán hành vi của khách hàng từ một đặc trưng mà mọi khách hàng đều có. Để cải thiện, nhóm phát triển thêm đặc trưng là "lịch sử mua hàng", tạo ra mô hình v2. Với khách hàng cũ, mang nhiều thông tin về nhãn. Với khách hàng mới, chưa có lịch sử nên chỉ là nhiễu. Cả v1 và v2 đều là hồi quy logistic và không biết khách hàng thuộc nhóm nào. Thí nghiệm trong code/mlops/experiments.py mô phỏng đúng tình huống này với 8 000 mẫu huấn luyện và 8 000 mẫu kiểm tra.
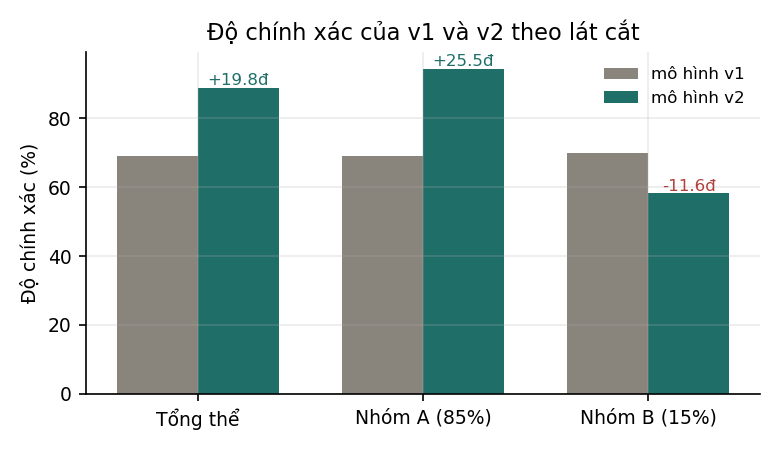
| Lát cắt | v1 | v2 | Thay đổi |
|---|---|---|---|
| Tổng thể | 69,14% | 88,96% | +19,83 điểm |
| Nhóm A: khách hàng cũ, 85% lưu lượng | 68,99% | 94,48% | +25,49 điểm |
| Nhóm B: khách hàng mới, 15% lưu lượng | 69,97% | 58,35% | −11,62 điểm |
Nếu chỉ nhìn dòng đầu tiên, v2 tốt hơn v1 gần 20 điểm phần trăm và chắc chắn sẽ được chọn. Tách theo nhóm thì thấy một bức tranh khác: khách hàng cũ được lợi lớn, còn khách hàng mới bị hại, xuống dưới cả mức của mô hình cũ. Nguyên nhân nằm ở cách mô hình học trọng số. Vì rất có ích với 85% dữ liệu, mô hình gán cho nó trọng số lớn (2,28, so với 1,07 của ). Với 15% khách hàng mới, chính trọng số lớn đó đưa nhiễu thẳng vào dự đoán. Đây là một minh hoạ đo được của nguyên lý CACE ở Mục 1.3: thêm một đặc trưng không cộng thêm một thứ vào mô hình mà thay đổi toàn bộ hàm dự đoán.
Có nhiều cách sửa, nhưng chỉ nghĩ ra được sau khi đã thấy vấn đề qua lát cắt. Có thể mã hoá trạng thái "chưa có lịch sử" thành một giá trị thiếu tường minh kèm một đặc trưng chỉ báo, thay vì để nó thành một số ngẫu nhiên; có thể thêm tương tác giữa và nhóm khách hàng; hoặc dùng một mô hình riêng cho khách hàng mới.
Nên theo dõi những lát cắt nào phụ thuộc vào bài toán, nhưng thường có bốn loại: lát cắt theo nghiệp vụ (khách hàng mới hay cũ, thị trường, hạng khách hàng, kênh bán), lát cắt theo kỹ thuật (thiết bị, phiên bản ứng dụng, có hay không có một đặc trưng nào đó), lát cắt theo các nhóm được pháp luật bảo vệ nếu bài toán liên quan tới công bằng, và lát cắt theo thời gian (giờ trong ngày, ngày trong tuần, ngày lễ). Tiêu chí Model 6 của ML Test Score phát biểu đúng yêu cầu này: chất lượng mô hình phải đủ tốt trên mọi lát cắt dữ liệu quan trọng.
6.4Kiểm thử hành vi#
Phần mềm thông thường được kiểm thử bằng các khẳng định cụ thể: với đầu vào này thì đầu ra phải là kia. Mô hình học máy cũng cần loại kiểm thử đó, bên cạnh chỉ số trung bình trên tập kiểm tra. Ribeiro và cộng sự (2020), với bộ công cụ CheckList, phân biệt ba loại kiểm thử hành vi:
# 1. Chức năng tối thiểu (minimum functionality): những trường hợp đơn giản không được phép sai
assert sentiment("Sản phẩm này tuyệt vời") == "tích cực"

# 2. Bất biến (invariance): thay đổi không liên quan thì dự đoán phải giữ nguyên
assert sentiment("Chuyến bay tới Hà Nội bị huỷ") == sentiment("Chuyến bay tới Đà Nẵng bị huỷ")

# 3. Kỳ vọng có hướng (directional expectation): thay đổi có hướng rõ thì dự đoán phải đổi đúng hướng
assert risk(income=50_000_000) <= risk(income=5_000_000)   # các đặc trưng khác giữ nguyên
Loại thứ nhất kiểm tra những trường hợp đơn giản mà mô hình nào cũng phải làm đúng. Loại thứ hai kiểm tra rằng những thay đổi không liên quan, như tên một thành phố, không làm thay đổi dự đoán. Loại thứ ba kiểm tra rằng khi đầu vào thay đổi theo một hướng có ý nghĩa rõ ràng, như thu nhập tăng, dự đoán thay đổi đúng hướng.
Giá trị của các kiểm thử này nằm ở chỗ chỉ số trung bình không phát hiện được những lỗi chúng tìm ra. Một mô hình có thể tăng một điểm độ chính xác trung bình mà mất khả năng xử lý đúng một trường hợp hiển nhiên. Vì vậy các kiểm thử hành vi nên chạy tự động mỗi khi có mô hình mới, giống như kiểm thử đơn vị trong CI.
6.5Bộ tiêu chí ML Test Score#
Ba cách đánh giá ở trên áp dụng cho mô hình. Để đánh giá mức sẵn sàng của cả hệ thống, bộ tiêu chí đầy đủ nhất là The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction của Breck và cộng sự (2017), cũng từ Google. Bộ tiêu chí gồm 28 mục chia thành bốn nhóm, mỗi nhóm 7 mục.
Nhóm thứ nhất kiểm tra dữ liệu và đặc trưng:
| Mục | Nội dung |
|---|---|
| Data 1 | Kỳ vọng về đặc trưng được ghi lại thành một lược đồ |
| Data 2 | Mọi đặc trưng đều có ích |
| Data 3 | Không đặc trưng nào có chi phí quá lớn so với lợi ích |
| Data 4 | Đặc trưng tuân thủ các yêu cầu ở mức chính sách (quyền riêng tư, pháp lý) |
| Data 5 | Pipeline dữ liệu có kiểm soát quyền riêng tư phù hợp |
| Data 6 | Có thể thêm đặc trưng mới nhanh chóng |
| Data 7 | Toàn bộ mã tính đặc trưng đều được kiểm thử |
Nhóm thứ hai kiểm tra quá trình phát triển mô hình:
| Mục | Nội dung |
|---|---|
| Model 1 | Mọi đặc tả mô hình đều được rà soát và đưa vào kho mã |
| Model 2 | Chỉ số ngoại tuyến tương quan với chỉ số trực tuyến |
| Model 3 | Mọi siêu tham số đã được tinh chỉnh |
| Model 4 | Đã biết ảnh hưởng của việc mô hình cũ đi |
| Model 5 | Một mô hình đơn giản hơn không tốt hơn (kiểm tra định kỳ) |
| Model 6 | Chất lượng đủ tốt trên mọi lát cắt dữ liệu quan trọng |
| Model 7 | Mô hình đã được kiểm tra về tính bao hàm giữa các nhóm người dùng |
Nhóm thứ ba kiểm tra hạ tầng học máy:
| Mục | Nội dung |
|---|---|
| Infra 1 | Huấn luyện tái lập được |
| Infra 2 | Mã đặc tả mô hình có kiểm thử đơn vị |
| Infra 3 | Toàn bộ pipeline có kiểm thử tích hợp |
| Infra 4 | Chất lượng mô hình được kiểm định trước khi đưa vào phục vụ |
| Infra 5 | Mô hình gỡ lỗi được bằng cách quan sát từng bước tính |
| Infra 6 | Mô hình được thử qua quy trình canary trước khi phục vụ toàn bộ |
| Infra 7 | Có thể quay lui mô hình đang phục vụ nhanh và an toàn |
Nhóm thứ tư kiểm tra việc giám sát:
| Mục | Nội dung |
|---|---|
| Monitor 1 | Thay đổi ở các hệ thống phụ thuộc phía trước sinh ra thông báo |
| Monitor 2 | Các bất biến của dữ liệu đúng ở cả đầu vào huấn luyện lẫn đầu vào phục vụ |
| Monitor 3 | Đặc trưng lúc huấn luyện và lúc phục vụ tính ra cùng giá trị |
| Monitor 4 | Mô hình không quá cũ |
| Monitor 5 | Mô hình ổn định về mặt số học (không có NaN, không có giá trị vô cùng) |
| Monitor 6 | Không có suy giảm, đột ngột hay từ từ, về tốc độ huấn luyện, độ trễ phục vụ, thông lượng hay bộ nhớ |
| Monitor 7 | Chất lượng dự đoán trên dữ liệu thật không suy giảm |
Nhiều mục trong bảng đã xuất hiện ở các chương trước: Data 1 là hợp đồng dữ liệu ở Mục 3.3, Model 6 là đánh giá theo lát cắt ở Mục 6.3, Infra 1 là tái lập ở Chương 5, Monitor 3 là lệch huấn luyện–phục vụ ở Mục 4.1.
Cách tính điểm của bộ tiêu chí có một chi tiết đáng hiểu kỹ. Mỗi mục được 0,5 điểm nếu được thực hiện thủ công, có ghi lại kết quả và gửi cho những người liên quan, và được 1 điểm nếu có hệ thống chạy nó tự động và định kỳ. Điểm của mỗi nhóm là tổng điểm các mục trong nhóm. Điểm cuối cùng của hệ thống không phải là tổng hay trung bình, mà là giá trị nhỏ nhất trong bốn điểm nhóm. Bài báo giải thích rằng cả bốn nhóm đều quan trọng, nên muốn tăng điểm phải cải thiện cả bốn. Hệ quả là một hệ thống có hạ tầng huấn luyện hoàn hảo nhưng không có giám sát nào vẫn có điểm 0, dù ba nhóm kia đạt tối đa.
Bài báo đưa ra bảng diễn giải điểm sau (Bảng V trong bài):
| Điểm | Ý nghĩa |
|---|---|
| 0 | giống một dự án nghiên cứu hơn là một hệ thống sản xuất |
| (0, 1] | đã có kiểm thử, nhưng có thể còn những lỗ hổng nghiêm trọng về độ tin cậy |
| (1, 2] | đã có bước đầu đưa vào sản xuất, cần đầu tư thêm |
| (2, 3] | kiểm thử tương đối đủ, nhiều mục còn có thể tự động hoá |
| (3, 5] | kiểm thử và giám sát tự động ở mức cao, phù hợp với hệ thống trọng yếu |
| > 5 | kiểm thử và giám sát tự động ở mức rất cao |
Các tác giả cũng lưu ý rằng hệ thống ở những giai đoạn khác nhau nên nhắm tới những mức điểm khác nhau: một bản nguyên mẫu không cần đạt mức của một hệ thống trọng yếu.
6.6Tóm tắt#
Một chỉ số tổng hợp trên tập kiểm tra không đủ để quyết định triển khai một mô hình. Chỉ số đó cần được kiểm tra định kỳ xem còn tương quan với chỉ số sản phẩm không, cần được tách theo lát cắt để không che mất các nhóm nhỏ, và cần được bổ sung bằng kiểm thử hành vi trên những trường hợp cụ thể. Ở mức cả hệ thống, ML Test Score cho một danh sách 28 mục, và cách tính điểm theo giá trị nhỏ nhất buộc phải chú ý tới cả bốn nhóm, trong đó giám sát thường là nhóm yếu nhất.
Khi mô hình đã qua đánh giá, nó cần được đóng gói và đặt vào một dịch vụ để nhận yêu cầu. Chương 7 bàn về cách phục vụ mô hình và những ràng buộc về độ trễ đi kèm.
7Phục vụ mô hình#
Phục vụ (serving) mô hình là đưa mô hình vào một hệ thống để nó nhận đầu vào và trả về dự đoán cho người dùng hoặc cho các dịch vụ khác. Có nhiều cách làm việc này, và cách nào phù hợp phụ thuộc vào việc kết quả cần nhanh tới đâu. Với các hệ thống trả lời trực tiếp cho người dùng, độ trễ trở thành ràng buộc chính, và cách đo độ trễ đúng không hiển nhiên như ta tưởng.
7.1Các chế độ phục vụ#
Có ba chế độ phục vụ chính. Ở chế độ theo lô (batch), mô hình chạy định kỳ, ví dụ mỗi đêm, chấm điểm cho toàn bộ người dùng hoặc sản phẩm rồi ghi kết quả vào một bảng; ứng dụng chỉ việc đọc bảng đó. Chế độ này phù hợp với gợi ý hằng ngày hay chấm điểm rủi ro tín dụng, và khó khăn chính của nó là dự đoán có thể đã cũ khi người dùng vừa thay đổi hành vi. Ở chế độ trực tuyến (online, hay request–response), mỗi yêu cầu gọi mô hình đồng bộ và nhận kết quả trong vài chục mili giây; chế độ này cần cho xếp hạng kết quả tìm kiếm hay chống gian lận khi thanh toán, và khó khăn chính là độ trễ. Ở chế độ luồng (streaming), mô hình xử lý từng sự kiện khi nó tới và cập nhật trạng thái liên tục, như khi phát hiện bất thường hay cá nhân hoá theo phiên; khó khăn chính là giữ trạng thái đúng và xử lý các sự kiện đến muộn.
Chi phí vận hành tăng nhanh theo thứ tự đó, nên nguyên tắc là chọn chế độ rẻ nhất vẫn đáp ứng được yêu cầu của sản phẩm. Một sai lầm hay gặp là chọn phục vụ trực tuyến khi nghiệp vụ không cần. Chế độ phục vụ cũng quyết định cách giám sát: với chấm điểm theo lô, có thể kiểm tra toàn bộ kết quả trước khi đưa vào sử dụng; với phục vụ trực tuyến, dự đoán đã tới người dùng trước khi ai kịp kiểm tra.
7.2Ngân sách độ trễ#
Thiết kế một dịch vụ phục vụ trực tuyến bắt đầu bằng việc chia tổng thời gian cho phép của một yêu cầu cho từng thành phần, gọi là ngân sách độ trễ. Ví dụ, giả sử một lượt xếp hạng kết quả tìm kiếm phải trả lời trong 150 ms, và được chia như sau:
| Thành phần | Ngân sách |
|---|---|
| Mạng, chiều đi và chiều về | 20 ms |
| Tra cứu đặc trưng ở kho trực tuyến | 25 ms |
| Tiền xử lý đặc trưng | 10 ms |
| Suy luận mô hình | 60 ms |
| Hậu xử lý, ghi log | 15 ms |
| Dự phòng | 20 ms |
Trong ví dụ này, suy luận mô hình chiếm chưa tới một nửa ngân sách. Nếu tối ưu mô hình để thời gian suy luận giảm từ 60 ms xuống 30 ms, tổng thời gian chỉ giảm 20%; trong khi bỏ được một lần tra cứu đặc trưng thừa có thể giảm nhiều hơn. Đây là phiên bản về độ trễ của Hình 1: mô hình chỉ là một phần của hệ thống. Các kỹ thuật giảm thời gian suy luận như lượng tử hoá được trình bày ở giáo trình Quantization.
7.3Phân vị độ trễ khi gọi nhiều dịch vụ#
Khi giám sát độ trễ, con số đầu tiên người ta nghĩ tới là độ trễ trung bình. Con số này ít có giá trị, vì phân phối độ trễ thường lệch phải rất mạnh: phần lớn yêu cầu nhanh, một số ít rất chậm, và người dùng nhớ những lần chậm. Vì vậy các mục tiêu mức dịch vụ (SLO) thường đặt trên phân vị cao như p95 hay p99, tức giá trị mà 95% hay 99% số yêu cầu không vượt quá.
Có một lý do sâu hơn để chú ý tới phân vị cao, được Dean và Barroso (2013) phân tích trong bài The Tail at Scale. Một yêu cầu tới hệ thống lớn thường phải gọi nhiều dịch vụ phía sau song song, chẳng hạn tra đặc trưng từ nhiều kho khác nhau, và chỉ trả lời được khi mọi lời gọi đã xong. Thời gian trả lời khi đó là giá trị lớn nhất của thời gian các lời gọi. Nếu có lời gọi độc lập, cùng hàm phân phối , thì
Như vậy, để cả yêu cầu đạt phân vị 99 như của một dịch vụ, mỗi dịch vụ phải đạt phân vị ; với , đó là phân vị 99,99.
Để thấy độ lớn của hiệu ứng, thí nghiệm trong code/mlops/experiments.py dùng một dịch vụ có độ trễ phân phối log-chuẩn với trung vị 20 ms và p99 bằng 100 ms, rồi tính thời gian trả lời khi gọi song song nhiều bản của nó:
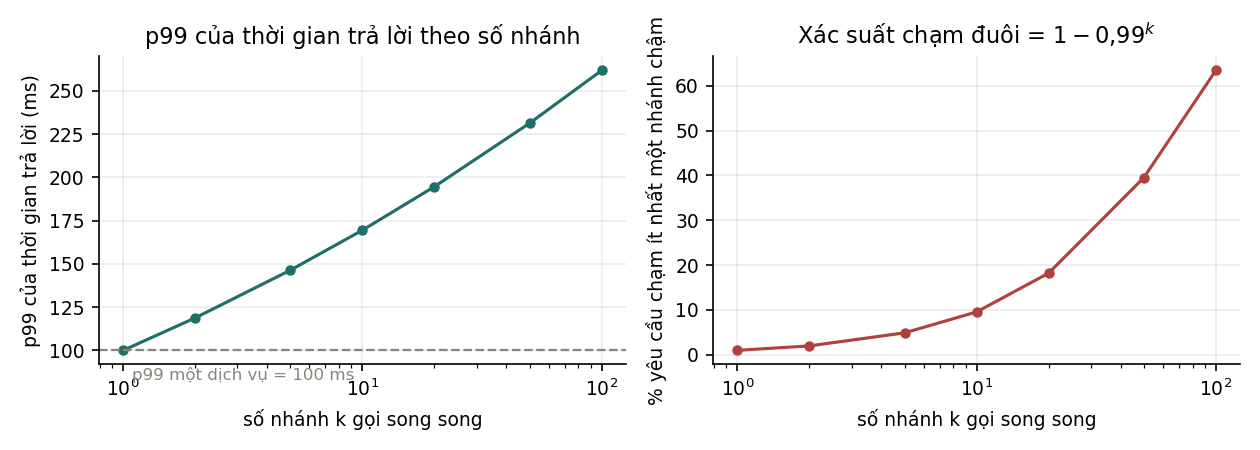
| Số dịch vụ | p99 của thời gian trả lời | Tỉ lệ yêu cầu gặp ít nhất một dịch vụ chậm |
|---|---|---|
| 1 | 100,0 ms | 1,0% |
| 10 | 169,5 ms | 9,6% |
| 50 | 231,4 ms | 39,5% |
| 100 | 261,9 ms | 63,4% |
Với 100 dịch vụ, mỗi dịch vụ chỉ chậm hơn 100 ms ở 1% số lần gọi, nhưng 63% số yêu cầu gặp ít nhất một lời gọi chậm như vậy. Giảm độ trễ trung bình của từng dịch vụ không giải quyết được vấn đề này, vì vấn đề nằm ở phần đuôi. Dean và Barroso đề xuất các cách tác động trực tiếp vào phần đuôi: giảm số dịch vụ phải gọi; đặt thời hạn chờ (timeout) và trả lời với kết quả một phần; và gửi yêu cầu dự phòng (hedged request), tức là nếu sau một khoảng thời gian bản đầu tiên chưa trả lời thì gửi thêm yêu cầu tới một bản sao khác, rồi dùng kết quả nào về trước.
7.4Đóng gói mô hình#
Nghiên cứu của Shankar và cộng sự ghi nhận một khó khăn mà nhiều kỹ sư gặp: môi trường phát triển và môi trường sản xuất khác nhau. Hai môi trường có yêu cầu trái ngược: môi trường phát triển cần linh hoạt để thử nghiệm nhanh, môi trường sản xuất cần chặt chẽ. Nhưng hai môi trường càng khác nhau thì càng khó phát hiện lỗi sớm, vì nhiều lỗi chỉ xuất hiện trong môi trường sản xuất.
Có ba thực hành giúp thu hẹp khoảng cách đó. Thứ nhất là dùng cùng một ảnh container cho huấn luyện và phục vụ, chỉ khác điểm vào (entrypoint). Thứ hai là dùng cùng một hàm biến đổi đặc trưng, đóng gói cùng mô hình thay vì cài đặt lại trong dịch vụ phục vụ, đúng tinh thần của Mục 4.4. Thứ ba là chạy kiểm thử tích hợp cho toàn bộ pipeline trong CI, trên một tập dữ liệu nhỏ nhưng thật, đúng như mục Infra 3 của ML Test Score.
Về định dạng lưu mô hình, có hai lựa chọn với ưu nhược điểm ngược nhau. Lưu bằng pickle hay state_dict của PyTorch đơn giản và giữ nguyên hệ sinh thái, nhưng phụ thuộc chặt vào phiên bản thư viện, và việc nạp một tệp pickle không đáng tin cậy có thể chạy mã tuỳ ý. Xuất mô hình thành đồ thị tính toán (ONNX, TorchScript, SavedModel) cho một tạo tác độc lập với ngôn ngữ, tối ưu được và có ranh giới rõ, nhưng kém linh hoạt và cần kiểm tra rằng đồ thị xuất ra cho cùng kết quả với bản gốc.
Với cách thứ hai, luôn cần một kiểm thử so sánh: chạy bản gốc và bản đã xuất trên cùng một lô đầu vào và so sánh đầu ra. Hai bản có thể dùng các kernel khác nhau, với thứ tự phép tính khác nhau, nên phép so sánh thường dùng một dung sai (ví dụ sai số tương đối ) thay vì đòi trùng khớp từng bit. Mục 6.5 của giáo trình Quantization là một ví dụ của cùng cách làm: kiểm tra bằng mã rằng phép tính số nguyên cho cùng kết quả với phép mô phỏng bằng số thực.
7.5Tóm tắt#
Có ba chế độ phục vụ, theo lô, trực tuyến và luồng, với chi phí và độ phức tạp tăng dần; nên chọn chế độ rẻ nhất đáp ứng được yêu cầu. Với phục vụ trực tuyến, ngân sách độ trễ cho thấy suy luận mô hình thường chỉ chiếm một phần thời gian, và khi một yêu cầu gọi nhiều dịch vụ song song, phần đuôi của phân phối độ trễ chi phối thời gian trả lời: với 100 dịch vụ, 63% số yêu cầu gặp ít nhất một lời gọi chậm. Đóng gói mô hình cùng hàm biến đổi đặc trưng trong cùng một container, và kiểm tra bản đã xuất bằng phép so sánh có dung sai, giúp môi trường sản xuất khớp với môi trường phát triển.
Một mô hình đã được đóng gói vẫn chưa nên được đưa ngay tới mọi người dùng. Chương 8 bàn về cách triển khai một mô hình mới từng bước, và cách biết chắc nó tốt hơn mô hình cũ.
8Triển khai mô hình mới#
Khi đã có một mô hình mới tốt hơn trên tập kiểm tra, câu hỏi còn lại là đưa nó tới người dùng thế nào. Thay ngay mô hình cũ bằng mô hình mới cho toàn bộ người dùng là cách rủi ro nhất: nếu mô hình mới có lỗi chưa phát hiện, mọi người dùng đều chịu ảnh hưởng cùng lúc. Các chiến lược ra mắt được thiết kế để giảm rủi ro đó, và mỗi chiến lược trả lời được một câu hỏi khác nhau về mô hình mới.
8.1Các chiến lược ra mắt#
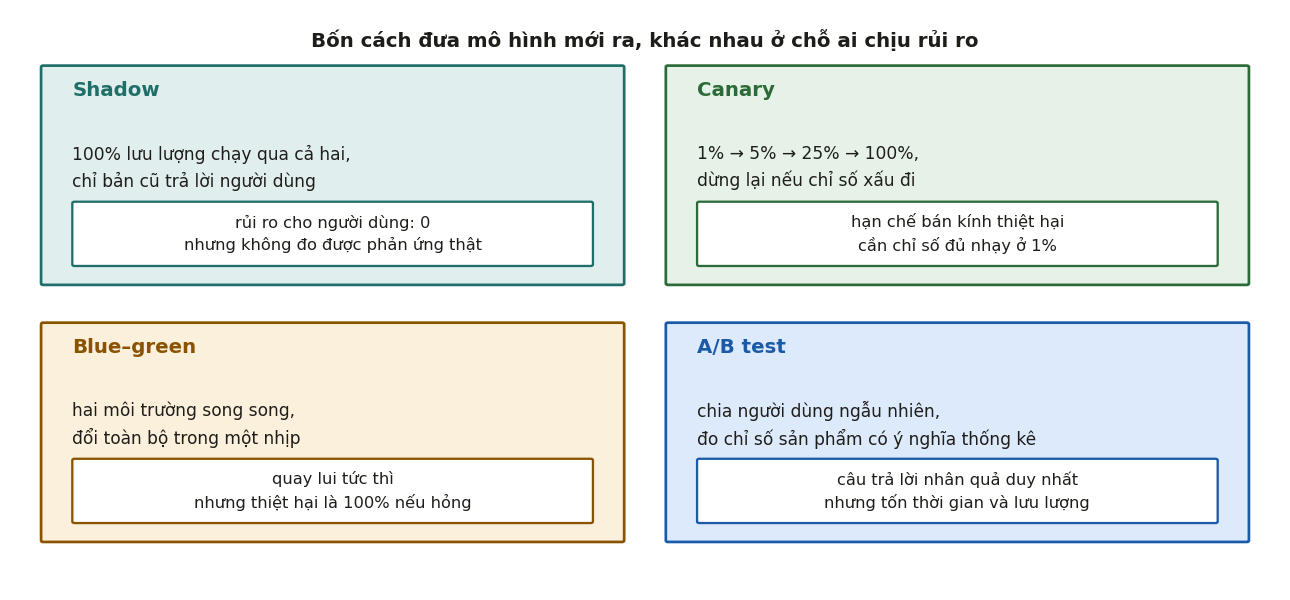
Chiến lược shadow (chạy song song ngầm) cho mô hình mới nhận cùng lưu lượng thật với mô hình cũ, nhưng chỉ ghi lại dự đoán của nó chứ không dùng. Nó cho biết mô hình mới có lỗi, có chậm không, và dự đoán của nó khác mô hình cũ nhiều tới đâu. Nó không cho biết người dùng phản ứng ra sao, vì người dùng không nhìn thấy kết quả của mô hình mới.
Chiến lược canary (ra mắt dần) đưa mô hình mới tới một phần nhỏ người dùng, rồi tăng dần. Nó cho biết có chỉ số vận hành nào xấu đi ở quy mô nhỏ hay không, nhưng không cho biết các hiệu ứng dài hạn hay các hiệu ứng lan truyền giữa người dùng.
Chiến lược blue–green duy trì hai môi trường giống nhau và chuyển toàn bộ lưu lượng từ môi trường này sang môi trường kia, cho phép quay lui tức thì. Nó là một cơ chế triển khai, không cho biết gì về chất lượng của mô hình.
Chiến lược A/B test chia ngẫu nhiên người dùng thành hai nhóm, một nhóm dùng mô hình cũ và một nhóm dùng mô hình mới, rồi so sánh chỉ số sản phẩm giữa hai nhóm. Vì việc chia là ngẫu nhiên, khác biệt đo được có thể quy cho mô hình theo nghĩa nhân quả. Đổi lại, A/B test tốn thời gian và tốn lưu lượng, như Mục 8.4 sẽ cho thấy.
Shankar và cộng sự ghi nhận rằng các nhóm có nhiều người dùng thường chia một lần ra mắt thành nhiều giai đoạn và đánh giá ở từng giai đoạn: đánh giá ngoại tuyến, rồi shadow, rồi canary ở 1% người dùng, rồi A/B test, cuối cùng là toàn bộ người dùng. Mỗi giai đoạn loại bỏ một loại rủi ro, và loại được rủi ro càng sớm thì càng rẻ. Quy trình này cũng có cái giá của nó: nhiều người được phỏng vấn cho rằng đi từ ý tưởng tới lúc kiểm chứng xong mất quá lâu. Một người cho biết ở công ty của họ, thử một ý tưởng đặc trưng mới mất hơn ba tháng; khoảng 40 tới 50% số ý tưởng đi tới được lần ra mắt đầu tiên, và khoảng một nửa trong số đó sau đó bị loại vì lý do pháp lý, quyền riêng tư hoặc độ phức tạp. Vì vậy, loại được ý tưởng kém càng sớm thì tốc độ chung của nhóm càng cao (Mục 2.2).
8.2Chạy song song ngầm#
Shadow thường bị coi là một bước thủ tục, nhưng nó trả lời được ba câu hỏi quan trọng mà người dùng không phải chịu rủi ro nào. Câu hỏi thứ nhất là mô hình mới có chịu được tải thật không: độ trễ, bộ nhớ, tỉ lệ lỗi khi nhận lưu lượng thật. Câu hỏi thứ hai là đặc trưng lúc phục vụ có khớp với lúc huấn luyện không; đây chính là mục Monitor 3 của ML Test Score, và shadow là cách rẻ nhất để đo nó trên lưu lượng thật. Câu hỏi thứ ba là phân phối dự đoán của mô hình mới có khác bất thường so với mô hình cũ không.
Câu hỏi thứ hai có giá trị đặc biệt. Nhiều lỗi lệch huấn luyện–phục vụ (Mục 4.1) chỉ xuất hiện trên phân phối đầu vào thật mà không xuất hiện trên tập kiểm tra, và shadow phát hiện được chúng trước khi có người dùng nào bị ảnh hưởng. Giới hạn của shadow nằm ở những hệ thống mà dự đoán tác động lên hành vi người dùng, như gợi ý hay xếp hạng: vì người dùng không thấy kết quả của mô hình mới, shadow không đo được phản ứng của họ.
8.3Ra mắt dần#
Canary đưa mô hình mới tới một phần nhỏ lưu lượng, ví dụ 1%, theo dõi một thời gian, rồi tăng dần lên 5%, 25%, 100%. Cách làm này chỉ có ý nghĩa nếu ở mức lưu lượng nhỏ ta vẫn đo được điều gì đó, và ở đây có một chỗ dễ nhầm. Với 1% lưu lượng, các chỉ số sản phẩm như tỉ lệ chuyển đổi gần như chắc chắn không đủ mẫu để có ý nghĩa thống kê (Mục 8.4 sẽ tính cụ thể). Thứ đo được ở canary là các chỉ số có nhiều mẫu và thay đổi lớn khi có sự cố: tỉ lệ lỗi, độ trễ p50, p95, p99, phân phối của dự đoán, tỉ lệ đặc trưng bị thiếu. Những chỉ số như tỉ lệ chuyển đổi, doanh thu mỗi phiên, tỉ lệ giữ chân người dùng phải đợi tới A/B test.
Hai giai đoạn này có vai trò khác nhau: canary bảo vệ hệ thống khỏi sự cố lớn, còn A/B test trả lời câu hỏi mô hình mới có mang lại giá trị hay không. Dùng kết quả canary để kết luận về giá trị sản phẩm là một lỗi thiết kế quy trình thường gặp.
8.4A/B test và cỡ mẫu#
Phần lớn chỉ số sản phẩm là tỉ lệ: tỉ lệ nhấp, tỉ lệ chuyển đổi. Để phát hiện chênh lệch giữa tỉ lệ của nhánh cũ và của nhánh mới, với mức ý nghĩa (hai phía) và lực kiểm định , mỗi nhánh cần số mẫu
Thay số cho một trường hợp: tỉ lệ nền , muốn phát hiện cải thiện tương đối 10%, tức và , với và lực kiểm định 80%, nên . Tử số là , mẫu số là , và mẫu mỗi nhánh. Điều cần nhớ nằm ở mẫu số: tỉ lệ nghịch với bình phương mức chênh lệch. Muốn phát hiện một mức cải thiện nhỏ bằng một nửa, cần gấp bốn lần số mẫu.
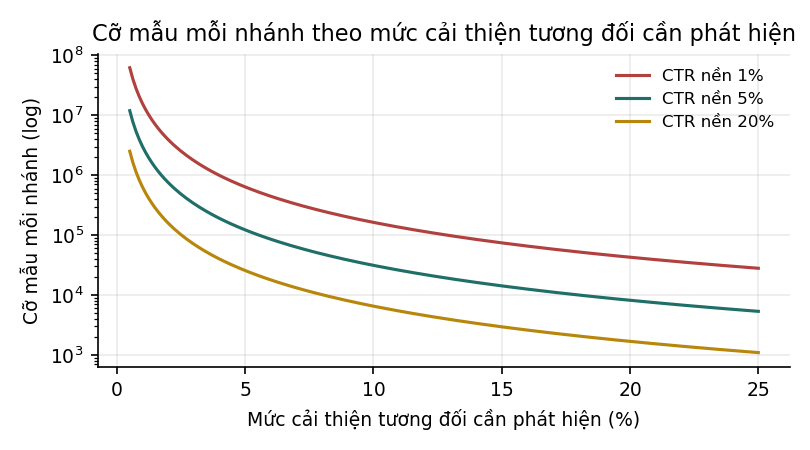
Bảng dưới tính cỡ mẫu với tỉ lệ nền 5%, hai phía và lực kiểm định 80% (tính trong code/mlops/experiments.py):
| Cải thiện tương đối cần phát hiện | Cỡ mẫu mỗi nhánh | Số ngày nếu mỗi nhánh có 100 000 lượt mỗi ngày |
|---|---|---|
| 1% (từ 5% lên 5,05%) | 2 996 694 | 30,0 ngày |
| 2% | 752 700 | 7,5 ngày |
| 5% | 122 121 | 1,2 ngày |
| 10% | 31 231 | 0,3 ngày |
| 20% | 8 155 | 0,1 ngày |
Dòng đầu tiên giải thích vì sao không thể A/B test mọi thay đổi. Để phát hiện một cải thiện tương đối 1% trên tỉ lệ nền 5%, tức từ 5% lên 5,05%, cần khoảng ba triệu mẫu mỗi nhánh, nghĩa là một tháng lưu lượng cho một ý tưởng. Lưu lượng là tài nguyên khan hiếm, và một quy trình ra mắt tốt không dùng nó cho những ý tưởng có thể loại sớm bằng cách rẻ hơn như đánh giá ngoại tuyến hay shadow.
Công thức cũng cho thấy ba cách giảm cỡ mẫu: chấp nhận chỉ phát hiện mức cải thiện lớn hơn, nới hoặc lực kiểm định, và giảm phương sai của chỉ số. Hai cách đầu làm thay đổi câu hỏi hoặc giảm độ tin cậy của kết luận; cách thứ ba thì không. Kỹ thuật giảm phương sai phổ biến nhất là CUPED (Deng và cộng sự, 2013). Ý tưởng của nó là phần lớn sự khác biệt giữa người dùng đã có từ trước thí nghiệm: người hay mua sắm vẫn hay mua sắm, dù ở nhánh nào. CUPED dùng giá trị của chính chỉ số đó ở mỗi người dùng trong giai đoạn trước thí nghiệm làm biến hiệp phương sai, và trừ đi phần biến động giải thích được bởi nó. Nếu hệ số tương quan giữa giá trị trước và trong thí nghiệm là , phương sai giảm theo hệ số , và cỡ mẫu cần thiết giảm theo cùng tỉ lệ. Với , phương sai còn 51%, nên 31 231 mẫu mỗi nhánh ở ví dụ trên giảm còn khoảng 15 900. Công cụ cỡ mẫu ở trang Phòng thí nghiệm cho phép nhập mức giảm phương sai này.
8.5Sai sót khi phân tích A/B test#
Kể cả khi có đủ mẫu, kết quả A/B test vẫn có thể bị đọc sai. Phần này dựa chủ yếu vào cuốn Trustworthy Online Controlled Experiments của Kohavi, Tang và Xu (2020), tài liệu chuẩn về chủ đề này.
Sai sót phổ biến nhất là xem kết quả giữa chừng (peeking): theo dõi p-value hằng ngày và dừng thí nghiệm ngay khi nó xuống dưới 0,05. Mỗi lần nhìn là một lần kiểm định, và nhìn nhiều lần làm tỉ lệ dương tính giả cao hơn 5% rất nhiều. Cách xử lý là cố định cỡ mẫu trước khi chạy, hoặc dùng các phương pháp được thiết kế cho việc theo dõi liên tục như kiểm định tuần tự.
Sai sót thứ hai là so sánh nhiều chỉ số cùng lúc. Nếu theo dõi 20 chỉ số mà không chỉ số nào thật sự thay đổi, kiểm định ở mức vẫn cho trung bình 1 chỉ số "có ý nghĩa" do ngẫu nhiên, và xác suất có ít nhất một chỉ số như vậy là nếu các chỉ số độc lập. Cách xử lý là khai báo trước một chỉ số chính để ra quyết định; các chỉ số còn lại là chỉ số bảo vệ (guardrail metric), chỉ dùng để phát hiện tác hại.
Sai sót thứ ba xảy ra khi hai nhánh ảnh hưởng lẫn nhau. Trong một mạng xã hội hay một sàn giao dịch hai phía, hành vi của người dùng ở nhánh này tác động tới người dùng ở nhánh kia, nên giả định các mẫu độc lập không còn đúng. Cách xử lý là chia ngẫu nhiên theo cụm, như theo vùng địa lý hay theo nhóm bạn bè, thay vì theo từng người.
Sai sót thứ tư là không kiểm tra tỉ lệ mẫu giữa hai nhánh. Thí nghiệm thiết kế chia 50/50, nhưng số người dùng thực tế ở hai nhánh chênh lệch nhiều hơn mức ngẫu nhiên cho phép, chẳng hạn vì một nhánh gây lỗi làm mất log. Hiện tượng này gọi là tỉ lệ mẫu lệch (sample ratio mismatch), và khi nó xảy ra thì kết quả thí nghiệm không đáng tin, dù p-value của chỉ số chính là bao nhiêu. Nên kiểm tra nó bằng kiểm định khi bình phương trên số người dùng của hai nhánh trước khi đọc bất kỳ kết quả nào.
Sai sót cuối cùng là bỏ qua hiệu ứng mới lạ: người dùng có thể phản ứng mạnh với một thay đổi chỉ vì nó mới, và hiệu ứng giảm dần sau vài tuần. Thí nghiệm cần chạy đủ lâu, và nên xem hiệu ứng theo thời gian, nhất là ở những người dùng đã gặp thay đổi nhiều lần.
8.6Tóm tắt#
Mỗi chiến lược ra mắt trả lời một câu hỏi khác nhau: shadow kiểm tra mô hình mới trên lưu lượng thật mà không có rủi ro cho người dùng, canary giới hạn phạm vi ảnh hưởng của sự cố, blue–green cho phép quay lui tức thì, còn A/B test đo tác động nhân quả lên chỉ số sản phẩm. Cỡ mẫu của A/B test tỉ lệ nghịch với bình phương mức cải thiện, nên một cải thiện 1% trên tỉ lệ nền 5% cần khoảng ba triệu mẫu mỗi nhánh; giảm phương sai bằng CUPED là cách rút ngắn thí nghiệm mà không giảm độ tin cậy. Khi đọc kết quả, cần tránh xem giữa chừng, so sánh nhiều chỉ số, bỏ qua ảnh hưởng giữa hai nhánh và tỉ lệ mẫu lệch.
Sau khi mô hình mới đã được triển khai cho mọi người dùng, công việc chưa kết thúc. Dữ liệu sẽ thay đổi dần theo thời gian, và mô hình cần được theo dõi. Chương 9 bắt đầu bằng cách mô tả chính xác "dữ liệu thay đổi" nghĩa là gì.
9Dịch chuyển phân phối#
Một giả định ngầm của mọi phương pháp học có giám sát là dữ liệu lúc sử dụng có cùng phân phối với dữ liệu lúc huấn luyện. Trong sản xuất, giả định đó chỉ đúng trong một thời gian. Người dùng thay đổi, sản phẩm thay đổi, thị trường thay đổi, và dữ liệu đi vào mô hình khác dần với dữ liệu nó đã học. Hiện tượng này gọi là dịch chuyển phân phối (distribution shift). Để phát hiện và xử lý nó, trước hết cần phân biệt các loại dịch chuyển, vì chúng có hậu quả rất khác nhau và không phải loại nào cũng phát hiện được bằng cùng một cách.
9.1Các loại dịch chuyển#
Mô hình học quan hệ giữa đầu vào và nhãn từ phân phối chung . Theo quy tắc nhân của xác suất, phân phối chung có thể tách theo hai cách:
Mỗi cách tách cho một cách mô tả sự thay đổi (Quiñonero-Candela và cộng sự, 2009). Theo cách tách thứ nhất, có thể chỉ thay đổi trong khi giữ nguyên; trường hợp này gọi là covariate shift. Ví dụ, một chiến dịch quảng cáo thu hút nhiều khách hàng trẻ hơn: quan hệ giữa tuổi và hành vi mua hàng không đổi, chỉ có tỉ lệ người trẻ trong dữ liệu tăng lên. Cũng theo cách tách đó, có thể thay đổi; trường hợp này gọi là concept drift. Ví dụ, ngân hàng thay đổi chính sách tín dụng, nên cùng một hồ sơ khách hàng giờ được đánh giá rủi ro khác trước. Theo cách tách thứ hai, có thể chỉ thay đổi trong khi giữ nguyên; trường hợp này gọi là label shift (hay prior probability shift). Ví dụ, tỉ lệ giao dịch gian lận tăng gấp đôi trong dịp lễ, nhưng một giao dịch gian lận vẫn có đặc điểm như trước.
Vì covariate shift và concept drift là hai thành phần của cùng một cách tách, còn label shift thuộc cách tách kia, câu hỏi "đây là covariate shift hay label shift" không phải lúc nào cũng có câu trả lời duy nhất. Nó phụ thuộc vào việc ta coi gây ra , như đặc điểm khách hàng quyết định hành vi, hay gây ra , như bệnh gây ra triệu chứng. Trong thực tế, nhiều loại dịch chuyển thường xảy ra cùng lúc.
9.2Phát hiện dịch chuyển khi chưa có nhãn#
Trong sản xuất, đầu vào có ngay khi mô hình nhận yêu cầu, còn nhãn thường đến muộn hoặc không bao giờ đến (Mục 3.5). Vì vậy câu hỏi thực tế là: chỉ nhìn vào , ta phát hiện được loại dịch chuyển nào? Thí nghiệm trong code/mlops/experiments.py trả lời câu hỏi đó.
Dữ liệu có hai đặc trưng, , và nhãn sinh theo mô hình logistic với trọng số . Một hồi quy logistic được huấn luyện trên 4 000 mẫu, rồi được đánh giá trên ba tập dữ liệu mới, mỗi tập 4 000 mẫu, ứng với ba loại dịch chuyển. Với covariate shift, được lấy từ trên mỗi trục, còn nhãn vẫn sinh theo quy tắc cũ. Với label shift, dữ liệu được lấy mẫu lại sao cho 80% mẫu có nhãn dương thay vì khoảng 50%, giữ nguyên . Với concept drift, có cùng phân phối như lúc huấn luyện nhưng nhãn sinh theo trọng số mới . Với mỗi tập, ta đo hai đại lượng: độ chính xác của mô hình, cần có nhãn; và p-value của kiểm định Kolmogorov–Smirnov (KS) hai mẫu trên từng đặc trưng so với dữ liệu huấn luyện, không cần nhãn. Một dịch chuyển được coi là phát hiện được nếu p-value nhỏ nhất trong hai đặc trưng dưới .
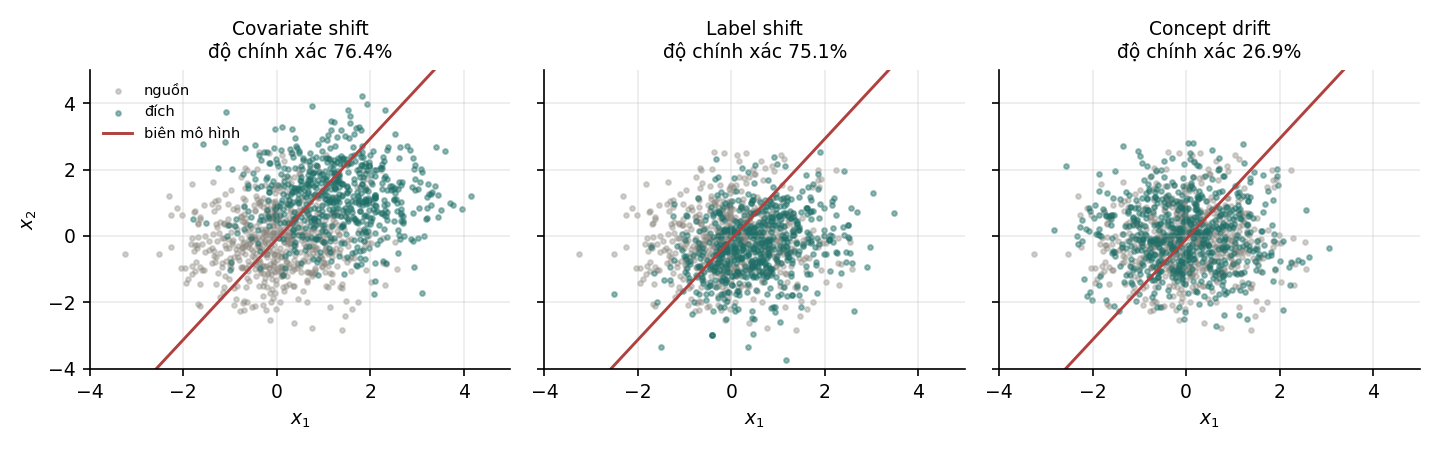
| Trường hợp | Độ chính xác | p-value KS trên | p-value KS trên | Phát hiện được chỉ từ |
|---|---|---|---|---|
| Không dịch chuyển | 75,6% | |||
| Covariate shift | 76,4% | có | ||
| Label shift | 75,1% | có | ||
| Concept drift | 26,9% | không |
Bảng kết quả cho thấy hai điều trái ngược nhau. Ở hai trường hợp giữa, kiểm định KS phát hiện thay đổi rất rõ, với p-value gần như bằng 0, nhưng độ chính xác gần như không đổi. Với covariate shift, lý do là mô hình logistic có dạng đúng với quy tắc sinh nhãn, nên dữ liệu dịch sang vùng khác không làm nó sai; covariate shift chỉ gây hại khi mô hình phải ngoại suy sang vùng có ít dữ liệu huấn luyện mà nó mô tả sai. Với label shift, thay đổi vì mang thông tin về : tỉ lệ nhãn thay đổi thì phân phối của cũng thay đổi theo. Nếu hệ thống cảnh báo dựa trên thay đổi của , cả hai trường hợp này đều thành báo động giả, đúng loại khó khăn được nhắc nhiều nhất ở Mục 3.2.
Ở dòng cuối thì ngược lại: độ chính xác giảm từ 75,6% xuống 26,9%, thấp hơn cả đoán ngẫu nhiên, trong khi các kiểm định trên không thấy gì bất thường. Giá trị trên chỉ là dao động ngẫu nhiên, vì phân phối của không hề đổi; nếu dùng ngưỡng 0,05 quen thuộc, nó sẽ bị tính là phát hiện được, một ví dụ của vấn đề kiểm định nhiều lần mà Mục 9.3 sẽ bàn.
Kết quả này không phải ngẫu nhiên mà suy ra được từ định nghĩa: concept drift có thể giữ nguyên , nên không phép kiểm tra nào chỉ dựa trên phát hiện được nó. Muốn phát hiện concept drift phải có tín hiệu về nhãn: nhãn thật, nhãn đến trễ, nhãn thay thế, hoặc phản hồi gián tiếp của người dùng. Đây là lý do Mục 3.5 nói độ trễ nhãn quyết định khả năng giám sát của hệ thống: nó quyết định ta có phát hiện được loại dịch chuyển gây hại nhiều nhất hay không.
9.3Các kiểm định thống kê#
Với dữ liệu thật, có nhiều cách so sánh phân phối hiện tại với phân phối tham chiếu. Kiểm định Kolmogorov–Smirnov hai mẫu dùng cho biến liên tục một chiều; nó không giả định dạng phân phối và cho p-value, nhưng với cỡ mẫu rất lớn thì những khác biệt nhỏ không đáng kể cũng thành có ý nghĩa thống kê. Kiểm định khi bình phương dùng cho biến rời rạc hoặc đã chia bin; nó có lý thuyết rõ ràng nhưng phụ thuộc vào cách chia bin và kém chính xác khi có bin ít mẫu. PSI, trình bày ở Mục 9.4, cho một con số dễ báo cáo nhưng không có p-value. Với dữ liệu nhiều chiều có MMD (maximum mean discrepancy), đo khoảng cách giữa hai phân phối qua một hàm kernel và kiểm định bằng hoán vị, và cách dùng một bộ phân loại miền (domain classifier): huấn luyện một mô hình phân biệt dữ liệu cũ với dữ liệu mới; nếu nó làm tốt hơn đoán ngẫu nhiên thì dữ liệu đã thay đổi, và AUC của nó đo mức độ thay đổi.
Rabanser và cộng sự (2019) so sánh có hệ thống các phương pháp này và thấy một cách đơn giản cho kết quả tốt: áp dụng kiểm định KS lên đầu ra của mô hình (xác suất dự đoán cho từng lớp) thay vì lên từng đặc trưng đầu vào, kèm hiệu chỉnh Bonferroni. Đầu ra có ít chiều hơn đầu vào nhiều, và tập trung đúng vào những thay đổi có ảnh hưởng tới dự đoán. Mục 10.3 sẽ dùng một ý tưởng gần với cách này.
Khi áp dụng các kiểm định trên cho nhiều đặc trưng, cần nhớ hai điều. Điều thứ nhất là kiểm định nhiều lần: chạy KS trên 200 đặc trưng ở mức thì trung bình có 2 đặc trưng báo động ở mỗi lần kiểm tra dù không có gì thay đổi, nên cần hiệu chỉnh (Bonferroni, Benjamini–Hochberg) hoặc dùng một phép kiểm tra nhiều chiều. Điều thứ hai là nhiều dịch chuyển nằm ở quan hệ giữa các đặc trưng chứ không ở từng đặc trưng: mỗi đặc trưng vẫn giữ phân phối cũ nhưng tương quan giữa chúng thay đổi, và chỉ các phép kiểm tra nhiều chiều mới phát hiện được.
9.4Chỉ số PSI#
Trong các phép đo dịch chuyển, PSI (population stability index) được dùng rộng rãi nhất trong công nghiệp, đặc biệt trong lĩnh vực chấm điểm tín dụng nơi nó ra đời. PSI được tính trên hai phân phối đã chia thành bin. Gọi là tỉ lệ mẫu rơi vào bin trong tập tham chiếu và là tỉ lệ đó trong tập hiện tại:
Công thức này có một cách hiểu gọn hơn. Tách tổng thành hai phần:
Vậy PSI là tổng hai chiều của phân kỳ KL, còn gọi là phân kỳ Jeffreys; khác với phân kỳ KL, nó đối xứng giữa hai phân phối. Chẳng hạn với hai bin, tập tham chiếu chia đều còn tập hiện tại là : PSI bằng , và cũng bằng tổng của và . Một thay đổi 10 điểm phần trăm ở mỗi bin vẫn nằm dưới ngưỡng 0,10 thường dùng. Vì có , PSI không xác định khi một bin không có mẫu nào, nên các cài đặt thường thay tỉ lệ 0 bằng một số dương rất nhỏ.
Đi kèm PSI là một bộ ngưỡng quy ước được trích dẫn rất nhiều: PSI dưới 0,10 coi như phân phối ổn định, từ 0,10 tới 0,25 là có dịch chuyển nhỏ nên xem xét, trên 0,25 là dịch chuyển đáng kể cần hành động. Mục tiếp theo cho thấy vì sao không nên dùng thẳng bộ ngưỡng này.
9.5Ngưỡng của PSI#
Ba ngưỡng 0,10 và 0,25 là quy tắc kinh nghiệm, không phải kết quả thống kê. Yurdakul và Naranjo (2020) chỉ ra rằng khi hai mẫu có cùng phân phối, PSI nhân với một hệ số phụ thuộc cỡ mẫu có phân phối tiệm cận khi bình phương, và đề xuất dùng giá trị tới hạn tính từ phân phối đó thay cho quy tắc kinh nghiệm, vì giá trị tới hạn phụ thuộc cả vào cỡ mẫu lẫn số bin.
Có thể thấy điều này bằng một mô phỏng đơn giản. Lấy hai mẫu từ cùng một phân phối chuẩn, tức không có dịch chuyển nào, chia bin theo phân vị của mẫu tham chiếu, rồi tính PSI; lặp lại 300 lần và lấy trung bình:
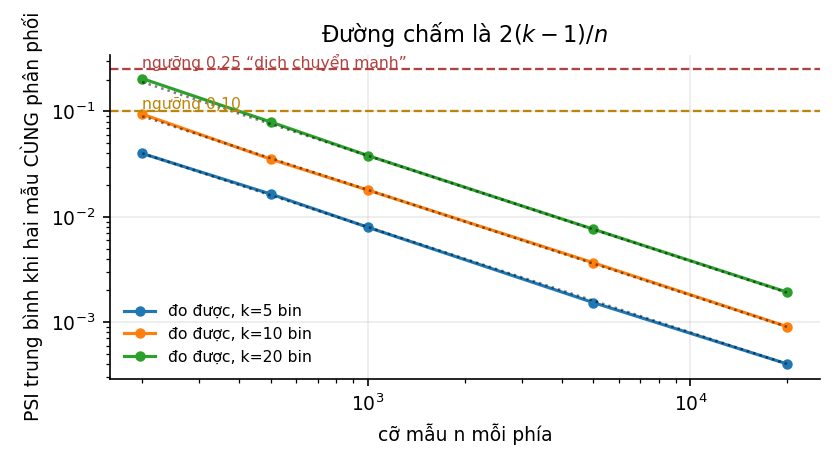
| mỗi mẫu | Lý thuyết , | |||
|---|---|---|---|---|
| 200 | 0,0399 | 0,0943 | 0,2050 | 0,0900 |
| 500 | 0,0164 | 0,0353 | 0,0795 | 0,0360 |
| 1 000 | 0,0080 | 0,0179 | 0,0381 | 0,0180 |
| 5 000 | 0,0015 | 0,0037 | 0,0076 | 0,0036 |
| 20 000 | 0,0004 | 0,0009 | 0,0019 | 0,0009 |
PSI trung bình bám sát giá trị . Có thể giải thích con số này như sau. Khi hai mẫu cùng phân phối, và đều gần xác suất thật của bin , và chênh lệch giữa chúng có độ lớn cỡ . Dùng xấp xỉ , ta được
Với hai mẫu độc lập cùng cỡ , , nên có phân phối xấp xỉ khi bình phương với bậc tự do, đúng với kết quả tiệm cận nêu trên. Lấy kỳ vọng hai vế:
Hai đầu của bảng cho thấy vấn đề của ngưỡng cố định. Với và 20 bin, PSI trung bình là 0,205 khi không có dịch chuyển nào, đã rất gần ngưỡng 0,25. Với , PSI trung bình chỉ là 0,0009, nên ngưỡng 0,25 khó bị vượt ngay cả khi có dịch chuyển thật. Cùng một ngưỡng vì thế vừa gây báo động giả ở mẫu nhỏ, vừa bỏ sót dịch chuyển ở mẫu lớn.
Thí nghiệm tiếp theo đo trực tiếp hai hiện tượng đó. Với mỗi cỡ mẫu và mỗi độ dịch chuyển (mẫu mới có trung bình dịch đi lần độ lệch chuẩn), ta lặp lại 400 lần và đếm tỉ lệ số lần mỗi quy tắc báo động. Quy tắc thứ nhất là PSI lớn hơn 0,25 với 10 bin; quy tắc thứ hai là kiểm định KS với .
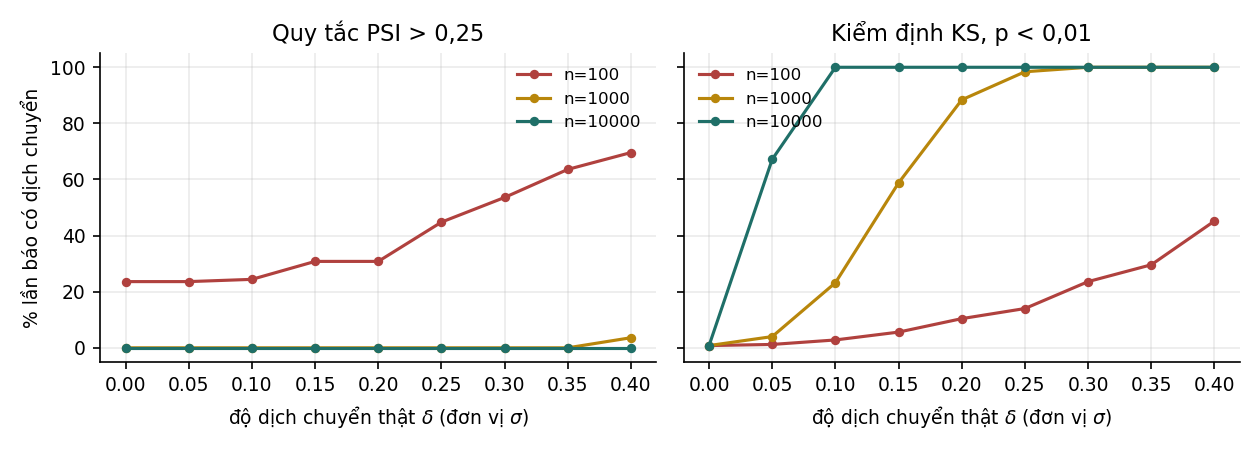
Mỗi ô ghi tỉ lệ báo động của quy tắc PSI, rồi của kiểm định KS:
| (không dịch chuyển) | |||
|---|---|---|---|
| 50 | 73% / 0% | 78% / 1% | 82% / 5% |
| 100 | 24% / 1% | 24% / 2% | 54% / 24% |
| 200 | 0% / 0% | 0% / 5% | 17% / 49% |
| 1 000 | 0% / 2% | 0% / 22% | 0% / 100% |
| 10 000 | 0% / 0% | 0% / 100% | 0% / 100% |
Cột là tỉ lệ báo động giả. Với , quy tắc PSI báo động 73% số lần dù không có gì thay đổi, còn kiểm định KS giữ tỉ lệ báo động giả quanh mức danh nghĩa 1% ở mọi cỡ mẫu. Hai cột còn lại là độ nhạy. Với và dịch chuyển thật 0,3 độ lệch chuẩn, quy tắc PSI không báo động lần nào, trong khi KS báo động ở cả 400 lần. Ở cỡ mẫu nhỏ, tỉ lệ báo động của PSI gần như không phụ thuộc vào việc có dịch chuyển hay không: 73% khi không có dịch chuyển, 78% với .
Từ đó có ba cách làm tốt hơn, theo thứ tự ưu tiên. Cách tốt nhất là dùng kiểm định có p-value (KS, khi bình phương, MMD với kiểm định hoán vị) kèm hiệu chỉnh cho kiểm định nhiều lần; ngưỡng khi đó tự điều chỉnh theo cỡ mẫu. Nếu buộc phải dùng PSI, chẳng hạn vì quy định của ngành hoặc vì báo cáo đã quen dùng, hãy tính ngưỡng theo đúng và của mình. Với hai mẫu cùng cỡ , kết quả ở trên cho ngưỡng ở mức ý nghĩa là . Ví dụ với và , , nên ngưỡng là 0,217 khi , 0,043 khi và 0,0043 khi . Cũng có thể xác định ngưỡng bằng mô phỏng: lấy nhiều cặp mẫu từ dữ liệu tham chiếu, tính PSI và dùng phân vị 99% làm ngưỡng. Cuối cùng, dù dùng cách nào, cần giữ cố định và giữa các lần đo; nếu cỡ lô thay đổi theo ngày thì PSI của hai ngày không so sánh được với nhau.
9.6Cửa sổ thời gian và tập tham chiếu#
Mọi phép kiểm tra dịch chuyển đều so sánh dữ liệu trong một cửa sổ hiện tại với một tập tham chiếu, và cả hai đều phải được chọn.
Cửa sổ hiện tại ngắn, ví dụ một giờ, cho phép phát hiện thay đổi nhanh nhưng nhiễu lớn và sinh nhiều báo động giả. Cửa sổ dài, ví dụ một tuần, ổn định hơn nhưng làm loãng các thay đổi đột ngột và phát hiện chúng muộn.
Với tập tham chiếu, nếu dùng cố định dữ liệu huấn luyện, phép kiểm tra trả lời đúng câu hỏi "dữ liệu hiện tại đã khác dữ liệu huấn luyện tới đâu", nhưng sẽ tiếp tục báo động cả khi dịch chuyển đã ổn định thành trạng thái bình thường mới. Nếu dùng tham chiếu trượt, ví dụ 30 ngày gần nhất, phép kiểm tra thích ứng với trạng thái bình thường mới, nhưng không phát hiện được dịch chuyển chậm, vì tập tham chiếu trôi theo dữ liệu. Điều này nguy hiểm, vì Chương 11 sẽ cho thấy dịch chuyển chậm có thể gây thiệt hại lớn. Cách làm hợp lý là dùng cả hai: tham chiếu cố định để biết dữ liệu đã cách xa dữ liệu huấn luyện bao nhiêu, tham chiếu trượt để phát hiện thay đổi đột ngột.
Một khó khăn khác là tính mùa vụ. Lưu lượng ngày thứ Bảy khác ngày thứ Ba, tháng Chạp khác tháng Ba. So dữ liệu thứ Bảy với tham chiếu tính trên các ngày thường sẽ báo động đều đặn mỗi tuần mà không có ý nghĩa gì. Cách xử lý tối thiểu là so sánh cùng kỳ, chẳng hạn thứ Bảy với các thứ Bảy trước.
9.7Tóm tắt#
Dịch chuyển phân phối có ba loại chính: covariate shift thay đổi , label shift thay đổi , và concept drift thay đổi . Chỉ hai loại đầu phát hiện được khi chỉ có , và trong thí nghiệm ở Mục 9.2, chúng gần như không làm giảm độ chính xác; concept drift làm độ chính xác giảm từ 75,6% xuống 26,9% mà không phép kiểm tra nào trên nhận ra. Để đo dịch chuyển nên dùng kiểm định có p-value kèm hiệu chỉnh cho kiểm định nhiều lần; ngưỡng PSI 0,25 không dùng được cho mọi cỡ mẫu vì PSI trung bình khi không có dịch chuyển xấp xỉ . Cửa sổ thời gian và tập tham chiếu cũng cần được chọn cẩn thận để không bỏ sót dịch chuyển chậm.
Phát hiện dịch chuyển chỉ là một phần của việc theo dõi mô hình trong sản xuất. Chương 10 đặt các phép kiểm tra này vào một hệ thống giám sát đầy đủ.
10Giám sát#
Đến đây ta đã biết những gì có thể hỏng trong một hệ thống học máy: dữ liệu đầu vào (Chương 3), đặc trưng (Chương 4), và phân phối dữ liệu theo thời gian (Chương 9). Giám sát là việc theo dõi liên tục để phát hiện những sự cố đó khi chúng xảy ra, và cảnh báo đúng người vào đúng lúc. Phần khó của giám sát không nằm ở việc đo được nhiều chỉ số, mà ở việc chọn đo cái gì và khi nào thì báo động.
10.1Chỉ số vận hành và chỉ số của mô hình#
Các chỉ số cần theo dõi chia thành hai loại. Loại thứ nhất là chỉ số vận hành: độ trễ, lưu lượng, tỉ lệ lỗi, mức sử dụng CPU, GPU, bộ nhớ. Chúng giống với chỉ số của mọi dịch vụ phần mềm khác, và khi có sự cố thì chúng thay đổi ngay. Sách Site Reliability Engineering của Google (Beyer và cộng sự, 2016) gọi bốn chỉ số độ trễ, lưu lượng, lỗi và mức bão hoà tài nguyên là bốn tín hiệu cơ bản (four golden signals). Sách cũng định nghĩa hai khái niệm sẽ dùng trong chương này: chỉ số mức dịch vụ (SLI) là một đại lượng đo được, như p99 của độ trễ, còn mục tiêu mức dịch vụ (SLO) là giá trị mục tiêu cho SLI đó, như "p99 dưới 200 ms trong 99,9% số phút".
Loại thứ hai là chỉ số riêng của mô hình học máy: độ chính xác, phân phối của dự đoán, phân phối của đặc trưng, chất lượng dữ liệu đầu vào. Khác với chỉ số vận hành, khi mô hình suy giảm thì các chỉ số này thường không thay đổi ngay, hoặc thay đổi mà không ai nhận ra. Ngành phần mềm đã có nhiều kinh nghiệm với loại chỉ số thứ nhất, nên phần còn lại của chương tập trung vào loại thứ hai.
10.2Các lớp giám sát#
Có thể sắp xếp các chỉ số của mô hình thành bốn lớp, theo khoảng cách tới nhãn: càng gần nhãn thì càng nói lên nhiều về chất lượng, nhưng càng khó có được.
Lớp ngoài cùng là dữ liệu đầu vào thô: dữ liệu tới có đủ số lượng, đúng giờ, đúng lược đồ không. Lớp này có ngay và phát hiện được lỗi cứng, nhưng nói rất ít về chất lượng dự đoán. Lớp thứ hai là đặc trưng: phân phối của từng đặc trưng, tỉ lệ giá trị thiếu, các giá trị danh mục lạ. Lớp này cũng có ngay, và phát hiện được covariate shift cùng lệch huấn luyện–phục vụ. Lớp thứ ba là dự đoán: phân phối của , tỉ lệ từng lớp, độ tự tin trung bình. Lớp này có ngay và phát hiện được nhiều sự cố mà không cần nhãn. Lớp trong cùng là chất lượng: độ chính xác, AUC, chỉ số sản phẩm. Lớp này có ý nghĩa nhất, nhưng chỉ có khi đã có nhãn, nên thường đến muộn.
Nguyên tắc chung là cảnh báo dựa trên lớp chất lượng khi có thể, và dùng ba lớp ngoài để điều tra nguyên nhân. Với những hệ thống có nhãn đến chậm, lớp dự đoán trở thành lớp giám sát chính.
10.3Độ lệch dự đoán#
Với lớp dự đoán, Sculley và cộng sự (2015) đề xuất một phép kiểm tra đơn giản nhưng hữu ích.
Định nghĩa 10.1 (Độ lệch dự đoán)
Trong một hệ thống hoạt động đúng, phân phối của các nhãn được dự đoán thường phải bằng phân phối của các nhãn quan sát được. Độ lệch dự đoán (prediction bias) là chênh lệch giữa hai phân phối đó.
Bài báo nêu rõ giới hạn của phép kiểm tra này: nó không đủ để khẳng định mô hình đúng, vì một mô hình luôn dự đoán đúng tỉ lệ trung bình mà không dùng gì tới đầu vào cũng có độ lệch bằng 0. Nhưng một thay đổi đột ngột của nó thường là dấu hiệu sự cố. Ưu điểm lớn của nó là không cần nhãn cho từng dự đoán, chỉ cần biết tỉ lệ nền theo thời gian. Ví dụ, nếu tỉ lệ giao dịch gian lận trong lịch sử là 1,2% mà mô hình đột nhiên đánh dấu 4,5% số giao dịch, có điều gì đó cần điều tra, dù chưa có nhãn nào cho ngày hôm nay.
Độ lệch dự đoán nên được tính theo lát cắt: theo thị trường, theo kênh, theo phiên bản ứng dụng. Độ lệch tổng thể bằng 0 vẫn có thể che giấu hai lát cắt lệch theo hai chiều ngược nhau.
10.4Giới hạn hành động và hệ thống phía trước#
Bài báo của Sculley và cộng sự đề xuất thêm hai cơ chế giám sát.
Cơ chế thứ nhất là giới hạn hành động (action limits). Với những hệ thống thực hiện hành động thật, như đặt giá thầu quảng cáo, chặn tin nhắn hay khoá tài khoản, cần đặt và thực thi giới hạn cho số hành động trong mỗi khoảng thời gian, như một phép kiểm tra hợp lý. Giới hạn đủ rộng để không bị chạm khi hệ thống hoạt động bình thường; khi bị chạm thì tự động cảnh báo và cần người xem xét. Cơ chế này không cần biết mô hình đúng hay sai. Nó chỉ cần biết rằng, chẳng hạn, việc khoá 50 000 tài khoản trong một giờ chưa từng xảy ra và không nên xảy ra.
Cơ chế thứ hai liên quan tới hệ thống phía trước (up-stream producers), tức các hệ thống cung cấp dữ liệu cho hệ thống học máy. Chúng cần được giám sát, kiểm thử và có SLO phù hợp với nhu cầu của hệ thống học máy phía sau. Cảnh báo ở phía trước phải được chuyển tới hệ thống học máy; ngược lại, khi hệ thống học máy không đạt SLO, mọi bên sử dụng kết quả của nó phải được thông báo. Đây cũng là cách xử lý dạng nợ "bên sử dụng không khai báo" ở Mục 1.4: biến các phụ thuộc ngầm thành phụ thuộc có tên và có cảnh báo theo cả hai chiều.
10.5Thiết kế cảnh báo#
Mục 3.2 đã nhắc tới khó khăn được nêu nhiều nhất trong nghiên cứu của Shankar và cộng sự: báo động giả. Khi phần lớn cảnh báo là giả, người nhận dần bỏ qua chúng, kể cả những cảnh báo thật. Một hệ thống cảnh báo như vậy có thể còn tệ hơn không có, vì nó tạo ra cảm giác an toàn không có cơ sở. Kinh nghiệm vận hành phần mềm, được tổng kết trong sách của Beyer và cộng sự (2016), cho bốn nguyên tắc thiết kế cảnh báo.
Nguyên tắc thứ nhất là mỗi cảnh báo phải gắn với một hành động cụ thể. Nếu người nhận không biết phải làm gì khi nhận được nó, đó là thông tin để xem chứ không phải cảnh báo, và nên được đưa vào bảng theo dõi (dashboard) thay vì gửi thông báo. Nguyên tắc thứ hai là phân mức độ: gọi người trực ngay (page) cho lỗi cứng và khi dịch vụ ngừng hoạt động; tạo phiếu xử lý (ticket) cho dịch chuyển và suy giảm chậm; phần còn lại chỉ hiển thị trên bảng theo dõi. Nguyên tắc thứ ba là cảnh báo theo triệu chứng chứ không theo nguyên nhân. "Tỉ lệ chuyển đổi giảm 15%" là một triệu chứng ảnh hưởng tới người dùng và đáng gọi người trực; "PSI của đặc trưng thứ 37 vượt 0,2" là một manh mối để điều tra, chưa phải một sự cố. Nguyên tắc thứ tư là yêu cầu tín hiệu kéo dài: một điểm dữ liệu vượt ngưỡng có thể là nhiễu, còn vượt ngưỡng trong ba cửa sổ liên tiếp mới là tín hiệu đáng tin.
10.6Ngưỡng quyết định khi mô hình thay đổi#
Sculley và cộng sự đặt tên cho một dạng nợ rất hay gặp liên quan tới giám sát: ngưỡng cố định trong hệ thống thay đổi (fixed thresholds in dynamic systems). Nhiều mô hình cần một ngưỡng quyết định, ví dụ để quyết định một email có phải thư rác không. Ngưỡng thường được đặt bằng tay để cân bằng precision và recall. Khi mô hình được huấn luyện lại trên dữ liệu mới, phân phối điểm số của nó thay đổi, và ngưỡng cũ có thể không còn phù hợp: cùng ngưỡng 0,7 nhưng số email bị chặn có thể tăng gấp đôi.
Cập nhật ngưỡng bằng tay cho nhiều mô hình vừa tốn công vừa dễ quên. Bài báo đề xuất xác định ngưỡng tự động trên một tập kiểm định riêng mỗi lần huấn luyện, và coi ngưỡng là một phần của mô hình, lưu cùng mô hình trong sổ đăng ký, thay vì là một hằng số trong cấu hình của dịch vụ. Đây cũng là một ví dụ của CACE: huấn luyện lại làm thay đổi phân phối điểm số, nên mọi thứ phụ thuộc vào điểm số đó cũng thay đổi theo, kể cả một con số trong tệp cấu hình mà không ai coi là một phần của mô hình.
10.7Tóm tắt#
Giám sát một hệ thống học máy gồm chỉ số vận hành, giống mọi dịch vụ khác, và chỉ số riêng của mô hình, xếp thành bốn lớp từ dữ liệu thô, đặc trưng, dự đoán tới chất lượng. Khi nhãn đến chậm, lớp dự đoán là lớp chính, với độ lệch dự đoán là một phép kiểm tra đơn giản. Giới hạn hành động bảo vệ hệ thống khỏi những hành động bất thường mà không cần biết mô hình đúng hay sai, còn cảnh báo cần gắn với hành động, phân mức độ, dựa trên triệu chứng và tín hiệu kéo dài để tránh báo động giả. Cuối cùng, ngưỡng quyết định phải được xác định lại mỗi lần huấn luyện lại mô hình.
Khi giám sát cho thấy mô hình đã suy giảm, cách xử lý thông thường là huấn luyện lại. Chương 11 bàn về việc huấn luyện lại: khi nào, bao lâu một lần, và làm sao để việc tự động hoá nó không tạo ra sự cố mới.
11Huấn luyện lại#
Chương 9 cho thấy dữ liệu thay đổi theo thời gian, và Chương 10 cho thấy cách phát hiện khi mô hình suy giảm. Cách xử lý thông thường là huấn luyện lại mô hình trên dữ liệu mới. Nhưng huấn luyện lại tốn tài nguyên và mỗi lần triển khai một mô hình mới đều có rủi ro, nên cần trả lời được ba câu hỏi: mô hình cũ đi nhanh tới mức nào, khi nào nên huấn luyện lại, và huấn luyện lại như thế nào.
11.1Độ cũ của mô hình#
Trước khi quyết định bao lâu huấn luyện lại một lần, cần biết cái giá của việc không huấn luyện lại. ML Test Score có hai mục cho vấn đề này: Model 4 yêu cầu biết ảnh hưởng của việc mô hình cũ đi, và Monitor 4 yêu cầu mô hình không quá cũ.
Để có con số cụ thể, thí nghiệm trong code/mlops/experiments.py mô phỏng một thế giới có concept drift chậm. Dữ liệu có hai chiều, và biên quyết định thật xoay một góc 0,035 radian (khoảng ) mỗi tuần, trong 52 tuần. Mỗi tuần có 4 000 mẫu mới. Mô hình ban đầu là hồi quy logistic huấn luyện trên dữ liệu tuần 0; mỗi khi tới lịch huấn luyện lại, một mô hình mới được huấn luyện trên dữ liệu của tuần vừa qua. Ta so sánh bốn nhịp huấn luyện lại:
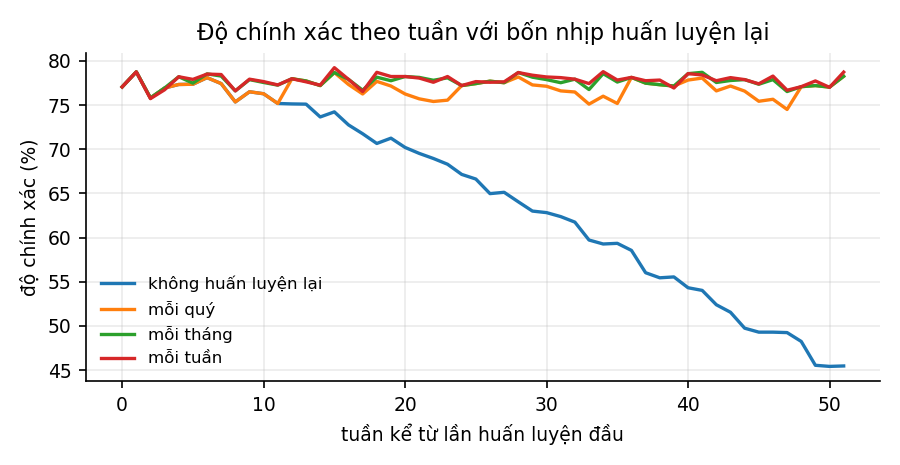
| Nhịp huấn luyện lại | Số lần huấn luyện lại trong năm | Độ chính xác trung bình | Thấp nhất | Tuần 52 |
|---|---|---|---|---|
| Không bao giờ | 0 | 64,61% | 45,42% | 45,48% |
| Mỗi quý (12 tuần) | 4 | 76,89% | 74,50% | 78,25% |
| Mỗi tháng (4 tuần) | 13 | 77,68% | 75,80% | 78,25% |
| Mỗi tuần | 52 | 77,80% | 75,72% | 78,72% |
Không huấn luyện lại thì sau một năm độ chính xác trung bình mất 13,19 điểm phần trăm. Tới tuần 52, biên quyết định đã xoay hơn , và mô hình chỉ còn đúng 45,5%, thấp hơn đoán ngẫu nhiên trên bài toán hai lớp cân bằng này. Hình 13 cho thấy thêm một điều đáng lo: độ chính xác giảm dần từng chút, nên không có tuần nào có một thay đổi đột ngột đủ để kích hoạt một cảnh báo theo ngưỡng.
Mặt khác, lợi ích của huấn luyện lại giảm nhanh khi nhịp dày lên. Chuyển từ không huấn luyện lại sang huấn luyện lại mỗi quý tăng 12,3 điểm, nhưng từ mỗi quý lên mỗi tuần chỉ tăng thêm 0,91 điểm, trong khi số lần huấn luyện tăng 13 lần. Vì vậy nhịp huấn luyện lại là một quyết định kinh tế. Nó được xác định bằng cách đo một đường cong như Hình 13 trên chính bài toán của mình, rồi so sánh giá trị của một điểm phần trăm độ chính xác với chi phí của một lần huấn luyện, kiểm định và triển khai. Bài 7 ở Chương 14 lặp lại thí nghiệm này với ba tốc độ dịch chuyển khác nhau.
Cần nhớ rằng các con số trên thuộc về một mô phỏng mà dịch chuyển xảy ra đều và chậm. Với những thay đổi đột ngột, như một sự kiện làm hành vi người dùng thay đổi chỉ trong vài ngày, huấn luyện lại theo lịch cố định phản ứng chậm, và cần thêm các điều kiện kích hoạt khác.
11.2Điều kiện kích hoạt huấn luyện lại#
Có bốn cách quyết định khi nào huấn luyện lại. Cách đơn giản nhất là theo lịch, ví dụ mỗi tuần hay mỗi tháng. Cách này dễ dự trù tài nguyên, nhưng huấn luyện lại cả khi không cần, và phản ứng quá muộn khi có thay đổi đột ngột. Cách thứ hai là theo chất lượng: huấn luyện lại khi chỉ số chất lượng giảm quá một ngưỡng. Cách này phản ứng đúng lúc cần, nhưng đòi hỏi có nhãn, nên bị giới hạn bởi độ trễ nhãn. Cách thứ ba là theo dịch chuyển: huấn luyện lại khi các phép kiểm tra ở Chương 9 báo động. Cách này không cần nhãn, nhưng như Mục 9.2 đã cho thấy, nó phát hiện được covariate shift mà không phát hiện được concept drift. Cách thứ tư là theo lượng dữ liệu: huấn luyện lại khi đã có đủ một số lượng mẫu mới. Cách này phù hợp khi dữ liệu tới không đều, nhưng không liên quan gì tới việc mô hình còn tốt hay không.
Trong thực tế, cấu hình thường gặp là huấn luyện lại theo lịch làm nền, cộng thêm kích hoạt theo chất lượng hoặc theo dịch chuyển để huấn luyện lại sớm khi cần. Shankar và cộng sự ghi nhận rằng nhiều nhóm chọn cách đơn giản hơn cả: huấn luyện lại thường xuyên trên dữ liệu mới nhất, có nhóm huấn luyện lại hằng ngày, thay vì xây dựng một cơ chế kích hoạt phức tạp.
11.3Huấn luyện lại từ đầu và cập nhật mô hình cũ#
Huyen (2022) phân biệt hai cách huấn luyện lại. Cách thứ nhất là huấn luyện lại từ đầu (stateless retraining): mỗi lần huấn luyện một mô hình mới hoàn toàn trên một cửa sổ dữ liệu, ví dụ ba tháng gần nhất. Cách thứ hai là huấn luyện có trạng thái (stateful training): tiếp tục cập nhật mô hình hiện có chỉ bằng dữ liệu mới.
Cập nhật mô hình cũ rẻ hơn nhiều cho mỗi lần, vì chỉ xử lý dữ liệu mới. Nhưng nó có hai nhược điểm khó thấy. Thứ nhất, trạng thái của mô hình phụ thuộc vào toàn bộ chuỗi cập nhật trước đó, nên rất khó tái lập; huấn luyện lại từ đầu thì dựng lại được chỉ từ dữ liệu, mã và hạt giống. Thứ hai, quay lui khó hơn: với huấn luyện lại từ đầu, chỉ cần nạp lại mô hình cũ, còn với cập nhật liên tục, muốn quay lại trạng thái trước một lô dữ liệu lỗi có thể phải phát lại cả lịch sử cập nhật. Ngoài ra, cập nhật liên tục có rủi ro quên thảm khốc (catastrophic forgetting), tức mô hình mất khả năng xử lý những gì đã học từ dữ liệu cũ, và một lô dữ liệu lỗi ảnh hưởng tới mọi phiên bản sau nó.
Vì vậy nên mặc định huấn luyện lại từ đầu, và chỉ chuyển sang cập nhật mô hình cũ khi có ràng buộc thật sự: dữ liệu quá lớn để huấn luyện lại toàn bộ, hoặc cần mô hình thích ứng trong vài phút. Khả năng tái lập và khả năng quay lui chỉ thể hiện giá trị khi có sự cố, nhưng khi đó chúng rất cần.
11.4Kiểm định trong pipeline huấn luyện lại#
Khi huấn luyện lại được tự động hoá, có một sai lầm nguy hiểm: để pipeline bỏ qua các bước kiểm định mà một lần phát hành thủ công phải qua. Một mô hình được huấn luyện lại tự động cũng là một mô hình mới, và phải đi qua đúng những bước như mọi mô hình mới khác:
dữ liệu mới
  → kiểm định dữ liệu              (Chương 3; nếu lỗi thì dừng, không huấn luyện)
  → huấn luyện
  → đánh giá trên tập kiểm tra cố định, theo lát cắt   (Chương 6)
  → so sánh với mô hình đang chạy  ← bước hay bị bỏ qua nhất
  → kiểm thử hành vi               (Mục 6.4)
  → đăng ký vào sổ đăng ký, trạng thái staging
  → shadow → canary → toàn bộ      (Chương 8)
Bước so sánh với mô hình đang chạy cần được nói riêng. Mục 2.3 đã nhắc rằng trong tám bước của pipeline theo tài liệu của Google Cloud, kiểm định mô hình (model validation) được tách khỏi đánh giá mô hình (model evaluation). Lý do là hai bước trả lời hai câu hỏi khác nhau: đánh giá cho biết mô hình mới tốt tới đâu, còn kiểm định quyết định có nên thay mô hình đang chạy bằng mô hình mới hay không. Một mô hình huấn luyện lại tự động có thể kém hơn mô hình đang chạy, trên tổng thể hoặc trên một lát cắt quan trọng, chẳng hạn vì dữ liệu tuần vừa qua có lỗi mềm chưa được phát hiện. Khi đó nó phải bị chặn tự động, không cần ai nhìn thấy.
Vì mọi bước đều tự động, cơ chế quay lui cũng phải tự động. Đây là mục Infra 7 của ML Test Score: có thể quay lui mô hình đang phục vụ nhanh và an toàn.
11.5Tóm tắt#
Mô hình cũ đi khi dữ liệu thay đổi; trong mô phỏng ở Mục 11.1, không huấn luyện lại thì sau một năm mất 13 điểm phần trăm độ chính xác, nhưng huấn luyện lại hằng quý đã lấy lại gần hết, nên nhịp huấn luyện lại là một quyết định kinh tế cần đo trên bài toán cụ thể. Có bốn cách kích hoạt huấn luyện lại: theo lịch, theo chất lượng, theo dịch chuyển và theo lượng dữ liệu, và thường được kết hợp. Nên mặc định huấn luyện lại từ đầu vì dễ tái lập và dễ quay lui. Khi tự động hoá, pipeline huấn luyện lại phải qua đủ các bước kiểm định như một lần phát hành thủ công, đặc biệt là bước so sánh với mô hình đang chạy.
Chương này giả định rằng dữ liệu mới phản ánh thế giới bên ngoài. Trong nhiều hệ thống, giả định đó không đúng: chính mô hình quyết định dữ liệu mới trông như thế nào. Chương 12 bàn về hiện tượng này.
12Vòng phản hồi#
Trong các chương trước, dữ liệu đến từ thế giới bên ngoài và mô hình chỉ quan sát nó. Ở nhiều hệ thống, điều đó không đúng. Một hệ thống gợi ý quyết định sản phẩm nào được hiển thị, và người dùng chỉ nhấp được vào những sản phẩm đã được hiển thị. Một mô hình chống gian lận chặn một số giao dịch, và ta không bao giờ biết các giao dịch bị chặn có thật sự gian lận không. Khi dự đoán của mô hình ảnh hưởng tới dữ liệu mà nó sẽ được huấn luyện lần sau, hệ thống có một vòng phản hồi (feedback loop).
12.1Vòng phản hồi trực tiếp và vòng phản hồi ẩn#
Sculley và cộng sự (2015) phân biệt hai loại vòng phản hồi. Trong vòng phản hồi trực tiếp (direct feedback loop), mô hình ảnh hưởng trực tiếp tới việc chọn dữ liệu huấn luyện tương lai của chính nó, như hệ thống gợi ý ở trên. Bài báo ghi nhận rằng về lý thuyết, cách giải đúng cho tình huống này là dùng thuật toán bandit, ví dụ contextual bandit, nhưng các thuật toán đó không phải lúc nào cũng mở rộng được tới kích thước không gian hành động của bài toán thực tế. Các cách giảm nhẹ khả thi hơn là thêm một mức ngẫu nhiên hoá vào quyết định của mô hình, hoặc tách riêng một phần dữ liệu không chịu ảnh hưởng của mô hình.
Trong vòng phản hồi ẩn (hidden feedback loop), hai hệ thống ảnh hưởng lẫn nhau một cách gián tiếp, qua thế giới bên ngoài. Ví dụ trong bài báo là hai hệ thống cùng quyết định nội dung của một trang web: một hệ thống chọn sản phẩm để hiển thị, hệ thống kia chọn các đánh giá liên quan. Cải thiện hệ thống thứ nhất làm người dùng nhấp nhiều hơn hoặc ít hơn vào phần của hệ thống thứ hai, và làm thay đổi dữ liệu huấn luyện của nó. Loại vòng phản hồi này khó phát hiện hơn nhiều, vì không có đường dữ liệu nào trong sơ đồ hệ thống cho thấy mối liên hệ giữa hai mô hình.
12.2Vòng phản hồi thoái hoá#
Trong thực tế, trường hợp gây hại nhiều nhất là vòng phản hồi thoái hoá (degenerate feedback loop), theo cách gọi của Huyen (2022): dự đoán ảnh hưởng tới phản hồi của người dùng, phản hồi được dùng làm nhãn cho lần huấn luyện sau, nên hệ thống tự củng cố những gì nó đã tin, kể cả khi điều đó sai.
Cơ chế này dễ thấy qua một hệ thống gợi ý. Giả sử ở vòng đầu, món A tình cờ được xếp cao hơn món B, dù chất lượng thật của hai món tương đương. A được hiển thị nhiều hơn nên nhận nhiều lượt nhấp hơn, chỉ vì được nhìn thấy nhiều hơn. Lần huấn luyện sau thấy A có nhiều lượt nhấp, nên xếp A cao hơn nữa. Dần dần B không còn được hiển thị, và vì không được hiển thị, B không có lượt nhấp nào để chứng tỏ nó cũng tốt.
Điều làm vòng phản hồi thoái hoá khó phát hiện là dữ liệu vẫn trông tốt. Tỉ lệ nhấp trên những gì được hiển thị vẫn cao, vì hệ thống chỉ hiển thị những gì nó tin là tốt, và các chỉ số ngoại tuyến tính trên dữ liệu log không cho thấy vấn đề gì.
12.3Mô phỏng một hệ thống gợi ý#
Để đo thiệt hại của vòng phản hồi, thí nghiệm trong code/mlops/experiments.py mô phỏng một hệ thống gợi ý với danh mục 2 000 món. Mỗi món có một chất lượng thật, tức xác suất người dùng nhấp khi thấy nó, lấy từ phân phối Beta(1,6; 9): phần lớn các món bình thường, chỉ ít món thật sự tốt. Hệ thống không biết các giá trị này. Nó khởi động bằng 200 lượt hiển thị ngẫu nhiên, sau đó lặp lại 30 vòng: xếp các món theo tỉ lệ nhấp đã quan sát, chọn 10 món đầu, hiển thị cho 3 000 người dùng, rồi cập nhật số liệu từ log nhấp của chính nó. Để so sánh, chiến lược ngẫu nhiên hoá với tham số thay vị trí trong danh sách bằng các món chọn ngẫu nhiên từ toàn bộ danh mục. Kết quả là trung bình của 20 lần chạy.
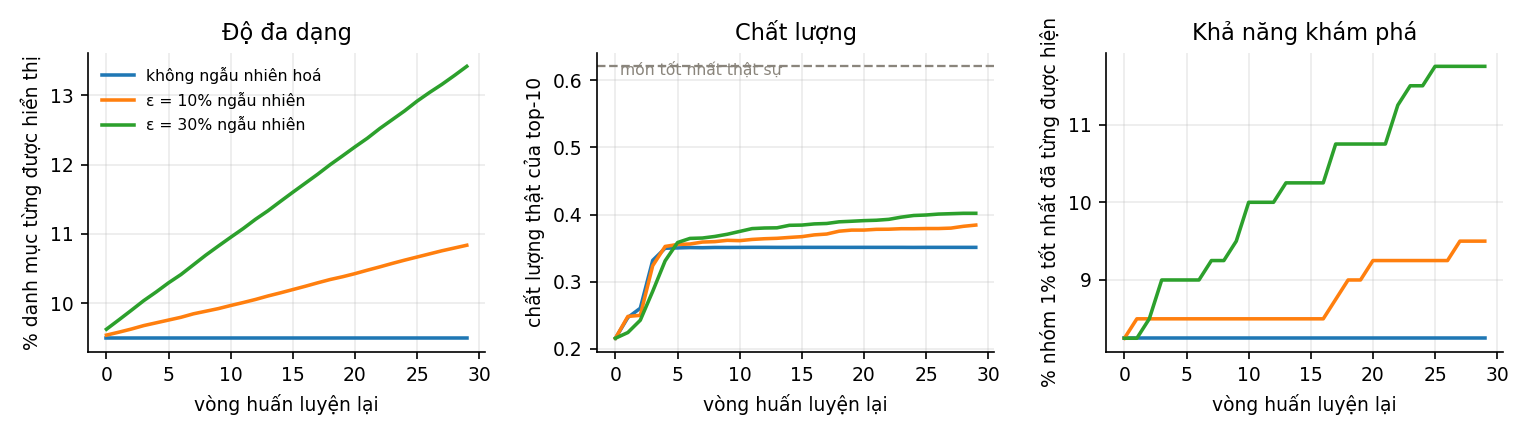
| Chiến lược | Tỉ lệ danh mục từng được hiển thị | Chất lượng thật của 10 món xếp đầu | Tỉ lệ nhóm 1% tốt nhất từng được hiển thị |
|---|---|---|---|
| Không ngẫu nhiên hoá | 9,5% | 0,351 | 8% |
| ε = 10% | 10,8% | 0,384 | 10% |
| ε = 30% | 13,4% | 0,402 | 12% |
Để có điểm so sánh: chất lượng trung bình của 10 món tốt nhất thật sự là 0,555, và chất lượng trung bình của toàn danh mục là 0,153.
Không ngẫu nhiên hoá, hệ thống đạt chất lượng 0,351, khoảng 63% mức tối đa, và trong suốt 30 vòng chỉ hiển thị 9,5% danh mục, đúng những món đã xuất hiện trong 200 lượt khởi động. Lý do nằm ở cách xếp hạng: những món chưa từng được hiển thị có tỉ lệ nhấp quan sát bằng 0, nên không bao giờ lọt vào danh sách. Hệ thống không hỏng theo nghĩa thông thường; nó chỉ không thể tốt hơn.
Dành 30% vị trí cho các món ngẫu nhiên nâng tỉ lệ danh mục được hiển thị từ 9,5% lên 13,4%, tức tăng 41% theo tỉ lệ tương đối, và nâng chất lượng của danh sách từ 0,351 lên 0,402, tức tăng khoảng 15%. Đổi lại, 30% số lượt hiển thị dành cho các món ngẫu nhiên có chất lượng trung bình chỉ 0,153. Đây là đánh đổi giữa khai thác (dùng những gì đã biết là tốt) và khám phá (thử những gì chưa biết), và cũng chính là "thêm một mức ngẫu nhiên hoá" mà Sculley và cộng sự đề xuất.
Mức cải thiện vẫn nhỏ so với khoảng cách tới mức tối đa. Với 30 vòng và chỉ 1 tới 3 vị trí ngẫu nhiên mỗi vòng, khám phá ngẫu nhiên đi rất chậm: sau 30 vòng, chiến lược mới gặp được 12% nhóm món tốt nhất. Các thuật toán bandit như UCB hay Thompson sampling hướng việc khám phá vào những món còn chưa chắc chắn thay vì chọn đều trên toàn danh mục, nên hiệu quả hơn nhiều. Bài 8 ở Chương 14 khảo sát thêm cách chọn khi tính cả chất lượng mà người dùng thực sự nhận được.
12.4Phát hiện và khắc phục#
Vòng phản hồi không để lại dấu vết trong các chỉ số chất lượng thông thường, nên cần theo dõi những tín hiệu khác. Tín hiệu thứ nhất là độ đa dạng giảm dần qua các vòng: entropy của phân phối hiển thị, số món khác nhau được hiển thị, tỉ lệ danh mục được hiển thị. Tín hiệu thứ hai là phân phối hiển thị lệch dần về một nhóm nhỏ, chẳng hạn tỉ trọng của 1% món được hiển thị nhiều nhất tăng đều. Tín hiệu thứ ba là các món mới thêm vào danh mục không bao giờ vào được danh sách đầu.
Có bốn cách khắc phục, xếp theo chi phí tăng dần. Cách rẻ nhất là ngẫu nhiên hoá một phần vị trí hiển thị như trong mô phỏng ở trên, hoặc dùng một thuật toán bandit. Cách thứ hai là giữ một nhóm đối chứng: một tỉ lệ nhỏ lưu lượng nhận kết quả ngẫu nhiên hoặc theo quy tắc đơn giản, không chịu ảnh hưởng của mô hình. Dữ liệu từ nhóm này không bị mô hình làm sai lệch, nên vừa dùng được để huấn luyện, vừa cho một thước đo đáng tin cậy về giá trị thật của hệ thống. Cách thứ ba là hiệu chỉnh theo xác suất hiển thị (inverse propensity weighting): khi huấn luyện, gán cho mỗi mẫu trọng số bằng nghịch đảo xác suất nó được hiển thị, để bù cho việc một số món được hiển thị nhiều hơn các món khác (Joachims và cộng sự, 2017). Cách này đòi hỏi ghi lại xác suất hiển thị ngay tại thời điểm hiển thị; nếu không ghi lại từ đầu thì không thể khôi phục về sau. Cách thứ tư dùng cho thiên lệch vị trí: khi huấn luyện, thêm vị trí hiển thị làm một đặc trưng để mô hình tách được phần lượt nhấp do vị trí gây ra; khi phục vụ, đặt vị trí bằng cùng một hằng số cho mọi món.
Trong bốn cách, nhóm đối chứng đáng được ưu tiên vì một nhóm nhỏ, duy trì thường xuyên, mang lại cả dữ liệu không bị sai lệch lẫn một thước đo trung thực.
12.5Tóm tắt#
Khi dự đoán của mô hình ảnh hưởng tới dữ liệu huấn luyện sau này, hệ thống có vòng phản hồi, trực tiếp hoặc ẩn. Vòng phản hồi thoái hoá làm hệ thống tự củng cố những gì nó đã tin: trong mô phỏng ở Mục 12.3, không ngẫu nhiên hoá thì hệ thống chỉ hiển thị 9,5% danh mục trong suốt 30 vòng và đạt 63% chất lượng tối đa. Vì dữ liệu vẫn trông tốt, cần theo dõi độ đa dạng của những gì được hiển thị. Ngẫu nhiên hoá, nhóm đối chứng, hiệu chỉnh theo xác suất hiển thị và đặc trưng vị trí là các cách khắc phục, trong đó nhóm đối chứng là cách đáng làm sớm nhất.
Mười hai chương đầu áp dụng cho mọi hệ thống học máy. Chương cuối xét một loại hệ thống đang phổ biến nhanh: ứng dụng dùng mô hình ngôn ngữ lớn, nơi nhiều giả định của các chương trước không còn đúng.
13Vận hành ứng dụng dùng mô hình ngôn ngữ lớn#
Khi một ứng dụng dùng mô hình ngôn ngữ lớn (LLM), phần lớn những gì đã trình bày vẫn đúng: vẫn cần hợp đồng dữ liệu, quản lý phiên bản, shadow và canary, giám sát và quay lui. Nhưng một số ràng buộc thay đổi, và việc vận hành loại hệ thống này thường được gọi riêng là LLMOps. Giáo trình Ứng dụng LLM trình bày cách xây dựng các ứng dụng đó; chương này xét chúng từ phía vận hành.
13.1Khác biệt so với hệ thống học máy thông thường#
Có năm ràng buộc thay đổi khi chuyển từ một mô hình tự huấn luyện sang một ứng dụng dùng LLM.
Ràng buộc đầu tiên là việc huấn luyện. Ứng dụng LLM thường dùng mô hình của bên thứ ba, nên thay cho huấn luyện lại là thay prompt, thay ngữ cảnh hoặc thay phiên bản mô hình. Ràng buộc thứ hai là đầu ra: thay vì một số hay một nhãn lớp, mô hình trả về văn bản tự do, và không có hàm đúng sai hiển nhiên để chấm nó. Ràng buộc thứ ba là tính tất định: ngoài yếu tố ngẫu nhiên khi lấy mẫu, mô hình của nhà cung cấp có thể thay đổi mà ứng dụng không hề biết. Ràng buộc thứ tư là chi phí: thay vì chủ yếu là chi phí huấn luyện, tương đối cố định, chi phí chính là suy luận tính theo token, thay đổi theo từng yêu cầu. Ràng buộc thứ năm là rủi ro: ngoài dự đoán sai còn có rò rỉ dữ liệu, nội dung có hại và prompt injection.
Ràng buộc thứ ba đáng chú ý nhất về mặt vận hành. Với mô hình tự huấn luyện, mô hình là một tạo tác bất biến nằm trong sổ đăng ký. Với mô hình gọi qua API, hành vi có thể thay đổi khi nhà cung cấp cập nhật mô hình mà vẫn giữ cùng tên gọi. Chen, Zaharia và Zou (2023) đo được những thay đổi đáng kể về hành vi của cùng một tên mô hình GPT-4 giữa hai phiên bản cách nhau ba tháng. Đây là dạng cực đoan của phụ thuộc dữ liệu không ổn định ở Mục 1.4, và cách xử lý cũng tương tự: dùng định danh phiên bản cố định của mô hình (các nhà cung cấp thường có tên kèm ngày phát hành), và coi mỗi lần đổi phiên bản là một lần phát hành đầy đủ, phải qua bộ đánh giá, shadow và canary.
13.2Đánh giá theo nhiều tầng#
Vì không có hàm đúng sai hiển nhiên, đánh giá là phần tốn kém nhất khi vận hành ứng dụng LLM. Cách tổ chức phổ biến là chia việc đánh giá thành ba tầng, đánh đổi giữa chi phí và độ tin cậy.
Tầng thứ nhất là kiểm tra theo quy tắc, áp dụng cho mọi lượt gọi với chi phí gần như bằng 0: đầu ra có đúng định dạng không, JSON có hợp lệ không, có trích dẫn không, độ dài có bất thường không, có từ khoá bị cấm không. Tầng thứ hai là dùng một mô hình ngôn ngữ làm giám khảo (LLM-as-a-judge) để chấm chất lượng nội dung, như câu trả lời có bám vào nguồn không, có hữu ích không, có đúng giọng văn không, có từ chối đúng lúc không. Tầng này tốn chi phí nên chỉ áp dụng cho một mẫu, thường từ vài phần trăm tới vài chục phần trăm số lượt gọi tuỳ lưu lượng; đây là mức thường gặp chứ không phải quy chuẩn. Tầng thứ ba là người chấm, trên một mẫu nhỏ và định kỳ. Tầng này đắt nhất, và dùng làm chuẩn để hiệu chỉnh giám khảo LLM.
Cấu trúc ba tầng này tương ứng với các lớp giám sát ở Mục 10.2: càng gần đánh giá thật thì càng đắt, nên phải lấy mẫu. Tầng thứ ba hay bị bỏ qua nhất, nhưng nó giữ cho cả hệ thống đánh giá đáng tin. Giám khảo LLM cũng là một mô hình, có sai số và có thể thay đổi theo phiên bản. Nếu không định kỳ đối chiếu với người chấm, hệ thống đánh giá có thể báo mọi thứ đều ổn trong khi chất lượng thực đã giảm. Chương 12 của Ứng dụng LLM trình bày chi tiết các loại đánh giá và cách tính số mẫu cần thiết.
13.3Thiên lệch của giám khảo LLM#
Zheng và cộng sự (2023), khi xây dựng bộ đánh giá MT-Bench, phân tích các thiên lệch của mô hình ngôn ngữ khi làm giám khảo. Có ba thiên lệch chính và một vấn đề về cách đặt câu hỏi.
Thiên lệch thứ nhất là thiên lệch vị trí: khi so sánh hai câu trả lời, giám khảo có xu hướng ưu tiên một vị trí, thường là câu trả lời đặt trước. Cách xử lý là hỏi hai lần với thứ tự đảo ngược, và chỉ tính là thắng khi thắng ở cả hai lần. Thiên lệch thứ hai là thiên lệch độ dài: câu trả lời dài hơn thường được chấm cao hơn dù không tốt hơn. Cách xử lý là đưa yêu cầu về độ dài vào tiêu chí chấm, hoặc so sánh các câu trả lời có độ dài tương đương. Thiên lệch thứ ba là khả năng giám khảo chấm cao hơn cho câu trả lời do chính nó sinh ra; các tác giả thấy dấu hiệu của hiện tượng này nhưng lưu ý rằng dữ liệu chưa đủ để kết luận chắc chắn. Cách xử lý thận trọng là dùng mô hình giám khảo khác họ với mô hình đang phục vụ. Cuối cùng, tiêu chí chấm mơ hồ như "câu trả lời này có tốt không" cho kết quả không ổn định; tiêu chí nên được chia thành nhiều chiều, mỗi chiều là một câu hỏi có hoặc không hoặc một thang điểm ngắn, kèm ví dụ mẫu.
Shankar và cộng sự (2024) ghi nhận thêm một hiện tượng khi xây dựng tiêu chí chấm: người dùng cần có tiêu chí để chấm đầu ra, nhưng chính việc đọc và chấm đầu ra lại làm họ thay đổi tiêu chí. Các tác giả gọi hiện tượng này là criteria drift. Hệ quả thực tế là không thể viết xong tiêu chí chấm một lần ngay từ đầu; cần đọc một lượng đầu ra thật trước, và xem lại tiêu chí định kỳ.
Nguyên tắc chung cho mọi giám khảo LLM là đo mức đồng thuận giữa nó và người chấm trên cùng một tập mẫu, ví dụ bằng hệ số kappa của Cohen, và coi đó là giới hạn trên cho độ tin cậy của mọi kết luận rút ra từ giám khảo. Lập luận này giống với lập luận về mức đồng thuận giữa những người gán nhãn ở Mục 3.5.
13.4Đánh giá ngoại tuyến và trực tuyến#
Việc đánh giá thường được tổ chức thành hai vòng. Vòng ngoại tuyến dùng một tập đánh giá chuẩn (golden set): một tập câu hỏi được chọn lọc, gồm cả những trường hợp khó, mà hệ thống phải đạt trước mỗi lần phát hành. Đây là bước kiểm định trong CI, tương đương với bước so sánh với mô hình đang chạy ở Mục 11.4; Mục 12.5 của Ứng dụng LLM trình bày cách kiểm thử hồi quy cho prompt. Vòng trực tuyến chấm bất đồng bộ một tỉ lệ nhỏ số lượt gọi thật, và gắn điểm vào bản ghi vết (trace) tương ứng (Chương 13 của Ứng dụng LLM).
Tập đánh giá chuẩn phải được cập nhật liên tục. Shankar và cộng sự (2022) ghi nhận thực hành này cho học máy nói chung: tập kiểm định nên thay đổi theo thời gian, và mỗi sự cố trong sản xuất nên trở thành một trường hợp mới trong tập kiểm định. Một tập đánh giá không được cập nhật dần dần chỉ còn đo những gì hệ thống đã làm đúng.
13.5Hệ thống RAG#
Với hệ thống RAG (retrieval-augmented generation), một câu trả lời sai có thể do hai nguyên nhân khác nhau, và mỗi nguyên nhân cần một cách sửa khác. Nếu tài liệu cần thiết không có trong ngữ cảnh, lỗi nằm ở bước truy xuất; nó được đo bằng recall@ hay MRR trên một tập câu hỏi có nhãn tài liệu đúng, và được sửa bằng cách cải thiện việc chia đoạn, mô hình embedding, tìm kiếm kết hợp hay xếp hạng lại. Nếu tài liệu cần thiết có trong ngữ cảnh mà câu trả lời vẫn sai, lỗi nằm ở bước sinh; nó được đo bằng độ trung thành (faithfulness), tức các khẳng định trong câu trả lời có được ngữ cảnh hỗ trợ không, và được sửa bằng prompt, bằng mô hình khác, hoặc bằng cách yêu cầu trích dẫn.
Phân biệt hai nguyên nhân này là bước chẩn đoán đầu tiên cho mọi lỗi của hệ thống RAG; gộp chúng vào một chỉ số duy nhất thì không biết cần sửa ở đâu. Es và cộng sự (2023), với thư viện RAGAS, đề xuất theo dõi ba chỉ số: độ trung thành của câu trả lời với ngữ cảnh, mức liên quan của câu trả lời với câu hỏi, và mức liên quan của ngữ cảnh với câu hỏi. Thí nghiệm ở Mục 8.5 của Ứng dụng LLM cho một ví dụ vì sao bước truy xuất cần được theo dõi riêng: ở những câu hỏi mà truy xuất không đưa về đoạn nào thuộc đúng chương, độ chính xác giảm từ 0,586 khi không có ngữ cảnh xuống 0,276 khi có ngữ cảnh sai.
Hệ thống RAG còn có ba vấn đề vận hành riêng. Vấn đề thứ nhất là độ mới của chỉ mục: kho tài liệu thay đổi (thêm tài liệu, sửa, xoá), nên chỉ mục phải được cập nhật, và cần theo dõi khoảng thời gian từ lúc tài liệu thay đổi tới lúc chỉ mục phản ánh thay đổi đó. Vấn đề thứ hai là đổi mô hình embedding đòi hỏi lập chỉ mục lại toàn bộ, vì vector của hai mô hình embedding khác nhau không so sánh được với nhau. Việc đổi mô hình embedding nên được làm như một lần chuyển dữ liệu: lập chỉ mục mới song song, đánh giá, rồi mới chuyển. Vấn đề thứ ba là quyền truy cập: bước truy xuất phải lọc theo quyền của người hỏi; nếu không, hệ thống có thể trả lời bằng nội dung lấy từ tài liệu mà người hỏi không được phép xem.
13.6Chi phí và độ trễ#
Chi phí là phần khác nhiều nhất so với hệ thống học máy thông thường, vì nó thay đổi theo từng yêu cầu. Chi phí cần được ghi lại theo từng bản ghi vết và tách thành các thành phần:
chi phí một lượt = (số token vào × đơn giá token vào) + (số token ra × đơn giá token ra)
                 + chi phí các lượt gọi giám khảo LLM      ← ghi thành một dòng riêng
                 + chi phí truy xuất (embedding + tìm kiếm vector)
Ghi riêng chi phí của giám khảo giúp biết chi phí tăng vì lưu lượng tăng hay vì tỉ lệ lấy mẫu đánh giá tăng.
Để giảm chi phí, nên thử theo thứ tự sau. Trước hết là bộ nhớ đệm (cache): lưu kết quả cho các câu hỏi lặp lại chính xác, cho các câu hỏi gần giống (semantic cache), và lưu đệm phần đầu cố định của prompt (prompt caching; Mục 4.6 của Ứng dụng LLM). Tiếp theo là định tuyến (routing): gửi câu hỏi dễ tới mô hình nhỏ và rẻ, chỉ gửi câu hỏi khó tới mô hình lớn; cách này cần một bộ phân loại độ khó, và bộ phân loại đó cũng là một mô hình phải được giám sát. Cuối cùng là giảm ngữ cảnh, như bớt số đoạn truy xuất hay tóm tắt lịch sử hội thoại. Chi phí tỉ lệ với số token đầu vào, và ngữ cảnh thường chiếm phần lớn số token đó: trong thí nghiệm RAG ở Mục 8.5 của Ứng dụng LLM, hai đoạn ngữ cảnh làm số token đầu vào tăng từ 137 lên 813.
Về độ trễ, ứng dụng LLM có hai chỉ số riêng. Thời gian tới token đầu tiên (time to first token) quyết định cảm nhận về độ nhanh khi câu trả lời bắt đầu hiện ra, còn thời gian giữa các token quyết định tốc độ hiện ra của phần còn lại (Mục 2.5 của Ứng dụng LLM). Phân tích phần đuôi ở Mục 7.3 vẫn áp dụng. Một agent gọi mô hình và công cụ qua bước nối tiếp có thời gian trả lời bằng tổng thời gian các bước, và nếu mỗi bước chậm với xác suất 1% thì xác suất gặp ít nhất một bước chậm vẫn là .
13.7Rào chắn#
Rào chắn (guardrails) là các phép kiểm tra chạy quanh lượt gọi mô hình. Ở đầu vào, chúng phát hiện prompt injection, phát hiện và che dữ liệu cá nhân, chặn những yêu cầu nằm ngoài phạm vi của ứng dụng, và giới hạn tần suất gọi của mỗi người dùng. Ở đầu ra, chúng kiểm tra định dạng (JSON hợp lệ, đúng lược đồ), phát hiện nội dung có hại, kiểm tra câu trả lời có bám vào nguồn với hệ thống RAG, và áp đặt giới hạn hành động (Mục 10.4).
Giới hạn hành động cần được nhấn mạnh. Với một agent có quyền gọi các công cụ có tác động thật, như gửi email, hoàn tiền hay sửa dữ liệu, cơ chế giới hạn hành động của Sculley và cộng sự áp dụng nguyên vẹn: đặt giới hạn cho số hành động mỗi loại trong mỗi khoảng thời gian, và khi chạm giới hạn thì dừng lại, chuyển cho người xử lý. Một mô hình ngôn ngữ trả lời sai mà có quyền hoàn tiền gây hậu quả lớn hơn nhiều so với một mô hình chấm điểm sai. Chương 11 của Ứng dụng LLM trình bày chi tiết về prompt injection, dữ liệu nhạy cảm và rào chắn nội dung.
13.8Quản lý phiên bản#
Yếu tố phiên bản ở Mục 2.2 áp dụng cho ứng dụng LLM với một danh sách dài hơn. Một phiên bản của ứng dụng gồm ít nhất: prompt, kể cả prompt hệ thống và các ví dụ few-shot (Mục 4.7 của Ứng dụng LLM); phiên bản mô hình và các tham số sinh như nhiệt độ, top-p, số token tối đa; cấu hình truy xuất gồm mô hình embedding, cách chia đoạn, số đoạn , bộ xếp hạng lại; ảnh chụp của kho tài liệu, tức chỉ mục được lập vào thời điểm nào; định nghĩa các công cụ mà agent được phép gọi; và tiêu chí chấm cùng tập đánh giá chuẩn đã dùng để duyệt phiên bản.
Thay đổi bất kỳ thành phần nào trong số đó là tạo ra một phiên bản mới và cần đánh giá lại. Đây là nguyên lý CACE ở Mục 1.3 áp dụng cho ứng dụng LLM: prompt, mô hình, kho tài liệu và công cụ phụ thuộc lẫn nhau, nên thay đổi một thành phần có thể thay đổi hành vi của cả hệ thống.
13.9Tóm tắt#
Vận hành ứng dụng LLM giữ nguyên phần lớn nguyên tắc của các chương trước, nhưng có năm ràng buộc mới: không tự huấn luyện, đầu ra là văn bản tự do, mô hình của nhà cung cấp có thể thay đổi, chi phí tính theo token và có thêm rủi ro về nội dung. Đánh giá được chia thành ba tầng, kiểm tra theo quy tắc, giám khảo LLM và người chấm, trong đó giám khảo LLM có các thiên lệch đã biết và phải được đối chiếu định kỳ với người. Với hệ thống RAG, lỗi truy xuất và lỗi sinh cần được tách riêng. Chi phí cần được ghi theo từng thành phần, rào chắn cần có giới hạn hành động khi agent có quyền tác động thật, và mỗi thay đổi của prompt, mô hình, kho tài liệu hay công cụ là một phiên bản mới.
Đây là chương cuối của phần lý thuyết. Các chương sau gồm bài tập để luyện tập các phép tính và thiết kế đã gặp, câu hỏi phỏng vấn để ôn lại toàn bộ giáo trình, và danh sách tài liệu tham khảo.
14Bài tập#
Các bài tập đi theo thứ tự các chương: bốn bài đầu là phép tính tay về PSI, cỡ mẫu A/B test, phần đuôi độ trễ và ghép theo thời điểm; các bài sau là phân loại, thí nghiệm và thiết kế. Lời giải chi tiết nằm ở trang Lời giải; số liệu trong lời giải của Bài 1, 2, 3, 4, 7 và 8 được sinh bởi code/mlops/bai_tap.py.
Bài 1 (tính tay). Một hệ thống giám sát dịch chuyển bằng PSI với bin; mỗi ngày lấy mẫu cho cả tập tham chiếu và tập hiện tại. (a) Tính PSI kỳ vọng khi không có dịch chuyển nào. (b) Hệ thống cảnh báo khi PSI vượt 0,10 và theo dõi 200 đặc trưng. Khi không có dịch chuyển, trung bình mỗi ngày có bao nhiêu cảnh báo giả? (c) Cần tối thiểu bằng bao nhiêu để PSI kỳ vọng khi không có dịch chuyển nhỏ hơn 0,01? Gợi ý: dùng kết quả ở Mục 9.5.
Bài 2 (tính tay). Tỉ lệ chuyển đổi nền là 2%. Cần phát hiện một cải thiện tương đối 5% với hai phía và lực kiểm định 80%. (a) Tính cỡ mẫu mỗi nhánh. (b) Mỗi nhánh nhận 40 000 lượt mỗi ngày. Thí nghiệm phải chạy bao lâu? (c) Cần rút thời gian xuống một nửa mà không giảm lực kiểm định. Nêu các cách hợp lệ, và chỉ ra những cách nghe hợp lý nhưng không hợp lệ. Gợi ý: công thức ở Mục 8.4, với và .
Bài 3 (tính tay). Một yêu cầu xếp hạng gọi song song 25 dịch vụ đặc trưng và phải đợi đủ 25 kết quả mới trả lời. Mỗi dịch vụ có p99 bằng 80 ms, và các dịch vụ độc lập với nhau. (a) Tính tỉ lệ yêu cầu gặp ít nhất một dịch vụ chậm hơn 80 ms. (b) Để p99 của cả yêu cầu bằng 80 ms, mỗi dịch vụ phải đạt phân vị nào? (c) Nêu hai cách giảm phần đuôi mà không cần làm từng dịch vụ nhanh hơn.
Bài 4 (suy luận). Cho bảng lịch sử đặc trưng và bảng nhãn dưới đây. Viết tập huấn luyện đúng theo thời điểm; chỉ ra tập huấn luyện sai mà một phép JOIN thông thường tạo ra, và cho biết mô hình sẽ học sai điều gì.
| user_id | valid_from | tong_don_hang |
|---|---|---|
| 7 | 2026-01-01 | 3 |
| 7 | 2026-03-01 | 19 |
| 7 | 2026-06-01 | 52 |
| user_id | event_time | nhan |
|---|---|---|
| 7 | 2026-02-10 | 0 |
| 7 | 2026-04-15 | 1 |
Bài 5 (phân loại). Xếp mỗi tình huống vào covariate shift, label shift hay concept drift, và cho biết có phát hiện được chỉ bằng cách giám sát hay không: (a) Một chiến dịch quảng cáo thu hút nhiều người dùng dưới 25 tuổi. (b) Ngân hàng đổi định nghĩa "nợ xấu" từ quá hạn 90 ngày thành quá hạn 60 ngày. (c) Mùa mua sắm cuối năm làm tỉ lệ giao dịch gian lận tăng gấp ba, nhưng cách gian lận không đổi. (d) Một đối thủ ra mắt tính năng mới, làm thay đổi kỳ vọng của người dùng về một kết quả tìm kiếm tốt. Gợi ý: xem lại bảng ở Mục 9.2.
Bài 6 (ML Test Score). Một nhóm có: lược đồ đặc trưng đầy đủ và kiểm thử đơn vị cho toàn bộ mã tính đặc trưng, chạy tự động; huấn luyện tái lập được và kiểm thử tích hợp toàn pipeline, chạy tự động; canary và quay lui tự động. Về giám sát, nhóm chỉ có một biểu đồ độ trễ để xem khi cần, không có cảnh báo tự động và không có mục nào khác thuộc nhóm giám sát. Đề bài không nói gì về các mục của nhóm phát triển mô hình. (a) Tính điểm ML Test Score của nhóm và giải thích vì sao quy tắc lấy giá trị nhỏ nhất cho ra con số đó. (b) Nhóm nên làm gì đầu tiên để tăng điểm?
Bài 7 (thí nghiệm). Sửa phần (G) của code/mlops/experiments.py để chạy với ba tốc độ dịch chuyển 0,010, 0,035 và 0,080 radian mỗi tuần, và thêm nhịp huấn luyện lại 2 tuần một lần. Với mỗi tốc độ, tìm nhịp thưa nhất mà độ chính xác trung bình không kém nhịp hằng tuần quá 1 điểm phần trăm. Rút ra quan hệ giữa tốc độ dịch chuyển và nhịp huấn luyện lại hợp lý.
Bài 8 (thí nghiệm). Trong phần (H) của code/mlops/experiments.py, cho chạy từ 0 tới 0,5 với bước 0,1 (tức từ 0 tới 5 vị trí ngẫu nhiên trong danh sách 10 món). Với mỗi , đo hai đại lượng: chất lượng thật của 10 món mà hệ thống xếp đầu ở vòng cuối, và chất lượng thật trung bình của các món đã thực sự hiển thị cho người dùng.
(a) Theo mỗi đại lượng, có giá trị tốt nhất không? Giải thích hình dạng của các đường cong.
(b) Điều gì thay đổi khi số vòng tăng từ 30 lên 300?
Bài 9 (thiết kế). Thiết kế hệ thống giám sát cho một mô hình phát hiện gian lận có độ trễ nhãn 30 ngày (tranh chấp giao dịch mất một tháng mới được xác nhận). Nêu rõ: giám sát gì ở mỗi lớp trong bốn lớp ở Mục 10.2; chỉ số nào đủ quan trọng để gọi người trực lúc nửa đêm; và phát hiện concept drift bằng cách nào khi nhãn đến trễ một tháng.
Bài 10 (thiết kế, LLM). Thiết kế quy trình đánh giá cho một trợ lý hỏi đáp dùng RAG trên tài liệu nội bộ của công ty, với 50 000 lượt hỏi mỗi ngày và ngân sách đánh giá bằng 3% chi phí suy luận. Nêu rõ: ba tầng đánh giá và tỉ lệ lấy mẫu của từng tầng; cách tách lỗi truy xuất khỏi lỗi sinh; và cách phát hiện khi chính giám khảo LLM thay đổi hành vi.
15Câu hỏi phỏng vấn#
Chương này không thêm kiến thức mới. Nó gom các nội dung của giáo trình thành những câu hỏi thường gặp khi phỏng vấn cho vị trí kỹ sư học máy hoặc kỹ sư MLOps, kèm cách trả lời mà một người đã hiểu kỹ vấn đề thường đưa ra.
15.1Cách trả lời#
Phần lớn câu hỏi về MLOps là câu hỏi mở, và người phỏng vấn quan tâm tới cách lập luận hơn là danh sách công cụ. Một câu trả lời tốt thường bắt đầu bằng việc nêu ràng buộc của bài toán, chẳng hạn "điều này phụ thuộc vào độ trễ nhãn" hay "phụ thuộc vào số mô hình dùng chung đặc trưng", vì nêu đúng ràng buộc cho thấy người trả lời hiểu bài toán. Sau đó là các lựa chọn và đánh đổi giữa chúng, rồi một lựa chọn cụ thể kèm lý do, thay vì dừng ở "còn tuỳ trường hợp". Cuối cùng là cách đo để biết lựa chọn đó có đúng không. Một con số cụ thể, như các số liệu đo được trong giáo trình, làm câu trả lời thuyết phục hơn nhiều so với một nhận định chung.
15.2Nền tảng#
Câu hỏi: MLOps là gì, và khác DevOps ở điểm nào?
Trả lời
DevOps quản lý một loại tạo tác là mã nguồn, và hệ thống chỉ thay đổi khi có người sửa mã. MLOps phải quản lý ba loại tạo tác thay đổi theo ba nhịp khác nhau: mã, dữ liệu và mô hình. Trong đó dữ liệu thay đổi theo thế giới bên ngoài mà không đi qua kho mã, nên ngoài CI/CD, hệ thống học máy cần thêm huấn luyện liên tục. Một khác biệt nữa nằm ở cách hệ thống hỏng: phần mềm thông thường thường báo lỗi khi có sự cố, còn mô hình nhận đầu vào đã thay đổi vẫn trả về kết quả đúng kiểu, đúng thời hạn, chỉ có điều kết quả đó sai. Vì vậy MLOps cần các cơ chế giám sát riêng.
Câu hỏi: Vì sao một mô hình tốt khi đánh giá lại suy giảm sau khi triển khai?
Trả lời
Thường do một trong bốn nguyên nhân. Đặc trưng lúc phục vụ được tính khác lúc huấn luyện, gọi là lệch huấn luyện–phục vụ. Dữ liệu thay đổi theo thời gian, gọi là dịch chuyển phân phối. Một hệ thống phía trước cung cấp dữ liệu thay đổi mà không thông báo, gọi là phụ thuộc dữ liệu không ổn định. Hoặc mô hình làm sai lệch chính dữ liệu huấn luyện của nó qua vòng phản hồi. Những nguyên nhân này khó phòng vì nguyên lý CACE: trong một mô hình, thay đổi bất kỳ thành phần nào cũng có thể thay đổi toàn bộ hành vi, nên không thể sửa cục bộ rồi yên tâm như với một hàm trong phần mềm thông thường.
Câu hỏi: Con số "5% mã học máy" nghĩa là gì?
Trả lời
Nó đến từ bài báo về nợ kỹ thuật của Sculley và cộng sự (2015), nằm trong phần bàn về mã keo chứ không phải chú thích của hình vẽ hay được trích dẫn. Bài báo nói một hệ thống trưởng thành có thể chỉ gồm nhiều nhất 5% mã học máy và ít nhất 95% mã keo; đây là nhận định định tính, không phải kết quả đo. Kết luận bài báo rút ra từ đó là đôi khi tự viết một giải pháp gọn còn rẻ hơn dùng lại một thư viện đa dụng, và nên bọc các thư viện sau một giao diện chung.
Câu hỏi: Các mức trưởng thành của MLOps là gì?
Trả lời
Theo kiến trúc tham chiếu của Google Cloud có ba mức. Ở mức 0, mọi bước làm bằng tay và thứ được bàn giao là một tệp mô hình. Ở mức 1, pipeline huấn luyện được tự động hoá và có huấn luyện liên tục, nên thứ được bàn giao là cả pipeline. Ở mức 2, chính pipeline có CI/CD, nên thứ được bàn giao là một hệ thống tự cập nhật. Tôi sẽ nói thêm rằng tự động hoá không thay thế được giám sát: một hệ thống ở mức 1 mà không có giám sát chỉ triển khai nhanh hơn, kể cả khi triển khai một mô hình đã hỏng.
15.3Dữ liệu và đặc trưng#
Câu hỏi: Lệch giữa huấn luyện và phục vụ là gì, và làm sao tránh?
Trả lời
Đó là khi đặc trưng lúc phục vụ được tính khác với lúc huấn luyện. Nguyên nhân thường gặp là có hai bản cài đặt: một truy vấn SQL trên kho dữ liệu khi huấn luyện, và một đoạn mã viết lại trong dịch vụ phục vụ cho đủ nhanh. Hai bản do hai người viết thì hiếm khi khớp hoàn toàn. Cách tránh là dùng một định nghĩa đặc trưng duy nhất cho cả hai nơi, đóng gói hàm biến đổi cùng mô hình, và đo độ lệch bằng cách so giá trị đặc trưng ở hai nơi trên cùng lưu lượng; đây là mục Monitor 3 của ML Test Score, và chạy shadow là cách rẻ nhất để đo nó.
Câu hỏi: Tính đúng theo thời điểm là gì?
Trả lời
Với mỗi dòng huấn luyện có thời điểm dự đoán , giá trị mọi đặc trưng phải là giá trị quan sát được tại , không phải giá trị tại lúc dựng tập dữ liệu. Ví dụ, một dòng của tháng 3 phải dùng tổng số đơn hàng của khách tại tháng 3. Nếu dùng con số hôm nay, mô hình học rằng khách có 480 đơn hàng thì không rời bỏ dịch vụ, trong khi con số 480 chỉ có được vì khách đã ở lại. Lỗi này nguy hiểm vì nó làm kết quả đánh giá ngoại tuyến tốt lên, nên không ai nghi ngờ cho tới khi mô hình chạy thật. Cách tránh là ghép dữ liệu theo thời điểm (as-of join) và thêm ràng buộc "không có sự kiện từ tương lai" vào hợp đồng dữ liệu.
Câu hỏi: Khi nào nên dùng kho đặc trưng?
Trả lời
Khi có đồng thời ba điều kiện: nhiều mô hình dùng chung đặc trưng, cần phục vụ trực tuyến với độ trễ thấp, và đặc trưng thay đổi theo thời gian. Thiếu các điều kiện đó, một bảng trong kho dữ liệu cộng với kỷ luật dùng chung một hàm biến đổi là đủ và rẻ hơn nhiều. Cũng cần biết rằng kho đặc trưng không tự động loại bỏ lệch huấn luyện–phục vụ; nếu nhóm vẫn viết một đường tính riêng cho phục vụ thì sự lệch quay lại.
Câu hỏi: Làm sao phát hiện dữ liệu có vấn đề?
Trả lời
Tôi chia lỗi dữ liệu thành ba loại với ba cách phản ứng. Lỗi cứng như sai lược đồ hay giá trị ngoài miền thì dừng pipeline. Lỗi mềm như thiếu một phần dữ liệu, đổi đơn vị hay giá trị danh mục lạ thì cảnh báo và theo dõi tỉ lệ. Dịch chuyển phân phối thì điều tra và có thể huấn luyện lại. Các kiểm tra được viết thành hợp đồng dữ liệu, suy ra từ dữ liệu tham chiếu rồi có người duyệt lại, và chạy ở cả đầu vào lẫn đầu ra của mỗi bước pipeline. Dùng chung một cơ chế cảnh báo cho cả ba loại lỗi là nguyên nhân phổ biến của báo động giả.
15.4Đánh giá và triển khai#
Câu hỏi: Vì sao không nên đánh giá mô hình chỉ bằng một chỉ số tổng thể?
Trả lời
Vì chỉ số tổng thể là trung bình theo lưu lượng, nên nhóm đa số quyết định kết quả. Trong thí nghiệm ở Mục 6.3, thêm một đặc trưng làm độ chính xác tổng thể tăng 19,8 điểm phần trăm, nhóm khách hàng cũ tăng 25,5 điểm, nhưng nhóm 15% khách hàng mới giảm 11,6 điểm, xuống dưới cả mô hình cũ. Lý do là đặc trưng mới chỉ có thông tin với khách hàng cũ, nên với khách hàng mới, trọng số lớn của nó đưa nhiễu vào dự đoán. Vì vậy cần đánh giá theo lát cắt, cùng với kiểm thử hành vi trên những trường hợp cụ thể.
Câu hỏi: Shadow, canary và A/B test khác nhau thế nào?
Trả lời
Mỗi cách trả lời một câu hỏi khác. Shadow cho biết mô hình mới có chịu được tải thật không và đặc trưng có khớp với lúc huấn luyện không, mà người dùng không chịu rủi ro nào; nhưng nó không cho biết người dùng phản ứng ra sao. Canary cho biết có chỉ số vận hành nào xấu đi ở quy mô nhỏ không, và giới hạn phạm vi ảnh hưởng nếu có sự cố. A/B test cho biết mô hình mới có làm chỉ số sản phẩm tốt lên theo nghĩa nhân quả không. Một điểm hay bị nhầm là dùng canary để kết luận về chỉ số sản phẩm: ở 1% lưu lượng thì không đủ mẫu.
Câu hỏi: Vì sao không thể A/B test mọi thay đổi?
Trả lời
Vì lưu lượng có hạn, và cỡ mẫu cần thiết tỉ lệ nghịch với bình phương mức cải thiện cần phát hiện. Với tỉ lệ nền 5%, phát hiện một cải thiện tương đối 1% với lực kiểm định 80% cần khoảng 3 triệu mẫu mỗi nhánh, tức khoảng một tháng nếu mỗi nhánh có 100 000 lượt mỗi ngày. Vì vậy quy trình tốt loại các ý tưởng kém bằng những cách rẻ hơn, như đánh giá ngoại tuyến và shadow, trước khi dùng lưu lượng cho A/B test. Nếu cần rút ngắn thí nghiệm mà không giảm độ tin cậy, có thể giảm phương sai bằng CUPED.
Câu hỏi: Khi đọc kết quả A/B test, cần tránh những sai sót nào?
Trả lời
Sai sót phổ biến nhất là xem kết quả giữa chừng rồi dừng khi thấy , làm tỉ lệ dương tính giả tăng; nên cố định cỡ mẫu trước hoặc dùng kiểm định tuần tự. Tiếp theo là so sánh nhiều chỉ số cùng lúc; nên khai báo trước một chỉ số chính. Trong mạng xã hội hay sàn giao dịch, hai nhánh có thể ảnh hưởng lẫn nhau, nên cần chia ngẫu nhiên theo cụm. Trước khi đọc kết quả, tôi kiểm tra tỉ lệ mẫu giữa hai nhánh có đúng thiết kế không, vì tỉ lệ mẫu lệch là dấu hiệu thí nghiệm có lỗi. Cuối cùng là hiệu ứng mới lạ, nên thí nghiệm cần chạy đủ lâu.
Câu hỏi: ML Test Score được tính thế nào?
Trả lời
Bộ tiêu chí gồm 28 mục chia đều thành bốn nhóm: dữ liệu, phát triển mô hình, hạ tầng, giám sát. Mỗi mục được 0,5 điểm nếu làm thủ công có ghi lại kết quả, 1 điểm nếu có hệ thống chạy tự động và định kỳ. Điểm mỗi nhóm là tổng điểm các mục, còn điểm cuối cùng là giá trị nhỏ nhất trong bốn nhóm. Lấy giá trị nhỏ nhất vì cả bốn nhóm đều cần thiết: một hệ thống có hạ tầng hoàn hảo mà không có giám sát vẫn có điểm 0.
15.5Giám sát và dịch chuyển#
Câu hỏi: Có những loại dịch chuyển phân phối nào?
Trả lời
Ba loại chính. Covariate shift là khi thay đổi mà giữ nguyên. Label shift là khi thay đổi mà giữ nguyên. Concept drift là khi chính quan hệ thay đổi. Hai loại đầu thường làm phân phối của thay đổi; concept drift thì không nhất thiết.
Câu hỏi: Loại dịch chuyển nào phát hiện được khi chưa có nhãn?
Trả lời
Covariate shift và label shift, vì cả hai làm phân phối của thay đổi. Concept drift có thể giữ nguyên , nên không phép kiểm tra nào chỉ dựa trên phát hiện được nó. Trong thí nghiệm ở Mục 9.2, concept drift làm độ chính xác giảm từ 75,6% xuống 26,9% trong khi kiểm định KS trên các đặc trưng cho . Ngược lại, covariate shift cho p-value gần bằng 0 mà độ chính xác gần như không đổi, nên nếu cảnh báo dựa trên thì đó là báo động giả. Từ đó, khi thiết kế giám sát, câu hỏi đầu tiên của tôi là sau bao lâu thì có nhãn thật.
Câu hỏi: Nên dùng ngưỡng PSI nào?
Trả lời
PSI là tổng hai chiều của phân kỳ KL giữa hai phân phối đã chia bin. Các ngưỡng 0,10 và 0,25 là quy tắc kinh nghiệm từ chấm điểm tín dụng và không tính tới cỡ mẫu hay số bin. Khi hai mẫu cùng phân phối, PSI có kỳ vọng xấp xỉ , nên với và 20 bin, PSI trung bình đã là 0,205 dù không có dịch chuyển nào. Trong mô phỏng ở Mục 9.5, với quy tắc PSI > 0,25 báo động 73% số lần khi không có dịch chuyển, còn với và dịch chuyển thật 0,3 độ lệch chuẩn thì nó không báo động lần nào. Tôi sẽ dùng kiểm định có p-value kèm hiệu chỉnh cho kiểm định nhiều lần; nếu buộc phải dùng PSI, tôi tính ngưỡng theo đúng và , ví dụ , và giữ , cố định giữa các lần đo.
Câu hỏi: Khi chưa có nhãn thì giám sát gì?
Trả lời
Tôi chia việc giám sát thành bốn lớp theo khoảng cách tới nhãn: dữ liệu thô, đặc trưng, dự đoán và chất lượng. Khi chưa có nhãn, lớp dự đoán là lớp chính: phân phối điểm số, tỉ lệ từng lớp, và độ lệch dự đoán so với tỉ lệ nền lịch sử, tính theo lát cắt. Độ lệch dự đoán không đủ để khẳng định mô hình đúng, vì một mô hình luôn dự đoán tỉ lệ trung bình cũng có độ lệch bằng 0, nhưng thay đổi đột ngột của nó thường là dấu hiệu sự cố. Với hệ thống có hành động thật, tôi thêm giới hạn hành động: đặt trần cho số hành động trong mỗi khoảng thời gian và cảnh báo khi chạm trần.
Câu hỏi: Vì sao cảnh báo hay bị bỏ qua, và nên thiết kế cảnh báo thế nào?
Trả lời
Vì báo động giả: khi phần lớn cảnh báo là giả, người nhận mất niềm tin và bỏ qua cả cảnh báo thật. Để tránh, mỗi cảnh báo phải gắn với một hành động cụ thể; cảnh báo được phân mức, từ gọi người trực, tạo phiếu xử lý, tới chỉ hiển thị trên bảng theo dõi; cảnh báo dựa trên triệu chứng như tỉ lệ chuyển đổi giảm, không dựa trên nguyên nhân như PSI của một đặc trưng; và chỉ báo động khi tín hiệu kéo dài qua nhiều cửa sổ liên tiếp.
15.6Thiết kế hệ thống#
Với câu hỏi dạng "thiết kế hệ thống học máy cho bài toán X", có thể đi theo trình tự của giáo trình để không bỏ sót. Bắt đầu bằng việc làm rõ bài toán: chỉ số sản phẩm là gì, chỉ số nào của mô hình đại diện cho nó, và hai chỉ số tương quan tới đâu. Tiếp theo hỏi về nhãn: lấy từ đâu, trễ bao lâu, có bị chính hệ thống làm sai lệch không; câu trả lời cho phần này quyết định phần lớn thiết kế còn lại. Sau đó chọn chế độ phục vụ rẻ nhất đáp ứng được yêu cầu, và lập ngân sách độ trễ nếu phục vụ trực tuyến. Về dữ liệu và đặc trưng, cần nói tới nguồn dữ liệu, hợp đồng dữ liệu, có cần ghép theo thời điểm không và có cần kho đặc trưng không. Về huấn luyện, cần nói tới nhịp huấn luyện lại, điều kiện kích hoạt và những gì cần cố định để tái lập. Về đánh giá, cần có tập kiểm tra cố định, các lát cắt, kiểm thử hành vi và bước so sánh với mô hình đang chạy. Về triển khai, cần có shadow, canary, A/B test và cơ chế quay lui. Về giám sát, cần nêu bốn lớp, chỉ số nào gọi người trực và quy trình khi có cảnh báo. Cuối cùng, cần xét hệ thống có ảnh hưởng tới dữ liệu tương lai của chính nó không và có cần nhóm đối chứng không. Hai phần hay bị bỏ qua nhất là câu hỏi về nhãn và câu hỏi về vòng phản hồi.
15.7Ứng dụng dùng mô hình ngôn ngữ lớn#
Câu hỏi: Vận hành ứng dụng LLM khác vận hành mô hình học máy thông thường ở điểm nào?
Trả lời
Phần lớn nguyên tắc giữ nguyên: hợp đồng dữ liệu, quản lý phiên bản, shadow và canary, giám sát, quay lui. Có năm ràng buộc thay đổi: thường không tự huấn luyện mô hình; đầu ra là văn bản tự do nên không có hàm đúng sai hiển nhiên; kết quả không tất định và nhà cung cấp có thể cập nhật mô hình mà giữ nguyên tên gọi; chi phí chủ yếu là suy luận tính theo token, thay đổi theo từng yêu cầu; và có thêm các rủi ro như nội dung có hại, rò rỉ dữ liệu, prompt injection. Việc nhà cung cấp cập nhật mô hình là dạng cực đoan của phụ thuộc dữ liệu không ổn định, nên tôi dùng định danh phiên bản cố định và coi mỗi lần đổi phiên bản là một lần phát hành đầy đủ.
Câu hỏi: Đánh giá một ứng dụng dùng LLM như thế nào?
Trả lời
Tôi chia thành ba tầng theo chi phí. Kiểm tra theo quy tắc chạy trên mọi lượt gọi: định dạng, JSON, trích dẫn, độ dài. Giám khảo LLM chấm một mẫu để đánh giá chất lượng nội dung. Người chấm chấm một mẫu nhỏ định kỳ để hiệu chỉnh giám khảo. Thêm vào đó là một tập đánh giá chuẩn làm bước kiểm định trước mỗi lần phát hành, và chấm mẫu trên lưu lượng thật. Với giám khảo LLM, cần biết các thiên lệch đã được ghi nhận: thiên lệch vị trí, xử lý bằng cách hỏi hai lần với thứ tự đảo; thiên lệch độ dài; và khả năng tự ưu tiên câu trả lời của chính mình. Giám khảo cũng là một mô hình có thể thay đổi, nên tôi đo mức đồng thuận giữa nó và người chấm theo thời gian.
Câu hỏi: Một câu trả lời của hệ thống RAG bị sai. Điều tra thế nào?
Trả lời
Tôi tách thành hai câu hỏi. Tài liệu cần thiết có nằm trong ngữ cảnh không? Nếu không, đó là lỗi truy xuất, đo bằng recall@, và sửa bằng cách chia đoạn, mô hình embedding, tìm kiếm kết hợp hay xếp hạng lại. Nếu có mà câu trả lời vẫn sai, đó là lỗi sinh, đo bằng độ trung thành với ngữ cảnh, và sửa bằng prompt, đổi mô hình hay yêu cầu trích dẫn. Để tách được hai loại lỗi, bản ghi vết phải lưu danh sách các đoạn đã truy xuất kèm điểm của chúng ngay từ đầu.
Câu hỏi: Làm sao giảm chi phí của một ứng dụng dùng LLM?
Trả lời
Tôi thử theo thứ tự: bộ nhớ đệm cho câu hỏi lặp lại, câu hỏi gần giống và phần đầu cố định của prompt; định tuyến câu hỏi dễ tới mô hình nhỏ; rồi giảm ngữ cảnh, như bớt số đoạn truy xuất hay tóm tắt lịch sử hội thoại. Tôi cũng ghi chi phí của giám khảo LLM thành một dòng riêng, để biết chi phí tăng vì lưu lượng hay vì tăng tỉ lệ lấy mẫu đánh giá.
15.8Những câu trả lời chưa đạt#
Bảng dưới liệt kê một số câu trả lời nghe hợp lý nhưng cho thấy người trả lời chưa hiểu kỹ vấn đề, kèm lý do.
| Câu trả lời | Vì sao chưa đạt |
|---|---|
| "Tôi giám sát độ chính xác trong sản xuất." | Chỉ làm được khi có nhãn ngay; không hỏi về độ trễ nhãn là bỏ qua ràng buộc quan trọng nhất. |
| "Ngưỡng PSI là 0,25." | Ngưỡng cố định không tính tới cỡ mẫu và số bin (Mục 9.5). |
| "Dùng kho đặc trưng là hết lệch huấn luyện–phục vụ." | Kho đặc trưng tạo điều kiện, không bảo đảm. |
| "A/B test mọi thay đổi." | Cỡ mẫu tỉ lệ với ; lưu lượng không đủ cho mọi ý tưởng. |
| "Huấn luyện lại hằng ngày cho chắc." | Lợi ích giảm dần nhanh (Mục 11.1), và không tính tới chi phí. |
| "Mô hình đạt 99% nên rất tốt." | Không hỏi về mất cân bằng lớp, về lát cắt, và về mức đồng thuận giữa người gán nhãn. |
| "Chúng tôi dùng công cụ X nên vấn đề đó đã được giải quyết." | Công cụ không thay được việc chọn đánh đổi; nêu tên công cụ trước khi nêu ràng buộc là dấu hiệu học thuộc. |
| "CI/CD là đủ cho học máy." | Thiếu huấn luyện liên tục, và bỏ qua việc dữ liệu thay đổi mà không ai sửa mã. |
| "Giám khảo LLM chấm 4,5/5 nên chất lượng tốt." | Không đối chiếu với người chấm thì không biết giám khảo có đáng tin không (Mục 13.3). |
16Tài liệu tham khảo#
Nợ kỹ thuật và kiểm thử hệ thống học máy
- D. Sculley, G. Holt, D. Golovin, E. Davydov, T. Phillips, D. Ebner, V. Chaudhary, M. Young, J.-F. Crespo, D. Dennison. Hidden Technical Debt in Machine Learning Systems. NeurIPS 2015. Nguồn của nguyên lý CACE, các dạng nợ kỹ thuật, nhận định về 5% mã học máy, vòng phản hồi, và ba cơ chế giám sát: độ lệch dự đoán, giới hạn hành động, hệ thống phía trước.
- D. Sculley và cộng sự. Machine Learning: The High-Interest Credit Card of Technical Debt. SE4ML Workshop, NeurIPS 2014. Phiên bản đầu, ngắn hơn, của bài báo trên.
- E. Breck, S. Cai, E. Nielsen, M. Salib, D. Sculley. The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction. IEEE BigData 2017. Nguồn của 28 mục kiểm tra, cách tính điểm và bảng diễn giải ở Mục 6.5.
- E. Breck, N. Polyzotis, S. Roy, S. E. Whang, M. Zinkevich. Data Validation for Machine Learning. SysML 2019. Kiểm định dữ liệu bằng lược đồ suy ra từ dữ liệu (Mục 3.3).
- M. Zinkevich. Rules of Machine Learning: Best Practices for ML Engineering. Google. Tập hợp các quy tắc thực hành, bổ sung cho Chương 2 và Chương 6.
Quy trình, kiến trúc và vận hành
- Google Cloud. MLOps: Continuous delivery and automation pipelines in machine learning. Nguồn của ba mức tự động hoá, tám bước của pipeline, sáu giai đoạn CI/CD ở mức 2, và định nghĩa lệch huấn luyện–phục vụ.
- D. Sato, A. Wider, C. Windheuser. Continuous Delivery for Machine Learning. martinfowler.com, 2019.
- D. Kreuzberger, N. Kühl, S. Hirschl. Machine Learning Operations (MLOps): Overview, Definition, and Architecture. IEEE Access, 2023.
- B. Beyer, C. Jones, J. Petoff, N. R. Murphy (chủ biên). Site Reliability Engineering: How Google Runs Production Systems. O'Reilly, 2016. Nguồn của SLI, SLO, bốn tín hiệu cơ bản và các nguyên tắc cảnh báo ở Chương 10.
- J. Dean, L. A. Barroso. The Tail at Scale. Communications of the ACM, 2013. Phân tích phần đuôi độ trễ khi toả nhánh và yêu cầu dự phòng (Mục 7.3).
Thực hành trong công nghiệp
- S. Shankar, R. Garcia, J. M. Hellerstein, A. G. Parameswaran. Operationalizing Machine Learning: An Interview Study. arXiv:2209.09125, 2022. Nguồn của ba yếu tố tốc độ, kiểm định, phiên bản; bốn nhiệm vụ trong vòng đời; ba loại lỗi dữ liệu; và bốn thói quen xấu.
- C. Huyen. Designing Machine Learning Systems. O'Reilly, 2022. Nguồn của khái niệm vòng phản hồi thoái hoá và cách phân biệt huấn luyện lại từ đầu với huấn luyện có trạng thái.
- A. Paleyes, R.-G. Urma, N. D. Lawrence. Challenges in Deploying Machine Learning: A Survey of Case Studies. ACM Computing Surveys, 2022.
- M. Mitchell, S. Wu, A. Zaldivar, P. Barnes, L. Vasserman, B. Hutchinson, E. Spitzer, I. D. Raji, T. Gebru. Model Cards for Model Reporting. FAT* 2019. Thẻ mô hình (Mục 5.4).
Đánh giá và thí nghiệm có đối chứng
- M. T. Ribeiro, T. Wu, C. Guestrin, S. Singh. Beyond Accuracy: Behavioral Testing of NLP Models with CheckList. ACL 2020. Ba loại kiểm thử hành vi ở Mục 6.4.
- R. Kohavi, D. Tang, Y. Xu. Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press, 2020. Tài liệu chuẩn về A/B test, gồm các lỗi ở Mục 8.5.
- A. Deng, Y. Xu, R. Kohavi, T. Walker. Improving the Sensitivity of Online Controlled Experiments by Utilizing Pre-Experiment Data. WSDM 2013. Kỹ thuật CUPED ở Mục 8.4.
Dịch chuyển phân phối
- J. Quiñonero-Candela, M. Sugiyama, A. Schwaighofer, N. D. Lawrence (chủ biên). Dataset Shift in Machine Learning. MIT Press, 2009. Nguồn học thuật của cách phân loại covariate shift, prior probability shift và concept shift.
- J. G. Moreno-Torres, T. Raeder, R. Alaiz-Rodríguez, N. V. Chawla, F. Herrera. A unifying view on dataset shift in classification. Pattern Recognition, 2012.
- S. Rabanser, S. Günnemann, Z. C. Lipton. Failing Loudly: An Empirical Study of Methods for Detecting Dataset Shift. NeurIPS 2019. So sánh các phương pháp phát hiện dịch chuyển (Mục 9.3).
- B. Yurdakul, J. Naranjo. Statistical properties of the population stability index. Journal of Risk Model Validation, 2020. Phân phối tiệm cận của PSI và giá trị tới hạn phụ thuộc cỡ mẫu và số bin (Mục 9.5).
- A. du Pisanie và cộng sự. A critical review of existing and new population stability testing procedures in credit risk scoring. arXiv:2303.01227, 2023.
Vòng phản hồi
- T. Joachims, A. Swaminathan, T. Schnabel. Unbiased Learning-to-Rank with Biased Feedback. WSDM 2017. Hiệu chỉnh theo xác suất hiển thị (Mục 12.4).
Kho đặc trưng
- Tài liệu của Feast (feast.dev) về ghép theo thời điểm, kho ngoại tuyến, kho trực tuyến và sổ đăng ký đặc trưng.
LLMOps
- L. Zheng, W.-L. Chiang, Y. Sheng và cộng sự. Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023, Datasets and Benchmarks Track. Các thiên lệch của giám khảo LLM (Mục 13.3).
- S. Es, J. James, L. Espinosa-Anke, S. Schockaert. RAGAS: Automated Evaluation of Retrieval Augmented Generation. arXiv:2309.15217, 2023. Ba chỉ số đánh giá RAG (Mục 13.5).
- S. Shankar, J. D. Zamfirescu-Pereira, B. Hartmann, A. G. Parameswaran, I. Arawjo. Who Validates the Validators? Aligning LLM-Assisted Evaluation of LLM Outputs with Human Preferences. UIST 2024. Hiện tượng criteria drift (Mục 13.3).
- L. Chen, M. Zaharia, J. Zou. How is ChatGPT's Behavior Changing over Time? arXiv:2307.09009, 2023. Thay đổi hành vi của cùng một tên mô hình theo thời gian (Mục 13.1).
- C. Huyen. AI Engineering: Building Applications with Foundation Models. O'Reilly, 2025. Đánh giá, vận hành và kiến trúc của ứng dụng dùng mô hình nền tảng.
Phụ lục: chạy lại toàn bộ thí nghiệm#
code/mlops/
├── experiments.py            # Hình 6, 7, 9–14 và mọi số liệu đo được trong bài
├── experiments_output.txt    # kết quả in ra của experiments.py
├── bai_tap.py                # số liệu cho lời giải bài tập Chương 14
├── bai_tap_output.txt        # kết quả in ra của bai_tap.py
└── fig_diagrams.py           # Hình 1–5 và Hình 8 (sơ đồ khái niệm)
pip install numpy scipy matplotlib scikit-learn
python code/mlops/experiments.py     # khoảng một phút
python code/mlops/bai_tap.py         # khoảng một phút rưỡi
python code/mlops/fig_diagrams.py
Các script đặt hạt giống cố định, nên mọi con số trong tài liệu lặp lại được y hệt với cùng phiên bản thư viện. Số liệu thực nghiệm đến từ dữ liệu mô phỏng, mỗi thí nghiệm được thiết kế để cô lập một cơ chế. Chúng cho thấy cơ chế đó tồn tại và có độ lớn đáng kể, không dùng để suy ra con số cho một hệ thống cụ thể.