2Vòng đời của hệ thống học máy#
Chương 1 cho thấy mô hình chỉ là một phần nhỏ của hệ thống. Chương này nhìn vào các phần còn lại theo trình tự thời gian: một hệ thống học máy được xây dựng, đưa vào sử dụng và cải tiến như thế nào, những người vận hành nó đánh giá thành công ra sao, và quy trình đó được tự động hoá tới mức nào.
2.1Các giai đoạn của vòng đời#
Khi mô tả việc làm một sản phẩm học máy, người ta thường kể ba bước: thu thập dữ liệu, huấn luyện mô hình, triển khai. Cách kể này là một đường thẳng, và nó bỏ qua phần tốn công nhất. Trên thực tế, công việc đi theo vòng lặp với nhiều đường quay lại: kết quả đánh giá cho thấy cần thêm dữ liệu, việc giám sát trong sản xuất cho thấy cần huấn luyện lại, một sự cố cho thấy một đặc trưng đang được tính sai.
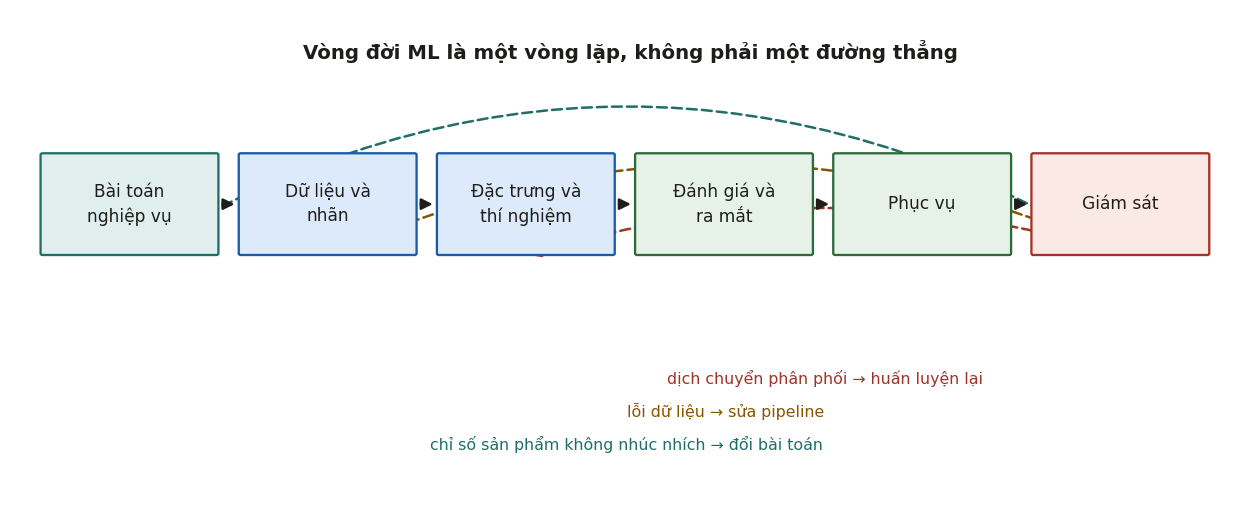
Shankar và cộng sự (2022) phỏng vấn 18 kỹ sư học máy đang vận hành hệ thống thật ở nhiều công ty, và gom công việc của họ thành bốn nhiệm vụ. Nhiệm vụ đầu tiên là thu thập và gán nhãn dữ liệu: tìm nguồn dữ liệu, đưa về một kho tập trung, làm sạch và gán nhãn. Nhiệm vụ thứ hai là tạo đặc trưng và thí nghiệm với mô hình, bằng cách thay đổi dữ liệu hoặc thay đổi mô hình để cải thiện một chỉ số. Nhiệm vụ thứ ba là đánh giá và triển khai: so sánh mô hình mới với mô hình đang chạy, rồi đưa thay đổi ra dần cho người dùng. Nhiệm vụ thứ tư là giám sát pipeline trong sản xuất và xử lý khi chất lượng suy giảm. Các chương của giáo trình này đi theo đúng bốn nhiệm vụ đó.
2.2Tốc độ, kiểm định và phiên bản#
Từ các cuộc phỏng vấn, Shankar và cộng sự rút ra ba yếu tố quyết định việc đưa mô hình vào sản xuất có thành công hay không. Các tác giả gọi chúng là ba chữ V: velocity, validation và versioning.
Yếu tố thứ nhất là tốc độ (velocity). Học máy mang tính thực nghiệm: không ai biết trước một ý tưởng có tác dụng hay không cho tới khi thử. Vì vậy năng suất của một nhóm phụ thuộc vào việc họ thử được bao nhiêu ý tưởng trong một khoảng thời gian. Các kỹ sư được phỏng vấn mong muốn đi được từ một ý tưởng mới tới một mô hình đã huấn luyện trong vòng một ngày.
Yếu tố thứ hai là kiểm định (validation): kiểm tra thay đổi, loại bỏ ý tưởng kém và phát hiện lỗi càng sớm càng tốt. Lỗi càng được phát hiện muộn thì càng tốn kém, và tốn kém nhất là khi người dùng đã nhìn thấy nó.
Yếu tố thứ ba là phiên bản (versioning): lưu và quản lý nhiều phiên bản của mô hình và dữ liệu. Không ai lường trước được mọi lỗi, nên khi lỗi xảy ra phải quay lại được phiên bản trước.
Thoạt nhìn, tốc độ và kiểm định kéo về hai phía: thêm một bước kiểm định thì quy trình chậm đi. Nhưng chúng cũng hỗ trợ nhau, vì loại được một ý tưởng kém ở giai đoạn sớm thì không tốn thời gian đưa nó qua các giai đoạn sau. Câu hỏi thực sự không phải là kiểm định nhiều hay ít, mà là đặt các bước kiểm định ở đâu trong quy trình.
2.3Các mức tự động hoá#
Một quy trình học máy có thể được tự động hoá tới những mức khác nhau. Kiến trúc tham chiếu được trích dẫn nhiều nhất là tài liệu MLOps: Continuous delivery and automation pipelines in machine learning của Google Cloud, chia thành ba mức.
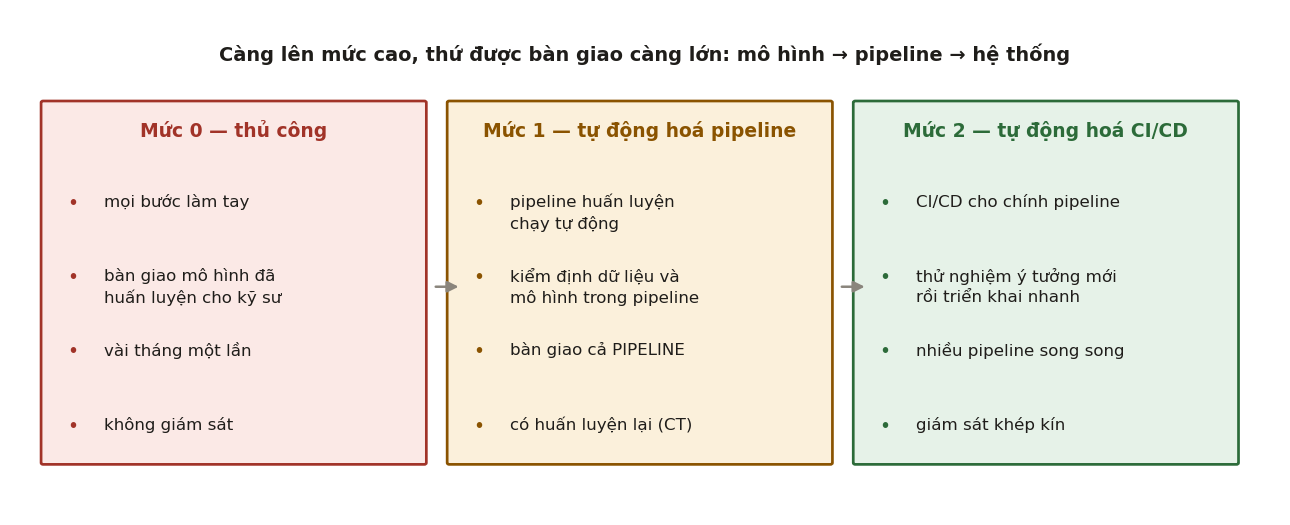
Ở mức 0, mọi bước đều làm bằng tay, từ phân tích và chuẩn bị dữ liệu tới huấn luyện và kiểm định. Nhóm khoa học dữ liệu huấn luyện mô hình rồi bàn giao tệp mô hình cho nhóm kỹ thuật triển khai; hai nhóm làm việc tách rời. Mô hình ít khi được cập nhật và thường không được theo dõi sau khi triển khai. Đây là trạng thái của phần lớn dự án học máy ở giai đoạn đầu.
Ở mức 1, toàn bộ pipeline huấn luyện được tự động hoá, nên mô hình có thể được huấn luyện lại trên dữ liệu mới mà không cần người làm từng bước. Pipeline có các bước kiểm định dữ liệu và kiểm định mô hình tự động. Thay đổi quan trọng nhất so với mức 0 là thứ được triển khai: không còn là một mô hình, mà là cả pipeline sinh ra mô hình.
Ở mức 2, bản thân pipeline cũng có hệ thống CI/CD, để các ý tưởng mới được kiểm thử và đưa vào sản xuất nhanh chóng. Tài liệu của Google chia mức này thành sáu giai đoạn: phát triển và thí nghiệm, tích hợp liên tục cho pipeline, bàn giao liên tục cho pipeline, kích hoạt tự động, bàn giao liên tục cho mô hình, và giám sát.
Cũng tài liệu đó liệt kê tám bước của một pipeline học máy: trích xuất dữ liệu, phân tích dữ liệu, chuẩn bị dữ liệu, huấn luyện, đánh giá mô hình, kiểm định mô hình, phục vụ và giám sát. Việc đánh giá và kiểm định được tách thành hai bước riêng có lý do, và Mục 11.4 sẽ trình bày lý do đó.
2.4Huấn luyện liên tục#
Trong phần mềm thông thường, hệ thống chỉ thay đổi khi có người sửa mã, và CI/CD được xây dựng quanh sự thay đổi đó: mỗi lần mã thay đổi thì kiểm thử, đóng gói và triển khai lại. Hệ thống học máy có thêm một nguồn thay đổi không đi qua kho mã: thế giới bên ngoài thay đổi, dữ liệu thay đổi theo, và mô hình cũ dần đi dù không ai đụng vào nó. Vì vậy học máy cần thêm huấn luyện liên tục (continuous training, CT): tự động huấn luyện lại và triển khai lại mô hình, được kích hoạt bởi dữ liệu mới, bởi chất lượng suy giảm hoặc bởi dịch chuyển phân phối (Chương 11).
Cũng vì vậy, tạo tác (artifact) mà một hệ thống học máy phải quản lý gồm ba thứ thay đổi theo ba nhịp khác nhau: mã thay đổi khi có người sửa, dữ liệu thay đổi hằng ngày, còn mô hình thay đổi mỗi lần huấn luyện lại. Quản lý đồng thời cả ba nhịp là điều làm cho MLOps khác với DevOps.
2.5Một số thói quen cần tránh#
Shankar và cộng sự cũng ghi nhận bốn thói quen làm việc không tốt mà họ gặp lặp đi lặp lại. Thói quen thứ nhất là khoảng cách giữa những gì học ở trường và những vấn đề gặp khi vận hành: người mới phải học lại qua chính các sự cố, trong khi phần lớn kiến thức đó có thể được truyền lại bằng tài liệu và quy trình. Thói quen thứ hai mà các tác giả gọi là "giữ cho GPU luôn nóng" (keeping GPUs warm): chạy càng nhiều thí nghiệm càng tốt để không lãng phí tài nguyên tính toán. Nghe như một cách làm việc hiệu quả, nhưng nó nhầm về thứ cần tiết kiệm. Tài nguyên khan hiếm thường không phải là GPU, mà là số giả thuyết đáng thử và thời gian của con người để đọc, hiểu kết quả; thí nghiệm không có giả thuyết rõ ràng tạo ra nhiều kết quả khó diễn giải và nhiều phiên bản phải quản lý.
Thói quen thứ ba là giải thích sau khi đã thấy kết quả (retrofitting an explanation): thấy một thay đổi cho kết quả tốt, đưa vào sản xuất, rồi mới đi tìm lý do vì sao nó tốt. Lời giải thích dựng lên sau có thể sai, và dễ dẫn các quyết định tiếp theo đi sai hướng. Thói quen thứ tư là hiểu biết về hệ thống chỉ nằm trong đầu vài người (undocumented tribal knowledge); khi họ rời nhóm, hiểu biết đó mất theo.
2.6Tóm tắt#
Vòng đời của một hệ thống học máy là một vòng lặp gồm bốn nhiệm vụ: thu thập dữ liệu, thí nghiệm, đánh giá và triển khai, giám sát. Theo các kỹ sư đang vận hành hệ thống thật, thành công phụ thuộc vào tốc độ thử nghiệm, việc kiểm định sớm và khả năng quay lại phiên bản cũ. Quy trình có thể được tự động hoá từ mức thủ công hoàn toàn tới mức có CI/CD cho cả pipeline, và khác với phần mềm thông thường, nó cần thêm huấn luyện liên tục vì dữ liệu thay đổi mà không đi qua kho mã.
Nhiệm vụ đầu tiên của vòng lặp là dữ liệu, và đó cũng là nơi phát sinh nhiều sự cố nhất. Chương 3 bắt đầu từ đây.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Ba yếu tố quyết định thành công theo nghiên cứu phỏng vấn của Shankar và cộng sự (2022) là gì?
Vì sao: Tốc độ: đi nhanh từ ý tưởng tới mô hình đã huấn luyện. Kiểm định: phát hiện ý tưởng kém và lỗi càng sớm càng tốt. Phiên bản: quản lý nhiều phiên bản mô hình và dữ liệu để quay lui được.2Huấn luyện liên tục (CT) khác CI/CD ở điểm nào?
Vì sao: Trong phần mềm thông thường, hệ thống chỉ thay đổi khi có người sửa mã. Trong học máy, dữ liệu thay đổi theo thế giới và mô hình cũ dần, nên cần tự động huấn luyện lại. Tạo tác của học máy gồm mã, dữ liệu và mô hình, thay đổi theo ba nhịp khác nhau.3Ở mức 1 của ba mức tự động hoá, thứ được bàn giao là gì?
Vì sao: Mức 0 bàn giao một mô hình, mức 1 bàn giao pipeline huấn luyện (có huấn luyện liên tục), mức 2 bàn giao một hệ thống có CI/CD cho chính pipeline.4Thói quen keeping GPUs warm sai ở đâu?
Vì sao: Chạy càng nhiều thí nghiệm càng tốt nghe như tận dụng tài nguyên, nhưng thí nghiệm không có giả thuyết tạo ra nhiều kết quả khó diễn giải và nhiều phiên bản phải quản lý.
Đã trả lời 0/4