8Triển khai mô hình mới#
Khi đã có một mô hình mới tốt hơn trên tập kiểm tra, câu hỏi còn lại là đưa nó tới người dùng thế nào. Thay ngay mô hình cũ bằng mô hình mới cho toàn bộ người dùng là cách rủi ro nhất: nếu mô hình mới có lỗi chưa phát hiện, mọi người dùng đều chịu ảnh hưởng cùng lúc. Các chiến lược ra mắt được thiết kế để giảm rủi ro đó, và mỗi chiến lược trả lời được một câu hỏi khác nhau về mô hình mới.
8.1Các chiến lược ra mắt#
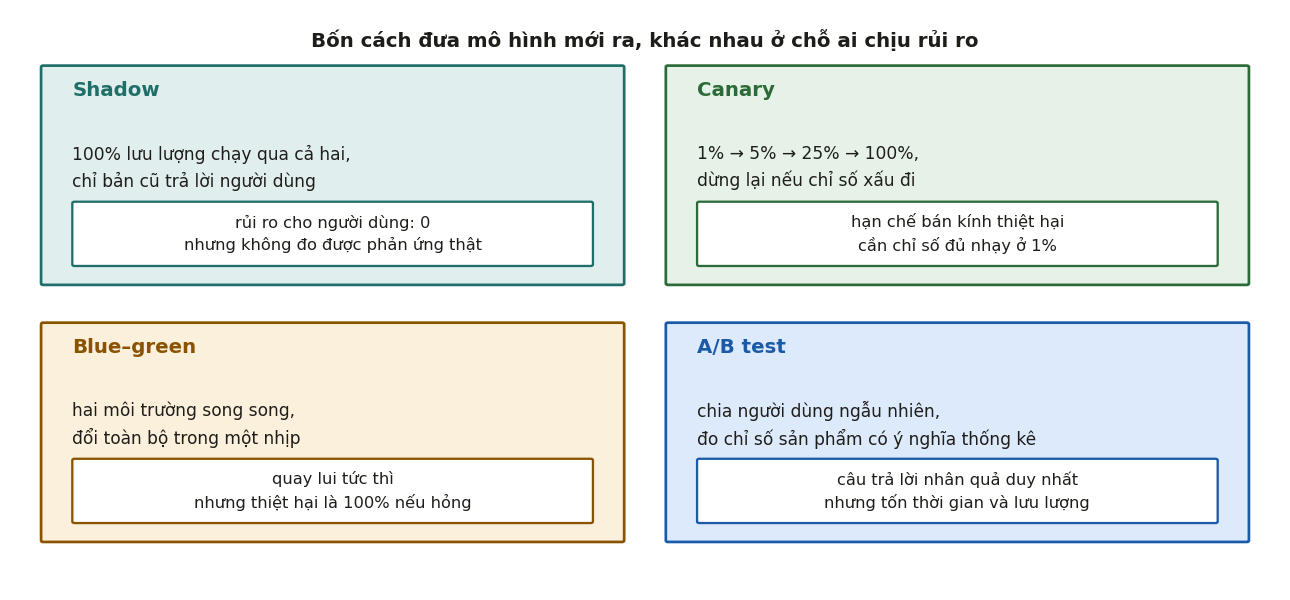
Chiến lược shadow (chạy song song ngầm) cho mô hình mới nhận cùng lưu lượng thật với mô hình cũ, nhưng chỉ ghi lại dự đoán của nó chứ không dùng. Nó cho biết mô hình mới có lỗi, có chậm không, và dự đoán của nó khác mô hình cũ nhiều tới đâu. Nó không cho biết người dùng phản ứng ra sao, vì người dùng không nhìn thấy kết quả của mô hình mới.
Chiến lược canary (ra mắt dần) đưa mô hình mới tới một phần nhỏ người dùng, rồi tăng dần. Nó cho biết có chỉ số vận hành nào xấu đi ở quy mô nhỏ hay không, nhưng không cho biết các hiệu ứng dài hạn hay các hiệu ứng lan truyền giữa người dùng.
Chiến lược blue–green duy trì hai môi trường giống nhau và chuyển toàn bộ lưu lượng từ môi trường này sang môi trường kia, cho phép quay lui tức thì. Nó là một cơ chế triển khai, không cho biết gì về chất lượng của mô hình.
Chiến lược A/B test chia ngẫu nhiên người dùng thành hai nhóm, một nhóm dùng mô hình cũ và một nhóm dùng mô hình mới, rồi so sánh chỉ số sản phẩm giữa hai nhóm. Vì việc chia là ngẫu nhiên, khác biệt đo được có thể quy cho mô hình theo nghĩa nhân quả. Đổi lại, A/B test tốn thời gian và tốn lưu lượng, như Mục 8.4 sẽ cho thấy.
Shankar và cộng sự ghi nhận rằng các nhóm có nhiều người dùng thường chia một lần ra mắt thành nhiều giai đoạn và đánh giá ở từng giai đoạn: đánh giá ngoại tuyến, rồi shadow, rồi canary ở 1% người dùng, rồi A/B test, cuối cùng là toàn bộ người dùng. Mỗi giai đoạn loại bỏ một loại rủi ro, và loại được rủi ro càng sớm thì càng rẻ. Quy trình này cũng có cái giá của nó: nhiều người được phỏng vấn cho rằng đi từ ý tưởng tới lúc kiểm chứng xong mất quá lâu. Một người cho biết ở công ty của họ, thử một ý tưởng đặc trưng mới mất hơn ba tháng; khoảng 40 tới 50% số ý tưởng đi tới được lần ra mắt đầu tiên, và khoảng một nửa trong số đó sau đó bị loại vì lý do pháp lý, quyền riêng tư hoặc độ phức tạp. Vì vậy, loại được ý tưởng kém càng sớm thì tốc độ chung của nhóm càng cao (Mục 2.2).
8.2Chạy song song ngầm#
Shadow thường bị coi là một bước thủ tục, nhưng nó trả lời được ba câu hỏi quan trọng mà người dùng không phải chịu rủi ro nào. Câu hỏi thứ nhất là mô hình mới có chịu được tải thật không: độ trễ, bộ nhớ, tỉ lệ lỗi khi nhận lưu lượng thật. Câu hỏi thứ hai là đặc trưng lúc phục vụ có khớp với lúc huấn luyện không; đây chính là mục Monitor 3 của ML Test Score, và shadow là cách rẻ nhất để đo nó trên lưu lượng thật. Câu hỏi thứ ba là phân phối dự đoán của mô hình mới có khác bất thường so với mô hình cũ không.
Câu hỏi thứ hai có giá trị đặc biệt. Nhiều lỗi lệch huấn luyện–phục vụ (Mục 4.1) chỉ xuất hiện trên phân phối đầu vào thật mà không xuất hiện trên tập kiểm tra, và shadow phát hiện được chúng trước khi có người dùng nào bị ảnh hưởng. Giới hạn của shadow nằm ở những hệ thống mà dự đoán tác động lên hành vi người dùng, như gợi ý hay xếp hạng: vì người dùng không thấy kết quả của mô hình mới, shadow không đo được phản ứng của họ.
8.3Ra mắt dần#
Canary đưa mô hình mới tới một phần nhỏ lưu lượng, ví dụ 1%, theo dõi một thời gian, rồi tăng dần lên 5%, 25%, 100%. Cách làm này chỉ có ý nghĩa nếu ở mức lưu lượng nhỏ ta vẫn đo được điều gì đó, và ở đây có một chỗ dễ nhầm. Với 1% lưu lượng, các chỉ số sản phẩm như tỉ lệ chuyển đổi gần như chắc chắn không đủ mẫu để có ý nghĩa thống kê (Mục 8.4 sẽ tính cụ thể). Thứ đo được ở canary là các chỉ số có nhiều mẫu và thay đổi lớn khi có sự cố: tỉ lệ lỗi, độ trễ p50, p95, p99, phân phối của dự đoán, tỉ lệ đặc trưng bị thiếu. Những chỉ số như tỉ lệ chuyển đổi, doanh thu mỗi phiên, tỉ lệ giữ chân người dùng phải đợi tới A/B test.
Hai giai đoạn này có vai trò khác nhau: canary bảo vệ hệ thống khỏi sự cố lớn, còn A/B test trả lời câu hỏi mô hình mới có mang lại giá trị hay không. Dùng kết quả canary để kết luận về giá trị sản phẩm là một lỗi thiết kế quy trình thường gặp.
8.4A/B test và cỡ mẫu#
Phần lớn chỉ số sản phẩm là tỉ lệ: tỉ lệ nhấp, tỉ lệ chuyển đổi. Để phát hiện chênh lệch giữa tỉ lệ của nhánh cũ và của nhánh mới, với mức ý nghĩa (hai phía) và lực kiểm định , mỗi nhánh cần số mẫu
Thay số cho một trường hợp: tỉ lệ nền , muốn phát hiện cải thiện tương đối 10%, tức và , với và lực kiểm định 80%, nên . Tử số là , mẫu số là , và mẫu mỗi nhánh. Điều cần nhớ nằm ở mẫu số: tỉ lệ nghịch với bình phương mức chênh lệch. Muốn phát hiện một mức cải thiện nhỏ bằng một nửa, cần gấp bốn lần số mẫu.
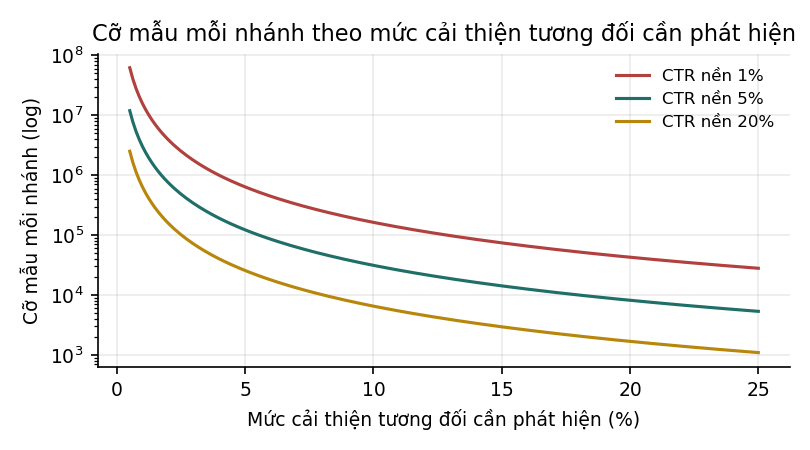
Bảng dưới tính cỡ mẫu với tỉ lệ nền 5%, hai phía và lực kiểm định 80% (tính trong code/mlops/experiments.py):
| Cải thiện tương đối cần phát hiện | Cỡ mẫu mỗi nhánh | Số ngày nếu mỗi nhánh có 100 000 lượt mỗi ngày |
|---|---|---|
| 1% (từ 5% lên 5,05%) | 2 996 694 | 30,0 ngày |
| 2% | 752 700 | 7,5 ngày |
| 5% | 122 121 | 1,2 ngày |
| 10% | 31 231 | 0,3 ngày |
| 20% | 8 155 | 0,1 ngày |
Dòng đầu tiên giải thích vì sao không thể A/B test mọi thay đổi. Để phát hiện một cải thiện tương đối 1% trên tỉ lệ nền 5%, tức từ 5% lên 5,05%, cần khoảng ba triệu mẫu mỗi nhánh, nghĩa là một tháng lưu lượng cho một ý tưởng. Lưu lượng là tài nguyên khan hiếm, và một quy trình ra mắt tốt không dùng nó cho những ý tưởng có thể loại sớm bằng cách rẻ hơn như đánh giá ngoại tuyến hay shadow.
Công thức cũng cho thấy ba cách giảm cỡ mẫu: chấp nhận chỉ phát hiện mức cải thiện lớn hơn, nới hoặc lực kiểm định, và giảm phương sai của chỉ số. Hai cách đầu làm thay đổi câu hỏi hoặc giảm độ tin cậy của kết luận; cách thứ ba thì không. Kỹ thuật giảm phương sai phổ biến nhất là CUPED (Deng và cộng sự, 2013). Ý tưởng của nó là phần lớn sự khác biệt giữa người dùng đã có từ trước thí nghiệm: người hay mua sắm vẫn hay mua sắm, dù ở nhánh nào. CUPED dùng giá trị của chính chỉ số đó ở mỗi người dùng trong giai đoạn trước thí nghiệm làm biến hiệp phương sai, và trừ đi phần biến động giải thích được bởi nó. Nếu hệ số tương quan giữa giá trị trước và trong thí nghiệm là , phương sai giảm theo hệ số , và cỡ mẫu cần thiết giảm theo cùng tỉ lệ. Với , phương sai còn 51%, nên 31 231 mẫu mỗi nhánh ở ví dụ trên giảm còn khoảng 15 900. Công cụ cỡ mẫu ở trang Phòng thí nghiệm cho phép nhập mức giảm phương sai này.
8.5Sai sót khi phân tích A/B test#
Kể cả khi có đủ mẫu, kết quả A/B test vẫn có thể bị đọc sai. Phần này dựa chủ yếu vào cuốn Trustworthy Online Controlled Experiments của Kohavi, Tang và Xu (2020), tài liệu chuẩn về chủ đề này.
Sai sót phổ biến nhất là xem kết quả giữa chừng (peeking): theo dõi p-value hằng ngày và dừng thí nghiệm ngay khi nó xuống dưới 0,05. Mỗi lần nhìn là một lần kiểm định, và nhìn nhiều lần làm tỉ lệ dương tính giả cao hơn 5% rất nhiều. Cách xử lý là cố định cỡ mẫu trước khi chạy, hoặc dùng các phương pháp được thiết kế cho việc theo dõi liên tục như kiểm định tuần tự.
Sai sót thứ hai là so sánh nhiều chỉ số cùng lúc. Nếu theo dõi 20 chỉ số mà không chỉ số nào thật sự thay đổi, kiểm định ở mức vẫn cho trung bình 1 chỉ số "có ý nghĩa" do ngẫu nhiên, và xác suất có ít nhất một chỉ số như vậy là nếu các chỉ số độc lập. Cách xử lý là khai báo trước một chỉ số chính để ra quyết định; các chỉ số còn lại là chỉ số bảo vệ (guardrail metric), chỉ dùng để phát hiện tác hại.
Sai sót thứ ba xảy ra khi hai nhánh ảnh hưởng lẫn nhau. Trong một mạng xã hội hay một sàn giao dịch hai phía, hành vi của người dùng ở nhánh này tác động tới người dùng ở nhánh kia, nên giả định các mẫu độc lập không còn đúng. Cách xử lý là chia ngẫu nhiên theo cụm, như theo vùng địa lý hay theo nhóm bạn bè, thay vì theo từng người.
Sai sót thứ tư là không kiểm tra tỉ lệ mẫu giữa hai nhánh. Thí nghiệm thiết kế chia 50/50, nhưng số người dùng thực tế ở hai nhánh chênh lệch nhiều hơn mức ngẫu nhiên cho phép, chẳng hạn vì một nhánh gây lỗi làm mất log. Hiện tượng này gọi là tỉ lệ mẫu lệch (sample ratio mismatch), và khi nó xảy ra thì kết quả thí nghiệm không đáng tin, dù p-value của chỉ số chính là bao nhiêu. Nên kiểm tra nó bằng kiểm định khi bình phương trên số người dùng của hai nhánh trước khi đọc bất kỳ kết quả nào.
Sai sót cuối cùng là bỏ qua hiệu ứng mới lạ: người dùng có thể phản ứng mạnh với một thay đổi chỉ vì nó mới, và hiệu ứng giảm dần sau vài tuần. Thí nghiệm cần chạy đủ lâu, và nên xem hiệu ứng theo thời gian, nhất là ở những người dùng đã gặp thay đổi nhiều lần.
8.6Tóm tắt#
Mỗi chiến lược ra mắt trả lời một câu hỏi khác nhau: shadow kiểm tra mô hình mới trên lưu lượng thật mà không có rủi ro cho người dùng, canary giới hạn phạm vi ảnh hưởng của sự cố, blue–green cho phép quay lui tức thì, còn A/B test đo tác động nhân quả lên chỉ số sản phẩm. Cỡ mẫu của A/B test tỉ lệ nghịch với bình phương mức cải thiện, nên một cải thiện 1% trên tỉ lệ nền 5% cần khoảng ba triệu mẫu mỗi nhánh; giảm phương sai bằng CUPED là cách rút ngắn thí nghiệm mà không giảm độ tin cậy. Khi đọc kết quả, cần tránh xem giữa chừng, so sánh nhiều chỉ số, bỏ qua ảnh hưởng giữa hai nhánh và tỉ lệ mẫu lệch.
Sau khi mô hình mới đã được triển khai cho mọi người dùng, công việc chưa kết thúc. Dữ liệu sẽ thay đổi dần theo thời gian, và mô hình cần được theo dõi. Chương 9 bắt đầu bằng cách mô tả chính xác "dữ liệu thay đổi" nghĩa là gì.
Tự kiểm tra
6 câu. Chọn đáp án để xem ngay lời giải thích.
1Canary không trả lời được câu hỏi nào?
Vì sao: Ở vài phần trăm lưu lượng, chỉ số sản phẩm gần như chắc chắn không đủ mẫu để có ý nghĩa thống kê. Canary bảo vệ khỏi sự cố lớn; A/B test trả lời câu hỏi về giá trị.2Với tỉ lệ nền 5%, cần khoảng bao nhiêu mẫu mỗi nhánh để phát hiện một cải thiện tương đối 1% với lực kiểm định 80%?
Vì sao: Chính xác là 2 996 694, tức khoảng một tháng lưu lượng nếu mỗi nhánh nhận 100 000 lượt mỗi ngày. Vì vậy các ý tưởng kém nên được loại bằng những cách rẻ hơn trước khi dùng lưu lượng cho A/B test.3Cỡ mẫu A/B test phụ thuộc mức chênh lệch cần phát hiện như thế nào?
Vì sao: Muốn phát hiện một chênh lệch nhỏ bằng một nửa thì cần gấp bốn lần số mẫu.4CUPED giảm cỡ mẫu cần thiết bằng cách nào?
Vì sao: Đây là cách rút ngắn thí nghiệm mà không đổi câu hỏi và không giảm độ tin cậy của kết luận (Deng và cộng sự, 2013).5Xem kết quả giữa chừng (peeking) trong A/B test là gì và vì sao sai?
Vì sao: Cách xử lý: cố định cỡ mẫu trước khi chạy, hoặc dùng các phương pháp thiết kế cho việc theo dõi liên tục như kiểm định tuần tự.6Thí nghiệm thiết kế chia 50/50 nhưng một nhánh có ít hơn nhánh kia 3% số người dùng, với hàng triệu người dùng mỗi nhánh. Nên làm gì?
Vì sao: Với hàng triệu người dùng, chênh lệch 3% lớn hơn rất nhiều so với dao động ngẫu nhiên, và kiểm định khi bình phương sẽ bác bỏ tỉ lệ 50/50. Khi đó kết quả không đáng tin, dù p-value của chỉ số chính là bao nhiêu (Kohavi và cộng sự, 2020).
Đã trả lời 0/6