3Dữ liệu#
Khi một mô hình hoạt động không như mong đợi, phản xạ tự nhiên của người học là xem lại mô hình: thử kiến trúc khác, chỉnh siêu tham số. Người vận hành hệ thống lâu năm thường làm ngược lại: họ xem dữ liệu trước. Chương này giải thích vì sao, phân loại các lỗi dữ liệu thường gặp, và trình bày cách biến những giả định ngầm về dữ liệu thành các phép kiểm tra tự động.
3.1Vai trò của dữ liệu#
Trong nghiên cứu phỏng vấn của Shankar và cộng sự, nhiều kỹ sư cho biết họ cải thiện hệ thống bằng cách thay đổi dữ liệu thường xuyên hơn là thay đổi mô hình. Điều này khớp với một quy tắc kinh nghiệm đã nêu ở Mục 1.3 của Học sâu: với cùng công sức, sửa dữ liệu và nhãn thường cải thiện kết quả nhiều hơn đổi kiến trúc.
Có một lý do khác khiến dữ liệu cần được chú ý đặc biệt: lỗi dữ liệu thường không làm chương trình báo lỗi. Một cột bị đổi đơn vị hay một nguồn dữ liệu bị thiếu một nửa số dòng vẫn cho ra một bảng hợp lệ, mô hình vẫn chạy, và chỉ có kết quả là sai. Những lỗi như vậy chỉ được phát hiện khi có người chủ động kiểm tra.
3.2Phân loại lỗi dữ liệu#
Không phải lỗi dữ liệu nào cũng giống nhau, và cách phản ứng phù hợp với lỗi này có thể là sai với lỗi khác. Shankar và cộng sự phân biệt ba loại, xếp từ dễ thấy tới khó thấy.
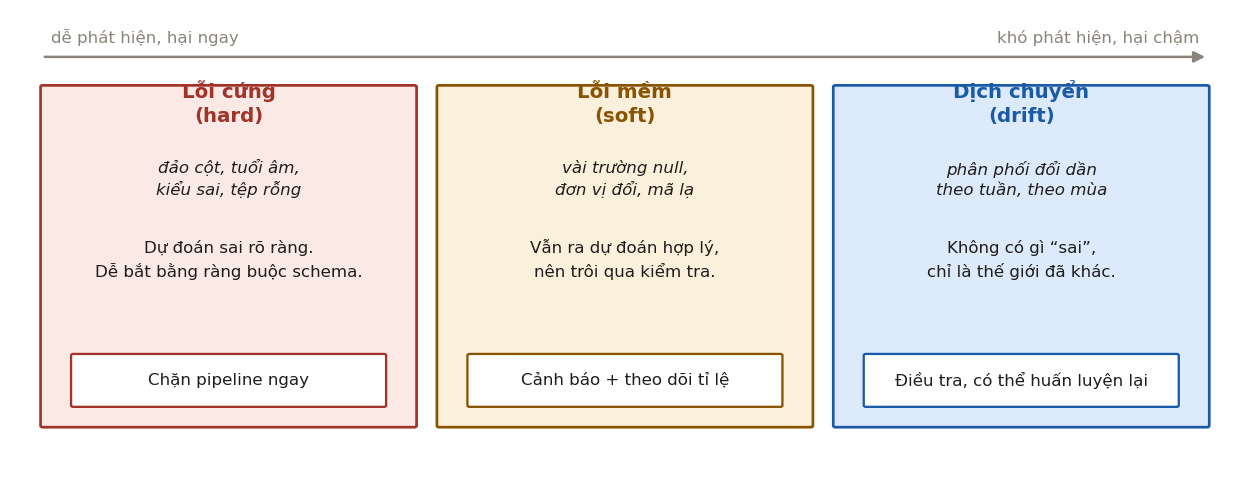
Lỗi cứng (hard error) là lỗi vi phạm một ràng buộc kiểm tra được: hai cột bị đảo chỗ, tuổi mang giá trị âm, sai kiểu dữ liệu, một tệp rỗng. Dự đoán dựa trên dữ liệu như vậy sai một cách rõ ràng, nên cách xử lý đúng là dừng pipeline lại; không có dự đoán còn hơn có một dự đoán sai.
Lỗi mềm (soft error) khó thấy hơn: một số trường bị thiếu, một cột đổi đơn vị tính, xuất hiện một giá trị danh mục chưa từng gặp. Dự đoán vẫn trông hợp lý nên vượt qua các phép kiểm tra đơn giản, và mức độ ảnh hưởng khó định lượng. Với loại lỗi này, dừng pipeline thường là phản ứng quá mạnh; cách hợp lý hơn là cảnh báo và theo dõi tỉ lệ dữ liệu bị ảnh hưởng.
Dịch chuyển (drift) là khi dữ liệu thay đổi dần theo thời gian, theo tuần hay theo mùa. Về mặt kỹ thuật không có gì sai cả; chỉ là thế giới đã khác so với lúc huấn luyện. Phản ứng phù hợp là điều tra nguyên nhân và có thể phải huấn luyện lại mô hình (Chương 9 và 11).
Những người được phỏng vấn cho biết hai khó khăn quanh việc kiểm tra dữ liệu. Khó khăn thứ nhất là các ràng buộc chất lượng dữ liệu thường do người đặt bằng tay, và cách làm này không bền vững: người biết vì sao một ngưỡng là 0,3 có thể rời công ty, còn ngưỡng thì ở lại. Khó khăn thứ hai, được nhắc tới nhiều nhất, là báo động giả: cảnh báo kích hoạt trong khi chất lượng của mô hình vẫn ổn. Khi báo động giả xảy ra thường xuyên, người vận hành mất niềm tin vào cảnh báo và bỏ qua cả những cảnh báo về sự cố thật (Mục 10.5). Một nguyên nhân phổ biến của báo động giả là dùng cùng một cơ chế phản ứng cho cả ba loại lỗi ở trên.
3.3Hợp đồng dữ liệu#
Với lỗi cứng, cách xử lý gốc rễ là viết ra những giả định về dữ liệu dưới dạng các ràng buộc mà máy kiểm tra được. Tập ràng buộc đó thường được gọi là hợp đồng dữ liệu (data contract), vì nó là thoả thuận giữa bên cung cấp dữ liệu và bên sử dụng. Một hợp đồng đầy đủ có bốn tầng ràng buộc, từ đơn giản tới phức tạp. Đoạn mã dưới đây minh hoạ cả bốn tầng cho một bảng giao dịch:
# Tầng 1: lược đồ (schema) - tên cột, kiểu, cột nào được phép thiếu
schema = {
    "user_id":    {"type": "int64",    "nullable": False},
    "amount_vnd": {"type": "float64",  "nullable": False},
    "country":    {"type": "category", "nullable": False},
    "event_time": {"type": "datetime", "nullable": False},
}

# Tầng 2: miền giá trị - ràng buộc trên từng giá trị
domain = {
    "amount_vnd": {"min": 0, "max": 5e9},
    "country":    {"allowed": {"VN", "SG", "TH", "ID"}},
}

# Tầng 3: thống kê - ràng buộc trên phân phối của cả lô
batch_stats = {
    "amount_vnd": {"null_rate_max": 0.001, "mean_shift_max_sigma": 3},
    "country":    {"new_category_rate_max": 0.005},
}

# Tầng 4: quan hệ giữa các cột và giữa các bảng
invariants = [
    "event_time <= ingest_time",       # không có sự kiện từ tương lai
    "refund_amount <= amount_vnd",
    "count(rows) between 0.7*d7_median and 1.4*d7_median",   # số dòng không hụt, không phình bất thường
]
Hai tầng đầu kiểm tra từng dòng dữ liệu, nên phát hiện được lỗi cứng; khi chúng bị vi phạm, pipeline nên dừng. Hai tầng sau kiểm tra cả lô dữ liệu và quan hệ giữa các bảng, nên phát hiện được phần lớn lỗi mềm; khi chúng bị vi phạm, cảnh báo thường là đủ. Ví dụ, ở tầng 4, mỗi dòng của một lô chỉ có một nửa số dòng bình thường vẫn hoàn toàn hợp lệ; chỉ khi so với các lô trước mới thấy thiếu dữ liệu.
Viết tay hàng trăm ràng buộc như vậy vừa tốn công vừa dễ sai. Cách làm phổ biến hơn là suy ra lược đồ và khoảng giá trị từ một tập dữ liệu tham chiếu đã được kiểm tra kỹ, rồi để người xem lại và chỉnh. Hợp đồng khi đó không phụ thuộc vào trí nhớ của một người cụ thể, giải quyết được khó khăn thứ nhất ở Mục 3.2. Các thư viện như TensorFlow Data Validation (Breck và cộng sự, 2019) và Great Expectations hỗ trợ cách làm này.
Ràng buộc "không có sự kiện từ tương lai" ở tầng 4 đáng được chú ý riêng. Nó là lớp phòng thủ đầu tiên chống lại rò rỉ dữ liệu theo thời gian, một lỗi khó phát hiện mà Chương 4 sẽ phân tích kỹ.
3.4Kiểm định tại ranh giới của pipeline#
Một thực hành được nhiều người phỏng vấn nhắc lại là kiểm định dữ liệu cả khi nó đi vào lẫn khi nó đi ra khỏi mỗi pipeline. Lý do nằm ở cách một pipeline nhiều bước hỏng. Nếu bước thứ ba tạo ra dữ liệu sai, bước thứ tư và thứ năm vẫn chạy bình thường trên dữ liệu sai đó, và chỉ khi nhìn vào kết quả cuối cùng mới thấy một con số bất thường. Lúc đó phải lần ngược qua từng bước để tìm nơi phát sinh lỗi, mất nhiều thời gian. Nếu mỗi bước kiểm tra đầu vào và đầu ra của mình, lỗi được phát hiện ngay tại bước gây ra nó.
Nguyên tắc này được mượn từ thiết kế hệ thống phân tán: phát hiện lỗi càng sớm càng tốt, báo lỗi rõ ràng, và đặt các phép kiểm tra tại ranh giới giữa các thành phần, nơi trách nhiệm chuyển từ nhóm này sang nhóm khác.
3.5Các vấn đề về nhãn#
Nhãn là phần dữ liệu ít được kiểm tra nhất, vì người ta thường mặc định nó đúng. Có ba vấn đề cần biết.
Vấn đề thứ nhất là độ trễ nhãn (label lag), tức khoảng thời gian từ lúc mô hình đưa ra dự đoán tới lúc biết đáp án thật. Với mô hình dự đoán người dùng có nhấp vào quảng cáo hay không, độ trễ chỉ vài phút. Với mô hình dự đoán một khoản vay có bị vỡ nợ hay không, độ trễ có thể là nhiều tháng hoặc nhiều năm. Độ trễ nhãn quyết định ta giám sát được gì (Chương 10) và huấn luyện lại được nhanh tới đâu (Chương 11). Mục 9.2 sẽ cho thấy nó còn quyết định ta có phát hiện được loại dịch chuyển gây hại nhiều nhất hay không.
Vấn đề thứ hai là nhãn có nhiễu, thể hiện qua việc những người gán nhãn không đồng ý với nhau. Mức đồng thuận giữa những người gán nhãn đặt ra giới hạn trên thực tế cho độ chính xác đo được. Nếu hai người gán nhãn chỉ đồng ý với nhau ở 90% số mẫu mà mô hình lại đạt 95% so với nhãn của một người, kết quả đó đáng nghi hơn là đáng mừng: có thể đã có rò rỉ dữ liệu, hoặc cách đo có vấn đề.
Vấn đề thứ ba là nhãn bị chính hệ thống làm sai lệch. Khi nhãn lấy từ hành vi của người dùng trên những kết quả mà mô hình đã chọn để hiển thị, nhãn đó không còn là quan sát khách quan về thế giới. Chương 12 sẽ phân tích hiện tượng này.
3.6Phiên bản hoá dữ liệu#
Yếu tố phiên bản ở Mục 2.2 áp dụng cho dữ liệu cũng như cho mô hình. Câu hỏi cần trả lời được bất cứ lúc nào là: mô hình đang chạy trong sản xuất được huấn luyện từ chính xác tập dữ liệu nào?
Có ba mức trả lời, chi phí tăng dần. Ở mức đơn giản nhất, ta ghi lại đường dẫn tới dữ liệu và thời điểm huấn luyện. Cách này chỉ cho biết dữ liệu nằm ở thư mục nào vào ngày nào, và vô dụng nếu thư mục đó đã bị ghi đè. Ở mức thứ hai, ta lưu mã băm (hash) của nội dung tập dữ liệu cùng với mô hình. Khi đó biết chắc một tập dữ liệu có phải đúng là tập đã dùng hay không, nhưng vẫn chưa dựng lại được nó nếu đã mất. Ở mức đầy đủ, dữ liệu được lưu theo kiểu bất biến, chỉ được thêm vào chứ không bị sửa (append-only), kèm theo ghi chép về nguồn gốc của từng tập (lineage). Khi đó dựng lại được đúng tập huấn luyện của bất kỳ mô hình nào trong quá khứ.
Mức đầy đủ tốn kém, nhưng nó là điều kiện để điều tra sự cố. Khi một mô hình hoạt động bất thường, câu hỏi đầu tiên thường là dữ liệu huấn luyện của nó có gì khác thường không. Nếu không dựng lại được tập dữ liệu đó, việc điều tra dừng lại ngay ở câu hỏi đầu tiên.
3.7Tóm tắt#
Lỗi dữ liệu là nguồn sự cố phổ biến nhất của hệ thống học máy, và chúng thường không làm chương trình báo lỗi. Có ba loại lỗi cần ba cách phản ứng khác nhau: dừng pipeline với lỗi cứng, cảnh báo với lỗi mềm, điều tra và huấn luyện lại với dịch chuyển. Hợp đồng dữ liệu bốn tầng biến các giả định về dữ liệu thành phép kiểm tra tự động, và các phép kiểm tra nên đặt ở ranh giới giữa các bước của pipeline. Nhãn cần được chú ý riêng vì độ trễ, độ nhiễu và việc bị chính hệ thống làm sai lệch, còn dữ liệu cần được quản lý phiên bản để điều tra được sự cố.
Dữ liệu sạch vẫn chưa đủ. Từ dữ liệu, ta tính ra đặc trưng, và chính bước này sinh ra hai lỗi khó phát hiện nhất trong học máy: đặc trưng lúc huấn luyện khác lúc phục vụ, và đặc trưng chứa thông tin từ tương lai. Đó là nội dung của Chương 4.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Ba loại lỗi dữ liệu (cứng, mềm, dịch chuyển) cần mấy cách phản ứng?
Vì sao: Dùng chung một cơ chế cảnh báo cho cả ba loại là nguyên nhân phổ biến của báo động giả, khó khăn được nhắc nhiều nhất trong nghiên cứu của Shankar và cộng sự.2Vì sao lỗi mềm khó phát hiện hơn lỗi cứng?
Vì sao: Một số trường bị thiếu hay một đơn vị tính bị đổi không vi phạm ràng buộc nào, nhưng làm dự đoán lệch dần. Vì vậy lỗi mềm được theo dõi theo tỉ lệ thay vì dừng pipeline.3Hậu quả nghiêm trọng nhất của báo động giả là gì?
Vì sao: Khi phần lớn cảnh báo là giả, hệ thống cảnh báo tạo ra cảm giác an toàn không có cơ sở (Mục 10.5).4Tầng nào của hợp đồng dữ liệu phát hiện được một lô dữ liệu có số dòng chỉ bằng một nửa bình thường?
Vì sao: Mỗi dòng trong lô có thể hoàn toàn hợp lệ về lược đồ và miền giá trị; chỉ khi so sánh với các lô trước mới thấy thiếu dữ liệu. Vi phạm tầng 3 và 4 thường là lỗi mềm, nên cảnh báo thay vì dừng pipeline.
Đã trả lời 0/4