11Huấn luyện lại#
Chương 9 cho thấy dữ liệu thay đổi theo thời gian, và Chương 10 cho thấy cách phát hiện khi mô hình suy giảm. Cách xử lý thông thường là huấn luyện lại mô hình trên dữ liệu mới. Nhưng huấn luyện lại tốn tài nguyên và mỗi lần triển khai một mô hình mới đều có rủi ro, nên cần trả lời được ba câu hỏi: mô hình cũ đi nhanh tới mức nào, khi nào nên huấn luyện lại, và huấn luyện lại như thế nào.
11.1Độ cũ của mô hình#
Trước khi quyết định bao lâu huấn luyện lại một lần, cần biết cái giá của việc không huấn luyện lại. ML Test Score có hai mục cho vấn đề này: Model 4 yêu cầu biết ảnh hưởng của việc mô hình cũ đi, và Monitor 4 yêu cầu mô hình không quá cũ.
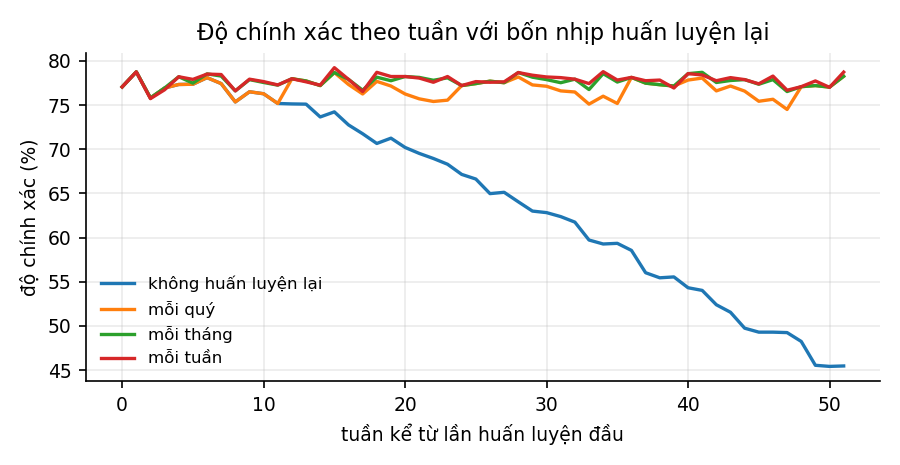
Để có con số cụ thể, thí nghiệm trong code/mlops/experiments.py mô phỏng một thế giới có concept drift chậm. Dữ liệu có hai chiều, và biên quyết định thật xoay một góc 0,035 radian (khoảng ) mỗi tuần, trong 52 tuần. Mỗi tuần có 4 000 mẫu mới. Mô hình ban đầu là hồi quy logistic huấn luyện trên dữ liệu tuần 0; mỗi khi tới lịch huấn luyện lại, một mô hình mới được huấn luyện trên dữ liệu của tuần vừa qua. Ta so sánh bốn nhịp huấn luyện lại:
| Nhịp huấn luyện lại | Số lần huấn luyện lại trong năm | Độ chính xác trung bình | Thấp nhất | Tuần 52 |
|---|---|---|---|---|
| Không bao giờ | 0 | 64,61% | 45,42% | 45,48% |
| Mỗi quý (12 tuần) | 4 | 76,89% | 74,50% | 78,25% |
| Mỗi tháng (4 tuần) | 13 | 77,68% | 75,80% | 78,25% |
| Mỗi tuần | 52 | 77,80% | 75,72% | 78,72% |
Không huấn luyện lại thì sau một năm độ chính xác trung bình mất 13,19 điểm phần trăm. Tới tuần 52, biên quyết định đã xoay hơn , và mô hình chỉ còn đúng 45,5%, thấp hơn đoán ngẫu nhiên trên bài toán hai lớp cân bằng này. Hình 13 cho thấy thêm một điều đáng lo: độ chính xác giảm dần từng chút, nên không có tuần nào có một thay đổi đột ngột đủ để kích hoạt một cảnh báo theo ngưỡng.
Mặt khác, lợi ích của huấn luyện lại giảm nhanh khi nhịp dày lên. Chuyển từ không huấn luyện lại sang huấn luyện lại mỗi quý tăng 12,3 điểm, nhưng từ mỗi quý lên mỗi tuần chỉ tăng thêm 0,91 điểm, trong khi số lần huấn luyện tăng 13 lần. Vì vậy nhịp huấn luyện lại là một quyết định kinh tế. Nó được xác định bằng cách đo một đường cong như Hình 13 trên chính bài toán của mình, rồi so sánh giá trị của một điểm phần trăm độ chính xác với chi phí của một lần huấn luyện, kiểm định và triển khai. Bài 7 ở Chương 14 lặp lại thí nghiệm này với ba tốc độ dịch chuyển khác nhau.
Cần nhớ rằng các con số trên thuộc về một mô phỏng mà dịch chuyển xảy ra đều và chậm. Với những thay đổi đột ngột, như một sự kiện làm hành vi người dùng thay đổi chỉ trong vài ngày, huấn luyện lại theo lịch cố định phản ứng chậm, và cần thêm các điều kiện kích hoạt khác.
11.2Điều kiện kích hoạt huấn luyện lại#
Có bốn cách quyết định khi nào huấn luyện lại. Cách đơn giản nhất là theo lịch, ví dụ mỗi tuần hay mỗi tháng. Cách này dễ dự trù tài nguyên, nhưng huấn luyện lại cả khi không cần, và phản ứng quá muộn khi có thay đổi đột ngột. Cách thứ hai là theo chất lượng: huấn luyện lại khi chỉ số chất lượng giảm quá một ngưỡng. Cách này phản ứng đúng lúc cần, nhưng đòi hỏi có nhãn, nên bị giới hạn bởi độ trễ nhãn. Cách thứ ba là theo dịch chuyển: huấn luyện lại khi các phép kiểm tra ở Chương 9 báo động. Cách này không cần nhãn, nhưng như Mục 9.2 đã cho thấy, nó phát hiện được covariate shift mà không phát hiện được concept drift. Cách thứ tư là theo lượng dữ liệu: huấn luyện lại khi đã có đủ một số lượng mẫu mới. Cách này phù hợp khi dữ liệu tới không đều, nhưng không liên quan gì tới việc mô hình còn tốt hay không.
Trong thực tế, cấu hình thường gặp là huấn luyện lại theo lịch làm nền, cộng thêm kích hoạt theo chất lượng hoặc theo dịch chuyển để huấn luyện lại sớm khi cần. Shankar và cộng sự ghi nhận rằng nhiều nhóm chọn cách đơn giản hơn cả: huấn luyện lại thường xuyên trên dữ liệu mới nhất, có nhóm huấn luyện lại hằng ngày, thay vì xây dựng một cơ chế kích hoạt phức tạp.
11.3Huấn luyện lại từ đầu và cập nhật mô hình cũ#
Huyen (2022) phân biệt hai cách huấn luyện lại. Cách thứ nhất là huấn luyện lại từ đầu (stateless retraining): mỗi lần huấn luyện một mô hình mới hoàn toàn trên một cửa sổ dữ liệu, ví dụ ba tháng gần nhất. Cách thứ hai là huấn luyện có trạng thái (stateful training): tiếp tục cập nhật mô hình hiện có chỉ bằng dữ liệu mới.
Cập nhật mô hình cũ rẻ hơn nhiều cho mỗi lần, vì chỉ xử lý dữ liệu mới. Nhưng nó có hai nhược điểm khó thấy. Thứ nhất, trạng thái của mô hình phụ thuộc vào toàn bộ chuỗi cập nhật trước đó, nên rất khó tái lập; huấn luyện lại từ đầu thì dựng lại được chỉ từ dữ liệu, mã và hạt giống. Thứ hai, quay lui khó hơn: với huấn luyện lại từ đầu, chỉ cần nạp lại mô hình cũ, còn với cập nhật liên tục, muốn quay lại trạng thái trước một lô dữ liệu lỗi có thể phải phát lại cả lịch sử cập nhật. Ngoài ra, cập nhật liên tục có rủi ro quên thảm khốc (catastrophic forgetting), tức mô hình mất khả năng xử lý những gì đã học từ dữ liệu cũ, và một lô dữ liệu lỗi ảnh hưởng tới mọi phiên bản sau nó.
Vì vậy nên mặc định huấn luyện lại từ đầu, và chỉ chuyển sang cập nhật mô hình cũ khi có ràng buộc thật sự: dữ liệu quá lớn để huấn luyện lại toàn bộ, hoặc cần mô hình thích ứng trong vài phút. Khả năng tái lập và khả năng quay lui chỉ thể hiện giá trị khi có sự cố, nhưng khi đó chúng rất cần.
11.4Kiểm định trong pipeline huấn luyện lại#
Khi huấn luyện lại được tự động hoá, có một sai lầm nguy hiểm: để pipeline bỏ qua các bước kiểm định mà một lần phát hành thủ công phải qua. Một mô hình được huấn luyện lại tự động cũng là một mô hình mới, và phải đi qua đúng những bước như mọi mô hình mới khác:
dữ liệu mới
  → kiểm định dữ liệu              (Chương 3; nếu lỗi thì dừng, không huấn luyện)
  → huấn luyện
  → đánh giá trên tập kiểm tra cố định, theo lát cắt   (Chương 6)
  → so sánh với mô hình đang chạy  ← bước hay bị bỏ qua nhất
  → kiểm thử hành vi               (Mục 6.4)
  → đăng ký vào sổ đăng ký, trạng thái staging
  → shadow → canary → toàn bộ      (Chương 8)
Bước so sánh với mô hình đang chạy cần được nói riêng. Mục 2.3 đã nhắc rằng trong tám bước của pipeline theo tài liệu của Google Cloud, kiểm định mô hình (model validation) được tách khỏi đánh giá mô hình (model evaluation). Lý do là hai bước trả lời hai câu hỏi khác nhau: đánh giá cho biết mô hình mới tốt tới đâu, còn kiểm định quyết định có nên thay mô hình đang chạy bằng mô hình mới hay không. Một mô hình huấn luyện lại tự động có thể kém hơn mô hình đang chạy, trên tổng thể hoặc trên một lát cắt quan trọng, chẳng hạn vì dữ liệu tuần vừa qua có lỗi mềm chưa được phát hiện. Khi đó nó phải bị chặn tự động, không cần ai nhìn thấy.
Vì mọi bước đều tự động, cơ chế quay lui cũng phải tự động. Đây là mục Infra 7 của ML Test Score: có thể quay lui mô hình đang phục vụ nhanh và an toàn.
11.5Tóm tắt#
Mô hình cũ đi khi dữ liệu thay đổi; trong mô phỏng ở Mục 11.1, không huấn luyện lại thì sau một năm mất 13 điểm phần trăm độ chính xác, nhưng huấn luyện lại hằng quý đã lấy lại gần hết, nên nhịp huấn luyện lại là một quyết định kinh tế cần đo trên bài toán cụ thể. Có bốn cách kích hoạt huấn luyện lại: theo lịch, theo chất lượng, theo dịch chuyển và theo lượng dữ liệu, và thường được kết hợp. Nên mặc định huấn luyện lại từ đầu vì dễ tái lập và dễ quay lui. Khi tự động hoá, pipeline huấn luyện lại phải qua đủ các bước kiểm định như một lần phát hành thủ công, đặc biệt là bước so sánh với mô hình đang chạy.
Chương này giả định rằng dữ liệu mới phản ánh thế giới bên ngoài. Trong nhiều hệ thống, giả định đó không đúng: chính mô hình quyết định dữ liệu mới trông như thế nào. Chương 12 bàn về hiện tượng này.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Trong thí nghiệm ở Mục 11.1, không huấn luyện lại suốt một năm gây thiệt hại bao nhiêu?
Vì sao: Độ chính xác giảm dần từng chút, nên không có tuần nào có một thay đổi đột ngột đủ để kích hoạt cảnh báo theo ngưỡng.2So với huấn luyện lại hằng quý, huấn luyện lại hằng tuần tăng thêm bao nhiêu trong thí nghiệm đó?
Vì sao: Lợi ích giảm dần nhanh, nên nhịp huấn luyện lại là một quyết định kinh tế: đo đường cong trên chính bài toán, rồi so giá trị của một điểm phần trăm với chi phí một lần huấn luyện, kiểm định và triển khai.3Kích hoạt huấn luyện lại theo dịch chuyển có hạn chế gì?
Vì sao: Kích hoạt theo chất lượng thì ngược lại: phát hiện được concept drift nhưng cần nhãn, nên bị giới hạn bởi độ trễ nhãn.4Bước nào hay bị bỏ qua nhất trong pipeline huấn luyện lại tự động?
Vì sao: Tài liệu của Google Cloud tách kiểm định mô hình khỏi đánh giá mô hình vì lý do này: đánh giá trả lời "mô hình này tốt tới đâu", kiểm định trả lời "có nên thay mô hình đang chạy bằng mô hình này không".5Vì sao nên mặc định huấn luyện lại từ đầu thay vì cập nhật mô hình cũ?
Vì sao: Cập nhật mô hình cũ rẻ hơn mỗi lần, nhưng có rủi ro quên thảm khốc, và một lô dữ liệu lỗi ảnh hưởng tới mọi phiên bản sau. Chỉ nên chuyển sang khi có ràng buộc thật về dữ liệu hoặc thời gian thích ứng.
Đã trả lời 0/5