6Đánh giá mô hình trước khi triển khai#
Trong các giáo trình trước, đánh giá một mô hình thường kết thúc bằng một con số: độ chính xác, AUC hay F1 trên tập kiểm tra. Con số đó cần thiết, nhưng trước khi đưa mô hình tới người dùng thật, nó không đủ để quyết định. Chương này giải thích vì sao, rồi giới thiệu ba cách đánh giá bổ sung và một bộ tiêu chí để kiểm tra mức sẵn sàng của cả hệ thống.
6.1Giới hạn của một chỉ số tổng hợp#
Một chỉ số duy nhất trên tập kiểm tra có ba giới hạn. Giới hạn thứ nhất là nó đo trên tập kiểm tra chứ không đo trên sản phẩm: một mô hình tốt hơn theo AUC chưa chắc làm doanh thu hay mức hài lòng của người dùng tăng lên (Mục 6.2). Giới hạn thứ hai là nó là trung bình trên toàn bộ dữ liệu, nên nhóm chiếm đa số quyết định kết quả; một nhóm nhỏ có thể tệ đi trong khi con số tổng thể vẫn tăng (Mục 6.3). Giới hạn thứ ba là nó không nói gì về từng trường hợp cụ thể: mô hình mới có thể đúng hơn trung bình một điểm, nhưng lại sai ở một trường hợp hiển nhiên mà mô hình cũ làm đúng (Mục 6.4).
6.2Chỉ số ngoại tuyến và chỉ số sản phẩm#
Shankar và cộng sự ghi nhận rằng các nhóm vận hành thành công thường gắn chỉ số đánh giá mô hình với chỉ số của sản phẩm. Bộ tiêu chí ML Test Score mà ta sẽ gặp ở Mục 6.5 cũng có một mục riêng cho yêu cầu này: chỉ số ngoại tuyến phải tương quan với chỉ số đo trực tuyến.
Quan hệ giữa hai loại chỉ số hiếm khi là tuyến tính. Với một mô hình phát hiện gian lận, khi AUC đã đủ cao, tăng thêm AUC có thể không làm số tiền thiệt hại giảm thêm, vì nhóm điều tra đã hết khả năng xử lý các giao dịch bị đánh dấu. Với một hệ thống xếp hạng, xếp hạng quá sát với sở thích cũ của người dùng có thể làm họ ít khám phá nội dung mới và rời đi sớm hơn, dù chỉ số NDCG tăng (Chương 12 phân tích hiện tượng này). Với một mô hình ngôn ngữ, perplexity thấp hơn chỉ tương quan yếu với việc người dùng có chấp nhận câu trả lời hay không, và tương quan càng yếu khi mô hình đã đủ tốt. Các ví dụ này minh hoạ những dạng quan hệ thường gặp, không phải số đo cụ thể.
Từ đó có một quy tắc thực hành: dùng một chỉ số ngoại tuyến rẻ để lặp nhanh trong quá trình phát triển, nhưng định kỳ kiểm tra xem nó còn tương quan với chỉ số sản phẩm không. Khi tương quan không còn, cải thiện chỉ số ngoại tuyến không mang lại giá trị cho sản phẩm nữa.
6.3Đánh giá theo lát cắt#
Đánh giá theo lát cắt (slice-based evaluation) là tính chỉ số riêng cho từng nhóm con của dữ liệu, thay vì chỉ một con số trên toàn bộ tập kiểm tra. Đây là một trong những kỹ thuật cho lợi ích lớn nhất so với công sức bỏ ra. Ví dụ dưới đây cho thấy vì sao.
Một cửa hàng trực tuyến có 85% khách hàng cũ (nhóm A) và 15% khách hàng mới (nhóm B). Mô hình v1 dự đoán hành vi của khách hàng từ một đặc trưng mà mọi khách hàng đều có. Để cải thiện, nhóm phát triển thêm đặc trưng là "lịch sử mua hàng", tạo ra mô hình v2. Với khách hàng cũ, mang nhiều thông tin về nhãn. Với khách hàng mới, chưa có lịch sử nên chỉ là nhiễu. Cả v1 và v2 đều là hồi quy logistic và không biết khách hàng thuộc nhóm nào. Thí nghiệm trong code/mlops/experiments.py mô phỏng đúng tình huống này với 8 000 mẫu huấn luyện và 8 000 mẫu kiểm tra.
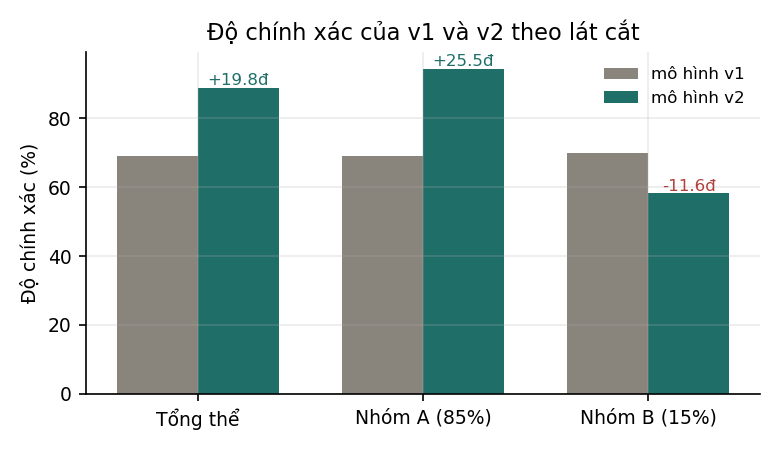
| Lát cắt | v1 | v2 | Thay đổi |
|---|---|---|---|
| Tổng thể | 69,14% | 88,96% | +19,83 điểm |
| Nhóm A: khách hàng cũ, 85% lưu lượng | 68,99% | 94,48% | +25,49 điểm |
| Nhóm B: khách hàng mới, 15% lưu lượng | 69,97% | 58,35% | −11,62 điểm |
Nếu chỉ nhìn dòng đầu tiên, v2 tốt hơn v1 gần 20 điểm phần trăm và chắc chắn sẽ được chọn. Tách theo nhóm thì thấy một bức tranh khác: khách hàng cũ được lợi lớn, còn khách hàng mới bị hại, xuống dưới cả mức của mô hình cũ. Nguyên nhân nằm ở cách mô hình học trọng số. Vì rất có ích với 85% dữ liệu, mô hình gán cho nó trọng số lớn (2,28, so với 1,07 của ). Với 15% khách hàng mới, chính trọng số lớn đó đưa nhiễu thẳng vào dự đoán. Đây là một minh hoạ đo được của nguyên lý CACE ở Mục 1.3: thêm một đặc trưng không cộng thêm một thứ vào mô hình mà thay đổi toàn bộ hàm dự đoán.
Có nhiều cách sửa, nhưng chỉ nghĩ ra được sau khi đã thấy vấn đề qua lát cắt. Có thể mã hoá trạng thái "chưa có lịch sử" thành một giá trị thiếu tường minh kèm một đặc trưng chỉ báo, thay vì để nó thành một số ngẫu nhiên; có thể thêm tương tác giữa và nhóm khách hàng; hoặc dùng một mô hình riêng cho khách hàng mới.
Nên theo dõi những lát cắt nào phụ thuộc vào bài toán, nhưng thường có bốn loại: lát cắt theo nghiệp vụ (khách hàng mới hay cũ, thị trường, hạng khách hàng, kênh bán), lát cắt theo kỹ thuật (thiết bị, phiên bản ứng dụng, có hay không có một đặc trưng nào đó), lát cắt theo các nhóm được pháp luật bảo vệ nếu bài toán liên quan tới công bằng, và lát cắt theo thời gian (giờ trong ngày, ngày trong tuần, ngày lễ). Tiêu chí Model 6 của ML Test Score phát biểu đúng yêu cầu này: chất lượng mô hình phải đủ tốt trên mọi lát cắt dữ liệu quan trọng.
6.4Kiểm thử hành vi#
Phần mềm thông thường được kiểm thử bằng các khẳng định cụ thể: với đầu vào này thì đầu ra phải là kia. Mô hình học máy cũng cần loại kiểm thử đó, bên cạnh chỉ số trung bình trên tập kiểm tra. Ribeiro và cộng sự (2020), với bộ công cụ CheckList, phân biệt ba loại kiểm thử hành vi:
# 1. Chức năng tối thiểu (minimum functionality): những trường hợp đơn giản không được phép sai
assert sentiment("Sản phẩm này tuyệt vời") == "tích cực"

# 2. Bất biến (invariance): thay đổi không liên quan thì dự đoán phải giữ nguyên
assert sentiment("Chuyến bay tới Hà Nội bị huỷ") == sentiment("Chuyến bay tới Đà Nẵng bị huỷ")

# 3. Kỳ vọng có hướng (directional expectation): thay đổi có hướng rõ thì dự đoán phải đổi đúng hướng
assert risk(income=50_000_000) <= risk(income=5_000_000)   # các đặc trưng khác giữ nguyên
Loại thứ nhất kiểm tra những trường hợp đơn giản mà mô hình nào cũng phải làm đúng. Loại thứ hai kiểm tra rằng những thay đổi không liên quan, như tên một thành phố, không làm thay đổi dự đoán. Loại thứ ba kiểm tra rằng khi đầu vào thay đổi theo một hướng có ý nghĩa rõ ràng, như thu nhập tăng, dự đoán thay đổi đúng hướng.
Giá trị của các kiểm thử này nằm ở chỗ chỉ số trung bình không phát hiện được những lỗi chúng tìm ra. Một mô hình có thể tăng một điểm độ chính xác trung bình mà mất khả năng xử lý đúng một trường hợp hiển nhiên. Vì vậy các kiểm thử hành vi nên chạy tự động mỗi khi có mô hình mới, giống như kiểm thử đơn vị trong CI.
6.5Bộ tiêu chí ML Test Score#
Ba cách đánh giá ở trên áp dụng cho mô hình. Để đánh giá mức sẵn sàng của cả hệ thống, bộ tiêu chí đầy đủ nhất là The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction của Breck và cộng sự (2017), cũng từ Google. Bộ tiêu chí gồm 28 mục chia thành bốn nhóm, mỗi nhóm 7 mục.
Nhóm thứ nhất kiểm tra dữ liệu và đặc trưng:
| Mục | Nội dung |
|---|---|
| Data 1 | Kỳ vọng về đặc trưng được ghi lại thành một lược đồ |
| Data 2 | Mọi đặc trưng đều có ích |
| Data 3 | Không đặc trưng nào có chi phí quá lớn so với lợi ích |
| Data 4 | Đặc trưng tuân thủ các yêu cầu ở mức chính sách (quyền riêng tư, pháp lý) |
| Data 5 | Pipeline dữ liệu có kiểm soát quyền riêng tư phù hợp |
| Data 6 | Có thể thêm đặc trưng mới nhanh chóng |
| Data 7 | Toàn bộ mã tính đặc trưng đều được kiểm thử |
Nhóm thứ hai kiểm tra quá trình phát triển mô hình:
| Mục | Nội dung |
|---|---|
| Model 1 | Mọi đặc tả mô hình đều được rà soát và đưa vào kho mã |
| Model 2 | Chỉ số ngoại tuyến tương quan với chỉ số trực tuyến |
| Model 3 | Mọi siêu tham số đã được tinh chỉnh |
| Model 4 | Đã biết ảnh hưởng của việc mô hình cũ đi |
| Model 5 | Một mô hình đơn giản hơn không tốt hơn (kiểm tra định kỳ) |
| Model 6 | Chất lượng đủ tốt trên mọi lát cắt dữ liệu quan trọng |
| Model 7 | Mô hình đã được kiểm tra về tính bao hàm giữa các nhóm người dùng |
Nhóm thứ ba kiểm tra hạ tầng học máy:
| Mục | Nội dung |
|---|---|
| Infra 1 | Huấn luyện tái lập được |
| Infra 2 | Mã đặc tả mô hình có kiểm thử đơn vị |
| Infra 3 | Toàn bộ pipeline có kiểm thử tích hợp |
| Infra 4 | Chất lượng mô hình được kiểm định trước khi đưa vào phục vụ |
| Infra 5 | Mô hình gỡ lỗi được bằng cách quan sát từng bước tính |
| Infra 6 | Mô hình được thử qua quy trình canary trước khi phục vụ toàn bộ |
| Infra 7 | Có thể quay lui mô hình đang phục vụ nhanh và an toàn |
Nhóm thứ tư kiểm tra việc giám sát:
| Mục | Nội dung |
|---|---|
| Monitor 1 | Thay đổi ở các hệ thống phụ thuộc phía trước sinh ra thông báo |
| Monitor 2 | Các bất biến của dữ liệu đúng ở cả đầu vào huấn luyện lẫn đầu vào phục vụ |
| Monitor 3 | Đặc trưng lúc huấn luyện và lúc phục vụ tính ra cùng giá trị |
| Monitor 4 | Mô hình không quá cũ |
| Monitor 5 | Mô hình ổn định về mặt số học (không có NaN, không có giá trị vô cùng) |
| Monitor 6 | Không có suy giảm, đột ngột hay từ từ, về tốc độ huấn luyện, độ trễ phục vụ, thông lượng hay bộ nhớ |
| Monitor 7 | Chất lượng dự đoán trên dữ liệu thật không suy giảm |
Nhiều mục trong bảng đã xuất hiện ở các chương trước: Data 1 là hợp đồng dữ liệu ở Mục 3.3, Model 6 là đánh giá theo lát cắt ở Mục 6.3, Infra 1 là tái lập ở Chương 5, Monitor 3 là lệch huấn luyện–phục vụ ở Mục 4.1.
Cách tính điểm của bộ tiêu chí có một chi tiết đáng hiểu kỹ. Mỗi mục được 0,5 điểm nếu được thực hiện thủ công, có ghi lại kết quả và gửi cho những người liên quan, và được 1 điểm nếu có hệ thống chạy nó tự động và định kỳ. Điểm của mỗi nhóm là tổng điểm các mục trong nhóm. Điểm cuối cùng của hệ thống không phải là tổng hay trung bình, mà là giá trị nhỏ nhất trong bốn điểm nhóm. Bài báo giải thích rằng cả bốn nhóm đều quan trọng, nên muốn tăng điểm phải cải thiện cả bốn. Hệ quả là một hệ thống có hạ tầng huấn luyện hoàn hảo nhưng không có giám sát nào vẫn có điểm 0, dù ba nhóm kia đạt tối đa.
Bài báo đưa ra bảng diễn giải điểm sau (Bảng V trong bài):
| Điểm | Ý nghĩa |
|---|---|
| 0 | giống một dự án nghiên cứu hơn là một hệ thống sản xuất |
| (0, 1] | đã có kiểm thử, nhưng có thể còn những lỗ hổng nghiêm trọng về độ tin cậy |
| (1, 2] | đã có bước đầu đưa vào sản xuất, cần đầu tư thêm |
| (2, 3] | kiểm thử tương đối đủ, nhiều mục còn có thể tự động hoá |
| (3, 5] | kiểm thử và giám sát tự động ở mức cao, phù hợp với hệ thống trọng yếu |
| > 5 | kiểm thử và giám sát tự động ở mức rất cao |
Các tác giả cũng lưu ý rằng hệ thống ở những giai đoạn khác nhau nên nhắm tới những mức điểm khác nhau: một bản nguyên mẫu không cần đạt mức của một hệ thống trọng yếu.
6.6Tóm tắt#
Một chỉ số tổng hợp trên tập kiểm tra không đủ để quyết định triển khai một mô hình. Chỉ số đó cần được kiểm tra định kỳ xem còn tương quan với chỉ số sản phẩm không, cần được tách theo lát cắt để không che mất các nhóm nhỏ, và cần được bổ sung bằng kiểm thử hành vi trên những trường hợp cụ thể. Ở mức cả hệ thống, ML Test Score cho một danh sách 28 mục, và cách tính điểm theo giá trị nhỏ nhất buộc phải chú ý tới cả bốn nhóm, trong đó giám sát thường là nhóm yếu nhất.
Khi mô hình đã qua đánh giá, nó cần được đóng gói và đặt vào một dịch vụ để nhận yêu cầu. Chương 7 bàn về cách phục vụ mô hình và những ràng buộc về độ trễ đi kèm.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Trong thí nghiệm đánh giá theo lát cắt ở Mục 6.3, điều gì xảy ra?
Vì sao: Đặc trưng mới chỉ có thông tin với khách hàng cũ, nên mô hình học cho nó trọng số lớn (2,28); với khách hàng mới, trọng số lớn đó đưa nhiễu vào dự đoán. Đây là một ví dụ đo được của nguyên lý CACE.2ML Test Score cuối cùng được tính thế nào?
Vì sao: Mỗi mục được 0,5 điểm nếu làm thủ công có ghi lại kết quả, 1 điểm nếu tự động và định kỳ. Lấy giá trị nhỏ nhất vì cả bốn nhóm đều cần thiết: hệ thống có hạ tầng hoàn hảo mà không có giám sát vẫn có điểm 0.3Mục Monitor 6 của ML Test Score kiểm tra điều gì?
Vì sao: Chất lượng dự đoán là Monitor 7; đặc trưng khớp giữa huấn luyện và phục vụ là Monitor 3; độ cũ của mô hình là Monitor 4.4Ba loại kiểm thử hành vi theo CheckList là gì?
Vì sao: Một mô hình có thể tăng một điểm độ chính xác trung bình mà sai ở một trường hợp hiển nhiên; chỉ số trung bình không phát hiện được điều đó, kiểm thử hành vi thì có (Ribeiro và cộng sự, 2020).
Đã trả lời 0/4