4Đặc trưng#
Một mô hình không học trực tiếp từ bảng dữ liệu gốc mà từ các đặc trưng được tính từ đó: tổng chi tiêu trong 30 ngày, số lần đăng nhập trong tuần, tỉ lệ đơn hàng bị huỷ. Việc tính đặc trưng nghe đơn giản, nhưng nó là nơi phát sinh hai lỗi khó phát hiện nhất của học máy. Cả hai đều có chung một đặc điểm: mô hình vẫn chạy, kết quả đánh giá vẫn tốt, và lỗi chỉ lộ ra khi mô hình đã phục vụ người dùng thật.
4.1Lệch giữa huấn luyện và phục vụ#
Xét đặc trưng "tổng chi tiêu trong 30 ngày qua" của một khách hàng. Khi chuẩn bị dữ liệu huấn luyện, nhóm khoa học dữ liệu tính nó bằng một truy vấn SQL trên kho dữ liệu. Khi đưa mô hình vào phục vụ, truy vấn đó quá chậm để chạy cho mỗi yêu cầu, nên nhóm kỹ thuật viết lại phép tính bằng Python trong dịch vụ phục vụ. Hai đoạn mã do hai người viết ở hai thời điểm, và rất hiếm khi chúng khớp nhau hoàn toàn: một bên tính 30 ngày theo lịch, bên kia tính 720 giờ tính lùi từ lúc có yêu cầu; một bên đã loại các giao dịch được hoàn tiền, bên kia thì chưa.
Hiện tượng đặc trưng lúc phục vụ khác với đặc trưng lúc huấn luyện được gọi là lệch giữa huấn luyện và phục vụ (training–serving skew). Tài liệu của Google Cloud định nghĩa nó đúng như vậy, và lưu ý rằng hậu quả là chất lượng mô hình giảm sau khi triển khai. Lỗi này không làm chương trình báo lỗi nào. Mô hình vẫn nhận đủ đặc trưng, chỉ có điều giá trị của chúng hơi khác so với những gì nó đã học, và độ chính xác mất đi vài điểm phần trăm mà không ai biết vì sao.
4.2Tính đúng theo thời điểm#
Lỗi thứ hai xảy ra ngay lúc dựng tập huấn luyện, trước khi mô hình được triển khai. Để hiểu nó, cần một khái niệm.
Định nghĩa 4.1 (Tính đúng theo thời điểm)
Một tập huấn luyện có tính đúng theo thời điểm (point-in-time correctness) nếu với mỗi dòng có thời điểm dự đoán , giá trị của mọi đặc trưng là giá trị quan sát được tại , không phải giá trị tại thời điểm dựng tập dữ liệu.
Định nghĩa nghe hiển nhiên: lúc dự đoán thật, mô hình chỉ biết những gì đã xảy ra trước đó, nên lúc huấn luyện cũng phải như vậy. Nhưng vi phạm nó rất dễ, vì cách viết truy vấn tự nhiên nhất lại cho kết quả sai.
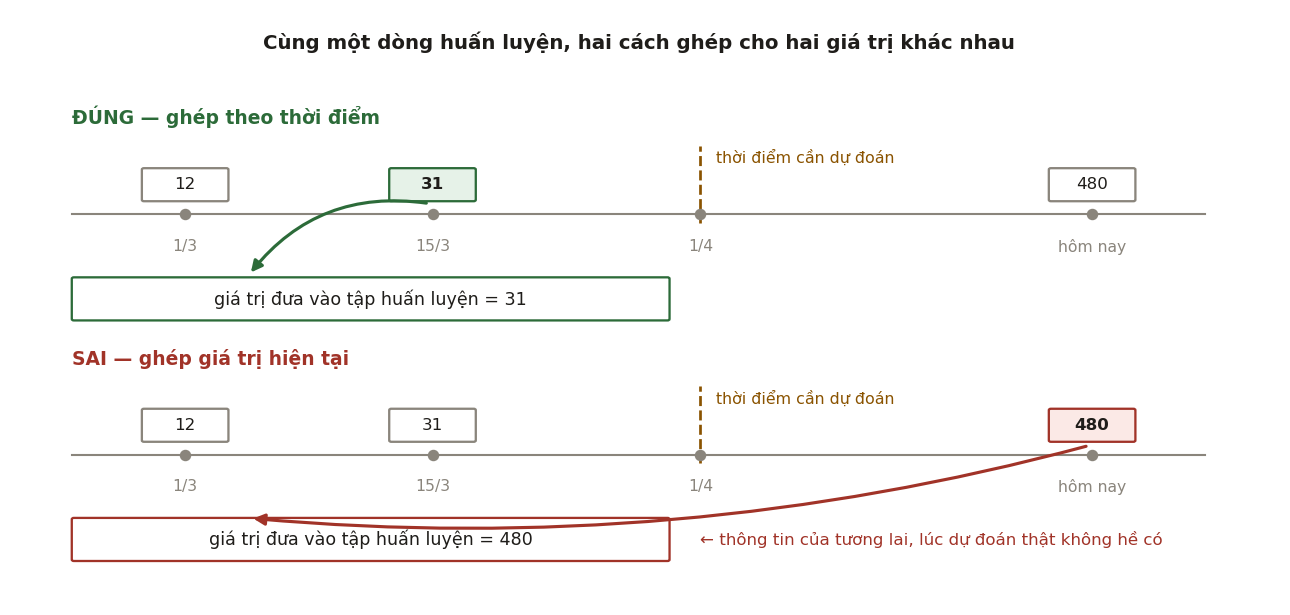
Giả sử ta có bảng nhãn (mỗi dòng là một khách hàng tại một thời điểm, kèm nhãn có rời bỏ dịch vụ hay không) và một bảng đặc trưng của khách hàng. Cách ghép hai bảng mà ai cũng viết đầu tiên là:
-- SAI: lấy giá trị đặc trưng HIỆN TẠI cho mọi dòng lịch sử
SELECT  l.user_id, l.event_time, l.label,
        f.total_orders                  -- giá trị của hôm nay
FROM    labels l
JOIN    user_features f ON f.user_id = l.user_id;
Truy vấn này đúng cú pháp và chạy nhanh, nhưng nó gán cho mọi dòng lịch sử giá trị đặc trưng của ngày hôm nay. Cách ghép đúng phải xét thêm trục thời gian: với mỗi dòng nhãn, lấy bản ghi đặc trưng mới nhất nhưng không muộn hơn thời điểm dự đoán của dòng đó. Phép ghép này được gọi là ghép theo thời điểm (point-in-time join hoặc as-of join):
-- ĐÚNG: ghép theo thời điểm (point-in-time join, as-of join)
SELECT  l.user_id, l.event_time, l.label, f.total_orders
FROM    labels l
LEFT JOIN LATERAL (
    SELECT total_orders
    FROM   user_features_history h
    WHERE  h.user_id    = l.user_id
      AND  h.valid_from <= l.event_time      -- chỉ nhìn về quá khứ
    ORDER BY h.valid_from DESC
    LIMIT 1
) f ON TRUE;
Điều làm lỗi này nguy hiểm là nó không làm kết quả đánh giá xấu đi mà làm chúng tốt lên. Với truy vấn sai, mô hình học được rằng khách hàng có 480 đơn hàng thì không rời bỏ dịch vụ. Quan hệ đó có thật trong dữ liệu, nhưng con số 480 chỉ tồn tại vì khách hàng đã ở lại. Khi dự đoán thật cho một khách hàng vào tháng 3, con số mô hình nhận được là 12 hoặc 31, không phải 480, và mô hình hoạt động kém hơn hẳn so với lúc đánh giá. Vì kết quả ngoại tuyến tốt nên không ai nghi ngờ trước khi triển khai. Shankar và cộng sự ghi nhận đúng điều này: rò rỉ dữ liệu, tức giả định lúc huấn luyện rằng có những dữ liệu mà lúc phục vụ không có, thường chỉ bị phát hiện sau khi mô hình đã được triển khai và đã đưa ra một số dự đoán sai. Mục 8.5 của Nền tảng trình bày các dạng rò rỉ khi chia dữ liệu huấn luyện và kiểm tra.
4.3Các dạng rò rỉ dữ liệu#
Rò rỉ theo thời gian như ở Mục 4.2 là dạng phổ biến nhất, nhưng không phải dạng duy nhất. Có thể phân biệt ba dạng, xếp theo mức độ khó phát hiện tăng dần.
Dạng thứ nhất là rò rỉ theo thời gian vừa trình bày. Cách phòng là ghép theo thời điểm, cộng với ràng buộc "không có sự kiện từ tương lai" trong hợp đồng dữ liệu (Mục 3.3).
Dạng thứ hai là rò rỉ theo thực thể. Khi chia dữ liệu ngẫu nhiên theo dòng, cùng một người dùng có thể có dữ liệu ở cả tập huấn luyện lẫn tập kiểm tra, và mô hình được kiểm tra trên chính những người nó đã thấy. Kết quả kiểm tra khi đó đánh giá quá cao khả năng của mô hình với người dùng mới. Cách phòng là chia theo nhóm thực thể (mỗi người dùng nằm trọn trong một tập), và với dữ liệu có yếu tố thời gian thì chia theo thời gian.
Dạng thứ ba khó nhất: đặc trưng là hệ quả của nhãn. Ví dụ, khi dự đoán một khách hàng có gặp sự cố với dịch vụ hay không, đặc trưng "số lần gọi tổng đài trong tuần" có thể rất mạnh, vì người gặp sự cố thì gọi tổng đài. Về mặt thời gian, đặc trưng này có thể hợp lệ, nhưng nó là hậu quả của điều cần dự đoán chứ không phải nguyên nhân, và vào lúc cần dự đoán (trước khi khách gọi) nó chưa tồn tại. Không phép kiểm tra tự động nào phát hiện được dạng rò rỉ này. Cách duy nhất là xem xét từng đặc trưng với hai câu hỏi: tại thời điểm cần dự đoán, giá trị này đã tồn tại chưa, và nó có tồn tại chỉ vì nhãn hay không.
4.4Kho đặc trưng#
Cả hai lỗi ở đầu chương đều liên quan tới việc đặc trưng được tính ở nhiều nơi khác nhau và không lưu lịch sử. Kho đặc trưng (feature store) là lớp hạ tầng được xây dựng để giải quyết chúng. Một kho đặc trưng thường gồm ba thành phần.
Thành phần thứ nhất là kho ngoại tuyến (offline store), lưu toàn bộ lịch sử giá trị của các đặc trưng kèm thời điểm có hiệu lực. Nó cần thông lượng cao và hỗ trợ ghép theo thời điểm trên dữ liệu lớn, để dựng tập huấn luyện đúng như Mục 4.2. Thành phần thứ hai là kho trực tuyến (online store), chỉ lưu giá trị mới nhất của mỗi thực thể và trả về trong vài mili giây khi tra theo khoá, để phục vụ các yêu cầu dự đoán. Thành phần thứ ba là sổ đăng ký đặc trưng (feature registry), nơi mỗi đặc trưng có một định nghĩa duy nhất, dùng chung cho cả hai kho.
Sổ đăng ký là thành phần quan trọng nhất, vì nó giải quyết lệch huấn luyện–phục vụ bằng cách buộc hai đường huấn luyện và phục vụ dùng chung một định nghĩa thay vì hai bản cài đặt. Kho ngoại tuyến giải quyết rò rỉ theo thời gian bằng cách giữ lịch sử để ghép được theo thời điểm.
Cần lưu ý rằng kho đặc trưng chỉ tạo điều kiện chứ không tự động loại bỏ lệch huấn luyện–phục vụ. Nếu vì lý do độ trễ mà nhóm vẫn viết một đường tính riêng cho phục vụ, sự lệch sẽ quay lại. Các công cụ khác nhau ở điểm này: có công cụ chỉ cung cấp hạ tầng lưu trữ và để nhóm tự giữ kỷ luật, có công cụ buộc mọi đặc trưng phải đi qua một định nghĩa duy nhất.
4.5Phạm vi áp dụng của kho đặc trưng#
Kho đặc trưng là một hạ tầng phức tạp, và không phải hệ thống nào cũng cần. Nó chỉ đáng đầu tư khi có đồng thời ba điều kiện. Điều kiện thứ nhất là có nhiều mô hình dùng chung đặc trưng; với một mô hình duy nhất, lợi ích tái sử dụng gần như bằng không. Điều kiện thứ hai là phải phục vụ trực tuyến với độ trễ thấp; nếu chỉ chấm điểm theo lô mỗi đêm, đọc thẳng từ kho dữ liệu là đủ. Điều kiện thứ ba là đặc trưng phụ thuộc thời gian và được cập nhật thường xuyên; nếu đặc trưng gần như cố định, vấn đề ghép theo thời điểm không còn nữa.
Khi thiếu các điều kiện đó, một bảng trong kho dữ liệu cộng với kỷ luật dùng chung một hàm biến đổi đặc trưng cho cả huấn luyện lẫn phục vụ đạt cùng mục tiêu với chi phí thấp hơn nhiều.
4.6Tóm tắt#
Lệch huấn luyện–phục vụ xảy ra khi đặc trưng được tính bằng hai bản cài đặt khác nhau; rò rỉ dữ liệu xảy ra khi tập huấn luyện chứa thông tin mà lúc dự đoán thật chưa có. Cả hai đều không làm chương trình báo lỗi, và rò rỉ còn làm kết quả đánh giá tốt lên, nên chỉ được phát hiện sau khi triển khai. Cách phòng chung là một định nghĩa đặc trưng duy nhất cho mọi nơi, ghép dữ liệu theo thời điểm, và xem xét từng đặc trưng xem nó có phải là hệ quả của nhãn không. Kho đặc trưng hỗ trợ những việc đó, nhưng chỉ đáng đầu tư khi có nhiều mô hình, phục vụ trực tuyến và đặc trưng thay đổi theo thời gian.
Đến đây ta có dữ liệu và đặc trưng đáng tin cậy để huấn luyện. Bước tiếp theo là huấn luyện sao cho khi cần, ta dựng lại được đúng mô hình đã huấn luyện. Chương 5 bàn về điều đó.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Lệch giữa huấn luyện và phục vụ (training–serving skew) là gì?
Vì sao: Thường vì có hai bản cài đặt riêng: một truy vấn SQL khi huấn luyện và một đoạn mã viết lại trong dịch vụ phục vụ. Loại lỗi này không gây ra lỗi chương trình nào; mô hình vẫn chạy nhưng kém đi.2Tính đúng theo thời điểm đòi hỏi điều gì?
Vì sao: Vi phạm tính chất này là đưa thông tin tương lai vào tập huấn luyện. Nó làm kết quả đánh giá ngoại tuyến tốt lên, nên thường chỉ bị phát hiện sau khi triển khai.3Khi nào không cần xây dựng kho đặc trưng?
Vì sao: Kho đặc trưng đáng đầu tư khi có đồng thời: nhiều mô hình dùng chung đặc trưng, phục vụ trực tuyến với độ trễ thấp, và đặc trưng phụ thuộc thời gian. Thiếu các điều kiện đó, một bảng trong kho dữ liệu cộng với một hàm biến đổi dùng chung là đủ.4Loại rò rỉ nào không có kiểm tra tự động nào phát hiện được?
Vì sao: Ví dụ "số lần gọi tổng đài sau sự cố" để dự đoán "khách có gặp sự cố không": hợp lệ về thời gian nhưng là hệ quả của nhãn. Chỉ có cách xem xét từng đặc trưng: tại thời điểm dự đoán, giá trị này đã tồn tại chưa, và nó có tồn tại vì nhãn không?
Đã trả lời 0/4