8Mạng nơ-ron hồi quy#
Văn bản, tiếng nói và chuỗi thời gian là dữ liệu dạng chuỗi có độ dài thay đổi, và ý nghĩa của mỗi phần tử phụ thuộc vào những gì đứng trước nó. Một mạng truyền thẳng nhận đầu vào có kích thước cố định nên không xử lý trực tiếp được loại dữ liệu này. Mạng nơ-ron hồi quy (recurrent neural network, RNN) giải quyết bằng một ý tưởng đơn giản: đọc chuỗi từng phần tử một và giữ một trạng thái tóm tắt những gì đã đọc. Ý tưởng này gặp lại đúng vấn đề gradient của Chương 6, ở dạng nặng hơn, và cuối cùng bị Transformer thay thế vì một giới hạn mà không kỹ thuật huấn luyện nào sửa được.
8.1Mô hình#
Định nghĩa 8.1 (Mạng nơ-ron hồi quy)
Với chuỗi đầu vào , một RNN cập nhật trạng thái ẩn theo
với cho trước, thường bằng 0. Cùng các ma trận , , được dùng ở mọi bước.
Dùng chung trọng số ở mọi bước là dạng chia sẻ trọng số theo trục thời gian, giống chia sẻ trọng số theo không gian của tích chập (Mục 7.1). Nhờ đó RNN xử lý được chuỗi dài tuỳ ý với số tham số cố định, và cách xử lý một mẫu ở vị trí thứ 5 giống ở vị trí thứ 500.
Trường hợp một chiều cho thấy trạng thái ẩn nhớ và quên ra sao. Lấy với và chuỗi đầu vào . Ba trạng thái lần lượt là , và : sau mỗi bước, dấu vết của đầu vào đầu tiên còn chưa tới một nửa, vì nó bị nhân với hệ số 0,5 rồi đi qua tanh.
Có những bài toán không giải được nếu thiếu trạng thái ẩn. Karpathy (2015) minh hoạ điều này bằng một mô hình đoán ký tự tiếp theo trên chữ "hello". Một ví dụ tiếng Việt cùng kiểu là chuỗi "con cò", tính cả dấu cách, cho năm cặp gồm ký tự hiện tại và ký tự tiếp theo: c → o, o → n, n → dấu cách, dấu cách → c, c → ò. Hai cặp có cùng đầu vào "c" nhưng đáp án khác nhau, nên không mô hình nào chỉ nhìn ký tự hiện tại làm đúng được cả hai. Chỉ trạng thái ẩn, vốn nhớ rằng trước chữ "c" thứ hai đã có cả một từ "con", mới phân biệt được hai lần gặp chữ "c".
Để huấn luyện, RNN được trải ra theo thời gian thành một mạng truyền thẳng lớp dùng chung trọng số, rồi áp dụng lan truyền ngược lên mạng đó. Thuật toán này gọi là lan truyền ngược theo thời gian (backpropagation through time). Gradient theo trọng số dùng chung là tổng các gradient tại mọi bước. Với chuỗi rất dài, như một văn bản hàng triệu ký tự, lan truyền ngược được cắt thành từng đoạn, gọi là truncated BPTT: trạng thái ẩn vẫn được mang từ đoạn trước sang đoạn sau, nhưng gradient chỉ đi ngược trong phạm vi một đoạn, chẳng hạn 100 bước (CS231n).
8.2Gradient tiêu biến và bùng nổ theo thời gian#
Một câu như "Anh ấy lớn lên ở Nhật Bản, học hết phổ thông ở đó, rồi mới về nước đi làm, nên nói thạo tiếng ___" cần thông tin cách chỗ trống mười bảy âm tiết. Để học được phụ thuộc như vậy, gradient của mất mát tại chỗ trống phải truyền ngược về tận chữ "Nhật"; Olah (2015) và Andrew Ng đều mở đầu phần này bằng những câu cùng kiểu. Mạng trải ra theo thời gian là một mạng sâu lớp, nên nó gặp đúng vấn đề của Chương 6. Theo quy tắc dây chuyền, đạo hàm của trạng thái ở bước theo trạng thái ở bước là
với là giá trị trước hàm tanh ở bước . Với RNN một chiều ở Mục 8.1, mỗi thừa số là , nên , và qua 20 bước đạo hàm không vượt quá . Tình huống giống Mục 6.1, nhưng nghiêm trọng hơn ở một điểm: cùng một ma trận được nhân lặp lại lần, thay vì mỗi lớp một ma trận khác nhau. Pascanu, Mikolov và Bengio (2013) chỉ ra rằng nếu giá trị suy biến lớn nhất của nhỏ hơn 1 thì gradient chắc chắn tiêu biến theo hàm mũ, vì . Điều ngược lại không đúng: giá trị suy biến lớn nhất lớn hơn 1 chỉ là điều kiện cần để gradient bùng nổ, chưa phải điều kiện đủ, vì tanh bão hoà có thể kéo các thừa số xuống. Trong thí nghiệm dưới đây, là bán kính phổ, tức trị tuyệt đối lớn nhất của các trị riêng, nên các con số cần được đọc với lưu ý đó.
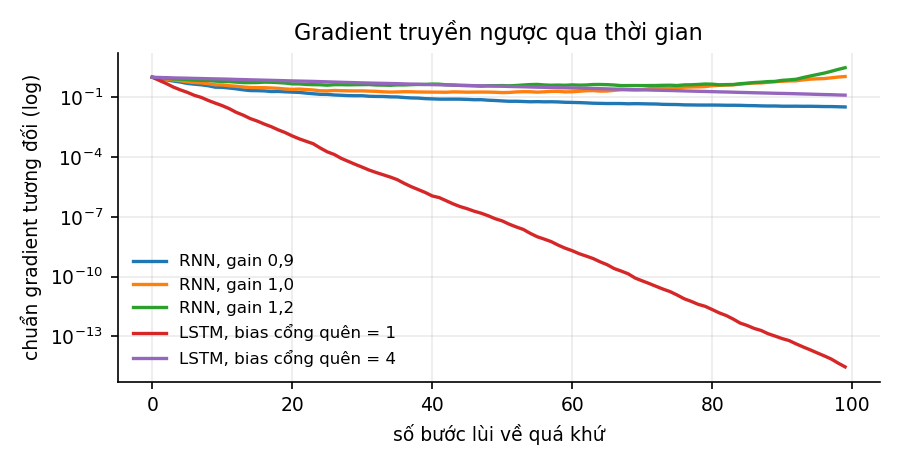
Thí nghiệm trong code/models/experiments.py đo trực tiếp hiện tượng này. Một RNN tanh 64 chiều có với các phần tử độc lập, phương sai , nên bán kính phổ xấp xỉ ; trạng thái đầu nhỏ, và mạng chạy 100 bước. Một gradient ngẫu nhiên được truyền ngược từ bước cuối, và thí nghiệm đo chuẩn của gradient sau 10, 50 và 100 bước lùi, chia cho chuẩn sau 1 bước và lấy trung bình trên 8 lần khởi tạo.
| Mô hình | Sau 10 bước | Sau 50 bước | Sau 100 bước |
|---|---|---|---|
| RNN, | |||
| RNN, | |||
| RNN, | |||
| Đường ô nhớ của LSTM, hệ số chặn cổng quên 1 | |||
| Đường ô nhớ của LSTM, hệ số chặn cổng quên 4 |
Với , gradient giảm đều. Với và , gradient giảm trong khoảng 50 bước lùi đầu rồi tăng trở lại, tới 3,0 sau 100 bước với . Lý do nằm ở trạng thái đầu nhỏ. Ở các bước đầu của chuỗi, còn nhỏ nên tanh gần như tuyến tính và Jacobi xấp xỉ , có bán kính phổ lớn hơn 1; ở các bước sau, với , trạng thái lớn dần, tanh bão hoà và đạo hàm của nó kéo Jacobi xuống. Như vậy độ lớn của gradient phụ thuộc cả vào lẫn vào mức bão hoà của các đơn vị dọc theo chuỗi, và trong khi huấn luyện, cả hai đều thay đổi. Hai dòng cuối của bảng nói về LSTM và sẽ được giải thích ở Mục 8.3.
Hai loại sự cố cần cách xử lý khác nhau. Bùng nổ dễ xử lý: cắt ngưỡng gradient (gradient clipping) nhân gradient với mỗi khi chuẩn của nó, tính trên toàn bộ tham số ghép lại, vượt ngưỡng , giữ nguyên hướng và chỉ giới hạn độ lớn (Pascanu, Mikolov và Bengio, 2013). Kỹ thuật này được dùng rộng rãi, kể cả khi huấn luyện Transformer. Tiêu biến thì khó xử lý hơn nhiều. Một gradient đã quá nhỏ không thể phóng to lại một cách có ý nghĩa, vì thông tin về ảnh hưởng của các bước xa đã lẫn vào nhiễu. Tệ hơn, khi gradient từ xa đã tiêu biến, quá trình học không phân biệt được hai tình huống: dữ liệu thật sự không có phụ thuộc xa, hay có nhưng tham số hiện tại chưa nắm được nó (CS224n). Muốn sửa phải thay đổi kiến trúc, và đó là việc LSTM làm.
8.3LSTM và GRU#
Kiến trúc giải quyết được vấn đề tiêu biến là LSTM (long short-term memory; Hochreiter và Schmidhuber, 1997, với cổng quên do Gers, Schmidhuber và Cummins, 2000 bổ sung). LSTM thêm một trạng thái ô nhớ bên cạnh trạng thái ẩn , và ba cổng có giá trị trong :
Cổng quên quyết định giữ lại bao nhiêu phần của ô nhớ cũ, cổng vào quyết định ghi thêm bao nhiêu thông tin mới, cổng ra quyết định đưa bao nhiêu phần của ô nhớ ra trạng thái ẩn. Chẳng hạn với một ô nhớ một chiều có , nếu ở bước này , , và thì và . Ô nhớ giữ lại 90% giá trị cũ, ghi thêm một nửa giá trị mới, và chỉ một phần của nó được đưa ra ngoài. Olah (2015) ví trạng thái ô nhớ như một băng chuyền chạy thẳng qua mọi bước, chỉ bị tác động bởi một phép nhân và một phép cộng ở mỗi bước, nên thông tin đi dọc theo nó mà ít bị biến đổi.
Chỗ khác biệt quyết định là ô nhớ được cập nhật bằng phép cộng có trọng số, không qua phép nhân ma trận. Dọc theo đường đi qua ô nhớ, nếu bỏ qua các đường gián tiếp qua , ta có
Đây là tích của các số trong , không phải tích của các ma trận, và mạng học được giá trị của : khi cần giữ thông tin lâu, nó có thể đặt gần 1. Ở ví dụ trên, đạo hàm của theo dọc theo ô nhớ đúng bằng , không qua hàm tanh hay ma trận trọng số nào. Cơ chế này tương tự kết nối tắt ở Mục 6.5, nhưng theo trục thời gian.
Hai dòng cuối của bảng ở Mục 8.2 mô phỏng riêng đường đi này: gradient nhân với ở mỗi bước, với là nhiễu nhỏ. Kết quả cho thấy lợi ích của LSTM phụ thuộc vào giá trị cổng quên. Với hệ số chặn , cổng quên trung bình khoảng , và sau 100 bước gradient chỉ còn . Với , cổng quên khoảng , và gradient còn 0,13.
Có thể hiểu các con số này qua thang thời gian của bộ nhớ. Với cổng quên không đổi , thông tin suy giảm theo . Tổng các trọng số cho biết bộ nhớ kéo dài khoảng bao nhiêu bước, còn thời gian để tín hiệu giảm lần là ; hai con số gần nhau khi gần 1. Với , chúng là 3,7 và 3,2 bước, tức khoảng 4 bước; với , là 50 và 49,5 bước. Khuyến nghị phổ biến là khởi tạo (Jozefowicz, Zaremba và Sutskever, 2015), đủ cho các phụ thuộc cỡ vài bước tới vài chục bước ngay từ đầu huấn luyện. Khi biết trước chuỗi có phụ thuộc rất xa, Tallec và Ollivier (2018) đề xuất khởi tạo theo thang thời gian mong muốn, để các đơn vị khác nhau có bộ nhớ dài ngắn khác nhau.
Một biến thể gọn hơn là GRU (gated recurrent unit; Cho và cộng sự, 2014). GRU gộp cổng quên và cổng vào thành một cổng cập nhật, bỏ ô nhớ riêng và cổng ra, nên có ba khối trọng số thay vì bốn, tức ít hơn khoảng 25% tham số. Chung và cộng sự (2014) so sánh trên nhiều bài toán và không thấy bên nào tốt hơn một cách nhất quán, nên chọn giữa hai loại là việc phải quyết định bằng thực nghiệm. Khi đọc các tài liệu về GRU cần để ý quy ước: d2l.ai viết cổng cập nhật gần 1 nghĩa là giữ trạng thái cũ, còn Andrew Ng và CS224n dùng quy ước ngược lại.
Với những bài toán có sẵn cả câu trước khi xử lý, như gán nhãn từ loại hay nhận dạng thực thể, có thể chạy thêm một RNN theo chiều ngược lại và ghép trạng thái của hai chiều tại mỗi vị trí, để mỗi vị trí dùng được cả ngữ cảnh phía sau. RNN hai chiều như vậy không dùng được cho mô hình ngôn ngữ hay cho dữ liệu đến dần theo thời gian, vì phần sau của chuỗi chưa có.
8.4Giới hạn về tính song song#
Vấn đề gradient giảm nhẹ được bằng LSTM, cắt ngưỡng gradient và khởi tạo tốt. Giới hạn không khắc phục được nằm ở chính định nghĩa: phụ thuộc , nên các bước phải tính tuần tự. Xử lý một chuỗi dài cần bước nối tiếp nhau, dù có bao nhiêu phần cứng song song. Bảng sau so sánh một lớp RNN với một lớp self-attention (Chương 9), theo Vaswani và cộng sự (2017).
| Lớp RNN | Lớp self-attention | |
|---|---|---|
| Số phép tính mỗi lớp | ||
| Số bước phải thực hiện tuần tự | ||
| Độ dài đường đi dài nhất giữa hai vị trí |
Self-attention tốn nhiều phép tính hơn khi , nhưng các phép tính đó thực hiện song song được trên GPU, còn các bước tuần tự thì không. Đường đi ngắn giữa hai vị trí bất kỳ còn có nghĩa là gradient nối hai token cách xa nhau không phải đi qua phép nhân như trong RNN. Hai điểm này khiến Transformer thay thế RNN trong phần lớn bài toán xử lý ngôn ngữ.
Hướng hồi quy chưa kết thúc. Các mô hình không gian trạng thái (state space model) như Mamba (Gu và Dao, 2023) dùng phép truy hồi tuyến tính theo thời gian, cho phép huấn luyện song song bằng thuật toán quét (scan) và suy luận với bộ nhớ không đổi theo độ dài chuỗi, và cạnh tranh được với Transformer ở một số quy mô.
8.5Tóm tắt#
RNN xử lý chuỗi bằng một trạng thái ẩn cập nhật qua từng bước với trọng số dùng chung, và được huấn luyện bằng lan truyền ngược trên mạng trải ra theo thời gian, cắt thành từng đoạn khi chuỗi dài. Trạng thái ẩn là điều kiện cần: với chuỗi "con cò", cùng đầu vào "c" phải cho hai đáp án khác nhau. Vì cùng một ma trận được nhân lặp lại, gradient tiêu biến hoặc bùng nổ theo số bước; bùng nổ xử lý được bằng cắt ngưỡng gradient, còn tiêu biến cần thay đổi kiến trúc. LSTM cập nhật ô nhớ bằng phép cộng có cổng, nên gradient dọc theo ô nhớ chỉ nhân với các giá trị cổng quên mà mạng tự học; thang thời gian của bộ nhớ khoảng bước, và mô phỏng cho thấy sau 100 bước gradient còn 0,13 với cổng quên 0,98 nhưng chỉ với cổng quên 0,73. Giới hạn cuối cùng của RNN là các bước phải tính tuần tự, và đường đi giữa hai vị trí xa nhau dài .
Self-attention bỏ hẳn phép truy hồi: mọi vị trí lấy thông tin trực tiếp từ mọi vị trí khác trong một bước. Chương 9 xây Transformer từ phép toán đó.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Giới hạn nào của RNN là lý do chính khiến Transformer thay thế nó?
Vì sao: Về số phép tính, self-attention tốn , nhiều hơn của RNN khi . Transformer thắng ở khả năng song song hoá theo thời gian và đường đi ngắn giữa hai vị trí bất kỳ (Mục 8.4).2Dọc theo trạng thái ô nhớ của LSTM, gradient nhân với gì ở mỗi bước?
3Theo mô phỏng ở Mục 8.2, gradient dọc ô nhớ sau 100 bước còn bao nhiêu khi hệ số chặn của cổng quên bằng 1 và bằng 4?
Vì sao: Cổng quên trung bình là và , ứng với thang thời gian của bộ nhớ khoảng 4 và 50 bước. Thí nghiệm chỉ mô phỏng đường đi qua ô nhớ, không phải một mạng LSTM đầy đủ.4Vì sao gradient bùng nổ dễ xử lý hơn gradient tiêu biến?
Vì sao: Tiêu biến cần sửa bằng kiến trúc: cổng như LSTM, kết nối tắt, chuẩn hoá (Mục 8.2).
Đã trả lời 0/4