2Độ chệch và phương sai#
Mục 3.6 của Nền tảng đã tách sai số của một ước lượng thành độ chệch và phương sai. Ở đây ta áp dụng cùng phép tách cho dự đoán của cả một mô hình học máy, rồi đo từng thành phần bằng mô phỏng. Phép tách này có giá trị thực tế rất rõ: biết sai số chủ yếu đến từ độ chệch hay từ phương sai thì biết nên đổi mô hình hay nên thu thêm dữ liệu, hai hướng đi tốn kém theo những cách rất khác nhau.
2.1Vai trò của phân rã độ chệch – phương sai#
Nhiều quyết định trong các chương sau thực chất là điều chỉnh độ linh hoạt của mô hình: thêm hay bớt lớp, regularization mạnh hay nhẹ, cây sâu hay nông, lấy trung bình bao nhiêu mô hình. Mỗi quyết định như vậy làm hai loại sai số thay đổi theo hai chiều ngược nhau. Phân rã độ chệch – phương sai cho biết chính xác hai loại sai số đó là gì, và vì sao tổng của chúng thường nhỏ nhất ở một mức linh hoạt vừa phải.
2.2Phân rã sai số dự đoán#
Giả sử dữ liệu sinh từ mô hình , trong đó là hàm thật, là nhiễu có , và độc lập với . Một thuật toán học nhận tập huấn luyện và trả về hàm dự đoán . Vì là ngẫu nhiên, giá trị dự đoán tại một điểm cố định cũng là một biến ngẫu nhiên.
Trước khi phát biểu định lý, hai loại sai số nói ở Mục 2.1 có thể thấy ngay trên bốn căn hộ ở Mục 1.4. Bài giảng CS229 cũng đi theo thứ tự đó: độ chệch được hiểu trước hết là sai số vẫn còn kể cả khi có vô hạn dữ liệu, phương sai là mức mô hình thay đổi giữa các tập huấn luyện, và phép phân rã chặt chẽ đến sau. Giả sử giá thật là cộng nhiễu có phương sai ở mỗi căn, và ta dự đoán giá căn 120 m², nơi . Ba mô hình dưới đây đều cho dự đoán là một tổ hợp tuyến tính của bốn mức giá quan sát được, với các hệ số chỉ phụ thuộc vào diện tích. Nhiễu ở bốn căn độc lập, nên phương sai của dự đoán là .
| Mô hình | Hệ số tại 120 m² | Độ chệch | Phương sai |
|---|---|---|---|
| Hằng số: trung bình bốn giá | 0,25 cho mỗi căn | ||
| Đường thẳng | 0 | ||
| Đa thức bậc ba qua bốn điểm | 0 |
Mô hình hằng số có phương sai nhỏ nhất nhưng kỳ vọng của nó là , lệch 1,2 tỉ so với giá thật 3,45 tỉ. Đường thẳng và đa thức bậc ba đều không chệch, vì hàm thật là một đường thẳng, nhưng phương sai của đa thức gấp 46 lần đường thẳng: hệ số của căn 80 m² nghĩa là nhiễu ở căn đó bị khuếch đại sáu lần khi ngoại suy ra 120 m². Với , ước lượng ở Mục 10.2 của Nền tảng, phần sai số ngoài nhiễu là 1,442 cho mô hình hằng số, 0,0135 cho đường thẳng và 0,621 cho đa thức bậc ba.
Con số cần được đọc đúng. Tại chính bốn diện tích đã thấy, phương sai trung bình của ba mô hình chỉ là , và , bằng số tham số chia cho số điểm (Hastie, Tibshirani và Friedman, 2009). Phương sai của đa thức bậc ba lên tới chủ yếu vì 120 m² nằm ngoài khoảng dữ liệu, nơi nó phải ngoại suy: độ linh hoạt khuếch đại nhiễu mạnh nhất ở những chỗ dữ liệu không ràng buộc được mô hình. Định lý sau cho thấy độ chệch bình phương, phương sai và nhiễu cộng lại đúng bằng sai số kỳ vọng tại một điểm.
Định lý 2.1 (Phân rã độ chệch – phương sai)
Tại một điểm , với là một quan sát mới độc lập với tập huấn luyện, sai số bình phương kỳ vọng tách thành ba phần:
trong đó kỳ vọng và phương sai lấy theo phân phối của tập huấn luyện và của nhiễu .
Chứng minh
Viết gọn , và . Ta có . Bình phương và lấy kỳ vọng: số hạng chéo bằng 0 vì độc lập với và có kỳ vọng 0, còn . Phần còn lại được tách giống Định lý 3.2 của Nền tảng: viết , số hạng chéo bằng 0, còn lại .
Ba thành phần có ý nghĩa khác nhau. Độ chệch đo sai lệch có hệ thống: lấy trung bình trên rất nhiều tập huấn luyện, mô hình vẫn dự đoán lệch khỏi giá trị thật, vì họ hàm quá hẹp so với hàm thật. Độ chệch cao ứng với underfitting. Phương sai đo mức dao động: đổi tập huấn luyện thì dự đoán thay đổi nhiều, vì mô hình đủ linh hoạt để khớp cả phần nhiễu riêng của từng tập. Phương sai cao ứng với overfitting. Còn nhiễu không phụ thuộc vào mô hình; nó là cận dưới của sai số mà không mô hình nào vượt qua được.
Lưu ý
Độ chệch và phương sai được định nghĩa qua kỳ vọng trên các tập huấn luyện có thể rút ra, tại một điểm cố định. Chúng không đo mức dao động của dự đoán giữa các điểm dữ liệu khác nhau. Một mô hình có dự đoán thay đổi mạnh theo vẫn có thể có phương sai thấp, nếu huấn luyện trên tập dữ liệu khác thì nó cho gần như cùng một hàm.
Lưu ý
Phân rã trên chỉ đúng với mất mát bình phương. Với mất mát 0–1 của bài toán phân loại, chưa có một phân rã được chấp nhận chung, và trực giác từ hồi quy có thể sai. Nếu xác suất thật của lớp dương tại một điểm là 0,9 mà mô hình luôn ước lượng 0,6, độ chệch bình phương của ước lượng xác suất là 0,09, nhưng mô hình vẫn chọn đúng lớp dương, nên sai số 0–1 không tăng chút nào so với một mô hình biết xác suất thật (Hastie, Tibshirani và Friedman, 2009).
Ba mô hình này là một trường hợp của quy luật chung. Khi tăng độ linh hoạt của mô hình, độ chệch thường giảm vì họ hàm rộng hơn, còn phương sai thường tăng vì có nhiều cách hơn để khớp theo nhiễu. Tổng của chúng vì vậy thường có dạng chữ U theo độ linh hoạt. Chữ "thường" ở đây là cần thiết: định lý chỉ khẳng định phép tách, không khẳng định hai thành phần thay đổi đơn điệu, và Mục 2.3 sẽ cho thấy những trường hợp ngoại lệ. Chữ "đánh đổi" cũng không có nghĩa là giảm thành phần này buộc phải tăng thành phần kia: độ chệch và phương sai có thể cùng cao, và với mạng nơ-ron, tăng kích thước mạng đi kèm regularization thích hợp thường giảm được độ chệch mà không làm tăng phương sai, điều Andrew Ng nhấn mạnh trong khoá Deep Learning Specialization.
2.3Đo độ chệch và phương sai bằng mô phỏng#
Với dữ liệu mô phỏng, hàm thật đã biết, nên có thể đo trực tiếp cả ba thành phần: sinh nhiều tập huấn luyện độc lập, huấn luyện một mô hình trên mỗi tập, rồi tính trung bình và phương sai của các dự đoán tại từng điểm.
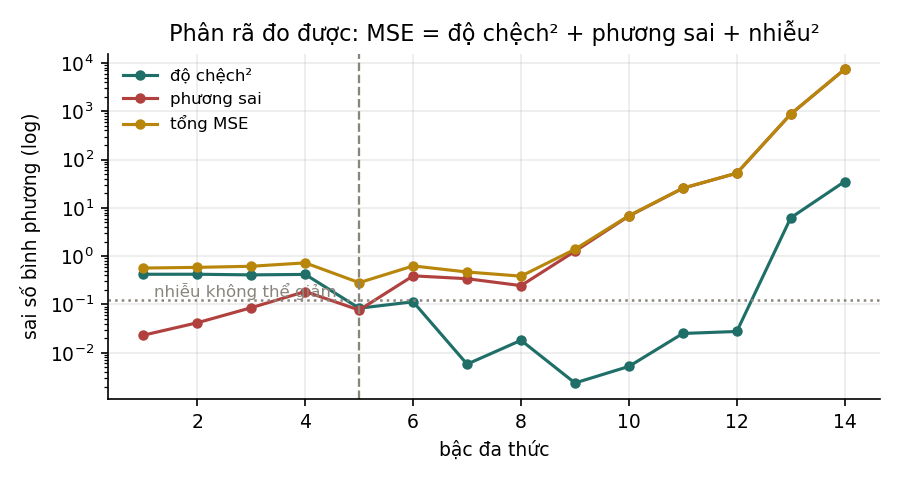
Thí nghiệm trong code/models/experiments.py dùng hàm thật trên đoạn và nhiễu Gauss có độ lệch chuẩn , tức . Mỗi tập huấn luyện gồm 40 điểm có rút đều trên đoạn. Với mỗi bậc đa thức từ 1 tới 14, thí nghiệm khớp đa thức trên 250 tập huấn luyện độc lập, rồi tính độ chệch² và phương sai tại 200 điểm cách đều và lấy trung bình theo các điểm.
| Bậc đa thức | Độ chệch² | Phương sai | Nhiễu | Tổng sai số |
|---|---|---|---|---|
| 1 | 0,4221 | 0,0231 | 0,1225 | 0,5677 |
| 2 | 0,4223 | 0,0418 | 0,1225 | 0,5866 |
| 3 | 0,4098 | 0,0857 | 0,1225 | 0,6180 |
| 4 | 0,4191 | 0,1852 | 0,1225 | 0,7268 |
| 5 | 0,0836 | 0,0767 | 0,1225 | 0,2828 |
| 7 | 0,0058 | 0,3415 | 0,1225 | 0,4699 |
| 9 | 0,0024 | 1,2645 | 0,1225 | 1,3894 |
| 12 | 0,0276 | 52,2156 | 0,1225 | 52,3657 |
| 14 | 35,1402 | 7 392,2751 | 0,1225 | 7 427,5379 |
Ta đọc bảng từ trên xuống. Ở bậc thấp, sai số đến từ độ chệch: với bậc 1, độ chệch² bằng 0,4221, chiếm 74% tổng sai số. Một đường thẳng không thể theo được hình sin dù có bao nhiêu dữ liệu, nên thu thêm dữ liệu không giúp gì; phải dùng họ hàm linh hoạt hơn.
Bảng còn cho thấy một chi tiết bất ngờ: tăng lên bậc chẵn gần như không làm giảm độ chệch. Độ chệch² ở bậc 2 bằng bậc 1 (0,4223 so với 0,4221), ở bậc 4 xấp xỉ bậc 3 (0,4191 so với 0,4098). Lý do là hàm thật là hàm lẻ, , còn dữ liệu rải đối xứng quanh 0, nên các số hạng bậc chẵn không giúp xấp xỉ tốt hơn; chúng chỉ thêm tham số để khớp nhiễu, nên phương sai tăng. Đây là một ví dụ cụ thể cho điều Mục 2.2 đã lưu ý: độ chệch không nhất thiết giảm đều khi mô hình phức tạp hơn, mà chỉ giảm khi họ hàm mở rộng theo hướng có ích cho việc xấp xỉ hàm thật.
Tổng sai số nhỏ nhất ở bậc 5, nơi độ chệch² 0,0836 và phương sai 0,0767 gần bằng nhau. Tổng 0,2828 vẫn cao hơn mức nhiễu 0,1225, và phần chênh này là sai số không tránh được khi chỉ có 40 điểm dữ liệu.
Từ bậc 7 trở đi, sai số đến từ phương sai. Ở bậc 12, phương sai bằng 52,2, gấp khoảng 1 900 lần độ chệch². Đa thức bậc cao dao động rất mạnh ở hai đầu đoạn, nơi có ít điểm dữ liệu, và mỗi tập huấn luyện cho một kiểu dao động khác nhau. Khác với độ chệch, phương sai giảm khi có thêm dữ liệu, nên với mô hình này thu thêm dữ liệu là cách sửa đúng.
Dòng cuối của bảng cần đọc thận trọng. Độ chệch² đo được ở bậc 13 (dòng này không có trong bảng) và bậc 14 tăng vọt lên 6,2 và 35,1, nhưng đó không phải độ chệch thật. Trung bình của 250 dự đoán có sai số ngẫu nhiên, và bình phương của sai số đó cộng thêm vào độ chệch² ước lượng một lượng cỡ , bằng khoảng 3,5 ở bậc 13 và 29,6 ở bậc 14. Khi phương sai lớn tới mức này, cần nhiều tập huấn luyện hơn hẳn mới ước lượng được độ chệch; kết luận chắc chắn duy nhất là phương sai chi phối.
Giá trị thực tế của phép phân rã nằm ở chỗ nó phân biệt hai tình huống cần xử lý ngược nhau. Độ chệch cao cần mô hình linh hoạt hơn, thêm đặc trưng hoặc giảm regularization, và thu thêm dữ liệu gần như vô ích. Phương sai cao thì cần thêm dữ liệu, tăng regularization hoặc dùng mô hình đơn giản hơn. Chẩn đoán sai có thể dẫn tới việc tốn nhiều tuần thu thập dữ liệu cho một mô hình mà dữ liệu không cứu được.
2.4Chẩn đoán bằng đường cong học#
Với dữ liệu thật, hàm không biết trước và không thể rút lại hàng trăm tập huấn luyện, nên không đo trực tiếp được độ chệch và phương sai. Công cụ thay thế là đường cong học (learning curve): đồ thị sai số trên tập huấn luyện và sai số trên tập xác thực theo số điểm dữ liệu huấn luyện, hoặc theo số vòng huấn luyện. Bảng dưới tóm tắt cách đọc các dấu hiệu thường gặp.
| Dấu hiệu | Chẩn đoán | Hướng xử lý |
|---|---|---|
| Sai số huấn luyện cao, sai số xác thực cao, hai đường sát nhau và đã nằm ngang | độ chệch cao (underfitting) | mô hình linh hoạt hơn, thêm đặc trưng, giảm regularization, huấn luyện lâu hơn |
| Sai số huấn luyện thấp, sai số xác thực cao, khoảng cách lớn và chưa thu hẹp | phương sai cao (overfitting) | thêm dữ liệu, tăng regularization, tăng cường dữ liệu, mô hình đơn giản hơn, dừng sớm |
| Cả hai đều cao và vẫn đang giảm theo số vòng huấn luyện | huấn luyện chưa xong | huấn luyện tiếp |
| Sai số xác thực thấp hơn sai số huấn luyện | thường là dấu hiệu có lỗi | kiểm tra rò rỉ dữ liệu; kiểm tra dropout hoặc tăng cường dữ liệu chỉ bật khi huấn luyện |
Dòng cuối cần chú ý vì nó trông như tin tốt. Tình huống vô hại duy nhất là khi dropout hoặc tăng cường dữ liệu chỉ bật lúc huấn luyện, vì khi đó sai số huấn luyện được đo trên một bài toán khó hơn bài toán lúc xác thực. Trong các trường hợp còn lại, nguyên nhân thường là rò rỉ dữ liệu (Mục 8.5 của Nền tảng), chẳng hạn tập xác thực chứa bản sao gần giống của dữ liệu huấn luyện.
Hai đường cong theo số điểm dữ liệu còn trả lời một câu hỏi có giá trị kinh tế: thu thêm dữ liệu có đáng không. Nếu đường sai số xác thực đã nằm ngang và sát đường sai số huấn luyện, thêm dữ liệu không giúp gì; nếu nó vẫn đang giảm và còn cách xa đường huấn luyện, thêm dữ liệu nhiều khả năng giúp được.
Andrew Ng dạy cách chẩn đoán này bằng những cặp số cụ thể, và cách dạy đó dễ nhớ hơn một bảng quy tắc. Sai số huấn luyện 2% và sai số xác thực 12%: khoảng cách lớn, nên phương sai cao. Sai số 14% và 15%: cả hai cùng cao và sát nhau, nên độ chệch cao. Sai số 14% và 28%: cả hai vấn đề cùng lúc. Sai số 1% và 1,5%: không có vấn đề gì đáng kể. Cách đọc này ngầm giả định rằng sai số nhỏ nhất có thể đạt được, gọi là sai số Bayes, gần bằng 0. Nếu ảnh mờ tới mức người giỏi nhất cũng sai 13%, thì cặp 14% và 15% lại là một mô hình tốt.
Từ đó Ng tách sai số theo một mức tham chiếu, thường là sai số của người giỏi nhất, dùng làm ước lượng cho sai số Bayes. Khoảng cách từ mức tham chiếu tới sai số huấn luyện là độ chệch tránh được (avoidable bias), còn khoảng cách từ sai số huấn luyện tới sai số xác thực là phương sai. Với sai số huấn luyện 6% và sai số xác thực 9%, nếu người làm được 1% thì độ chệch tránh được là 5 điểm, lớn hơn phương sai 3 điểm, nên cần một mô hình mạnh hơn trước; nếu người cũng sai 5% thì độ chệch tránh được chỉ còn 1 điểm, và phần đáng giảm là phương sai.
Khi dữ liệu huấn luyện và dữ liệu dùng thật đến từ hai phân phối khác nhau, chẳng hạn huấn luyện trên ảnh sản phẩm lấy từ web mà dùng cho ảnh chụp bằng điện thoại, khoảng cách giữa sai số huấn luyện và sai số xác thực lẫn hai thứ: phương sai và độ lệch giữa hai phân phối. Ng tách chúng bằng một tập huấn luyện–xác thực (train-dev), rút từ cùng phân phối với tập huấn luyện nhưng không dùng để huấn luyện. Với sai số huấn luyện 2%, huấn luyện–xác thực 8% và xác thực 9%, khoảng cách đã xuất hiện ngay trên dữ liệu cùng phân phối, nên đó là phương sai. Với 2%, 2,5% và 9%, mô hình tổng quát tốt trên phân phối cũ nhưng hỏng khi đổi phân phối; vấn đề là độ lệch dữ liệu, và thêm dữ liệu cùng loại cũ không giúp được (Chương 9 của MLOps).
Thứ tự xử lý mà Ng khuyên là giải quyết độ chệch trước, nhìn vào sai số huấn luyện: dùng mạng lớn hơn, huấn luyện lâu hơn hoặc đổi kiến trúc. Khi sai số huấn luyện đã chấp nhận được mới xét phương sai, nhìn vào sai số xác thực: thêm dữ liệu, tăng regularization hoặc đổi kiến trúc. Hai bước được lặp lại cho tới khi cả hai sai số đều đạt yêu cầu.
2.5Double descent#
Đường chữ U ở Mục 2.3 là bức tranh cổ điển, đúng khi số tham số nhỏ hơn số điểm dữ liệu. Với mô hình có số tham số vượt xa số điểm dữ liệu, như các mạng nơ-ron hiện đại, người ta quan sát được hiện tượng double descent (Belkin và cộng sự, 2019): sai số xác thực tăng lên tới một đỉnh tại ngưỡng mà mô hình vừa đủ tham số để khớp chính xác mọi điểm huấn luyện, gọi là ngưỡng nội suy, rồi giảm trở lại khi số tham số tiếp tục tăng. Nakkiran và cộng sự (2020) quan sát cùng hiện tượng với mạng tích chập và Transformer, theo cả số tham số lẫn số vòng huấn luyện, và thấy cả những trường hợp thêm dữ liệu lại làm sai số tăng.
Double descent không mâu thuẫn với Định lý 2.1, vì phân rã là một đẳng thức và luôn đúng. Điều thay đổi là cách phương sai phụ thuộc vào số tham số. Khi có nhiều tham số hơn số điểm dữ liệu, có vô số nghiệm khớp chính xác dữ liệu huấn luyện, và thuật toán tối ưu chọn một trong số đó. Với hồi quy tuyến tính, có thể chứng minh gradient descent khởi tạo từ 0 hội tụ tới nghiệm có chuẩn nhỏ nhất, tức nghiệm giả nghịch đảo (Mục 4.3 của Nền tảng). Việc chọn nghiệm chuẩn nhỏ nhất tác dụng như một dạng regularization ngầm, và càng nhiều tham số thì nghiệm chuẩn nhỏ nhất càng trơn. Với mạng sâu, cơ chế tương tự được nhiều nghiên cứu ủng hộ nhưng chưa được chứng minh đầy đủ.
Hai nhận xét giúp đọc đúng hiện tượng này. Thứ nhất, đỉnh ở ngưỡng nội suy phần lớn đến từ việc khớp dữ liệu mà không có regularization: với cường độ regularization được chọn tối ưu, đỉnh giảm hẳn hoặc biến mất (Nakkiran và cộng sự, 2021), và James và cộng sự (2021) nhấn mạnh rằng double descent không mâu thuẫn với đánh đổi độ chệch – phương sai. Thứ hai, khi có vô số nghiệm khớp dữ liệu, số tham số là một thước đo tồi cho độ linh hoạt: ghi chú bài giảng CS229 cho thấy vẽ sai số theo chuẩn của nghiệm thay vì theo số tham số thì đường cong không còn hai lần giảm.
Vì vậy câu "mô hình càng nhiều tham số càng dễ overfitting" chỉ đúng trong chế độ cổ điển, khi số tham số nhỏ hơn số điểm dữ liệu. Trong chế độ nhiều tham số hơn dữ liệu, nó không còn đúng hiển nhiên, và đó là một phần lời giải thích cho việc các mô hình hàng tỉ tham số vẫn tổng quát hoá được. Tuy vậy, ngay trong chế độ này, regularization, dừng sớm và dữ liệu nhiều hơn vẫn có ích; double descent không có nghĩa là có thể bỏ qua overfitting.
2.6Tóm tắt#
Sai số kỳ vọng của một mô hình tại một điểm tách thành độ chệch², phương sai và nhiễu. Độ chệch đến từ họ hàm quá hẹp, phương sai đến từ việc khớp theo nhiễu riêng của từng tập huấn luyện, còn nhiễu là cận dưới không vượt qua được. Với bốn căn hộ và căn 120 m², mô hình hằng số lệch 1,2 tỉ, đường thẳng không chệch với phương sai , còn đa thức bậc ba qua bốn điểm không chệch nhưng có phương sai , phần lớn vì phải ngoại suy. Phân rã này chỉ đúng với mất mát bình phương. Mô phỏng với đa thức cho thấy tổng sai số nhỏ nhất ở bậc 5, nơi hai thành phần gần bằng nhau, và độ chệch chỉ giảm khi họ hàm mở rộng theo hướng có ích, như các bậc lẻ với một hàm lẻ. Với dữ liệu thật, đường cong học thay cho phép đo trực tiếp và cho biết nên đổi mô hình hay thu thêm dữ liệu; so sánh sai số huấn luyện và xác thực với một mức tham chiếu như sai số của người cho biết nên giảm độ chệch tránh được hay phương sai, còn tập huấn luyện–xác thực tách phương sai khỏi độ lệch phân phối. Ở chế độ nhiều tham số hơn dữ liệu, double descent cho thấy phương sai không nhất thiết tăng theo số tham số, và đỉnh của nó phần lớn biến mất khi regularization được chọn đúng.
Một mô hình minh hoạ rất rõ cả hai loại sai số là cây quyết định: cây nông có độ chệch cao, cây sâu có phương sai cao. Chương 3 xét cây quyết định, rồi hai cách kết hợp nhiều cây để giảm từng loại sai số.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Độ chệch và phương sai trong phân rã sai số được định nghĩa qua kỳ vọng trên cái gì?
Vì sao: Phương sai đo mức dự đoán tại một điểm thay đổi khi đổi tập huấn luyện, không đo mức dự đoán dao động giữa các điểm dữ liệu (Mục 2.2).2Sai số huấn luyện 2%, sai số xác thực 18%, khoảng cách lớn và vẫn thu hẹp dần khi thêm dữ liệu. Nên làm gì?
Vì sao: Khoảng cách lớn giữa hai sai số là dấu hiệu phương sai cao. Phương sai giảm khi có thêm dữ liệu, nên thêm dữ liệu có tác dụng; ngược với trường hợp độ chệch cao (Mục 2.4).3Trong thí nghiệm ở Mục 2.3, vì sao thêm dữ liệu không giúp được đa thức bậc 1?
Vì sao: Một đường thẳng không thể theo được hình sin dù có bao nhiêu dữ liệu; phải đổi họ hàm. Ngược lại, ở bậc 12 phương sai gấp khoảng 1 900 lần độ chệch², nên thêm dữ liệu giúp được.4Trong thí nghiệm ở Mục 2.3, vì sao đa thức bậc 2 có độ chệch² gần như bằng bậc 1?
Vì sao: thoả . Số hạng bậc chẵn chỉ thêm tham số để khớp nhiễu nên làm tăng phương sai mà không giảm độ chệch; độ chệch không nhất thiết giảm đều khi mô hình phức tạp hơn.5Hiện tượng double descent nói điều gì?
Vì sao: Phân rã là một đẳng thức nên luôn đúng. Điều thay đổi là phương sai không tăng đều theo số tham số, vì thuật toán tối ưu chọn một nghiệm cụ thể trong vô số nghiệm khớp dữ liệu, ví dụ nghiệm có chuẩn nhỏ nhất (Mục 2.5).
Đã trả lời 0/5