5Lan truyền ngược và các thuật toán tối ưu#
Huấn luyện một mạng nơ-ron gồm hai việc tách biệt: tính gradient của hàm mất mát theo mọi tham số, và dùng gradient đó để cập nhật tham số. Lan truyền ngược làm việc thứ nhất; SGD, momentum và Adam làm việc thứ hai. Người mới hay gộp hai việc làm một, nói "huấn luyện bằng lan truyền ngược" như thể lan truyền ngược là một thuật toán học. Tách chúng ra giúp trả lời những câu hỏi rất thực tế: vì sao tính gradient của một mô hình hàng tỉ tham số chỉ tốn cỡ ba lần tính hàm mất mát, vì sao huấn luyện tốn bộ nhớ hơn suy luận nhiều, và vì sao Adam phải giữ thêm hai giá trị cho mỗi tham số.
5.1Lan truyền ngược#
Định nghĩa 5.1 (Lan truyền ngược)
Lan truyền ngược (backpropagation) là thuật toán tính gradient của một hàm mất mát vô hướng theo mọi tham số của mạng, bằng cách áp dụng quy tắc dây chuyền theo thứ tự từ đầu ra ngược về đầu vào và dùng lại các giá trị trung gian đã tính ở lượt xuôi.
Lan truyền ngược không phải là thuật toán học. Nó chỉ tính gradient; dùng gradient để cập nhật tham số thế nào là việc của thuật toán tối ưu (Mục 5.4). Hai thành phần độc lập với nhau: cùng một gradient có thể dùng cho SGD hay Adam, và cùng một thuật toán tối ưu nhận được gradient tính bằng lan truyền ngược hay bằng cách khác.
Thuật toán gồm hai lượt. Lượt xuôi tính đầu ra từ đầu vào, lần lượt qua từng lớp, và lưu lại mọi giá trị trung gian: đầu vào của mỗi lớp, giá trị trước và sau hàm kích hoạt. Lượt ngược bắt đầu từ và đi ngược qua từng lớp. Với một lớp , , khi đã có thì
Vector lại là đầu vào cho lớp phía trước, và mỗi công thức chỉ cần các giá trị , đã lưu ở lượt xuôi. Rumelhart, Hinton và Williams (1986) phổ biến thuật toán này cho mạng nơ-ron; trong toán học ứng dụng, nó là trường hợp riêng của vi phân tự động chế độ ngược.
Bài giảng CS231n trình bày cùng thuật toán theo một cách dễ hình dung hơn: mỗi phép toán là một cổng, nhận gradient từ phía sau rồi nhân với đạo hàm cục bộ của chính nó. Lấy với , , . Lượt xuôi cho rồi . Lượt ngược bắt đầu từ . Cổng nhân đổi chéo: gradient của là giá trị của đầu vào kia, , còn gradient của là . Cổng cộng chia đều: và cùng nhận nguyên gradient của . Cổng max, như trong ReLU, chuyển toàn bộ gradient cho đầu vào lớn hơn và cho đầu vào kia 0. Khi một biến được dùng ở nhiều chỗ, gradient của nó là tổng gradient từ mọi nhánh; Karpathy (2022) minh hoạ bằng , có đạo hàm 2 chứ không phải 1, và quên cộng dồn là lỗi kinh điển khi tự cài lan truyền ngược.
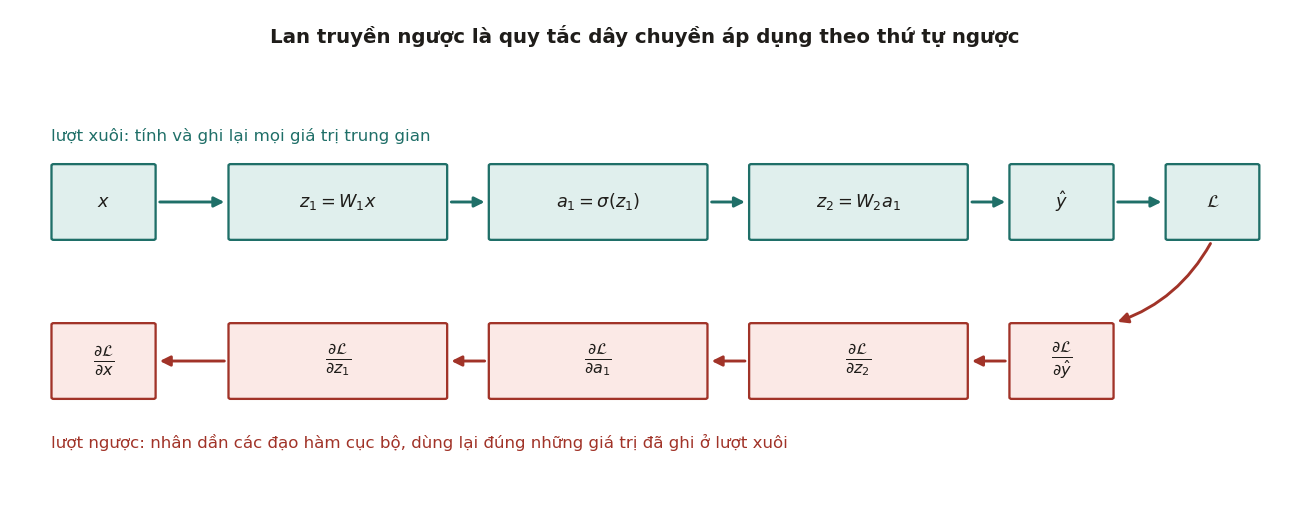
Ví dụ sau thực hiện đầy đủ một lượt xuôi, một lượt ngược và một bước cập nhật trên mạng nhỏ nhất có lớp ẩn, để thấy từng công thức trên hoạt động thế nào.
Ví dụ 5.1
Mạng có đầu vào , lớp ẩn 2 đơn vị ReLU và một đầu ra tuyến tính, hàm mất mát với . Tham số:
Lượt xuôi. . Qua ReLU: . Đầu ra . Mất mát .
Lượt ngược. . Lớp ra: , , và . Qua ReLU: . Lớp ẩn: và .
Kiểm tra bằng sai phân. Tăng rồi giảm một lượng : mất mát thành và , nên đạo hàm xấp xỉ , khớp với lượt ngược.
Cập nhật. Một bước gradient descent với đưa từ 0,45 lên 0,606 và mất mát từ 0,151 xuống 0,078.
Ví dụ cho thấy một chi tiết quan trọng: đơn vị ẩn thứ hai có , nên đạo hàm của ReLU tại đó bằng 0, và toàn bộ hàng thứ hai của nhận gradient bằng 0. Đơn vị nào không kích hoạt với một đầu vào thì không học được gì từ đầu vào đó. Nếu một đơn vị không kích hoạt với mọi đầu vào, nó không bao giờ được cập nhật nữa; đó chính là đơn vị ReLU chết ở Mục 4.2. Cách kiểm tra bằng sai phân, và cách chọn bước sai phân, được trình bày ở Mục 5.5 của Nền tảng. Khi kiểm tra gradient của cả một mạng, CS231n khuyên dùng sai phân trung tâm như trong ví dụ và so bằng sai số tương đối giữa gradient giải tích và gradient số : dưới là tốt, còn trên thì gần như chắc chắn có lỗi. Phép kiểm tra nên chạy bằng số thực 64 bit, trên vài điểm dữ liệu, và tắt dropout cùng regularization. Với ReLU, các giá trị trước hàm kích hoạt nên cách 0 xa hơn bước sai phân, như trong ví dụ, để phép sai phân không vắt qua điểm gãy.
5.2Thứ tự nhân các ma trận Jacobi#
Vì sao phải đi ngược mà không đi xuôi? Theo quy tắc dây chuyền, với mạng trong đó là một số, gradient theo đầu vào là tích các ma trận Jacobi:
Phép nhân ma trận có tính kết hợp, nên có thể nhân theo bất kỳ thứ tự nào, nhưng chi phí rất khác nhau. Nhân từ trái sang phải, tức chế độ ngược của lan truyền ngược, thì kết quả trung gian luôn là một vector hàng , và mỗi bước chỉ là một phép nhân vector với ma trận, tốn . Nhân từ phải sang trái, tức chế độ xuôi, thì kết quả trung gian là một ma trận , và mỗi bước là một phép nhân ma trận với ma trận, tốn . Với 10 lớp có , chế độ ngược tốn khoảng phép nhân, chế độ xuôi khoảng , chênh nhau 1 000 lần, đúng bằng số đầu vào .
Tổng quát hơn, với một hàm từ đầu vào ra đầu ra, chế độ ngược tính toàn bộ gradient với chi phí cỡ lần tính hàm, còn chế độ xuôi cần cỡ lần (Baydin và cộng sự, 2018). Huấn luyện mạng nơ-ron có , vì hàm mất mát là một số, còn bằng số tham số, có thể tới hàng tỉ, nên chế độ ngược rẻ hơn hàng tỉ lần. Trên thực tế, một lượt ngược tốn khoảng gấp đôi một lượt xuôi (Mục 12.4), nên tính gradient chỉ tốn cỡ ba lần tính hàm mất mát. Đặt cạnh cách tính bằng sai phân, vốn cần thêm một lượt tính hàm mất mát cho mỗi tham số, tức một triệu lẻ một lượt với một mô hình một triệu tham số (Nielsen, 2015), hai cách chênh nhau hơn trăm nghìn lần.
Ngược lại, khi cần đạo hàm của nhiều đầu ra theo ít đầu vào, chế độ xuôi rẻ hơn. Các thư viện như PyTorch và JAX cài đặt cả hai chế độ.
5.3Bộ nhớ cho lan truyền ngược#
Lượt ngược cần các giá trị trung gian của lượt xuôi, nên chúng phải được giữ trong bộ nhớ cho tới khi lượt ngược dùng xong. Phần bộ nhớ này, gọi là bộ nhớ kích hoạt, tỉ lệ với
Bộ nhớ kích hoạt không tỉ lệ với số tham số mà tỉ lệ với kích thước lô và độ dài chuỗi. Vì vậy khi huấn luyện bị hết bộ nhớ, cách xử lý đầu tiên thường là giảm kích thước lô, không phải thu nhỏ mô hình.
Có hai kỹ thuật đổi thời gian tính lấy bộ nhớ. Gradient checkpointing (Chen và cộng sự, 2016) chỉ lưu giá trị trung gian tại một số lớp mốc; các lớp khác được tính lại từ mốc gần nhất khi lượt ngược cần tới. Đặt mốc cách nhau lớp thì bộ nhớ kích hoạt giảm từ xuống , đổi lại phải tính thêm khoảng một lượt xuôi, tức thời gian tăng khoảng một phần ba. Tích luỹ gradient (gradient accumulation) chia một lô lớn thành nhiều lô nhỏ, cộng dồn gradient của các lô nhỏ rồi mới cập nhật một lần. Kết quả tương đương huấn luyện với lô lớn, bộ nhớ chỉ bằng của lô nhỏ, nhưng không nhanh hơn. Có một chi tiết dễ quên: khi mất mát của mỗi lô nhỏ là trung bình trên lô đó, phải chia nó cho số lô nhỏ trước khi cộng dồn, nếu không gradient sẽ lớn gấp từng ấy lần so với khi huấn luyện thật với lô lớn (Karpathy, 2024).
5.4SGD, momentum và Adam#
Có gradient rồi, ta chuyển sang việc thứ hai. Gradient descent cập nhật với (Chương 5 của Nền tảng). Với mạng nơ-ron, là trung bình trên hàng triệu điểm dữ liệu, nên tính gradient đầy đủ ở mỗi bước là quá đắt. Cách giải quyết là SGD theo mini-batch: ước lượng bằng gradient trên một lô nhỏ điểm chọn ngẫu nhiên. Ước lượng này không chệch, và phương sai của nó giảm theo . Nhiễu của ước lượng không hoàn toàn có hại: nhiều nghiên cứu cho thấy nó giúp tránh một số điểm cực tiểu hẹp và có tác dụng như một dạng regularization, dù cơ chế chính xác vẫn đang được nghiên cứu.
Cải tiến đầu tiên là momentum, giữ một trung bình trượt của các gradient:
Trong một thung lũng hẹp và dài, gradient đổi dấu liên tục theo chiều ngang thung lũng và giữ cùng dấu theo chiều dọc. Trung bình trượt triệt tiêu phần dao động ngang và cộng dồn phần dọc, nên với , bước đi theo hướng ổn định lớn gấp khoảng lần. Mục 5.3 của Nền tảng đã đo được tác dụng này: số vòng lặp giảm từ bậc xuống bậc . CS231n và Andrew Ng cùng dùng hình ảnh một quả bóng lăn xuống dốc có ma sát: gradient đóng vai trò gia tốc, là vận tốc, còn là hệ số giữ lại vận tốc sau mỗi bước, tức phần bù của ma sát.
Các tài liệu viết momentum theo ba cách sai khác nhau một hệ số. Cách ở trên, , là cách của PyTorch. CS231n viết rồi cộng thẳng vào tham số, tương đương với cách trên. Andrew Ng viết , một trung bình trượt mũ thật sự, nên với cùng , bước đi nhỏ hơn lần, tức 10 lần khi . Khi chuyển công thức hay siêu tham số giữa các tài liệu, tốc độ học phải được chỉnh lại theo hệ số đó. Tên "trung bình trượt" cũng có nghĩa cụ thể: với , trọng số của giá trị cách đây 10 bước là , nên trung bình chủ yếu gồm khoảng giá trị gần nhất.
Adam (Kingma và Ba, 2015) đi xa hơn: giữ trung bình trượt của cả gradient và bình phương gradient, rồi chia từng toạ độ cho căn bậc hai của trung bình bình phương, nên mỗi tham số có một bước đi riêng:
Các giá trị mặc định là , , .
Hai phép chia cho gọi là hiệu chỉnh độ chệch (bias correction), và tên gọi này đúng theo nghĩa thống kê của Mục 2.2. Vì khởi tạo , khai triển công thức truy hồi được . Nếu các có cùng kỳ vọng thì
Như vậy là ước lượng chệch về phía 0 của , và chia cho cho ước lượng không chệch. Andrew Ng giảng điều này bằng trung bình trượt của nhiệt độ hằng ngày. Với nhiệt độ ba ngày đầu là 30, 32 và 31 °C và hệ số 0,9, trung bình trượt khởi tạo từ 0 cho 3; 5,9 và 8,41, thấp xa nhiệt độ thật; chia lần lượt cho , và được 30; 31,05 và 31,03. Cùng lập luận cho . Hai độ chệch này không bù trừ cho nhau, vì bị kéo về 0 mạnh hơn nhiều. Ở bước đầu, và , nên nếu không hiệu chỉnh, bước đi là theo dấu của , trong khi bước đã hiệu chỉnh là đúng . Với gradient không đổi, tỉ số giữa hai bước là : tăng lên tới khoảng 6,6 quanh bước 12, còn 3,2 ở bước 100 và vẫn còn 1,26 ở bước 1 000, vì tăng rất chậm. Bỏ hiệu chỉnh vì vậy làm các bước đầu lớn bất thường, không phải nhỏ đi; Kingma và Ba (2015) nêu đúng điều này. Khi lớn, và phép hiệu chỉnh không còn tác dụng gì.
Cuối cùng, AdamW (Loshchilov và Hutter, 2019) sửa cách Adam xử lý weight decay. Nếu thêm vào hàm mất mát rồi dùng Adam, gradient của thành phần phạt cũng bị chia cho , nên tham số có gradient lớn lại bị phạt ít hơn, ngược với mục đích của regularization. AdamW tách weight decay ra khỏi gradient và trừ trực tiếp ở mỗi bước. AdamW là lựa chọn mặc định khi huấn luyện Transformer. Bảng dưới so sánh hai nhóm thuật toán.
| SGD với momentum | Adam, AdamW | |
|---|---|---|
| Độ nhạy với tốc độ học | cao | thấp hơn nhiều |
| Tốc độ giảm mất mát ban đầu | chậm hơn | nhanh hơn |
| Tổng quát hoá | trên một số bài toán thị giác, tốt hơn (Wilson và cộng sự, 2017) | thường tốt, là mặc định cho Transformer |
| Bộ nhớ trạng thái | 1 giá trị mỗi tham số | 2 giá trị mỗi tham số |
Dòng cuối quan trọng khi huấn luyện mô hình lớn. Adam giữ và cho mọi tham số, thường ở FP32. Với mô hình 7 tỉ tham số, riêng trạng thái Adam đã chiếm GB. Mục 12.5 sẽ tính đầy đủ bộ nhớ huấn luyện.
5.5Lịch tốc độ học#
Tốc độ học là siêu tham số quan trọng nhất khi huấn luyện mạng nơ-ron, và cách thay đổi nó theo thời gian cũng quan trọng gần như vậy. Phần lớn lịch tốc độ học hiện nay bắt đầu bằng warmup: tăng tuyến tính tốc độ học từ gần 0 lên giá trị đích trong vài trăm tới vài nghìn bước đầu. Với Adam, ở các bước đầu được ước lượng từ rất ít gradient nên rất nhiễu, và bước đi có thể lớn bất thường; warmup tránh được những bước như vậy. Warmup cũng cần thiết với Transformer dùng post-LN (Mục 10.2).
Sau warmup, tốc độ học được giảm dần. Lịch phổ biến khi huấn luyện mô hình ngôn ngữ là cosine decay (Loshchilov và Hutter, 2017), giảm tốc độ học theo nửa chu kỳ hàm cosin về gần 0 ở bước cuối. Trong thị giác máy tính, lịch giảm theo bậc thang, tức chia tốc độ học cho 10 tại một số mốc định trước, vẫn còn phổ biến.
Khi tăng kích thước lô lên lần, gradient ít nhiễu hơn nên có thể dùng tốc độ học lớn hơn. Với SGD, Goyal và cộng sự (2017) dùng quy tắc tuyến tính: nhân tốc độ học với , kèm warmup, và huấn luyện được ResNet-50 trên ImageNet với lô 8 192 ảnh mà không giảm độ chính xác. Với Adam, Malladi và cộng sự (2022) lập luận rằng quy tắc phù hợp là nhân với . Cả hai là quy tắc kinh nghiệm có cơ sở lý thuyết một phần, và đều không còn đúng khi lô quá lớn.
Một lịch cụ thể cho thấy các thành phần này ghép với nhau ra sao. Khi tái hiện GPT-2 124 triệu tham số, Karpathy (2024) dùng AdamW với , , warmup tuyến tính trong 715 bước lên , rồi giảm theo cosine xuống ở bước 19 073, kèm cắt chuẩn gradient ở 1,0.
Đường mất mát cho biết tốc độ học đang ở mức nào: mất mát gần như không giảm là dấu hiệu tốc độ học quá nhỏ, còn mất mát tăng vọt hoặc thành NaN là dấu hiệu quá lớn. CS231n khuyên theo dõi thêm tỉ số giữa độ lớn của bước cập nhật và độ lớn của tham số, nên ở quanh . Và trước khi huấn luyện thật, nên cho mạng khớp hoàn toàn một tập rất nhỏ, chẳng hạn 20 mẫu: một mạng đủ lớn phải đưa được mất mát trên 20 mẫu đó về gần 0, nếu không thì mã có lỗi.
5.6Các hiểu lầm thường gặp#
Bảng dưới gom những hiểu lầm hay gặp về lan truyền ngược và tối ưu.
| Phát biểu | Thực tế |
|---|---|
| "Lan truyền ngược là thuật toán học." | Nó chỉ tính gradient. Việc cập nhật tham số do SGD, Adam hay thuật toán tối ưu khác đảm nhận. |
| "Mạng nơ-ron hay bị kẹt ở cực tiểu địa phương xấu." | Trong không gian nhiều chiều, điểm yên ngựa phổ biến hơn nhiều so với cực tiểu địa phương xấu (Dauphin và cộng sự, 2014), và thực nghiệm cho thấy các cực tiểu mà gradient descent tìm được trong mạng lớn thường có mất mát gần nhau. |
| "Adam luôn tốt hơn SGD." | Adam giảm mất mát nhanh hơn và ít phải chỉnh; SGD với momentum có thể tổng quát hoá tốt hơn trên một số bài toán thị giác. |
| "Gradient bằng 0 nghĩa là đã hội tụ." | Cũng có thể là điểm yên ngựa, đơn vị ReLU đã chết, hoặc gradient đã tiêu biến qua nhiều lớp. |
| "Lô càng lớn càng tốt." | Lô rất lớn làm mất phần nhiễu có ích, cần chỉnh lại tốc độ học, và lợi ích về thời gian giảm dần khi lô tăng. |
5.7Tóm tắt#
Lan truyền ngược tính gradient của hàm mất mát theo mọi tham số bằng quy tắc dây chuyền, đi từ đầu ra về đầu vào và dùng lại các giá trị đã lưu ở lượt xuôi; nhìn theo từng cổng, cổng cộng chia đều gradient, cổng nhân đổi chéo, cổng max chuyển gradient cho đầu vào lớn hơn, và gradient của một biến dùng ở nhiều chỗ là tổng các nhánh. Nhân các ma trận Jacobi theo chiều ngược làm mọi kết quả trung gian là vector, nên với hàm mất mát là một số, tính toàn bộ gradient chỉ tốn cỡ ba lần tính hàm. Đổi lại, các giá trị trung gian phải được giữ trong bộ nhớ, và phần bộ nhớ kích hoạt này tăng theo kích thước lô và độ dài chuỗi. Gradient được dùng bởi SGD theo mini-batch, momentum hoặc Adam; Adam chia bước đi theo từng tham số, cần hiệu chỉnh độ chệch ở các bước đầu và giữ hai giá trị trạng thái cho mỗi tham số, còn AdamW tách weight decay khỏi gradient. Momentum được viết theo nhiều quy ước sai khác nhau một hệ số , nên phải chỉnh tốc độ học khi đổi quy ước. Tốc độ học thường đi theo lịch warmup rồi giảm dần, và trước khi huấn luyện thật, kiểm tra gradient bằng sai số tương đối và cho mạng khớp một tập rất nhỏ là hai bước kiểm tra rẻ.
Với các công cụ này, ví dụ tính tay đã chạy đúng trên một mạng hai lớp. Khi mạng có hàng chục lớp, một vấn đề mới xuất hiện ngay trong công thức lan truyền ngược: gradient là tích của nhiều ma trận, và tích đó có thể co về 0 hoặc phình ra rất nhanh. Chương 6 xét vấn đề này.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao lan truyền ngược, tức vi phân chế độ ngược, rẻ hơn chế độ xuôi khi huấn luyện mạng nơ-ron?
Vì sao: Quy tắc dây chuyền đúng theo mọi thứ tự nhân. Chế độ ngược tốn chi phí cỡ số đầu ra lần tính hàm, chế độ xuôi cỡ số đầu vào lần; với một đầu ra và hàng tỉ tham số, chế độ ngược rẻ hơn rất nhiều (Mục 5.2).2Trong Ví dụ 5.1, vì sao hàng thứ hai của nhận gradient bằng 0?
Vì sao: Đơn vị nào không kích hoạt với một đầu vào thì không nhận gradient từ đầu vào đó. Nếu không kích hoạt với mọi đầu vào, nó thành đơn vị ReLU chết (Mục 5.1).3Vì sao Adam có bước hiệu chỉnh độ chệch?
Vì sao: Với , . Chia cho cho ước lượng không chệch của kỳ vọng gradient; khi lớn, và phép hiệu chỉnh không còn tác dụng (Mục 5.4).4Trạng thái của Adam cho mô hình 7 tỉ tham số, lưu ở FP32, chiếm bao nhiêu bộ nhớ?
Vì sao: Hai trạng thái và cho mỗi tham số, mỗi trạng thái 4 byte: GB. Con số 112 GB là toàn bộ bộ nhớ huấn luyện với độ chính xác hỗn hợp, 16 byte mỗi tham số (Mục 12.5).5AdamW khác Adam kèm regularization ở điểm nào?
Vì sao: Với Adam thường, gradient của thành phần phạt bị chia cho , nên tham số có gradient lớn lại bị phạt ít hơn, ngược với mục đích của regularization.
Đã trả lời 0/5