3Cây quyết định và phương pháp tập hợp#
Cây quyết định có những ưu điểm mà các mô hình khác hiếm có: dễ diễn giải, không cần chuẩn hoá đặc trưng, xử lý tự nhiên cả đặc trưng số lẫn đặc trưng hạng mục. Điểm yếu của nó là phương sai: một cây sâu thay đổi gần như hoàn toàn khi dữ liệu thay đổi một chút. Hai ý tưởng kết hợp nhiều cây biến điểm yếu đó thành điểm mạnh theo hai cách khác nhau, và phân rã ở Chương 2 cho biết chính xác mỗi cách tác động vào đâu: bagging nhắm vào phương sai, còn boosting nhắm vào độ chệch. Rừng ngẫu nhiên và gradient boosting, hai sản phẩm của hai ý tưởng đó, nằm trong số các mô hình được dùng nhiều nhất cho dữ liệu dạng bảng. Ta bắt đầu từ một cây.
3.1Cây quyết định#
Cây quyết định chia không gian đặc trưng thành các vùng hình hộp bằng các phép chia dạng "", mỗi phép chia dùng một đặc trưng và một ngưỡng. Mỗi lá của cây ứng với một vùng, và dự đoán trong vùng đó là một hằng số: lớp chiếm đa số với bài toán phân loại, hoặc giá trị trung bình với bài toán hồi quy, của các điểm huấn luyện rơi vào vùng.
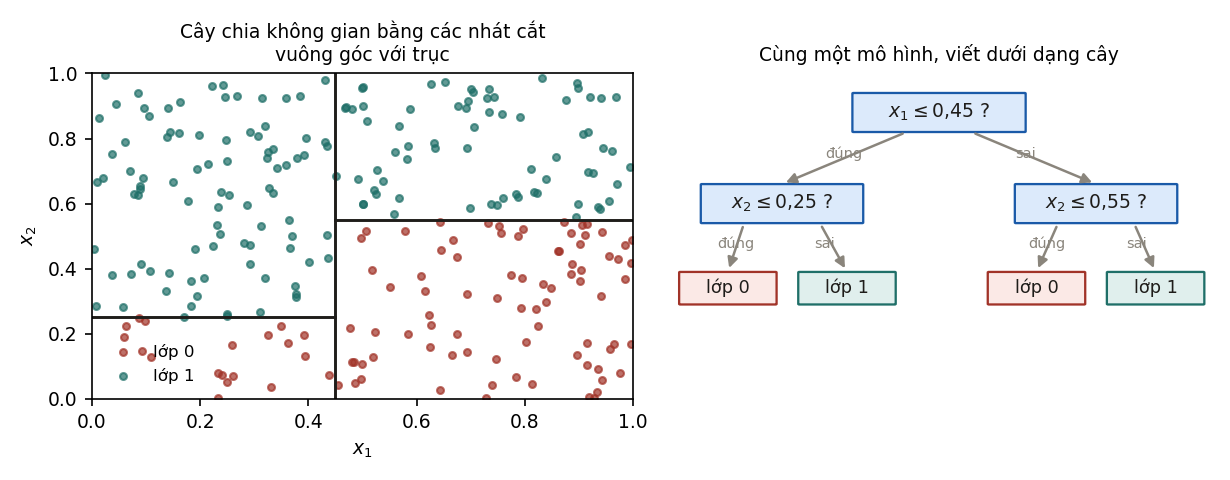
Vì mọi phép chia đều song song với trục, cây có ba tính chất đi liền với nhau. Thứ nhất, cây bất biến với phép biến đổi đơn điệu của từng đặc trưng: lấy logarit hay chuẩn hoá một đặc trưng không đổi thứ tự các giá trị, nên không đổi tập các phép chia có thể có. Vì vậy cây không cần chuẩn hoá đặc trưng, khác với hồi quy logistic, SVM hay k-NN. Thứ hai, cây không ngoại suy được: ngoài miền dữ liệu huấn luyện, nó trả về hằng số của vùng ngoài cùng. Một cây dự đoán giá nhà theo diện tích sẽ cho căn nhà 500 m² cùng giá với căn lớn nhất trong dữ liệu huấn luyện. Cây một lần chia ở Mục 1.4 định giá mọi căn từ 70 m² trở lên là 2,7 tỉ, dù căn đó rộng 100 m² hay 500 m². Thứ ba, cây khó biểu diễn biên chéo. Biên quyết định phải được xấp xỉ bằng một đường bậc thang gồm nhiều phép chia, trong khi mô hình tuyến tính chỉ cần ba tham số.
3.2Chọn phép chia#
Cây được xây từ gốc xuống. Tại mỗi nút, thuật toán xét mọi đặc trưng và mọi ngưỡng có thể, rồi chọn phép chia làm giảm độ không thuần nhất (impurity) nhiều nhất. Với phân loại, gọi là tỉ lệ điểm thuộc lớp trong nút; hai thước đo thông dụng là
Cả hai bằng 0 khi nút chỉ chứa một lớp và lớn nhất khi các lớp chia đều. Độ lợi của một phép chia là độ không thuần nhất của nút cha trừ trung bình có trọng số, theo số điểm, của hai nút con. Với hồi quy, độ không thuần nhất là phương sai của trong nút, và phép chia tốt nhất là phép chia làm giảm tổng bình phương sai số nhiều nhất. Với bốn căn hộ, có ba ngưỡng để thử: giữa 40 và 60 m², giữa 60 và 80 m², giữa 80 và 100 m². Khi mọi căn được đoán bằng giá trung bình 2,25 tỉ, tổng bình phương sai số là 1,17. Chia ở 50 m² tách căn nhỏ nhất ra một mình và đoán 2,5 tỉ cho ba căn còn lại, tổng còn 0,42; chia ở 70 m² cho hai nút với giá trung bình 1,8 và 2,7 tỉ, tổng còn 0,36; chia ở 90 m² cũng còn 0,42. Thuật toán chọn ngưỡng 70 m², và đó là cây một lần chia ở Mục 1.4.
Ví dụ 3.1
Một nút có 10 điểm, 6 điểm lớp A và 4 điểm lớp B, nên . Phép chia thứ nhất cho nút trái 4 điểm (4A, 0B) và nút phải 6 điểm (2A, 4B). Gini của nút trái bằng 0, của nút phải bằng , nên trung bình có trọng số là và độ lợi là . Phép chia thứ hai cho hai nút 5 điểm: (4A, 1B) có Gini 0,32 và (2A, 3B) có Gini 0,48, trung bình 0,40, nên độ lợi chỉ là 0,08. Thuật toán chọn phép chia thứ nhất. Dùng entropy cũng cho cùng kết luận: độ lợi thông tin là 0,420 bit so với 0,125 bit.
Một câu hỏi tự nhiên là vì sao không chọn phép chia theo chính tỉ lệ phân loại sai, thước đo cuối cùng ta quan tâm. Ghi chú CS229 về cây quyết định trả lời bằng một ví dụ kiểu sau. Một nút có 300 điểm lớp A và 100 điểm lớp B, tức 100 điểm bị phân loại sai nếu cả nút đoán A. Phép chia thứ nhất cho hai nút (100A, 100B) và (200A, 0B); phép chia thứ hai cho (200A, 100B) và (100A, 0B). Cả hai phép chia vẫn để lại đúng 100 điểm sai, nên theo tỉ lệ sai, chúng không tốt hơn việc không chia, và một thuật toán dừng khi tỉ lệ sai không giảm sẽ dừng ngay tại đây. Gini thì phân biệt được: Gini của nút cha là 0,375, của phép chia thứ nhất là , của phép chia thứ hai là . Phép chia thứ nhất tạo một nút thuần nhất 200 điểm, và nút còn lại có thể chia tiếp. Lý do nằm ở hình dạng của hàm: Gini và entropy là hàm lõm ngặt của tỉ lệ lớp, nên trung bình có trọng số của các nút con nhỏ hơn hẳn nút cha trừ khi các nút con có cùng tỉ lệ lớp với nút cha, còn tỉ lệ sai là hàm tuyến tính từng khúc nên không có tính chất này.
Trong thực tế, Gini và entropy gần như luôn chọn cùng một phép chia, và Gini tính nhanh hơn vì không cần logarit. Các siêu tham số đáng chỉnh hơn nhiều là độ sâu tối đa và số điểm tối thiểu trong mỗi lá, vì chúng quyết định độ linh hoạt của cây.
Cách xây cây như trên là tham lam: tại mỗi nút, nó chọn phép chia tốt nhất lúc đó mà không xét ảnh hưởng tới các phép chia phía dưới. Tìm cây tối ưu toàn cục là bài toán NP-khó (Hyafil và Rivest, 1976). Vì vậy một cây đơn lẻ có phương sai cao: chỉ cần vài điểm dữ liệu thay đổi là phép chia ở gốc có thể đổi, kéo theo toàn bộ cấu trúc phía dưới thay đổi.
Còn lại câu hỏi dừng ở đâu. Dừng khi một phép chia không làm độ không thuần nhất giảm đủ nhiều nghe hợp lý, nhưng có thể bỏ lỡ những phép chia chỉ có ích khi đi cùng phép chia sau nó. Với dữ liệu XOR ở Mục 4.1, phép chia đầu tiên theo trục nào cũng giữ nguyên Gini ở mức 0,5, nhưng phép chia thứ hai cho bốn lá thuần nhất. Vì vậy cách làm chuẩn, được ISLR và CS229 trình bày, là mọc cây thật lớn rồi cắt tỉa (pruning): trong các cây con, chọn cây làm nhỏ nhất , với là số lá và là giá của mỗi lá. Với bốn căn hộ, cây tốt nhất có 1, 2, 3 và 4 lá có tổng bình phương sai số lần lượt là 1,17; 0,36; 0,18 và 0. Với , điểm của bốn cây là 1,27; 0,56; 0,48 và 0,40, nên giữ cây 4 lá, tức ghi nhớ cả bốn căn. Với , điểm là 1,37; 0,76; 0,78 và 0,80, nên giữ cây 2 lá, đúng cây cắt ở 70 m². Với , chỉ còn một lá. Giá trị của được chọn bằng cross-validation, giống cường độ regularization ở Mục 9.5 của Nền tảng.
3.3Bagging, rừng ngẫu nhiên và boosting#
Phương sai cao là điểm yếu khi dùng một cây, nhưng lại làm cây trở thành thành phần phù hợp cho phương pháp tập hợp. Có hai cách kết hợp, và chúng tác động vào hai thành phần khác nhau của phân rã ở Chương 2.
Cách thứ nhất là bagging (bootstrap aggregating; Breiman, 1996): huấn luyện mô hình, mỗi mô hình trên một mẫu bootstrap, tức điểm rút có hoàn lại từ điểm huấn luyện, rồi lấy trung bình dự đoán. Theo Ví dụ 3.1 của Nền tảng, nếu mỗi mô hình có phương sai và mỗi cặp có hệ số tương quan thì trung bình của mô hình có phương sai
Khi tăng, số hạng thứ hai tiến về 0 và chỉ còn lại . Công thức này nói hai điều. Thêm mô hình không bao giờ làm phương sai tăng, nên thêm cây vào bagging không gây overfitting. Và muốn giảm phương sai tiếp thì phải giảm tương quan giữa các mô hình. Rừng ngẫu nhiên (random forest; Breiman, 2001) làm đúng việc đó: tại mỗi nút, cây chỉ được chọn phép chia trong một tập con ngẫu nhiên các đặc trưng, thường là đặc trưng với bài toán phân loại, nên các cây khác nhau hơn và ít tương quan hơn. Còn độ chệch thì bagging gần như không thay đổi, vì trung bình của các mô hình có cùng kỳ vọng với từng mô hình. Cũng vì vậy bagging chỉ có ích với mô hình không ổn định: lấy trung bình nhiều đường thẳng hồi quy khớp trên các mẫu bootstrap cho gần như đúng đường thẳng khớp trên toàn bộ dữ liệu, vì hồi quy tuyến tính vốn đã ổn định, còn với cây sâu, mỗi mẫu bootstrap cho một cây rất khác và trung bình của chúng mới khác hẳn từng cây (Hastie, Tibshirani và Friedman, 2009).
Cách thứ hai là boosting: huấn luyện các mô hình tuần tự, mỗi mô hình mới sửa phần sai của tổng các mô hình trước. Gradient boosting (Friedman, 2001) viết điều này dưới dạng
trong đó cây được huấn luyện để xấp xỉ gradient âm của hàm mất mát theo giá trị dự đoán, tại , và là tốc độ học, thường từ 0,01 tới 0,3. Với mất mát bình phương, gradient âm chính là phần dư , nên mỗi cây mới học phần dư của các cây trước. Với bốn căn hộ và cây một lần chia, là giá trung bình 2,25 tỉ, và phần dư là ; ; ; . Cây đầu tiên khớp phần dư này bằng phép chia ở 70 m², dự đoán cho hai căn nhỏ và cho hai căn lớn. Với , chỉ đi một phần mười quãng đường đó: 2,205 tỉ cho hai căn nhỏ, 2,295 tỉ cho hai căn lớn, và sai số bình phương trung bình giảm từ 0,2925 xuống 0,254. Phần dư mới lớn nhất ở hai căn ngoài cùng, nên cây thứ hai chia ở 50 m² để tách căn 40 m², và cây thứ ba chia ở 90 m² để tách căn 100 m². Đây là gradient descent trong không gian hàm: thay vì cập nhật tham số, mỗi bước cộng thêm một hàm theo hướng làm giảm mất mát. Gradient âm chỉ tính được tại các điểm huấn luyện, nơi biết nhãn ; khớp một cây vào các giá trị đó là bước biến một hướng chỉ xác định trên dữ liệu thành một hàm dùng được cho mọi . Vì mỗi cây chỉ cần sửa một phần nhỏ, các cây trong boosting thường rất nông, độ sâu từ 2 tới 6. Tổ hợp của nhiều cây nông có độ chệch thấp hơn nhiều so với từng cây, nên boosting chủ yếu giảm độ chệch.
3.4Đo tác dụng của bagging và boosting#
Phân tích trên có thể kiểm tra trực tiếp. Thí nghiệm trong code/models/experiments.py dùng cùng hàm thật và mức nhiễu như Chương 2, mỗi tập huấn luyện 120 điểm, và đo độ chệch² cùng phương sai của ba mô hình trên 40 tập huấn luyện độc lập: một cây sâu 8, bagging 100 cây sâu 8, và gradient boosting 100 cây sâu 2 với tốc độ học 0,1.
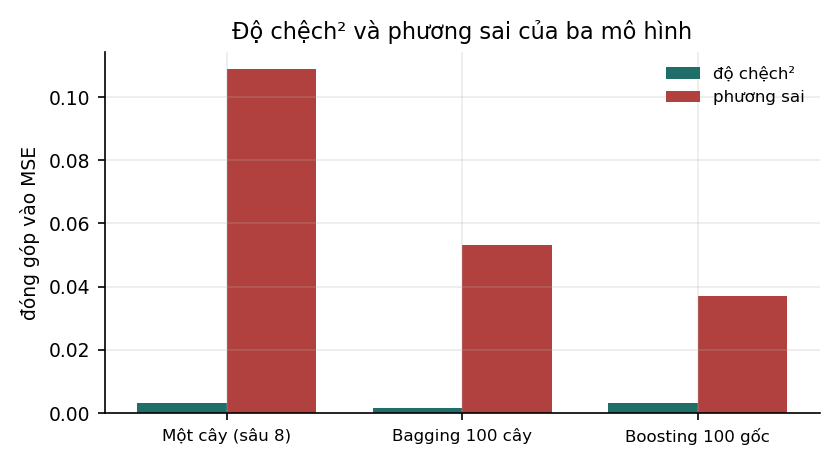
| Mô hình | Độ chệch² | Phương sai | Tổng (không tính nhiễu) |
|---|---|---|---|
| Một cây, sâu 8 | 0,0031 | 0,1089 | 0,1120 |
| Bagging, 100 cây sâu 8 | 0,0016 | 0,0534 | 0,0550 |
| Gradient boosting, 100 cây sâu 2 | 0,0032 | 0,0371 | 0,0403 |
Cây sâu 8 đủ linh hoạt để có độ chệch rất thấp, nên sai số của nó gần như hoàn toàn là phương sai: phương sai gấp khoảng 35 lần độ chệch². Bagging giảm phương sai đi một nửa, từ 0,1089 xuống 0,0534, và gần như không đổi độ chệch, đúng như phân tích ở Mục 3.3. Phương sai không giảm tới 0 dù có 100 cây, vì các cây được huấn luyện trên các mẫu bootstrap của cùng một tập dữ liệu nên vẫn tương quan với nhau; phần còn lại đó chính là số hạng .
Gradient boosting cho tổng sai số thấp nhất. Mỗi cây sâu 2 chỉ có 4 lá, nên nếu dùng một mình thì có độ chệch rất cao. Cộng 100 cây như vậy hạ độ chệch xuống ngang cây sâu 8, trong khi phương sai giữ ở mức thấp vì mỗi cây rất đơn giản và tốc độ học 0,1 làm mỗi cây chỉ đóng góp một phần nhỏ.
3.5Các hiểu lầm thường gặp#
Cây và các phương pháp tập hợp đi kèm khá nhiều hiểu lầm phổ biến. Một hiểu lầm thấy được ngay trên bốn căn hộ: tiếp tục ví dụ ở Mục 3.3 tới 100 cây thì sai số huấn luyện gần như bằng 0. Tổng các cây khi đó là một hàm bậc thang đi qua đúng bốn mức giá, và nó định giá căn 85 m² là 2,4 tỉ, bằng căn 80 m², trong khi đường thẳng định giá 2,61 tỉ. Bốn điểm dữ liệu không đủ cho 100 cây. Bảng dưới gom những hiểu lầm hay gặp nhất cùng điều đúng tương ứng.
| Phát biểu | Thực tế |
|---|---|
| "Cây quyết định cần chuẩn hoá đặc trưng." | Không cần: cây bất biến với mọi phép biến đổi đơn điệu của từng đặc trưng. |
| "Rừng ngẫu nhiên không bị overfitting." | Thêm cây không gây overfitting, nhưng cây quá sâu trên dữ liệu nhiễu vẫn làm rừng overfitting. |
| "Thêm cây vào gradient boosting luôn tốt hơn." | Không: boosting có thể overfitting khi số cây quá lớn. Số cây phải chọn bằng tập xác thực, thường kết hợp dừng sớm. |
| "Độ quan trọng đặc trưng tính từ cây là đáng tin." | Độ quan trọng tính theo tổng độ giảm độ không thuần nhất thiên về các đặc trưng có nhiều giá trị khác nhau, và khi hai đặc trưng tương quan thay thế được cho nhau, phần quan trọng bị chia giữa chúng một cách tuỳ ý. Permutation importance (Breiman, 2001) hoặc SHAP (Lundberg và Lee, 2017) đáng tin hơn. |
| "Boosting chỉ dùng được với cây." | Boosting dùng được với mọi mô hình yếu; cây phổ biến vì rẻ và xử lý tốt đặc trưng hỗn hợp. |
| "XGBoost là một thuật toán khác gradient boosting." | XGBoost (Chen và Guestrin, 2016) là một cài đặt hiệu quả của gradient boosting, có thêm regularization trên cấu trúc cây và cách xử lý giá trị thiếu. |
3.6Gradient boosting trong thực hành#
Các thư viện phổ biến là XGBoost, LightGBM (Ke và cộng sự, 2017) và CatBoost (Prokhorenkova và cộng sự, 2018). Chúng khác nhau ở chi tiết cài đặt, như cách tìm ngưỡng chia trên dữ liệu lớn hay cách xử lý đặc trưng hạng mục, nhưng có chung các siêu tham số quan trọng.
Quan trọng nhất là cặp tốc độ học và số cây, hai siêu tham số luôn đi cùng nhau: tốc độ học nhỏ cần nhiều cây hơn nhưng thường tổng quát hoá tốt hơn. Cách làm thông dụng là cố định tốc độ học ở một mức nhỏ, chẳng hạn 0,05, rồi chọn số cây bằng dừng sớm trên tập xác thực, tức dừng khi sai số xác thực không giảm sau một số vòng. Tiếp theo là độ phức tạp của mỗi cây, đặt bằng độ sâu tối đa hoặc số lá tối đa và số điểm tối thiểu trong mỗi lá. Cây sâu hơn biểu diễn được tương tác bậc cao hơn giữa các đặc trưng, nhưng làm tăng phương sai.
Hai nhóm siêu tham số còn lại đóng vai trò regularization. Lấy mẫu con cho mỗi cây chỉ dùng một phần ngẫu nhiên các điểm dữ liệu, chẳng hạn 80%, và một phần các đặc trưng; cách này giảm tương quan giữa các cây theo đúng ý tưởng của rừng ngẫu nhiên, và thường cải thiện tổng quát hoá (Friedman, 2002). Regularization trên lá phạt lên giá trị của các lá và yêu cầu một độ lợi tối thiểu cho mỗi phép chia.
So với rừng ngẫu nhiên, gradient boosting thường chính xác hơn khi được chỉnh tốt, nhưng nhạy hơn với siêu tham số. Rừng ngẫu nhiên là lựa chọn mặc định an toàn: các cây độc lập nên dễ song song hoá, và thêm cây không làm kết quả kém đi. Với cả hai, cần chia tập xác thực đúng cách, theo thời gian hoặc theo nhóm khi dữ liệu có cấu trúc đó (Mục 8.5 của Nền tảng).
3.7Tóm tắt#
Cây quyết định chia không gian bằng các phép chia song song với trục, chọn tham lam theo độ giảm độ không thuần nhất, đo bằng Gini hay entropy chứ không bằng tỉ lệ sai, vì tỉ lệ sai có thể không phân biệt được hai phép chia rất khác nhau. Cây được mọc lớn rồi cắt tỉa theo , với chọn bằng cross-validation. Nhờ vậy nó không cần chuẩn hoá đặc trưng, nhưng không ngoại suy được và có phương sai cao. Bagging lấy trung bình nhiều cây trên các mẫu bootstrap để giảm phương sai, tới giới hạn đặt bởi tương quan giữa các cây, và rừng ngẫu nhiên hạ giới hạn đó bằng cách chọn ngẫu nhiên đặc trưng ở mỗi nút. Gradient boosting cộng dần các cây nông, mỗi cây đi theo gradient âm của hàm mất mát, nên chủ yếu giảm độ chệch. Với bốn căn hộ, cây chọn ngưỡng 70 m² vì nó giảm tổng bình phương sai số từ 1,17 xuống 0,36, và gradient boosting với cây một lần chia khớp đúng bốn mức giá sau 100 cây, thành một hàm bậc thang. Trên bài toán mô phỏng, bagging giảm một nửa phương sai của một cây sâu, còn gradient boosting cho tổng sai số thấp nhất.
Gradient boosting là gradient descent trong không gian hàm, mỗi bước cộng thêm một cây. Chương 4 chuyển sang một họ mô hình mà gradient descent chạy trên chính các tham số: mạng nơ-ron nhiều lớp, bắt đầu từ chỗ hồi quy logistic đã dừng.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Phương sai của trung bình mô hình, mỗi mô hình có phương sai và mỗi cặp có tương quan , là bao nhiêu?
Vì sao: Khi tăng, số hạng thứ hai tiến về 0 và chỉ còn . Muốn giảm tiếp phải giảm tương quan giữa các mô hình, và đó là điều rừng ngẫu nhiên làm (Mục 3.3).2Gradient boosting chủ yếu giảm thành phần nào của sai số?
3Phát biểu nào về cây quyết định là đúng?
Vì sao: Phép chia chỉ phụ thuộc thứ tự các giá trị, nên chuẩn hoá hay lấy logarit không đổi cây. Độ quan trọng tính từ độ giảm độ không thuần nhất thiên về các đặc trưng có nhiều giá trị; permutation importance đáng tin hơn (Mục 3.5).4Rừng ngẫu nhiên khác bagging thông thường ở điểm nào?
Vì sao: Vì phương sai của trung bình dừng ở , giảm tương quan là cách duy nhất để giảm tiếp phương sai.5Một nút có 6 điểm lớp A và 4 điểm lớp B. Độ không thuần nhất Gini của nút là bao nhiêu?
Vì sao: . Con số 0,971 là entropy của nút tính theo bit (Ví dụ 3.1).
Đã trả lời 0/5