4Mạng nơ-ron nhiều lớp#
Hồi quy logistic ở Chương 6 của Nền tảng là một mạng nơ-ron một lớp: một phép biến đổi tuyến tính theo sau là hàm sigmoid. Nó chỉ vẽ được biên quyết định thẳng, nên ở Nền tảng, mỗi khi biên cong ta phải tự tạo thêm đặc trưng như bình phương hay tích của các đặc trưng gốc. Mạng nhiều lớp tự học những đặc trưng đó bằng cách chồng nhiều lớp lên nhau. Ta sẽ thấy vì sao giữa các lớp bắt buộc phải có hàm phi tuyến, mạng một lớp ẩn biểu diễn được tới đâu theo định lý xấp xỉ phổ quát, và độ sâu tiết kiệm được bao nhiêu tham số qua một phép dựng tường minh.
4.1Từ mô hình tuyến tính tới mạng nhiều lớp#
Mô hình tuyến tính ngầm giả định rằng mỗi đặc trưng tác động theo một chiều cố định và với cùng một mức ở mọi nơi. Giả định đó sai ở nhiều bài toán quen thuộc, và d2l.ai mở đầu chương về mạng nhiều lớp bằng đúng nhận xét này. Mức thoải mái của người trong phòng cao nhất quanh 25 °C và giảm khi phòng nóng lên hay lạnh đi, nên không hàm tuyến tính nào của nhiệt độ mô tả được nó; trường hợp này còn sửa được bằng tay, bằng cách dùng khoảng cách tới 25 °C làm đặc trưng. Với ảnh thì không: giá trị của một điểm ảnh riêng lẻ không cho biết ảnh có con mèo hay không, vì điều đó phụ thuộc vào quan hệ giữa rất nhiều điểm ảnh, và không có đặc trưng tự tạo đơn giản nào nắm được quan hệ ấy. Mạng nhiều lớp học những đặc trưng như vậy từ dữ liệu.
Một lớp tuyến tính tính . Chồng hai lớp tuyến tính không tạo ra gì mới, vì
vẫn là một phép biến đổi affine của . Chồng bao nhiêu lớp tuyến tính cũng chỉ tương đương một lớp. Muốn nhiều lớp biểu diễn được nhiều hơn một lớp, phải xen giữa chúng một hàm phi tuyến.
Định nghĩa 4.1 (Mạng nơ-ron truyền thẳng nhiều lớp)
Một mạng nơ-ron truyền thẳng nhiều lớp (multilayer perceptron, MLP) có lớp tính
trong đó là hàm kích hoạt áp dụng cho từng phần tử. Các với gọi là lớp ẩn, số phần tử của mỗi lớp ẩn là bề rộng của lớp đó.
Định nghĩa đếm các lớp có trọng số, không đếm lớp đầu vào, theo cùng quy ước với CS231n: mạng 784–256–10 ở dưới là mạng hai lớp. Lớp cuối không có hàm kích hoạt vì nó được chọn theo bài toán. Với hồi quy, được dùng trực tiếp và hàm mất mát là bình phương sai số. Với phân loại nhị phân, đi qua sigmoid; với nhiều lớp, qua softmax; và hàm mất mát là cross-entropy. Cả hai cặp lựa chọn đều đến từ ước lượng hợp lý cực đại (Chương 10 của Nền tảng): bình phương sai số ứng với nhiễu Gauss, cross-entropy ứng với phân phối Bernoulli hoặc phân phối phân loại.
Một lớp có đầu vào và đầu ra có tham số. Chẳng hạn, mạng 784–256–10 cho ảnh chữ số MNIST có tham số ở lớp ẩn và tham số ở lớp ra, tổng cộng 203 530.
Ví dụ 4.1 (Hàm XOR)
Bốn điểm , có nhãn 0 và , có nhãn 1 không tách được bằng một đường thẳng, nên không mô hình tuyến tính nào phân loại đúng cả bốn. Một mạng có hai đơn vị ReLU ở lớp ẩn làm được:
Kiểm tra: tại có nên ; tại và có nên ; tại có nên . Lớp ẩn đã biến đổi bốn điểm sang một không gian mới, trong đó chúng tách được bằng một hàm tuyến tính. Đó là cách hiểu hữu ích về mạng nhiều lớp: các lớp ẩn học một phép biến đổi đặc trưng, lớp cuối là một mô hình tuyến tính trên đặc trưng đã học. Nghiệm này cũng là nghiệm mà Goodfellow, Bengio và Courville (2016, Mục 6.1) dùng để giới thiệu mạng truyền thẳng.
4.2Hàm kích hoạt#
Bảng dưới so sánh các hàm kích hoạt thường gặp.
| Hàm | Công thức | Đạo hàm | Ưu điểm | Nhược điểm |
|---|---|---|---|---|
| Sigmoid | đầu ra trong | bão hoà ở hai phía, đạo hàm gần 0; đầu ra không có trung bình 0 | ||
| Tanh | đầu ra có trung bình quanh 0 | vẫn bão hoà ở hai phía | ||
| ReLU | 1 nếu , 0 nếu | không bão hoà phía dương, tính rất rẻ | đơn vị có thể "chết" (luôn có ) | |
| Leaky ReLU | , | hoặc | tránh đơn vị chết | thêm một siêu tham số |
| GELU | trơn | dùng phổ biến trong Transformer | tính đắt hơn ReLU một chút | |
| SiLU (Swish) | trơn | dùng trong nhiều mô hình ngôn ngữ (Mục 10.5) | như GELU |
Trong bảng, là hàm phân phối tích luỹ của phân phối chuẩn tắc. GELU do Hendrycks và Gimpel (2016) đề xuất; SiLU do Elfwing, Uchibe và Doya (2018) và Ramachandran, Zoph và Le (2017) đề xuất độc lập.
Từ bảng có ba điều cần nắm. Điều đầu tiên giải thích vì sao ReLU thay thế sigmoid trong mạng sâu: đạo hàm của ReLU bằng 1 ở phía dương. Gradient qua nhiều lớp là tích của các đạo hàm (Chương 5), mà đạo hàm của sigmoid không vượt quá 1/4, nên qua 10 lớp sigmoid, riêng phần đạo hàm của hàm kích hoạt đã nhân gradient với tối đa . Đây là một nguồn của gradient tiêu biến (Chương 6).
Điều thứ hai là ReLU có một kiểu hỏng riêng, gọi là đơn vị chết. Nếu một bước cập nhật lớn đẩy hệ số chặn của một đơn vị xuống đủ âm, đơn vị đó cho với mọi đầu vào, đạo hàm bằng 0, và nó không bao giờ được cập nhật lại. Nguyên nhân thường gặp là tốc độ học quá lớn.
Điều thứ ba là hàm kích hoạt của lớp ra khác với lớp ẩn. Lớp ra dùng sigmoid, softmax hoặc không dùng gì, tuỳ bài toán (Mục 4.1). Dùng ReLU ở lớp ra của một bài toán hồi quy có giá trị âm là một lỗi hay gặp: mô hình khi đó không bao giờ dự đoán được giá trị âm.
4.3Định lý xấp xỉ phổ quát#
Một câu hỏi tự nhiên là mạng nhiều lớp biểu diễn được những hàm nào. Câu trả lời cổ điển là: gần như mọi hàm, ngay cả khi chỉ có một lớp ẩn.
Định lý 4.1 (Xấp xỉ phổ quát)
Cho là một hàm liên tục không phải đa thức. Với mọi hàm liên tục trên một tập compact và mọi , tồn tại một mạng một lớp ẩn sao cho với mọi .
Cybenko (1989) chứng minh định lý cho hàm sigmoid, Hornik (1991) mở rộng, và Leshno và cộng sự (1993) chứng minh điều kiện "không phải đa thức" là đủ, nên định lý áp dụng cho cả ReLU.
Với đầu vào một chiều, có thể thấy định lý đúng bằng một phép dựng tay, theo tinh thần chứng minh bằng hình của Nielsen (2015). Mỗi đơn vị bằng 0 bên trái và tăng tuyến tính bên phải , nên tổng của vài đơn vị như vậy là một đường gấp khúc có điểm gãy tại các đã chọn. Đường gấp khúc đi qua các điểm của một hàm liên tục, với các điểm gãy đủ dày, xấp xỉ hàm đó tốt tuỳ ý. Chẳng hạn trên đoạn , hàm có hệ số góc 0,5 rồi 1,5, đi qua đúng các điểm , và của , và lệch khỏi nhiều nhất 0,0625. Dùng bốn đơn vị với các điểm gãy cách nhau 0,25 thì sai số lớn nhất còn 0,0156: mỗi lần gấp đôi số đơn vị, sai số giảm bốn lần.
Định lý nói rằng mạng một lớp ẩn đủ rộng biểu diễn được mọi hàm liên tục, nhưng nó chỉ khẳng định sự tồn tại. Nó không cho biết cần bao nhiêu đơn vị ẩn, và với một số hàm, con số này tăng theo hàm mũ của số chiều hoặc của độ phức tạp của hàm. Nó không cho biết gradient descent có tìm được bộ trọng số đó hay không. Và nó cũng không cho biết cần bao nhiêu dữ liệu để tìm được bộ trọng số đó mà không overfitting. Ba câu hỏi này mới là những câu quan trọng trong thực tế. d2l.ai so sánh định lý với nhận xét rằng ngôn ngữ C viết được mọi chương trình: điều đó đúng, nhưng viết ra chương trình cần thiết mới là phần khó.
Vì vậy định lý không giải thích được vì sao mạng sâu hoạt động tốt hơn mạng nông mà rộng. Mục 4.4 trả lời một phần câu hỏi này: có những hàm mà mạng sâu biểu diễn bằng số tham số tăng tuyến tính, trong khi mạng một lớp ẩn cần số tham số tăng theo hàm mũ.
4.4Độ sâu và số tham số cần thiết#
Phép dựng sau, theo ý tưởng của Telgarsky (2016), cho thấy lợi ích của độ sâu mà không phụ thuộc vào việc huấn luyện có thành công hay không. Ta xuất phát từ hàm lều dùng đúng hai đơn vị ReLU:
Trên , hàm này tăng tuyến tính từ lên rồi giảm tuyến tính về , nên nó ánh xạ lên . Bây giờ hợp với chính nó lần. Mỗi nhánh của phủ trọn đoạn , nên mỗi lần hợp làm số đoạn tuyến tính tăng gấp đôi. Với : và , nên ; tương tự nên , còn . Hàm đi từ 0 lên 1 ở , xuống 0 ở , lên 1 ở rồi về 0 ở : bốn đoạn tuyến tính, từ hai lớp, mỗi lớp hai đơn vị. Kết quả là một hàm răng cưa có đúng đoạn tuyến tính, biểu diễn bằng một mạng lớp, mỗi lớp 2 đơn vị ReLU, tổng cộng tham số.
Mạng một lớp ẩn cần bao nhiêu đơn vị để biểu diễn cùng hàm đó? Với đầu vào một chiều, mỗi đơn vị ReLU tạo ra đúng một điểm gãy tại , và tổng của đơn vị là một hàm tuyến tính từng khúc có tối đa điểm gãy. Hàm răng cưa có điểm gãy bên trong đoạn, nên mạng một lớp ẩn cần ít nhất đơn vị để biểu diễn chính xác nó.
Thí nghiệm trong code/models/experiments.py kiểm tra điều này theo hướng xấp xỉ. Với mỗi bề rộng trong dãy 2, 4, 8, …, 256, thí nghiệm đặt điểm gãy cách đều trên rồi giải bình phương tối thiểu cho các hệ số của lớp ra. Như vậy mạng một lớp được cho sẵn nghiệm tối ưu với các điểm gãy cố định, thay vì phải tự tìm bằng gradient descent. Bề rộng cần thiết là bề rộng nhỏ nhất trong dãy cho sai số bình phương trung bình dưới một nửa phương sai của hàm răng cưa, tức tốt hơn rõ rệt so với dự đoán bằng một hằng số.
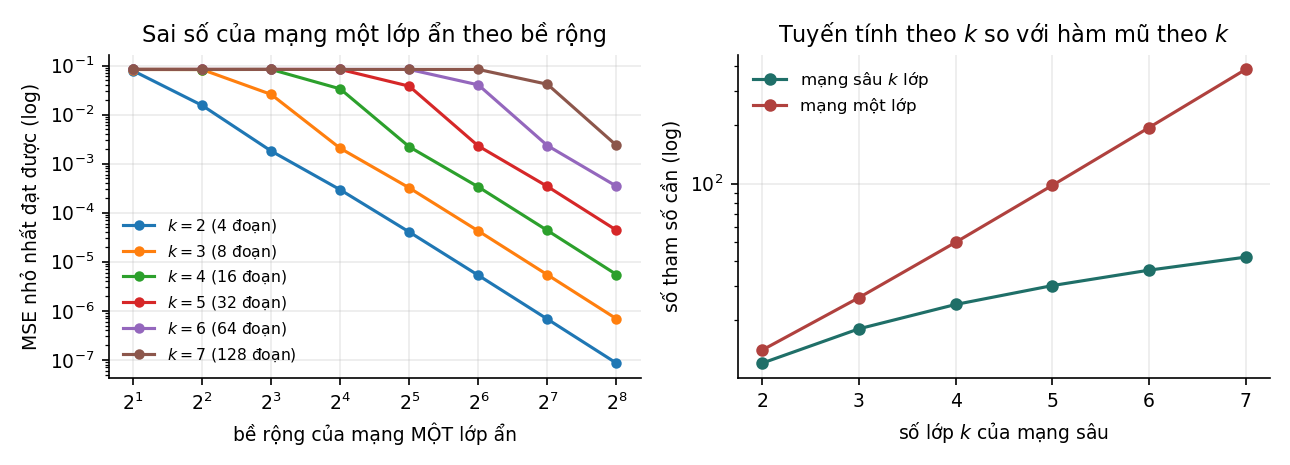
| Số đoạn | Tham số mạng sâu | Bề rộng mạng một lớp cần | Tham số mạng một lớp | Tỉ lệ | |
|---|---|---|---|---|---|
| 2 | 4 | 12 | 4 | 14 | 1,2 |
| 3 | 8 | 18 | 8 | 26 | 1,4 |
| 4 | 16 | 24 | 16 | 50 | 2,1 |
| 5 | 32 | 30 | 32 | 98 | 3,3 |
| 6 | 64 | 36 | 64 | 194 | 5,4 |
| 7 | 128 | 42 | 128 | 386 | 9,2 |
Với mọi , bề rộng cần thiết là , khớp với cận dưới ở trên. Dưới bề rộng đó, mạng một lớp không làm tốt hơn dự đoán hằng số: với , mọi bề rộng từ 2 tới 64 đều cho sai số 0,083, đúng bằng phương sai của hàm răng cưa. Số tham số của mạng sâu tăng tuyến tính theo , của mạng một lớp tăng theo , nên tỉ lệ giữa chúng tăng không giới hạn: 9,2 lần ở , và hơn 26 000 lần ở .
Kết quả này cần được đọc đúng phạm vi. Đây là so sánh về khả năng biểu diễn, không phải về khả năng học: mạng sâu được cho trọng số tường minh, không qua huấn luyện. Trên thực tế, huấn luyện một mạng 7 lớp chỉ có 2 đơn vị mỗi lớp để học hàm này bằng gradient descent gần như luôn thất bại, và Chương 6 giải thích một phần nguyên nhân. Hàm răng cưa cũng là trường hợp thuận lợi nhất cho độ sâu, vì nó có cấu trúc lặp lại mà phép hợp hàm khai thác trực tiếp; kết quả không có nghĩa là mạng càng sâu càng tốt với mọi dữ liệu, và với dữ liệu dạng bảng, thêm lớp thường không giúp gì (Mục 1.2). Cuối cùng, độ sâu không làm tăng những gì mạng biểu diễn được về nguyên tắc, vì theo Định lý 4.1 mạng một lớp đủ rộng đã biểu diễn được mọi hàm liên tục. Thứ độ sâu mang lại là khả năng biểu diễn một số hàm bằng ít tham số hơn rất nhiều.
4.5Thiết kế MLP trong thực hành#
Với dữ liệu không có cấu trúc không gian hay thời gian, một số lựa chọn mặc định thường là điểm khởi đầu tốt. Đầu vào cần được chuẩn hoá: đưa mỗi đặc trưng số về trung bình 0, độ lệch chuẩn 1, dùng thống kê tính trên tập huấn luyện. Khác với cây quyết định, mạng nơ-ron nhạy với thang đo của đặc trưng, vì thang đo ảnh hưởng tới số điều kiện của bài toán tối ưu (Mục 5.3 của Nền tảng). Mạng nên có 2 tới 4 lớp ẩn, bề rộng bằng nhau hoặc giảm dần; mạng sâu hơn cần kết nối tắt và chuẩn hoá (Chương 6). Hàm kích hoạt nên là ReLU hoặc GELU, và thuật toán tối ưu là Adam hoặc AdamW với tốc độ học khoảng (Mục 5.4). Để chống overfitting, dừng sớm dựa trên sai số xác thực là biện pháp rẻ và hiệu quả nhất, nên làm trước; sau đó mới tới weight decay và dropout với tỉ lệ 0,1 tới 0,3 (Mục 6.6).
Trước khi huấn luyện lâu, có hai kiểm tra rẻ ngay ở bước khởi tạo. Với bài toán phân loại lớp, mạng vừa khởi tạo nên cho xác suất gần đều trên các lớp, nên cross-entropy ban đầu phải gần , tức khoảng 2,303 với 10 lớp. Một con số lớn hơn nhiều cho thấy logit ban đầu quá lớn, và mạng sẽ tốn những vòng huấn luyện đầu chỉ để thu nhỏ chúng (CS231n; Karpathy, 2019). Kiểm tra thứ hai là đặt sẵn hệ số chặn của lớp ra theo dữ liệu: bằng trung bình của biến mục tiêu với hồi quy, hoặc bằng log tỉ lệ cược của tỉ lệ lớp với phân loại mất cân bằng; chẳng hạn khi 10% mẫu là dương, hệ số chặn ban đầu là , ứng với xác suất dự đoán 0,1. Như vậy mô hình không phải học điều hiển nhiên đó trong những vòng đầu.
CS231n còn có một lời khuyên đi ngược trực giác: không thu nhỏ mạng để chống overfitting. Mạng nhỏ dễ dừng ở những nghiệm có mất mát cao và cho kết quả dao động nhiều giữa các lần khởi tạo; nên dùng mạng lớn nhất mà tài nguyên cho phép rồi kiểm soát overfitting bằng regularization.
Trên dữ liệu dạng bảng, nên so sánh MLP với gradient boosting (Mục 3.6) trước khi kết luận, vì như Mục 1.2 đã nêu, gradient boosting thường tốt bằng hoặc tốt hơn.
4.6Tóm tắt#
Mạng nơ-ron nhiều lớp chồng các phép biến đổi affine xen với hàm kích hoạt phi tuyến; không có hàm phi tuyến thì chồng bao nhiêu lớp cũng chỉ bằng một lớp. Các lớp ẩn học một phép biến đổi đặc trưng, như ví dụ XOR cho thấy, còn lớp ra là một mô hình tuyến tính trên đặc trưng đã học, với hàm kích hoạt và hàm mất mát chọn theo bài toán. ReLU thay sigmoid trong mạng sâu vì đạo hàm của nó bằng 1 ở phía dương. Định lý xấp xỉ phổ quát bảo đảm mạng một lớp ẩn đủ rộng biểu diễn được mọi hàm liên tục, và với ReLU có thể thấy điều đó bằng một đường gấp khúc đi qua các điểm của hàm cần xấp xỉ; nhưng định lý không nói gì về số đơn vị cần thiết hay về việc học. Trước khi huấn luyện, mất mát ban đầu gần và hệ số chặn lớp ra đặt theo dữ liệu là hai kiểm tra rẻ. Với hàm răng cưa đoạn, mạng sâu cần tham số, trong khi mạng một lớp cần cỡ .
Biểu diễn được một hàm chưa có nghĩa là học được nó. Để học, ta cần gradient của hàm mất mát theo mọi tham số của mạng, và một cách dùng gradient đó để cập nhật tham số. Chương 5 trình bày cả hai việc.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Vì sao mạng nơ-ron cần hàm kích hoạt phi tuyến?
Vì sao: . Không có hàm phi tuyến thì mạng bao nhiêu lớp cũng chỉ biểu diễn được hàm affine, và không giải được cả bài toán XOR (Ví dụ 4.1).2Định lý xấp xỉ phổ quát không cho biết điều gì?
Vì sao: Đây là định lý tồn tại. Số đơn vị cần thiết, khả năng tìm được bằng tối ưu và lượng dữ liệu cần thiết đều nằm ngoài phạm vi của nó (Mục 4.3).3Một mạng một lớp ẩn với đầu vào một chiều cần ít nhất bao nhiêu đơn vị ReLU để biểu diễn chính xác hàm răng cưa đoạn?
Vì sao: Mỗi đơn vị ReLU tạo đúng một điểm gãy, và hàm răng cưa có điểm gãy bên trong. Mạng sâu lớp chỉ cần đơn vị, tức tham số; với là 42 so với 386 tham số (Mục 4.4).4Kết quả ở Mục 4.4 cho phép kết luận điều gì?
Vì sao: Hàm răng cưa là trường hợp thuận lợi nhất cho độ sâu, và thí nghiệm chỉ nói về khả năng biểu diễn. Huấn luyện một mạng 7 lớp, mỗi lớp 2 đơn vị, để học hàm này bằng gradient descent gần như luôn thất bại.5Vì sao đạo hàm của sigmoid làm gradient qua nhiều lớp nhỏ đi nhanh?
Đã trả lời 0/5