7Mạng nơ-ron tích chập#
Ảnh có một cấu trúc mà dữ liệu dạng bảng không có: các điểm ảnh gần nhau liên quan với nhau, và một chi tiết như cạnh hay góc có ý nghĩa như nhau dù xuất hiện ở đâu trong ảnh. Một mạng kết nối đầy đủ bỏ qua cấu trúc đó, nên phải học riêng cho từng vị trí và cần số tham số khổng lồ. Mạng nơ-ron tích chập (convolutional neural network, CNN) đưa hai tính chất trên vào chính kiến trúc, và nhờ vậy giảm số tham số đi hàng nghìn lần. Ta bắt đầu từ phép tích chập và các phép tính kích thước, tham số, chi phí đi kèm, rồi xem các khối mà CNN hiện đại ghép từ đó, so sánh CNN với Vision Transformer, và cuối cùng là hai bài toán thị giác ngoài phân loại ảnh: phát hiện đối tượng và phân đoạn ảnh.
7.1Phép tích chập#
Một lớp kết nối đầy đủ nhận ảnh và cho 1 000 đơn vị ẩn cần tham số, chỉ cho một lớp. Mạng tích chập giảm con số đó bằng ba giả định về ảnh, tóm tắt trong bảng dưới.
| Giả định | Cách thực hiện | Tác dụng |
|---|---|---|
| Đặc trưng có tính cục bộ | mỗi đơn vị chỉ nối với một vùng nhỏ của lớp trước | số kết nối của mỗi đơn vị không phụ thuộc kích thước ảnh |
| Một đặc trưng hữu ích ở một vị trí thì cũng hữu ích ở vị trí khác | chia sẻ trọng số: cùng một bộ lọc quét qua mọi vị trí | số tham số không phụ thuộc kích thước ảnh |
| Vị trí chính xác của đặc trưng ít quan trọng hơn sự có mặt của nó | gộp (pooling) hoặc bước nhảy lớn hơn 1 | giảm độ phân giải; bất biến gần đúng với dịch chuyển nhỏ |
Định nghĩa 7.1 (Lớp tích chập hai chiều)
Cho đầu vào và bộ lọc . Lớp tích chập với bước nhảy tính
Mỗi kênh đầu ra ứng với một bộ lọc, và giá trị tại vị trí là tích vô hướng giữa bộ lọc và vùng ảnh tương ứng.
Về mặt toán học, công thức trên là phép tương quan chéo (cross-correlation), vì bộ lọc không bị lật như trong định nghĩa tích chập của xử lý tín hiệu. Bộ lọc được học từ dữ liệu, nên lật hay không cũng không thay đổi những gì mạng biểu diễn được, và trong học sâu cả hai được gọi chung là tích chập.
Một ví dụ nhỏ cho thấy bộ lọc làm gì. Một ảnh xám cao 3, rộng 5 điểm, có mọi hàng là : phần trái tối, phần phải sáng, và một cạnh dọc ở giữa. Bộ lọc có mọi hàng là ; tại mỗi vị trí, nó cộng trên ba hàng hiệu giữa điểm ảnh bên phải và điểm ảnh bên trái của cửa sổ. Không đệm và bước nhảy 1, đầu ra có kích thước và bằng : bằng 0 ở vùng đồng nhất, bằng 3 ở hai vị trí mà cửa sổ chứa cạnh. Đây là một bộ dò cạnh dọc, và các lớp tích chập đầu tiên của một CNN đã huấn luyện thường học được những bộ dò cạnh theo nhiều hướng như vậy. Andrew Ng giảng phép tích chập theo đúng thứ tự này, bộ lọc viết tay trước rồi mới tới ý chính: trong CNN, chín con số của bộ lọc là tham số học từ dữ liệu, không phải do người thiết kế.
Khi thiết kế một mạng tích chập, ba phép tính được dùng liên tục. Phép tính đầu tiên là kích thước đầu ra. Với đầu vào cao , bộ lọc cao , bước nhảy và phần đệm (padding) ô mỗi phía, chiều cao đầu ra là
và chiều rộng tính tương tự. Không phải tổ hợp nào cũng khớp: với , , và không đệm, không nguyên, phép lấy phần nguyên cho đầu ra cao 2, và hàng cuối của ảnh không bao giờ được bộ lọc đi qua; CS231n coi đó là một cấu hình cần tránh. Phép tính thứ hai là số tham số: một lớp tích chập có tham số, không phụ thuộc kích thước ảnh. Phép tính thứ ba là số phép tính, và con số này thì có phụ thuộc vào kích thước ảnh: mỗi giá trị đầu ra cần phép nhân và cộng, nên cả lớp tốn khoảng
Ví dụ 7.1 (Lớp đầu của ResNet-50)
Lớp tích chập đầu tiên nhận ảnh , dùng 64 bộ lọc , bước nhảy 2, phần đệm 3. Kích thước đầu ra là , tức . Số tham số là (lớp này không có hệ số chặn vì có BatchNorm theo sau). Số phép tính là FLOP. So với lớp kết nối đầy đủ ở đầu mục, số tham số nhỏ hơn khoảng 16 000 lần.
Sự tách rời giữa số tham số và số phép tính hay gây nhầm lẫn khi ước lượng chi phí. Một mô hình "nhẹ" về tham số vẫn có thể rất tốn tính toán khi chạy trên ảnh độ phân giải cao, vì số phép tính tăng theo diện tích ảnh. Bộ nhớ cho giá trị kích hoạt cũng vậy: CS231n tính rằng VGG-16 cần khoảng 93 MB chỉ để lưu giá trị kích hoạt của một ảnh ở lượt xuôi, phần lớn ở các lớp tích chập đầu nơi ảnh còn lớn, trong khi phần lớn 138 triệu tham số của nó nằm ở các lớp kết nối đầy đủ cuối mạng.
Chia sẻ trọng số còn làm lớp tích chập đẳng biến với phép dịch chuyển (translation equivariant): dịch ảnh đầu vào đi một số ô thì bản đồ đặc trưng đầu ra dịch theo đúng số ô đó, nếu bỏ qua hiệu ứng ở biên. Với ảnh cạnh dọc ở trên, thêm một cột tối vào bên trái, tức ảnh rộng 6 điểm và cạnh dịch sang phải một ô, thì đầu ra rộng 4 và bằng : hai giá trị 3 dịch theo đúng một ô. Gộp và bước nhảy biến tính đẳng biến này thành bất biến gần đúng: một dịch chuyển nhỏ không làm thay đổi đầu ra sau khi gộp. Nhiều tài liệu, kể cả d2l.ai và CS231n, gọi chung cả hai tính chất là bất biến; nói chặt chẽ thì tích chập đẳng biến, còn gộp mới đưa lại bất biến gần đúng. Tính bất biến này chỉ gần đúng; Azulay và Weiss (2019) cho thấy các CNN hiện đại có thể đổi dự đoán khi ảnh chỉ dịch đi một điểm ảnh, vì bước nhảy lớn hơn 1 phá vỡ tính đẳng biến.
7.2Trường tiếp nhận#
Mỗi đơn vị của lớp tích chập chỉ nhìn một vùng nhỏ của lớp trước. Muốn nhận ra một đối tượng lớn, mạng phải chồng nhiều lớp để vùng nhìn thấy của các đơn vị ở sâu lớn dần lên.
Định nghĩa 7.2 (Trường tiếp nhận)
Trường tiếp nhận (receptive field) của một đơn vị là vùng của ảnh đầu vào có ảnh hưởng tới giá trị của đơn vị đó.
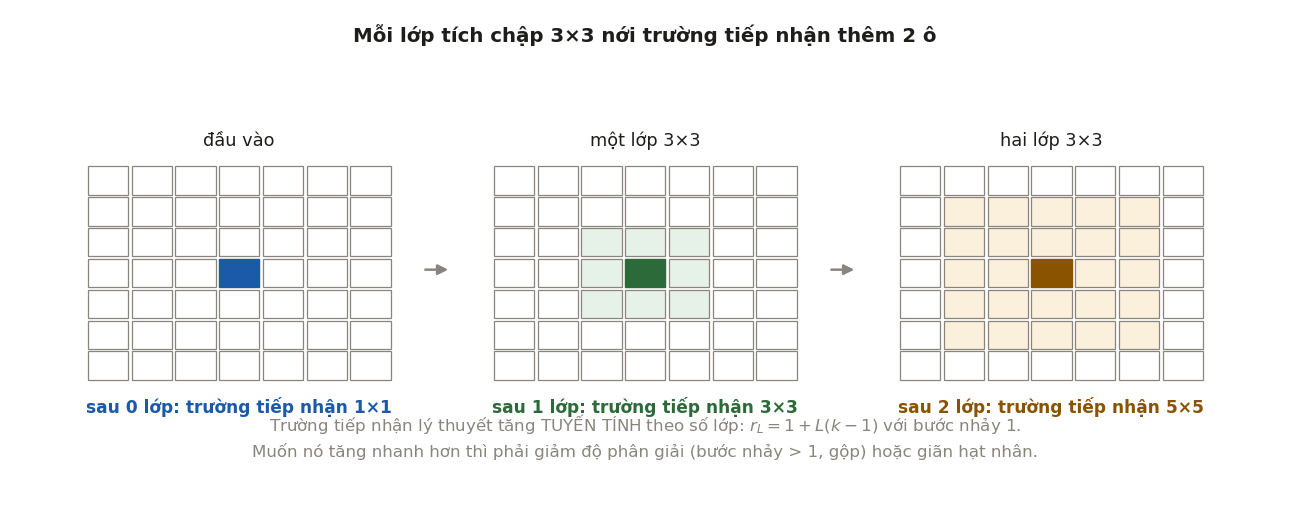
Với lớp thứ có bộ lọc kích thước và bước nhảy , kích thước trường tiếp nhận tính theo công thức truy hồi
Tích các bước nhảy phía trước cho biết một ô ở lớp ứng với bao nhiêu điểm ảnh của đầu vào. Với bước nhảy 1 và bộ lọc ở mọi lớp, : trường tiếp nhận chỉ tăng tuyến tính theo số lớp, và phải cần tới 112 lớp mới phủ được ảnh rộng 224 điểm. Vì vậy các CNN thực tế đều giảm độ phân giải sớm: sau mỗi lần bước nhảy 2, mọi lớp phía sau mở rộng trường tiếp nhận nhanh gấp đôi. Chẳng hạn, lớp bước nhảy 2 cho ; lớp gộp bước nhảy 2 phía sau đưa lên ; mỗi lớp tiếp theo thêm điểm ảnh.
Công thức này dẫn tới hai hệ quả trong thiết kế. Hai lớp có cùng trường tiếp nhận với một lớp , nhưng dùng trọng số cho mỗi cặp kênh thay vì 25, và có thêm một hàm phi tuyến ở giữa. Tương tự, ba lớp thay được một lớp với 27 thay vì 49 trọng số. Đây là lập luận của mạng VGG (Simonyan và Zisserman, 2015), và giải thích vì sao bộ lọc lớn ít được dùng trong các mạng sau đó.
Hệ quả thứ hai là trường tiếp nhận hiệu dụng nhỏ hơn nhiều so với con số lý thuyết. Cần để ý tên gọi: CS231n dùng "trường tiếp nhận hiệu dụng" cho chính trường tiếp nhận lý thuyết của nhiều lớp chồng lên nhau, như của hai lớp , còn ở đây, theo Luo và cộng sự, tên gọi chỉ vùng có ảnh hưởng thật sự đáng kể. Luo và cộng sự (2016) cho thấy ảnh hưởng của các điểm ảnh lên một đơn vị có phân bố gần với phân phối Gauss tập trung ở giữa trường tiếp nhận, và độ rộng hiệu dụng chỉ tăng theo thay vì . Các điểm ảnh ở rìa trường tiếp nhận lý thuyết gần như không có ảnh hưởng.
7.3Các khối thường dùng#
Các CNN hiện đại được ghép từ một số khối chuẩn. Bảng dưới liệt kê những khối hay gặp nhất cùng tác dụng của chúng.
| Khối | Cấu tạo | Tác dụng |
|---|---|---|
| Tích chập | bộ lọc kích thước | trộn thông tin giữa các kênh tại từng vị trí; thay đổi số kênh với chi phí thấp |
| Khối cổ chai (bottleneck) | giảm số kênh, , rồi tăng lại số kênh | giảm mạnh số phép tính ở cùng độ sâu; dùng trong ResNet-50 trở lên |
| Tích chập tách theo chiều sâu (depthwise separable) | tích chập riêng cho từng kênh, rồi tích chập | giảm chi phí khoảng lần; là nền tảng của MobileNet (Howard và cộng sự, 2017) |
| Khối dư (residual block) | cho phép mạng sâu hàng trăm lớp (Mục 6.5) | |
| Gộp trung bình toàn cục | lấy trung bình mỗi kênh trên toàn bộ không gian trước lớp phân loại | bỏ được lớp kết nối đầy đủ lớn ở cuối mạng; nhận ảnh có kích thước bất kỳ |
Khối cổ chai cho thấy tích chập tiết kiệm được bao nhiêu. Ở độ phân giải với 256 kênh, một tích chập giữ nguyên 256 kênh tốn phép nhân–cộng. Khối cổ chai của ResNet-50 giảm còn 64 kênh bằng tích chập , chạy tích chập trên 64 kênh, rồi tăng lại 256 kênh: , ít hơn khoảng 8,5 lần. Andrew Ng dùng cùng kiểu phép tính với khối Inception để giới thiệu tích chập .
Với tích chập tách theo chiều sâu, số trọng số của tích chập thường là , còn của phiên bản tách là . Tỉ lệ giữa hai con số là
Với và , tỉ lệ là 0,115, tức rẻ hơn khoảng 8,7 lần, và số phép tính giảm theo cùng tỉ lệ. Đổi lại, mỗi kênh của lớp depthwise chỉ có 9 trọng số, và dải giá trị của các kênh có thể chênh nhau rất nhiều; Mục 5.3 của Quantization cho thấy đây là loại lớp nhạy nhất khi lượng tử hoá với một thang đo chung cho cả lớp.
7.4CNN và Vision Transformer#
Từ năm 2020, CNN có một đối thủ trên chính sân nhà của nó. Vision Transformer (ViT; Dosovitskiy và cộng sự, 2021) cắt ảnh thành các mảnh điểm ảnh, chiếu mỗi mảnh thành một vector, rồi xử lý dãy vector như dãy token bằng Transformer (Chương 9). Ảnh cho token.
Khác biệt giữa hai kiến trúc là khác biệt về thiên kiến quy nạp (Mục 1.4). CNN đưa sẵn vào kiến trúc tính cục bộ và tính đẳng biến với dịch chuyển; đây là giả định đúng với ảnh tự nhiên, nên CNN học được từ lượng dữ liệu vừa phải. ViT gần như không giả định gì về cấu trúc không gian: mọi mảnh có thể tương tác với mọi mảnh ngay từ lớp đầu, và mô hình phải tự học từ dữ liệu những quan hệ mà CNN có sẵn. Kết quả trong bài báo ViT phản ánh đúng đánh đổi này: khi chỉ huấn luyện trên ImageNet (1,3 triệu ảnh), ViT kém các mạng ResNet cùng cỡ; khi tiền huấn luyện trên tập JFT-300M (300 triệu ảnh), ViT vượt ResNet.
Theo ngôn ngữ của Chương 2, thiên kiến quy nạp mạnh ứng với độ chệch cao hơn và phương sai thấp hơn: có lợi khi dữ liệu ít, trở thành giới hạn khi dữ liệu nhiều. Khoảng cách giữa hai họ cũng không cố định. ConvNeXt (Liu và cộng sự, 2022) cho thấy một CNN được hiện đại hoá theo các lựa chọn thiết kế của Transformer cạnh tranh được với ViT ở cùng quy mô, và nhiều kiến trúc hiện nay kết hợp tích chập với attention.
7.5Phát hiện đối tượng#
Phân loại ảnh trả lời câu hỏi "ảnh có gì". Phát hiện đối tượng (object detection) trả lời thêm câu hỏi "ở đâu": đầu ra là một danh sách hộp bao (bounding box), mỗi hộp kèm nhãn lớp và một điểm tin cậy. Số đối tượng thay đổi theo từng ảnh, nên đầu ra không có kích thước cố định như bài toán phân loại, và phần lớn cấu trúc của các bộ phát hiện đến từ việc giải quyết điều này.
Một hộp thường được biểu diễn bằng toạ độ góc trên bên trái và góc dưới bên phải , hoặc bằng tâm và kích thước . Để so sánh hai hộp, cần một thước đo mức trùng khớp.
Định nghĩa 7.3 (IoU)
Độ trùng khớp IoU (intersection over union) giữa hai hộp và là tỉ số giữa diện tích phần giao và diện tích phần hợp:
IoU nằm trong , bằng 1 khi hai hộp trùng nhau hoàn toàn và bằng 0 khi chúng không giao nhau.
Ví dụ 7.2
Hộp và : phần giao là hình vuông , diện tích 4; phần hợp là ; nên . Hộp chỉ là dịch sang phải 1 đơn vị: giao , hợp , IoU . Hộp là nửa trên của : IoU . Ví dụ cuối cho thấy một hộp chỉ phủ nửa đối tượng vẫn đạt ngưỡng 0,5 thường dùng khi đánh giá.
Các bộ phát hiện dựa trên CNN chia thành hai họ. Họ hai giai đoạn (two-stage) đề xuất trước các vùng có khả năng chứa đối tượng, rồi mới phân loại từng vùng và tinh chỉnh hộp. Đại diện đầu tiên là R-CNN (Girshick và cộng sự, 2014), lấy khoảng 2 000 vùng đề xuất từ thuật toán selective search và chạy CNN riêng trên từng vùng, nên rất chậm. Fast R-CNN (Girshick, 2015) chạy CNN một lần cho cả ảnh rồi cắt đặc trưng của từng vùng bằng phép RoI pooling. Faster R-CNN (Ren và cộng sự, 2015) thay selective search bằng một mạng đề xuất vùng (region proposal network, RPN) dùng chung đặc trưng với phần phát hiện, nên toàn bộ hệ thống trở thành một mạng nơ-ron huấn luyện được từ đầu tới cuối.
Họ một giai đoạn (one-stage) bỏ bước đề xuất vùng và dự đoán trực tiếp hộp cùng lớp trên một lưới dày đặc. YOLO (Redmon và cộng sự, 2016) chia ảnh thành lưới ; mỗi ô dự đoán 2 hộp và xác suất của 20 lớp, nên đầu ra là một tensor , và mô hình chạy được 45 khung hình mỗi giây. SSD (Liu và cộng sự, 2016) dự đoán trên nhiều bản đồ đặc trưng có độ phân giải khác nhau, để bản đồ chi tiết bắt đối tượng nhỏ còn bản đồ thô bắt đối tượng lớn.
Bộ một giai đoạn thường nhanh hơn, còn bộ hai giai đoạn từng chính xác hơn. Lin và cộng sự (2017) chỉ ra nguyên nhân chính của khoảng cách này: bộ một giai đoạn đánh giá hàng chục nghìn vị trí trên mỗi ảnh, phần lớn là nền dễ nhận ra, và tổng hàm mất mát của số đông mẫu dễ này lấn át số ít đối tượng thật. Họ đề xuất focal loss:
trong đó là xác suất mô hình gán cho lớp đúng và là trọng số theo lớp. Hệ số giảm trọng số của các mẫu đã được phân loại tốt: với , một mẫu có nhận trọng số , tức đóng góp nhỏ hơn 100 lần so với cross-entropy, còn một mẫu khó với nhận trọng số . Bộ phát hiện một giai đoạn RetinaNet dùng hàm mất mát này đạt độ chính xác của các bộ hai giai đoạn cùng thời.
Một chi tiết chung của Faster R-CNN, SSD và RetinaNet là hộp neo (anchor box). Tại mỗi vị trí trên bản đồ đặc trưng, mô hình đặt một số hộp có kích thước và tỉ lệ cạnh định trước; RPN của Faster R-CNN dùng 3 kích thước và 3 tỉ lệ, tức 9 hộp neo mỗi vị trí. Mạng không dự đoán toạ độ tuyệt đối mà dự đoán độ lệch so với hộp neo:
với là tâm và kích thước của hộp, chỉ số chỉ hộp neo. Chia cho kích thước hộp neo làm độ lệch không phụ thuộc vào kích thước đối tượng, còn logarit làm phép co giãn đối xứng: hộp lớn gấp đôi hay nhỏ đi một nửa cho bằng hay . Khi huấn luyện, mỗi hộp neo được gán nhãn theo IoU với các hộp thật: trong RPN, hộp neo có IoU lớn hơn 0,7 với một hộp thật là mẫu dương, nhỏ hơn 0,3 với mọi hộp thật là mẫu âm, còn ở giữa thì bỏ qua. Một số cài đặt còn chia các độ lệch này cho những hằng số như 0,1 và 0,2 để chuẩn hoá thang đo, nên khi đọc mã cần xem dùng quy ước nào. Kích thước của các hộp neo được chọn bằng tay, hoặc bằng K-means trên kích thước các hộp thật như YOLOv2 (Redmon và Farhadi, 2017). Các bộ phát hiện không dùng hộp neo (anchor-free) như FCOS (Tian và cộng sự, 2019) và CenterNet (Zhou và cộng sự, 2019) dự đoán trực tiếp từ từng điểm của bản đồ đặc trưng, bớt được các siêu tham số về kích thước và tỉ lệ của hộp neo.
Vì dự đoán trên một lưới dày đặc, một đối tượng thường được nhiều hộp gần nhau cùng phát hiện. Bước non-maximum suppression (NMS) lọc các hộp trùng theo thuật toán sau.
- Sắp xếp các hộp theo điểm tin cậy giảm dần.
- Đưa hộp có điểm cao nhất vào kết quả.
- Bỏ mọi hộp còn lại có IoU với hộp vừa chọn lớn hơn một ngưỡng, thường là 0,5.
- Lặp lại bước 2 và 3 với các hộp còn lại cho tới khi hết.
Ví dụ 7.3 (Hình 9, trái)
Sáu hộp dự đoán có điểm A 0,92; B 0,85; D 0,80; C 0,60; E 0,55; F 0,40. IoU giữa A và B là 0,822, giữa A và C là 0,566, giữa A và F là 0,143, giữa D và E là 0,716. Với ngưỡng 0,5: chọn A, bỏ B và C; trong các hộp còn lại D có điểm cao nhất, chọn D và bỏ E; còn F, chọn F. Kết quả là ba hộp A, D, F.
Hộp F chỉ trùng 0,143 với A nên được giữ, vì NMS coi đó là một đối tượng khác. Trong thực tế còn hai chi tiết mà Andrew Ng nhấn mạnh: các hộp có điểm tin cậy dưới một ngưỡng bị bỏ ngay trước khi chạy NMS, và NMS chạy riêng cho từng lớp, để một hộp "người" không loại nhầm một hộp "xe đạp" trùng với nó. Đây cũng là giới hạn của NMS: hai đối tượng thật đứng sát nhau, như người trong đám đông, có hộp trùng nhau nhiều, và hộp có điểm thấp hơn bị loại nhầm. DETR (Carion và cộng sự, 2020) bỏ hẳn NMS và hộp neo. Một Transformer encoder–decoder nhận đặc trưng của ảnh và 100 vector truy vấn, mỗi truy vấn sinh ra một hộp hoặc "không có đối tượng"; khi huấn luyện, các dự đoán được ghép một–một với hộp thật bằng thuật toán Hungary, nên mỗi đối tượng chỉ có một dự đoán chịu trách nhiệm. Đổi lại, DETR huấn luyện lâu hơn nhiều: bài báo gốc dùng 500 epoch trên COCO.
Còn lại câu hỏi đánh giá một bộ phát hiện thế nào. Cách đánh giá dựa trên precision và recall (Mục 8.3 của Nền tảng), với định nghĩa đúng sai qua IoU. Ta xét các hộp dự đoán theo điểm giảm dần. Một hộp là dương tính thật nếu IoU của nó với một hộp thật cùng lớp, chưa được ghép với dự đoán nào trước đó, đạt ngưỡng, thường là 0,5; ngược lại nó là dương tính giả. Hộp thật không được ghép là âm tính giả. Mỗi hộp thật chỉ được ghép một lần, nên các hộp trùng của cùng một đối tượng bị tính là dương tính giả.
Hạ dần ngưỡng điểm, ta được đường precision–recall. AP (average precision) là diện tích dưới đường này sau khi thay mỗi giá trị precision bằng precision lớn nhất ở các mức recall lớn hơn hoặc bằng: . PASCAL VOC 2007 lấy trung bình tại 11 mức recall ; từ VOC 2010, AP là diện tích tính tại mọi điểm (Everingham và cộng sự, 2010). mAP là trung bình AP của các lớp. COCO (Lin và cộng sự, 2014) tính AP tại 101 mức recall và lấy trung bình trên 10 ngưỡng IoU . Con số này được ký hiệu AP@[0,5:0,95], hoặc gọn là AP trong các bài báo dùng COCO, còn AP50 và AP75 là AP tại một ngưỡng IoU. COCO không phân biệt AP với mAP: con số AP của COCO đã là trung bình trên các lớp.
Để thấy các quy ước này ảnh hưởng ra sao, script code/models/thi_giac.py mô phỏng một bộ phát hiện trên 300 ảnh kích thước , mỗi ảnh 1 tới 4 đối tượng, tổng cộng 765 hộp thật. Mỗi đối tượng được phát hiện với xác suất 0,9 bằng một hộp lệch ngẫu nhiên khoảng 6% kích thước ở mỗi cạnh; với xác suất 0,3 có thêm một hộp trùng lệch hơn và điểm thấp hơn; ngoài ra mỗi ảnh có trung bình 0,6 hộp báo nhầm ở chỗ không có gì. Không có mô hình nào được huấn luyện: mô phỏng cô lập đúng phần cần hiểu là cách ghép hộp, lọc trùng và tính AP.
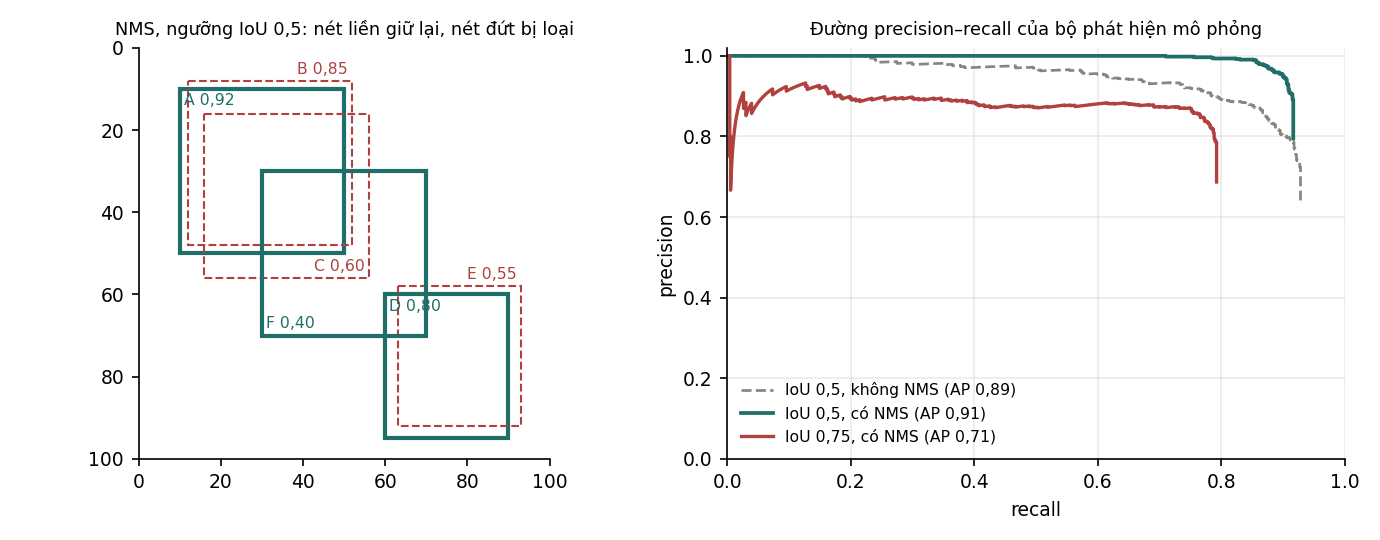
| Cách đánh giá | AP (mọi điểm) | AP (101 điểm) | Recall lớn nhất |
|---|---|---|---|
| IoU 0,5, không lọc trùng | 0,885 | 0,879 | 0,928 |
| IoU 0,5, có NMS | 0,913 | 0,908 | 0,916 |
| IoU 0,75, có NMS | 0,708 | 0,708 | 0,792 |
Với NMS, AP theo cách tính của COCO tại các ngưỡng IoU 0,5; 0,6; 0,7; 0,8; 0,9 lần lượt là 0,908; 0,894; 0,829; 0,425; 0,014, và trung bình trên 10 ngưỡng là AP@[0,5:0,95] = 0,569.
Hai dòng đầu cho thấy NMS tăng AP nhưng loại nhầm một ít hộp đúng. Không lọc trùng, các hộp trùng bị tính là dương tính giả và AP50 là 0,885; sau NMS, AP50 tăng lên 0,913. Nhưng recall lớn nhất giảm từ 0,928 xuống 0,916, vì NMS đã loại một số hộp đúng của các đối tượng đứng sát nhau, đúng giới hạn nêu ở trên.
Dòng cuối và dãy AP theo ngưỡng cho thấy ngưỡng IoU thay đổi con số rất nhiều. Cùng một bộ phát hiện, AP giảm từ 0,908 ở ngưỡng 0,5 xuống 0,708 ở 0,75 và gần 0 ở 0,9: hộp lệch khoảng 6% kích thước mỗi cạnh là đủ tốt cho ngưỡng 0,5 nhưng hiếm khi đạt 0,9. AP@[0,5:0,95] thưởng cho việc định vị chính xác, nên hai bộ phát hiện có cùng AP50 có thể khác xa nhau theo thước đo này. Khi đọc một con số AP, cần biết nó được tính theo quy ước nào.
7.6Phân đoạn ảnh#
Phát hiện đối tượng khoanh vùng bằng hộp, nhưng một chiếc xe hay một khối u không có hình hộp. Phân đoạn ảnh (image segmentation) đi xa hơn: gán nhãn cho từng điểm ảnh thay vì cho cả ảnh hay cho một hộp. Có ba bài toán phân đoạn, khác nhau ở việc có phân biệt các đối tượng cùng lớp hay không.
| Bài toán | Đầu ra | Ví dụ |
|---|---|---|
| Phân đoạn ngữ nghĩa (semantic segmentation) | mỗi điểm ảnh một nhãn lớp; không phân biệt các đối tượng cùng lớp | đường, vỉa hè, xe, người trong ảnh từ camera của xe |
| Phân đoạn thể hiện (instance segmentation) | một mặt nạ riêng cho từng đối tượng | từng chiếc xe, từng người |
| Phân đoạn toàn cảnh (panoptic segmentation; Kirillov và cộng sự, 2019) | mọi điểm ảnh có nhãn lớp, và các đối tượng đếm được có thêm định danh riêng | bản đồ đầy đủ của một cảnh |
Khó khăn đầu tiên là độ phân giải. Một CNN phân loại giảm độ phân giải dần qua các lớp, chẳng hạn từ xuống , để trường tiếp nhận đủ lớn (Mục 7.2), trong khi phân đoạn lại cần đầu ra ở độ phân giải gốc. FCN (fully convolutional network; Long, Shelhamer và Darrell, 2015) giải quyết bằng ba thay đổi. Các lớp kết nối đầy đủ ở cuối được thay bằng tích chập, để mạng cho ra một bản đồ lớp thô thay vì một vector. Bản đồ đó được tăng độ phân giải bằng tích chập chuyển vị. Và đặc trưng từ các lớp đầu, nơi độ phân giải còn cao, được cộng thêm vào để khôi phục chi tiết ở biên đối tượng.
Tích chập chuyển vị (transposed convolution) là phép tăng kích thước không gian. Với đầu vào kích thước , bộ lọc , bước nhảy và phần đệm , đầu ra có kích thước
Ví dụ, , , , cho : độ phân giải tăng gấp đôi. Ví dụ quen thuộc trong các bài giảng biến ảnh thành bằng bộ lọc , bước nhảy 2, đệm 1; công thức trên cho 3, và các thư viện thêm một tham số output_padding bằng 1 để được 4. Cơ chế dễ thấy nhất ở một chiều: đầu vào với bộ lọc và bước nhảy 2 cho . Mỗi giá trị đầu vào rải một bản sao của bộ lọc, nhân với chính nó, và các bản sao cộng chồng ở chỗ giao nhau. Tên gọi deconvolution hay dùng cho phép này là sai, vì nó không đảo ngược phép tích chập: viết phép tích chập thành phép nhân với một ma trận thưa , phép tăng kích thước này là phép nhân với , nên mới có tên tích chập chuyển vị (CS231n; d2l.ai). Khi không chia hết cho , các vùng ảnh hưởng của bộ lọc chồng lên nhau không đều và có thể tạo hoa văn ô cờ trên ảnh đầu ra (Odena và cộng sự, 2016); một cách thay thế phổ biến là phóng to bằng nội suy song tuyến tính rồi mới tích chập.
Kiến trúc phân đoạn được dùng rộng rãi nhất là U-Net (Ronneberger, Fischer và Brox, 2015). Nó gồm một nhánh mã hoá giảm độ phân giải và tăng số kênh như một CNN phân loại, và một nhánh giải mã đối xứng tăng dần độ phân giải. Ở mỗi mức độ phân giải, nhánh giải mã ghép (concatenate) bản đồ đặc trưng của nhánh mã hoá ở cùng mức: đặc trưng sâu cho biết "đây là gì", đặc trưng nông cho biết chính xác "ở đâu". U-Net được thiết kế cho ảnh y sinh, nơi chỉ có vài chục ảnh có nhãn (một bài toán trong bài báo có 30 ảnh huấn luyện), và dựa nhiều vào tăng cường dữ liệu. Ngày nay kiến trúc này còn là mạng khử nhiễu trong nhiều mô hình khuếch tán (Ho và cộng sự, 2020; Chương 11 của Biểu diễn & Căn chỉnh).
Một cách khác để có trường tiếp nhận lớn mà không phải giảm độ phân giải là tích chập giãn (dilated convolution, atrous convolution), chèn ô trống giữa các phần tử của bộ lọc. Bộ lọc với hệ số giãn phủ một vùng kích thước mà vẫn chỉ có trọng số: bộ lọc với phủ , với phủ . DeepLab (Chen và cộng sự, 2018) dùng tích chập giãn, và chạy song song nhiều hệ số giãn khác nhau để bắt ngữ cảnh ở nhiều tỉ lệ.
Với phân đoạn thể hiện, Mask R-CNN (He và cộng sự, 2017) thêm vào Faster R-CNN một nhánh dự đoán mặt nạ nhị phân cho mỗi vùng, song song với nhánh phân loại và nhánh hộp. Nó cũng thay RoI pooling bằng RoIAlign. RoI pooling làm tròn toạ độ của vùng về lưới của bản đồ đặc trưng, gây lệch tới nửa ô; sai lệch đó chấp nhận được với hộp nhưng không chấp nhận được khi cần chính xác tới từng điểm ảnh, nên RoIAlign lấy giá trị tại toạ độ thực bằng nội suy song tuyến tính.
Đánh giá phân đoạn cũng có bẫy riêng. Độ chính xác theo điểm ảnh (pixel accuracy) dễ gây hiểu lầm khi các lớp mất cân bằng: nếu nền chiếm 95% số điểm ảnh, một mô hình gán mọi điểm là nền đạt 95%. Thước đo chuẩn cho phân đoạn ngữ nghĩa là IoU theo lớp và mIoU, trung bình IoU của các lớp, với IoU tính trên tập điểm ảnh thay vì trên hộp. Trong phân đoạn ảnh y tế, người ta hay dùng hệ số Dice . Dice và IoU liên hệ bởi , nên Dice luôn lớn hơn hoặc bằng IoU: IoU 0,3; 0,5; 0,7; 0,9 ứng với Dice 0,462; 0,667; 0,824; 0,947. Vì vậy khi so sánh kết quả từ hai bài báo, cần chú ý chúng dùng thước đo nào.
Hàm mất mát cơ bản là cross-entropy trên từng điểm ảnh. Khi đối tượng chỉ chiếm một phần rất nhỏ của ảnh, như khối u trên ảnh chụp, cross-entropy bị số đông điểm ảnh nền chi phối, giống tình huống của focal loss ở Mục 7.5. Các cách xử lý gồm đặt trọng số theo lớp, dùng focal loss, và dùng Dice loss (Milletari và cộng sự, 2016): , với Dice tính từ xác suất dự đoán thay vì nhãn đã làm tròn để lấy đạo hàm được. Dice loss chỉ quan tâm tới mức trùng khớp của vùng đối tượng, nên không bị số điểm ảnh nền lấn át.
Xu hướng mới nhất trong phân đoạn là mô hình nền. SAM (Segment Anything; Kirillov và cộng sự, 2023) nhận một ảnh và một gợi ý, có thể là một vài điểm hoặc một hộp, rồi trả về mặt nạ của đối tượng được chỉ tới. Mô hình được huấn luyện trên bộ dữ liệu SA-1B gồm hơn 1 tỉ mặt nạ trên 11 triệu ảnh, và dùng được trên nhiều loại ảnh chưa từng thấy mà không cần huấn luyện thêm. Trong ứng dụng, SAM thường được ghép với một bộ phát hiện: bộ phát hiện đưa ra hộp, SAM biến hộp thành mặt nạ. Đây là cùng xu hướng với mô hình ngôn ngữ ở các Chương 9 tới 12: một mô hình nền huấn luyện trên dữ liệu rất lớn, rồi được dùng cho nhiều nhiệm vụ cụ thể.
7.7Tóm tắt#
Mạng tích chập dựa trên ba giả định về ảnh: tính cục bộ, chia sẻ trọng số giữa các vị trí, và tính bất biến gần đúng với dịch chuyển nhỏ. Nhờ vậy số tham số của một lớp không phụ thuộc kích thước ảnh, dù số phép tính thì có, như lớp đầu của ResNet-50 với 9 408 tham số và khoảng FLOP. Trường tiếp nhận tăng tuyến tính theo số lớp, nên mạng phải giảm độ phân giải sớm, và chồng các lớp rẻ hơn dùng bộ lọc lớn. So với ViT, CNN có thiên kiến quy nạp mạnh hơn, nên tốt hơn khi dữ liệu vừa phải và kém hơn khi dữ liệu rất lớn. Phát hiện đối tượng thêm câu hỏi "ở đâu", với IoU để so hộp, hộp neo, NMS để lọc trùng và AP để đánh giá; mô phỏng cho thấy AP giảm từ 0,908 ở ngưỡng IoU 0,5 xuống 0,014 ở 0,9, nên con số AP chỉ có nghĩa khi biết quy ước tính. Phân đoạn gán nhãn cho từng điểm ảnh, với FCN, U-Net, tích chập giãn và các thước đo IoU, Dice.
CNN khai thác cấu trúc không gian của ảnh. Văn bản, tiếng nói và chuỗi thời gian có một cấu trúc khác: thứ tự. Chương 8 xét họ mô hình đầu tiên được thiết kế cho dữ liệu dạng chuỗi.
Tự kiểm tra
9 câu. Chọn đáp án để xem ngay lời giải thích.
1Trường tiếp nhận sau lớp tích chập với bước nhảy 1 rộng bao nhiêu điểm ảnh?
Vì sao: Theo với và , mỗi lớp thêm 2. Phủ ảnh rộng 224 điểm cần 112 lớp, nên CNN thực tế đều giảm độ phân giải bằng bước nhảy hoặc gộp (Mục 7.2).2Vì sao trường tiếp nhận hiệu dụng nhỏ hơn con số lý thuyết?
Vì sao: Kết quả của Luo và cộng sự (2016). Các điểm ở rìa trường tiếp nhận lý thuyết gần như không ảnh hưởng tới đơn vị.3Ba giả định mà mạng tích chập đưa vào kiến trúc là gì?
4Một lớp tích chập , 64 bộ lọc, bước nhảy 2, phần đệm 3, nhận ảnh . Đầu ra có kích thước không gian bao nhiêu?
Vì sao: . Lớp có trọng số (Ví dụ 7.1).5Hai hộp và có IoU bằng bao nhiêu?
Vì sao: Phần giao là hình vuông , diện tích 4; phần hợp là ; IoU (Ví dụ 7.2). Lỗi hay gặp là chia cho tổng diện tích 32 thay vì diện tích phần hợp.6Vì sao bộ phát hiện cần bước NMS?
Vì sao: Khi đánh giá, hộp trùng của cùng một đối tượng bị tính là dương tính giả, nên NMS làm AP tăng; đổi lại, nó có thể loại nhầm hộp đúng của đối tượng đứng sát bên (Mục 7.5).7Cùng một bộ phát hiện, vì sao AP@[0,5:0,95] thấp hơn nhiều so với AP50?
Vì sao: Trong thí nghiệm ở Mục 7.5, AP giảm từ 0,908 ở ngưỡng 0,5 xuống 0,014 ở ngưỡng 0,9, và trung bình trên 10 ngưỡng là 0,569.8Trong U-Net, các kết nối giữa nhánh mã hoá và nhánh giải mã có tác dụng gì?
Vì sao: Đặc trưng sâu cho biết "đây là gì" nhưng đã mất chi tiết vị trí sau nhiều lần giảm độ phân giải; ghép với đặc trưng nông cùng mức cho biết "ở đâu" (Mục 7.6).9Hai mô hình phân đoạn có IoU 0,5. Hệ số Dice tương ứng là bao nhiêu?
Vì sao: . Dice luôn lớn hơn hoặc bằng IoU, nên khi so sánh kết quả phải cùng một thước đo (Mục 7.6).
Đã trả lời 0/9