6Khởi tạo, chuẩn hoá và kết nối tắt#
Ở Mục 4.4, một mạng 7 lớp, mỗi lớp 2 đơn vị, biểu diễn được hàm răng cưa 128 đoạn, nhưng gradient descent gần như không bao giờ tìm ra bộ trọng số đó. Một phần nguyên nhân nằm trong công thức lan truyền ngược của Chương 5: gradient tại một lớp là tích của các ma trận Jacobi của mọi lớp phía sau, và tích của nhiều thừa số hơi nhỏ hơn hoặc hơi lớn hơn 1 sẽ co về 0 hoặc phình ra rất nhanh. Trong một thời gian dài, đây là trở ngại khiến các mạng sâu vài chục lớp rất khó huấn luyện. Ba kỹ thuật giữ độ lớn của tín hiệu ổn định đã gỡ trở ngại đó: khởi tạo trọng số đúng phương sai, chuẩn hoá, và kết nối tắt. Một thí nghiệm trên mạng 40 lớp sẽ đo tác dụng của từng kỹ thuật, và cho một kết quả hay bị hiểu sai: kết nối tắt một mình không đủ.
6.1Tín hiệu co lại hoặc phình ra qua nhiều lớp#
Theo Mục 5.2, gradient theo đầu vào của một lớp là tích của các ma trận Jacobi của mọi lớp phía sau. Nếu mỗi lớp nhân độ lớn của gradient với một hệ số trung bình , thì qua lớp gradient bị nhân với khoảng . Với và , hệ số là ; với , hệ số là 117. Chỉ cần lệch khỏi 1 một chút, gradient ở các lớp đầu sẽ tiêu biến về gần 0 hoặc bùng nổ. Lượt xuôi gặp vấn đề tương tự với độ lớn của các giá trị kích hoạt.
Ba kỹ thuật trong chương này đều nhằm giữ gần 1, và chúng bổ sung cho nhau chứ không thay thế nhau.
6.2Khởi tạo Xavier và He#
Kỹ thuật đầu tiên tác động ngay từ bước khởi tạo. Trước hết, các trọng số không được khởi tạo bằng nhau, chẳng hạn cùng bằng 0: khi đó mọi đơn vị trong một lớp tính cùng một giá trị, nhận cùng một gradient và mãi giống hệt nhau, nên một lớp rộng 128 đơn vị chỉ làm được việc của một đơn vị (CS231n). Khởi tạo ngẫu nhiên phá vỡ sự đối xứng đó, và câu hỏi còn lại là phương sai bao nhiêu. Xét một lớp với . Giả sử các phần tử của độc lập, có trung bình 0 và phương sai , và độc lập với . Khi đó mỗi thành phần của có
Nếu có trung bình 0 thì , và muốn phương sai không đổi qua lớp thì cần . Áp dụng cùng lập luận cho lượt ngược, nơi gradient nhân với , cho điều kiện . Khởi tạo Xavier (Glorot và Bengio, 2010) dung hoà hai điều kiện bằng
Lập luận trên đúng với hàm kích hoạt gần tuyến tính quanh 0 như tanh. Với ReLU thì phải sửa lại: nếu đối xứng quanh 0 thì bằng 0 với một nửa số giá trị, nên
Thay vào công thức trên, phương sai giữ nguyên qua các lớp khi , tức
Đây là khởi tạo He (He và cộng sự, 2015). Hệ số 2 đến trực tiếp từ việc ReLU loại bỏ một nửa phân phối. Với các lớp rộng 128 đơn vị ở Mục 6.3, khởi tạo He lấy , tức độ lệch chuẩn 0,125, còn Xavier lấy , tức độ lệch chuẩn khoảng 0,088, nhỏ hơn lần. Lớp vuông che mất tính chất dung hoà của Xavier; với một lớp có và , điều kiện của lượt xuôi đòi phương sai , tức độ lệch chuẩn 0,044, điều kiện của lượt ngược đòi , tức 0,088, còn Xavier chọn , tức 0,056, nằm giữa hai giá trị đó. Dùng Xavier cho mạng ReLU thì mỗi lớp nhân độ lớn tín hiệu với khoảng , và qua 40 lớp còn . Nguyên tắc chung là khởi tạo phải khớp với hàm kích hoạt: Xavier cho tanh và sigmoid, He cho ReLU và các biến thể gần giống.
6.3Thí nghiệm với mạng 40 lớp#
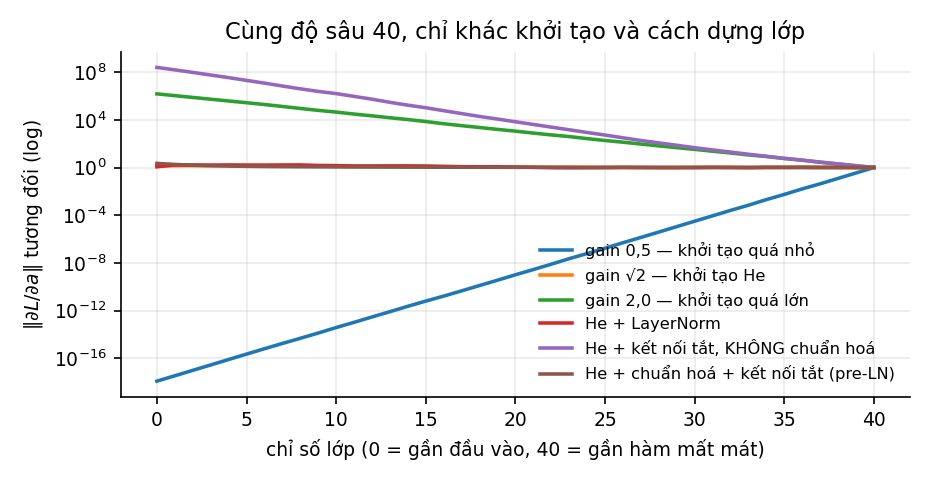
Thí nghiệm trong code/models/experiments.py dùng một mạng 40 lớp, mỗi lớp rộng 128 đơn vị ReLU, với một lô 128 đầu vào ngẫu nhiên. Sau lượt xuôi, một gradient ngẫu nhiên có chuẩn 1 được truyền ngược từ lớp cuối, và thí nghiệm đo chuẩn của gradient theo giá trị kích hoạt tại từng lớp. Kết quả lấy trung bình trên 5 lần khởi tạo và chia cho giá trị ở lớp cuối. Trọng số được khởi tạo với phương sai , nên khởi tạo He ứng với .
Sáu cách dựng lớp được so sánh. Ba cách đầu là mạng thường, mỗi lớp tính , với ba mức gain 0,5, và 2,0. Cách thứ tư thêm LayerNorm trước ReLU: . Cách thứ năm thêm kết nối tắt mà không chuẩn hoá: . Cách thứ sáu dùng cả hai, , với chuẩn hoá nằm trong nhánh còn đường tắt đi thẳng, cùng nguyên tắc với pre-LN của Transformer (Mục 10.2). Ba cách sau đều dùng khởi tạo He.
| Cách dựng lớp | Gradient tại lớp 1 so với lớp 40 | Kết luận |
|---|---|---|
| Khởi tạo với gain 0,5 (quá nhỏ) | tiêu biến | |
| Khởi tạo He, gain | ổn định | |
| Khởi tạo với gain 2,0 (quá lớn) | bùng nổ | |
| He và LayerNorm | ổn định | |
| He và kết nối tắt, không chuẩn hoá | bùng nổ | |
| He, chuẩn hoá trong nhánh và kết nối tắt | ổn định |
Ba dòng đầu cho thấy khởi tạo có ảnh hưởng rất lớn. Trên cùng một kiến trúc, chỉ đổi gain từ 0,5 sang 2,0 làm gradient ở lớp đầu thay đổi từ tới , tức 24 bậc độ lớn. Với gain 0,5, mỗi lớp nhân gradient với khoảng , và . Khởi tạo He thì giữ gradient gần như không đổi, với tỉ lệ 1,42 sau 40 lớp, đúng như lập luận ở Mục 6.2.
Dòng thứ năm là kết quả hay bị hiểu sai nhất: kết nối tắt một mình làm gradient bùng nổ. Với khởi tạo He, nhánh có độ lớn cùng cỡ với , nên mỗi lớp cộng thêm vào tín hiệu một lượng xấp xỉ bằng chính nó, và độ lớn của tín hiệu tăng gần gấp đôi sau mỗi lớp. Ở lượt ngược, Jacobi của mỗi lớp là với có độ lớn cỡ 1, và tích của 40 ma trận như vậy tăng theo cấp số nhân. Vì vậy mạng ResNet luôn có chuẩn hoá đi kèm kết nối tắt.
Dòng cuối cho thấy cách kết hợp đúng: chuẩn hoá trong nhánh kèm đường tắt đi thẳng cho gradient ổn định, với tỉ lệ 2,22. Chuẩn hoá giữ đầu ra của mỗi nhánh ở độ lớn cố định, nên tín hiệu chỉ tăng theo kiểu cộng dồn thay vì nhân lên, còn đường tắt bảo đảm gradient luôn có một đường đi không qua ma trận trọng số nào. Đây là cấu hình mà các Transformer hiện nay dùng (Mục 10.2).
Trang thí nghiệm tương tác của giáo trình cho phép tự chọn gain, số lớp và các thành phần để quan sát các đường trong Hình 7.
Hai bài giảng nổi tiếng quan sát cùng hiện tượng theo hai cách khác, cũng nên dùng khi gỡ lỗi. CS231n vẽ phân phối giá trị kích hoạt ở từng lớp của một mạng 10 lớp tanh: khởi tạo quá nhỏ làm các giá trị co dần về 0 ở các lớp sâu, quá lớn làm chúng dồn về , tức tanh bão hoà, còn Xavier giữ được phân phối qua mọi lớp; chuyển sang ReLU thì Xavier lại làm các giá trị co dần, và phải thêm hệ số 2 của He. Karpathy, trong bài giảng makemore về giá trị kích hoạt và gradient, theo dõi trong khi huấn luyện tỉ lệ đơn vị tanh bão hoà, với , và tỉ số giữa độ lớn của bước cập nhật và độ lớn của tham số ở từng lớp, nên ở quanh như Mục 5.5.
6.4BatchNorm, LayerNorm và RMSNorm#
Kỹ thuật thứ hai là chuẩn hoá. Các lớp chuẩn hoá đưa giá trị kích hoạt về trung bình 0, phương sai 1, rồi nhân với một hệ số và cộng một độ dịch học được, để mạng vẫn biểu diễn được mọi thang đo nếu cần:
Các phương pháp khác nhau ở tập giá trị dùng để tính và , như bảng dưới cho thấy.
| BatchNorm (Ioffe và Szegedy, 2015) | LayerNorm (Ba, Kiros và Hinton, 2016) | |
|---|---|---|
| Tính thống kê trên | mọi mẫu trong lô, riêng cho từng đặc trưng (từng kênh) | mọi đặc trưng của một mẫu, riêng cho từng mẫu |
| Phụ thuộc kích thước lô | có: lô nhỏ cho thống kê nhiễu | không |
| Khác nhau giữa huấn luyện và suy luận | có: suy luận dùng trung bình trượt tích luỹ khi huấn luyện | không |
| Dùng phổ biến trong | mạng tích chập cho ảnh | Transformer, RNN |
Transformer dùng LayerNorm thay cho BatchNorm, và ba hàng đầu của bảng giải thích vì sao. Các chuỗi trong một lô có độ dài khác nhau và được đệm thêm, nên thống kê theo lô trên trục thời gian bị phần đệm làm sai lệch. BatchNorm dùng thống kê của lô khi huấn luyện và trung bình trượt khi suy luận; khi sinh văn bản từng token, mỗi bước chỉ xử lý một vị trí, và khác biệt giữa hai chế độ trở thành một nguồn sai lệch. Ngoài ra, với BatchNorm, dự đoán cho một mẫu phụ thuộc vào các mẫu khác cùng lô, điều không mong muốn khi phục vụ nhiều người dùng cùng lúc.
RMSNorm (Zhang và Sennrich, 2019) đơn giản hoá LayerNorm bằng cách bỏ bước trừ trung bình và độ dịch , chỉ chia cho căn trung bình bình phương:
Với vector , và , LayerNorm trừ trung bình 3, chia cho độ lệch chuẩn , với phương sai tính bằng mẫu số như các thư viện làm, và cho . RMSNorm chỉ chia cho căn trung bình bình phương và cho : các phần tử giữ nguyên dấu và tỉ lệ với nhau, chỉ thang đo thay đổi. Phép tính rẻ hơn LayerNorm, và thực nghiệm cho chất lượng tương đương. RMSNorm là lựa chọn của nhiều mô hình ngôn ngữ hiện nay, như Llama.
Hai chi tiết cài đặt của BatchNorm hay gây nhầm. Hệ số chặn của lớp đứng ngay trước BatchNorm là thừa, vì phép trừ trung bình triệt tiêu nó; độ dịch đã làm việc đó. Còn tham số momentum của BatchNorm trong PyTorch, mặc định 0,1, là trọng số dành cho lô mới khi cập nhật trung bình trượt dùng lúc suy luận, ngược với vai trò của trong momentum ở Mục 5.4.
Vì sao chuẩn hoá giúp huấn luyện vẫn còn được thảo luận. Bài báo gốc của BatchNorm giải thích bằng việc giảm "dịch chuyển hiệp biến nội tại" (internal covariate shift), nhưng Santurkar và cộng sự (2018) cho thấy lợi ích chủ yếu đến từ việc làm hàm mất mát trơn hơn, cho phép dùng tốc độ học lớn hơn. Tác dụng giữ ổn định độ lớn của tín hiệu, đo được ở Mục 6.3, là một phần của lời giải thích đó.
6.5Kết nối tắt#
Kỹ thuật thứ ba thay bằng
trong đó là một khối gồm vài lớp. Có hai cách hiểu bổ sung cho nhau.
Cách hiểu thứ nhất nhìn theo đường đi của gradient. Jacobi của một khối là , và số hạng bảo đảm gradient luôn có một đường đi thẳng từ đầu ra về đầu vào mà không nhân với ma trận trọng số nào. Qua nhiều khối, tích khai triển thành tổng của mọi tích con, trong đó có số hạng , nên không tự co về 0 như .
Cách hiểu thứ hai nhìn theo bài toán cần học. Thay vì học trực tiếp hàm , khối học phần dư . Nếu ánh xạ đồng nhất đã là một xấp xỉ tốt, khối chỉ cần học một hiệu chỉnh nhỏ, và khởi tạo đã là một điểm xuất phát tốt. Đây là lập luận của bài báo ResNet (He và cộng sự, 2016), xuất phát từ vấn đề suy thoái (degradation problem): trên CIFAR-10, mạng thường 56 lớp có sai số huấn luyện cao hơn mạng 20 lớp. Mạng 56 lớp biểu diễn được mọi hàm mà mạng 20 lớp biểu diễn được, chỉ cần 36 lớp thừa là ánh xạ đồng nhất, nên sai số huấn luyện cao hơn không phải do overfitting mà do khó tối ưu. Kết nối tắt làm ánh xạ đồng nhất trở nên dễ biểu diễn, và mạng ResNet với hơn 100 lớp huấn luyện được bình thường. d2l.ai diễn đạt cùng lập luận bằng các họ hàm lồng nhau: nếu khối mới biểu diễn được ánh xạ đồng nhất thì họ hàm của mạng sâu hơn chứa họ hàm của mạng nông hơn, nên thêm khối không thể làm mạng kém đi về mặt biểu diễn.
Một cách khác để giữ độ lớn của tín hiệu trên đường tắt là thu nhỏ các nhánh ngay từ lúc khởi tạo. GPT-2 nhân trọng số ở lối ra của mỗi nhánh dư với , với là số nhánh dư trong mạng (Radford và cộng sự, 2019). Nếu mỗi nhánh đóng góp một lượng có phương sai cỡ , tổng của nhánh cộng dồn có phương sai cỡ 1, thay vì tăng tỉ lệ với độ sâu như dòng thứ năm của bảng ở Mục 6.3.
Lưu ý
Kết nối tắt ra đời để giải quyết vấn đề suy thoái, tức sai số huấn luyện tăng theo độ sâu, không phải để chống overfitting. Và như Mục 6.3 cho thấy, kết nối tắt cần đi kèm chuẩn hoá thì gradient mới ổn định.
6.6Dropout và các phương pháp regularization khác#
Ba kỹ thuật trên giúp huấn luyện được mạng sâu; còn lại là chống overfitting. Phương pháp regularization riêng của mạng nơ-ron được dùng nhiều nhất là dropout (Srivastava và cộng sự, 2014). Khi huấn luyện, mỗi đơn vị bị đặt bằng 0 với xác suất , độc lập ở mỗi bước, và các đơn vị còn lại được chia cho để kỳ vọng của đầu ra không đổi; cách làm này gọi là inverted dropout. Chẳng hạn với , một lớp có đầu ra có thể bị giữ lại phần tử thứ nhất và thứ ba ở một bước, thành sau khi chia cho . Mỗi phần tử được nhân đôi với xác suất 0,5 và bằng 0 với xác suất 0,5, nên kỳ vọng của nó đúng bằng giá trị ban đầu. Các tài liệu dùng hai quy ước cho : PyTorch và d2l.ai dùng xác suất bị bỏ như ở đây, còn CS231n và Andrew Ng dùng xác suất được giữ lại. Khi suy luận, dropout bị tắt và mạng dùng mọi đơn vị. Mỗi bước huấn luyện vì vậy dùng một mạng con khác nhau chia sẻ trọng số, và mạng đầy đủ khi suy luận xấp xỉ trung bình của rất nhiều mạng con. Cơ chế giảm phương sai vì thế tương tự bagging ở Mục 3.3, nhưng không phải huấn luyện nhiều mô hình.
Với mô hình ngôn ngữ lớn, vai trò của dropout giảm nhiều. Khi tiền huấn luyện trên kho dữ liệu cực lớn, mỗi mẫu thường chỉ được xem một lần nên overfitting không phải vấn đề chính, và một số mô hình như PaLM (Chowdhery và cộng sự, 2022) không dùng dropout khi tiền huấn luyện. Dropout vẫn hữu ích khi tinh chỉnh trên tập dữ liệu nhỏ. Bảng dưới đặt dropout cạnh các phương pháp regularization khác.
| Phương pháp | Cơ chế | Dùng ở đâu |
|---|---|---|
| Weight decay | phạt chuẩn của trọng số (Mục 9.2 của Nền tảng); với Adam phải dùng dạng AdamW (Mục 5.4) | hầu hết mọi nơi |
| Dropout | huấn luyện trên các mạng con ngẫu nhiên | MLP, mạng tích chập, tinh chỉnh; ít dùng khi tiền huấn luyện LLM |
| Dừng sớm | dừng khi sai số xác thực ngừng giảm | hầu hết mọi nơi; rẻ nhất |
| Tăng cường dữ liệu | tạo thêm mẫu bằng các biến đổi giữ nguyên nhãn: lật, cắt, xoay ảnh, thêm nhiễu vào âm thanh | ảnh, âm thanh |
| Làm mượt nhãn | thay nhãn one-hot bằng , để mô hình không bị đẩy tới xác suất tuyệt đối 0 và 1 (Szegedy và cộng sự, 2016) | phân loại nhiều lớp |
Weight decay có một cách hiểu từ Nền tảng: regularization tương đương ước lượng MAP với tiên nghiệm Gauss trên trọng số (Chương 10 của Nền tảng). Dừng sớm cũng có liên hệ với regularization: với hồi quy tuyến tính, dừng gradient descent sau bước cho kết quả gần giống hồi quy ridge với tỉ lệ nghịch với . Andrew Ng lưu ý rằng dừng sớm gộp hai việc vốn nên tách riêng, giảm mất mát huấn luyện và chống overfitting, nên khi tài nguyên cho phép thử nhiều giá trị của hệ số regularization, ông thích dùng regularization hơn. Trong thực hành, weight decay thường chỉ áp dụng cho các ma trận trọng số, không áp dụng cho hệ số chặn và tham số của các lớp chuẩn hoá (Karpathy, 2024).
6.7Tóm tắt#
Qua nhiều lớp, gradient bị nhân với tích của các ma trận Jacobi, nên chỉ cần mỗi lớp lệch khỏi hệ số 1 một chút là gradient tiêu biến hoặc bùng nổ. Khởi tạo phải phá vỡ đối xứng giữa các đơn vị và khớp với hàm kích hoạt: Xavier cho tanh, He với phương sai cho ReLU. Chuẩn hoá giữ đầu ra mỗi lớp ở độ lớn cố định; Transformer dùng LayerNorm hoặc RMSNorm thay BatchNorm vì không muốn phụ thuộc vào lô. Kết nối tắt cho gradient một đường đi thẳng và giải quyết vấn đề suy thoái, và GPT-2 còn thu nhỏ các nhánh dư theo lúc khởi tạo; nhưng thí nghiệm với mạng 40 lớp cho thấy kết nối tắt làm gradient bùng nổ tới lần nếu không có chuẩn hoá trong nhánh. Dropout, weight decay và dừng sớm lo phần chống overfitting, dù vai trò của dropout giảm nhiều khi tiền huấn luyện mô hình ngôn ngữ lớn.
Với các kỹ thuật này, ta huấn luyện được mạng hàng trăm lớp. Nhưng mạng kết nối đầy đủ vẫn rất lãng phí khi đầu vào là ảnh: chỉ riêng một lớp nhận ảnh và cho 1 000 đơn vị ẩn đã cần khoảng 150 triệu tham số. Chương 7 trình bày một kiến trúc khai thác cấu trúc không gian của ảnh, nhờ đó số tham số giảm đi hàng nghìn lần.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Hệ số 2 trong khởi tạo He, , đến từ đâu?
Vì sao: Muốn phương sai giữ nguyên qua lớp thì . Với tanh, gần tuyến tính quanh 0, không cần hệ số này và dùng khởi tạo Xavier (Mục 6.2).2Trong thí nghiệm ở Mục 6.3, kết nối tắt không kèm chuẩn hoá cho kết quả gì trên mạng 40 lớp?
Vì sao: Mỗi lớp cộng thêm vào tín hiệu một lượng cùng cỡ, nên độ lớn tăng theo cấp số nhân. Kết hợp kết nối tắt với chuẩn hoá trong nhánh cho tỉ lệ 2,22, là cấu hình giống pre-LN.3Vì sao Transformer dùng LayerNorm thay cho BatchNorm?
Vì sao: LayerNorm tính thống kê trên các đặc trưng của từng mẫu nên không có ba vấn đề trên (Mục 6.4).4Kết nối tắt trong ResNet được đề xuất để giải quyết vấn đề gì?
Vì sao: Bằng chứng là sai số huấn luyện, không phải sai số xác thực, tăng theo độ sâu, dù mạng sâu hơn biểu diễn được mọi hàm của mạng nông hơn. Đây là vấn đề tối ưu (Mục 6.5).5RMSNorm khác LayerNorm ở điểm nào?
Vì sao: RMSNorm rẻ hơn và cho chất lượng tương đương, nên được Llama và nhiều mô hình ngôn ngữ khác dùng.
Đã trả lời 0/5