Học sâu và các kiến trúc mô hình
Toàn bộ giáo trình trên một trang — tiện cho Ctrl+F, đọc ngoại tuyến hoặc in ra giấy.
Giáo trình 2 của lộ trình
Giáo trình Nền tảng dừng ở các mô hình tuyến tính, SVM và các phương pháp không giám sát cổ điển. Giáo trình này đi tiếp từ chỗ đó theo một mạch: so sánh các họ mô hình qua giả định của chúng, dùng phân rã độ chệch – phương sai để hiểu vì sao kết hợp nhiều cây lại tốt hơn một cây, rồi chuyển sang mạng nơ-ron, cách huấn luyện chúng khi chúng sâu, các kiến trúc cho ảnh và cho chuỗi, và cuối cùng là Transformer cùng các thành phần của mô hình ngôn ngữ lớn hiện nay.
Kiến thức cần có. Đại số tuyến tính, xác suất, gradient descent và hồi quy logistic ở mức của Nền tảng. Chỗ nào dùng lại kiến thức cũ đều có liên kết tới đúng mục.
Về số liệu. Giáo trình có hai loại con số. Loại thứ nhất trích từ bài báo gốc, mỗi lần dùng đều ghi nguồn, và danh sách nguồn nằm ở Chương 15. Loại thứ hai được đo trong chính repo này bằng các script trong
code/models/với hạt giống cố định, nên chạy lại cho kết quả giống hệt. Một số kết quả là phép đối chiếu với con số đã công bố, như số tham số của GPT-2 và Llama 2, và các phép đối chiếu đó khớp chính xác.
0Ký hiệu và quy ước#
Giáo trình dùng lại ký hiệu và quy ước thuật ngữ của Nền tảng (Chương 0 của Nền tảng), và bổ sung các ký hiệu riêng cho mạng nơ-ron và Transformer.
0.1Bảng ký hiệu#
| Ký hiệu | Ý nghĩa |
|---|---|
| một điểm dữ liệu đầu vào có đặc trưng | |
| ma trận dữ liệu gồm điểm | |
| , | nhãn thật và giá trị dự đoán |
| , | ma trận trọng số và vector hệ số chặn của một lớp |
| , | đầu ra của lớp ẩn thứ ; trạng thái ẩn của RNN tại bước |
| , | hàm kích hoạt nói chung; hàm sigmoid |
| hàm mất mát | |
| tốc độ học (learning rate) | |
| kích thước lô (batch size) | |
| độ dài chuỗi: số token hoặc số bước thời gian | |
| hay | số chiều biểu diễn của Transformer |
| số đầu attention | |
| số chiều của mỗi đầu | |
| số chiều lớp ẩn của khối FFN | |
| số lớp của mạng; với Transformer là số khối | |
| kích thước từ vựng; trong công thức attention là ma trận giá trị (value) | |
| số tham số của mô hình (không tính embedding, trừ khi ghi rõ) | |
| số token dữ liệu huấn luyện |
Giáo trình Nền tảng viết hàm mất mát là , vì ở đó chưa có mạng nhiều lớp. Từ giáo trình này, chữ được dành cho số lớp, xuất hiện từ định nghĩa mạng nhiều lớp ở Chương 4 tới phép đếm tham số ở Chương 12, nên hàm mất mát viết là . Chữ chỉ vector ẩn khi nói về mạng nhiều lớp, mạng hồi quy và kết nối tắt (Chương 4 tới 8), và chỉ số đầu attention trong các chương về Transformer (Chương 9 tới 12).
0.2Quy ước thuật ngữ#
Giống Nền tảng, giáo trình dùng thuật ngữ theo cách phổ biến trong cộng đồng học máy tiếng Việt, có tham khảo bản dịch tiếng Việt các cheatsheet CS229 và CS230 của Đại học Stanford. Bảng dưới ghi các thuật ngữ mới xuất hiện trong giáo trình này.
| Tiếng Anh | Dùng trong giáo trình |
|---|---|
| bias (của một ước lượng) | độ chệch |
| bias (tham số của một lớp) | hệ số chặn (bias) |
| inductive bias | thiên kiến quy nạp (inductive bias) |
| layer, hidden layer | lớp, lớp ẩn |
| activation function | hàm kích hoạt |
| forward / backward pass | lượt xuôi / lượt ngược |
| backpropagation | lan truyền ngược |
| weight decay | weight decay (suy giảm trọng số) |
| residual / skip connection | kết nối tắt |
| convolution, filter, stride, padding, pooling | tích chập, bộ lọc, bước nhảy (stride), phần đệm (padding), gộp (pooling) |
| receptive field | trường tiếp nhận |
| recurrent neural network | mạng nơ-ron hồi quy (RNN) |
| gate, forget gate, cell state | cổng, cổng quên, trạng thái ô nhớ |
| query, key, value | truy vấn, khoá, giá trị (query, key, value) |
| head, mask | đầu, mặt nạ |
| decoding, beam search, temperature | giải mã, beam search, nhiệt độ |
| ensemble | phương pháp tập hợp (ensemble) |
| bagging, boosting, dropout, embedding, softmax, attention | giữ nguyên tiếng Anh |
Chữ bias có ba nghĩa trong giáo trình, và mỗi nghĩa có một tên riêng. Độ chệch là sai lệch có hệ thống của một ước lượng, như trong "ước lượng không chệch". Hệ số chặn là tham số cộng thêm trong . Thiên kiến quy nạp là tập các giả định mà một thuật toán học dùng để chọn giữa các hàm cùng khớp dữ liệu (Mục 1.4).
0.3Quy ước về chiều#
Trong công thức, là vector cột và một lớp viết là với . Trong mã, dữ liệu xếp theo hàng nên cả lô viết là X @ W + b với W.shape == (d_in, d_out). Hai cách viết chỉ khác nhau một phép chuyển vị. Phần chữ dùng dấu phẩy thập phân (0,15); phần mã và kết quả in ra từ script giữ dấu chấm (0.15).
1Các họ mô hình#
Ở giáo trình Nền tảng, mỗi chương giới thiệu một mô hình: hồi quy tuyến tính, hồi quy logistic, SVM, k láng giềng gần nhất. Khi đứng trước một bài toán mới, câu hỏi thực tế lại khác: nên dùng mô hình nào? Câu trả lời hay nghe là "thử vài mô hình rồi chọn cái tốt nhất". Lời khuyên đó không sai, nhưng có thể đoán trước khá nhiều điều nếu biết mỗi họ mô hình giả định gì về hàm cần học. Chẳng hạn, cây tăng cường gradient vẫn thường thắng mạng nơ-ron trên dữ liệu dạng bảng, trong khi mạng tích chập và Transformer vượt xa mọi thứ khác trên ảnh và văn bản; cả hai sự kiện đều giải thích được bằng giả định của mô hình. Ta bắt đầu bằng việc dựng một khung để so sánh các họ mô hình theo cách đó.
1.1Các câu hỏi khi thiết kế một mô hình#
Mọi thuật toán học có giám sát đều phải trả lời cùng một nhóm câu hỏi, và mỗi thuật toán là một cách trả lời cụ thể. Câu hỏi đầu tiên là xét họ hàm nào: hàm tuyến tính của đặc trưng, hàm hằng trên từng vùng hình hộp, hay hợp của nhiều phép biến đổi. Đây chính là thành phần "mô hình" trong ba thành phần của một thuật toán học (Mục 1.1 của Nền tảng). Câu hỏi thứ hai là đo mức tốt của một hàm bằng gì, tức hàm mất mát, thành phần thứ hai trong ba thành phần đó; Domingos (2012) tóm gọn cả ba thành công thức học = biểu diễn + đánh giá + tối ưu. Câu hỏi thứ ba là số tham số được cố định trước hay tăng theo dữ liệu. Hồi quy tuyến tính có tham số dù có bao nhiêu dữ liệu, còn cây quyết định có thể mọc thêm nút khi có thêm dữ liệu; những mô hình như cây được gọi là phi tham số (nonparametric). Tên gọi này dễ gây hiểu nhầm: chúng vẫn có tham số, chỉ là số tham số tăng theo dữ liệu, và một cây bị giới hạn độ sâu, như cây một lần chia ở Mục 1.4, lại là mô hình có tham số.
Câu hỏi thứ tư là tìm tham số bằng cách nào: bằng nghiệm dạng đóng như hồi quy tuyến tính, giải bài toán tối ưu lồi như hồi quy logistic và SVM, tìm kiếm tham lam như cây quyết định, hay chạy gradient descent trên một hàm không lồi như mạng nơ-ron. Câu hỏi cuối cùng là kiểm soát overfitting bằng cách nào: phạt chuẩn của trọng số, giới hạn độ sâu của cây, lấy trung bình nhiều mô hình, hay dừng sớm quá trình tối ưu.
Trả lời được năm câu hỏi này cho một mô hình là nắm được những đặc điểm quan trọng nhất của nó: nó biểu diễn được gì, cần bao nhiêu dữ liệu, huấn luyện tốn kém thế nào và dễ hỏng ở đâu. Hình 1 xếp bốn họ mô hình lớn theo mức độ giả định của chúng.
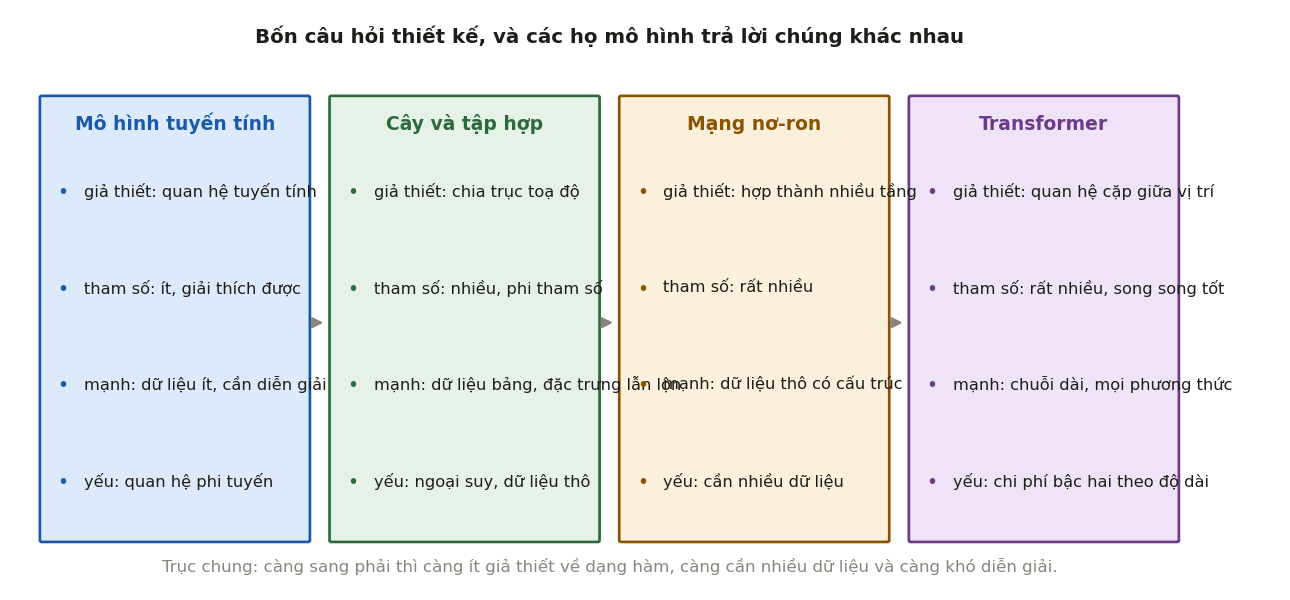
1.2So sánh các họ mô hình#
Bảng dưới trả lời các câu hỏi ở Mục 1.1 cho bốn họ mô hình, kèm trường hợp phù hợp và hạn chế của mỗi họ. Bảng không có dòng cho hàm mất mát, vì lựa chọn đó phụ thuộc vào bài toán, hồi quy hay phân loại, nhiều hơn vào họ mô hình.
| Mô hình tuyến tính | Cây và phương pháp tập hợp | Mạng nơ-ron nhiều lớp | Transformer | |
|---|---|---|---|---|
| Giả định về dạng hàm | tổ hợp tuyến tính của các đặc trưng | hằng số trên các hình hộp có cạnh song song với trục | hợp của nhiều phép biến đổi affine xen với hàm phi tuyến | như mạng nơ-ron, thêm cơ chế kết hợp thông tin giữa mọi cặp vị trí |
| Số tham số | , cố định | tăng theo dữ liệu nếu không giới hạn độ sâu | rất nhiều, cố định trước | rất nhiều, cố định trước |
| Cách tối ưu | nghiệm dạng đóng hoặc tối ưu lồi | tham lam theo từng lần chia | gradient descent và lan truyền ngược | như mạng nơ-ron |
| Kiểm soát overfitting | regularization , | giới hạn độ sâu, cắt tỉa, lấy trung bình | dừng sớm, weight decay, dropout, tăng cường dữ liệu | như mạng nơ-ron |
| Phù hợp khi | ít dữ liệu, cần diễn giải, quan hệ gần tuyến tính | dữ liệu dạng bảng, đặc trưng lẫn số và hạng mục | dữ liệu thô có cấu trúc: ảnh, âm thanh | chuỗi dài, văn bản, và ngày càng nhiều loại dữ liệu khác |
| Hạn chế | không biểu diễn được quan hệ phi tuyến nếu không tự tạo đặc trưng | không ngoại suy được; kém với dữ liệu thô | cần nhiều dữ liệu; kém với dữ liệu bảng thuần | chi phí tăng theo bình phương độ dài chuỗi |
Bảng này giải thích được một kết quả thực nghiệm mà người mới thường ngạc nhiên: trên dữ liệu dạng bảng, các mô hình dựa trên cây, nhất là gradient boosting, vẫn thường cho kết quả bằng hoặc tốt hơn mạng nơ-ron sâu, với chi phí thấp hơn nhiều. Grinsztajn, Oyallon và Varoquaux (2022) so sánh trên 45 bộ dữ liệu dạng bảng cỡ vừa, khoảng 10 nghìn mẫu huấn luyện mỗi bộ, sau khi tinh chỉnh kỹ siêu tham số cho mọi mô hình, và chỉ ra ba nguyên nhân. Dữ liệu bảng thường có nhiều đặc trưng không liên quan. Hàm cần học thường không trơn mà có những bước nhảy theo ngưỡng. Và mỗi cột có ý nghĩa riêng, nên một phép quay không gian đặc trưng làm mất thông tin. Cả ba đặc điểm này hợp với cách chia theo từng trục của cây, và không hợp với phép biến đổi affine của mạng nơ-ron. Kết luận đúng trong phạm vi đó chứ không phải một quy luật chung: McElfresh và cộng sự (2023) so sánh trên 176 bộ dữ liệu và thấy rằng trên nhiều bộ, chênh lệch giữa hai họ không đáng kể, còn tinh chỉnh nhẹ siêu tham số của gradient boosting quan trọng hơn việc chọn giữa mạng nơ-ron và cây.
1.3Các yếu tố quyết định kết quả#
Họ mô hình không phải yếu tố duy nhất, và thường cũng không phải yếu tố quan trọng nhất. Với cùng một bài toán, kinh nghiệm thực tế cho thấy thứ tự ảnh hưởng tới kết quả thường là
Đây là quy tắc kinh nghiệm, không phải định lý, và có ngoại lệ: với ảnh và văn bản, chọn đúng họ mô hình như mạng tích chập hay Transformer quan trọng hơn nhiều so với tự thiết kế đặc trưng. Nhưng quy tắc này nhắc một điều hay bị quên: nhãn sai, hoặc dữ liệu không đại diện cho tình huống sử dụng thật, là những lỗi mà không mô hình nào sửa được. Giáo trình này tập trung vào ba mức sau; hai mức đầu được bàn trong MLOps.
Với một dự án cụ thể, không cần dựa vào thứ tự chung này, vì có thể đo được thành phần nào đáng cải thiện nhất. Andrew Ng thường dạy hai phép đo cho việc đó trong phần hướng dẫn áp dụng học máy của khoá CS229. Phân tích lỗi (error analysis) lần lượt thay đầu ra của từng bước trong hệ thống bằng kết quả đúng, rồi xem độ chính xác cuối cùng tăng bao nhiêu. Chẳng hạn một hệ thống đọc hoá đơn gồm ba bước, tìm vùng chữ, nhận dạng chữ và trích các trường thông tin, đạt độ chính xác 85%. Thay bước tìm vùng chữ bằng vùng đúng chỉ đưa con số lên 86%, còn thay thêm bước nhận dạng chữ bằng chữ đúng đưa lên 97%, nên bước nhận dạng chữ là chỗ đáng đầu tư trước. Phân tích loại bỏ (ablation) đi theo chiều ngược lại: bỏ lần lượt từng thành phần khỏi hệ thống hoàn chỉnh rồi đo mức giảm, để biết thành phần nào thật sự đóng góp.
1.4Thiên kiến quy nạp#
Một tập dữ liệu hữu hạn luôn khớp được với vô số hàm khác nhau. Qua 10 điểm dữ liệu có vô số đường cong đi qua chính xác mọi điểm, và chúng dự đoán rất khác nhau ở những điểm chưa thấy. Muốn dự đoán được, thuật toán học phải ưu tiên một số hàm hơn các hàm khác, bằng những giả định không đến từ dữ liệu.
Định nghĩa 1.1 (Thiên kiến quy nạp)
Thiên kiến quy nạp (inductive bias) của một thuật toán học là tập các giả định nó dùng để chọn giữa các hàm cùng khớp dữ liệu huấn luyện, và do đó quyết định cách nó dự đoán cho các điểm chưa thấy.
Mỗi họ mô hình có một thiên kiến quy nạp riêng. Hồi quy tuyến tính giả định quan hệ tuyến tính. Regularization ưu tiên trọng số nhỏ (Mục 9.2 của Nền tảng). k láng giềng gần nhất giả định các điểm gần nhau có nhãn giống nhau. Mạng tích chập giả định đặc trưng có tính cục bộ và giống nhau ở mọi vị trí trong ảnh (Mục 7.1). Transformer giả định rất ít, và vì thế cần rất nhiều dữ liệu.
Bốn căn hộ ở Chương 4 của Nền tảng, rộng 40, 60, 80, 100 m² với giá 1,5; 2,1; 2,4; 3,0 tỉ đồng, cho thấy thiên kiến quy nạp quyết định dự đoán ra sao. Ba mô hình học từ cùng bốn điểm này. Hồi quy tuyến tính cho đường . Cây quyết định một lần chia cắt ở 70 m², dự đoán 1,8 tỉ cho mọi căn nhỏ hơn và 2,7 tỉ cho mọi căn lớn hơn. Còn 1 láng giềng gần nhất lấy giá của căn gần nhất. Với căn 120 m², ba mô hình dự đoán lần lượt 3,45; 2,7 và 3,0 tỉ. Cả ba đều khớp bốn căn hộ ở mức chấp nhận được, nhưng khác nhau ở giả định: hồi quy tuyến tính giả định giá tăng đều theo diện tích nên ngoại suy theo đường thẳng, cây giả định giá là hằng số trên từng khoảng nên mọi dự đoán của nó nằm trong khoảng giá đã thấy, còn 1 láng giềng gần nhất giả định một căn hộ đáng giá như căn giống nó nhất đã thấy. Dữ liệu không cho biết giả định nào đúng.
Không có thiên kiến quy nạp nào tốt nhất cho mọi bài toán. Định lý "không có bữa trưa miễn phí" (no free lunch; Wolpert, 1996) phát biểu chặt chẽ điều này: lấy trung bình trên mọi bài toán có thể, mọi thuật toán học có cùng sai số trên các điểm ngoài tập huấn luyện. Một thuật toán chỉ tốt hơn thuật toán khác trên những bài toán mà giả định của nó phù hợp. Vì vậy câu hỏi "mô hình nào tốt nhất" không có câu trả lời chung; câu hỏi đúng là giả định của mô hình nào khớp với cấu trúc của dữ liệu đang có.
Lượng dữ liệu cũng quyết định giả định nào có lợi. Domingos (2012) dẫn một thí nghiệm trong đó dữ liệu được sinh từ một tập luật, vậy mà Naive Bayes, với giả định độc lập vốn sai với dữ liệu đó, vẫn thắng một thuật toán học luật cho tới khoảng 1 000 mẫu: khi dữ liệu còn ít, một giả định mạnh mà sai có thể tốt hơn một giả định yếu mà đúng. Andrew Ng minh hoạ chiều còn lại bằng đồ thị hiệu năng theo lượng dữ liệu có nhãn trong khoá Deep Learning Specialization. Các mô hình như hồi quy logistic chững lại khi dữ liệu tăng, còn mạng nơ-ron càng lớn càng tiếp tục cải thiện. Ở vùng ít dữ liệu, thứ tự giữa các thuật toán không rõ ràng, và cách thiết kế đặc trưng quyết định nhiều hơn.
1.5Tóm tắt#
Mỗi họ mô hình là một cách trả lời năm câu hỏi: xét họ hàm nào, đo mức tốt bằng hàm mất mát nào, số tham số cố định hay tăng theo dữ liệu, tìm tham số bằng cách nào, và kiểm soát overfitting ra sao. Các câu trả lời đó quy về thiên kiến quy nạp của mô hình, tức những giả định nó dùng để chọn giữa các hàm cùng khớp dữ liệu; từ cùng bốn căn hộ, hồi quy tuyến tính, cây một lần chia và 1 láng giềng gần nhất định giá căn 120 m² là 3,45; 2,7 và 3,0 tỉ. Không có thiên kiến nào tốt nhất cho mọi bài toán: cây hợp với dữ liệu bảng vì nó chia theo từng trục, còn mạng tích chập và Transformer hợp với ảnh và văn bản vì giả định của chúng khớp với cấu trúc của các loại dữ liệu đó. Khi dữ liệu ít, giả định mạnh có lợi kể cả khi nó sai; khi dữ liệu nhiều, mô hình ít giả định như mạng nơ-ron lớn tiếp tục cải thiện. Dù vậy, dữ liệu và nhãn thường ảnh hưởng tới kết quả nhiều hơn việc chọn mô hình, và trong một dự án cụ thể, phân tích lỗi cho biết thành phần nào đáng cải thiện nhất.
Giả định càng mạnh thì họ hàm càng hẹp. Nếu giả định đúng, mô hình học được từ ít dữ liệu; nếu sai, nó mắc một sai số có hệ thống mà thêm dữ liệu cũng không sửa được. Chương 2 đặt tên cho loại sai số này và loại sai số đối lập với nó, rồi đo cả hai.
2Độ chệch và phương sai#
Mục 3.6 của Nền tảng đã tách sai số của một ước lượng thành độ chệch và phương sai. Ở đây ta áp dụng cùng phép tách cho dự đoán của cả một mô hình học máy, rồi đo từng thành phần bằng mô phỏng. Phép tách này có giá trị thực tế rất rõ: biết sai số chủ yếu đến từ độ chệch hay từ phương sai thì biết nên đổi mô hình hay nên thu thêm dữ liệu, hai hướng đi tốn kém theo những cách rất khác nhau.
2.1Vai trò của phân rã độ chệch – phương sai#
Nhiều quyết định trong các chương sau thực chất là điều chỉnh độ linh hoạt của mô hình: thêm hay bớt lớp, regularization mạnh hay nhẹ, cây sâu hay nông, lấy trung bình bao nhiêu mô hình. Mỗi quyết định như vậy làm hai loại sai số thay đổi theo hai chiều ngược nhau. Phân rã độ chệch – phương sai cho biết chính xác hai loại sai số đó là gì, và vì sao tổng của chúng thường nhỏ nhất ở một mức linh hoạt vừa phải.
2.2Phân rã sai số dự đoán#
Giả sử dữ liệu sinh từ mô hình , trong đó là hàm thật, là nhiễu có , và độc lập với . Một thuật toán học nhận tập huấn luyện và trả về hàm dự đoán . Vì là ngẫu nhiên, giá trị dự đoán tại một điểm cố định cũng là một biến ngẫu nhiên.
Trước khi phát biểu định lý, hai loại sai số nói ở Mục 2.1 có thể thấy ngay trên bốn căn hộ ở Mục 1.4. Bài giảng CS229 cũng đi theo thứ tự đó: độ chệch được hiểu trước hết là sai số vẫn còn kể cả khi có vô hạn dữ liệu, phương sai là mức mô hình thay đổi giữa các tập huấn luyện, và phép phân rã chặt chẽ đến sau. Giả sử giá thật là cộng nhiễu có phương sai ở mỗi căn, và ta dự đoán giá căn 120 m², nơi . Ba mô hình dưới đây đều cho dự đoán là một tổ hợp tuyến tính của bốn mức giá quan sát được, với các hệ số chỉ phụ thuộc vào diện tích. Nhiễu ở bốn căn độc lập, nên phương sai của dự đoán là .
| Mô hình | Hệ số tại 120 m² | Độ chệch | Phương sai |
|---|---|---|---|
| Hằng số: trung bình bốn giá | 0,25 cho mỗi căn | ||
| Đường thẳng | 0 | ||
| Đa thức bậc ba qua bốn điểm | 0 |
Mô hình hằng số có phương sai nhỏ nhất nhưng kỳ vọng của nó là , lệch 1,2 tỉ so với giá thật 3,45 tỉ. Đường thẳng và đa thức bậc ba đều không chệch, vì hàm thật là một đường thẳng, nhưng phương sai của đa thức gấp 46 lần đường thẳng: hệ số của căn 80 m² nghĩa là nhiễu ở căn đó bị khuếch đại sáu lần khi ngoại suy ra 120 m². Với , ước lượng ở Mục 10.2 của Nền tảng, phần sai số ngoài nhiễu là 1,442 cho mô hình hằng số, 0,0135 cho đường thẳng và 0,621 cho đa thức bậc ba.
Con số cần được đọc đúng. Tại chính bốn diện tích đã thấy, phương sai trung bình của ba mô hình chỉ là , và , bằng số tham số chia cho số điểm (Hastie, Tibshirani và Friedman, 2009). Phương sai của đa thức bậc ba lên tới chủ yếu vì 120 m² nằm ngoài khoảng dữ liệu, nơi nó phải ngoại suy: độ linh hoạt khuếch đại nhiễu mạnh nhất ở những chỗ dữ liệu không ràng buộc được mô hình. Định lý sau cho thấy độ chệch bình phương, phương sai và nhiễu cộng lại đúng bằng sai số kỳ vọng tại một điểm.
Định lý 2.1 (Phân rã độ chệch – phương sai)
Tại một điểm , với là một quan sát mới độc lập với tập huấn luyện, sai số bình phương kỳ vọng tách thành ba phần:
trong đó kỳ vọng và phương sai lấy theo phân phối của tập huấn luyện và của nhiễu .
Chứng minh
Viết gọn , và . Ta có . Bình phương và lấy kỳ vọng: số hạng chéo bằng 0 vì độc lập với và có kỳ vọng 0, còn . Phần còn lại được tách giống Định lý 3.2 của Nền tảng: viết , số hạng chéo bằng 0, còn lại .
Ba thành phần có ý nghĩa khác nhau. Độ chệch đo sai lệch có hệ thống: lấy trung bình trên rất nhiều tập huấn luyện, mô hình vẫn dự đoán lệch khỏi giá trị thật, vì họ hàm quá hẹp so với hàm thật. Độ chệch cao ứng với underfitting. Phương sai đo mức dao động: đổi tập huấn luyện thì dự đoán thay đổi nhiều, vì mô hình đủ linh hoạt để khớp cả phần nhiễu riêng của từng tập. Phương sai cao ứng với overfitting. Còn nhiễu không phụ thuộc vào mô hình; nó là cận dưới của sai số mà không mô hình nào vượt qua được.
Lưu ý
Độ chệch và phương sai được định nghĩa qua kỳ vọng trên các tập huấn luyện có thể rút ra, tại một điểm cố định. Chúng không đo mức dao động của dự đoán giữa các điểm dữ liệu khác nhau. Một mô hình có dự đoán thay đổi mạnh theo vẫn có thể có phương sai thấp, nếu huấn luyện trên tập dữ liệu khác thì nó cho gần như cùng một hàm.
Lưu ý
Phân rã trên chỉ đúng với mất mát bình phương. Với mất mát 0–1 của bài toán phân loại, chưa có một phân rã được chấp nhận chung, và trực giác từ hồi quy có thể sai. Nếu xác suất thật của lớp dương tại một điểm là 0,9 mà mô hình luôn ước lượng 0,6, độ chệch bình phương của ước lượng xác suất là 0,09, nhưng mô hình vẫn chọn đúng lớp dương, nên sai số 0–1 không tăng chút nào so với một mô hình biết xác suất thật (Hastie, Tibshirani và Friedman, 2009).
Ba mô hình này là một trường hợp của quy luật chung. Khi tăng độ linh hoạt của mô hình, độ chệch thường giảm vì họ hàm rộng hơn, còn phương sai thường tăng vì có nhiều cách hơn để khớp theo nhiễu. Tổng của chúng vì vậy thường có dạng chữ U theo độ linh hoạt. Chữ "thường" ở đây là cần thiết: định lý chỉ khẳng định phép tách, không khẳng định hai thành phần thay đổi đơn điệu, và Mục 2.3 sẽ cho thấy những trường hợp ngoại lệ. Chữ "đánh đổi" cũng không có nghĩa là giảm thành phần này buộc phải tăng thành phần kia: độ chệch và phương sai có thể cùng cao, và với mạng nơ-ron, tăng kích thước mạng đi kèm regularization thích hợp thường giảm được độ chệch mà không làm tăng phương sai, điều Andrew Ng nhấn mạnh trong khoá Deep Learning Specialization.
2.3Đo độ chệch và phương sai bằng mô phỏng#
Với dữ liệu mô phỏng, hàm thật đã biết, nên có thể đo trực tiếp cả ba thành phần: sinh nhiều tập huấn luyện độc lập, huấn luyện một mô hình trên mỗi tập, rồi tính trung bình và phương sai của các dự đoán tại từng điểm.
Thí nghiệm trong code/models/experiments.py dùng hàm thật trên đoạn và nhiễu Gauss có độ lệch chuẩn , tức . Mỗi tập huấn luyện gồm 40 điểm có rút đều trên đoạn. Với mỗi bậc đa thức từ 1 tới 14, thí nghiệm khớp đa thức trên 250 tập huấn luyện độc lập, rồi tính độ chệch² và phương sai tại 200 điểm cách đều và lấy trung bình theo các điểm.
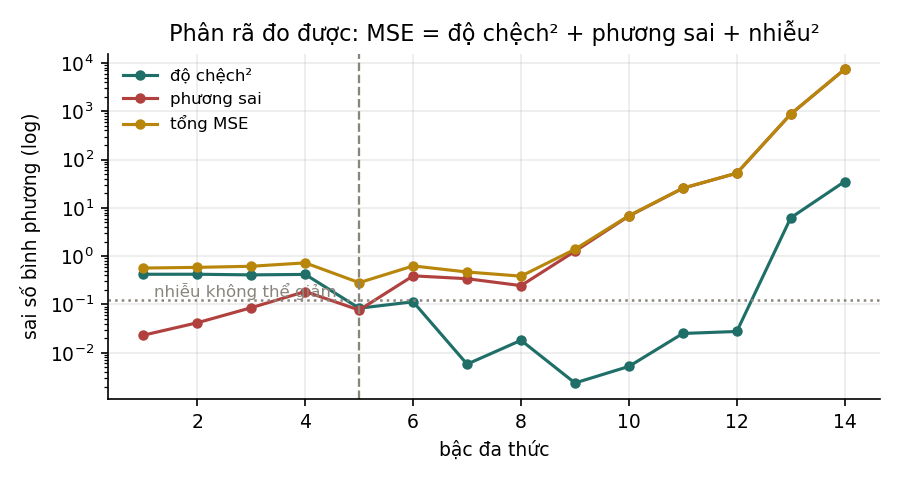
| Bậc đa thức | Độ chệch² | Phương sai | Nhiễu | Tổng sai số |
|---|---|---|---|---|
| 1 | 0,4221 | 0,0231 | 0,1225 | 0,5677 |
| 2 | 0,4223 | 0,0418 | 0,1225 | 0,5866 |
| 3 | 0,4098 | 0,0857 | 0,1225 | 0,6180 |
| 4 | 0,4191 | 0,1852 | 0,1225 | 0,7268 |
| 5 | 0,0836 | 0,0767 | 0,1225 | 0,2828 |
| 7 | 0,0058 | 0,3415 | 0,1225 | 0,4699 |
| 9 | 0,0024 | 1,2645 | 0,1225 | 1,3894 |
| 12 | 0,0276 | 52,2156 | 0,1225 | 52,3657 |
| 14 | 35,1402 | 7 392,2751 | 0,1225 | 7 427,5379 |
Ta đọc bảng từ trên xuống. Ở bậc thấp, sai số đến từ độ chệch: với bậc 1, độ chệch² bằng 0,4221, chiếm 74% tổng sai số. Một đường thẳng không thể theo được hình sin dù có bao nhiêu dữ liệu, nên thu thêm dữ liệu không giúp gì; phải dùng họ hàm linh hoạt hơn.
Bảng còn cho thấy một chi tiết bất ngờ: tăng lên bậc chẵn gần như không làm giảm độ chệch. Độ chệch² ở bậc 2 bằng bậc 1 (0,4223 so với 0,4221), ở bậc 4 xấp xỉ bậc 3 (0,4191 so với 0,4098). Lý do là hàm thật là hàm lẻ, , còn dữ liệu rải đối xứng quanh 0, nên các số hạng bậc chẵn không giúp xấp xỉ tốt hơn; chúng chỉ thêm tham số để khớp nhiễu, nên phương sai tăng. Đây là một ví dụ cụ thể cho điều Mục 2.2 đã lưu ý: độ chệch không nhất thiết giảm đều khi mô hình phức tạp hơn, mà chỉ giảm khi họ hàm mở rộng theo hướng có ích cho việc xấp xỉ hàm thật.
Tổng sai số nhỏ nhất ở bậc 5, nơi độ chệch² 0,0836 và phương sai 0,0767 gần bằng nhau. Tổng 0,2828 vẫn cao hơn mức nhiễu 0,1225, và phần chênh này là sai số không tránh được khi chỉ có 40 điểm dữ liệu.
Từ bậc 7 trở đi, sai số đến từ phương sai. Ở bậc 12, phương sai bằng 52,2, gấp khoảng 1 900 lần độ chệch². Đa thức bậc cao dao động rất mạnh ở hai đầu đoạn, nơi có ít điểm dữ liệu, và mỗi tập huấn luyện cho một kiểu dao động khác nhau. Khác với độ chệch, phương sai giảm khi có thêm dữ liệu, nên với mô hình này thu thêm dữ liệu là cách sửa đúng.
Dòng cuối của bảng cần đọc thận trọng. Độ chệch² đo được ở bậc 13 (dòng này không có trong bảng) và bậc 14 tăng vọt lên 6,2 và 35,1, nhưng đó không phải độ chệch thật. Trung bình của 250 dự đoán có sai số ngẫu nhiên, và bình phương của sai số đó cộng thêm vào độ chệch² ước lượng một lượng cỡ , bằng khoảng 3,5 ở bậc 13 và 29,6 ở bậc 14. Khi phương sai lớn tới mức này, cần nhiều tập huấn luyện hơn hẳn mới ước lượng được độ chệch; kết luận chắc chắn duy nhất là phương sai chi phối.
Giá trị thực tế của phép phân rã nằm ở chỗ nó phân biệt hai tình huống cần xử lý ngược nhau. Độ chệch cao cần mô hình linh hoạt hơn, thêm đặc trưng hoặc giảm regularization, và thu thêm dữ liệu gần như vô ích. Phương sai cao thì cần thêm dữ liệu, tăng regularization hoặc dùng mô hình đơn giản hơn. Chẩn đoán sai có thể dẫn tới việc tốn nhiều tuần thu thập dữ liệu cho một mô hình mà dữ liệu không cứu được.
2.4Chẩn đoán bằng đường cong học#
Với dữ liệu thật, hàm không biết trước và không thể rút lại hàng trăm tập huấn luyện, nên không đo trực tiếp được độ chệch và phương sai. Công cụ thay thế là đường cong học (learning curve): đồ thị sai số trên tập huấn luyện và sai số trên tập xác thực theo số điểm dữ liệu huấn luyện, hoặc theo số vòng huấn luyện. Bảng dưới tóm tắt cách đọc các dấu hiệu thường gặp.
| Dấu hiệu | Chẩn đoán | Hướng xử lý |
|---|---|---|
| Sai số huấn luyện cao, sai số xác thực cao, hai đường sát nhau và đã nằm ngang | độ chệch cao (underfitting) | mô hình linh hoạt hơn, thêm đặc trưng, giảm regularization, huấn luyện lâu hơn |
| Sai số huấn luyện thấp, sai số xác thực cao, khoảng cách lớn và chưa thu hẹp | phương sai cao (overfitting) | thêm dữ liệu, tăng regularization, tăng cường dữ liệu, mô hình đơn giản hơn, dừng sớm |
| Cả hai đều cao và vẫn đang giảm theo số vòng huấn luyện | huấn luyện chưa xong | huấn luyện tiếp |
| Sai số xác thực thấp hơn sai số huấn luyện | thường là dấu hiệu có lỗi | kiểm tra rò rỉ dữ liệu; kiểm tra dropout hoặc tăng cường dữ liệu chỉ bật khi huấn luyện |
Dòng cuối cần chú ý vì nó trông như tin tốt. Tình huống vô hại duy nhất là khi dropout hoặc tăng cường dữ liệu chỉ bật lúc huấn luyện, vì khi đó sai số huấn luyện được đo trên một bài toán khó hơn bài toán lúc xác thực. Trong các trường hợp còn lại, nguyên nhân thường là rò rỉ dữ liệu (Mục 8.5 của Nền tảng), chẳng hạn tập xác thực chứa bản sao gần giống của dữ liệu huấn luyện.
Hai đường cong theo số điểm dữ liệu còn trả lời một câu hỏi có giá trị kinh tế: thu thêm dữ liệu có đáng không. Nếu đường sai số xác thực đã nằm ngang và sát đường sai số huấn luyện, thêm dữ liệu không giúp gì; nếu nó vẫn đang giảm và còn cách xa đường huấn luyện, thêm dữ liệu nhiều khả năng giúp được.
Andrew Ng dạy cách chẩn đoán này bằng những cặp số cụ thể, và cách dạy đó dễ nhớ hơn một bảng quy tắc. Sai số huấn luyện 2% và sai số xác thực 12%: khoảng cách lớn, nên phương sai cao. Sai số 14% và 15%: cả hai cùng cao và sát nhau, nên độ chệch cao. Sai số 14% và 28%: cả hai vấn đề cùng lúc. Sai số 1% và 1,5%: không có vấn đề gì đáng kể. Cách đọc này ngầm giả định rằng sai số nhỏ nhất có thể đạt được, gọi là sai số Bayes, gần bằng 0. Nếu ảnh mờ tới mức người giỏi nhất cũng sai 13%, thì cặp 14% và 15% lại là một mô hình tốt.
Từ đó Ng tách sai số theo một mức tham chiếu, thường là sai số của người giỏi nhất, dùng làm ước lượng cho sai số Bayes. Khoảng cách từ mức tham chiếu tới sai số huấn luyện là độ chệch tránh được (avoidable bias), còn khoảng cách từ sai số huấn luyện tới sai số xác thực là phương sai. Với sai số huấn luyện 6% và sai số xác thực 9%, nếu người làm được 1% thì độ chệch tránh được là 5 điểm, lớn hơn phương sai 3 điểm, nên cần một mô hình mạnh hơn trước; nếu người cũng sai 5% thì độ chệch tránh được chỉ còn 1 điểm, và phần đáng giảm là phương sai.
Khi dữ liệu huấn luyện và dữ liệu dùng thật đến từ hai phân phối khác nhau, chẳng hạn huấn luyện trên ảnh sản phẩm lấy từ web mà dùng cho ảnh chụp bằng điện thoại, khoảng cách giữa sai số huấn luyện và sai số xác thực lẫn hai thứ: phương sai và độ lệch giữa hai phân phối. Ng tách chúng bằng một tập huấn luyện–xác thực (train-dev), rút từ cùng phân phối với tập huấn luyện nhưng không dùng để huấn luyện. Với sai số huấn luyện 2%, huấn luyện–xác thực 8% và xác thực 9%, khoảng cách đã xuất hiện ngay trên dữ liệu cùng phân phối, nên đó là phương sai. Với 2%, 2,5% và 9%, mô hình tổng quát tốt trên phân phối cũ nhưng hỏng khi đổi phân phối; vấn đề là độ lệch dữ liệu, và thêm dữ liệu cùng loại cũ không giúp được (Chương 9 của MLOps).
Thứ tự xử lý mà Ng khuyên là giải quyết độ chệch trước, nhìn vào sai số huấn luyện: dùng mạng lớn hơn, huấn luyện lâu hơn hoặc đổi kiến trúc. Khi sai số huấn luyện đã chấp nhận được mới xét phương sai, nhìn vào sai số xác thực: thêm dữ liệu, tăng regularization hoặc đổi kiến trúc. Hai bước được lặp lại cho tới khi cả hai sai số đều đạt yêu cầu.
2.5Double descent#
Đường chữ U ở Mục 2.3 là bức tranh cổ điển, đúng khi số tham số nhỏ hơn số điểm dữ liệu. Với mô hình có số tham số vượt xa số điểm dữ liệu, như các mạng nơ-ron hiện đại, người ta quan sát được hiện tượng double descent (Belkin và cộng sự, 2019): sai số xác thực tăng lên tới một đỉnh tại ngưỡng mà mô hình vừa đủ tham số để khớp chính xác mọi điểm huấn luyện, gọi là ngưỡng nội suy, rồi giảm trở lại khi số tham số tiếp tục tăng. Nakkiran và cộng sự (2020) quan sát cùng hiện tượng với mạng tích chập và Transformer, theo cả số tham số lẫn số vòng huấn luyện, và thấy cả những trường hợp thêm dữ liệu lại làm sai số tăng.
Double descent không mâu thuẫn với Định lý 2.1, vì phân rã là một đẳng thức và luôn đúng. Điều thay đổi là cách phương sai phụ thuộc vào số tham số. Khi có nhiều tham số hơn số điểm dữ liệu, có vô số nghiệm khớp chính xác dữ liệu huấn luyện, và thuật toán tối ưu chọn một trong số đó. Với hồi quy tuyến tính, có thể chứng minh gradient descent khởi tạo từ 0 hội tụ tới nghiệm có chuẩn nhỏ nhất, tức nghiệm giả nghịch đảo (Mục 4.3 của Nền tảng). Việc chọn nghiệm chuẩn nhỏ nhất tác dụng như một dạng regularization ngầm, và càng nhiều tham số thì nghiệm chuẩn nhỏ nhất càng trơn. Với mạng sâu, cơ chế tương tự được nhiều nghiên cứu ủng hộ nhưng chưa được chứng minh đầy đủ.
Hai nhận xét giúp đọc đúng hiện tượng này. Thứ nhất, đỉnh ở ngưỡng nội suy phần lớn đến từ việc khớp dữ liệu mà không có regularization: với cường độ regularization được chọn tối ưu, đỉnh giảm hẳn hoặc biến mất (Nakkiran và cộng sự, 2021), và James và cộng sự (2021) nhấn mạnh rằng double descent không mâu thuẫn với đánh đổi độ chệch – phương sai. Thứ hai, khi có vô số nghiệm khớp dữ liệu, số tham số là một thước đo tồi cho độ linh hoạt: ghi chú bài giảng CS229 cho thấy vẽ sai số theo chuẩn của nghiệm thay vì theo số tham số thì đường cong không còn hai lần giảm.
Vì vậy câu "mô hình càng nhiều tham số càng dễ overfitting" chỉ đúng trong chế độ cổ điển, khi số tham số nhỏ hơn số điểm dữ liệu. Trong chế độ nhiều tham số hơn dữ liệu, nó không còn đúng hiển nhiên, và đó là một phần lời giải thích cho việc các mô hình hàng tỉ tham số vẫn tổng quát hoá được. Tuy vậy, ngay trong chế độ này, regularization, dừng sớm và dữ liệu nhiều hơn vẫn có ích; double descent không có nghĩa là có thể bỏ qua overfitting.
2.6Tóm tắt#
Sai số kỳ vọng của một mô hình tại một điểm tách thành độ chệch², phương sai và nhiễu. Độ chệch đến từ họ hàm quá hẹp, phương sai đến từ việc khớp theo nhiễu riêng của từng tập huấn luyện, còn nhiễu là cận dưới không vượt qua được. Với bốn căn hộ và căn 120 m², mô hình hằng số lệch 1,2 tỉ, đường thẳng không chệch với phương sai , còn đa thức bậc ba qua bốn điểm không chệch nhưng có phương sai , phần lớn vì phải ngoại suy. Phân rã này chỉ đúng với mất mát bình phương. Mô phỏng với đa thức cho thấy tổng sai số nhỏ nhất ở bậc 5, nơi hai thành phần gần bằng nhau, và độ chệch chỉ giảm khi họ hàm mở rộng theo hướng có ích, như các bậc lẻ với một hàm lẻ. Với dữ liệu thật, đường cong học thay cho phép đo trực tiếp và cho biết nên đổi mô hình hay thu thêm dữ liệu; so sánh sai số huấn luyện và xác thực với một mức tham chiếu như sai số của người cho biết nên giảm độ chệch tránh được hay phương sai, còn tập huấn luyện–xác thực tách phương sai khỏi độ lệch phân phối. Ở chế độ nhiều tham số hơn dữ liệu, double descent cho thấy phương sai không nhất thiết tăng theo số tham số, và đỉnh của nó phần lớn biến mất khi regularization được chọn đúng.
Một mô hình minh hoạ rất rõ cả hai loại sai số là cây quyết định: cây nông có độ chệch cao, cây sâu có phương sai cao. Chương 3 xét cây quyết định, rồi hai cách kết hợp nhiều cây để giảm từng loại sai số.
3Cây quyết định và phương pháp tập hợp#
Cây quyết định có những ưu điểm mà các mô hình khác hiếm có: dễ diễn giải, không cần chuẩn hoá đặc trưng, xử lý tự nhiên cả đặc trưng số lẫn đặc trưng hạng mục. Điểm yếu của nó là phương sai: một cây sâu thay đổi gần như hoàn toàn khi dữ liệu thay đổi một chút. Hai ý tưởng kết hợp nhiều cây biến điểm yếu đó thành điểm mạnh theo hai cách khác nhau, và phân rã ở Chương 2 cho biết chính xác mỗi cách tác động vào đâu: bagging nhắm vào phương sai, còn boosting nhắm vào độ chệch. Rừng ngẫu nhiên và gradient boosting, hai sản phẩm của hai ý tưởng đó, nằm trong số các mô hình được dùng nhiều nhất cho dữ liệu dạng bảng. Ta bắt đầu từ một cây.
3.1Cây quyết định#
Cây quyết định chia không gian đặc trưng thành các vùng hình hộp bằng các phép chia dạng "", mỗi phép chia dùng một đặc trưng và một ngưỡng. Mỗi lá của cây ứng với một vùng, và dự đoán trong vùng đó là một hằng số: lớp chiếm đa số với bài toán phân loại, hoặc giá trị trung bình với bài toán hồi quy, của các điểm huấn luyện rơi vào vùng.
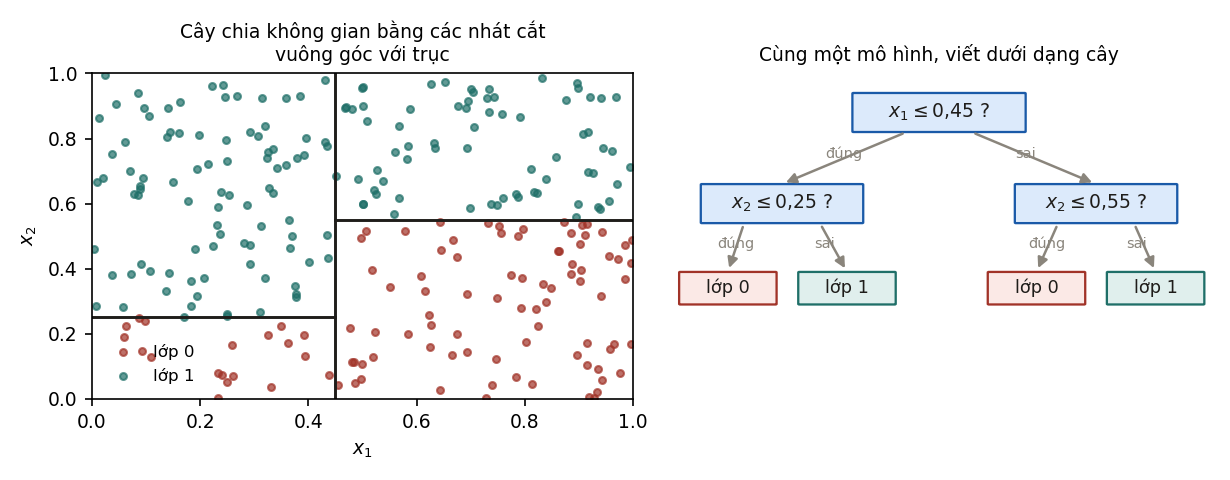
Vì mọi phép chia đều song song với trục, cây có ba tính chất đi liền với nhau. Thứ nhất, cây bất biến với phép biến đổi đơn điệu của từng đặc trưng: lấy logarit hay chuẩn hoá một đặc trưng không đổi thứ tự các giá trị, nên không đổi tập các phép chia có thể có. Vì vậy cây không cần chuẩn hoá đặc trưng, khác với hồi quy logistic, SVM hay k-NN. Thứ hai, cây không ngoại suy được: ngoài miền dữ liệu huấn luyện, nó trả về hằng số của vùng ngoài cùng. Một cây dự đoán giá nhà theo diện tích sẽ cho căn nhà 500 m² cùng giá với căn lớn nhất trong dữ liệu huấn luyện. Cây một lần chia ở Mục 1.4 định giá mọi căn từ 70 m² trở lên là 2,7 tỉ, dù căn đó rộng 100 m² hay 500 m². Thứ ba, cây khó biểu diễn biên chéo. Biên quyết định phải được xấp xỉ bằng một đường bậc thang gồm nhiều phép chia, trong khi mô hình tuyến tính chỉ cần ba tham số.
3.2Chọn phép chia#
Cây được xây từ gốc xuống. Tại mỗi nút, thuật toán xét mọi đặc trưng và mọi ngưỡng có thể, rồi chọn phép chia làm giảm độ không thuần nhất (impurity) nhiều nhất. Với phân loại, gọi là tỉ lệ điểm thuộc lớp trong nút; hai thước đo thông dụng là
Cả hai bằng 0 khi nút chỉ chứa một lớp và lớn nhất khi các lớp chia đều. Độ lợi của một phép chia là độ không thuần nhất của nút cha trừ trung bình có trọng số, theo số điểm, của hai nút con. Với hồi quy, độ không thuần nhất là phương sai của trong nút, và phép chia tốt nhất là phép chia làm giảm tổng bình phương sai số nhiều nhất. Với bốn căn hộ, có ba ngưỡng để thử: giữa 40 và 60 m², giữa 60 và 80 m², giữa 80 và 100 m². Khi mọi căn được đoán bằng giá trung bình 2,25 tỉ, tổng bình phương sai số là 1,17. Chia ở 50 m² tách căn nhỏ nhất ra một mình và đoán 2,5 tỉ cho ba căn còn lại, tổng còn 0,42; chia ở 70 m² cho hai nút với giá trung bình 1,8 và 2,7 tỉ, tổng còn 0,36; chia ở 90 m² cũng còn 0,42. Thuật toán chọn ngưỡng 70 m², và đó là cây một lần chia ở Mục 1.4.
Ví dụ 3.1
Một nút có 10 điểm, 6 điểm lớp A và 4 điểm lớp B, nên . Phép chia thứ nhất cho nút trái 4 điểm (4A, 0B) và nút phải 6 điểm (2A, 4B). Gini của nút trái bằng 0, của nút phải bằng , nên trung bình có trọng số là và độ lợi là . Phép chia thứ hai cho hai nút 5 điểm: (4A, 1B) có Gini 0,32 và (2A, 3B) có Gini 0,48, trung bình 0,40, nên độ lợi chỉ là 0,08. Thuật toán chọn phép chia thứ nhất. Dùng entropy cũng cho cùng kết luận: độ lợi thông tin là 0,420 bit so với 0,125 bit.
Một câu hỏi tự nhiên là vì sao không chọn phép chia theo chính tỉ lệ phân loại sai, thước đo cuối cùng ta quan tâm. Ghi chú CS229 về cây quyết định trả lời bằng một ví dụ kiểu sau. Một nút có 300 điểm lớp A và 100 điểm lớp B, tức 100 điểm bị phân loại sai nếu cả nút đoán A. Phép chia thứ nhất cho hai nút (100A, 100B) và (200A, 0B); phép chia thứ hai cho (200A, 100B) và (100A, 0B). Cả hai phép chia vẫn để lại đúng 100 điểm sai, nên theo tỉ lệ sai, chúng không tốt hơn việc không chia, và một thuật toán dừng khi tỉ lệ sai không giảm sẽ dừng ngay tại đây. Gini thì phân biệt được: Gini của nút cha là 0,375, của phép chia thứ nhất là , của phép chia thứ hai là . Phép chia thứ nhất tạo một nút thuần nhất 200 điểm, và nút còn lại có thể chia tiếp. Lý do nằm ở hình dạng của hàm: Gini và entropy là hàm lõm ngặt của tỉ lệ lớp, nên trung bình có trọng số của các nút con nhỏ hơn hẳn nút cha trừ khi các nút con có cùng tỉ lệ lớp với nút cha, còn tỉ lệ sai là hàm tuyến tính từng khúc nên không có tính chất này.
Trong thực tế, Gini và entropy gần như luôn chọn cùng một phép chia, và Gini tính nhanh hơn vì không cần logarit. Các siêu tham số đáng chỉnh hơn nhiều là độ sâu tối đa và số điểm tối thiểu trong mỗi lá, vì chúng quyết định độ linh hoạt của cây.
Cách xây cây như trên là tham lam: tại mỗi nút, nó chọn phép chia tốt nhất lúc đó mà không xét ảnh hưởng tới các phép chia phía dưới. Tìm cây tối ưu toàn cục là bài toán NP-khó (Hyafil và Rivest, 1976). Vì vậy một cây đơn lẻ có phương sai cao: chỉ cần vài điểm dữ liệu thay đổi là phép chia ở gốc có thể đổi, kéo theo toàn bộ cấu trúc phía dưới thay đổi.
Còn lại câu hỏi dừng ở đâu. Dừng khi một phép chia không làm độ không thuần nhất giảm đủ nhiều nghe hợp lý, nhưng có thể bỏ lỡ những phép chia chỉ có ích khi đi cùng phép chia sau nó. Với dữ liệu XOR ở Mục 4.1, phép chia đầu tiên theo trục nào cũng giữ nguyên Gini ở mức 0,5, nhưng phép chia thứ hai cho bốn lá thuần nhất. Vì vậy cách làm chuẩn, được ISLR và CS229 trình bày, là mọc cây thật lớn rồi cắt tỉa (pruning): trong các cây con, chọn cây làm nhỏ nhất , với là số lá và là giá của mỗi lá. Với bốn căn hộ, cây tốt nhất có 1, 2, 3 và 4 lá có tổng bình phương sai số lần lượt là 1,17; 0,36; 0,18 và 0. Với , điểm của bốn cây là 1,27; 0,56; 0,48 và 0,40, nên giữ cây 4 lá, tức ghi nhớ cả bốn căn. Với , điểm là 1,37; 0,76; 0,78 và 0,80, nên giữ cây 2 lá, đúng cây cắt ở 70 m². Với , chỉ còn một lá. Giá trị của được chọn bằng cross-validation, giống cường độ regularization ở Mục 9.5 của Nền tảng.
3.3Bagging, rừng ngẫu nhiên và boosting#
Phương sai cao là điểm yếu khi dùng một cây, nhưng lại làm cây trở thành thành phần phù hợp cho phương pháp tập hợp. Có hai cách kết hợp, và chúng tác động vào hai thành phần khác nhau của phân rã ở Chương 2.
Cách thứ nhất là bagging (bootstrap aggregating; Breiman, 1996): huấn luyện mô hình, mỗi mô hình trên một mẫu bootstrap, tức điểm rút có hoàn lại từ điểm huấn luyện, rồi lấy trung bình dự đoán. Theo Ví dụ 3.1 của Nền tảng, nếu mỗi mô hình có phương sai và mỗi cặp có hệ số tương quan thì trung bình của mô hình có phương sai
Khi tăng, số hạng thứ hai tiến về 0 và chỉ còn lại . Công thức này nói hai điều. Thêm mô hình không bao giờ làm phương sai tăng, nên thêm cây vào bagging không gây overfitting. Và muốn giảm phương sai tiếp thì phải giảm tương quan giữa các mô hình. Rừng ngẫu nhiên (random forest; Breiman, 2001) làm đúng việc đó: tại mỗi nút, cây chỉ được chọn phép chia trong một tập con ngẫu nhiên các đặc trưng, thường là đặc trưng với bài toán phân loại, nên các cây khác nhau hơn và ít tương quan hơn. Còn độ chệch thì bagging gần như không thay đổi, vì trung bình của các mô hình có cùng kỳ vọng với từng mô hình. Cũng vì vậy bagging chỉ có ích với mô hình không ổn định: lấy trung bình nhiều đường thẳng hồi quy khớp trên các mẫu bootstrap cho gần như đúng đường thẳng khớp trên toàn bộ dữ liệu, vì hồi quy tuyến tính vốn đã ổn định, còn với cây sâu, mỗi mẫu bootstrap cho một cây rất khác và trung bình của chúng mới khác hẳn từng cây (Hastie, Tibshirani và Friedman, 2009).
Cách thứ hai là boosting: huấn luyện các mô hình tuần tự, mỗi mô hình mới sửa phần sai của tổng các mô hình trước. Gradient boosting (Friedman, 2001) viết điều này dưới dạng
trong đó cây được huấn luyện để xấp xỉ gradient âm của hàm mất mát theo giá trị dự đoán, tại , và là tốc độ học, thường từ 0,01 tới 0,3. Với mất mát bình phương, gradient âm chính là phần dư , nên mỗi cây mới học phần dư của các cây trước. Với bốn căn hộ và cây một lần chia, là giá trung bình 2,25 tỉ, và phần dư là ; ; ; . Cây đầu tiên khớp phần dư này bằng phép chia ở 70 m², dự đoán cho hai căn nhỏ và cho hai căn lớn. Với , chỉ đi một phần mười quãng đường đó: 2,205 tỉ cho hai căn nhỏ, 2,295 tỉ cho hai căn lớn, và sai số bình phương trung bình giảm từ 0,2925 xuống 0,254. Phần dư mới lớn nhất ở hai căn ngoài cùng, nên cây thứ hai chia ở 50 m² để tách căn 40 m², và cây thứ ba chia ở 90 m² để tách căn 100 m². Đây là gradient descent trong không gian hàm: thay vì cập nhật tham số, mỗi bước cộng thêm một hàm theo hướng làm giảm mất mát. Gradient âm chỉ tính được tại các điểm huấn luyện, nơi biết nhãn ; khớp một cây vào các giá trị đó là bước biến một hướng chỉ xác định trên dữ liệu thành một hàm dùng được cho mọi . Vì mỗi cây chỉ cần sửa một phần nhỏ, các cây trong boosting thường rất nông, độ sâu từ 2 tới 6. Tổ hợp của nhiều cây nông có độ chệch thấp hơn nhiều so với từng cây, nên boosting chủ yếu giảm độ chệch.
3.4Đo tác dụng của bagging và boosting#
Phân tích trên có thể kiểm tra trực tiếp. Thí nghiệm trong code/models/experiments.py dùng cùng hàm thật và mức nhiễu như Chương 2, mỗi tập huấn luyện 120 điểm, và đo độ chệch² cùng phương sai của ba mô hình trên 40 tập huấn luyện độc lập: một cây sâu 8, bagging 100 cây sâu 8, và gradient boosting 100 cây sâu 2 với tốc độ học 0,1.
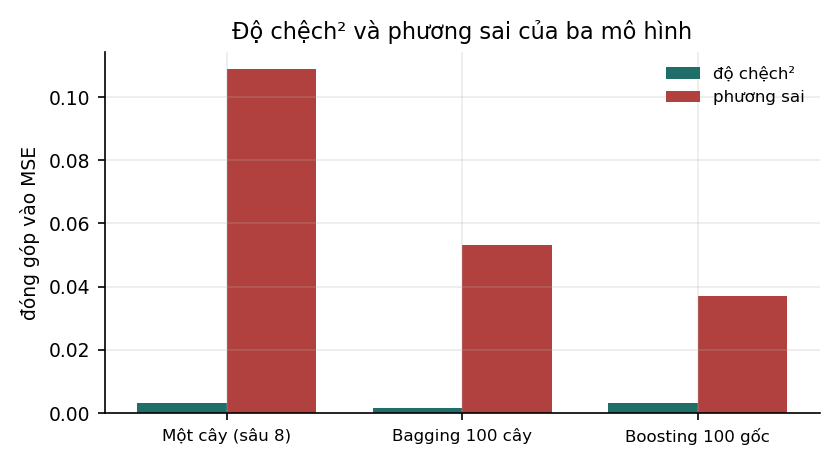
| Mô hình | Độ chệch² | Phương sai | Tổng (không tính nhiễu) |
|---|---|---|---|
| Một cây, sâu 8 | 0,0031 | 0,1089 | 0,1120 |
| Bagging, 100 cây sâu 8 | 0,0016 | 0,0534 | 0,0550 |
| Gradient boosting, 100 cây sâu 2 | 0,0032 | 0,0371 | 0,0403 |
Cây sâu 8 đủ linh hoạt để có độ chệch rất thấp, nên sai số của nó gần như hoàn toàn là phương sai: phương sai gấp khoảng 35 lần độ chệch². Bagging giảm phương sai đi một nửa, từ 0,1089 xuống 0,0534, và gần như không đổi độ chệch, đúng như phân tích ở Mục 3.3. Phương sai không giảm tới 0 dù có 100 cây, vì các cây được huấn luyện trên các mẫu bootstrap của cùng một tập dữ liệu nên vẫn tương quan với nhau; phần còn lại đó chính là số hạng .
Gradient boosting cho tổng sai số thấp nhất. Mỗi cây sâu 2 chỉ có 4 lá, nên nếu dùng một mình thì có độ chệch rất cao. Cộng 100 cây như vậy hạ độ chệch xuống ngang cây sâu 8, trong khi phương sai giữ ở mức thấp vì mỗi cây rất đơn giản và tốc độ học 0,1 làm mỗi cây chỉ đóng góp một phần nhỏ.
3.5Các hiểu lầm thường gặp#
Cây và các phương pháp tập hợp đi kèm khá nhiều hiểu lầm phổ biến. Một hiểu lầm thấy được ngay trên bốn căn hộ: tiếp tục ví dụ ở Mục 3.3 tới 100 cây thì sai số huấn luyện gần như bằng 0. Tổng các cây khi đó là một hàm bậc thang đi qua đúng bốn mức giá, và nó định giá căn 85 m² là 2,4 tỉ, bằng căn 80 m², trong khi đường thẳng định giá 2,61 tỉ. Bốn điểm dữ liệu không đủ cho 100 cây. Bảng dưới gom những hiểu lầm hay gặp nhất cùng điều đúng tương ứng.
| Phát biểu | Thực tế |
|---|---|
| "Cây quyết định cần chuẩn hoá đặc trưng." | Không cần: cây bất biến với mọi phép biến đổi đơn điệu của từng đặc trưng. |
| "Rừng ngẫu nhiên không bị overfitting." | Thêm cây không gây overfitting, nhưng cây quá sâu trên dữ liệu nhiễu vẫn làm rừng overfitting. |
| "Thêm cây vào gradient boosting luôn tốt hơn." | Không: boosting có thể overfitting khi số cây quá lớn. Số cây phải chọn bằng tập xác thực, thường kết hợp dừng sớm. |
| "Độ quan trọng đặc trưng tính từ cây là đáng tin." | Độ quan trọng tính theo tổng độ giảm độ không thuần nhất thiên về các đặc trưng có nhiều giá trị khác nhau, và khi hai đặc trưng tương quan thay thế được cho nhau, phần quan trọng bị chia giữa chúng một cách tuỳ ý. Permutation importance (Breiman, 2001) hoặc SHAP (Lundberg và Lee, 2017) đáng tin hơn. |
| "Boosting chỉ dùng được với cây." | Boosting dùng được với mọi mô hình yếu; cây phổ biến vì rẻ và xử lý tốt đặc trưng hỗn hợp. |
| "XGBoost là một thuật toán khác gradient boosting." | XGBoost (Chen và Guestrin, 2016) là một cài đặt hiệu quả của gradient boosting, có thêm regularization trên cấu trúc cây và cách xử lý giá trị thiếu. |
3.6Gradient boosting trong thực hành#
Các thư viện phổ biến là XGBoost, LightGBM (Ke và cộng sự, 2017) và CatBoost (Prokhorenkova và cộng sự, 2018). Chúng khác nhau ở chi tiết cài đặt, như cách tìm ngưỡng chia trên dữ liệu lớn hay cách xử lý đặc trưng hạng mục, nhưng có chung các siêu tham số quan trọng.
Quan trọng nhất là cặp tốc độ học và số cây, hai siêu tham số luôn đi cùng nhau: tốc độ học nhỏ cần nhiều cây hơn nhưng thường tổng quát hoá tốt hơn. Cách làm thông dụng là cố định tốc độ học ở một mức nhỏ, chẳng hạn 0,05, rồi chọn số cây bằng dừng sớm trên tập xác thực, tức dừng khi sai số xác thực không giảm sau một số vòng. Tiếp theo là độ phức tạp của mỗi cây, đặt bằng độ sâu tối đa hoặc số lá tối đa và số điểm tối thiểu trong mỗi lá. Cây sâu hơn biểu diễn được tương tác bậc cao hơn giữa các đặc trưng, nhưng làm tăng phương sai.
Hai nhóm siêu tham số còn lại đóng vai trò regularization. Lấy mẫu con cho mỗi cây chỉ dùng một phần ngẫu nhiên các điểm dữ liệu, chẳng hạn 80%, và một phần các đặc trưng; cách này giảm tương quan giữa các cây theo đúng ý tưởng của rừng ngẫu nhiên, và thường cải thiện tổng quát hoá (Friedman, 2002). Regularization trên lá phạt lên giá trị của các lá và yêu cầu một độ lợi tối thiểu cho mỗi phép chia.
So với rừng ngẫu nhiên, gradient boosting thường chính xác hơn khi được chỉnh tốt, nhưng nhạy hơn với siêu tham số. Rừng ngẫu nhiên là lựa chọn mặc định an toàn: các cây độc lập nên dễ song song hoá, và thêm cây không làm kết quả kém đi. Với cả hai, cần chia tập xác thực đúng cách, theo thời gian hoặc theo nhóm khi dữ liệu có cấu trúc đó (Mục 8.5 của Nền tảng).
3.7Tóm tắt#
Cây quyết định chia không gian bằng các phép chia song song với trục, chọn tham lam theo độ giảm độ không thuần nhất, đo bằng Gini hay entropy chứ không bằng tỉ lệ sai, vì tỉ lệ sai có thể không phân biệt được hai phép chia rất khác nhau. Cây được mọc lớn rồi cắt tỉa theo , với chọn bằng cross-validation. Nhờ vậy nó không cần chuẩn hoá đặc trưng, nhưng không ngoại suy được và có phương sai cao. Bagging lấy trung bình nhiều cây trên các mẫu bootstrap để giảm phương sai, tới giới hạn đặt bởi tương quan giữa các cây, và rừng ngẫu nhiên hạ giới hạn đó bằng cách chọn ngẫu nhiên đặc trưng ở mỗi nút. Gradient boosting cộng dần các cây nông, mỗi cây đi theo gradient âm của hàm mất mát, nên chủ yếu giảm độ chệch. Với bốn căn hộ, cây chọn ngưỡng 70 m² vì nó giảm tổng bình phương sai số từ 1,17 xuống 0,36, và gradient boosting với cây một lần chia khớp đúng bốn mức giá sau 100 cây, thành một hàm bậc thang. Trên bài toán mô phỏng, bagging giảm một nửa phương sai của một cây sâu, còn gradient boosting cho tổng sai số thấp nhất.
Gradient boosting là gradient descent trong không gian hàm, mỗi bước cộng thêm một cây. Chương 4 chuyển sang một họ mô hình mà gradient descent chạy trên chính các tham số: mạng nơ-ron nhiều lớp, bắt đầu từ chỗ hồi quy logistic đã dừng.
4Mạng nơ-ron nhiều lớp#
Hồi quy logistic ở Chương 6 của Nền tảng là một mạng nơ-ron một lớp: một phép biến đổi tuyến tính theo sau là hàm sigmoid. Nó chỉ vẽ được biên quyết định thẳng, nên ở Nền tảng, mỗi khi biên cong ta phải tự tạo thêm đặc trưng như bình phương hay tích của các đặc trưng gốc. Mạng nhiều lớp tự học những đặc trưng đó bằng cách chồng nhiều lớp lên nhau. Ta sẽ thấy vì sao giữa các lớp bắt buộc phải có hàm phi tuyến, mạng một lớp ẩn biểu diễn được tới đâu theo định lý xấp xỉ phổ quát, và độ sâu tiết kiệm được bao nhiêu tham số qua một phép dựng tường minh.
4.1Từ mô hình tuyến tính tới mạng nhiều lớp#
Mô hình tuyến tính ngầm giả định rằng mỗi đặc trưng tác động theo một chiều cố định và với cùng một mức ở mọi nơi. Giả định đó sai ở nhiều bài toán quen thuộc, và d2l.ai mở đầu chương về mạng nhiều lớp bằng đúng nhận xét này. Mức thoải mái của người trong phòng cao nhất quanh 25 °C và giảm khi phòng nóng lên hay lạnh đi, nên không hàm tuyến tính nào của nhiệt độ mô tả được nó; trường hợp này còn sửa được bằng tay, bằng cách dùng khoảng cách tới 25 °C làm đặc trưng. Với ảnh thì không: giá trị của một điểm ảnh riêng lẻ không cho biết ảnh có con mèo hay không, vì điều đó phụ thuộc vào quan hệ giữa rất nhiều điểm ảnh, và không có đặc trưng tự tạo đơn giản nào nắm được quan hệ ấy. Mạng nhiều lớp học những đặc trưng như vậy từ dữ liệu.
Một lớp tuyến tính tính . Chồng hai lớp tuyến tính không tạo ra gì mới, vì
vẫn là một phép biến đổi affine của . Chồng bao nhiêu lớp tuyến tính cũng chỉ tương đương một lớp. Muốn nhiều lớp biểu diễn được nhiều hơn một lớp, phải xen giữa chúng một hàm phi tuyến.
Định nghĩa 4.1 (Mạng nơ-ron truyền thẳng nhiều lớp)
Một mạng nơ-ron truyền thẳng nhiều lớp (multilayer perceptron, MLP) có lớp tính
trong đó là hàm kích hoạt áp dụng cho từng phần tử. Các với gọi là lớp ẩn, số phần tử của mỗi lớp ẩn là bề rộng của lớp đó.
Định nghĩa đếm các lớp có trọng số, không đếm lớp đầu vào, theo cùng quy ước với CS231n: mạng 784–256–10 ở dưới là mạng hai lớp. Lớp cuối không có hàm kích hoạt vì nó được chọn theo bài toán. Với hồi quy, được dùng trực tiếp và hàm mất mát là bình phương sai số. Với phân loại nhị phân, đi qua sigmoid; với nhiều lớp, qua softmax; và hàm mất mát là cross-entropy. Cả hai cặp lựa chọn đều đến từ ước lượng hợp lý cực đại (Chương 10 của Nền tảng): bình phương sai số ứng với nhiễu Gauss, cross-entropy ứng với phân phối Bernoulli hoặc phân phối phân loại.
Một lớp có đầu vào và đầu ra có tham số. Chẳng hạn, mạng 784–256–10 cho ảnh chữ số MNIST có tham số ở lớp ẩn và tham số ở lớp ra, tổng cộng 203 530.
Ví dụ 4.1 (Hàm XOR)
Bốn điểm , có nhãn 0 và , có nhãn 1 không tách được bằng một đường thẳng, nên không mô hình tuyến tính nào phân loại đúng cả bốn. Một mạng có hai đơn vị ReLU ở lớp ẩn làm được:
Kiểm tra: tại có nên ; tại và có nên ; tại có nên . Lớp ẩn đã biến đổi bốn điểm sang một không gian mới, trong đó chúng tách được bằng một hàm tuyến tính. Đó là cách hiểu hữu ích về mạng nhiều lớp: các lớp ẩn học một phép biến đổi đặc trưng, lớp cuối là một mô hình tuyến tính trên đặc trưng đã học. Nghiệm này cũng là nghiệm mà Goodfellow, Bengio và Courville (2016, Mục 6.1) dùng để giới thiệu mạng truyền thẳng.
4.2Hàm kích hoạt#
Bảng dưới so sánh các hàm kích hoạt thường gặp.
| Hàm | Công thức | Đạo hàm | Ưu điểm | Nhược điểm |
|---|---|---|---|---|
| Sigmoid | đầu ra trong | bão hoà ở hai phía, đạo hàm gần 0; đầu ra không có trung bình 0 | ||
| Tanh | đầu ra có trung bình quanh 0 | vẫn bão hoà ở hai phía | ||
| ReLU | 1 nếu , 0 nếu | không bão hoà phía dương, tính rất rẻ | đơn vị có thể "chết" (luôn có ) | |
| Leaky ReLU | , | hoặc | tránh đơn vị chết | thêm một siêu tham số |
| GELU | trơn | dùng phổ biến trong Transformer | tính đắt hơn ReLU một chút | |
| SiLU (Swish) | trơn | dùng trong nhiều mô hình ngôn ngữ (Mục 10.5) | như GELU |
Trong bảng, là hàm phân phối tích luỹ của phân phối chuẩn tắc. GELU do Hendrycks và Gimpel (2016) đề xuất; SiLU do Elfwing, Uchibe và Doya (2018) và Ramachandran, Zoph và Le (2017) đề xuất độc lập.
Từ bảng có ba điều cần nắm. Điều đầu tiên giải thích vì sao ReLU thay thế sigmoid trong mạng sâu: đạo hàm của ReLU bằng 1 ở phía dương. Gradient qua nhiều lớp là tích của các đạo hàm (Chương 5), mà đạo hàm của sigmoid không vượt quá 1/4, nên qua 10 lớp sigmoid, riêng phần đạo hàm của hàm kích hoạt đã nhân gradient với tối đa . Đây là một nguồn của gradient tiêu biến (Chương 6).
Điều thứ hai là ReLU có một kiểu hỏng riêng, gọi là đơn vị chết. Nếu một bước cập nhật lớn đẩy hệ số chặn của một đơn vị xuống đủ âm, đơn vị đó cho với mọi đầu vào, đạo hàm bằng 0, và nó không bao giờ được cập nhật lại. Nguyên nhân thường gặp là tốc độ học quá lớn.
Điều thứ ba là hàm kích hoạt của lớp ra khác với lớp ẩn. Lớp ra dùng sigmoid, softmax hoặc không dùng gì, tuỳ bài toán (Mục 4.1). Dùng ReLU ở lớp ra của một bài toán hồi quy có giá trị âm là một lỗi hay gặp: mô hình khi đó không bao giờ dự đoán được giá trị âm.
4.3Định lý xấp xỉ phổ quát#
Một câu hỏi tự nhiên là mạng nhiều lớp biểu diễn được những hàm nào. Câu trả lời cổ điển là: gần như mọi hàm, ngay cả khi chỉ có một lớp ẩn.
Định lý 4.1 (Xấp xỉ phổ quát)
Cho là một hàm liên tục không phải đa thức. Với mọi hàm liên tục trên một tập compact và mọi , tồn tại một mạng một lớp ẩn sao cho với mọi .
Cybenko (1989) chứng minh định lý cho hàm sigmoid, Hornik (1991) mở rộng, và Leshno và cộng sự (1993) chứng minh điều kiện "không phải đa thức" là đủ, nên định lý áp dụng cho cả ReLU.
Với đầu vào một chiều, có thể thấy định lý đúng bằng một phép dựng tay, theo tinh thần chứng minh bằng hình của Nielsen (2015). Mỗi đơn vị bằng 0 bên trái và tăng tuyến tính bên phải , nên tổng của vài đơn vị như vậy là một đường gấp khúc có điểm gãy tại các đã chọn. Đường gấp khúc đi qua các điểm của một hàm liên tục, với các điểm gãy đủ dày, xấp xỉ hàm đó tốt tuỳ ý. Chẳng hạn trên đoạn , hàm có hệ số góc 0,5 rồi 1,5, đi qua đúng các điểm , và của , và lệch khỏi nhiều nhất 0,0625. Dùng bốn đơn vị với các điểm gãy cách nhau 0,25 thì sai số lớn nhất còn 0,0156: mỗi lần gấp đôi số đơn vị, sai số giảm bốn lần.
Định lý nói rằng mạng một lớp ẩn đủ rộng biểu diễn được mọi hàm liên tục, nhưng nó chỉ khẳng định sự tồn tại. Nó không cho biết cần bao nhiêu đơn vị ẩn, và với một số hàm, con số này tăng theo hàm mũ của số chiều hoặc của độ phức tạp của hàm. Nó không cho biết gradient descent có tìm được bộ trọng số đó hay không. Và nó cũng không cho biết cần bao nhiêu dữ liệu để tìm được bộ trọng số đó mà không overfitting. Ba câu hỏi này mới là những câu quan trọng trong thực tế. d2l.ai so sánh định lý với nhận xét rằng ngôn ngữ C viết được mọi chương trình: điều đó đúng, nhưng viết ra chương trình cần thiết mới là phần khó.
Vì vậy định lý không giải thích được vì sao mạng sâu hoạt động tốt hơn mạng nông mà rộng. Mục 4.4 trả lời một phần câu hỏi này: có những hàm mà mạng sâu biểu diễn bằng số tham số tăng tuyến tính, trong khi mạng một lớp ẩn cần số tham số tăng theo hàm mũ.
4.4Độ sâu và số tham số cần thiết#
Phép dựng sau, theo ý tưởng của Telgarsky (2016), cho thấy lợi ích của độ sâu mà không phụ thuộc vào việc huấn luyện có thành công hay không. Ta xuất phát từ hàm lều dùng đúng hai đơn vị ReLU:
Trên , hàm này tăng tuyến tính từ lên rồi giảm tuyến tính về , nên nó ánh xạ lên . Bây giờ hợp với chính nó lần. Mỗi nhánh của phủ trọn đoạn , nên mỗi lần hợp làm số đoạn tuyến tính tăng gấp đôi. Với : và , nên ; tương tự nên , còn . Hàm đi từ 0 lên 1 ở , xuống 0 ở , lên 1 ở rồi về 0 ở : bốn đoạn tuyến tính, từ hai lớp, mỗi lớp hai đơn vị. Kết quả là một hàm răng cưa có đúng đoạn tuyến tính, biểu diễn bằng một mạng lớp, mỗi lớp 2 đơn vị ReLU, tổng cộng tham số.
Mạng một lớp ẩn cần bao nhiêu đơn vị để biểu diễn cùng hàm đó? Với đầu vào một chiều, mỗi đơn vị ReLU tạo ra đúng một điểm gãy tại , và tổng của đơn vị là một hàm tuyến tính từng khúc có tối đa điểm gãy. Hàm răng cưa có điểm gãy bên trong đoạn, nên mạng một lớp ẩn cần ít nhất đơn vị để biểu diễn chính xác nó.
Thí nghiệm trong code/models/experiments.py kiểm tra điều này theo hướng xấp xỉ. Với mỗi bề rộng trong dãy 2, 4, 8, …, 256, thí nghiệm đặt điểm gãy cách đều trên rồi giải bình phương tối thiểu cho các hệ số của lớp ra. Như vậy mạng một lớp được cho sẵn nghiệm tối ưu với các điểm gãy cố định, thay vì phải tự tìm bằng gradient descent. Bề rộng cần thiết là bề rộng nhỏ nhất trong dãy cho sai số bình phương trung bình dưới một nửa phương sai của hàm răng cưa, tức tốt hơn rõ rệt so với dự đoán bằng một hằng số.
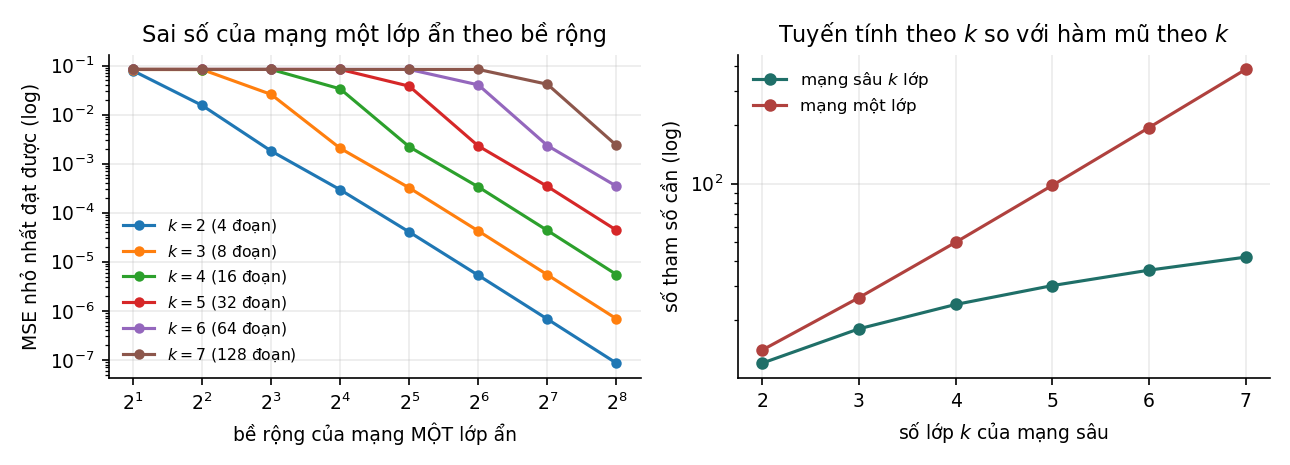
| Số đoạn | Tham số mạng sâu | Bề rộng mạng một lớp cần | Tham số mạng một lớp | Tỉ lệ | |
|---|---|---|---|---|---|
| 2 | 4 | 12 | 4 | 14 | 1,2 |
| 3 | 8 | 18 | 8 | 26 | 1,4 |
| 4 | 16 | 24 | 16 | 50 | 2,1 |
| 5 | 32 | 30 | 32 | 98 | 3,3 |
| 6 | 64 | 36 | 64 | 194 | 5,4 |
| 7 | 128 | 42 | 128 | 386 | 9,2 |
Với mọi , bề rộng cần thiết là , khớp với cận dưới ở trên. Dưới bề rộng đó, mạng một lớp không làm tốt hơn dự đoán hằng số: với , mọi bề rộng từ 2 tới 64 đều cho sai số 0,083, đúng bằng phương sai của hàm răng cưa. Số tham số của mạng sâu tăng tuyến tính theo , của mạng một lớp tăng theo , nên tỉ lệ giữa chúng tăng không giới hạn: 9,2 lần ở , và hơn 26 000 lần ở .
Kết quả này cần được đọc đúng phạm vi. Đây là so sánh về khả năng biểu diễn, không phải về khả năng học: mạng sâu được cho trọng số tường minh, không qua huấn luyện. Trên thực tế, huấn luyện một mạng 7 lớp chỉ có 2 đơn vị mỗi lớp để học hàm này bằng gradient descent gần như luôn thất bại, và Chương 6 giải thích một phần nguyên nhân. Hàm răng cưa cũng là trường hợp thuận lợi nhất cho độ sâu, vì nó có cấu trúc lặp lại mà phép hợp hàm khai thác trực tiếp; kết quả không có nghĩa là mạng càng sâu càng tốt với mọi dữ liệu, và với dữ liệu dạng bảng, thêm lớp thường không giúp gì (Mục 1.2). Cuối cùng, độ sâu không làm tăng những gì mạng biểu diễn được về nguyên tắc, vì theo Định lý 4.1 mạng một lớp đủ rộng đã biểu diễn được mọi hàm liên tục. Thứ độ sâu mang lại là khả năng biểu diễn một số hàm bằng ít tham số hơn rất nhiều.
4.5Thiết kế MLP trong thực hành#
Với dữ liệu không có cấu trúc không gian hay thời gian, một số lựa chọn mặc định thường là điểm khởi đầu tốt. Đầu vào cần được chuẩn hoá: đưa mỗi đặc trưng số về trung bình 0, độ lệch chuẩn 1, dùng thống kê tính trên tập huấn luyện. Khác với cây quyết định, mạng nơ-ron nhạy với thang đo của đặc trưng, vì thang đo ảnh hưởng tới số điều kiện của bài toán tối ưu (Mục 5.3 của Nền tảng). Mạng nên có 2 tới 4 lớp ẩn, bề rộng bằng nhau hoặc giảm dần; mạng sâu hơn cần kết nối tắt và chuẩn hoá (Chương 6). Hàm kích hoạt nên là ReLU hoặc GELU, và thuật toán tối ưu là Adam hoặc AdamW với tốc độ học khoảng (Mục 5.4). Để chống overfitting, dừng sớm dựa trên sai số xác thực là biện pháp rẻ và hiệu quả nhất, nên làm trước; sau đó mới tới weight decay và dropout với tỉ lệ 0,1 tới 0,3 (Mục 6.6).
Trước khi huấn luyện lâu, có hai kiểm tra rẻ ngay ở bước khởi tạo. Với bài toán phân loại lớp, mạng vừa khởi tạo nên cho xác suất gần đều trên các lớp, nên cross-entropy ban đầu phải gần , tức khoảng 2,303 với 10 lớp. Một con số lớn hơn nhiều cho thấy logit ban đầu quá lớn, và mạng sẽ tốn những vòng huấn luyện đầu chỉ để thu nhỏ chúng (CS231n; Karpathy, 2019). Kiểm tra thứ hai là đặt sẵn hệ số chặn của lớp ra theo dữ liệu: bằng trung bình của biến mục tiêu với hồi quy, hoặc bằng log tỉ lệ cược của tỉ lệ lớp với phân loại mất cân bằng; chẳng hạn khi 10% mẫu là dương, hệ số chặn ban đầu là , ứng với xác suất dự đoán 0,1. Như vậy mô hình không phải học điều hiển nhiên đó trong những vòng đầu.
CS231n còn có một lời khuyên đi ngược trực giác: không thu nhỏ mạng để chống overfitting. Mạng nhỏ dễ dừng ở những nghiệm có mất mát cao và cho kết quả dao động nhiều giữa các lần khởi tạo; nên dùng mạng lớn nhất mà tài nguyên cho phép rồi kiểm soát overfitting bằng regularization.
Trên dữ liệu dạng bảng, nên so sánh MLP với gradient boosting (Mục 3.6) trước khi kết luận, vì như Mục 1.2 đã nêu, gradient boosting thường tốt bằng hoặc tốt hơn.
4.6Tóm tắt#
Mạng nơ-ron nhiều lớp chồng các phép biến đổi affine xen với hàm kích hoạt phi tuyến; không có hàm phi tuyến thì chồng bao nhiêu lớp cũng chỉ bằng một lớp. Các lớp ẩn học một phép biến đổi đặc trưng, như ví dụ XOR cho thấy, còn lớp ra là một mô hình tuyến tính trên đặc trưng đã học, với hàm kích hoạt và hàm mất mát chọn theo bài toán. ReLU thay sigmoid trong mạng sâu vì đạo hàm của nó bằng 1 ở phía dương. Định lý xấp xỉ phổ quát bảo đảm mạng một lớp ẩn đủ rộng biểu diễn được mọi hàm liên tục, và với ReLU có thể thấy điều đó bằng một đường gấp khúc đi qua các điểm của hàm cần xấp xỉ; nhưng định lý không nói gì về số đơn vị cần thiết hay về việc học. Trước khi huấn luyện, mất mát ban đầu gần và hệ số chặn lớp ra đặt theo dữ liệu là hai kiểm tra rẻ. Với hàm răng cưa đoạn, mạng sâu cần tham số, trong khi mạng một lớp cần cỡ .
Biểu diễn được một hàm chưa có nghĩa là học được nó. Để học, ta cần gradient của hàm mất mát theo mọi tham số của mạng, và một cách dùng gradient đó để cập nhật tham số. Chương 5 trình bày cả hai việc.
5Lan truyền ngược và các thuật toán tối ưu#
Huấn luyện một mạng nơ-ron gồm hai việc tách biệt: tính gradient của hàm mất mát theo mọi tham số, và dùng gradient đó để cập nhật tham số. Lan truyền ngược làm việc thứ nhất; SGD, momentum và Adam làm việc thứ hai. Người mới hay gộp hai việc làm một, nói "huấn luyện bằng lan truyền ngược" như thể lan truyền ngược là một thuật toán học. Tách chúng ra giúp trả lời những câu hỏi rất thực tế: vì sao tính gradient của một mô hình hàng tỉ tham số chỉ tốn cỡ ba lần tính hàm mất mát, vì sao huấn luyện tốn bộ nhớ hơn suy luận nhiều, và vì sao Adam phải giữ thêm hai giá trị cho mỗi tham số.
5.1Lan truyền ngược#
Định nghĩa 5.1 (Lan truyền ngược)
Lan truyền ngược (backpropagation) là thuật toán tính gradient của một hàm mất mát vô hướng theo mọi tham số của mạng, bằng cách áp dụng quy tắc dây chuyền theo thứ tự từ đầu ra ngược về đầu vào và dùng lại các giá trị trung gian đã tính ở lượt xuôi.
Lan truyền ngược không phải là thuật toán học. Nó chỉ tính gradient; dùng gradient để cập nhật tham số thế nào là việc của thuật toán tối ưu (Mục 5.4). Hai thành phần độc lập với nhau: cùng một gradient có thể dùng cho SGD hay Adam, và cùng một thuật toán tối ưu nhận được gradient tính bằng lan truyền ngược hay bằng cách khác.
Thuật toán gồm hai lượt. Lượt xuôi tính đầu ra từ đầu vào, lần lượt qua từng lớp, và lưu lại mọi giá trị trung gian: đầu vào của mỗi lớp, giá trị trước và sau hàm kích hoạt. Lượt ngược bắt đầu từ và đi ngược qua từng lớp. Với một lớp , , khi đã có thì
Vector lại là đầu vào cho lớp phía trước, và mỗi công thức chỉ cần các giá trị , đã lưu ở lượt xuôi. Rumelhart, Hinton và Williams (1986) phổ biến thuật toán này cho mạng nơ-ron; trong toán học ứng dụng, nó là trường hợp riêng của vi phân tự động chế độ ngược.
Bài giảng CS231n trình bày cùng thuật toán theo một cách dễ hình dung hơn: mỗi phép toán là một cổng, nhận gradient từ phía sau rồi nhân với đạo hàm cục bộ của chính nó. Lấy với , , . Lượt xuôi cho rồi . Lượt ngược bắt đầu từ . Cổng nhân đổi chéo: gradient của là giá trị của đầu vào kia, , còn gradient của là . Cổng cộng chia đều: và cùng nhận nguyên gradient của . Cổng max, như trong ReLU, chuyển toàn bộ gradient cho đầu vào lớn hơn và cho đầu vào kia 0. Khi một biến được dùng ở nhiều chỗ, gradient của nó là tổng gradient từ mọi nhánh; Karpathy (2022) minh hoạ bằng , có đạo hàm 2 chứ không phải 1, và quên cộng dồn là lỗi kinh điển khi tự cài lan truyền ngược.
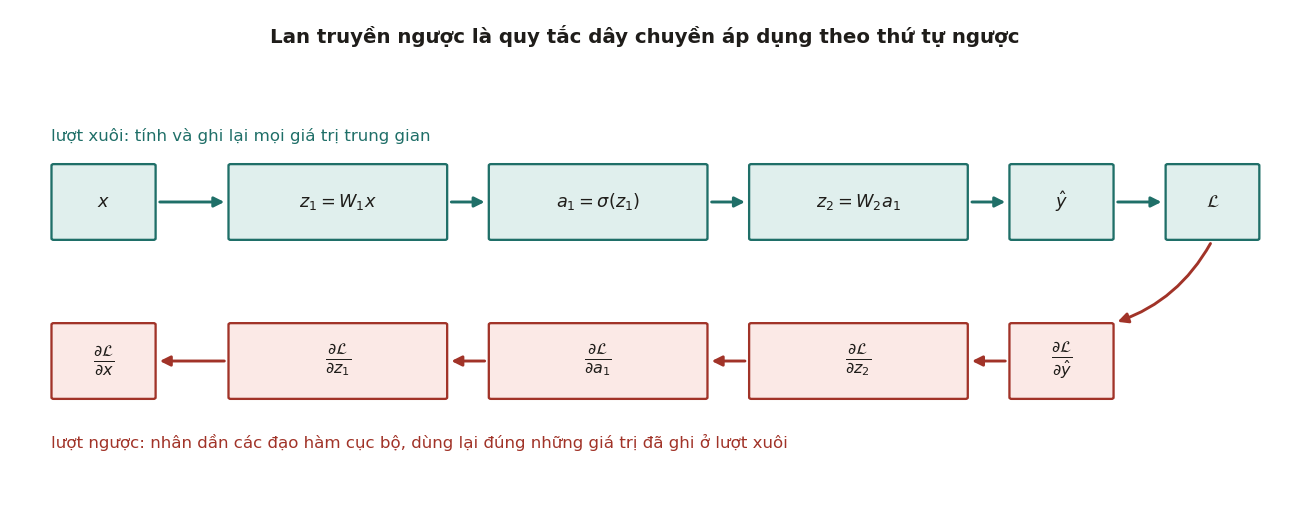
Ví dụ sau thực hiện đầy đủ một lượt xuôi, một lượt ngược và một bước cập nhật trên mạng nhỏ nhất có lớp ẩn, để thấy từng công thức trên hoạt động thế nào.
Ví dụ 5.1
Mạng có đầu vào , lớp ẩn 2 đơn vị ReLU và một đầu ra tuyến tính, hàm mất mát với . Tham số:
Lượt xuôi. . Qua ReLU: . Đầu ra . Mất mát .
Lượt ngược. . Lớp ra: , , và . Qua ReLU: . Lớp ẩn: và .
Kiểm tra bằng sai phân. Tăng rồi giảm một lượng : mất mát thành và , nên đạo hàm xấp xỉ , khớp với lượt ngược.
Cập nhật. Một bước gradient descent với đưa từ 0,45 lên 0,606 và mất mát từ 0,151 xuống 0,078.
Ví dụ cho thấy một chi tiết quan trọng: đơn vị ẩn thứ hai có , nên đạo hàm của ReLU tại đó bằng 0, và toàn bộ hàng thứ hai của nhận gradient bằng 0. Đơn vị nào không kích hoạt với một đầu vào thì không học được gì từ đầu vào đó. Nếu một đơn vị không kích hoạt với mọi đầu vào, nó không bao giờ được cập nhật nữa; đó chính là đơn vị ReLU chết ở Mục 4.2. Cách kiểm tra bằng sai phân, và cách chọn bước sai phân, được trình bày ở Mục 5.5 của Nền tảng. Khi kiểm tra gradient của cả một mạng, CS231n khuyên dùng sai phân trung tâm như trong ví dụ và so bằng sai số tương đối giữa gradient giải tích và gradient số : dưới là tốt, còn trên thì gần như chắc chắn có lỗi. Phép kiểm tra nên chạy bằng số thực 64 bit, trên vài điểm dữ liệu, và tắt dropout cùng regularization. Với ReLU, các giá trị trước hàm kích hoạt nên cách 0 xa hơn bước sai phân, như trong ví dụ, để phép sai phân không vắt qua điểm gãy.
5.2Thứ tự nhân các ma trận Jacobi#
Vì sao phải đi ngược mà không đi xuôi? Theo quy tắc dây chuyền, với mạng trong đó là một số, gradient theo đầu vào là tích các ma trận Jacobi:
Phép nhân ma trận có tính kết hợp, nên có thể nhân theo bất kỳ thứ tự nào, nhưng chi phí rất khác nhau. Nhân từ trái sang phải, tức chế độ ngược của lan truyền ngược, thì kết quả trung gian luôn là một vector hàng , và mỗi bước chỉ là một phép nhân vector với ma trận, tốn . Nhân từ phải sang trái, tức chế độ xuôi, thì kết quả trung gian là một ma trận , và mỗi bước là một phép nhân ma trận với ma trận, tốn . Với 10 lớp có , chế độ ngược tốn khoảng phép nhân, chế độ xuôi khoảng , chênh nhau 1 000 lần, đúng bằng số đầu vào .
Tổng quát hơn, với một hàm từ đầu vào ra đầu ra, chế độ ngược tính toàn bộ gradient với chi phí cỡ lần tính hàm, còn chế độ xuôi cần cỡ lần (Baydin và cộng sự, 2018). Huấn luyện mạng nơ-ron có , vì hàm mất mát là một số, còn bằng số tham số, có thể tới hàng tỉ, nên chế độ ngược rẻ hơn hàng tỉ lần. Trên thực tế, một lượt ngược tốn khoảng gấp đôi một lượt xuôi (Mục 12.4), nên tính gradient chỉ tốn cỡ ba lần tính hàm mất mát. Đặt cạnh cách tính bằng sai phân, vốn cần thêm một lượt tính hàm mất mát cho mỗi tham số, tức một triệu lẻ một lượt với một mô hình một triệu tham số (Nielsen, 2015), hai cách chênh nhau hơn trăm nghìn lần.
Ngược lại, khi cần đạo hàm của nhiều đầu ra theo ít đầu vào, chế độ xuôi rẻ hơn. Các thư viện như PyTorch và JAX cài đặt cả hai chế độ.
5.3Bộ nhớ cho lan truyền ngược#
Lượt ngược cần các giá trị trung gian của lượt xuôi, nên chúng phải được giữ trong bộ nhớ cho tới khi lượt ngược dùng xong. Phần bộ nhớ này, gọi là bộ nhớ kích hoạt, tỉ lệ với
Bộ nhớ kích hoạt không tỉ lệ với số tham số mà tỉ lệ với kích thước lô và độ dài chuỗi. Vì vậy khi huấn luyện bị hết bộ nhớ, cách xử lý đầu tiên thường là giảm kích thước lô, không phải thu nhỏ mô hình.
Có hai kỹ thuật đổi thời gian tính lấy bộ nhớ. Gradient checkpointing (Chen và cộng sự, 2016) chỉ lưu giá trị trung gian tại một số lớp mốc; các lớp khác được tính lại từ mốc gần nhất khi lượt ngược cần tới. Đặt mốc cách nhau lớp thì bộ nhớ kích hoạt giảm từ xuống , đổi lại phải tính thêm khoảng một lượt xuôi, tức thời gian tăng khoảng một phần ba. Tích luỹ gradient (gradient accumulation) chia một lô lớn thành nhiều lô nhỏ, cộng dồn gradient của các lô nhỏ rồi mới cập nhật một lần. Kết quả tương đương huấn luyện với lô lớn, bộ nhớ chỉ bằng của lô nhỏ, nhưng không nhanh hơn. Có một chi tiết dễ quên: khi mất mát của mỗi lô nhỏ là trung bình trên lô đó, phải chia nó cho số lô nhỏ trước khi cộng dồn, nếu không gradient sẽ lớn gấp từng ấy lần so với khi huấn luyện thật với lô lớn (Karpathy, 2024).
5.4SGD, momentum và Adam#
Có gradient rồi, ta chuyển sang việc thứ hai. Gradient descent cập nhật với (Chương 5 của Nền tảng). Với mạng nơ-ron, là trung bình trên hàng triệu điểm dữ liệu, nên tính gradient đầy đủ ở mỗi bước là quá đắt. Cách giải quyết là SGD theo mini-batch: ước lượng bằng gradient trên một lô nhỏ điểm chọn ngẫu nhiên. Ước lượng này không chệch, và phương sai của nó giảm theo . Nhiễu của ước lượng không hoàn toàn có hại: nhiều nghiên cứu cho thấy nó giúp tránh một số điểm cực tiểu hẹp và có tác dụng như một dạng regularization, dù cơ chế chính xác vẫn đang được nghiên cứu.
Cải tiến đầu tiên là momentum, giữ một trung bình trượt của các gradient:
Trong một thung lũng hẹp và dài, gradient đổi dấu liên tục theo chiều ngang thung lũng và giữ cùng dấu theo chiều dọc. Trung bình trượt triệt tiêu phần dao động ngang và cộng dồn phần dọc, nên với , bước đi theo hướng ổn định lớn gấp khoảng lần. Mục 5.3 của Nền tảng đã đo được tác dụng này: số vòng lặp giảm từ bậc xuống bậc . CS231n và Andrew Ng cùng dùng hình ảnh một quả bóng lăn xuống dốc có ma sát: gradient đóng vai trò gia tốc, là vận tốc, còn là hệ số giữ lại vận tốc sau mỗi bước, tức phần bù của ma sát.
Các tài liệu viết momentum theo ba cách sai khác nhau một hệ số. Cách ở trên, , là cách của PyTorch. CS231n viết rồi cộng thẳng vào tham số, tương đương với cách trên. Andrew Ng viết , một trung bình trượt mũ thật sự, nên với cùng , bước đi nhỏ hơn lần, tức 10 lần khi . Khi chuyển công thức hay siêu tham số giữa các tài liệu, tốc độ học phải được chỉnh lại theo hệ số đó. Tên "trung bình trượt" cũng có nghĩa cụ thể: với , trọng số của giá trị cách đây 10 bước là , nên trung bình chủ yếu gồm khoảng giá trị gần nhất.
Adam (Kingma và Ba, 2015) đi xa hơn: giữ trung bình trượt của cả gradient và bình phương gradient, rồi chia từng toạ độ cho căn bậc hai của trung bình bình phương, nên mỗi tham số có một bước đi riêng:
Các giá trị mặc định là , , .
Hai phép chia cho gọi là hiệu chỉnh độ chệch (bias correction), và tên gọi này đúng theo nghĩa thống kê của Mục 2.2. Vì khởi tạo , khai triển công thức truy hồi được . Nếu các có cùng kỳ vọng thì
Như vậy là ước lượng chệch về phía 0 của , và chia cho cho ước lượng không chệch. Andrew Ng giảng điều này bằng trung bình trượt của nhiệt độ hằng ngày. Với nhiệt độ ba ngày đầu là 30, 32 và 31 °C và hệ số 0,9, trung bình trượt khởi tạo từ 0 cho 3; 5,9 và 8,41, thấp xa nhiệt độ thật; chia lần lượt cho , và được 30; 31,05 và 31,03. Cùng lập luận cho . Hai độ chệch này không bù trừ cho nhau, vì bị kéo về 0 mạnh hơn nhiều. Ở bước đầu, và , nên nếu không hiệu chỉnh, bước đi là theo dấu của , trong khi bước đã hiệu chỉnh là đúng . Với gradient không đổi, tỉ số giữa hai bước là : tăng lên tới khoảng 6,6 quanh bước 12, còn 3,2 ở bước 100 và vẫn còn 1,26 ở bước 1 000, vì tăng rất chậm. Bỏ hiệu chỉnh vì vậy làm các bước đầu lớn bất thường, không phải nhỏ đi; Kingma và Ba (2015) nêu đúng điều này. Khi lớn, và phép hiệu chỉnh không còn tác dụng gì.
Cuối cùng, AdamW (Loshchilov và Hutter, 2019) sửa cách Adam xử lý weight decay. Nếu thêm vào hàm mất mát rồi dùng Adam, gradient của thành phần phạt cũng bị chia cho , nên tham số có gradient lớn lại bị phạt ít hơn, ngược với mục đích của regularization. AdamW tách weight decay ra khỏi gradient và trừ trực tiếp ở mỗi bước. AdamW là lựa chọn mặc định khi huấn luyện Transformer. Bảng dưới so sánh hai nhóm thuật toán.
| SGD với momentum | Adam, AdamW | |
|---|---|---|
| Độ nhạy với tốc độ học | cao | thấp hơn nhiều |
| Tốc độ giảm mất mát ban đầu | chậm hơn | nhanh hơn |
| Tổng quát hoá | trên một số bài toán thị giác, tốt hơn (Wilson và cộng sự, 2017) | thường tốt, là mặc định cho Transformer |
| Bộ nhớ trạng thái | 1 giá trị mỗi tham số | 2 giá trị mỗi tham số |
Dòng cuối quan trọng khi huấn luyện mô hình lớn. Adam giữ và cho mọi tham số, thường ở FP32. Với mô hình 7 tỉ tham số, riêng trạng thái Adam đã chiếm GB. Mục 12.5 sẽ tính đầy đủ bộ nhớ huấn luyện.
5.5Lịch tốc độ học#
Tốc độ học là siêu tham số quan trọng nhất khi huấn luyện mạng nơ-ron, và cách thay đổi nó theo thời gian cũng quan trọng gần như vậy. Phần lớn lịch tốc độ học hiện nay bắt đầu bằng warmup: tăng tuyến tính tốc độ học từ gần 0 lên giá trị đích trong vài trăm tới vài nghìn bước đầu. Với Adam, ở các bước đầu được ước lượng từ rất ít gradient nên rất nhiễu, và bước đi có thể lớn bất thường; warmup tránh được những bước như vậy. Warmup cũng cần thiết với Transformer dùng post-LN (Mục 10.2).
Sau warmup, tốc độ học được giảm dần. Lịch phổ biến khi huấn luyện mô hình ngôn ngữ là cosine decay (Loshchilov và Hutter, 2017), giảm tốc độ học theo nửa chu kỳ hàm cosin về gần 0 ở bước cuối. Trong thị giác máy tính, lịch giảm theo bậc thang, tức chia tốc độ học cho 10 tại một số mốc định trước, vẫn còn phổ biến.
Khi tăng kích thước lô lên lần, gradient ít nhiễu hơn nên có thể dùng tốc độ học lớn hơn. Với SGD, Goyal và cộng sự (2017) dùng quy tắc tuyến tính: nhân tốc độ học với , kèm warmup, và huấn luyện được ResNet-50 trên ImageNet với lô 8 192 ảnh mà không giảm độ chính xác. Với Adam, Malladi và cộng sự (2022) lập luận rằng quy tắc phù hợp là nhân với . Cả hai là quy tắc kinh nghiệm có cơ sở lý thuyết một phần, và đều không còn đúng khi lô quá lớn.
Một lịch cụ thể cho thấy các thành phần này ghép với nhau ra sao. Khi tái hiện GPT-2 124 triệu tham số, Karpathy (2024) dùng AdamW với , , warmup tuyến tính trong 715 bước lên , rồi giảm theo cosine xuống ở bước 19 073, kèm cắt chuẩn gradient ở 1,0.
Đường mất mát cho biết tốc độ học đang ở mức nào: mất mát gần như không giảm là dấu hiệu tốc độ học quá nhỏ, còn mất mát tăng vọt hoặc thành NaN là dấu hiệu quá lớn. CS231n khuyên theo dõi thêm tỉ số giữa độ lớn của bước cập nhật và độ lớn của tham số, nên ở quanh . Và trước khi huấn luyện thật, nên cho mạng khớp hoàn toàn một tập rất nhỏ, chẳng hạn 20 mẫu: một mạng đủ lớn phải đưa được mất mát trên 20 mẫu đó về gần 0, nếu không thì mã có lỗi.
5.6Các hiểu lầm thường gặp#
Bảng dưới gom những hiểu lầm hay gặp về lan truyền ngược và tối ưu.
| Phát biểu | Thực tế |
|---|---|
| "Lan truyền ngược là thuật toán học." | Nó chỉ tính gradient. Việc cập nhật tham số do SGD, Adam hay thuật toán tối ưu khác đảm nhận. |
| "Mạng nơ-ron hay bị kẹt ở cực tiểu địa phương xấu." | Trong không gian nhiều chiều, điểm yên ngựa phổ biến hơn nhiều so với cực tiểu địa phương xấu (Dauphin và cộng sự, 2014), và thực nghiệm cho thấy các cực tiểu mà gradient descent tìm được trong mạng lớn thường có mất mát gần nhau. |
| "Adam luôn tốt hơn SGD." | Adam giảm mất mát nhanh hơn và ít phải chỉnh; SGD với momentum có thể tổng quát hoá tốt hơn trên một số bài toán thị giác. |
| "Gradient bằng 0 nghĩa là đã hội tụ." | Cũng có thể là điểm yên ngựa, đơn vị ReLU đã chết, hoặc gradient đã tiêu biến qua nhiều lớp. |
| "Lô càng lớn càng tốt." | Lô rất lớn làm mất phần nhiễu có ích, cần chỉnh lại tốc độ học, và lợi ích về thời gian giảm dần khi lô tăng. |
5.7Tóm tắt#
Lan truyền ngược tính gradient của hàm mất mát theo mọi tham số bằng quy tắc dây chuyền, đi từ đầu ra về đầu vào và dùng lại các giá trị đã lưu ở lượt xuôi; nhìn theo từng cổng, cổng cộng chia đều gradient, cổng nhân đổi chéo, cổng max chuyển gradient cho đầu vào lớn hơn, và gradient của một biến dùng ở nhiều chỗ là tổng các nhánh. Nhân các ma trận Jacobi theo chiều ngược làm mọi kết quả trung gian là vector, nên với hàm mất mát là một số, tính toàn bộ gradient chỉ tốn cỡ ba lần tính hàm. Đổi lại, các giá trị trung gian phải được giữ trong bộ nhớ, và phần bộ nhớ kích hoạt này tăng theo kích thước lô và độ dài chuỗi. Gradient được dùng bởi SGD theo mini-batch, momentum hoặc Adam; Adam chia bước đi theo từng tham số, cần hiệu chỉnh độ chệch ở các bước đầu và giữ hai giá trị trạng thái cho mỗi tham số, còn AdamW tách weight decay khỏi gradient. Momentum được viết theo nhiều quy ước sai khác nhau một hệ số , nên phải chỉnh tốc độ học khi đổi quy ước. Tốc độ học thường đi theo lịch warmup rồi giảm dần, và trước khi huấn luyện thật, kiểm tra gradient bằng sai số tương đối và cho mạng khớp một tập rất nhỏ là hai bước kiểm tra rẻ.
Với các công cụ này, ví dụ tính tay đã chạy đúng trên một mạng hai lớp. Khi mạng có hàng chục lớp, một vấn đề mới xuất hiện ngay trong công thức lan truyền ngược: gradient là tích của nhiều ma trận, và tích đó có thể co về 0 hoặc phình ra rất nhanh. Chương 6 xét vấn đề này.
6Khởi tạo, chuẩn hoá và kết nối tắt#
Ở Mục 4.4, một mạng 7 lớp, mỗi lớp 2 đơn vị, biểu diễn được hàm răng cưa 128 đoạn, nhưng gradient descent gần như không bao giờ tìm ra bộ trọng số đó. Một phần nguyên nhân nằm trong công thức lan truyền ngược của Chương 5: gradient tại một lớp là tích của các ma trận Jacobi của mọi lớp phía sau, và tích của nhiều thừa số hơi nhỏ hơn hoặc hơi lớn hơn 1 sẽ co về 0 hoặc phình ra rất nhanh. Trong một thời gian dài, đây là trở ngại khiến các mạng sâu vài chục lớp rất khó huấn luyện. Ba kỹ thuật giữ độ lớn của tín hiệu ổn định đã gỡ trở ngại đó: khởi tạo trọng số đúng phương sai, chuẩn hoá, và kết nối tắt. Một thí nghiệm trên mạng 40 lớp sẽ đo tác dụng của từng kỹ thuật, và cho một kết quả hay bị hiểu sai: kết nối tắt một mình không đủ.
6.1Tín hiệu co lại hoặc phình ra qua nhiều lớp#
Theo Mục 5.2, gradient theo đầu vào của một lớp là tích của các ma trận Jacobi của mọi lớp phía sau. Nếu mỗi lớp nhân độ lớn của gradient với một hệ số trung bình , thì qua lớp gradient bị nhân với khoảng . Với và , hệ số là ; với , hệ số là 117. Chỉ cần lệch khỏi 1 một chút, gradient ở các lớp đầu sẽ tiêu biến về gần 0 hoặc bùng nổ. Lượt xuôi gặp vấn đề tương tự với độ lớn của các giá trị kích hoạt.
Ba kỹ thuật trong chương này đều nhằm giữ gần 1, và chúng bổ sung cho nhau chứ không thay thế nhau.
6.2Khởi tạo Xavier và He#
Kỹ thuật đầu tiên tác động ngay từ bước khởi tạo. Trước hết, các trọng số không được khởi tạo bằng nhau, chẳng hạn cùng bằng 0: khi đó mọi đơn vị trong một lớp tính cùng một giá trị, nhận cùng một gradient và mãi giống hệt nhau, nên một lớp rộng 128 đơn vị chỉ làm được việc của một đơn vị (CS231n). Khởi tạo ngẫu nhiên phá vỡ sự đối xứng đó, và câu hỏi còn lại là phương sai bao nhiêu. Xét một lớp với . Giả sử các phần tử của độc lập, có trung bình 0 và phương sai , và độc lập với . Khi đó mỗi thành phần của có
Nếu có trung bình 0 thì , và muốn phương sai không đổi qua lớp thì cần . Áp dụng cùng lập luận cho lượt ngược, nơi gradient nhân với , cho điều kiện . Khởi tạo Xavier (Glorot và Bengio, 2010) dung hoà hai điều kiện bằng
Lập luận trên đúng với hàm kích hoạt gần tuyến tính quanh 0 như tanh. Với ReLU thì phải sửa lại: nếu đối xứng quanh 0 thì bằng 0 với một nửa số giá trị, nên
Thay vào công thức trên, phương sai giữ nguyên qua các lớp khi , tức
Đây là khởi tạo He (He và cộng sự, 2015). Hệ số 2 đến trực tiếp từ việc ReLU loại bỏ một nửa phân phối. Với các lớp rộng 128 đơn vị ở Mục 6.3, khởi tạo He lấy , tức độ lệch chuẩn 0,125, còn Xavier lấy , tức độ lệch chuẩn khoảng 0,088, nhỏ hơn lần. Lớp vuông che mất tính chất dung hoà của Xavier; với một lớp có và , điều kiện của lượt xuôi đòi phương sai , tức độ lệch chuẩn 0,044, điều kiện của lượt ngược đòi , tức 0,088, còn Xavier chọn , tức 0,056, nằm giữa hai giá trị đó. Dùng Xavier cho mạng ReLU thì mỗi lớp nhân độ lớn tín hiệu với khoảng , và qua 40 lớp còn . Nguyên tắc chung là khởi tạo phải khớp với hàm kích hoạt: Xavier cho tanh và sigmoid, He cho ReLU và các biến thể gần giống.
6.3Thí nghiệm với mạng 40 lớp#
Thí nghiệm trong code/models/experiments.py dùng một mạng 40 lớp, mỗi lớp rộng 128 đơn vị ReLU, với một lô 128 đầu vào ngẫu nhiên. Sau lượt xuôi, một gradient ngẫu nhiên có chuẩn 1 được truyền ngược từ lớp cuối, và thí nghiệm đo chuẩn của gradient theo giá trị kích hoạt tại từng lớp. Kết quả lấy trung bình trên 5 lần khởi tạo và chia cho giá trị ở lớp cuối. Trọng số được khởi tạo với phương sai , nên khởi tạo He ứng với .
Sáu cách dựng lớp được so sánh. Ba cách đầu là mạng thường, mỗi lớp tính , với ba mức gain 0,5, và 2,0. Cách thứ tư thêm LayerNorm trước ReLU: . Cách thứ năm thêm kết nối tắt mà không chuẩn hoá: . Cách thứ sáu dùng cả hai, , với chuẩn hoá nằm trong nhánh còn đường tắt đi thẳng, cùng nguyên tắc với pre-LN của Transformer (Mục 10.2). Ba cách sau đều dùng khởi tạo He.
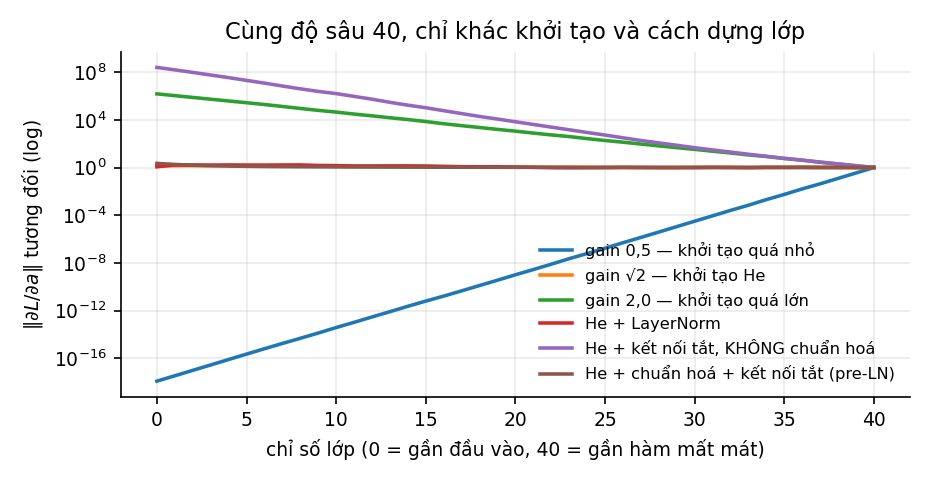
| Cách dựng lớp | Gradient tại lớp 1 so với lớp 40 | Kết luận |
|---|---|---|
| Khởi tạo với gain 0,5 (quá nhỏ) | tiêu biến | |
| Khởi tạo He, gain | ổn định | |
| Khởi tạo với gain 2,0 (quá lớn) | bùng nổ | |
| He và LayerNorm | ổn định | |
| He và kết nối tắt, không chuẩn hoá | bùng nổ | |
| He, chuẩn hoá trong nhánh và kết nối tắt | ổn định |
Ba dòng đầu cho thấy khởi tạo có ảnh hưởng rất lớn. Trên cùng một kiến trúc, chỉ đổi gain từ 0,5 sang 2,0 làm gradient ở lớp đầu thay đổi từ tới , tức 24 bậc độ lớn. Với gain 0,5, mỗi lớp nhân gradient với khoảng , và . Khởi tạo He thì giữ gradient gần như không đổi, với tỉ lệ 1,42 sau 40 lớp, đúng như lập luận ở Mục 6.2.
Dòng thứ năm là kết quả hay bị hiểu sai nhất: kết nối tắt một mình làm gradient bùng nổ. Với khởi tạo He, nhánh có độ lớn cùng cỡ với , nên mỗi lớp cộng thêm vào tín hiệu một lượng xấp xỉ bằng chính nó, và độ lớn của tín hiệu tăng gần gấp đôi sau mỗi lớp. Ở lượt ngược, Jacobi của mỗi lớp là với có độ lớn cỡ 1, và tích của 40 ma trận như vậy tăng theo cấp số nhân. Vì vậy mạng ResNet luôn có chuẩn hoá đi kèm kết nối tắt.
Dòng cuối cho thấy cách kết hợp đúng: chuẩn hoá trong nhánh kèm đường tắt đi thẳng cho gradient ổn định, với tỉ lệ 2,22. Chuẩn hoá giữ đầu ra của mỗi nhánh ở độ lớn cố định, nên tín hiệu chỉ tăng theo kiểu cộng dồn thay vì nhân lên, còn đường tắt bảo đảm gradient luôn có một đường đi không qua ma trận trọng số nào. Đây là cấu hình mà các Transformer hiện nay dùng (Mục 10.2).
Trang thí nghiệm tương tác của giáo trình cho phép tự chọn gain, số lớp và các thành phần để quan sát các đường trong Hình 7.
Hai bài giảng nổi tiếng quan sát cùng hiện tượng theo hai cách khác, cũng nên dùng khi gỡ lỗi. CS231n vẽ phân phối giá trị kích hoạt ở từng lớp của một mạng 10 lớp tanh: khởi tạo quá nhỏ làm các giá trị co dần về 0 ở các lớp sâu, quá lớn làm chúng dồn về , tức tanh bão hoà, còn Xavier giữ được phân phối qua mọi lớp; chuyển sang ReLU thì Xavier lại làm các giá trị co dần, và phải thêm hệ số 2 của He. Karpathy, trong bài giảng makemore về giá trị kích hoạt và gradient, theo dõi trong khi huấn luyện tỉ lệ đơn vị tanh bão hoà, với , và tỉ số giữa độ lớn của bước cập nhật và độ lớn của tham số ở từng lớp, nên ở quanh như Mục 5.5.
6.4BatchNorm, LayerNorm và RMSNorm#
Kỹ thuật thứ hai là chuẩn hoá. Các lớp chuẩn hoá đưa giá trị kích hoạt về trung bình 0, phương sai 1, rồi nhân với một hệ số và cộng một độ dịch học được, để mạng vẫn biểu diễn được mọi thang đo nếu cần:
Các phương pháp khác nhau ở tập giá trị dùng để tính và , như bảng dưới cho thấy.
| BatchNorm (Ioffe và Szegedy, 2015) | LayerNorm (Ba, Kiros và Hinton, 2016) | |
|---|---|---|
| Tính thống kê trên | mọi mẫu trong lô, riêng cho từng đặc trưng (từng kênh) | mọi đặc trưng của một mẫu, riêng cho từng mẫu |
| Phụ thuộc kích thước lô | có: lô nhỏ cho thống kê nhiễu | không |
| Khác nhau giữa huấn luyện và suy luận | có: suy luận dùng trung bình trượt tích luỹ khi huấn luyện | không |
| Dùng phổ biến trong | mạng tích chập cho ảnh | Transformer, RNN |
Transformer dùng LayerNorm thay cho BatchNorm, và ba hàng đầu của bảng giải thích vì sao. Các chuỗi trong một lô có độ dài khác nhau và được đệm thêm, nên thống kê theo lô trên trục thời gian bị phần đệm làm sai lệch. BatchNorm dùng thống kê của lô khi huấn luyện và trung bình trượt khi suy luận; khi sinh văn bản từng token, mỗi bước chỉ xử lý một vị trí, và khác biệt giữa hai chế độ trở thành một nguồn sai lệch. Ngoài ra, với BatchNorm, dự đoán cho một mẫu phụ thuộc vào các mẫu khác cùng lô, điều không mong muốn khi phục vụ nhiều người dùng cùng lúc.
RMSNorm (Zhang và Sennrich, 2019) đơn giản hoá LayerNorm bằng cách bỏ bước trừ trung bình và độ dịch , chỉ chia cho căn trung bình bình phương:
Với vector , và , LayerNorm trừ trung bình 3, chia cho độ lệch chuẩn , với phương sai tính bằng mẫu số như các thư viện làm, và cho . RMSNorm chỉ chia cho căn trung bình bình phương và cho : các phần tử giữ nguyên dấu và tỉ lệ với nhau, chỉ thang đo thay đổi. Phép tính rẻ hơn LayerNorm, và thực nghiệm cho chất lượng tương đương. RMSNorm là lựa chọn của nhiều mô hình ngôn ngữ hiện nay, như Llama.
Hai chi tiết cài đặt của BatchNorm hay gây nhầm. Hệ số chặn của lớp đứng ngay trước BatchNorm là thừa, vì phép trừ trung bình triệt tiêu nó; độ dịch đã làm việc đó. Còn tham số momentum của BatchNorm trong PyTorch, mặc định 0,1, là trọng số dành cho lô mới khi cập nhật trung bình trượt dùng lúc suy luận, ngược với vai trò của trong momentum ở Mục 5.4.
Vì sao chuẩn hoá giúp huấn luyện vẫn còn được thảo luận. Bài báo gốc của BatchNorm giải thích bằng việc giảm "dịch chuyển hiệp biến nội tại" (internal covariate shift), nhưng Santurkar và cộng sự (2018) cho thấy lợi ích chủ yếu đến từ việc làm hàm mất mát trơn hơn, cho phép dùng tốc độ học lớn hơn. Tác dụng giữ ổn định độ lớn của tín hiệu, đo được ở Mục 6.3, là một phần của lời giải thích đó.
6.5Kết nối tắt#
Kỹ thuật thứ ba thay bằng
trong đó là một khối gồm vài lớp. Có hai cách hiểu bổ sung cho nhau.
Cách hiểu thứ nhất nhìn theo đường đi của gradient. Jacobi của một khối là , và số hạng bảo đảm gradient luôn có một đường đi thẳng từ đầu ra về đầu vào mà không nhân với ma trận trọng số nào. Qua nhiều khối, tích khai triển thành tổng của mọi tích con, trong đó có số hạng , nên không tự co về 0 như .
Cách hiểu thứ hai nhìn theo bài toán cần học. Thay vì học trực tiếp hàm , khối học phần dư . Nếu ánh xạ đồng nhất đã là một xấp xỉ tốt, khối chỉ cần học một hiệu chỉnh nhỏ, và khởi tạo đã là một điểm xuất phát tốt. Đây là lập luận của bài báo ResNet (He và cộng sự, 2016), xuất phát từ vấn đề suy thoái (degradation problem): trên CIFAR-10, mạng thường 56 lớp có sai số huấn luyện cao hơn mạng 20 lớp. Mạng 56 lớp biểu diễn được mọi hàm mà mạng 20 lớp biểu diễn được, chỉ cần 36 lớp thừa là ánh xạ đồng nhất, nên sai số huấn luyện cao hơn không phải do overfitting mà do khó tối ưu. Kết nối tắt làm ánh xạ đồng nhất trở nên dễ biểu diễn, và mạng ResNet với hơn 100 lớp huấn luyện được bình thường. d2l.ai diễn đạt cùng lập luận bằng các họ hàm lồng nhau: nếu khối mới biểu diễn được ánh xạ đồng nhất thì họ hàm của mạng sâu hơn chứa họ hàm của mạng nông hơn, nên thêm khối không thể làm mạng kém đi về mặt biểu diễn.
Một cách khác để giữ độ lớn của tín hiệu trên đường tắt là thu nhỏ các nhánh ngay từ lúc khởi tạo. GPT-2 nhân trọng số ở lối ra của mỗi nhánh dư với , với là số nhánh dư trong mạng (Radford và cộng sự, 2019). Nếu mỗi nhánh đóng góp một lượng có phương sai cỡ , tổng của nhánh cộng dồn có phương sai cỡ 1, thay vì tăng tỉ lệ với độ sâu như dòng thứ năm của bảng ở Mục 6.3.
Lưu ý
Kết nối tắt ra đời để giải quyết vấn đề suy thoái, tức sai số huấn luyện tăng theo độ sâu, không phải để chống overfitting. Và như Mục 6.3 cho thấy, kết nối tắt cần đi kèm chuẩn hoá thì gradient mới ổn định.
6.6Dropout và các phương pháp regularization khác#
Ba kỹ thuật trên giúp huấn luyện được mạng sâu; còn lại là chống overfitting. Phương pháp regularization riêng của mạng nơ-ron được dùng nhiều nhất là dropout (Srivastava và cộng sự, 2014). Khi huấn luyện, mỗi đơn vị bị đặt bằng 0 với xác suất , độc lập ở mỗi bước, và các đơn vị còn lại được chia cho để kỳ vọng của đầu ra không đổi; cách làm này gọi là inverted dropout. Chẳng hạn với , một lớp có đầu ra có thể bị giữ lại phần tử thứ nhất và thứ ba ở một bước, thành sau khi chia cho . Mỗi phần tử được nhân đôi với xác suất 0,5 và bằng 0 với xác suất 0,5, nên kỳ vọng của nó đúng bằng giá trị ban đầu. Các tài liệu dùng hai quy ước cho : PyTorch và d2l.ai dùng xác suất bị bỏ như ở đây, còn CS231n và Andrew Ng dùng xác suất được giữ lại. Khi suy luận, dropout bị tắt và mạng dùng mọi đơn vị. Mỗi bước huấn luyện vì vậy dùng một mạng con khác nhau chia sẻ trọng số, và mạng đầy đủ khi suy luận xấp xỉ trung bình của rất nhiều mạng con. Cơ chế giảm phương sai vì thế tương tự bagging ở Mục 3.3, nhưng không phải huấn luyện nhiều mô hình.
Với mô hình ngôn ngữ lớn, vai trò của dropout giảm nhiều. Khi tiền huấn luyện trên kho dữ liệu cực lớn, mỗi mẫu thường chỉ được xem một lần nên overfitting không phải vấn đề chính, và một số mô hình như PaLM (Chowdhery và cộng sự, 2022) không dùng dropout khi tiền huấn luyện. Dropout vẫn hữu ích khi tinh chỉnh trên tập dữ liệu nhỏ. Bảng dưới đặt dropout cạnh các phương pháp regularization khác.
| Phương pháp | Cơ chế | Dùng ở đâu |
|---|---|---|
| Weight decay | phạt chuẩn của trọng số (Mục 9.2 của Nền tảng); với Adam phải dùng dạng AdamW (Mục 5.4) | hầu hết mọi nơi |
| Dropout | huấn luyện trên các mạng con ngẫu nhiên | MLP, mạng tích chập, tinh chỉnh; ít dùng khi tiền huấn luyện LLM |
| Dừng sớm | dừng khi sai số xác thực ngừng giảm | hầu hết mọi nơi; rẻ nhất |
| Tăng cường dữ liệu | tạo thêm mẫu bằng các biến đổi giữ nguyên nhãn: lật, cắt, xoay ảnh, thêm nhiễu vào âm thanh | ảnh, âm thanh |
| Làm mượt nhãn | thay nhãn one-hot bằng , để mô hình không bị đẩy tới xác suất tuyệt đối 0 và 1 (Szegedy và cộng sự, 2016) | phân loại nhiều lớp |
Weight decay có một cách hiểu từ Nền tảng: regularization tương đương ước lượng MAP với tiên nghiệm Gauss trên trọng số (Chương 10 của Nền tảng). Dừng sớm cũng có liên hệ với regularization: với hồi quy tuyến tính, dừng gradient descent sau bước cho kết quả gần giống hồi quy ridge với tỉ lệ nghịch với . Andrew Ng lưu ý rằng dừng sớm gộp hai việc vốn nên tách riêng, giảm mất mát huấn luyện và chống overfitting, nên khi tài nguyên cho phép thử nhiều giá trị của hệ số regularization, ông thích dùng regularization hơn. Trong thực hành, weight decay thường chỉ áp dụng cho các ma trận trọng số, không áp dụng cho hệ số chặn và tham số của các lớp chuẩn hoá (Karpathy, 2024).
6.7Tóm tắt#
Qua nhiều lớp, gradient bị nhân với tích của các ma trận Jacobi, nên chỉ cần mỗi lớp lệch khỏi hệ số 1 một chút là gradient tiêu biến hoặc bùng nổ. Khởi tạo phải phá vỡ đối xứng giữa các đơn vị và khớp với hàm kích hoạt: Xavier cho tanh, He với phương sai cho ReLU. Chuẩn hoá giữ đầu ra mỗi lớp ở độ lớn cố định; Transformer dùng LayerNorm hoặc RMSNorm thay BatchNorm vì không muốn phụ thuộc vào lô. Kết nối tắt cho gradient một đường đi thẳng và giải quyết vấn đề suy thoái, và GPT-2 còn thu nhỏ các nhánh dư theo lúc khởi tạo; nhưng thí nghiệm với mạng 40 lớp cho thấy kết nối tắt làm gradient bùng nổ tới lần nếu không có chuẩn hoá trong nhánh. Dropout, weight decay và dừng sớm lo phần chống overfitting, dù vai trò của dropout giảm nhiều khi tiền huấn luyện mô hình ngôn ngữ lớn.
Với các kỹ thuật này, ta huấn luyện được mạng hàng trăm lớp. Nhưng mạng kết nối đầy đủ vẫn rất lãng phí khi đầu vào là ảnh: chỉ riêng một lớp nhận ảnh và cho 1 000 đơn vị ẩn đã cần khoảng 150 triệu tham số. Chương 7 trình bày một kiến trúc khai thác cấu trúc không gian của ảnh, nhờ đó số tham số giảm đi hàng nghìn lần.
7Mạng nơ-ron tích chập#
Ảnh có một cấu trúc mà dữ liệu dạng bảng không có: các điểm ảnh gần nhau liên quan với nhau, và một chi tiết như cạnh hay góc có ý nghĩa như nhau dù xuất hiện ở đâu trong ảnh. Một mạng kết nối đầy đủ bỏ qua cấu trúc đó, nên phải học riêng cho từng vị trí và cần số tham số khổng lồ. Mạng nơ-ron tích chập (convolutional neural network, CNN) đưa hai tính chất trên vào chính kiến trúc, và nhờ vậy giảm số tham số đi hàng nghìn lần. Ta bắt đầu từ phép tích chập và các phép tính kích thước, tham số, chi phí đi kèm, rồi xem các khối mà CNN hiện đại ghép từ đó, so sánh CNN với Vision Transformer, và cuối cùng là hai bài toán thị giác ngoài phân loại ảnh: phát hiện đối tượng và phân đoạn ảnh.
7.1Phép tích chập#
Một lớp kết nối đầy đủ nhận ảnh và cho 1 000 đơn vị ẩn cần tham số, chỉ cho một lớp. Mạng tích chập giảm con số đó bằng ba giả định về ảnh, tóm tắt trong bảng dưới.
| Giả định | Cách thực hiện | Tác dụng |
|---|---|---|
| Đặc trưng có tính cục bộ | mỗi đơn vị chỉ nối với một vùng nhỏ của lớp trước | số kết nối của mỗi đơn vị không phụ thuộc kích thước ảnh |
| Một đặc trưng hữu ích ở một vị trí thì cũng hữu ích ở vị trí khác | chia sẻ trọng số: cùng một bộ lọc quét qua mọi vị trí | số tham số không phụ thuộc kích thước ảnh |
| Vị trí chính xác của đặc trưng ít quan trọng hơn sự có mặt của nó | gộp (pooling) hoặc bước nhảy lớn hơn 1 | giảm độ phân giải; bất biến gần đúng với dịch chuyển nhỏ |
Định nghĩa 7.1 (Lớp tích chập hai chiều)
Cho đầu vào và bộ lọc . Lớp tích chập với bước nhảy tính
Mỗi kênh đầu ra ứng với một bộ lọc, và giá trị tại vị trí là tích vô hướng giữa bộ lọc và vùng ảnh tương ứng.
Về mặt toán học, công thức trên là phép tương quan chéo (cross-correlation), vì bộ lọc không bị lật như trong định nghĩa tích chập của xử lý tín hiệu. Bộ lọc được học từ dữ liệu, nên lật hay không cũng không thay đổi những gì mạng biểu diễn được, và trong học sâu cả hai được gọi chung là tích chập.
Một ví dụ nhỏ cho thấy bộ lọc làm gì. Một ảnh xám cao 3, rộng 5 điểm, có mọi hàng là : phần trái tối, phần phải sáng, và một cạnh dọc ở giữa. Bộ lọc có mọi hàng là ; tại mỗi vị trí, nó cộng trên ba hàng hiệu giữa điểm ảnh bên phải và điểm ảnh bên trái của cửa sổ. Không đệm và bước nhảy 1, đầu ra có kích thước và bằng : bằng 0 ở vùng đồng nhất, bằng 3 ở hai vị trí mà cửa sổ chứa cạnh. Đây là một bộ dò cạnh dọc, và các lớp tích chập đầu tiên của một CNN đã huấn luyện thường học được những bộ dò cạnh theo nhiều hướng như vậy. Andrew Ng giảng phép tích chập theo đúng thứ tự này, bộ lọc viết tay trước rồi mới tới ý chính: trong CNN, chín con số của bộ lọc là tham số học từ dữ liệu, không phải do người thiết kế.
Khi thiết kế một mạng tích chập, ba phép tính được dùng liên tục. Phép tính đầu tiên là kích thước đầu ra. Với đầu vào cao , bộ lọc cao , bước nhảy và phần đệm (padding) ô mỗi phía, chiều cao đầu ra là
và chiều rộng tính tương tự. Không phải tổ hợp nào cũng khớp: với , , và không đệm, không nguyên, phép lấy phần nguyên cho đầu ra cao 2, và hàng cuối của ảnh không bao giờ được bộ lọc đi qua; CS231n coi đó là một cấu hình cần tránh. Phép tính thứ hai là số tham số: một lớp tích chập có tham số, không phụ thuộc kích thước ảnh. Phép tính thứ ba là số phép tính, và con số này thì có phụ thuộc vào kích thước ảnh: mỗi giá trị đầu ra cần phép nhân và cộng, nên cả lớp tốn khoảng
Ví dụ 7.1 (Lớp đầu của ResNet-50)
Lớp tích chập đầu tiên nhận ảnh , dùng 64 bộ lọc , bước nhảy 2, phần đệm 3. Kích thước đầu ra là , tức . Số tham số là (lớp này không có hệ số chặn vì có BatchNorm theo sau). Số phép tính là FLOP. So với lớp kết nối đầy đủ ở đầu mục, số tham số nhỏ hơn khoảng 16 000 lần.
Sự tách rời giữa số tham số và số phép tính hay gây nhầm lẫn khi ước lượng chi phí. Một mô hình "nhẹ" về tham số vẫn có thể rất tốn tính toán khi chạy trên ảnh độ phân giải cao, vì số phép tính tăng theo diện tích ảnh. Bộ nhớ cho giá trị kích hoạt cũng vậy: CS231n tính rằng VGG-16 cần khoảng 93 MB chỉ để lưu giá trị kích hoạt của một ảnh ở lượt xuôi, phần lớn ở các lớp tích chập đầu nơi ảnh còn lớn, trong khi phần lớn 138 triệu tham số của nó nằm ở các lớp kết nối đầy đủ cuối mạng.
Chia sẻ trọng số còn làm lớp tích chập đẳng biến với phép dịch chuyển (translation equivariant): dịch ảnh đầu vào đi một số ô thì bản đồ đặc trưng đầu ra dịch theo đúng số ô đó, nếu bỏ qua hiệu ứng ở biên. Với ảnh cạnh dọc ở trên, thêm một cột tối vào bên trái, tức ảnh rộng 6 điểm và cạnh dịch sang phải một ô, thì đầu ra rộng 4 và bằng : hai giá trị 3 dịch theo đúng một ô. Gộp và bước nhảy biến tính đẳng biến này thành bất biến gần đúng: một dịch chuyển nhỏ không làm thay đổi đầu ra sau khi gộp. Nhiều tài liệu, kể cả d2l.ai và CS231n, gọi chung cả hai tính chất là bất biến; nói chặt chẽ thì tích chập đẳng biến, còn gộp mới đưa lại bất biến gần đúng. Tính bất biến này chỉ gần đúng; Azulay và Weiss (2019) cho thấy các CNN hiện đại có thể đổi dự đoán khi ảnh chỉ dịch đi một điểm ảnh, vì bước nhảy lớn hơn 1 phá vỡ tính đẳng biến.
7.2Trường tiếp nhận#
Mỗi đơn vị của lớp tích chập chỉ nhìn một vùng nhỏ của lớp trước. Muốn nhận ra một đối tượng lớn, mạng phải chồng nhiều lớp để vùng nhìn thấy của các đơn vị ở sâu lớn dần lên.
Định nghĩa 7.2 (Trường tiếp nhận)
Trường tiếp nhận (receptive field) của một đơn vị là vùng của ảnh đầu vào có ảnh hưởng tới giá trị của đơn vị đó.
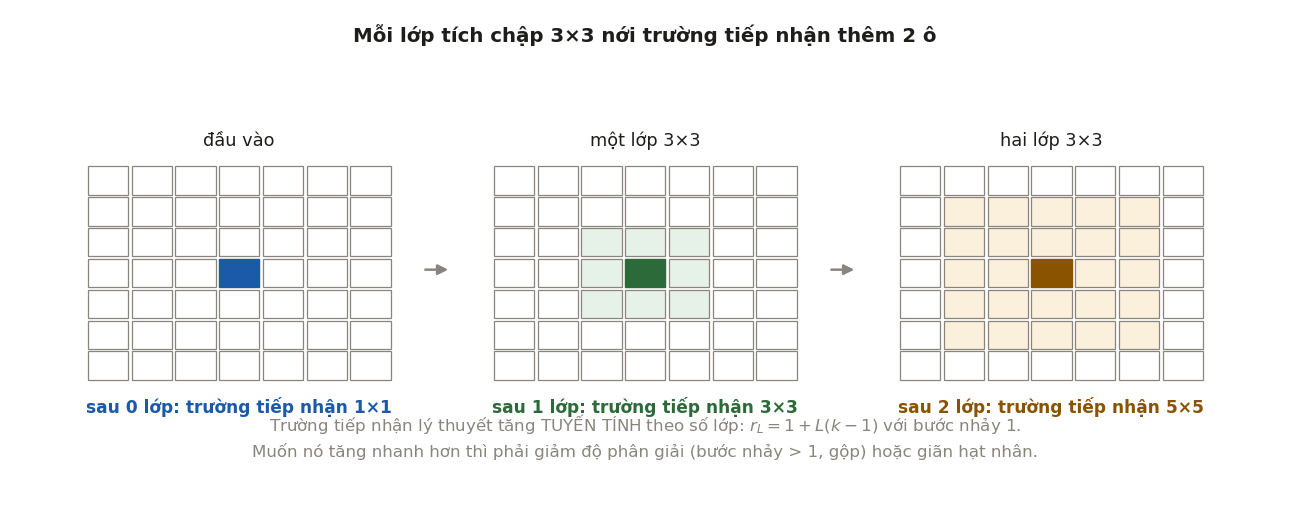
Với lớp thứ có bộ lọc kích thước và bước nhảy , kích thước trường tiếp nhận tính theo công thức truy hồi
Tích các bước nhảy phía trước cho biết một ô ở lớp ứng với bao nhiêu điểm ảnh của đầu vào. Với bước nhảy 1 và bộ lọc ở mọi lớp, : trường tiếp nhận chỉ tăng tuyến tính theo số lớp, và phải cần tới 112 lớp mới phủ được ảnh rộng 224 điểm. Vì vậy các CNN thực tế đều giảm độ phân giải sớm: sau mỗi lần bước nhảy 2, mọi lớp phía sau mở rộng trường tiếp nhận nhanh gấp đôi. Chẳng hạn, lớp bước nhảy 2 cho ; lớp gộp bước nhảy 2 phía sau đưa lên ; mỗi lớp tiếp theo thêm điểm ảnh.
Công thức này dẫn tới hai hệ quả trong thiết kế. Hai lớp có cùng trường tiếp nhận với một lớp , nhưng dùng trọng số cho mỗi cặp kênh thay vì 25, và có thêm một hàm phi tuyến ở giữa. Tương tự, ba lớp thay được một lớp với 27 thay vì 49 trọng số. Đây là lập luận của mạng VGG (Simonyan và Zisserman, 2015), và giải thích vì sao bộ lọc lớn ít được dùng trong các mạng sau đó.
Hệ quả thứ hai là trường tiếp nhận hiệu dụng nhỏ hơn nhiều so với con số lý thuyết. Cần để ý tên gọi: CS231n dùng "trường tiếp nhận hiệu dụng" cho chính trường tiếp nhận lý thuyết của nhiều lớp chồng lên nhau, như của hai lớp , còn ở đây, theo Luo và cộng sự, tên gọi chỉ vùng có ảnh hưởng thật sự đáng kể. Luo và cộng sự (2016) cho thấy ảnh hưởng của các điểm ảnh lên một đơn vị có phân bố gần với phân phối Gauss tập trung ở giữa trường tiếp nhận, và độ rộng hiệu dụng chỉ tăng theo thay vì . Các điểm ảnh ở rìa trường tiếp nhận lý thuyết gần như không có ảnh hưởng.
7.3Các khối thường dùng#
Các CNN hiện đại được ghép từ một số khối chuẩn. Bảng dưới liệt kê những khối hay gặp nhất cùng tác dụng của chúng.
| Khối | Cấu tạo | Tác dụng |
|---|---|---|
| Tích chập | bộ lọc kích thước | trộn thông tin giữa các kênh tại từng vị trí; thay đổi số kênh với chi phí thấp |
| Khối cổ chai (bottleneck) | giảm số kênh, , rồi tăng lại số kênh | giảm mạnh số phép tính ở cùng độ sâu; dùng trong ResNet-50 trở lên |
| Tích chập tách theo chiều sâu (depthwise separable) | tích chập riêng cho từng kênh, rồi tích chập | giảm chi phí khoảng lần; là nền tảng của MobileNet (Howard và cộng sự, 2017) |
| Khối dư (residual block) | cho phép mạng sâu hàng trăm lớp (Mục 6.5) | |
| Gộp trung bình toàn cục | lấy trung bình mỗi kênh trên toàn bộ không gian trước lớp phân loại | bỏ được lớp kết nối đầy đủ lớn ở cuối mạng; nhận ảnh có kích thước bất kỳ |
Khối cổ chai cho thấy tích chập tiết kiệm được bao nhiêu. Ở độ phân giải với 256 kênh, một tích chập giữ nguyên 256 kênh tốn phép nhân–cộng. Khối cổ chai của ResNet-50 giảm còn 64 kênh bằng tích chập , chạy tích chập trên 64 kênh, rồi tăng lại 256 kênh: , ít hơn khoảng 8,5 lần. Andrew Ng dùng cùng kiểu phép tính với khối Inception để giới thiệu tích chập .
Với tích chập tách theo chiều sâu, số trọng số của tích chập thường là , còn của phiên bản tách là . Tỉ lệ giữa hai con số là
Với và , tỉ lệ là 0,115, tức rẻ hơn khoảng 8,7 lần, và số phép tính giảm theo cùng tỉ lệ. Đổi lại, mỗi kênh của lớp depthwise chỉ có 9 trọng số, và dải giá trị của các kênh có thể chênh nhau rất nhiều; Mục 5.3 của Quantization cho thấy đây là loại lớp nhạy nhất khi lượng tử hoá với một thang đo chung cho cả lớp.
7.4CNN và Vision Transformer#
Từ năm 2020, CNN có một đối thủ trên chính sân nhà của nó. Vision Transformer (ViT; Dosovitskiy và cộng sự, 2021) cắt ảnh thành các mảnh điểm ảnh, chiếu mỗi mảnh thành một vector, rồi xử lý dãy vector như dãy token bằng Transformer (Chương 9). Ảnh cho token.
Khác biệt giữa hai kiến trúc là khác biệt về thiên kiến quy nạp (Mục 1.4). CNN đưa sẵn vào kiến trúc tính cục bộ và tính đẳng biến với dịch chuyển; đây là giả định đúng với ảnh tự nhiên, nên CNN học được từ lượng dữ liệu vừa phải. ViT gần như không giả định gì về cấu trúc không gian: mọi mảnh có thể tương tác với mọi mảnh ngay từ lớp đầu, và mô hình phải tự học từ dữ liệu những quan hệ mà CNN có sẵn. Kết quả trong bài báo ViT phản ánh đúng đánh đổi này: khi chỉ huấn luyện trên ImageNet (1,3 triệu ảnh), ViT kém các mạng ResNet cùng cỡ; khi tiền huấn luyện trên tập JFT-300M (300 triệu ảnh), ViT vượt ResNet.
Theo ngôn ngữ của Chương 2, thiên kiến quy nạp mạnh ứng với độ chệch cao hơn và phương sai thấp hơn: có lợi khi dữ liệu ít, trở thành giới hạn khi dữ liệu nhiều. Khoảng cách giữa hai họ cũng không cố định. ConvNeXt (Liu và cộng sự, 2022) cho thấy một CNN được hiện đại hoá theo các lựa chọn thiết kế của Transformer cạnh tranh được với ViT ở cùng quy mô, và nhiều kiến trúc hiện nay kết hợp tích chập với attention.
7.5Phát hiện đối tượng#
Phân loại ảnh trả lời câu hỏi "ảnh có gì". Phát hiện đối tượng (object detection) trả lời thêm câu hỏi "ở đâu": đầu ra là một danh sách hộp bao (bounding box), mỗi hộp kèm nhãn lớp và một điểm tin cậy. Số đối tượng thay đổi theo từng ảnh, nên đầu ra không có kích thước cố định như bài toán phân loại, và phần lớn cấu trúc của các bộ phát hiện đến từ việc giải quyết điều này.
Một hộp thường được biểu diễn bằng toạ độ góc trên bên trái và góc dưới bên phải , hoặc bằng tâm và kích thước . Để so sánh hai hộp, cần một thước đo mức trùng khớp.
Định nghĩa 7.3 (IoU)
Độ trùng khớp IoU (intersection over union) giữa hai hộp và là tỉ số giữa diện tích phần giao và diện tích phần hợp:
IoU nằm trong , bằng 1 khi hai hộp trùng nhau hoàn toàn và bằng 0 khi chúng không giao nhau.
Ví dụ 7.2
Hộp và : phần giao là hình vuông , diện tích 4; phần hợp là ; nên . Hộp chỉ là dịch sang phải 1 đơn vị: giao , hợp , IoU . Hộp là nửa trên của : IoU . Ví dụ cuối cho thấy một hộp chỉ phủ nửa đối tượng vẫn đạt ngưỡng 0,5 thường dùng khi đánh giá.
Các bộ phát hiện dựa trên CNN chia thành hai họ. Họ hai giai đoạn (two-stage) đề xuất trước các vùng có khả năng chứa đối tượng, rồi mới phân loại từng vùng và tinh chỉnh hộp. Đại diện đầu tiên là R-CNN (Girshick và cộng sự, 2014), lấy khoảng 2 000 vùng đề xuất từ thuật toán selective search và chạy CNN riêng trên từng vùng, nên rất chậm. Fast R-CNN (Girshick, 2015) chạy CNN một lần cho cả ảnh rồi cắt đặc trưng của từng vùng bằng phép RoI pooling. Faster R-CNN (Ren và cộng sự, 2015) thay selective search bằng một mạng đề xuất vùng (region proposal network, RPN) dùng chung đặc trưng với phần phát hiện, nên toàn bộ hệ thống trở thành một mạng nơ-ron huấn luyện được từ đầu tới cuối.
Họ một giai đoạn (one-stage) bỏ bước đề xuất vùng và dự đoán trực tiếp hộp cùng lớp trên một lưới dày đặc. YOLO (Redmon và cộng sự, 2016) chia ảnh thành lưới ; mỗi ô dự đoán 2 hộp và xác suất của 20 lớp, nên đầu ra là một tensor , và mô hình chạy được 45 khung hình mỗi giây. SSD (Liu và cộng sự, 2016) dự đoán trên nhiều bản đồ đặc trưng có độ phân giải khác nhau, để bản đồ chi tiết bắt đối tượng nhỏ còn bản đồ thô bắt đối tượng lớn.
Bộ một giai đoạn thường nhanh hơn, còn bộ hai giai đoạn từng chính xác hơn. Lin và cộng sự (2017) chỉ ra nguyên nhân chính của khoảng cách này: bộ một giai đoạn đánh giá hàng chục nghìn vị trí trên mỗi ảnh, phần lớn là nền dễ nhận ra, và tổng hàm mất mát của số đông mẫu dễ này lấn át số ít đối tượng thật. Họ đề xuất focal loss:
trong đó là xác suất mô hình gán cho lớp đúng và là trọng số theo lớp. Hệ số giảm trọng số của các mẫu đã được phân loại tốt: với , một mẫu có nhận trọng số , tức đóng góp nhỏ hơn 100 lần so với cross-entropy, còn một mẫu khó với nhận trọng số . Bộ phát hiện một giai đoạn RetinaNet dùng hàm mất mát này đạt độ chính xác của các bộ hai giai đoạn cùng thời.
Một chi tiết chung của Faster R-CNN, SSD và RetinaNet là hộp neo (anchor box). Tại mỗi vị trí trên bản đồ đặc trưng, mô hình đặt một số hộp có kích thước và tỉ lệ cạnh định trước; RPN của Faster R-CNN dùng 3 kích thước và 3 tỉ lệ, tức 9 hộp neo mỗi vị trí. Mạng không dự đoán toạ độ tuyệt đối mà dự đoán độ lệch so với hộp neo:
với là tâm và kích thước của hộp, chỉ số chỉ hộp neo. Chia cho kích thước hộp neo làm độ lệch không phụ thuộc vào kích thước đối tượng, còn logarit làm phép co giãn đối xứng: hộp lớn gấp đôi hay nhỏ đi một nửa cho bằng hay . Khi huấn luyện, mỗi hộp neo được gán nhãn theo IoU với các hộp thật: trong RPN, hộp neo có IoU lớn hơn 0,7 với một hộp thật là mẫu dương, nhỏ hơn 0,3 với mọi hộp thật là mẫu âm, còn ở giữa thì bỏ qua. Một số cài đặt còn chia các độ lệch này cho những hằng số như 0,1 và 0,2 để chuẩn hoá thang đo, nên khi đọc mã cần xem dùng quy ước nào. Kích thước của các hộp neo được chọn bằng tay, hoặc bằng K-means trên kích thước các hộp thật như YOLOv2 (Redmon và Farhadi, 2017). Các bộ phát hiện không dùng hộp neo (anchor-free) như FCOS (Tian và cộng sự, 2019) và CenterNet (Zhou và cộng sự, 2019) dự đoán trực tiếp từ từng điểm của bản đồ đặc trưng, bớt được các siêu tham số về kích thước và tỉ lệ của hộp neo.
Vì dự đoán trên một lưới dày đặc, một đối tượng thường được nhiều hộp gần nhau cùng phát hiện. Bước non-maximum suppression (NMS) lọc các hộp trùng theo thuật toán sau.
- Sắp xếp các hộp theo điểm tin cậy giảm dần.
- Đưa hộp có điểm cao nhất vào kết quả.
- Bỏ mọi hộp còn lại có IoU với hộp vừa chọn lớn hơn một ngưỡng, thường là 0,5.
- Lặp lại bước 2 và 3 với các hộp còn lại cho tới khi hết.
Ví dụ 7.3 (Hình 9, trái)
Sáu hộp dự đoán có điểm A 0,92; B 0,85; D 0,80; C 0,60; E 0,55; F 0,40. IoU giữa A và B là 0,822, giữa A và C là 0,566, giữa A và F là 0,143, giữa D và E là 0,716. Với ngưỡng 0,5: chọn A, bỏ B và C; trong các hộp còn lại D có điểm cao nhất, chọn D và bỏ E; còn F, chọn F. Kết quả là ba hộp A, D, F.
Hộp F chỉ trùng 0,143 với A nên được giữ, vì NMS coi đó là một đối tượng khác. Trong thực tế còn hai chi tiết mà Andrew Ng nhấn mạnh: các hộp có điểm tin cậy dưới một ngưỡng bị bỏ ngay trước khi chạy NMS, và NMS chạy riêng cho từng lớp, để một hộp "người" không loại nhầm một hộp "xe đạp" trùng với nó. Đây cũng là giới hạn của NMS: hai đối tượng thật đứng sát nhau, như người trong đám đông, có hộp trùng nhau nhiều, và hộp có điểm thấp hơn bị loại nhầm. DETR (Carion và cộng sự, 2020) bỏ hẳn NMS và hộp neo. Một Transformer encoder–decoder nhận đặc trưng của ảnh và 100 vector truy vấn, mỗi truy vấn sinh ra một hộp hoặc "không có đối tượng"; khi huấn luyện, các dự đoán được ghép một–một với hộp thật bằng thuật toán Hungary, nên mỗi đối tượng chỉ có một dự đoán chịu trách nhiệm. Đổi lại, DETR huấn luyện lâu hơn nhiều: bài báo gốc dùng 500 epoch trên COCO.
Còn lại câu hỏi đánh giá một bộ phát hiện thế nào. Cách đánh giá dựa trên precision và recall (Mục 8.3 của Nền tảng), với định nghĩa đúng sai qua IoU. Ta xét các hộp dự đoán theo điểm giảm dần. Một hộp là dương tính thật nếu IoU của nó với một hộp thật cùng lớp, chưa được ghép với dự đoán nào trước đó, đạt ngưỡng, thường là 0,5; ngược lại nó là dương tính giả. Hộp thật không được ghép là âm tính giả. Mỗi hộp thật chỉ được ghép một lần, nên các hộp trùng của cùng một đối tượng bị tính là dương tính giả.
Hạ dần ngưỡng điểm, ta được đường precision–recall. AP (average precision) là diện tích dưới đường này sau khi thay mỗi giá trị precision bằng precision lớn nhất ở các mức recall lớn hơn hoặc bằng: . PASCAL VOC 2007 lấy trung bình tại 11 mức recall ; từ VOC 2010, AP là diện tích tính tại mọi điểm (Everingham và cộng sự, 2010). mAP là trung bình AP của các lớp. COCO (Lin và cộng sự, 2014) tính AP tại 101 mức recall và lấy trung bình trên 10 ngưỡng IoU . Con số này được ký hiệu AP@[0,5:0,95], hoặc gọn là AP trong các bài báo dùng COCO, còn AP50 và AP75 là AP tại một ngưỡng IoU. COCO không phân biệt AP với mAP: con số AP của COCO đã là trung bình trên các lớp.
Để thấy các quy ước này ảnh hưởng ra sao, script code/models/thi_giac.py mô phỏng một bộ phát hiện trên 300 ảnh kích thước , mỗi ảnh 1 tới 4 đối tượng, tổng cộng 765 hộp thật. Mỗi đối tượng được phát hiện với xác suất 0,9 bằng một hộp lệch ngẫu nhiên khoảng 6% kích thước ở mỗi cạnh; với xác suất 0,3 có thêm một hộp trùng lệch hơn và điểm thấp hơn; ngoài ra mỗi ảnh có trung bình 0,6 hộp báo nhầm ở chỗ không có gì. Không có mô hình nào được huấn luyện: mô phỏng cô lập đúng phần cần hiểu là cách ghép hộp, lọc trùng và tính AP.
| Cách đánh giá | AP (mọi điểm) | AP (101 điểm) | Recall lớn nhất |
|---|---|---|---|
| IoU 0,5, không lọc trùng | 0,885 | 0,879 | 0,928 |
| IoU 0,5, có NMS | 0,913 | 0,908 | 0,916 |
| IoU 0,75, có NMS | 0,708 | 0,708 | 0,792 |
Với NMS, AP theo cách tính của COCO tại các ngưỡng IoU 0,5; 0,6; 0,7; 0,8; 0,9 lần lượt là 0,908; 0,894; 0,829; 0,425; 0,014, và trung bình trên 10 ngưỡng là AP@[0,5:0,95] = 0,569.
Hai dòng đầu cho thấy NMS tăng AP nhưng loại nhầm một ít hộp đúng. Không lọc trùng, các hộp trùng bị tính là dương tính giả và AP50 là 0,885; sau NMS, AP50 tăng lên 0,913. Nhưng recall lớn nhất giảm từ 0,928 xuống 0,916, vì NMS đã loại một số hộp đúng của các đối tượng đứng sát nhau, đúng giới hạn nêu ở trên.
Dòng cuối và dãy AP theo ngưỡng cho thấy ngưỡng IoU thay đổi con số rất nhiều. Cùng một bộ phát hiện, AP giảm từ 0,908 ở ngưỡng 0,5 xuống 0,708 ở 0,75 và gần 0 ở 0,9: hộp lệch khoảng 6% kích thước mỗi cạnh là đủ tốt cho ngưỡng 0,5 nhưng hiếm khi đạt 0,9. AP@[0,5:0,95] thưởng cho việc định vị chính xác, nên hai bộ phát hiện có cùng AP50 có thể khác xa nhau theo thước đo này. Khi đọc một con số AP, cần biết nó được tính theo quy ước nào.
7.6Phân đoạn ảnh#
Phát hiện đối tượng khoanh vùng bằng hộp, nhưng một chiếc xe hay một khối u không có hình hộp. Phân đoạn ảnh (image segmentation) đi xa hơn: gán nhãn cho từng điểm ảnh thay vì cho cả ảnh hay cho một hộp. Có ba bài toán phân đoạn, khác nhau ở việc có phân biệt các đối tượng cùng lớp hay không.
| Bài toán | Đầu ra | Ví dụ |
|---|---|---|
| Phân đoạn ngữ nghĩa (semantic segmentation) | mỗi điểm ảnh một nhãn lớp; không phân biệt các đối tượng cùng lớp | đường, vỉa hè, xe, người trong ảnh từ camera của xe |
| Phân đoạn thể hiện (instance segmentation) | một mặt nạ riêng cho từng đối tượng | từng chiếc xe, từng người |
| Phân đoạn toàn cảnh (panoptic segmentation; Kirillov và cộng sự, 2019) | mọi điểm ảnh có nhãn lớp, và các đối tượng đếm được có thêm định danh riêng | bản đồ đầy đủ của một cảnh |
Khó khăn đầu tiên là độ phân giải. Một CNN phân loại giảm độ phân giải dần qua các lớp, chẳng hạn từ xuống , để trường tiếp nhận đủ lớn (Mục 7.2), trong khi phân đoạn lại cần đầu ra ở độ phân giải gốc. FCN (fully convolutional network; Long, Shelhamer và Darrell, 2015) giải quyết bằng ba thay đổi. Các lớp kết nối đầy đủ ở cuối được thay bằng tích chập, để mạng cho ra một bản đồ lớp thô thay vì một vector. Bản đồ đó được tăng độ phân giải bằng tích chập chuyển vị. Và đặc trưng từ các lớp đầu, nơi độ phân giải còn cao, được cộng thêm vào để khôi phục chi tiết ở biên đối tượng.
Tích chập chuyển vị (transposed convolution) là phép tăng kích thước không gian. Với đầu vào kích thước , bộ lọc , bước nhảy và phần đệm , đầu ra có kích thước
Ví dụ, , , , cho : độ phân giải tăng gấp đôi. Ví dụ quen thuộc trong các bài giảng biến ảnh thành bằng bộ lọc , bước nhảy 2, đệm 1; công thức trên cho 3, và các thư viện thêm một tham số output_padding bằng 1 để được 4. Cơ chế dễ thấy nhất ở một chiều: đầu vào với bộ lọc và bước nhảy 2 cho . Mỗi giá trị đầu vào rải một bản sao của bộ lọc, nhân với chính nó, và các bản sao cộng chồng ở chỗ giao nhau. Tên gọi deconvolution hay dùng cho phép này là sai, vì nó không đảo ngược phép tích chập: viết phép tích chập thành phép nhân với một ma trận thưa , phép tăng kích thước này là phép nhân với , nên mới có tên tích chập chuyển vị (CS231n; d2l.ai). Khi không chia hết cho , các vùng ảnh hưởng của bộ lọc chồng lên nhau không đều và có thể tạo hoa văn ô cờ trên ảnh đầu ra (Odena và cộng sự, 2016); một cách thay thế phổ biến là phóng to bằng nội suy song tuyến tính rồi mới tích chập.
Kiến trúc phân đoạn được dùng rộng rãi nhất là U-Net (Ronneberger, Fischer và Brox, 2015). Nó gồm một nhánh mã hoá giảm độ phân giải và tăng số kênh như một CNN phân loại, và một nhánh giải mã đối xứng tăng dần độ phân giải. Ở mỗi mức độ phân giải, nhánh giải mã ghép (concatenate) bản đồ đặc trưng của nhánh mã hoá ở cùng mức: đặc trưng sâu cho biết "đây là gì", đặc trưng nông cho biết chính xác "ở đâu". U-Net được thiết kế cho ảnh y sinh, nơi chỉ có vài chục ảnh có nhãn (một bài toán trong bài báo có 30 ảnh huấn luyện), và dựa nhiều vào tăng cường dữ liệu. Ngày nay kiến trúc này còn là mạng khử nhiễu trong nhiều mô hình khuếch tán (Ho và cộng sự, 2020; Chương 11 của Biểu diễn & Căn chỉnh).
Một cách khác để có trường tiếp nhận lớn mà không phải giảm độ phân giải là tích chập giãn (dilated convolution, atrous convolution), chèn ô trống giữa các phần tử của bộ lọc. Bộ lọc với hệ số giãn phủ một vùng kích thước mà vẫn chỉ có trọng số: bộ lọc với phủ , với phủ . DeepLab (Chen và cộng sự, 2018) dùng tích chập giãn, và chạy song song nhiều hệ số giãn khác nhau để bắt ngữ cảnh ở nhiều tỉ lệ.
Với phân đoạn thể hiện, Mask R-CNN (He và cộng sự, 2017) thêm vào Faster R-CNN một nhánh dự đoán mặt nạ nhị phân cho mỗi vùng, song song với nhánh phân loại và nhánh hộp. Nó cũng thay RoI pooling bằng RoIAlign. RoI pooling làm tròn toạ độ của vùng về lưới của bản đồ đặc trưng, gây lệch tới nửa ô; sai lệch đó chấp nhận được với hộp nhưng không chấp nhận được khi cần chính xác tới từng điểm ảnh, nên RoIAlign lấy giá trị tại toạ độ thực bằng nội suy song tuyến tính.
Đánh giá phân đoạn cũng có bẫy riêng. Độ chính xác theo điểm ảnh (pixel accuracy) dễ gây hiểu lầm khi các lớp mất cân bằng: nếu nền chiếm 95% số điểm ảnh, một mô hình gán mọi điểm là nền đạt 95%. Thước đo chuẩn cho phân đoạn ngữ nghĩa là IoU theo lớp và mIoU, trung bình IoU của các lớp, với IoU tính trên tập điểm ảnh thay vì trên hộp. Trong phân đoạn ảnh y tế, người ta hay dùng hệ số Dice . Dice và IoU liên hệ bởi , nên Dice luôn lớn hơn hoặc bằng IoU: IoU 0,3; 0,5; 0,7; 0,9 ứng với Dice 0,462; 0,667; 0,824; 0,947. Vì vậy khi so sánh kết quả từ hai bài báo, cần chú ý chúng dùng thước đo nào.
Hàm mất mát cơ bản là cross-entropy trên từng điểm ảnh. Khi đối tượng chỉ chiếm một phần rất nhỏ của ảnh, như khối u trên ảnh chụp, cross-entropy bị số đông điểm ảnh nền chi phối, giống tình huống của focal loss ở Mục 7.5. Các cách xử lý gồm đặt trọng số theo lớp, dùng focal loss, và dùng Dice loss (Milletari và cộng sự, 2016): , với Dice tính từ xác suất dự đoán thay vì nhãn đã làm tròn để lấy đạo hàm được. Dice loss chỉ quan tâm tới mức trùng khớp của vùng đối tượng, nên không bị số điểm ảnh nền lấn át.
Xu hướng mới nhất trong phân đoạn là mô hình nền. SAM (Segment Anything; Kirillov và cộng sự, 2023) nhận một ảnh và một gợi ý, có thể là một vài điểm hoặc một hộp, rồi trả về mặt nạ của đối tượng được chỉ tới. Mô hình được huấn luyện trên bộ dữ liệu SA-1B gồm hơn 1 tỉ mặt nạ trên 11 triệu ảnh, và dùng được trên nhiều loại ảnh chưa từng thấy mà không cần huấn luyện thêm. Trong ứng dụng, SAM thường được ghép với một bộ phát hiện: bộ phát hiện đưa ra hộp, SAM biến hộp thành mặt nạ. Đây là cùng xu hướng với mô hình ngôn ngữ ở các Chương 9 tới 12: một mô hình nền huấn luyện trên dữ liệu rất lớn, rồi được dùng cho nhiều nhiệm vụ cụ thể.
7.7Tóm tắt#
Mạng tích chập dựa trên ba giả định về ảnh: tính cục bộ, chia sẻ trọng số giữa các vị trí, và tính bất biến gần đúng với dịch chuyển nhỏ. Nhờ vậy số tham số của một lớp không phụ thuộc kích thước ảnh, dù số phép tính thì có, như lớp đầu của ResNet-50 với 9 408 tham số và khoảng FLOP. Trường tiếp nhận tăng tuyến tính theo số lớp, nên mạng phải giảm độ phân giải sớm, và chồng các lớp rẻ hơn dùng bộ lọc lớn. So với ViT, CNN có thiên kiến quy nạp mạnh hơn, nên tốt hơn khi dữ liệu vừa phải và kém hơn khi dữ liệu rất lớn. Phát hiện đối tượng thêm câu hỏi "ở đâu", với IoU để so hộp, hộp neo, NMS để lọc trùng và AP để đánh giá; mô phỏng cho thấy AP giảm từ 0,908 ở ngưỡng IoU 0,5 xuống 0,014 ở 0,9, nên con số AP chỉ có nghĩa khi biết quy ước tính. Phân đoạn gán nhãn cho từng điểm ảnh, với FCN, U-Net, tích chập giãn và các thước đo IoU, Dice.
CNN khai thác cấu trúc không gian của ảnh. Văn bản, tiếng nói và chuỗi thời gian có một cấu trúc khác: thứ tự. Chương 8 xét họ mô hình đầu tiên được thiết kế cho dữ liệu dạng chuỗi.
8Mạng nơ-ron hồi quy#
Văn bản, tiếng nói và chuỗi thời gian là dữ liệu dạng chuỗi có độ dài thay đổi, và ý nghĩa của mỗi phần tử phụ thuộc vào những gì đứng trước nó. Một mạng truyền thẳng nhận đầu vào có kích thước cố định nên không xử lý trực tiếp được loại dữ liệu này. Mạng nơ-ron hồi quy (recurrent neural network, RNN) giải quyết bằng một ý tưởng đơn giản: đọc chuỗi từng phần tử một và giữ một trạng thái tóm tắt những gì đã đọc. Ý tưởng này gặp lại đúng vấn đề gradient của Chương 6, ở dạng nặng hơn, và cuối cùng bị Transformer thay thế vì một giới hạn mà không kỹ thuật huấn luyện nào sửa được.
8.1Mô hình#
Định nghĩa 8.1 (Mạng nơ-ron hồi quy)
Với chuỗi đầu vào , một RNN cập nhật trạng thái ẩn theo
với cho trước, thường bằng 0. Cùng các ma trận , , được dùng ở mọi bước.
Dùng chung trọng số ở mọi bước là dạng chia sẻ trọng số theo trục thời gian, giống chia sẻ trọng số theo không gian của tích chập (Mục 7.1). Nhờ đó RNN xử lý được chuỗi dài tuỳ ý với số tham số cố định, và cách xử lý một mẫu ở vị trí thứ 5 giống ở vị trí thứ 500.
Trường hợp một chiều cho thấy trạng thái ẩn nhớ và quên ra sao. Lấy với và chuỗi đầu vào . Ba trạng thái lần lượt là , và : sau mỗi bước, dấu vết của đầu vào đầu tiên còn chưa tới một nửa, vì nó bị nhân với hệ số 0,5 rồi đi qua tanh.
Có những bài toán không giải được nếu thiếu trạng thái ẩn. Karpathy (2015) minh hoạ điều này bằng một mô hình đoán ký tự tiếp theo trên chữ "hello". Một ví dụ tiếng Việt cùng kiểu là chuỗi "con cò", tính cả dấu cách, cho năm cặp gồm ký tự hiện tại và ký tự tiếp theo: c → o, o → n, n → dấu cách, dấu cách → c, c → ò. Hai cặp có cùng đầu vào "c" nhưng đáp án khác nhau, nên không mô hình nào chỉ nhìn ký tự hiện tại làm đúng được cả hai. Chỉ trạng thái ẩn, vốn nhớ rằng trước chữ "c" thứ hai đã có cả một từ "con", mới phân biệt được hai lần gặp chữ "c".
Để huấn luyện, RNN được trải ra theo thời gian thành một mạng truyền thẳng lớp dùng chung trọng số, rồi áp dụng lan truyền ngược lên mạng đó. Thuật toán này gọi là lan truyền ngược theo thời gian (backpropagation through time). Gradient theo trọng số dùng chung là tổng các gradient tại mọi bước. Với chuỗi rất dài, như một văn bản hàng triệu ký tự, lan truyền ngược được cắt thành từng đoạn, gọi là truncated BPTT: trạng thái ẩn vẫn được mang từ đoạn trước sang đoạn sau, nhưng gradient chỉ đi ngược trong phạm vi một đoạn, chẳng hạn 100 bước (CS231n).
8.2Gradient tiêu biến và bùng nổ theo thời gian#
Một câu như "Anh ấy lớn lên ở Nhật Bản, học hết phổ thông ở đó, rồi mới về nước đi làm, nên nói thạo tiếng ___" cần thông tin cách chỗ trống mười bảy âm tiết. Để học được phụ thuộc như vậy, gradient của mất mát tại chỗ trống phải truyền ngược về tận chữ "Nhật"; Olah (2015) và Andrew Ng đều mở đầu phần này bằng những câu cùng kiểu. Mạng trải ra theo thời gian là một mạng sâu lớp, nên nó gặp đúng vấn đề của Chương 6. Theo quy tắc dây chuyền, đạo hàm của trạng thái ở bước theo trạng thái ở bước là
với là giá trị trước hàm tanh ở bước . Với RNN một chiều ở Mục 8.1, mỗi thừa số là , nên , và qua 20 bước đạo hàm không vượt quá . Tình huống giống Mục 6.1, nhưng nghiêm trọng hơn ở một điểm: cùng một ma trận được nhân lặp lại lần, thay vì mỗi lớp một ma trận khác nhau. Pascanu, Mikolov và Bengio (2013) chỉ ra rằng nếu giá trị suy biến lớn nhất của nhỏ hơn 1 thì gradient chắc chắn tiêu biến theo hàm mũ, vì . Điều ngược lại không đúng: giá trị suy biến lớn nhất lớn hơn 1 chỉ là điều kiện cần để gradient bùng nổ, chưa phải điều kiện đủ, vì tanh bão hoà có thể kéo các thừa số xuống. Trong thí nghiệm dưới đây, là bán kính phổ, tức trị tuyệt đối lớn nhất của các trị riêng, nên các con số cần được đọc với lưu ý đó.
Thí nghiệm trong code/models/experiments.py đo trực tiếp hiện tượng này. Một RNN tanh 64 chiều có với các phần tử độc lập, phương sai , nên bán kính phổ xấp xỉ ; trạng thái đầu nhỏ, và mạng chạy 100 bước. Một gradient ngẫu nhiên được truyền ngược từ bước cuối, và thí nghiệm đo chuẩn của gradient sau 10, 50 và 100 bước lùi, chia cho chuẩn sau 1 bước và lấy trung bình trên 8 lần khởi tạo.
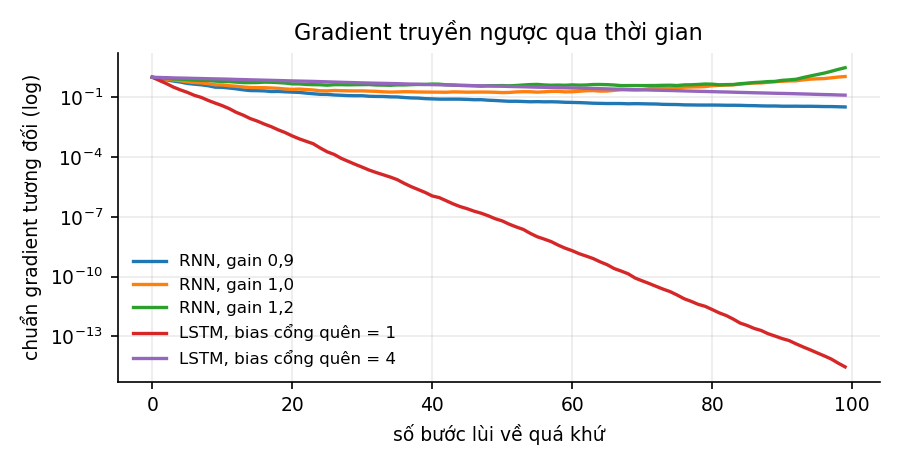
| Mô hình | Sau 10 bước | Sau 50 bước | Sau 100 bước |
|---|---|---|---|
| RNN, | |||
| RNN, | |||
| RNN, | |||
| Đường ô nhớ của LSTM, hệ số chặn cổng quên 1 | |||
| Đường ô nhớ của LSTM, hệ số chặn cổng quên 4 |
Với , gradient giảm đều. Với và , gradient giảm trong khoảng 50 bước lùi đầu rồi tăng trở lại, tới 3,0 sau 100 bước với . Lý do nằm ở trạng thái đầu nhỏ. Ở các bước đầu của chuỗi, còn nhỏ nên tanh gần như tuyến tính và Jacobi xấp xỉ , có bán kính phổ lớn hơn 1; ở các bước sau, với , trạng thái lớn dần, tanh bão hoà và đạo hàm của nó kéo Jacobi xuống. Như vậy độ lớn của gradient phụ thuộc cả vào lẫn vào mức bão hoà của các đơn vị dọc theo chuỗi, và trong khi huấn luyện, cả hai đều thay đổi. Hai dòng cuối của bảng nói về LSTM và sẽ được giải thích ở Mục 8.3.
Hai loại sự cố cần cách xử lý khác nhau. Bùng nổ dễ xử lý: cắt ngưỡng gradient (gradient clipping) nhân gradient với mỗi khi chuẩn của nó, tính trên toàn bộ tham số ghép lại, vượt ngưỡng , giữ nguyên hướng và chỉ giới hạn độ lớn (Pascanu, Mikolov và Bengio, 2013). Kỹ thuật này được dùng rộng rãi, kể cả khi huấn luyện Transformer. Tiêu biến thì khó xử lý hơn nhiều. Một gradient đã quá nhỏ không thể phóng to lại một cách có ý nghĩa, vì thông tin về ảnh hưởng của các bước xa đã lẫn vào nhiễu. Tệ hơn, khi gradient từ xa đã tiêu biến, quá trình học không phân biệt được hai tình huống: dữ liệu thật sự không có phụ thuộc xa, hay có nhưng tham số hiện tại chưa nắm được nó (CS224n). Muốn sửa phải thay đổi kiến trúc, và đó là việc LSTM làm.
8.3LSTM và GRU#
Kiến trúc giải quyết được vấn đề tiêu biến là LSTM (long short-term memory; Hochreiter và Schmidhuber, 1997, với cổng quên do Gers, Schmidhuber và Cummins, 2000 bổ sung). LSTM thêm một trạng thái ô nhớ bên cạnh trạng thái ẩn , và ba cổng có giá trị trong :
Cổng quên quyết định giữ lại bao nhiêu phần của ô nhớ cũ, cổng vào quyết định ghi thêm bao nhiêu thông tin mới, cổng ra quyết định đưa bao nhiêu phần của ô nhớ ra trạng thái ẩn. Chẳng hạn với một ô nhớ một chiều có , nếu ở bước này , , và thì và . Ô nhớ giữ lại 90% giá trị cũ, ghi thêm một nửa giá trị mới, và chỉ một phần của nó được đưa ra ngoài. Olah (2015) ví trạng thái ô nhớ như một băng chuyền chạy thẳng qua mọi bước, chỉ bị tác động bởi một phép nhân và một phép cộng ở mỗi bước, nên thông tin đi dọc theo nó mà ít bị biến đổi.
Chỗ khác biệt quyết định là ô nhớ được cập nhật bằng phép cộng có trọng số, không qua phép nhân ma trận. Dọc theo đường đi qua ô nhớ, nếu bỏ qua các đường gián tiếp qua , ta có
Đây là tích của các số trong , không phải tích của các ma trận, và mạng học được giá trị của : khi cần giữ thông tin lâu, nó có thể đặt gần 1. Ở ví dụ trên, đạo hàm của theo dọc theo ô nhớ đúng bằng , không qua hàm tanh hay ma trận trọng số nào. Cơ chế này tương tự kết nối tắt ở Mục 6.5, nhưng theo trục thời gian.
Hai dòng cuối của bảng ở Mục 8.2 mô phỏng riêng đường đi này: gradient nhân với ở mỗi bước, với là nhiễu nhỏ. Kết quả cho thấy lợi ích của LSTM phụ thuộc vào giá trị cổng quên. Với hệ số chặn , cổng quên trung bình khoảng , và sau 100 bước gradient chỉ còn . Với , cổng quên khoảng , và gradient còn 0,13.
Có thể hiểu các con số này qua thang thời gian của bộ nhớ. Với cổng quên không đổi , thông tin suy giảm theo . Tổng các trọng số cho biết bộ nhớ kéo dài khoảng bao nhiêu bước, còn thời gian để tín hiệu giảm lần là ; hai con số gần nhau khi gần 1. Với , chúng là 3,7 và 3,2 bước, tức khoảng 4 bước; với , là 50 và 49,5 bước. Khuyến nghị phổ biến là khởi tạo (Jozefowicz, Zaremba và Sutskever, 2015), đủ cho các phụ thuộc cỡ vài bước tới vài chục bước ngay từ đầu huấn luyện. Khi biết trước chuỗi có phụ thuộc rất xa, Tallec và Ollivier (2018) đề xuất khởi tạo theo thang thời gian mong muốn, để các đơn vị khác nhau có bộ nhớ dài ngắn khác nhau.
Một biến thể gọn hơn là GRU (gated recurrent unit; Cho và cộng sự, 2014). GRU gộp cổng quên và cổng vào thành một cổng cập nhật, bỏ ô nhớ riêng và cổng ra, nên có ba khối trọng số thay vì bốn, tức ít hơn khoảng 25% tham số. Chung và cộng sự (2014) so sánh trên nhiều bài toán và không thấy bên nào tốt hơn một cách nhất quán, nên chọn giữa hai loại là việc phải quyết định bằng thực nghiệm. Khi đọc các tài liệu về GRU cần để ý quy ước: d2l.ai viết cổng cập nhật gần 1 nghĩa là giữ trạng thái cũ, còn Andrew Ng và CS224n dùng quy ước ngược lại.
Với những bài toán có sẵn cả câu trước khi xử lý, như gán nhãn từ loại hay nhận dạng thực thể, có thể chạy thêm một RNN theo chiều ngược lại và ghép trạng thái của hai chiều tại mỗi vị trí, để mỗi vị trí dùng được cả ngữ cảnh phía sau. RNN hai chiều như vậy không dùng được cho mô hình ngôn ngữ hay cho dữ liệu đến dần theo thời gian, vì phần sau của chuỗi chưa có.
8.4Giới hạn về tính song song#
Vấn đề gradient giảm nhẹ được bằng LSTM, cắt ngưỡng gradient và khởi tạo tốt. Giới hạn không khắc phục được nằm ở chính định nghĩa: phụ thuộc , nên các bước phải tính tuần tự. Xử lý một chuỗi dài cần bước nối tiếp nhau, dù có bao nhiêu phần cứng song song. Bảng sau so sánh một lớp RNN với một lớp self-attention (Chương 9), theo Vaswani và cộng sự (2017).
| Lớp RNN | Lớp self-attention | |
|---|---|---|
| Số phép tính mỗi lớp | ||
| Số bước phải thực hiện tuần tự | ||
| Độ dài đường đi dài nhất giữa hai vị trí |
Self-attention tốn nhiều phép tính hơn khi , nhưng các phép tính đó thực hiện song song được trên GPU, còn các bước tuần tự thì không. Đường đi ngắn giữa hai vị trí bất kỳ còn có nghĩa là gradient nối hai token cách xa nhau không phải đi qua phép nhân như trong RNN. Hai điểm này khiến Transformer thay thế RNN trong phần lớn bài toán xử lý ngôn ngữ.
Hướng hồi quy chưa kết thúc. Các mô hình không gian trạng thái (state space model) như Mamba (Gu và Dao, 2023) dùng phép truy hồi tuyến tính theo thời gian, cho phép huấn luyện song song bằng thuật toán quét (scan) và suy luận với bộ nhớ không đổi theo độ dài chuỗi, và cạnh tranh được với Transformer ở một số quy mô.
8.5Tóm tắt#
RNN xử lý chuỗi bằng một trạng thái ẩn cập nhật qua từng bước với trọng số dùng chung, và được huấn luyện bằng lan truyền ngược trên mạng trải ra theo thời gian, cắt thành từng đoạn khi chuỗi dài. Trạng thái ẩn là điều kiện cần: với chuỗi "con cò", cùng đầu vào "c" phải cho hai đáp án khác nhau. Vì cùng một ma trận được nhân lặp lại, gradient tiêu biến hoặc bùng nổ theo số bước; bùng nổ xử lý được bằng cắt ngưỡng gradient, còn tiêu biến cần thay đổi kiến trúc. LSTM cập nhật ô nhớ bằng phép cộng có cổng, nên gradient dọc theo ô nhớ chỉ nhân với các giá trị cổng quên mà mạng tự học; thang thời gian của bộ nhớ khoảng bước, và mô phỏng cho thấy sau 100 bước gradient còn 0,13 với cổng quên 0,98 nhưng chỉ với cổng quên 0,73. Giới hạn cuối cùng của RNN là các bước phải tính tuần tự, và đường đi giữa hai vị trí xa nhau dài .
Self-attention bỏ hẳn phép truy hồi: mọi vị trí lấy thông tin trực tiếp từ mọi vị trí khác trong một bước. Chương 9 xây Transformer từ phép toán đó.
9Attention và Transformer#
Mục 8.4 kết thúc ở bảng so sánh một lớp RNN với một lớp self-attention: self-attention tốn nhiều phép tính hơn nhưng không có bước tuần tự nào, và mọi cặp vị trí chỉ cách nhau một bước. Transformer (Vaswani và cộng sự, 2017) xây toàn bộ kiến trúc quanh phép toán đó, và ngày nay là kiến trúc của gần như mọi mô hình ngôn ngữ lớn. Ta bắt đầu từ attention như một phép tra cứu, rồi lần lượt ghép các thành phần lại thành một khối Transformer hoàn chỉnh.
9.1Attention như phép tra cứu mềm#
Một từ điển trả về giá trị ứng với khoá khớp đúng truy vấn. Attention làm việc tương tự nhưng mềm hơn: nó so truy vấn với mọi khoá, biến các độ giống nhau thành trọng số dương có tổng bằng 1, rồi trả về trung bình có trọng số của các giá trị. Vì mọi bước đều khả vi, cả phép tra cứu có thể học bằng gradient descent.
Định nghĩa 9.1 (Scaled dot-product attention)
Cho ma trận truy vấn , khoá và giá trị ,
trong đó softmax áp dụng cho từng hàng. Ma trận gọi là ma trận trọng số attention; mỗi hàng của nó không âm và có tổng bằng 1.
Ba ma trận đóng ba vai khác nhau trong phép tra cứu, như bảng dưới tóm tắt. Alammar (2019) ví chúng với một tủ hồ sơ: truy vấn là tờ giấy ghi điều cần tìm, khoá là nhãn dán trên từng tập hồ sơ, còn giá trị là nội dung bên trong; attention so tờ giấy với mọi nhãn rồi lấy về một hỗn hợp nội dung theo mức khớp.
| Ký hiệu | Vai trò |
|---|---|
| (query, truy vấn) | thông tin mà vị trí đang xét cần tìm |
| (key, khoá) | đặc điểm để so khớp của từng vị trí |
| (value, giá trị) | nội dung được lấy về từ từng vị trí |
Trong self-attention, cả ba ma trận là phép chiếu tuyến tính của cùng một chuỗi đầu vào : , , . Trong cross-attention, lấy từ một chuỗi còn và lấy từ chuỗi khác, chẳng hạn câu đang dịch và câu nguồn. Cơ chế attention được Bahdanau, Cho và Bengio (2015) đưa vào dịch máy trước khi có Transformer, dùng kết hợp với RNN.
Bài giảng CS224n dựng Transformer theo một trình tự đáng theo: bắt đầu từ self-attention thuần, chỉ ra từng thiếu sót của nó, rồi thêm đúng một thành phần để sửa mỗi thiếu sót. Self-attention thuần không biết thứ tự của các token, nên cần mã hoá vị trí (Mục 9.6). Nó chỉ lấy trung bình có trọng số, nên cần thêm một khối phi tuyến cho từng vị trí (Mục 9.5). Và khi sinh văn bản, nó nhìn thấy cả các token tương lai, nên cần mặt nạ (Mục 9.4). Các mục dưới đi qua từng thành phần đó, sau khi xét kỹ phép tính attention.
Ví dụ 9.1
Truy vấn , ba khoá , , và ba giá trị , , , với . Điểm số là ; chia cho được . Softmax cho trọng số : truy vấn "giống" khoá 1 và khoá 3 như nhau và giống khoá 2 ít hơn. Đầu ra là .
9.2Phép chia cho #
Trong Định nghĩa 9.1, điểm số được chia cho trước softmax. Phép chia này trông như một chi tiết nhỏ, nhưng thiếu nó thì attention gần như không học được khi lớn.
Mệnh đề 9.1
Nếu các thành phần của là các biến ngẫu nhiên độc lập, có trung bình 0 và phương sai 1, thì có trung bình 0 và phương sai .
Chứng minh
. Mỗi số hạng có và . Các số hạng độc lập với nhau, nên phương sai của tổng bằng tổng các phương sai, tức .
Như vậy độ lệch chuẩn của điểm số tăng theo : với , các điểm số trải trong khoảng cỡ ; với là . Softmax của các số chênh nhau hàng chục đơn vị gần như là một vector one-hot. Karpathy (2023) cho thấy điều này bằng một phép thử nhỏ, có thể làm lại với số riêng: softmax của bốn điểm số 0,2; ; 0,4; 0 là , khá đều; nhân cả bốn với 8, như khi độ lệch chuẩn của điểm số lớn gấp 8 lần, softmax thành , gần như dồn hết vào một khoá. Đạo hàm của softmax là , và khi gần one-hot thì mọi phần tử của ma trận này đều gần 0, nên gradient gần như không truyền qua được. Chia điểm số cho đưa phương sai về 1 với mọi . Vaswani và cộng sự (2017) nêu lập luận này trong chú thích 4 của bài báo.
Thí nghiệm trong code/models/experiments.py kiểm tra cả hai vế của lập luận: tạo 4 000 truy vấn và 64 khoá ngẫu nhiên theo phân phối chuẩn tắc, đo phương sai của điểm số và entropy của phân phối attention trên 64 khoá, có và không có phép chia.
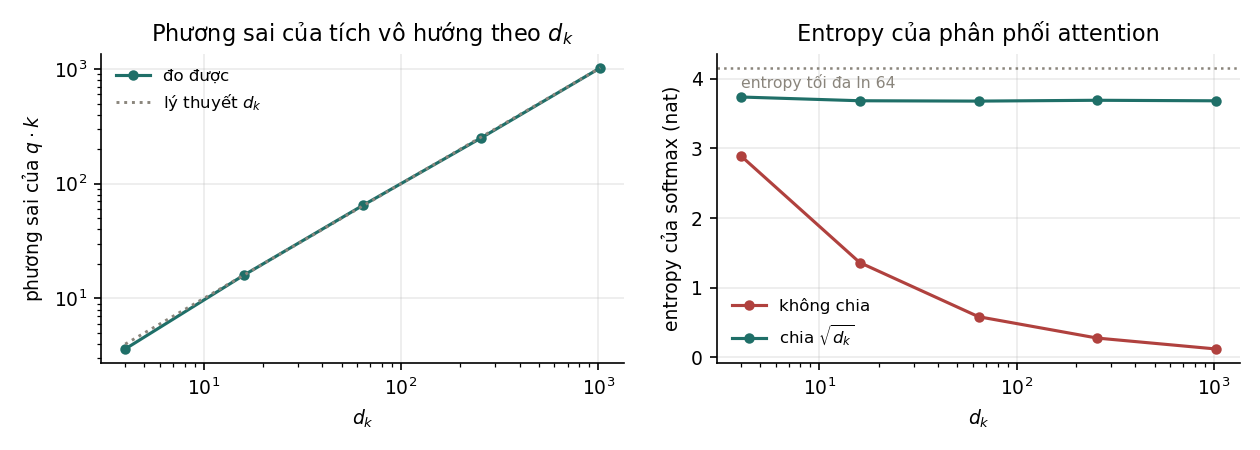
| đo được | Lý thuyết | Entropy, không chia | Entropy, có chia | Trọng số lớn nhất, không chia | |
|---|---|---|---|---|---|
| 4 | 3,63 | 4 | 2,892 | 3,739 | 0,258 |
| 16 | 15,99 | 16 | 1,360 | 3,685 | 0,584 |
| 64 | 64,66 | 64 | 0,582 | 3,680 | 0,791 |
| 256 | 251,67 | 256 | 0,275 | 3,692 | 0,894 |
| 1 024 | 1 021,97 | 1 024 | 0,118 | 3,685 | 0,953 |
Phương sai đo được khớp lý thuyết ở mọi . Không chia thì entropy giảm dần về 0: ở , entropy chỉ còn 0,118 nat, trong khi giá trị lớn nhất có thể là nat khi trọng số chia đều, và trọng số lớn nhất trung bình là 0,953, tức attention gần như chỉ chọn một khoá. Có chia thì entropy giữ quanh 3,68 với mọi , nghĩa là hành vi của attention không còn phụ thuộc vào số chiều được chọn cho mỗi đầu.
9.3Attention nhiều đầu#
Thay vì một phép attention trên chiều, attention nhiều đầu (multi-head attention) chiếu đầu vào xuống không gian con, mỗi không gian chiều, thực hiện phép attention song song, rồi nối kết quả và chiếu lại:
Bài báo gốc dùng , , . Phép chia ở Mục 9.2 dùng số chiều của mỗi đầu, , không phải , vì phương sai cần đưa về 1 là phương sai của tích vô hướng trong từng đầu. Về cài đặt, đầu được tính cùng lúc như thêm một trục lô, nên chi phí gần như bằng một đầu trên đủ chiều. Vì mỗi đầu hẹp đi lần, tổng số tham số, cho , , , , và tổng số phép tính gần như bằng attention một đầu trên đủ chiều. Nhiều đầu không mua thêm khả năng tính toán mà cho phép mô hình cùng lúc chú ý tới những loại quan hệ khác nhau ở những vị trí khác nhau, chẳng hạn một đầu theo quan hệ cú pháp, một đầu theo từ đồng tham chiếu. Với một đầu duy nhất, phép lấy trung bình có trọng số sẽ trộn lẫn các quan hệ đó.
Không phải đầu nào cũng quan trọng như nhau. Michel, Levy và Neubig (2019) cho thấy có thể bỏ phần lớn các đầu của một mô hình đã huấn luyện mà chất lượng giảm rất ít, dù một số ít đầu là thiết yếu. Nhận xét này là cơ sở cho các cách chia sẻ khoá và giá trị giữa các đầu ở Mục 10.4.
9.4Mặt nạ#
Đôi khi một vị trí không được phép nhìn một số vị trí khác. Hai loại mặt nạ thường gặp có mục đích khác nhau.
| Loại | Che các vị trí nào | Mục đích |
|---|---|---|
| Mặt nạ nhân quả (causal mask) | mọi vị trí khi tính đầu ra tại vị trí | mô hình sinh văn bản không được nhìn thấy các token phía sau |
| Mặt nạ đệm (padding mask) | các vị trí đệm thêm để các chuỗi trong lô dài bằng nhau | phần đệm không đóng góp vào kết quả |
Mặt nạ được cài đặt bằng cách cộng , trong thực tế là một số âm rất lớn, vào điểm số của các vị trí bị che trước khi tính softmax, để sau softmax trọng số của chúng bằng đúng 0. Chẳng hạn với ba token có điểm số bằng nhau ở mọi cặp, không có mặt nạ thì mỗi hàng của ma trận trọng số là . Có mặt nạ nhân quả, hàng thứ nhất chỉ còn chính nó, ; hàng thứ hai chia đều cho hai vị trí đầu, ; hàng thứ ba giữ nguyên . Ba hàng đó là ma trận tam giác dưới chuẩn hoá theo hàng, và nhân nó với dãy vector giá trị , , cho , , : mỗi vị trí lấy trung bình của chính nó và mọi vị trí trước nó. Karpathy (2023) giới thiệu self-attention nhân quả bằng đúng phép nhân này, rồi thay các điểm số bằng nhau bằng các điểm số học được từ truy vấn và khoá. Lý do dùng một số âm rất lớn thay cho thật là nếu cả một hàng bị che, softmax trên toàn cho kết quả NaN.
Mặt nạ nhân quả còn cho phép một điều quan trọng khi huấn luyện. Với một chuỗi token, một lượt xuôi duy nhất tính được dự đoán cho cả vị trí cùng lúc, và vị trí nào cũng chỉ thấy các token phía trước nó. Mỗi chuỗi huấn luyện vì vậy cho bài toán dự đoán token tiếp theo, tính song song. RNN cũng cho dự đoán, nhưng phải tính tuần tự.
9.5Cấu trúc một khối Transformer#
Attention nhiều đầu, mặt nạ, chuẩn hoá và kết nối tắt ở Chương 6 ghép lại thành một khối Transformer.
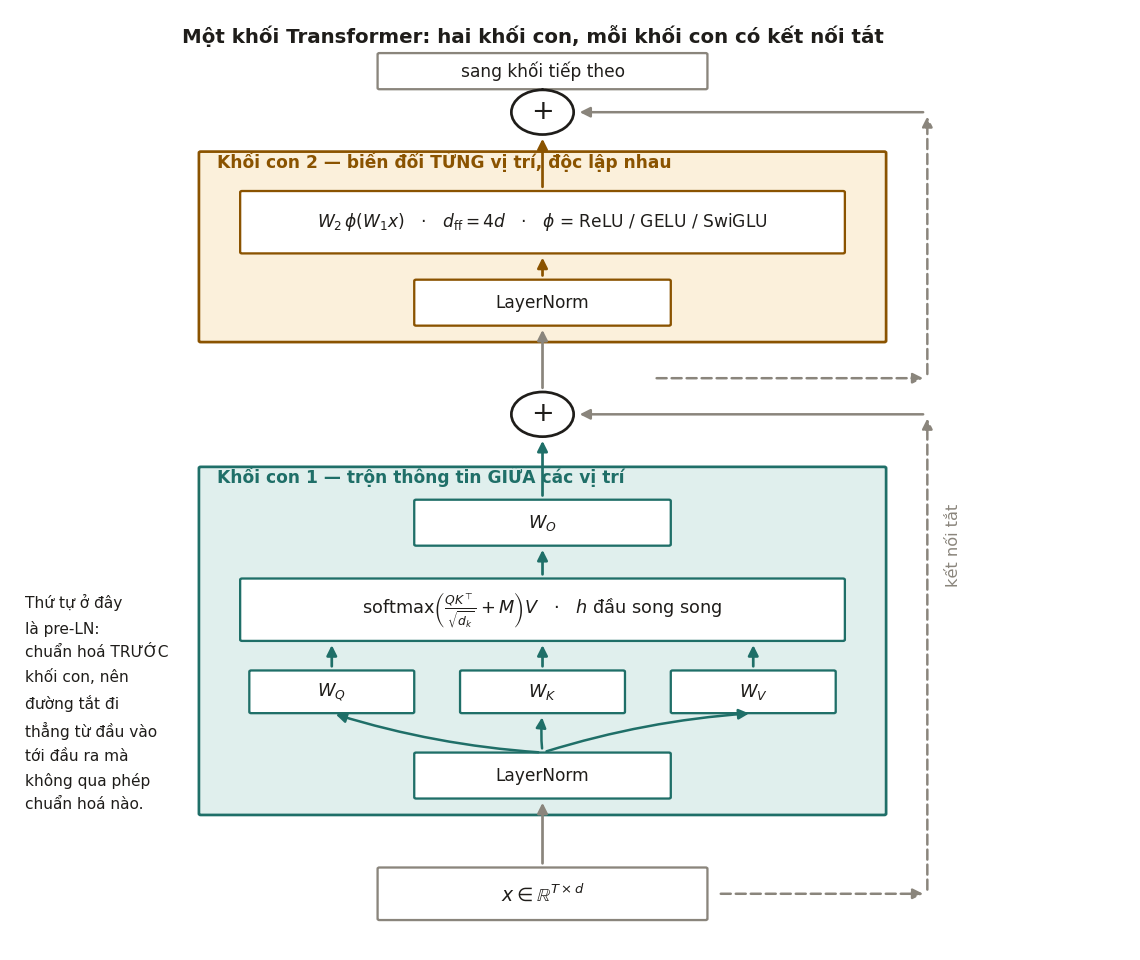
Một khối Transformer theo thứ tự pre-LN tính
trong đó là một MLP hai lớp áp dụng riêng cho từng vị trí, thường với . Một mô hình gồm nhiều khối như vậy xếp chồng, cộng với lớp embedding ở đầu và lớp chiếu ra từ vựng ở cuối. Hai khối con phân công rõ ràng, như bảng dưới cho thấy.
| Khối con attention | Khối con FFN | |
|---|---|---|
| Kết hợp thông tin theo trục nào | giữa các vị trí | giữa các chiều đặc trưng của cùng một vị trí |
| Các vị trí có được xử lý độc lập không | không: mỗi vị trí nhìn thấy các vị trí khác | có: từng vị trí xử lý riêng |
| Số tham số, với , bỏ qua hệ số chặn | ||
| Số phép tính theo độ dài chuỗi |
Từ bảng rút ra hai điều mà người mới thường không để ý. FFN chiếm hai phần ba số tham số của mỗi khối, dù attention là phần được nói tới nhiều hơn; Chương 12 kiểm chứng con số này trên GPT-2. Và attention là thành phần duy nhất kết hợp thông tin giữa các vị trí: bỏ attention đi, Transformer chỉ còn là một MLP áp dụng độc lập cho từng token. Chiều ngược lại cũng đáng nhớ: bỏ FFN đi thì đầu ra của mỗi lớp chỉ là trung bình có trọng số của các phép biến đổi tuyến tính của đầu vào, và ghi chú CS224n của Hewitt chỉ ra rằng thiếu phần phi tuyến theo từng vị trí, mô hình không biến đổi được đặc trưng của từng token. Karpathy (2023) tóm gọn sự phân công này: attention là cơ chế để các token trao đổi thông tin với nhau, còn FFN là nơi mỗi token xử lý thông tin vừa nhận được.
9.6Mã hoá vị trí#
Self-attention không có khái niệm thứ tự. Nếu hoán vị các token đầu vào, khi không có mặt nạ, thì các vector đầu ra chỉ hoán vị theo, giá trị của từng vector không đổi. Hai câu "chó cắn người" và "người cắn chó" vì vậy sẽ cho cùng một tập biểu diễn. Ví dụ 9.1 cho thấy điều này ở quy mô nhỏ: đổi thứ tự ba cặp khoá–giá trị thì ba trọng số đổi chỗ theo, còn đầu ra vẫn là , vì trung bình có trọng số không phụ thuộc thứ tự cộng. Thông tin vị trí phải được đưa vào riêng, và có ba cách chính.
Cách đầu tiên, dùng trong bài báo gốc (Vaswani và cộng sự, 2017), là mã hoá sin–cos cố định: cộng vào embedding của token ở vị trí vector với và . Cách này không có tham số học, và bài báo gốc thấy embedding vị trí học được cho kết quả gần như như nhau. Các tần số khác nhau cho phép biểu diễn cả khoảng cách gần lẫn xa, và là một phép biến đổi tuyến tính của , nên mô hình có thể học quan hệ theo khoảng cách tương đối.
Cách thứ hai, dùng trong BERT và GPT-2, là embedding vị trí học được: một bảng tra kích thước , học như embedding của từ. Cách này đơn giản, nhưng không dùng được cho vị trí vượt quá , tức 512 với BERT và 1 024 với GPT-2.
Cách thứ ba đưa khoảng cách giữa hai vị trí trực tiếp vào điểm số attention thay vì cộng vào embedding. RoPE (Mục 10.3) xoay truy vấn và khoá theo vị trí; ALiBi (Press, Smith và Lewis, 2022) cộng vào điểm số một đại lượng tỉ lệ với khoảng cách. Đây là hướng mà phần lớn mô hình ngôn ngữ hiện nay đi theo.
9.7Encoder, decoder và encoder–decoder#
Bài báo gốc của Transformer dùng kiến trúc encoder–decoder cho dịch máy. Các mô hình về sau dùng một trong ba kiểu, khác nhau ở loại attention và mục tiêu tiền huấn luyện.
| Kiểu | Attention | Mục tiêu tiền huấn luyện | Mô hình tiêu biểu | Dùng cho |
|---|---|---|---|---|
| Chỉ encoder | hai chiều: mỗi token thấy mọi token | đoán các token bị che (masked language modeling) | BERT (Devlin và cộng sự, 2019), 110 triệu tham số với bản base | phân loại, trích xuất thông tin, embedding cho tìm kiếm |
| Chỉ decoder | nhân quả: mỗi token chỉ thấy các token phía trước | đoán token tiếp theo | GPT-2 (Radford và cộng sự, 2019), các mô hình ngôn ngữ lớn hiện nay | sinh văn bản, và qua sinh văn bản là hầu hết các nhiệm vụ khác |
| Encoder–decoder | encoder hai chiều; decoder nhân quả, thêm cross-attention tới đầu ra của encoder | khôi phục các đoạn văn bị che | T5 (Raffel và cộng sự, 2020) | dịch máy, tóm tắt, các bài toán biến chuỗi thành chuỗi |
BERT che ngẫu nhiên 15% số token và học đoán lại chúng từ cả hai phía, nên biểu diễn của mỗi token chứa thông tin của toàn câu; vì vậy các mô hình embedding văn bản thường dựa trên encoder (Chương 4 của Biểu diễn & Căn chỉnh). Mô hình chỉ decoder học từ mọi vị trí của mọi chuỗi (Mục 9.4), dùng một mục tiêu duy nhất, và sinh văn bản một cách tự nhiên; khi mở rộng quy mô, kiểu kiến trúc này trở thành lựa chọn của gần như mọi mô hình ngôn ngữ lớn. Các chương tiếp theo tập trung vào kiểu chỉ decoder.
9.8Tóm tắt#
Attention là một phép tra cứu mềm: so truy vấn với mọi khoá, biến độ giống nhau thành trọng số bằng softmax, rồi lấy trung bình có trọng số của các giá trị. Điểm số phải chia cho , vì phương sai của tích vô hướng bằng ; thí nghiệm cho thấy không chia thì entropy của attention ở chỉ còn 0,118 nat và attention gần như chỉ chọn một khoá. Nhiều đầu cho phép chú ý tới nhiều loại quan hệ cùng lúc với cùng số tham số, mặt nạ nhân quả cho phép huấn luyện song song trên mọi vị trí, và mã hoá vị trí đưa thứ tự vào một phép toán vốn không có thứ tự. Một khối Transformer gồm attention và FFN, mỗi phần có kết nối tắt và chuẩn hoá, trong đó FFN chiếm hai phần ba tham số còn attention là phần duy nhất trộn thông tin giữa các vị trí. Kiểu chỉ decoder trở thành kiến trúc của các mô hình ngôn ngữ lớn.
Khung của khối Transformer gần như giữ nguyên tới nay, nhưng các thành phần bên trong đã được thay gần hết kể từ bài báo gốc: vị trí của lớp chuẩn hoá, cách mã hoá vị trí, cách chia sẻ khoá và giá trị giữa các đầu, hàm kích hoạt của FFN, và cả cách tính attention trên phần cứng. Chương 10 xét từng thay đổi đó.
10Các cải tiến của Transformer#
Nếu đặt sơ đồ một khối của Llama 2 cạnh sơ đồ trong bài báo Transformer năm 2017, ta thấy cùng một khung: attention, FFN, kết nối tắt và chuẩn hoá. Nhìn kỹ từng thành phần thì gần như thành phần nào cũng đã đổi. Mỗi thay đổi ra đời để giải quyết một vấn đề cụ thể, có khi về độ ổn định khi huấn luyện, có khi về bộ nhớ khi suy luận, có khi về tốc độ trên phần cứng, và mỗi thay đổi cũng có điểm yếu riêng. Ta xét chúng theo thứ tự trong bảng tổng quan ở Mục 10.1.
10.1Những thay đổi so với Transformer gốc#
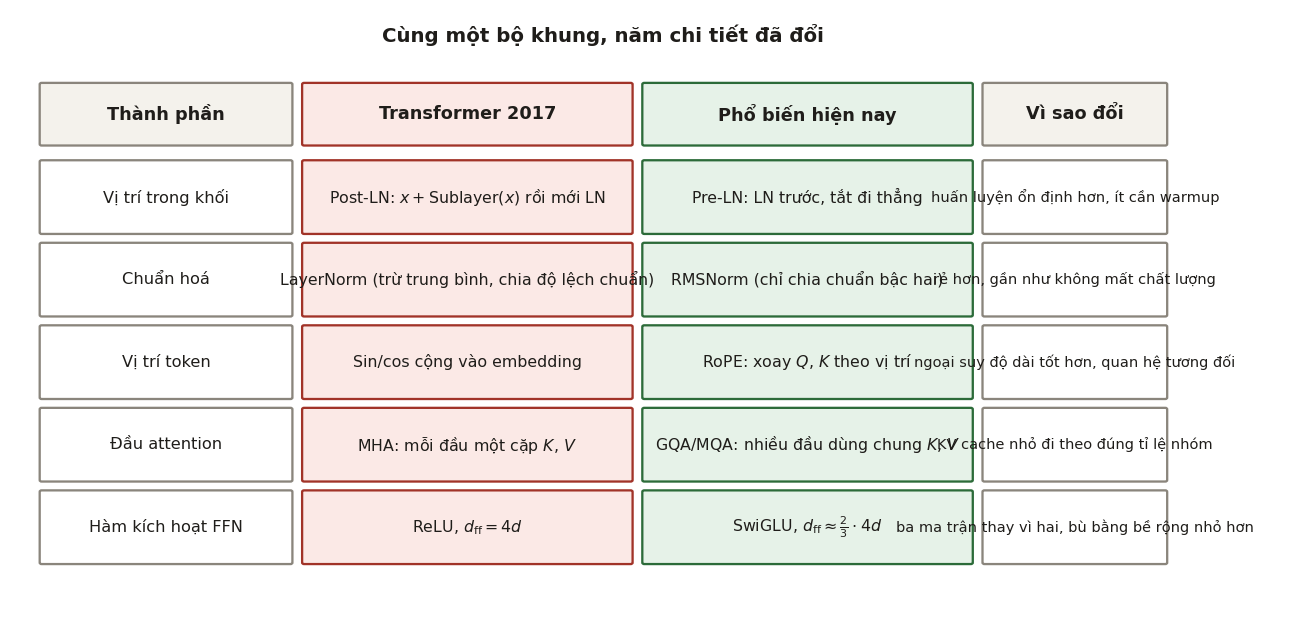
| Thành phần | Transformer 2017 | Phổ biến hiện nay | Lý do thay đổi | Mục |
|---|---|---|---|---|
| Vị trí lớp chuẩn hoá | sau khối con (post-LN) | trước khối con (pre-LN) | huấn luyện ổn định hơn | 10.2 |
| Loại chuẩn hoá | LayerNorm | RMSNorm | rẻ hơn, chất lượng tương đương | 6.4 |
| Thông tin vị trí | sin–cos cộng vào embedding | RoPE | quan hệ tương đối, mở rộng ngữ cảnh tốt hơn | 10.3 |
| Khoá và giá trị | mỗi đầu một cặp (MHA) | nhiều đầu chung một cặp (GQA) | KV cache nhỏ hơn khi suy luận | 10.4 |
| Khối FFN | ReLU, | SwiGLU, | chất lượng tốt hơn ở cùng số tham số | 10.5 |
Llama 2 (Touvron và cộng sự, 2023) là một ví dụ dùng cả năm lựa chọn ở cột thứ ba, với một ngoại lệ: bản 7B và 13B dùng MHA, chỉ bản 70B dùng GQA. Hai thay đổi còn lại của chương, mixture of experts và FlashAttention, không nằm trong bảng vì chúng không thay một thành phần mà thay cách tổ chức hoặc cách tính.
Bảng cũng chưa liệt kê những thay đổi nhỏ hơn mà các mô hình 2024–2025 dùng rộng rãi, theo tổng hợp của Raschka (2025) và bài giảng CS336. Phần lớn mô hình bỏ hệ số chặn trong các lớp tuyến tính và không dùng dropout khi tiền huấn luyện. Nhiều mô hình chuẩn hoá truy vấn và khoá trước khi tính điểm số, gọi là QK-norm, để điểm số attention không phình ra trong khi huấn luyện. Một số mô hình xen các lớp attention cục bộ, chỉ nhìn một cửa sổ trượt, với các lớp attention toàn cục để giảm KV cache: Gemma 3 dùng năm lớp cục bộ với cửa sổ 1 024 token cho mỗi lớp toàn cục (Gemma Team, 2025).
10.2Pre-LN và post-LN#
Bài báo gốc đặt chuẩn hoá sau phép cộng của kết nối tắt, , cách làm gọi là post-LN. Phần lớn mô hình hiện nay đặt chuẩn hoá trước khối con, , gọi là pre-LN, và thêm một lớp chuẩn hoá sau khối cuối cùng.
Khác biệt nằm ở đường tắt. Với post-LN, tín hiệu đi từ đầu vào tới đầu ra phải qua một lớp chuẩn hoá ở mỗi khối. Với pre-LN, đường tắt đi thẳng qua mọi khối mà không qua phép biến đổi nào, đúng cấu hình "chuẩn hoá trong nhánh, đường tắt đi thẳng" mà Mục 6.3 đo được là ổn định. Xiong và cộng sự (2020) phân tích gradient lúc khởi tạo và chỉ ra rằng với post-LN, gradient của các tham số gần đầu ra rất lớn, nên cần warmup để tránh các bước cập nhật quá lớn ở đầu quá trình huấn luyện; với pre-LN, gradient có độ lớn hợp lý ở mọi lớp, và mô hình huấn luyện được với ít hoặc không cần warmup.
Pre-LN cũng có nhược điểm: độ lớn của tín hiệu trên đường tắt tăng dần theo độ sâu, nên các khối ở sâu đóng góp tương đối ít hơn. Một số nghiên cứu cho thấy post-LN, khi huấn luyện được ổn định, có thể cho chất lượng cuối cao hơn một chút, và đã có các biến thể kết hợp ưu điểm của cả hai. Trong thực hành, pre-LN vẫn là lựa chọn mặc định, vì khi huấn luyện một mô hình lớn tốn kém, độ ổn định quan trọng hơn một chút chất lượng. Một số mô hình mới thử vị trí khác mà vẫn giữ đường tắt đi thẳng: OLMo 2 (Team OLMo, 2024) đặt chuẩn hoá ở cuối nhánh dư, sau khối con, còn Gemma 3 chuẩn hoá cả trước lẫn sau khối con. Bài giảng CS336 lưu ý rằng cả hai đều không phải post-LN kiểu 2017, vì phép cộng của đường tắt không đi qua lớp chuẩn hoá nào.
10.3RoPE#
RoPE (rotary position embedding; Su và cộng sự, 2024) đưa thông tin vị trí vào attention bằng cách quay vector truy vấn và khoá một góc tỉ lệ với vị trí, thay vì cộng một vector vị trí vào embedding.
Định nghĩa 10.1 (RoPE)
Chia chiều của một vector thành cặp. Với vị trí , phép biến đổi quay cặp thứ một góc trong mặt phẳng của cặp đó, với , . Truy vấn tại vị trí và khoá tại vị trí được thay bằng và trước khi tính điểm số attention.
Mệnh đề 10.1
Với mọi , và mọi vị trí , : . Như vậy điểm số attention chỉ phụ thuộc vào khoảng cách tương đối .
Chứng minh
là ma trận khối đường chéo gồm các ma trận quay , nên nó trực giao: . Hai phép quay cùng mặt phẳng cộng góc, nên . Do đó .
Trường hợp cho thấy cơ chế mà không cần ký hiệu khối: chỉ có một cặp, và là phép quay góc . Lấy và . Tại và , và , nên tích vô hướng là . Dời cả hai sang vị trí 10 và 12 thì góc chênh vẫn là và tích vô hướng vẫn là 0,540. Bài giảng CS336 diễn đạt cùng ý bằng một câu: trong "chúng tôi biết" và "dĩ nhiên chúng tôi biết", hai chữ "tôi" và "biết" đứng ở những vị trí tuyệt đối khác nhau nhưng cách nhau cùng một khoảng, nên với RoPE, điểm số giữa chúng như nhau. Dãy tần số giống dãy tần số của mã hoá sin–cos ở Mục 9.6: cặp đầu quay nhanh, phù hợp để phân biệt khoảng cách gần; cặp cuối quay rất chậm, phân biệt được khoảng cách xa.
Thí nghiệm trong code/models/experiments.py kiểm tra mệnh đề với và hai vector ngẫu nhiên.
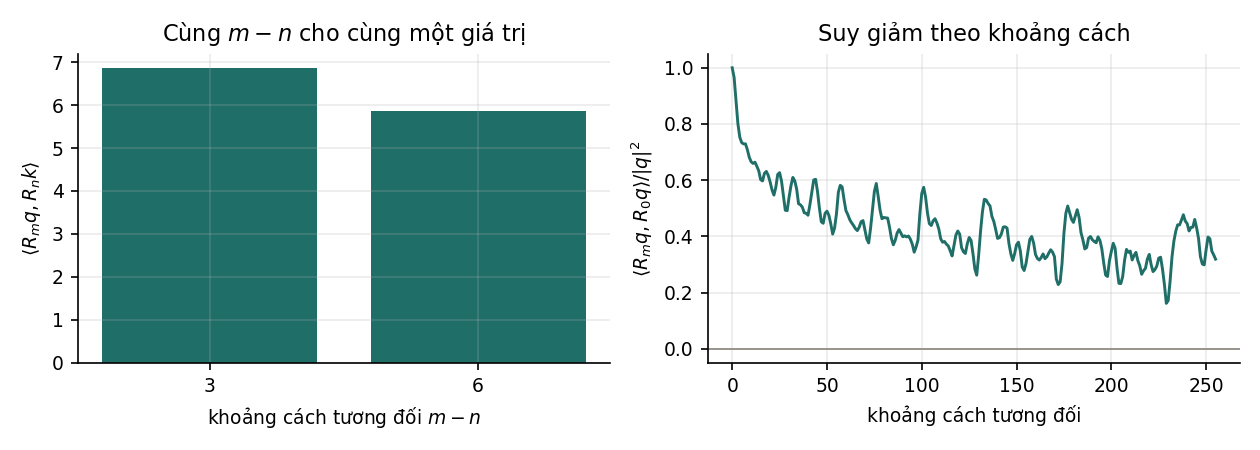
| 5 | 2 | 3 | 6,851342 |
| 105 | 102 | 3 | 6,851342 |
| 500 | 497 | 3 | 6,851342 |
| 9 | 3 | 6 | 5,861634 |
| 109 | 103 | 6 | 5,861634 |
Các cặp có cùng khoảng cách cho cùng giá trị tới chữ số thứ sáu sau dấu phẩy, đúng như mệnh đề. Thí nghiệm còn đo độ tương đồng của một vector với chính nó ở hai vị trí cách nhau , trung bình trên 300 vector ngẫu nhiên.
| 0 | 8 | 64 | 255 | |
|---|---|---|---|---|
| 1,000 | 0,708 | 0,439 | 0,319 |
Kết quả này có công thức rõ ràng: , tức một trung bình có trọng số của . Khi tăng, các cặp có tần số khác nhau lệch pha nhau và trung bình giảm dần. Đây là tính chất suy giảm theo khoảng cách mà bài báo RoPE nêu: cùng một nội dung, ở xa thì có xu hướng nhận điểm attention thấp hơn. Bài báo chỉ chứng minh tính chất này cho một chặn trên của điểm số chứ không cho chính điểm số, vì vậy nó chỉ nên được hiểu như một xu hướng. Về thực nghiệm, nhóm EleutherAI đo trên mô hình 125 triệu tham số được mất mát xác thực 2,809 với embedding vị trí học được, 2,801 với cách mã hoá tương đối của T5 và 2,759 với RoPE (Biderman và cộng sự, 2021).
RoPE có ba ưu điểm. Nó mã hoá vị trí tương đối mà không cần bảng tham số riêng. Nó chỉ tác động lên và , không thay đổi , không thêm tham số và không đổi kích thước tensor. Và nó cho phép mở rộng ngữ cảnh sau khi huấn luyện: vì không có bảng vị trí với giới hạn cứng, có thể co giãn các góc quay để mô hình huấn luyện với ngữ cảnh 4 096 token dùng được cho ngữ cảnh dài hơn, kèm một bước tinh chỉnh ngắn. Hai phương pháp phổ biến là nội suy vị trí (position interpolation; Chen và cộng sự, 2023), chia chỉ số vị trí cho hệ số mở rộng, và YaRN (Peng và cộng sự, 2024), co giãn khác nhau cho các dải tần số. Với nội suy vị trí, Chen và cộng sự mở rộng ngữ cảnh của LLaMA lên 32 768 token chỉ với khoảng 1 000 bước tinh chỉnh.
10.4MQA và GQA#
Khi sinh văn bản, mỗi token mới cần khoá và giá trị của mọi token trước đó ở mọi lớp. Để không phải tính lại, chúng được lưu trong KV cache. Với attention nhiều đầu thông thường (multi-head attention, MHA), mỗi đầu có khoá và giá trị riêng, nên dung lượng KV cache tỉ lệ với số đầu:
trong đó hệ số 2 cho khoá và giá trị, là số đầu có khoá và giá trị riêng, là số chuỗi xử lý cùng lúc.
Ý tưởng giảm KV cache là cho nhiều đầu truy vấn dùng chung khoá và giá trị. Ở mức cực đoan, MQA (multi-query attention; Shazeer, 2019) cho mọi đầu truy vấn dùng chung một cặp khoá và giá trị, tức . GQA (grouped-query attention; Ainslie và cộng sự, 2023) đi giữa hai thái cực: chia đầu truy vấn thành nhóm, mỗi nhóm dùng chung một cặp khoá và giá trị, nên . MQA là trường hợp , còn MHA là trường hợp .
KV cache giảm đúng lần. Với một mô hình cỡ Llama 2 70B (80 lớp, , 64 đầu truy vấn), ngữ cảnh 4 096 token, 8 chuỗi cùng lúc, lưu ở FP16, MHA với 64 đầu khoá–giá trị cần 80 GiB, còn GQA với 8 đầu cần 10 GiB. Mỗi token của mỗi chuỗi tốn 2,5 MiB với MHA và 0,3125 MiB với GQA.
MQA giảm KV cache nhiều nhất nhưng có thể làm giảm chất lượng và làm huấn luyện kém ổn định. Ainslie và cộng sự (2023) cho thấy GQA cho chất lượng gần MHA với tốc độ suy luận gần MQA, và một mô hình MHA đã huấn luyện có thể chuyển sang GQA bằng cách huấn luyện thêm với khoảng 5% lượng tính toán ban đầu. GQA vì vậy là một quyết định thiết kế vì bộ nhớ lúc suy luận, không phải vì chất lượng. DeepSeek-V2 (DeepSeek-AI, 2024) đi xa hơn với multi-head latent attention (MLA): khoá và giá trị được nén vào một vector ẩn nhỏ, và KV cache chỉ lưu vector đó; báo cáo của mô hình cho biết KV cache của MLA tương đương GQA với khoảng 2,25 nhóm, trong khi chất lượng tốt hơn MHA. Mục 2.2 của Ứng dụng LLM tính KV cache của Llama 3 8B, một mô hình dùng GQA, và hệ quả của nó lên chi phí phục vụ.
10.5SwiGLU#
Khối FFN gốc là với , gồm hai ma trận. Shazeer (2020) thử các biến thể có cổng, trong đó đầu ra của một nhánh tuyến tính được nhân từng phần tử với đầu ra của một nhánh khác:
Biến thể dùng SiLU (Swish), gọi là SwiGLU, cho chất lượng tốt nhất trong các thí nghiệm của bài báo và được nhiều mô hình ngôn ngữ dùng.
SwiGLU có ba ma trận , , thay vì hai. Để số tham số và số phép tính bằng khối FFN gốc, số chiều ẩn phải giảm: cho
Bài báo làm đúng như vậy: mô hình gốc có , các biến thể có cổng dùng . Trong thực tế, được làm tròn lên bội của một số như 128 hoặc 256 cho hiệu quả phần cứng. Với Llama 2 7B, nên , và giá trị thật chính là số đó làm tròn lên bội của 256. Tỉ lệ chỉ là điểm xuất phát: Llama 2 70B dùng .
10.6Mixture of experts#
Các thay đổi trên giữ nguyên số phép tính cho mỗi token. Mixture of experts đi theo hướng khác: tăng số tham số mà không tăng số phép tính. Trong một lớp mixture of experts (MoE; Shazeer và cộng sự, 2017), khối FFN được thay bằng khối FFN song song gọi là chuyên gia (expert), cùng một bộ định tuyến (router) chọn chuyên gia cho mỗi token, thường hoặc 2. Đầu ra là tổng có trọng số của các chuyên gia được chọn, với trọng số do bộ định tuyến tính.
Như vậy MoE tách số tham số khỏi số phép tính: tổng số tham số tăng theo , nhưng mỗi token chỉ đi qua chuyên gia. Chẳng hạn, Mixtral 8x7B (Jiang và cộng sự, 2024) có 8 chuyên gia mỗi lớp, mỗi token dùng 2, tổng khoảng 47 tỉ tham số nhưng mỗi token chỉ dùng khoảng 13 tỉ. Tổng không phải tỉ, vì chỉ các khối FFN được nhân bản, còn attention và embedding dùng chung. Các mô hình về sau chia nhỏ chuyên gia hơn nhiều: DeepSeek-V3 (DeepSeek-AI, 2024) có 256 chuyên gia trong mỗi lớp MoE cộng một chuyên gia dùng chung mà mọi token đều đi qua, mỗi token chọn 8 chuyên gia, nên trong 671 tỉ tham số chỉ khoảng 37 tỉ được dùng cho mỗi token.
Đổi lại, MoE kéo theo ba vấn đề kỹ thuật. Vấn đề đầu tiên là cân bằng tải: bộ định tuyến có xu hướng dồn phần lớn token vào vài chuyên gia, làm các chuyên gia khác không được huấn luyện, và cách xử lý thông dụng là thêm một hàm mất mát phụ phạt sự mất cân bằng (Fedus, Zoph và Shazeer, 2022). Vấn đề thứ hai là bộ nhớ: dù mỗi token chỉ dùng một phần, mọi chuyên gia đều phải nằm sẵn trong bộ nhớ, vì token tiếp theo có thể cần bất kỳ chuyên gia nào. Vấn đề thứ ba là truyền dữ liệu: khi các chuyên gia nằm trên nhiều GPU khác nhau, mỗi lớp MoE phải gửi token tới GPU chứa chuyên gia được chọn rồi nhận kết quả về. Vì vậy MoE có lợi khi giới hạn là số phép tính; nếu giới hạn là bộ nhớ, MoE không giúp được.
10.7FlashAttention#
Thay đổi cuối cùng không động tới mô hình mà tới cách tính. Tính attention trực tiếp theo Định nghĩa 9.1 tạo ra ma trận điểm số cho mỗi đầu và lưu nó trong bộ nhớ chính của GPU (HBM). Với , 32 đầu và số 16 bit, riêng các ma trận này đã chiếm 1 GiB cho một chuỗi ở một lớp. Ngoài dung lượng, việc ghi và đọc lại ma trận lớn này từ HBM còn tốn thời gian hơn chính các phép tính, vì trên GPU hiện đại tốc độ tính toán vượt xa tốc độ truy cập bộ nhớ.
FlashAttention (Dao và cộng sự, 2022) tính chính xác cùng kết quả mà không bao giờ tạo ra toàn bộ ma trận . Thuật toán chia , , thành các khối đủ nhỏ để nằm trong bộ nhớ nhanh trên chip (SRAM), và tính softmax theo từng khối bằng kỹ thuật softmax trực tuyến (Milakov và Gimelshein, 2018). Với mỗi hàng, thuật toán giữ giá trị lớn nhất và tổng của các điểm số đã xử lý; khi gặp khối mới có giá trị lớn nhất , nó nhân tổng cũ và kết quả tích luỹ cũ với rồi cộng phần của khối mới. Chẳng hạn một hàng có bốn điểm số chia thành hai khối và . Sau khối đầu, và . Khối thứ hai có giá trị lớn nhất 3, nên tổng cũ được nhân với rồi cộng thêm : , đúng bằng tổng tính trực tiếp trên cả bốn điểm số. Ở lượt ngược, các giá trị cần thiết được tính lại từ các khối thay vì đọc từ bộ nhớ.
Nhờ vậy bộ nhớ cho attention tăng tuyến tính theo thay vì theo , và thời gian chạy giảm đáng kể vì ít truy cập HBM hơn, dù số phép tính tăng nhẹ do phải tính lại ở lượt ngược. FlashAttention không thay đổi bậc của số phép tính; nó thay đổi cách thực hiện chúng trên phần cứng. Bài báo đo cụ thể trên GPT-2 medium với chuỗi 1 024 token trên GPU A100, tính cả lượt xuôi và lượt ngược: FlashAttention làm nhiều phép tính hơn, 75,2 so với 66,6 GFLOP, nhưng đọc ghi bộ nhớ chính ít hơn khoảng chín lần, 4,4 so với 40,3 GB, và chạy nhanh hơn khoảng 5,7 lần, 7,3 so với 41,7 ms. Số phép tính không quyết định thời gian chạy khi giới hạn nằm ở bộ nhớ. Các thư viện huấn luyện và phục vụ mô hình ngôn ngữ hiện nay đều dùng FlashAttention hoặc các cài đặt cùng ý tưởng (Dao, 2024).
10.8Tóm tắt#
Khung của Transformer giữ nguyên từ năm 2017, nhưng các thành phần đã thay đổi vì những lý do cụ thể. Pre-LN cho đường tắt đi thẳng nên huấn luyện ổn định hơn post-LN. RoPE quay truy vấn và khoá theo vị trí, nên điểm số attention chỉ phụ thuộc khoảng cách tương đối, và thí nghiệm xác nhận điều này tới chữ số thứ sáu. GQA cho nhiều đầu truy vấn dùng chung khoá và giá trị, giảm KV cache của một mô hình cỡ Llama 2 70B từ 80 GiB xuống 10 GiB trong ví dụ đã tính. SwiGLU thêm cổng vào FFN và giảm xuống để giữ số tham số. MoE tăng số tham số mà không tăng số phép tính cho mỗi token, đổi lại phải cân bằng tải và giữ mọi chuyên gia trong bộ nhớ. FlashAttention tính đúng attention mà không tạo ma trận , nên bộ nhớ tăng tuyến tính theo độ dài chuỗi.
Đến đây ta có đủ các thành phần của một mô hình ngôn ngữ hiện đại. Sau mỗi lượt xuôi, mô hình đó chỉ cho ra một phân phối xác suất trên từ vựng; muốn có văn bản, còn phải quyết định chọn token nào từ phân phối ấy. Chương 11 bàn về quyết định này.
11Các chiến lược giải mã#
Sau mỗi lượt xuôi, mô hình ngôn ngữ cho ra một phân phối xác suất trên toàn bộ từ vựng cho token tiếp theo. Để có văn bản, cần một quy tắc chọn token từ phân phối đó, gọi là chiến lược giải mã. Quy tắc này nằm hoàn toàn ngoài mô hình, nhưng ảnh hưởng của nó lớn hơn nhiều người nghĩ: cùng một mô hình với hai chiến lược khác nhau cho ra hai hệ thống có hành vi rất khác nhau, một bên lặp lại nhạt nhẽo, một bên lan man khó kiểm soát.
11.1Bài toán giải mã#
Tại mỗi bước, mô hình cho vector logit trên toàn bộ từ vựng, và phân phối của token tiếp theo là . Giải mã (decoding) là quy tắc chọn một token từ , nối vào chuỗi, rồi lặp lại cho tới khi gặp token kết thúc hoặc đạt độ dài tối đa.
Để so sánh các chiến lược, ta dùng hai đại lượng mô tả một phân phối. Đại lượng thứ nhất là entropy , tính bằng nat, đo mức không chắc chắn. Giá trị gọi là perplexity của phân phối, và có thể hiểu là số lựa chọn hiệu dụng: phân phối đều trên token có . Đại lượng thứ hai là số token phủ 90% xác suất, tức số token ít nhất, lấy theo thứ tự xác suất giảm dần, có tổng xác suất đạt 0,9.
11.2Các chiến lược#
Bảng dưới tóm tắt các chiến lược giải mã phổ biến và trường hợp dùng của mỗi chiến lược.
| Chiến lược | Quy tắc | Phù hợp với |
|---|---|---|
| Greedy | luôn chọn token có xác suất cao nhất | bài toán có một đáp án đúng: trích xuất, phân loại, trả lời ngắn |
| Beam search | giữ chuỗi có xác suất cao nhất ở mỗi bước, mở rộng song song | dịch máy, nhận dạng tiếng nói |
| Lấy mẫu với nhiệt độ | lấy mẫu từ | văn bản mở, hội thoại |
| Top- (Fan, Lewis và Dauphin, 2018) | chỉ giữ token có xác suất cao nhất, chuẩn hoá lại rồi lấy mẫu | cắt đuôi phân phối với ngưỡng cố định |
| Top-, hay nucleus (Holtzman và cộng sự, 2020) | giữ tập nhỏ nhất các token có tổng xác suất ít nhất , chuẩn hoá lại rồi lấy mẫu | cắt đuôi với ngưỡng thích ứng theo phân phối |
Nhiệt độ làm phân phối nhọn hơn, làm phân phối phẳng hơn; cho greedy, giữ nguyên phân phối của mô hình. Các biến thể mới hơn tiếp tục điều chỉnh cách cắt đuôi, chẳng hạn min- (Nguyen và cộng sự, 2025) chỉ giữ các token có xác suất ít nhất một tỉ lệ cố định của xác suất lớn nhất.
Một từ vựng chỉ có bốn token đủ để thấy mỗi chiến lược làm gì. Với logit , softmax cho phân phối ở dòng đầu của bảng dưới, có entropy 0,948 nat, tức khoảng 2,6 lựa chọn hiệu dụng.
| Chiến lược | Token 1 | Token 2 | Token 3 | Token 4 | Entropy (nat) |
|---|---|---|---|---|---|
| Phân phối gốc, | 0,644 | 0,237 | 0,087 | 0,032 | 0,948 |
| 0,865 | 0,117 | 0,016 | 0,002 | 0,455 | |
| 0,455 | 0,276 | 0,167 | 0,102 | 1,245 | |
| Top-, | 0,731 | 0,269 | 0 | 0 | 0,582 |
| Top-, | 0,665 | 0,245 | 0,090 | 0 | 0,832 |
Greedy luôn chọn token 1. Nhiệt độ chia mọi logit cho nên đổi xác suất của cả bốn token: dồn 86,5% vào token 1, làm phân phối phẳng hơn, nhưng không token nào bị loại hẳn. Top- với bỏ hai token cuối rồi chuẩn hoá lại. Top- với cộng dồn xác suất theo thứ tự giảm dần, 0,644 rồi 0,881 rồi 0,968, nên giữ ba token đầu, tập nhỏ nhất có tổng đạt 0,9.
11.3Ảnh hưởng của các chiến lược tới phân phối#
Để thấy các chiến lược khác nhau ra sao, thí nghiệm trong code/models/experiments.py dựng một phân phối trên 50 000 token có đuôi dài, với logit lấy từ phân phối chuẩn có độ lệch chuẩn 2,2, rồi đo entropy, số token phủ 90% xác suất và xác suất của token đứng đầu sau mỗi phép biến đổi.
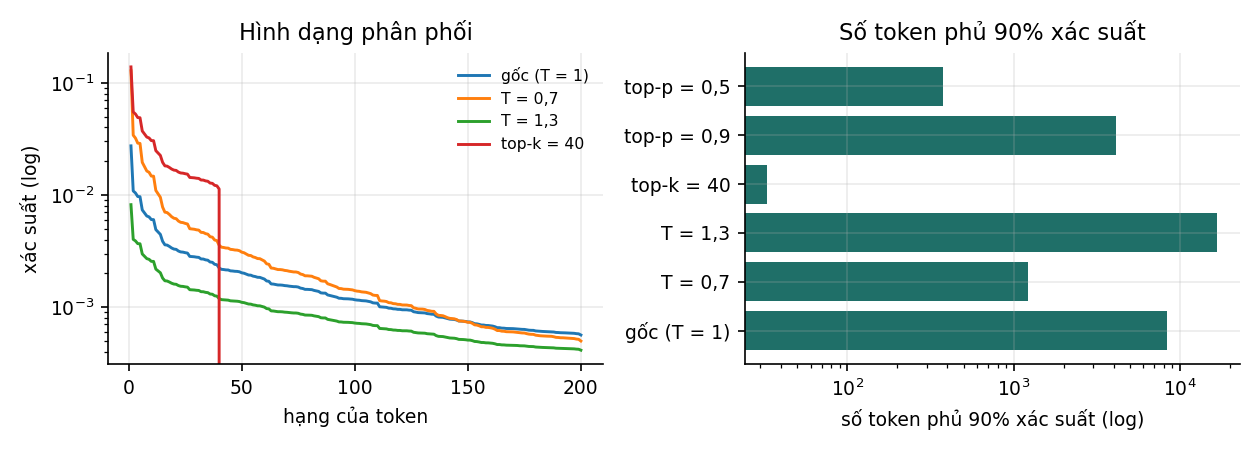
| Chiến lược | Entropy (nat) | Số lựa chọn hiệu dụng | Số token phủ 90% | Xác suất token đầu |
|---|---|---|---|---|
| Phân phối gốc, | 8,223 | 3 726 | 8 362 | 0,027 |
| 5,886 | 360 | 1 215 | 0,128 | |
| 9,305 | 10 993 | 16 766 | 0,008 | |
| Top-, | 3,449 | 31 | 33 | 0,139 |
| Top-, | 7,669 | 2 141 | 4 141 | 0,030 |
| Top-, | 5,673 | 291 | 376 | 0,055 |
Dòng đầu cho thấy phân phối gốc có đuôi rất dài: cần 8 362 token để phủ 90% xác suất. Lấy mẫu trực tiếp từ phân phối này nghĩa là ở mỗi bước có một xác suất đáng kể chọn phải một token rất ít khả năng, và một token sai có thể kéo lệch cả phần văn bản sau đó.
So các dòng còn lại, ta thấy hai cơ chế khác nhau. Nhiệt độ co giãn cả phân phối, còn top- và top- cắt bỏ phần đuôi. Với , vẫn còn 1 215 token trong vùng 90%, trong khi top- với chỉ còn 33. Vì hai cơ chế khác nhau, chúng thường được dùng cùng nhau: cắt đuôi bằng top-, rồi điều chỉnh độ tập trung bằng nhiệt độ.
Giữa hai cách cắt đuôi, top- thích ứng theo phân phối, còn top- thì không. Khi mô hình rất chắc chắn, gần như toàn bộ xác suất nằm ở một vài token, nhưng top- với vẫn giữ 40 lựa chọn; khi mô hình không chắc chắn, hàng trăm token đều hợp lý, nhưng top- cắt bớt còn 40. Top- giữ ít token ở trường hợp đầu và nhiều token ở trường hợp sau.
Số lựa chọn hiệu dụng còn được dùng để đo độ đa dạng của mẫu sinh ra, chẳng hạn số chế độ dữ liệu mà một mạng đối sinh phủ được (Chương 10 của Biểu diễn & Căn chỉnh).
11.4Beam search và văn bản mở#
Greedy chọn token tốt nhất ở từng bước, nhưng chuỗi gồm các lựa chọn tốt nhất từng bước chưa chắc là chuỗi có xác suất cao nhất; đây là cùng kiểu hạn chế của thuật toán tham lam khi xây cây ở Mục 3.2. Tìm chính xác chuỗi có xác suất cao nhất thì không khả thi: với từ vựng 50 000 token, riêng số chuỗi dài 10 token đã là . Beam search nằm giữa hai cực đó. Nó giữ ứng viên ở mỗi bước, mở rộng mỗi ứng viên bằng mọi token, rồi chỉ giữ lại chuỗi có xác suất cao nhất.
Andrew Ng và d2l.ai đều giải thích beam search bằng một ví dụ tính tay; một ví dụ cùng kiểu với số riêng như sau. Sau câu mở đầu "Trời hôm nay", giả sử mô hình cho token tiếp theo là "đẹp" với xác suất 0,6, "mưa" với 0,3 và "lạnh" với 0,1. Sau "đẹp", token tiếp theo là "quá" với xác suất 0,4, "lắm" với 0,35 và "và" với 0,25; sau "mưa", là "to" với 0,9 và "nhỏ" với 0,1. Greedy chọn "đẹp" rồi "quá", được chuỗi có xác suất . Beam search với giữ cả "đẹp" và "mưa" sau bước đầu. Ở bước hai, nó so năm chuỗi "đẹp quá" 0,24, "đẹp lắm" 0,21, "đẹp và" 0,15, "mưa to" và "mưa nhỏ" 0,03, rồi giữ "mưa to" và "đẹp quá". Chuỗi "mưa to" có xác suất cao hơn chuỗi của greedy, dù token đầu của nó chỉ đứng thứ hai. Beam search vẫn là một phép tìm kiếm gần đúng: với nhỏ, nó vẫn có thể bỏ sót chuỗi tốt nhất, và chi phí của nó gấp khoảng lần greedy.
Beam search còn một khuyết điểm mà các bài giảng đều nhắc. Điểm số của một chuỗi là tổng log-xác suất của các token, mỗi số hạng đều âm, nên chuỗi càng dài điểm càng thấp và beam search thiên về câu ngắn. Cách sửa thông dụng là chia tổng cho , với là độ dài chuỗi: là không chuẩn hoá, là lấy trung bình theo token, còn Andrew Ng và d2l.ai dùng khoảng 0,7 đến 0,75. Chẳng hạn một chuỗi 3 token có tổng log-xác suất và một chuỗi 6 token có tổng . Không chuẩn hoá thì chuỗi ngắn thắng. Với , điểm số của chúng là và , và chuỗi dài thắng.
Khi kết quả của beam search tệ, Andrew Ng gợi ý một phép phân tích lỗi để biết nên sửa phần nào. Gọi là kết quả của beam search và là một kết quả tốt, chẳng hạn bản dịch của người, rồi dùng chính mô hình để tính và . Nếu , mô hình đã đánh giá cao hơn nhưng beam search không tìm thấy, nên tăng có thể giúp. Nếu ngược lại, lỗi nằm ở mô hình, và tăng không giúp được gì. Đếm hai trường hợp trên nhiều ví dụ lỗi cho biết nên dành công sức cho bộ giải mã hay cho mô hình, theo đúng tinh thần phân tích lỗi ở Mục 1.3.
Với văn bản mở, beam search lại cho kết quả kém: văn bản thường lặp lại, nhạt và chung chung. Holtzman và cộng sự (2020) giải thích rằng văn bản do con người viết không có xác suất cao một cách đều đặn theo mô hình, mà thường có những lựa chọn ít khả năng. Tối đa hoá xác suất của cả chuỗi vì vậy đẩy kết quả về phía văn bản an toàn và đơn điệu. Các con số của họ trên GPT-2 Large cho thấy rõ điều này. Văn bản do người viết có perplexity 12,38 theo mô hình, còn văn bản sinh bằng greedy và bằng beam search với chỉ có 1,50 và 1,48, tức dễ đoán hơn nhiều so với văn bản thật. Tỉ lệ đoạn sinh ra rơi vào vòng lặp là 73,66% với greedy và 28,94% với beam search, so với 0,28% ở văn bản của người. Lấy mẫu top- với cho perplexity 13,13 và tỉ lệ lặp 0,36%, gần với văn bản thật hơn hẳn. Do đó sinh văn bản mở thường dùng lấy mẫu, còn các bài toán có một đáp án đúng rõ ràng như dịch máy vẫn dùng beam search.
Hai kỹ thuật thường dùng để giảm lặp là phạt lặp, tức giảm logit của các token đã xuất hiện (Keskar và cộng sự, 2019), và cấm lặp lại một cụm token đã có. Phạt lặp có một chi tiết cài đặt hay gây nhầm. Công thức của CTRL chia logit của các token đã xuất hiện cho một hệ số, thường khoảng 1,2. Với logit dương, phép chia làm giảm đúng như ý muốn, 2,4 thành 2,0; nhưng với logit âm, nó lại làm tăng, thành . Thư viện Transformers của Hugging Face vì vậy nhân logit âm với hệ số thay vì chia, nên thành . API của OpenAI dùng cách trừ: presence penalty trừ một hằng số khỏi logit của mọi token đã xuất hiện, còn frequency penalty trừ một lượng tỉ lệ với số lần token đó đã xuất hiện. Cả hai là biện pháp điều chỉnh bên ngoài, không giải quyết nguyên nhân từ phía mô hình.
11.5Giải mã trong hệ thống thực tế#
Khi đưa vào hệ thống thật, giải mã có mấy điểm cần biết. Điểm đầu tiên là nhiệt độ 0 chưa chắc cho kết quả tất định. Với , quy tắc là greedy, nhưng phép cộng số thực không có tính kết hợp, và thứ tự cộng trong các kernel trên GPU có thể phụ thuộc vào kích thước lô, tức vào những yêu cầu khác đang được xử lý cùng lúc. Hai lần gọi giống hệt nhau vì vậy có thể cho kết quả khác nhau khi hai logit gần bằng nhau (He, 2025). Trong thí nghiệm của He, 1 000 lần gọi mô hình Qwen3-235B với cùng một câu lệnh và nhiệt độ 0 cho 80 kết quả khác nhau; mọi kết quả trùng nhau ở 102 token đầu và bắt đầu khác nhau từ token thứ 103. Sau khi thay các kernel bằng phiên bản cho kết quả không phụ thuộc kích thước lô, cả 1 000 kết quả giống hệt nhau, đổi lại hệ thống chạy chậm hơn. Không nên hứa với người dùng rằng đầu ra là tất định nếu hệ thống không được thiết kế riêng cho điều đó.
Điểm thứ hai là độ trễ. Mỗi token đầu ra cần một lượt xuôi qua toàn bộ mô hình, nên chi phí tỉ lệ với số token sinh ra, và yêu cầu mô hình trả lời ngắn gọn giảm chi phí và độ trễ một cách trực tiếp. Giải mã suy đoán (speculative decoding; Leviathan, Kalman và Matias, 2023; Chen và cộng sự, 2023) giảm độ trễ theo một cách khác: một mô hình nhỏ đề xuất trước vài token, mô hình lớn kiểm tra tất cả trong một lượt xuôi, và một quy tắc chấp nhận–từ chối bảo đảm phân phối của đầu ra đúng bằng phân phối của mô hình lớn. Kỹ thuật này giảm độ trễ mà không thay đổi chất lượng.
Quy tắc chấp nhận–từ chối đủ đơn giản để kiểm tra bằng tay. Gọi là phân phối của mô hình nhỏ và là phân phối của mô hình lớn tại cùng một vị trí. Token do mô hình nhỏ đề xuất được nhận với xác suất ; nếu bị từ chối, token được lấy mẫu lại từ phần dư sau khi chuẩn hoá. Xét hai token A, B với và . A được đề xuất với xác suất 0,8 và được nhận với xác suất , nên đầu ra là A với xác suất 0,6. B được đề xuất với xác suất 0,2 và luôn được nhận. A bị từ chối với xác suất , và khi đó phần dư chỉ còn B. Tổng cộng, đầu ra là B với xác suất , đúng bằng .
Tỉ lệ chấp nhận trung bình trong ví dụ trên là , và nó quyết định kỹ thuật này nhanh tới đâu. Nếu mỗi token được nhận với xác suất và mô hình nhỏ đề xuất token mỗi lượt, số token sinh được sau một lượt xuôi của mô hình lớn có kỳ vọng (Leviathan, Kalman và Matias, 2023); với và , con số này là 3,36 thay vì 1. Tốc độ thực tế thấp hơn vì mô hình nhỏ cũng tốn thời gian: Leviathan và cộng sự đo được mức tăng tốc 2 đến 3 lần với T5-XXL, còn Chen và cộng sự đo được 2 đến 2,5 lần với Chinchilla 70B.
Điểm cuối cùng là giải mã có thể được dùng để ép định dạng. Giải mã có ràng buộc đặt xác suất bằng 0 cho các token làm đầu ra vi phạm một cú pháp cho trước, chẳng hạn một lược đồ JSON, nên bảo đảm đầu ra đúng định dạng. Kỹ thuật này bảo đảm định dạng nhưng không giữ nguyên phân phối: Park và cộng sự (2024) chỉ ra rằng che token theo từng bước làm lệch phân phối của đầu ra so với phân phối của chính mô hình khi chỉ xét các chuỗi hợp lệ. Xét một ví dụ nhỏ. Mô hình sinh chuỗi gồm hai token, mỗi token là A hoặc B; cú pháp chỉ cấm chuỗi AB, và mô hình cho , , còn sau B thì A và B đều có xác suất 0,5. Theo chính mô hình, ba chuỗi hợp lệ AA, BA, BB có xác suất 0,06; 0,2; 0,2, tức 0,13; 0,43; 0,43 sau khi chuẩn hoá. Giải mã có ràng buộc vẫn cho phép A ở bước đầu, vì AA hợp lệ, rồi buộc token thứ hai là A, nên sinh ra AA với xác suất 0,6, gần gấp năm lần. Sai lệch chỉ lớn khi cú pháp cấm đúng những đường mà mô hình ưa thích; nếu mô hình vốn đã dồn xác suất vào các đầu ra hợp lệ, chẳng hạn vì định dạng được mô tả và cho ví dụ ngay trong câu lệnh, thì phép che gần như không thay đổi gì. Mục 4.4 của Ứng dụng LLM trình bày cách dùng kỹ thuật này.
11.6Tóm tắt#
Giải mã là quy tắc chọn token từ phân phối mà mô hình cho ra, và nó quyết định hành vi của hệ thống không kém gì mô hình. Greedy và beam search hợp với bài toán có một đáp án đúng. Beam search tìm được chuỗi có xác suất cao hơn greedy, như "mưa to" với 0,27 so với "đẹp quá" với 0,24 trong ví dụ, nhưng cần chuẩn hoá theo độ dài để khỏi thiên về câu ngắn. Văn bản mở dùng lấy mẫu, vì tối đa hoá xác suất của cả chuỗi cho văn bản nhạt và lặp: trên GPT-2 Large, 73,66% số đoạn sinh bằng greedy rơi vào vòng lặp. Trên một phân phối có đuôi dài, cần 8 362 token để phủ 90% xác suất; nhiệt độ co giãn cả phân phối, còn top- và top- cắt đuôi, với top- thích ứng theo mức chắc chắn của mô hình. Trong hệ thống thật, nhiệt độ 0 chưa chắc cho kết quả tất định, chi phí tỉ lệ với số token sinh ra, giải mã suy đoán giảm độ trễ mà không đổi phân phối nhờ quy tắc chấp nhận với xác suất , còn giải mã có ràng buộc bảo đảm định dạng nhưng có thể làm lệch phân phối.
Cả giải mã lẫn các cải tiến ở Chương 10 đều quay về cùng một câu hỏi thực tế: mô hình tốn bao nhiêu bộ nhớ và bao nhiêu phép tính. Chương 12 trả lời câu hỏi đó bằng các công thức tính được trên giấy, và kiểm chứng chúng với các mô hình thật.
12Tham số, FLOP và bộ nhớ của Transformer#
Khi làm việc với mô hình lớn, nhiều câu hỏi quan trọng có thể trả lời trên giấy trong vài phút, trước khi chạy bất cứ thứ gì: mô hình có vừa bộ nhớ GPU không, huấn luyện mất bao lâu, tăng gấp đôi độ dài ngữ cảnh thì chi phí tăng bao nhiêu. Các công thức để trả lời đều dựng được từ những gì đã học ở Chương 9 và 10. Ta sẽ dựng chúng rồi kiểm chứng với các con số thật của GPT-2 và Llama 2; như sẽ thấy, công thức đếm tham số khớp tới từng tham số.
12.1Mục đích của việc ước lượng#
Câu hỏi thường gặp nhất là mô hình có vừa hay không. Số tham số nhân số byte mỗi tham số cho dung lượng trọng số, và cần cộng thêm KV cache khi suy luận, hoặc gradient, trạng thái của bộ tối ưu và giá trị kích hoạt khi huấn luyện. Câu hỏi thứ hai là tốn bao nhiêu thời gian: số phép tính chia cho tốc độ tính thực tế của phần cứng cho thời gian huấn luyện hoặc độ trễ. Câu hỏi thứ ba là khi thay đổi một cấu hình, như tăng độ dài ngữ cảnh, dùng GQA hay lượng tử hoá trọng số xuống 4 bit, thì chi phí thay đổi thế nào. Cả ba đều bắt đầu từ việc đếm tham số.
12.2Số tham số của một khối Transformer#
Với là số chiều của mô hình và là số chiều ẩn của FFN, bỏ qua hệ số chặn và tham số của các lớp chuẩn hoá, bảng dưới đếm tham số của một khối.
| Thành phần | Số tham số |
|---|---|
| , , | |
| FFN, hai ma trận , | |
| Tổng một khối, với |
Với khối, số tham số không tính embedding là
Đây là công thức Kaplan và cộng sự (2020) dùng trong nghiên cứu về quy luật co giãn. Phần embedding thêm tham số cho bảng embedding từ vựng, cộng nếu dùng embedding vị trí học được. Nếu lớp chiếu ra từ vựng không dùng chung trọng số với bảng embedding, cộng thêm nữa.
12.3Kiểm chứng trên GPT-2 và Llama 2#
Thí nghiệm trong code/models/experiments.py tính đầy đủ số tham số, kể cả hệ số chặn và tham số của LayerNorm, rồi so với số tham số đếm trực tiếp trên các mô hình GPT-2 mà OpenAI đã phát hành.
| Mô hình | Theo công thức | Mô hình phát hành | Chênh lệch | |
|---|---|---|---|---|
| GPT-2 small (, ) | 124 439 808 | 124 439 808 | 0 | 84 934 656 |
| GPT-2 medium (, ) | 354 823 168 | 354 823 168 | 0 | 301 989 888 |
| GPT-2 large (, ) | 774 030 080 | 774 030 080 | 0 | 707 788 800 |
Công thức khớp chính xác tới từng tham số với cả ba kích thước. Các con số trong bài báo GPT-2 lại khác: 117 triệu, 345 triệu và 762 triệu. Kho mã của OpenAI về sau ghi chú rằng các con số ban đầu sai do một lỗi, và tên gọi 124M, 355M, 774M dùng hiện nay đến từ cách đếm trực tiếp như ở bảng trên. Phép đếm tay vì vậy còn có ích để kiểm tra chính các con số được công bố.
Chia nhỏ GPT-2 small cho thấy tham số nằm ở đâu.
| Thành phần | Số tham số | Tỉ lệ |
|---|---|---|
| Embedding từ vựng () | 38 597 376 | 31,0% |
| Embedding vị trí () | 786 432 | 0,6% |
| Attention, 12 khối | 28 348 416 | 22,8% |
| FFN, 12 khối | 56 669 184 | 45,5% |
Bảng chia nhỏ cho thấy hai điều. Embedding chiếm 31% số tham số của GPT-2 small: với mô hình nhỏ và từ vựng lớn, phần embedding chiếm tỉ trọng lớn, nên các nghiên cứu về quy luật co giãn tách riêng số tham số không tính embedding. Còn trong các khối Transformer, FFN chiếm 67% số tham số, đúng tỉ lệ ở Mục 12.2.
Cùng cách đếm áp dụng được cho kiến trúc kiểu Llama, chỉ cần sửa bốn chỗ: FFN dạng SwiGLU có ba ma trận, nên mỗi khối có tham số; RMSNorm chỉ có ; không có hệ số chặn và không có embedding vị trí, vì vị trí được mã hoá bằng RoPE; và lớp chiếu ra không dùng chung trọng số với embedding. Kết quả cho Llama 2 7B là 6 738 415 616 và cho Llama 2 13B là 13 015 864 320, khớp chính xác với số tham số của trọng số đã phát hành. Bài tập 1 yêu cầu tự tính con số của bản 7B.
12.4Số FLOP#
Phép nhân ma trận với tốn FLOP, vì mỗi phần tử kết quả cần phép nhân và phép cộng. Với mỗi token, mỗi tham số của một lớp tuyến tính tham gia đúng một phép nhân và một phép cộng ở lượt xuôi, nên
Lượt ngược tốn khoảng gấp đôi lượt xuôi: một lần cho gradient theo đầu vào của mỗi lớp, để truyền tiếp về phía trước, và một lần cho gradient theo trọng số. Vì vậy huấn luyện tốn khoảng FLOP mỗi token, và toàn bộ quá trình huấn luyện trên token tốn
Với GPT-2 small, , nên suy luận tốn khoảng 170 triệu FLOP mỗi token và huấn luyện khoảng 510 triệu FLOP mỗi token. Đó là con số theo quy ước của Kaplan và cộng sự, chỉ tính các tham số không thuộc embedding. Bảng embedding đầu vào đúng là không tốn phép tính, vì chỉ là phép tra bảng, nhưng lớp chiếu ra từ vựng là một phép nhân ma trận thật. Với GPT-2 small, lớp này tốn thêm triệu FLOP mỗi token ở lượt xuôi, gần một nửa con số 170 triệu, dù ma trận của nó dùng chung với bảng embedding.
Ví dụ 12.1 (Ngân sách huấn luyện Llama 2 7B)
Llama 2 7B có tham số không tính embedding và được huấn luyện trên token, nên FLOP. GPU A100 đạt tối đa 312 TFLOPS với số bf16, nhưng trong thực tế chỉ dùng được một phần; tỉ lệ này gọi là mức sử dụng phần cứng (model FLOPs utilization, MFU), thường 30% tới 50% với mô hình lớn. Với MFU 30%, 37,6% và 40%, ước lượng lần lượt là 230 627, 184 011 và 172 970 giờ-GPU. Meta công bố 184 320 giờ-GPU (Touvron và cộng sự, 2023), ứng với MFU khoảng 37,5%, nằm trong khoảng thông thường. Công thức vì vậy cho đúng bậc độ lớn của chi phí huấn luyện; con số chính xác phụ thuộc hiệu suất của hệ thống.
Con số 37,5% còn phụ thuộc vào cách đếm. Nếu lấy là tổng số tham số, 6 738 415 616, MFU thành khoảng 39%. Nếu cộng thêm phép tính của attention theo quy ước của PaLM (Chowdhery và cộng sự, 2022), tức FLOP mỗi token khi huấn luyện với , MFU thành khoảng 45%. Khi so MFU giữa các báo cáo, cần xem họ đếm những phép tính nào.
Cùng phép tính cho phép trả lời nhanh những câu hỏi mà bài giảng CS336 dùng làm bài tập nhẩm. Huấn luyện một mô hình 70 tỉ tham số trên 15 nghìn tỉ token bằng 1 024 GPU H100 mất bao lâu? Tổng là FLOP. Một H100 đạt khoảng 989 TFLOPS với bf16 khi không dùng tính thưa; với MFU 50%, 1 024 GPU làm được khoảng FLOP mỗi ngày, nên cần khoảng 144 ngày. Karpathy làm phép tính tương tự cho GPT-2 small trong nanoGPT: 124 triệu tham số, 300 tỉ token và 8 GPU A100 với MFU 30% cho khoảng 3,5 ngày, còn lần huấn luyện thật hội tụ sau khoảng 4 ngày.
Công thức dẫn tới một câu hỏi thiết kế: với một ngân sách tính toán cố định, nên chia giữa kích thước mô hình và lượng dữ liệu thế nào? Hoffmann và cộng sự (2022) huấn luyện hơn 400 mô hình và kết luận rằng và nên tăng cùng tỉ lệ khi tăng, với khoảng 20 token dữ liệu cho mỗi tham số; mô hình Chinchilla 70B huấn luyện trên 1,4 nghìn tỉ token theo nguyên tắc này tốt hơn các mô hình lớn hơn nhiều nhưng ít dữ liệu hơn. Kết quả này được gọi là quy luật co giãn tối ưu về tính toán. Trong thực tế, nhiều mô hình được huấn luyện trên lượng dữ liệu vượt xa tỉ lệ 20 token mỗi tham số, vì mô hình nhỏ hơn rẻ hơn khi phục vụ; Llama 2 7B dùng khoảng 300 token mỗi tham số, còn Llama 3 8B dùng hơn 15 nghìn tỉ token, gần 1 900 token mỗi tham số (Llama Team, 2024).
Khi đọc các quy luật co giãn cần để ý được đếm thế nào. Kaplan và cộng sự dùng số tham số không tính embedding, còn Hoffmann và cộng sự dùng tổng số tham số; với GPT-2 small, hai con số là 85 triệu và 124 triệu. Hai nhóm đi tới hai khuyến nghị khác nhau: Kaplan và cộng sự khuyên tăng nhanh hơn nhiều khi ngân sách tăng, còn Chinchilla khuyên tăng như nhau. Pearce và Song (2024) cho thấy phần lớn chênh lệch đó đến từ chính khác biệt trong cách đếm , cộng với việc Kaplan và cộng sự làm thí nghiệm ở quy mô nhỏ, nơi embedding chiếm tỉ trọng lớn.
Công thức chỉ tính các phép nhân với ma trận trọng số, chưa tính hai phép nhân phụ thuộc độ dài ngữ cảnh trong attention: điểm số và tích với . Với mỗi token và mỗi lớp, mỗi phép tốn khoảng FLOP khi tính trên cả ngữ cảnh token, tổng cho cả mô hình. So với , ta có
Với GPT-2 small (, ), tỉ lệ là 0,22, tức attention chiếm phần nhỏ. Với , tỉ lệ là 0,17 ở , nhưng 1,33 ở và 5,33 ở , khi attention trở thành phần chính. Như vậy chi phí tăng theo bình phương độ dài chỉ thực sự chi phối khi vượt khoảng . Nếu cài đặt bỏ qua phần bị mặt nạ nhân quả che, như FlashAttention, chi phí attention giảm khoảng một nửa và ngưỡng thành , là con số mà Kaplan và cộng sự (2020) dùng.
12.5Bộ nhớ#
Bộ nhớ gồm nhiều khoản, mỗi khoản phụ thuộc vào những đại lượng khác nhau, và nhầm lẫn giữa chúng là nguyên nhân của nhiều sự cố hết bộ nhớ. Bảng dưới tách riêng từng khoản.
| Khoản | Công thức | Phụ thuộc vào |
|---|---|---|
| Trọng số | số byte mỗi tham số | số tham số |
| Gradient | số byte | số tham số; chỉ khi huấn luyện |
| Trạng thái của bộ tối ưu | Adam: byte, cộng bản sao FP32 của trọng số khi huấn luyện với độ chính xác hỗn hợp | số tham số; chỉ khi huấn luyện |
| Giá trị kích hoạt | tỉ lệ với , cộng một phần tỉ lệ với nếu lưu ma trận attention | kích thước lô, độ dài chuỗi; chỉ khi huấn luyện |
| KV cache | số byte | độ dài ngữ cảnh, số chuỗi; chỉ khi suy luận |
Khi huấn luyện với độ chính xác hỗn hợp và Adam, mỗi tham số cần khoảng 16 byte (Rajbhandari và cộng sự, 2020): 2 byte cho trọng số 16 bit, 2 byte cho gradient 16 bit, 4 byte cho bản sao trọng số FP32 mà bộ tối ưu cập nhật, và 8 byte cho hai trạng thái , của Adam ở FP32. Với mô hình 7 tỉ tham số, con số là 112 GB, chưa tính giá trị kích hoạt, nên không vừa một GPU 80 GB. Các kỹ thuật như ZeRO (Rajbhandari và cộng sự, 2020) chia gradient và trạng thái bộ tối ưu cho nhiều GPU để giải quyết vấn đề này. Huấn luyện hoàn toàn bằng FP32 cũng tốn đúng 16 byte mỗi tham số, gồm 4 cho trọng số, 4 cho gradient và 8 cho Adam, nên độ chính xác hỗn hợp không giảm các khoản này; lợi ích của nó nằm ở tốc độ tính và ở bộ nhớ cho giá trị kích hoạt, vốn được lưu ở 16 bit. Phép tính theo chiều ngược lại cũng hữu ích, và CS336 dùng nó làm bài tập nhẩm thứ hai: 8 GPU 80 GB, với 16 byte mỗi tham số và mọi khoản được chia đều cho các GPU, chứa được khoảng tham số, tức 40 tỉ, trước khi tính giá trị kích hoạt.
Giá trị kích hoạt có thể còn lớn hơn thế. Korthikanti và cộng sự (2022) ước lượng mỗi khối Transformer huấn luyện với số 16 bit cần khoảng byte cho giá trị kích hoạt, với là độ dài chuỗi, là kích thước lô và là số đầu attention. Với cấu hình của Llama 2 7B (, , 32 khối), một chuỗi 4 096 token cần khoảng 97 GiB, trong đó 80 GiB là số hạng đến từ các ma trận attention . FlashAttention (Mục 10.7) không lưu các ma trận này, đưa con số xuống khoảng 17 GiB, và gradient checkpointing (Mục 5.3) giảm tiếp bằng cách tính lại.
Khi suy luận, trọng số và KV cache là hai khoản chính. Với Llama 2 7B dùng MHA (32 lớp, 32 đầu, ) ở FP16, KV cache tốn byte, tức 0,5 MiB mỗi token; một chuỗi 4 096 token cần 2 GiB, bằng khoảng 16% dung lượng trọng số 13,5 GB. Với nhiều chuỗi và ngữ cảnh dài, KV cache có thể vượt dung lượng trọng số. Mục 3.3 của Ứng dụng LLM dùng các con số này để ước lượng bộ nhớ khi tự triển khai mô hình.
Giảm số byte mỗi số là cách tác động trực tiếp lên mọi dòng của bảng trên, và là chủ đề của giáo trình Quantization.
12.6Tóm tắt#
Các công thức của chương được gom trong bảng dưới.
| Đại lượng | Công thức | Dùng để |
|---|---|---|
| Số tham số không tính embedding | (FFN hai ma trận, ) | ước lượng kích thước mô hình |
| FLOP suy luận mỗi token | , cộng cho attention | ước lượng độ trễ |
| FLOP huấn luyện | ước lượng ngân sách tính toán | |
| Ngưỡng attention chi phối chi phí | (tính đủ ma trận), (bỏ phần bị che) | quyết định có cần attention hiệu quả hơn không |
| KV cache mỗi token | số byte | ước lượng bộ nhớ khi suy luận |
| Bộ nhớ huấn luyện với Adam | khoảng 16 byte mỗi tham số, cộng giá trị kích hoạt | ước lượng bộ nhớ khi huấn luyện |
Công thức đếm tham số khớp tới từng tham số với GPT-2 và Llama 2, còn công thức cho đúng bậc độ lớn của 184 320 giờ-GPU mà Meta công bố cho Llama 2 7B khi mức sử dụng phần cứng khoảng 37,5%. Khi dùng cần nói rõ và các phép tính được đếm gồm những gì: cùng số giờ-GPU đó ứng với MFU 37,5%, 39% hay 45% tuỳ cách đếm, và hai quy luật co giãn của Kaplan và của Chinchilla khác nhau phần lớn vì đếm khác nhau. Attention chỉ chi phối chi phí tính toán khi độ dài ngữ cảnh vượt khoảng . Về bộ nhớ, huấn luyện tốn khoảng 16 byte mỗi tham số cộng giá trị kích hoạt, còn suy luận tốn trọng số cộng KV cache, và mỗi khoản phụ thuộc vào những đại lượng khác nhau.
Chương này khép lại phần kiến trúc của giáo trình. Đi từ các họ mô hình qua cây, mạng nhiều lớp, mạng tích chập, mạng hồi quy tới Transformer, ta đã thấy cùng một câu hỏi lặp lại dưới nhiều dạng: giả định nào của mô hình khớp với cấu trúc của dữ liệu, và làm sao để gradient đi được qua một mạng sâu. Hai giáo trình tiếp theo dùng trực tiếp các kết quả ở đây: Biểu diễn & Căn chỉnh xét những gì một mô hình như vậy học được và cách căn chỉnh nó theo ý người dùng, còn Quantization giảm số byte mỗi số trong mọi dòng của bảng bộ nhớ ở Mục 12.5. Chương 13 gồm các bài tập để luyện các phép tính của giáo trình, và Chương 14 gom các câu hỏi phỏng vấn thường gặp.
13Bài tập#
Các bài tập trải đều trên các chương của giáo trình. Phần lớn là phép tính tay với số liệu của các mô hình thật như Llama 2, vài bài là chứng minh ngắn, một bài là bài thiết kế và một bài là thí nghiệm sửa mã. Lời giải chi tiết, kèm nhãn chương và độ khó của từng bài, nằm ở trang Lời giải.
Bài 1 (tính tay). Tính số tham số của Llama 2 7B từ cấu hình: 32 khối, , , từ vựng 32 000 token, 32 đầu attention và 32 đầu khoá–giá trị, RoPE (không có embedding vị trí), RMSNorm (chỉ có ), không có hệ số chặn, FFN dạng SwiGLU, lớp chiếu ra không dùng chung trọng số với embedding. (a) Tính riêng số tham số của attention, FFN, các lớp chuẩn hoá, embedding và lớp chiếu ra. (b) So tổng với con số đã công bố 6 738 415 616. (c) Tỉ số bằng bao nhiêu? Vì sao nó không bằng 4? Gợi ý: SwiGLU có ba ma trận. So với (Mục 10.5).
Bài 2 (tính tay). Dùng kết quả Bài 1. (a) Tính số FLOP để huấn luyện Llama 2 7B trên token theo công thức . (b) Trên GPU A100 (312 TFLOPS với bf16), ước lượng số giờ-GPU khi mức sử dụng phần cứng (MFU) là 30% và 40%. (c) Meta công bố 184 320 giờ-GPU. Từ con số này, suy ra MFU thực tế. Giá trị đó có hợp lý không? (d) Vì sao trong công thức không tính tham số của embedding?
Bài 3 (suy luận). (a) Chứng minh: nếu các thành phần của độc lập, có trung bình 0 và phương sai 1 thì . (b) Dùng đạo hàm của softmax để giải thích vì sao điểm số có phương sai lớn làm gradient qua attention gần như bằng 0. (c) Nếu chia điểm số cho thay vì thì điều gì xảy ra khi lớn?
Bài 4 (tính tay). Một CNN chỉ gồm các lớp tích chập . (a) Với bước nhảy 1 ở mọi lớp, cần bao nhiêu lớp để trường tiếp nhận phủ hết ảnh rộng 224 điểm ảnh? (b) Nếu các lớp thứ 2, 4, 6, … có bước nhảy 2 và các lớp còn lại có bước nhảy 1, tính trường tiếp nhận sau 10 lớp. Cần bao nhiêu lớp để phủ 224 điểm ảnh? (c) Vì sao trường tiếp nhận hiệu dụng nhỏ hơn con số tính ở trên? Gợi ý: (Mục 7.2).
Bài 5 (chẩn đoán). Với mỗi tình huống, cho biết vấn đề chủ yếu là độ chệch hay phương sai, hay là dấu hiệu của lỗi, và nêu hai việc nên làm: (a) Sai số huấn luyện 2%, sai số xác thực 18%, khoảng cách không thu hẹp khi thêm dữ liệu vào tập huấn luyện nhưng vẫn giảm dần. (b) Sai số huấn luyện 24%, sai số xác thực 25%, cả hai đã nằm ngang. (c) Sai số xác thực 12%, sai số huấn luyện 15%.
Bài 6 (suy luận). Cho hàm lều . (a) Chứng minh ánh xạ lên . (b) Chứng minh bằng quy nạp rằng hợp với chính nó lần là một hàm tuyến tính từng khúc có đoạn. (c) Chứng minh một mạng một lớp ẩn với đầu vào một chiều cần ít nhất đơn vị ReLU để biểu diễn chính xác hàm đó, và so với đơn vị của mạng sâu.
Bài 7 (suy luận). (a) Bỏ qua hàm tanh, gradient của một RNN tuyến tính sau 100 bước lùi có độ lớn cỡ với là bán kính phổ của . Tính giá trị này khi và . So với số đo ở Mục 8.2 và giải thích vì sao chúng khác nhau. (b) Dọc theo ô nhớ của LSTM, gradient nhân với cổng quên ở mỗi bước. Tính khi hệ số chặn của cổng quên là 1 và là 4 (bỏ qua phần phụ thuộc đầu vào), và thang thời gian tương ứng. (c) Vì sao gradient bùng nổ dễ xử lý hơn gradient tiêu biến?
Bài 8 (tính tay). Một mô hình 70 tỉ tham số có 80 lớp, và 64 đầu truy vấn. Tính dung lượng KV cache ở FP16 cho ngữ cảnh 4 096 token và 8 chuỗi cùng lúc, trong hai trường hợp: (a) MHA với 64 đầu khoá–giá trị; (b) GQA với 8 đầu khoá–giá trị. (c) So với dung lượng trọng số ở FP16. Vì sao GQA là quyết định về bộ nhớ khi suy luận chứ không phải về chất lượng?
Bài 9 (thiết kế). Với mỗi bài toán, chọn họ mô hình và giải thích bằng thiên kiến quy nạp của mô hình và cấu trúc của dữ liệu, không dựa vào mức độ phổ biến của mô hình: (a) Dự đoán khách hàng rời bỏ dịch vụ từ 40 đặc trưng dạng bảng, 30 000 khách hàng, kết quả cần giải thích được cho bộ phận kinh doanh. (b) Phân loại ảnh sản phẩm lỗi trên dây chuyền, 3 000 ảnh có nhãn, các ảnh có bố cục rất giống nhau. (c) Trích xuất các trường thông tin từ hợp đồng dài 50 trang. (d) Dự báo phụ tải điện theo giờ cho 12 tháng tới.
Bài 10 (thí nghiệm). Trong phần (E) của code/models/experiments.py, thay softmax bằng một phép chuẩn hoá không có hàm mũ, ví dụ , rồi đo lại entropy theo khi không chia cho .
(a) Hiện tượng bão hoà còn xuất hiện không? Giải thích.
(b) Từ đó cho biết phép chia xử lý vấn đề của softmax hay của tích vô hướng.
(c) Nêu lý do attention vẫn dùng softmax.
Bài 11 (tính tay). Phát hiện đối tượng (Mục 7.5). (a) Tính IoU của hai hộp và , toạ độ dạng . (b) Chạy NMS với ngưỡng IoU 0,5 trên bốn hộp: điểm 0,9; điểm 0,8; điểm 0,7; điểm 0,6. Những hộp nào được giữ? (c) Một lớp có 4 hộp thật. Bộ phát hiện trả về 6 hộp; xếp theo điểm giảm dần, kết quả ghép ở ngưỡng IoU 0,5 lần lượt là: đúng, đúng, sai, đúng, sai, sai. Tính precision và recall sau mỗi hộp, rồi tính AP theo cách tính mọi điểm của PASCAL VOC. (d) Vì sao một hộp dự đoán trùng với hộp đúng của cùng đối tượng bị tính là dương tính giả, và điều đó liên quan gì tới NMS?
Bài 12 (tính tay). Giải mã (Mục 11.4 và 11.5). (a) Sau câu "Tôi muốn ăn", mô hình cho "phở" xác suất 0,5, "cơm" 0,4 và "bún" 0,1. Sau "phở", token tiếp theo là "bò" với xác suất 0,5, "gà" 0,3 và "cuốn" 0,2; sau "cơm", là "tấm" 0,8 và "rang" 0,2. Tìm chuỗi hai token mà greedy chọn và chuỗi mà beam search với chọn, kèm xác suất của chúng. (b) Hai chuỗi hoàn chỉnh: chuỗi 4 token có tổng log-xác suất , chuỗi 8 token có tổng . Với , và , chuẩn hoá theo độ dài chọn chuỗi nào? (c) Giải mã suy đoán trên ba token A, B, C, với phân phối của mô hình nhỏ và của mô hình lớn . Tính xác suất nhận của từng token và phân phối phần dư, rồi kiểm tra rằng phân phối của đầu ra đúng bằng . (d) Tính tỉ lệ chấp nhận trong (c) và số token kỳ vọng sau một lượt xuôi của mô hình lớn khi mô hình nhỏ đề xuất token mỗi lượt.
Bài 13 (tính tay). Tính toán tài nguyên theo kiểu bài tập nhẩm của CS336 (Mục 12.4 và 12.5). Một mô hình 13 tỉ tham số được huấn luyện trên 2 nghìn tỉ token bằng GPU A100, đạt tối đa 312 TFLOPS với bf16. (a) Với MFU 40%, ước lượng số giờ-GPU, và số ngày nếu dùng 1 024 GPU. (b) Meta công bố 368 640 giờ-GPU cho Llama 2 13B. Suy ra MFU và so với con số 37,5% của Llama 2 7B ở Ví dụ 12.1. (c) Với Adam và độ chính xác hỗn hợp, trọng số, gradient và trạng thái của bộ tối ưu cần bao nhiêu GB? Cần ít nhất bao nhiêu GPU 80 GB nếu mọi khoản được chia đều, và vì sao con số thực tế lớn hơn? (d) Với và , lớp chiếu ra từ vựng tốn bao nhiêu FLOP mỗi token ở lượt xuôi, và bằng bao nhiêu phần trăm của ? So với GPT-2 small ở Mục 12.4.
14Câu hỏi phỏng vấn#
14.1Cách trình bày câu trả lời#
Phần lớn câu hỏi phỏng vấn về mô hình và kiến trúc có dạng "vì sao X". Một câu trả lời tốt thường đi qua ba bước. Đầu tiên là vấn đề mà X giải quyết: không có X thì điều gì hỏng. Tiếp theo là cơ chế: X giải quyết vấn đề đó bằng cách nào, tốt nhất bằng một công thức ngắn hoặc một con số. Cuối cùng là giới hạn: X tốn kém ở đâu, và khi nào nó không còn tác dụng. Bước cuối thường là chỗ phân biệt người hiểu với người chỉ nhớ.
Các câu trả lời mẫu dưới đây dẫn số liệu từ các thí nghiệm của giáo trình. Khi phỏng vấn không cần nhớ chính xác từng con số, nhưng cần nắm độ lớn và chiều của hiệu ứng.
14.2Học máy cổ điển và mạng nơ-ron#
Câu hỏi: Giải thích phân rã độ chệch – phương sai.
Trả lời
Sai số bình phương kỳ vọng tại một điểm tách thành độ chệch², phương sai và nhiễu, với kỳ vọng lấy trên các tập huấn luyện có thể rút ra. Độ chệch là sai lệch có hệ thống do họ hàm quá hẹp; phương sai là mức dự đoán thay đổi khi đổi tập huấn luyện; nhiễu không giảm được. Giá trị thực tế của phân rã là phân biệt hai tình huống cần xử lý ngược nhau. Ở Mục 2.3, đa thức bậc 1 có độ chệch² chiếm 74% sai số, nên thêm dữ liệu không giúp gì; đa thức bậc 12 có phương sai gấp khoảng 1 900 lần độ chệch², nên thêm dữ liệu là cách sửa đúng.
Câu hỏi: Vì sao mạng nơ-ron cần hàm kích hoạt phi tuyến?
Trả lời
Vì hợp của các phép biến đổi affine vẫn là một phép biến đổi affine: . Không có hàm phi tuyến thì mạng bao nhiêu lớp cũng tương đương một lớp tuyến tính. Ví dụ đơn giản nhất là hàm XOR: không mô hình tuyến tính nào biểu diễn được, nhưng hai đơn vị ReLU ở lớp ẩn là đủ.
Câu hỏi: Mạng sâu hay mạng rộng?
Trả lời
Định lý xấp xỉ phổ quát nói mạng một lớp ẩn đủ rộng biểu diễn được mọi hàm liên tục, nhưng chỉ khẳng định sự tồn tại, không cho biết cần bao nhiêu đơn vị. Có những hàm mà mạng sâu biểu diễn với ít tham số hơn theo cấp số mũ. Ở Mục 4.4, hàm răng cưa đoạn biểu diễn được bằng mạng lớp với tham số, trong khi mạng một lớp ẩn cần ít nhất đơn vị; với là 42 so với 386 tham số. Đổi lại, mạng sâu khó tối ưu hơn, cần khởi tạo đúng, chuẩn hoá và kết nối tắt.
Câu hỏi: Rừng ngẫu nhiên hay gradient boosting?
Trả lời
Hai phương pháp tác động vào hai thành phần khác nhau của sai số. Rừng ngẫu nhiên lấy trung bình các cây sâu huấn luyện độc lập, nên giảm phương sai; thêm cây không gây overfitting, dễ chỉnh và dễ song song hoá. Gradient boosting cộng dần các cây nông, mỗi cây sửa phần sai của các cây trước, nên giảm độ chệch; thường chính xác hơn khi chỉnh tốt, nhưng nhạy với tốc độ học và số cây, và có thể overfitting nếu không dừng sớm. Ở Mục 3.4, bagging giảm phương sai của một cây sâu 8 đi một nửa, còn boosting 100 cây sâu 2 cho tổng sai số thấp nhất.
Câu hỏi: Vì sao cây quyết định không cần chuẩn hoá đặc trưng?
Trả lời
Vì mỗi phép chia có dạng chỉ phụ thuộc thứ tự các giá trị của đặc trưng. Mọi phép biến đổi đơn điệu, như chuẩn hoá hay lấy logarit, giữ nguyên thứ tự, nên không đổi tập các phép chia có thể có và không đổi cây. Mạng nơ-ron, hồi quy logistic, SVM và k-NN thì nhạy với thang đo.
14.3Huấn luyện mạng sâu#
Câu hỏi: Vì sao có gradient tiêu biến, và xử lý thế nào?
Trả lời
Gradient qua lớp là tích của ma trận Jacobi; nếu mỗi lớp nhân độ lớn với một hệ số lệch khỏi 1, tích co về 0 hoặc tăng vọt theo hàm mũ. Ở Mục 6.3, cùng một mạng 40 lớp, chỉ đổi hệ số khởi tạo từ 0,5 sang 2,0 làm gradient ở lớp đầu thay đổi từ tới . Ba cách xử lý bổ sung cho nhau: khởi tạo đúng phương sai (He cho ReLU), chuẩn hoá, và kết nối tắt. Kết nối tắt một mình làm gradient bùng nổ ( sau 40 lớp) vì mỗi lớp cộng thêm vào tín hiệu một lượng cùng cỡ; phải kết hợp với chuẩn hoá trong nhánh (tỉ lệ 2,22), đúng như cấu hình pre-LN của Transformer.
Câu hỏi: Hệ số 2 trong khởi tạo He đến từ đâu?
Trả lời
Từ ReLU. Với đối xứng quanh 0, vì ReLU đặt một nửa phân phối bằng 0. Muốn phương sai giữ nguyên qua lớp thì , tức . Với tanh, gần tuyến tính quanh 0, không có hệ số này và dùng khởi tạo Xavier.
Câu hỏi: BatchNorm khác LayerNorm thế nào? Vì sao Transformer dùng LayerNorm?
Trả lời
BatchNorm tính trung bình và phương sai trên các mẫu trong lô, riêng cho từng đặc trưng; LayerNorm tính trên các đặc trưng của một mẫu. Transformer dùng LayerNorm vì ba lý do: các chuỗi trong lô có độ dài khác nhau và có phần đệm; BatchNorm dùng thống kê của lô khi huấn luyện nhưng trung bình trượt khi suy luận, gây sai lệch khi sinh từng token; và BatchNorm làm dự đoán của một mẫu phụ thuộc các mẫu khác trong lô. RMSNorm bỏ bước trừ trung bình, rẻ hơn và chất lượng tương đương, nên được nhiều mô hình ngôn ngữ dùng.
Câu hỏi: Adam khác SGD thế nào? Hiệu chỉnh độ chệch trong Adam để làm gì?
Trả lời
Adam giữ trung bình trượt của gradient () và của bình phương gradient (), chia cho , nên mỗi tham số có bước đi riêng và ít nhạy với tốc độ học hơn SGD. Vì , ta có , tức là ước lượng chệch về 0 ở các bước đầu; chia cho cho ước lượng không chệch, và tương tự với . Đổi lại, Adam cần hai trạng thái cho mỗi tham số: với mô hình 7 tỉ tham số là 56 GB ở FP32. AdamW tách weight decay khỏi gradient, vì với Adam thường, thành phần phạt bị chia cho và tham số có gradient lớn lại bị phạt ít hơn.
Câu hỏi: Kết nối tắt giải quyết vấn đề gì?
Trả lời
Vấn đề suy thoái: trên CIFAR-10, mạng thường 56 lớp có sai số huấn luyện cao hơn mạng 20 lớp. Đây là vấn đề tối ưu, không phải overfitting, vì mạng sâu hơn biểu diễn được mọi thứ mạng nông biểu diễn được. Kết nối tắt làm ánh xạ đồng nhất dễ biểu diễn và cho gradient một đường đi không qua ma trận trọng số nào, vì Jacobi là . Kết nối tắt cần đi kèm chuẩn hoá mới ổn định.
Câu hỏi: Dropout hoạt động thế nào, và vì sao ít dùng khi tiền huấn luyện mô hình ngôn ngữ lớn?
Trả lời
Khi huấn luyện, mỗi đơn vị bị tắt với xác suất và các đơn vị còn lại được chia cho ; khi suy luận dùng mọi đơn vị. Mạng đầy đủ xấp xỉ trung bình của rất nhiều mạng con, nên dropout giảm phương sai tương tự bagging. Khi tiền huấn luyện trên kho dữ liệu cực lớn, mỗi mẫu thường chỉ được thấy một lần nên overfitting không phải vấn đề chính, và một số mô hình như PaLM không dùng dropout. Dropout vẫn hữu ích khi tinh chỉnh trên tập nhỏ.
14.4Transformer#
Câu hỏi: Giải thích attention.
Trả lời
Attention là phép tra cứu mềm, khả vi: mỗi vị trí tạo một truy vấn, so với khoá của mọi vị trí bằng tích vô hướng, chuẩn hoá các điểm số bằng softmax, rồi lấy trung bình có trọng số của các giá trị: . Trong một khối Transformer, attention là thành phần duy nhất kết hợp thông tin giữa các vị trí; FFN xử lý từng vị trí độc lập.
Câu hỏi: Vì sao chia điểm số cho ?
Trả lời
Nếu các thành phần của và độc lập, trung bình 0, phương sai 1 thì có phương sai . Điểm số lớn đẩy softmax về gần one-hot, nơi đạo hàm gần bằng 0. Chia cho đưa phương sai về 1 với mọi . Ở Mục 9.2, với và 64 khoá, không chia thì entropy của attention chỉ còn 0,118 nat so với tối đa 4,159, trọng số lớn nhất trung bình 0,953; có chia thì entropy giữ quanh 3,68 với mọi .
Câu hỏi: Attention nhiều đầu mang lại gì?
Trả lời
Không mang lại thêm khả năng tính toán: mỗi đầu hẹp đi lần nên tổng số tham số và số phép tính gần như bằng attention một đầu ở đủ số chiều. Nó cho phép mô hình cùng lúc theo dõi nhiều loại quan hệ khác nhau ở những vị trí khác nhau, điều mà một phép lấy trung bình duy nhất sẽ trộn lẫn. Các đầu có mức độ dư thừa nhất định: nhiều đầu có thể bỏ đi sau khi huấn luyện mà chất lượng giảm ít, và đó là cơ sở của MQA, GQA.
Câu hỏi: Vì sao Transformer thay thế RNN?
Trả lời
Không phải vì ít phép tính hơn: một lớp self-attention tốn , một lớp RNN tốn . Lý do là số bước tuần tự: RNN cần bước không song song hoá được, self-attention cần . Thêm vào đó, đường đi giữa hai vị trí bất kỳ trong self-attention dài thay vì , nên gradient nối hai token cách xa không phải qua hàng trăm phép nhân. Khi huấn luyện với mặt nạ nhân quả, một lượt xuôi tính được dự đoán cho mọi vị trí của chuỗi cùng lúc.
Câu hỏi: Vì sao cần mã hoá vị trí, và RoPE hoạt động thế nào?
Trả lời
Self-attention không có khái niệm thứ tự: hoán vị các token đầu vào thì đầu ra chỉ hoán vị theo, nên "chó cắn người" và "người cắn chó" cho cùng một tập biểu diễn. RoPE quay từng cặp chiều của truy vấn và khoá một góc tỉ lệ với vị trí, với tần số . Vì phép quay trực giao, : điểm số chỉ phụ thuộc khoảng cách tương đối. Ở Mục 10.3, các cặp vị trí , và cho cùng giá trị 6,851342. RoPE không thêm tham số, chỉ tác động lên và , và cho phép mở rộng ngữ cảnh sau huấn luyện bằng cách co giãn góc quay.
Câu hỏi: GQA là gì, và vì sao được dùng?
Trả lời
Nhiều đầu truy vấn dùng chung một cặp khoá và giá trị, nên KV cache giảm đúng theo tỉ số số đầu truy vấn trên số đầu khoá–giá trị. Với mô hình cỡ 70B, ngữ cảnh 4 096 token, 8 chuỗi, FP16: MHA với 64 đầu cần 80 GiB KV cache, GQA với 8 đầu cần 10 GiB. GQA là quyết định vì bộ nhớ và băng thông khi suy luận; chất lượng gần MHA nhưng không tốt hơn.
Câu hỏi: Vì sao của nhiều mô hình mới không bằng ?
Trả lời
Vì FFN dạng SwiGLU có ba ma trận thay vì hai. Để giữ số tham số và số phép tính, số chiều ẩn giảm còn . Với Llama 2 7B, , làm tròn lên bội của 256 được 11 008, đúng giá trị trong cấu hình.
Câu hỏi: Encoder, decoder và encoder–decoder khác nhau thế nào?
Trả lời
Encoder dùng attention hai chiều, tiền huấn luyện bằng cách đoán token bị che, cho biểu diễn tốt cho phân loại và tìm kiếm (BERT). Decoder dùng mặt nạ nhân quả, tiền huấn luyện bằng cách đoán token tiếp theo, dùng để sinh văn bản (GPT và gần như mọi mô hình ngôn ngữ lớn hiện nay). Encoder–decoder đọc đầu vào hai chiều rồi sinh đầu ra có cross-attention tới đầu vào, phù hợp với dịch máy và tóm tắt (T5).
Câu hỏi: FlashAttention làm gì?
Trả lời
Tính chính xác attention mà không lưu ma trận trong bộ nhớ chính của GPU: chia , , thành khối nằm vừa bộ nhớ trên chip, tính softmax theo từng khối bằng softmax trực tuyến, và tính lại ở lượt ngược. Bộ nhớ cho attention tăng tuyến tính theo thay vì bậc hai, và thời gian giảm vì ít truy cập bộ nhớ. Số phép tính vẫn là .
Câu hỏi: Nhiệt độ, top- và top- khác nhau thế nào?
Trả lời
Nhiệt độ chia mọi logit cho , nên co giãn cả phân phối mà không loại token nào; top- và top- cắt bỏ phần đuôi rồi chuẩn hoá lại. Top- giữ một số token cố định, còn top- giữ tập nhỏ nhất có tổng xác suất đạt , nên thích ứng theo mức chắc chắn của mô hình: giữ ít token khi mô hình chắc chắn, nhiều token khi không. Trên phân phối đuôi dài ở Mục 11.3, cần 8 362 token để phủ 90% xác suất; vẫn để lại 1 215 token trong vùng đó, còn top- với chỉ còn 33. Vì hai cơ chế khác nhau nên chúng thường được dùng cùng nhau.
Câu hỏi: Vì sao không dùng beam search để sinh văn bản mở?
Trả lời
Beam search tìm chuỗi có xác suất cao, nhưng văn bản do người viết không có xác suất cao một cách đều đặn. Trên GPT-2 Large, văn bản của người có perplexity 12,38 theo mô hình, còn văn bản của beam search chỉ có 1,48, và 28,94% số đoạn beam search sinh ra rơi vào vòng lặp, so với 0,28% ở văn bản thật (Holtzman và cộng sự, 2020). Beam search vẫn hợp với bài toán có một đáp án đúng như dịch máy, với điểm số được chuẩn hoá theo độ dài để khỏi thiên về câu ngắn.
Câu hỏi: Đặt nhiệt độ bằng 0 thì đầu ra có tất định không?
Trả lời
Chưa chắc. Quy tắc giải mã khi đó là greedy, nhưng phép cộng số thực không có tính kết hợp, và thứ tự cộng trong các kernel phụ thuộc kích thước lô, tức phụ thuộc vào những yêu cầu khác đang được xử lý cùng lúc. Khi hai logit gần bằng nhau, token được chọn có thể đổi. Trong thí nghiệm của He (2025), 1 000 lần gọi cùng một câu lệnh cho 80 kết quả khác nhau; chỉ khi dùng các kernel không phụ thuộc kích thước lô, cả 1 000 kết quả mới giống hệt nhau.
Câu hỏi: Giải mã suy đoán tăng tốc mà vẫn giữ đúng phân phối của mô hình lớn bằng cách nào?
Trả lời
Một mô hình nhỏ đề xuất token, rồi mô hình lớn kiểm tra tất cả trong một lượt xuôi. Token được nhận với xác suất , và khi bị từ chối thì được lấy mẫu lại từ phần dư đã chuẩn hoá; quy tắc này bảo đảm đầu ra có đúng phân phối của mô hình lớn. Với tỉ lệ chấp nhận , mỗi lượt xuôi của mô hình lớn sinh trung bình token, khoảng 3,36 khi và . Mức tăng tốc đo được thường là 2 đến 3 lần, vì mô hình nhỏ cũng tốn thời gian.
14.5Tính toán tài nguyên#
Câu hỏi: Một Transformer lớp, số chiều có bao nhiêu tham số?
Trả lời
Khoảng không tính embedding: cho , , , và cho FFN với . Cộng cho embedding từ vựng. FFN chiếm hai phần ba tham số của mỗi khối. Với mô hình nhỏ, embedding chiếm tỉ trọng lớn: 31% ở GPT-2 small. Mục 12.3 kiểm chứng công thức khớp chính xác với GPT-2 và Llama 2.
Câu hỏi: Huấn luyện một mô hình tốn bao nhiêu phép tính?
Trả lời
: mỗi token tốn khoảng FLOP ở lượt xuôi và ở lượt ngược, với là số tham số không tính embedding. Với Llama 2 7B, tỉ và token, FLOP. Con số 184 320 giờ-GPU A100 mà Meta công bố ứng với mức sử dụng phần cứng khoảng 37,5%, nằm trong khoảng thông thường 30–50%.
Câu hỏi: MFU là gì, và vì sao cần hỏi nó được đếm thế nào?
Trả lời
MFU (model FLOPs utilization) là tỉ số giữa tốc độ tính hữu ích, tức số phép tính mà mô hình cần theo công thức chia cho thời gian huấn luyện, và tốc độ đỉnh của phần cứng; với mô hình lớn, con số thường từ 30% tới 50%. Nó phụ thuộc vào cách đếm: cùng 184 320 giờ-GPU của Llama 2 7B ứng với MFU 37,5% nếu không tính embedding, 39% nếu là tổng số tham số, và khoảng 45% nếu cộng thêm phép tính của attention theo quy ước của PaLM. Khi so hiệu suất của hai hệ thống, cần biết mỗi bên đếm những phép tính nào.
Câu hỏi: Khi nào chi phí bậc hai của attention trở thành vấn đề?
Trả lời
Tỉ số giữa phần tính toán của attention và phần còn lại xấp xỉ khi tính đủ ma trận điểm số. Với , attention chỉ chiếm phần chính khi vượt khoảng 24 000 token; ở nó mới bằng 17% phần còn lại. Về bộ nhớ, vấn đề xuất hiện sớm hơn nhiều nếu lưu ma trận attention, nên FlashAttention được dùng rộng rãi.
Câu hỏi: Vì sao hết bộ nhớ khi huấn luyện, và xử lý thế nào?
Trả lời
Bộ nhớ gồm trọng số, gradient và trạng thái bộ tối ưu (khoảng 16 byte mỗi tham số với Adam và độ chính xác hỗn hợp, tức 112 GB cho mô hình 7B), cộng giá trị kích hoạt tỉ lệ với kích thước lô và độ dài chuỗi. Nếu phần tăng theo lô là nguyên nhân, giảm kích thước lô và dùng tích luỹ gradient; tiếp theo là gradient checkpointing (bộ nhớ kích hoạt từ xuống , đổi lấy khoảng một lượt xuôi tính lại), FlashAttention, và chia trạng thái bộ tối ưu cho nhiều GPU như ZeRO.
14.6Thị giác máy tính#
Câu hỏi: IoU là gì, và vì sao dùng nó để đánh giá bộ phát hiện?
Trả lời
IoU là diện tích phần giao chia cho diện tích phần hợp của hai hộp, nằm trong khoảng từ 0 tới 1. Nó đo mức trùng khớp mà không phụ thuộc vào kích thước tuyệt đối của đối tượng, nên một ngưỡng như 0,5 dùng được cho cả đối tượng lớn lẫn nhỏ. Cần biết giới hạn của ngưỡng 0,5: một hộp chỉ phủ nửa đối tượng đã đạt IoU 0,5 (Ví dụ 7.2), vì vậy COCO lấy trung bình AP trên các ngưỡng từ 0,5 tới 0,95.
Câu hỏi: NMS hoạt động thế nào, và nó có nhược điểm gì?
Trả lời
Sắp xếp các hộp theo điểm, lấy hộp điểm cao nhất, bỏ các hộp còn lại có IoU với nó vượt ngưỡng, rồi lặp lại. NMS cần thiết vì bộ phát hiện dự đoán trên lưới dày nên một đối tượng có nhiều hộp. Nhược điểm: với các đối tượng đứng sát nhau, hộp đúng của đối tượng thứ hai có thể bị loại vì trùng nhiều với hộp của đối tượng thứ nhất; trong thí nghiệm ở Mục 7.5, NMS làm recall lớn nhất giảm từ 0,928 xuống 0,916. DETR tránh NMS bằng cách ghép một–một giữa dự đoán và hộp thật khi huấn luyện.
Câu hỏi: AP50 và AP@[0,5:0,95] khác nhau thế nào?
Trả lời
AP50 là diện tích dưới đường precision–recall khi một dự đoán được tính là đúng nếu IoU với hộp thật đạt 0,5. AP@[0,5:0,95], thước đo chính của COCO, là trung bình AP trên 10 ngưỡng IoU từ 0,5 tới 0,95, nên thưởng cho việc định vị chính xác. Cùng một bộ phát hiện mô phỏng ở Mục 7.5 có AP50 bằng 0,908 nhưng AP@[0,5:0,95] chỉ bằng 0,569. So sánh hai con số AP chỉ có nghĩa khi chúng cùng quy ước.
Câu hỏi: Vì sao focal loss giúp bộ phát hiện một giai đoạn?
Trả lời
Bộ một giai đoạn đánh giá hàng chục nghìn vị trí mỗi ảnh, phần lớn là nền dễ. Với cross-entropy, tổng mất mát nhỏ của rất nhiều mẫu dễ lấn át mất mát của số ít đối tượng thật. Focal loss nhân thêm hệ số : với , mẫu đã đúng với xác suất 0,9 chỉ còn 1% trọng số, nên gradient tập trung vào các mẫu khó.
Câu hỏi: U-Net khác một CNN phân loại ở điểm nào?
Trả lời
U-Net có nhánh mã hoá giống CNN phân loại và thêm một nhánh giải mã tăng dần độ phân giải về kích thước ảnh gốc. Ở mỗi mức độ phân giải, nhánh giải mã ghép đặc trưng của nhánh mã hoá cùng mức, để kết hợp thông tin "là gì" của lớp sâu với thông tin "ở đâu" của lớp nông. Nhờ vậy nó cho ra nhãn cho từng điểm ảnh với biên đối tượng chính xác, và học được từ ít ảnh có nhãn nếu tăng cường dữ liệu tốt.
14.7Các câu trả lời chưa đạt#
| Câu trả lời | Vì sao chưa đạt |
|---|---|
| "Chia để huấn luyện ổn định." | Đúng nhưng chưa đủ. Cần nêu phương sai của tích vô hướng bằng và hiện tượng bão hoà của softmax. |
| "Nhiều đầu attention làm mô hình mạnh hơn." | Không nêu được rằng tổng chi phí không đổi và cái nhận được là khả năng theo dõi nhiều loại quan hệ. |
| "ResNet ra đời để chống overfitting." | Sai: nó giải quyết vấn đề suy thoái, tức sai số huấn luyện tăng theo độ sâu. |
| "Kết nối tắt giải quyết gradient tiêu biến." | Chưa đủ: một mình kết nối tắt làm gradient bùng nổ, cần đi kèm chuẩn hoá. |
| "Mô hình càng nhiều tham số càng overfitting." | Đúng khi số tham số nhỏ hơn số điểm dữ liệu; với mô hình nhiều tham số hơn dữ liệu có hiện tượng double descent. |
| "Cây quyết định cần chuẩn hoá đặc trưng." | Sai: cây bất biến với phép biến đổi đơn điệu của từng đặc trưng. |
| "Adam luôn tốt hơn SGD." | Adam hội tụ nhanh hơn và ít phải chỉnh, nhưng SGD với momentum có thể tổng quát hoá tốt hơn trên một số bài toán thị giác. |
| "Transformer nhanh hơn RNN vì ít phép tính hơn." | Sai: self-attention tốn nhiều phép tính hơn khi . Transformer thắng ở số bước tuần tự. |
| "Mạng nào cũng cần dropout." | Nhiều mô hình ngôn ngữ lớn không dùng dropout khi tiền huấn luyện. |
| "GQA làm tăng chất lượng." | GQA giảm chất lượng một chút so với MHA; lý do dùng là KV cache nhỏ hơn. |
| "Bộ phát hiện này có AP 0,9 nên rất tốt." | Phải biết ngưỡng IoU và quy ước tính: cùng một bộ phát hiện có thể có AP50 bằng 0,91 và AP@[0,5:0,95] bằng 0,57 (Mục 7.5). |
15Tài liệu tham khảo#
Sách và học máy cổ điển
- T. Hastie, R. Tibshirani, J. Friedman. The Elements of Statistical Learning, 2nd ed. Springer, 2009. Nguồn chuẩn cho phân rã độ chệch – phương sai, cây quyết định, bagging và boosting.
- C. M. Bishop. Pattern Recognition and Machine Learning. Springer, 2006.
- I. Goodfellow, Y. Bengio, A. Courville. Deep Learning. MIT Press, 2016. Nguồn chuẩn cho lan truyền ngược, khởi tạo, regularization và tối ưu.
- D. H. Wolpert. The Lack of A Priori Distinctions Between Learning Algorithms. Neural Computation, 1996. Định lý "không có bữa trưa miễn phí" ở Mục 1.4.
- L. Hyafil, R. L. Rivest. Constructing Optimal Binary Decision Trees is NP-Complete. Information Processing Letters, 1976.
- L. Breiman. Bagging Predictors. Machine Learning, 1996.
- L. Breiman. Random Forests. Machine Learning, 2001. Lập luận về tương quan giữa các cây và permutation importance.
- J. H. Friedman. Greedy Function Approximation: A Gradient Boosting Machine. Annals of Statistics, 2001.
- J. H. Friedman. Stochastic Gradient Boosting. Computational Statistics & Data Analysis, 2002.
- T. Chen, C. Guestrin. XGBoost: A Scalable Tree Boosting System. KDD, 2016.
- G. Ke và cộng sự. LightGBM: A Highly Efficient Gradient Boosting Decision Tree. NeurIPS, 2017.
- L. Prokhorenkova và cộng sự. CatBoost: Unbiased Boosting with Categorical Features. NeurIPS, 2018.
- S. M. Lundberg, S.-I. Lee. A Unified Approach to Interpreting Model Predictions. NeurIPS, 2017. Phương pháp SHAP.
- L. Grinsztajn, E. Oyallon, G. Varoquaux. Why Do Tree-Based Models Still Outperform Deep Learning on Typical Tabular Data? NeurIPS Datasets and Benchmarks, 2022. Nguồn của nhận định ở Mục 1.2.
- M. Belkin, D. Hsu, S. Ma, S. Mandal. Reconciling Modern Machine-Learning Practice and the Classical Bias–Variance Trade-off. PNAS, 2019. Double descent.
- P. Nakkiran và cộng sự. Deep Double Descent: Where Bigger Models and More Data Hurt. ICLR, 2020.
Mạng nơ-ron và cách huấn luyện
- G. Cybenko. Approximation by Superpositions of a Sigmoidal Function. Mathematics of Control, Signals and Systems, 1989.
- K. Hornik. Approximation Capabilities of Multilayer Feedforward Networks. Neural Networks, 1991.
- M. Leshno, V. Y. Lin, A. Pinkus, S. Schocken. Multilayer Feedforward Networks with a Nonpolynomial Activation Function Can Approximate Any Function. Neural Networks, 1993.
- M. Telgarsky. Benefits of Depth in Neural Networks. COLT, 2016. Ý tưởng của phép dựng hàm răng cưa ở Mục 4.4.
- D. Hendrycks, K. Gimpel. Gaussian Error Linear Units (GELUs). arXiv:1606.08415, 2016.
- S. Elfwing, E. Uchibe, K. Doya. Sigmoid-Weighted Linear Units for Neural Network Function Approximation in Reinforcement Learning. Neural Networks, 2018.
- P. Ramachandran, B. Zoph, Q. V. Le. Searching for Activation Functions. arXiv:1710.05941, 2017.
- D. E. Rumelhart, G. E. Hinton, R. J. Williams. Learning Representations by Back-Propagating Errors. Nature, 1986.
- A. G. Baydin, B. A. Pearlmutter, A. A. Radul, J. M. Siskind. Automatic Differentiation in Machine Learning: a Survey. JMLR, 2018. Chế độ xuôi và chế độ ngược ở Mục 5.2.
- T. Chen, B. Xu, C. Zhang, C. Guestrin. Training Deep Nets with Sublinear Memory Cost. arXiv:1604.06174, 2016. Gradient checkpointing.
- D. P. Kingma, J. Ba. Adam: A Method for Stochastic Optimization. ICLR, 2015.
- I. Loshchilov, F. Hutter. SGDR: Stochastic Gradient Descent with Warm Restarts. ICLR, 2017. Lịch cosine.
- I. Loshchilov, F. Hutter. Decoupled Weight Decay Regularization. ICLR, 2019. AdamW.
- P. Goyal và cộng sự. Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour. arXiv:1706.02677, 2017. Quy tắc tuyến tính cho tốc độ học.
- S. Malladi, K. Lyu, A. Panigrahi, S. Arora. On the SDEs and Scaling Rules for Adaptive Gradient Algorithms. NeurIPS, 2022. Quy tắc căn bậc hai cho Adam.
- A. C. Wilson và cộng sự. The Marginal Value of Adaptive Gradient Methods in Machine Learning. NeurIPS, 2017.
- Y. N. Dauphin và cộng sự. Identifying and Attacking the Saddle Point Problem in High-Dimensional Non-Convex Optimization. NeurIPS, 2014.
- X. Glorot, Y. Bengio. Understanding the Difficulty of Training Deep Feedforward Neural Networks. AISTATS, 2010. Khởi tạo Xavier.
- K. He, X. Zhang, S. Ren, J. Sun. Delving Deep into Rectifiers. ICCV, 2015. Khởi tạo He.
- S. Ioffe, C. Szegedy. Batch Normalization. ICML, 2015.
- J. L. Ba, J. R. Kiros, G. E. Hinton. Layer Normalization. arXiv:1607.06450, 2016.
- B. Zhang, R. Sennrich. Root Mean Square Layer Normalization. NeurIPS, 2019.
- S. Santurkar, D. Tsipras, A. Ilyas, A. Madry. How Does Batch Normalization Help Optimization? NeurIPS, 2018.
- K. He, X. Zhang, S. Ren, J. Sun. Deep Residual Learning for Image Recognition. CVPR, 2016. Vấn đề suy thoái và kết nối tắt.
- N. Srivastava và cộng sự. Dropout: A Simple Way to Prevent Neural Networks from Overfitting. JMLR, 2014.
- C. Szegedy và cộng sự. Rethinking the Inception Architecture for Computer Vision. CVPR, 2016. Làm mượt nhãn.
- A. Chowdhery và cộng sự. PaLM: Scaling Language Modeling with Pathways. arXiv:2204.02311, 2022.
Mạng tích chập và mạng hồi quy
- K. Simonyan, A. Zisserman. Very Deep Convolutional Networks for Large-Scale Image Recognition. ICLR, 2015.
- A. G. Howard và cộng sự. MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications. arXiv:1704.04861, 2017.
- W. Luo, Y. Li, R. Urtasun, R. Zemel. Understanding the Effective Receptive Field in Deep Convolutional Neural Networks. NeurIPS, 2016.
- A. Azulay, Y. Weiss. Why Do Deep Convolutional Networks Generalize So Poorly to Small Image Transformations? JMLR, 2019.
- A. Dosovitskiy và cộng sự. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR, 2021.
- Z. Liu và cộng sự. A ConvNet for the 2020s. CVPR, 2022.
- S. Hochreiter, J. Schmidhuber. Long Short-Term Memory. Neural Computation, 1997.
- F. A. Gers, J. Schmidhuber, F. Cummins. Learning to Forget: Continual Prediction with LSTM. Neural Computation, 2000.
- R. Pascanu, T. Mikolov, Y. Bengio. On the Difficulty of Training Recurrent Neural Networks. ICML, 2013. Điều kiện về giá trị suy biến và cắt ngưỡng gradient.
- R. Jozefowicz, W. Zaremba, I. Sutskever. An Empirical Exploration of Recurrent Network Architectures. ICML, 2015.
- C. Tallec, Y. Ollivier. Can Recurrent Neural Networks Warp Time? ICLR, 2018.
- K. Cho và cộng sự. Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation. EMNLP, 2014. Mạng GRU.
- J. Chung, C. Gulcehre, K. Cho, Y. Bengio. Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling. arXiv:1412.3555, 2014.
- A. Gu, T. Dao. Mamba: Linear-Time Sequence Modeling with Selective State Spaces. arXiv:2312.00752, 2023.
Thị giác máy tính: phát hiện đối tượng và phân đoạn
- R. Girshick, J. Donahue, T. Darrell, J. Malik. Rich Feature Hierarchies for Accurate Object Detection and Semantic Segmentation. CVPR, 2014. R-CNN.
- R. Girshick. Fast R-CNN. ICCV, 2015.
- S. Ren, K. He, R. Girshick, J. Sun. Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks. NeurIPS, 2015. Mạng đề xuất vùng và hộp neo.
- J. Redmon, S. Divvala, R. Girshick, A. Farhadi. You Only Look Once: Unified, Real-Time Object Detection. CVPR, 2016.
- W. Liu và cộng sự. SSD: Single Shot MultiBox Detector. ECCV, 2016.
- T.-Y. Lin, P. Goyal, R. Girshick, K. He, P. Dollár. Focal Loss for Dense Object Detection. ICCV, 2017. RetinaNet.
- Z. Tian, C. Shen, H. Chen, T. He. FCOS: Fully Convolutional One-Stage Object Detection. ICCV, 2019.
- X. Zhou, D. Wang, P. Krähenbühl. Objects as Points. arXiv:1904.07850, 2019. CenterNet.
- N. Carion và cộng sự. End-to-End Object Detection with Transformers. ECCV, 2020. DETR.
- M. Everingham, L. Van Gool, C. K. I. Williams, J. Winn, A. Zisserman. The PASCAL Visual Object Classes (VOC) Challenge. IJCV, 2010. Cách tính AP 11 điểm và mọi điểm.
- T.-Y. Lin và cộng sự. Microsoft COCO: Common Objects in Context. ECCV, 2014. AP@[0,5:0,95].
- J. Long, E. Shelhamer, T. Darrell. Fully Convolutional Networks for Semantic Segmentation. CVPR, 2015.
- O. Ronneberger, P. Fischer, T. Brox. U-Net: Convolutional Networks for Biomedical Image Segmentation. MICCAI, 2015.
- V. Dumoulin, F. Visin. A Guide to Convolution Arithmetic for Deep Learning. arXiv:1603.07285, 2016. Kích thước đầu ra của tích chập chuyển vị.
- A. Odena, V. Dumoulin, C. Olah. Deconvolution and Checkerboard Artifacts. Distill, 2016.
- L.-C. Chen, G. Papandreou, I. Kokkinos, K. Murphy, A. L. Yuille. DeepLab: Semantic Image Segmentation with Deep Convolutional Nets, Atrous Convolution, and Fully Connected CRFs. TPAMI, 2018.
- K. He, G. Gkioxari, P. Dollár, R. Girshick. Mask R-CNN. ICCV, 2017. RoIAlign.
- A. Kirillov, K. He, R. Girshick, C. Rother, P. Dollár. Panoptic Segmentation. CVPR, 2019.
- F. Milletari, N. Navab, S.-A. Ahmadi. V-Net: Fully Convolutional Neural Networks for Volumetric Medical Image Segmentation. 3DV, 2016. Dice loss.
- A. Kirillov và cộng sự. Segment Anything. ICCV, 2023. SAM và bộ dữ liệu SA-1B.
- J. Ho, A. Jain, P. Abbeel. Denoising Diffusion Probabilistic Models. NeurIPS, 2020. U-Net làm mạng khử nhiễu.
Transformer
- A. Vaswani và cộng sự. Attention Is All You Need. NeurIPS, 2017. Scaled dot-product attention, lập luận ở chú thích 4, attention nhiều đầu và bảng so sánh với RNN.
- D. Bahdanau, K. Cho, Y. Bengio. Neural Machine Translation by Jointly Learning to Align and Translate. ICLR, 2015.
- P. Michel, O. Levy, G. Neubig. Are Sixteen Heads Really Better than One? NeurIPS, 2019.
- O. Press, N. A. Smith, M. Lewis. Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation. ICLR, 2022. ALiBi.
- J. Devlin, M.-W. Chang, K. Lee, K. Toutanova. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL, 2019.
- A. Radford và cộng sự. Language Models are Unsupervised Multitask Learners. OpenAI, 2019. GPT-2.
- C. Raffel và cộng sự. Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. JMLR, 2020. T5.
- R. Xiong và cộng sự. On Layer Normalization in the Transformer Architecture. ICML, 2020. Pre-LN và post-LN.
- J. Su và cộng sự. RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing, 2024. RoPE.
- S. Chen, S. Wong, L. Chen, Y. Tian. Extending Context Window of Large Language Models via Positional Interpolation. arXiv:2306.15595, 2023.
- B. Peng, J. Quesnelle, H. Fan, E. Shippole. YaRN: Efficient Context Window Extension of Large Language Models. ICLR, 2024.
- N. Shazeer. Fast Transformer Decoding: One Write-Head is All You Need. arXiv:1911.02150, 2019. MQA.
- J. Ainslie và cộng sự. GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints. EMNLP, 2023.
- N. Shazeer. GLU Variants Improve Transformer. arXiv:2002.05202, 2020. SwiGLU và việc giảm còn hai phần ba.
- N. Shazeer và cộng sự. Outrageously Large Neural Networks: The Sparsely-Gated Mixture-of-Experts Layer. ICLR, 2017.
- W. Fedus, B. Zoph, N. Shazeer. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity. JMLR, 2022.
- A. Q. Jiang và cộng sự. Mixtral of Experts. arXiv:2401.04088, 2024.
- H. Touvron và cộng sự. Llama 2: Open Foundation and Fine-Tuned Chat Models. arXiv:2307.09288, 2023. Cấu hình mô hình và con số 184 320 giờ-GPU.
- T. Dao, D. Y. Fu, S. Ermon, A. Rudra, C. Ré. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness. NeurIPS, 2022.
- T. Dao. FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning. ICLR, 2024.
- M. Milakov, N. Gimelshein. Online Normalizer Calculation for Softmax. arXiv:1805.02867, 2018.
Giải mã
- A. Fan, M. Lewis, Y. Dauphin. Hierarchical Neural Story Generation. ACL, 2018. Lấy mẫu top-.
- A. Holtzman, J. Buys, L. Du, M. Forbes, Y. Choi. The Curious Case of Neural Text Degeneration. ICLR, 2020. Top- và nhận xét về beam search.
- M. Nguyen và cộng sự. Turning Up the Heat: Min-p Sampling for Creative and Coherent LLM Outputs. ICLR, 2025.
- N. S. Keskar và cộng sự. CTRL: A Conditional Transformer Language Model for Controllable Generation. arXiv:1909.05858, 2019. Phạt lặp.
- Y. Leviathan, M. Kalman, Y. Matias. Fast Inference from Transformers via Speculative Decoding. ICML, 2023.
- C. Chen và cộng sự. Accelerating Large Language Model Decoding with Speculative Sampling. arXiv:2302.01318, 2023.
- H. He. Defeating Nondeterminism in LLM Inference. Thinking Machines Lab, 2025.
Tài nguyên tính toán
- J. Kaplan và cộng sự. Scaling Laws for Neural Language Models. arXiv:2001.08361, 2020. Công thức , và .
- J. Hoffmann và cộng sự. Training Compute-Optimal Large Language Models. NeurIPS, 2022. Chinchilla.
- S. Rajbhandari, J. Rasley, O. Ruwase, Y. He. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. SC, 2020. Con số 16 byte mỗi tham số.
- V. Korthikanti và cộng sự. Reducing Activation Recomputation in Large Transformer Models. arXiv:2205.05198, 2022. Công thức bộ nhớ kích hoạt ở Mục 12.5.
Bài giảng và tài liệu bổ sung
- P. Domingos. A Few Useful Things to Know About Machine Learning. Communications of the ACM, 2012. Công thức học = biểu diễn + đánh giá + tối ưu ở Mục 1.1, và thí nghiệm giả định mạnh mà sai ở Mục 1.4.
- D. McElfresh và cộng sự. When Do Neural Nets Outperform Boosted Trees on Tabular Data? NeurIPS Datasets and Benchmarks, 2023.
- A. Ng, T. Ma. CS229: Machine Learning, Lecture Notes. Stanford University. Cách trình bày độ chệch – phương sai, cây quyết định và phương pháp tập hợp; phần hướng dẫn áp dụng học máy đi kèm là nguồn của phân tích lỗi và phân tích loại bỏ ở Mục 1.3.
- A. Ng. Deep Learning Specialization. DeepLearning.AI và Coursera, 2017. Đồ thị hiệu năng theo lượng dữ liệu ở Mục 1.4; chẩn đoán bằng sai số huấn luyện và xác thực, độ chệch tránh được và tập huấn luyện–xác thực ở Mục 2.4; beam search, chuẩn hoá theo độ dài và phân tích lỗi của beam search ở Mục 11.4.
- G. James, D. Witten, T. Hastie, R. Tibshirani. An Introduction to Statistical Learning, 2nd ed. Springer, 2021. Nhận xét rằng double descent không mâu thuẫn với đánh đổi độ chệch – phương sai, và cách cắt tỉa cây ở Mục 3.2.
- P. Nakkiran, P. Venkat, S. Kakade, T. Ma. Optimal Regularization Can Mitigate Double Descent. ICLR, 2021.
- F.-F. Li, J. Johnson, A. Karpathy và cộng sự. CS231n: Deep Learning for Computer Vision, Course Notes. Stanford University. Cách nhìn lan truyền ngược qua các cổng, kiểm tra gradient, các kiểm tra trước khi huấn luyện, khởi tạo và BatchNorm.
- A. Zhang, Z. C. Lipton, M. Li, A. J. Smola. Dive into Deep Learning. Cambridge University Press, 2023. Cách mở đầu chương mạng nhiều lớp ở Mục 4.1 và nhiều ví dụ tính tay.
- M. Nielsen. Neural Networks and Deep Learning. Determination Press, 2015. Chứng minh bằng hình của định lý xấp xỉ phổ quát và phân tích gradient tiêu biến.
- A. Karpathy. A Recipe for Training Neural Networks. 2019. Các kiểm tra lúc khởi tạo ở Mục 4.5.
- A. Karpathy. The Spelled-Out Intro to Neural Networks and Backpropagation: Building Micrograd. Bài giảng video, 2022. Ví dụ cộng dồn gradient ở Mục 5.1.
- A. Karpathy. Let's Reproduce GPT-2 (124M). Bài giảng video và mã nguồn build-nanogpt, 2024. Lịch tốc độ học ở Mục 5.5 và cách chia mất mát khi tích luỹ gradient ở Mục 5.3.
- A. Karpathy. Building makemore Part 3: Activations & Gradients, BatchNorm. Bài giảng video, 2022. Các đồ thị theo dõi tỉ lệ bão hoà và tỉ số cập nhật ở Mục 6.3.
- J. Redmon, A. Farhadi. YOLO9000: Better, Faster, Stronger. CVPR, 2017. Chọn kích thước hộp neo bằng K-means.
- A. Karpathy. The Unreasonable Effectiveness of Recurrent Neural Networks. 2015. Ví dụ mô hình ký tự ở Mục 8.1.
- C. Olah. Understanding LSTM Networks. 2015. Hình ảnh băng chuyền của ô nhớ ở Mục 8.3.
- C. D. Manning và cộng sự. CS224n: Natural Language Processing with Deep Learning, Lecture Notes and Slides. Stanford University. Gradient tiêu biến trong RNN, attention, Transformer và các chiến lược giải mã.
- J. Alammar. The Illustrated Transformer và The Illustrated GPT-2. 2018–2019. Hình ảnh tủ hồ sơ cho truy vấn, khoá và giá trị.
- A. Karpathy. Let's Build GPT: from Scratch, in Code, Spelled Out. Bài giảng video, 2023. Mẹo ma trận tam giác dưới ở Mục 9.4 và phép thử độ bão hoà của softmax ở Mục 9.2.
- P. Liang, T. Hashimoto. CS336: Language Modeling from Scratch. Stanford University, 2025. Các bài giảng về kiến trúc, mixture of experts và tính toán tài nguyên.
- S. Raschka. The Big LLM Architecture Comparison. 2025. Tổng hợp các thay đổi kiến trúc ở Mục 10.1.
- S. Biderman và cộng sự. Rotary Embeddings: A Relative Revolution. EleutherAI, 2021. So sánh RoPE với các cách mã hoá vị trí khác.
- Gemma Team. Gemma 3 Technical Report. arXiv:2503.19786, 2025.
- Team OLMo. 2 OLMo 2 Furious. arXiv:2501.00656, 2024. Báo cáo kỹ thuật của OLMo 2.
- DeepSeek-AI. DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model. arXiv:2405.04434, 2024. Multi-head latent attention.
- DeepSeek-AI. DeepSeek-V3 Technical Report. arXiv:2412.19437, 2024.
- K. Park, J. Wang, T. Berg-Kirkpatrick, N. Polikarpova, L. D'Antoni. Grammar-Aligned Decoding. NeurIPS, 2024. Sai lệch phân phối của giải mã có ràng buộc.
- Llama Team, AI @ Meta. The Llama 3 Herd of Models. arXiv:2407.21783, 2024.
- T. Pearce, J. Song. Reconciling Kaplan and Chinchilla Scaling Laws. arXiv:2406.12907, 2024.
- A. Karpathy. nanoGPT. GitHub, 2023. Sổ tay transformer_sizing.ipynb ước lượng thời gian huấn luyện GPT-2 small bằng .
- OpenAI. gpt-2, kho mã và ghi chú phát hành. GitHub, 2019. Ghi chú rằng số tham số trong bài báo GPT-2 bị tính sai.
Phụ lục: chạy lại thí nghiệm#
code/models/
├── experiments.py            # Hình 2, 4, 5, 7, 10, 11, 14, 15 và mọi số liệu đo được
├── experiments_output.txt    # kết quả in ra của script trên
├── thi_giac.py               # Hình 9 và số liệu về IoU, NMS, AP ở Mục 7.5–7.6
├── thi_giac_output.txt       # kết quả in ra của thi_giac.py
└── fig_diagrams.py           # Hình 1, 3, 6, 8, 12, 13 (sơ đồ khái niệm)
pip install numpy scipy matplotlib scikit-learn
python code/models/experiments.py     # khoảng một tới vài phút trên CPU
python code/models/thi_giac.py        # vài giây
python code/models/fig_diagrams.py
Các script đặt hạt giống cố định nên mọi con số trong giáo trình lặp lại được trên cùng phiên bản thư viện. Môi trường đã dùng: Python 3.13, NumPy 2.3, SciPy 1.16, scikit-learn 1.7, matplotlib 3.10. Trên Windows, đặt PYTHONIOENCODING=utf-8 khi ghi kết quả ra tệp.
Một số kết quả là phép đối chiếu với con số đã công bố, không phải mô phỏng: số tham số của GPT-2 small, medium, large và của Llama 2 7B, 13B; ngân sách giờ-GPU của Llama 2 7B; và phương sai của tích vô hướng trong chú thích 4 của bài báo Transformer. Các phép đối chiếu này kiểm tra rằng công thức ở Chương 12 đúng, không chỉ hợp lý.
Các thí nghiệm dùng dữ liệu mô phỏng nhỏ để quan sát cơ chế một cách rõ ràng. Hai điểm cần nhớ khi đọc kết quả: thí nghiệm ở Mục 4.4 so sánh khả năng biểu diễn chứ không phải khả năng học bằng gradient descent; và thí nghiệm về LSTM ở Mục 8.2 chỉ mô phỏng đường đi qua ô nhớ, không phải một mạng LSTM đầy đủ.