10Các cải tiến của Transformer#
Nếu đặt sơ đồ một khối của Llama 2 cạnh sơ đồ trong bài báo Transformer năm 2017, ta thấy cùng một khung: attention, FFN, kết nối tắt và chuẩn hoá. Nhìn kỹ từng thành phần thì gần như thành phần nào cũng đã đổi. Mỗi thay đổi ra đời để giải quyết một vấn đề cụ thể, có khi về độ ổn định khi huấn luyện, có khi về bộ nhớ khi suy luận, có khi về tốc độ trên phần cứng, và mỗi thay đổi cũng có điểm yếu riêng. Ta xét chúng theo thứ tự trong bảng tổng quan ở Mục 10.1.
10.1Những thay đổi so với Transformer gốc#
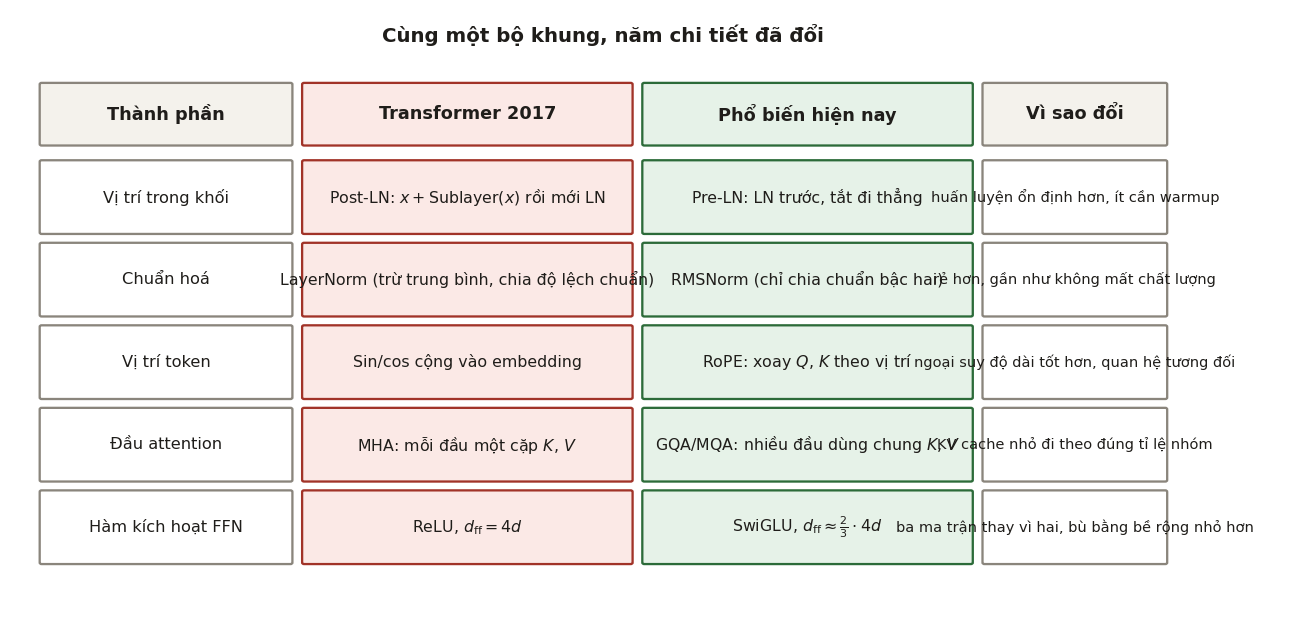
| Thành phần | Transformer 2017 | Phổ biến hiện nay | Lý do thay đổi | Mục |
|---|---|---|---|---|
| Vị trí lớp chuẩn hoá | sau khối con (post-LN) | trước khối con (pre-LN) | huấn luyện ổn định hơn | 10.2 |
| Loại chuẩn hoá | LayerNorm | RMSNorm | rẻ hơn, chất lượng tương đương | 6.4 |
| Thông tin vị trí | sin–cos cộng vào embedding | RoPE | quan hệ tương đối, mở rộng ngữ cảnh tốt hơn | 10.3 |
| Khoá và giá trị | mỗi đầu một cặp (MHA) | nhiều đầu chung một cặp (GQA) | KV cache nhỏ hơn khi suy luận | 10.4 |
| Khối FFN | ReLU, | SwiGLU, | chất lượng tốt hơn ở cùng số tham số | 10.5 |
Llama 2 (Touvron và cộng sự, 2023) là một ví dụ dùng cả năm lựa chọn ở cột thứ ba, với một ngoại lệ: bản 7B và 13B dùng MHA, chỉ bản 70B dùng GQA. Hai thay đổi còn lại của chương, mixture of experts và FlashAttention, không nằm trong bảng vì chúng không thay một thành phần mà thay cách tổ chức hoặc cách tính.
Bảng cũng chưa liệt kê những thay đổi nhỏ hơn mà các mô hình 2024–2025 dùng rộng rãi, theo tổng hợp của Raschka (2025) và bài giảng CS336. Phần lớn mô hình bỏ hệ số chặn trong các lớp tuyến tính và không dùng dropout khi tiền huấn luyện. Nhiều mô hình chuẩn hoá truy vấn và khoá trước khi tính điểm số, gọi là QK-norm, để điểm số attention không phình ra trong khi huấn luyện. Một số mô hình xen các lớp attention cục bộ, chỉ nhìn một cửa sổ trượt, với các lớp attention toàn cục để giảm KV cache: Gemma 3 dùng năm lớp cục bộ với cửa sổ 1 024 token cho mỗi lớp toàn cục (Gemma Team, 2025).
10.2Pre-LN và post-LN#
Bài báo gốc đặt chuẩn hoá sau phép cộng của kết nối tắt, , cách làm gọi là post-LN. Phần lớn mô hình hiện nay đặt chuẩn hoá trước khối con, , gọi là pre-LN, và thêm một lớp chuẩn hoá sau khối cuối cùng.
Khác biệt nằm ở đường tắt. Với post-LN, tín hiệu đi từ đầu vào tới đầu ra phải qua một lớp chuẩn hoá ở mỗi khối. Với pre-LN, đường tắt đi thẳng qua mọi khối mà không qua phép biến đổi nào, đúng cấu hình "chuẩn hoá trong nhánh, đường tắt đi thẳng" mà Mục 6.3 đo được là ổn định. Xiong và cộng sự (2020) phân tích gradient lúc khởi tạo và chỉ ra rằng với post-LN, gradient của các tham số gần đầu ra rất lớn, nên cần warmup để tránh các bước cập nhật quá lớn ở đầu quá trình huấn luyện; với pre-LN, gradient có độ lớn hợp lý ở mọi lớp, và mô hình huấn luyện được với ít hoặc không cần warmup.
Pre-LN cũng có nhược điểm: độ lớn của tín hiệu trên đường tắt tăng dần theo độ sâu, nên các khối ở sâu đóng góp tương đối ít hơn. Một số nghiên cứu cho thấy post-LN, khi huấn luyện được ổn định, có thể cho chất lượng cuối cao hơn một chút, và đã có các biến thể kết hợp ưu điểm của cả hai. Trong thực hành, pre-LN vẫn là lựa chọn mặc định, vì khi huấn luyện một mô hình lớn tốn kém, độ ổn định quan trọng hơn một chút chất lượng. Một số mô hình mới thử vị trí khác mà vẫn giữ đường tắt đi thẳng: OLMo 2 (Team OLMo, 2024) đặt chuẩn hoá ở cuối nhánh dư, sau khối con, còn Gemma 3 chuẩn hoá cả trước lẫn sau khối con. Bài giảng CS336 lưu ý rằng cả hai đều không phải post-LN kiểu 2017, vì phép cộng của đường tắt không đi qua lớp chuẩn hoá nào.
10.3RoPE#
RoPE (rotary position embedding; Su và cộng sự, 2024) đưa thông tin vị trí vào attention bằng cách quay vector truy vấn và khoá một góc tỉ lệ với vị trí, thay vì cộng một vector vị trí vào embedding.
Định nghĩa 10.1 (RoPE)
Chia chiều của một vector thành cặp. Với vị trí , phép biến đổi quay cặp thứ một góc trong mặt phẳng của cặp đó, với , . Truy vấn tại vị trí và khoá tại vị trí được thay bằng và trước khi tính điểm số attention.
Mệnh đề 10.1
Với mọi , và mọi vị trí , : . Như vậy điểm số attention chỉ phụ thuộc vào khoảng cách tương đối .
Chứng minh
là ma trận khối đường chéo gồm các ma trận quay , nên nó trực giao: . Hai phép quay cùng mặt phẳng cộng góc, nên . Do đó .
Trường hợp cho thấy cơ chế mà không cần ký hiệu khối: chỉ có một cặp, và là phép quay góc . Lấy và . Tại và , và , nên tích vô hướng là . Dời cả hai sang vị trí 10 và 12 thì góc chênh vẫn là và tích vô hướng vẫn là 0,540. Bài giảng CS336 diễn đạt cùng ý bằng một câu: trong "chúng tôi biết" và "dĩ nhiên chúng tôi biết", hai chữ "tôi" và "biết" đứng ở những vị trí tuyệt đối khác nhau nhưng cách nhau cùng một khoảng, nên với RoPE, điểm số giữa chúng như nhau. Dãy tần số giống dãy tần số của mã hoá sin–cos ở Mục 9.6: cặp đầu quay nhanh, phù hợp để phân biệt khoảng cách gần; cặp cuối quay rất chậm, phân biệt được khoảng cách xa.
Thí nghiệm trong code/models/experiments.py kiểm tra mệnh đề với và hai vector ngẫu nhiên.
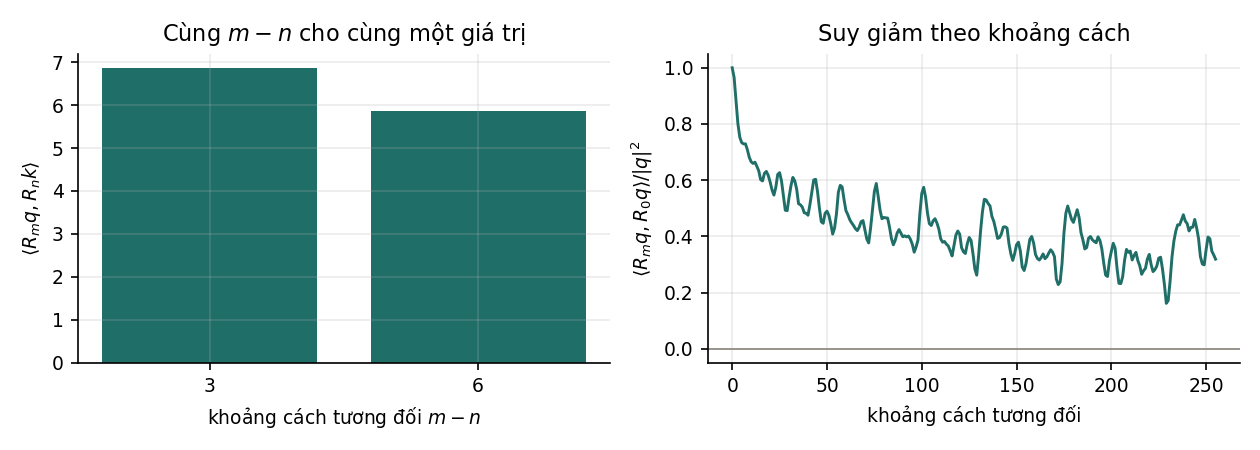
| 5 | 2 | 3 | 6,851342 |
| 105 | 102 | 3 | 6,851342 |
| 500 | 497 | 3 | 6,851342 |
| 9 | 3 | 6 | 5,861634 |
| 109 | 103 | 6 | 5,861634 |
Các cặp có cùng khoảng cách cho cùng giá trị tới chữ số thứ sáu sau dấu phẩy, đúng như mệnh đề. Thí nghiệm còn đo độ tương đồng của một vector với chính nó ở hai vị trí cách nhau , trung bình trên 300 vector ngẫu nhiên.
| 0 | 8 | 64 | 255 | |
|---|---|---|---|---|
| 1,000 | 0,708 | 0,439 | 0,319 |
Kết quả này có công thức rõ ràng: , tức một trung bình có trọng số của . Khi tăng, các cặp có tần số khác nhau lệch pha nhau và trung bình giảm dần. Đây là tính chất suy giảm theo khoảng cách mà bài báo RoPE nêu: cùng một nội dung, ở xa thì có xu hướng nhận điểm attention thấp hơn. Bài báo chỉ chứng minh tính chất này cho một chặn trên của điểm số chứ không cho chính điểm số, vì vậy nó chỉ nên được hiểu như một xu hướng. Về thực nghiệm, nhóm EleutherAI đo trên mô hình 125 triệu tham số được mất mát xác thực 2,809 với embedding vị trí học được, 2,801 với cách mã hoá tương đối của T5 và 2,759 với RoPE (Biderman và cộng sự, 2021).
RoPE có ba ưu điểm. Nó mã hoá vị trí tương đối mà không cần bảng tham số riêng. Nó chỉ tác động lên và , không thay đổi , không thêm tham số và không đổi kích thước tensor. Và nó cho phép mở rộng ngữ cảnh sau khi huấn luyện: vì không có bảng vị trí với giới hạn cứng, có thể co giãn các góc quay để mô hình huấn luyện với ngữ cảnh 4 096 token dùng được cho ngữ cảnh dài hơn, kèm một bước tinh chỉnh ngắn. Hai phương pháp phổ biến là nội suy vị trí (position interpolation; Chen và cộng sự, 2023), chia chỉ số vị trí cho hệ số mở rộng, và YaRN (Peng và cộng sự, 2024), co giãn khác nhau cho các dải tần số. Với nội suy vị trí, Chen và cộng sự mở rộng ngữ cảnh của LLaMA lên 32 768 token chỉ với khoảng 1 000 bước tinh chỉnh.
10.4MQA và GQA#
Khi sinh văn bản, mỗi token mới cần khoá và giá trị của mọi token trước đó ở mọi lớp. Để không phải tính lại, chúng được lưu trong KV cache. Với attention nhiều đầu thông thường (multi-head attention, MHA), mỗi đầu có khoá và giá trị riêng, nên dung lượng KV cache tỉ lệ với số đầu:
trong đó hệ số 2 cho khoá và giá trị, là số đầu có khoá và giá trị riêng, là số chuỗi xử lý cùng lúc.
Ý tưởng giảm KV cache là cho nhiều đầu truy vấn dùng chung khoá và giá trị. Ở mức cực đoan, MQA (multi-query attention; Shazeer, 2019) cho mọi đầu truy vấn dùng chung một cặp khoá và giá trị, tức . GQA (grouped-query attention; Ainslie và cộng sự, 2023) đi giữa hai thái cực: chia đầu truy vấn thành nhóm, mỗi nhóm dùng chung một cặp khoá và giá trị, nên . MQA là trường hợp , còn MHA là trường hợp .
KV cache giảm đúng lần. Với một mô hình cỡ Llama 2 70B (80 lớp, , 64 đầu truy vấn), ngữ cảnh 4 096 token, 8 chuỗi cùng lúc, lưu ở FP16, MHA với 64 đầu khoá–giá trị cần 80 GiB, còn GQA với 8 đầu cần 10 GiB. Mỗi token của mỗi chuỗi tốn 2,5 MiB với MHA và 0,3125 MiB với GQA.
MQA giảm KV cache nhiều nhất nhưng có thể làm giảm chất lượng và làm huấn luyện kém ổn định. Ainslie và cộng sự (2023) cho thấy GQA cho chất lượng gần MHA với tốc độ suy luận gần MQA, và một mô hình MHA đã huấn luyện có thể chuyển sang GQA bằng cách huấn luyện thêm với khoảng 5% lượng tính toán ban đầu. GQA vì vậy là một quyết định thiết kế vì bộ nhớ lúc suy luận, không phải vì chất lượng. DeepSeek-V2 (DeepSeek-AI, 2024) đi xa hơn với multi-head latent attention (MLA): khoá và giá trị được nén vào một vector ẩn nhỏ, và KV cache chỉ lưu vector đó; báo cáo của mô hình cho biết KV cache của MLA tương đương GQA với khoảng 2,25 nhóm, trong khi chất lượng tốt hơn MHA. Mục 2.2 của Ứng dụng LLM tính KV cache của Llama 3 8B, một mô hình dùng GQA, và hệ quả của nó lên chi phí phục vụ.
10.5SwiGLU#
Khối FFN gốc là với , gồm hai ma trận. Shazeer (2020) thử các biến thể có cổng, trong đó đầu ra của một nhánh tuyến tính được nhân từng phần tử với đầu ra của một nhánh khác:
Biến thể dùng SiLU (Swish), gọi là SwiGLU, cho chất lượng tốt nhất trong các thí nghiệm của bài báo và được nhiều mô hình ngôn ngữ dùng.
SwiGLU có ba ma trận , , thay vì hai. Để số tham số và số phép tính bằng khối FFN gốc, số chiều ẩn phải giảm: cho
Bài báo làm đúng như vậy: mô hình gốc có , các biến thể có cổng dùng . Trong thực tế, được làm tròn lên bội của một số như 128 hoặc 256 cho hiệu quả phần cứng. Với Llama 2 7B, nên , và giá trị thật chính là số đó làm tròn lên bội của 256. Tỉ lệ chỉ là điểm xuất phát: Llama 2 70B dùng .
10.6Mixture of experts#
Các thay đổi trên giữ nguyên số phép tính cho mỗi token. Mixture of experts đi theo hướng khác: tăng số tham số mà không tăng số phép tính. Trong một lớp mixture of experts (MoE; Shazeer và cộng sự, 2017), khối FFN được thay bằng khối FFN song song gọi là chuyên gia (expert), cùng một bộ định tuyến (router) chọn chuyên gia cho mỗi token, thường hoặc 2. Đầu ra là tổng có trọng số của các chuyên gia được chọn, với trọng số do bộ định tuyến tính.
Như vậy MoE tách số tham số khỏi số phép tính: tổng số tham số tăng theo , nhưng mỗi token chỉ đi qua chuyên gia. Chẳng hạn, Mixtral 8x7B (Jiang và cộng sự, 2024) có 8 chuyên gia mỗi lớp, mỗi token dùng 2, tổng khoảng 47 tỉ tham số nhưng mỗi token chỉ dùng khoảng 13 tỉ. Tổng không phải tỉ, vì chỉ các khối FFN được nhân bản, còn attention và embedding dùng chung. Các mô hình về sau chia nhỏ chuyên gia hơn nhiều: DeepSeek-V3 (DeepSeek-AI, 2024) có 256 chuyên gia trong mỗi lớp MoE cộng một chuyên gia dùng chung mà mọi token đều đi qua, mỗi token chọn 8 chuyên gia, nên trong 671 tỉ tham số chỉ khoảng 37 tỉ được dùng cho mỗi token.
Đổi lại, MoE kéo theo ba vấn đề kỹ thuật. Vấn đề đầu tiên là cân bằng tải: bộ định tuyến có xu hướng dồn phần lớn token vào vài chuyên gia, làm các chuyên gia khác không được huấn luyện, và cách xử lý thông dụng là thêm một hàm mất mát phụ phạt sự mất cân bằng (Fedus, Zoph và Shazeer, 2022). Vấn đề thứ hai là bộ nhớ: dù mỗi token chỉ dùng một phần, mọi chuyên gia đều phải nằm sẵn trong bộ nhớ, vì token tiếp theo có thể cần bất kỳ chuyên gia nào. Vấn đề thứ ba là truyền dữ liệu: khi các chuyên gia nằm trên nhiều GPU khác nhau, mỗi lớp MoE phải gửi token tới GPU chứa chuyên gia được chọn rồi nhận kết quả về. Vì vậy MoE có lợi khi giới hạn là số phép tính; nếu giới hạn là bộ nhớ, MoE không giúp được.
10.7FlashAttention#
Thay đổi cuối cùng không động tới mô hình mà tới cách tính. Tính attention trực tiếp theo Định nghĩa 9.1 tạo ra ma trận điểm số cho mỗi đầu và lưu nó trong bộ nhớ chính của GPU (HBM). Với , 32 đầu và số 16 bit, riêng các ma trận này đã chiếm 1 GiB cho một chuỗi ở một lớp. Ngoài dung lượng, việc ghi và đọc lại ma trận lớn này từ HBM còn tốn thời gian hơn chính các phép tính, vì trên GPU hiện đại tốc độ tính toán vượt xa tốc độ truy cập bộ nhớ.
FlashAttention (Dao và cộng sự, 2022) tính chính xác cùng kết quả mà không bao giờ tạo ra toàn bộ ma trận . Thuật toán chia , , thành các khối đủ nhỏ để nằm trong bộ nhớ nhanh trên chip (SRAM), và tính softmax theo từng khối bằng kỹ thuật softmax trực tuyến (Milakov và Gimelshein, 2018). Với mỗi hàng, thuật toán giữ giá trị lớn nhất và tổng của các điểm số đã xử lý; khi gặp khối mới có giá trị lớn nhất , nó nhân tổng cũ và kết quả tích luỹ cũ với rồi cộng phần của khối mới. Chẳng hạn một hàng có bốn điểm số chia thành hai khối và . Sau khối đầu, và . Khối thứ hai có giá trị lớn nhất 3, nên tổng cũ được nhân với rồi cộng thêm : , đúng bằng tổng tính trực tiếp trên cả bốn điểm số. Ở lượt ngược, các giá trị cần thiết được tính lại từ các khối thay vì đọc từ bộ nhớ.
Nhờ vậy bộ nhớ cho attention tăng tuyến tính theo thay vì theo , và thời gian chạy giảm đáng kể vì ít truy cập HBM hơn, dù số phép tính tăng nhẹ do phải tính lại ở lượt ngược. FlashAttention không thay đổi bậc của số phép tính; nó thay đổi cách thực hiện chúng trên phần cứng. Bài báo đo cụ thể trên GPT-2 medium với chuỗi 1 024 token trên GPU A100, tính cả lượt xuôi và lượt ngược: FlashAttention làm nhiều phép tính hơn, 75,2 so với 66,6 GFLOP, nhưng đọc ghi bộ nhớ chính ít hơn khoảng chín lần, 4,4 so với 40,3 GB, và chạy nhanh hơn khoảng 5,7 lần, 7,3 so với 41,7 ms. Số phép tính không quyết định thời gian chạy khi giới hạn nằm ở bộ nhớ. Các thư viện huấn luyện và phục vụ mô hình ngôn ngữ hiện nay đều dùng FlashAttention hoặc các cài đặt cùng ý tưởng (Dao, 2024).
10.8Tóm tắt#
Khung của Transformer giữ nguyên từ năm 2017, nhưng các thành phần đã thay đổi vì những lý do cụ thể. Pre-LN cho đường tắt đi thẳng nên huấn luyện ổn định hơn post-LN. RoPE quay truy vấn và khoá theo vị trí, nên điểm số attention chỉ phụ thuộc khoảng cách tương đối, và thí nghiệm xác nhận điều này tới chữ số thứ sáu. GQA cho nhiều đầu truy vấn dùng chung khoá và giá trị, giảm KV cache của một mô hình cỡ Llama 2 70B từ 80 GiB xuống 10 GiB trong ví dụ đã tính. SwiGLU thêm cổng vào FFN và giảm xuống để giữ số tham số. MoE tăng số tham số mà không tăng số phép tính cho mỗi token, đổi lại phải cân bằng tải và giữ mọi chuyên gia trong bộ nhớ. FlashAttention tính đúng attention mà không tạo ma trận , nên bộ nhớ tăng tuyến tính theo độ dài chuỗi.
Đến đây ta có đủ các thành phần của một mô hình ngôn ngữ hiện đại. Sau mỗi lượt xuôi, mô hình đó chỉ cho ra một phân phối xác suất trên từ vựng; muốn có văn bản, còn phải quyết định chọn token nào từ phân phối ấy. Chương 11 bàn về quyết định này.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Tính chất quan trọng nhất của RoPE là gì?
Vì sao: Ở Mục 10.3, các cặp vị trí , và cho cùng giá trị 6,851342. Không thêm tham số là một ưu điểm đi kèm.2GQA được dùng vì lý do gì?
Vì sao: Với mô hình cỡ 70B, ngữ cảnh 4 096 token, 8 chuỗi, FP16: MHA cần 80 GiB KV cache, GQA với 8 nhóm cần 10 GiB. Chất lượng của GQA gần MHA nhưng không cao hơn (Mục 10.4).3Vì sao của Llama 2 7B là 11 008 chứ không phải ?
Vì sao: là bội của 256 nhỏ nhất không nhỏ hơn 10 923 (Mục 10.5).4Mixture of experts tách hai đại lượng nào khỏi nhau?
Vì sao: Mỗi token chỉ đi qua vài chuyên gia, nên mô hình có nhiều tham số nhưng mỗi token chỉ dùng một phần. Mọi chuyên gia vẫn phải nằm trong bộ nhớ (Mục 10.6).5FlashAttention thay đổi điều gì so với cách tính attention trực tiếp?
Vì sao: FlashAttention tính chính xác cùng kết quả, theo từng khối trong bộ nhớ trên chip, dùng softmax trực tuyến. Số phép tính vẫn là (Mục 10.7).
Đã trả lời 0/5