5Gradient descent#
Chương 4 tìm đường thẳng tốt nhất cho bốn căn hộ bằng một công thức. Phần lớn bài toán học máy không có công thức như vậy: chỉ cần đổi hàm mất mát sang cross-entropy của hồi quy logistic là phương trình "gradient bằng 0" đã không giải tường minh được nữa. Khi đó ta tìm nghiệm bằng cách đi từng bước nhỏ xuống dốc của hàm mất mát. Để thấy cách làm này vận hành ra sao, ta giải lại bài toán căn hộ như thể không biết công thức, rồi dùng chính ví dụ đó để trả lời hai câu hỏi thực tế: cần bao nhiêu bước, và làm sao biết mình đã tính gradient đúng.
5.1Lý do dùng phương pháp lặp#
Có ba lý do khiến ta dùng phương pháp lặp thay cho nghiệm dạng đóng. Lý do đầu tiên là nhiều bài toán không có nghiệm dạng đóng: cho gradient của hàm mất mát logistic bằng 0 dẫn tới một hệ phương trình phi tuyến không giải được bằng biểu thức tường minh, và mọi mạng nơ-ron cũng thuộc loại này. Lý do thứ hai là nghiệm dạng đóng có thể quá đắt. Lập và giải tốn khoảng phép tính; với đặc trưng, riêng đã vượt khả năng tính toán thông thường, trong khi một bước gradient chỉ tốn . Lý do thứ ba là dữ liệu có thể không vừa bộ nhớ, và các biến thể ngẫu nhiên của gradient descent (Mục 5.6) chỉ cần một phần nhỏ dữ liệu ở mỗi bước.
5.2Thuật toán gradient descent#
Gradient của hàm tại một điểm chỉ hướng mà tăng nhanh nhất. Muốn giảm , ta đi một bước nhỏ theo hướng ngược lại, rồi lặp lại.
Định nghĩa 5.1 (Gradient descent)
Bắt đầu từ , lặp
trong đó là tốc độ học (learning rate). Thuật toán dừng khi gradient đủ nhỏ hoặc khi đạt số vòng lặp tối đa.
Vì sao hướng ngược gradient là hướng giảm nhanh nhất? Với bước dịch chuyển nhỏ , khai triển Taylor bậc nhất cho
Trong mọi có cùng độ dài, số hạng âm nhất khi ngược hướng với , theo bất đẳng thức Cauchy–Schwarz. Lập luận này chỉ đúng cục bộ, vì xấp xỉ bậc nhất chỉ chính xác khi bước đi đủ nhỏ. Nếu quá lớn, bước đi có thể vượt qua cực tiểu và làm tăng lên.
Ta thử thuật toán trên bốn căn hộ của Chương 4. Để các con số gọn, đổi biến diện tích thành , tức độ lệch so với diện tích trung bình, tính bằng chục mét vuông; bốn căn có lần lượt là ; ; ; . Mô hình là , trong đó là phần giá tăng thêm cho mỗi 10 m². Nghiệm của Chương 4 khi đó ứng với , đúng bằng giá trung bình vì đường thẳng tốt nhất đi qua điểm trung bình, và .
Vì các có trung bình bằng 0, hàm mất mát tách được thành
Khi khai triển và lấy trung bình, các số hạng chéo giữa và có tổng bằng 0, còn trung bình của bằng 5; có thể kiểm tra tại điểm , nơi cả hai cách tính đều cho . Dạng này cho thấy ngay hình dạng của bài toán: một cái chén có đáy tại , cong theo hướng gấp 5 lần theo hướng . Gradient là
và tại nó bằng : cả hai thành phần âm, nên bước đầu tiên tăng cả lẫn .
Với , bước đầu tiên đưa từ tới , và mất mát giảm từ 5,355 xuống 3,2445. Hệ số góc đã đúng ngay sau một bước, còn hệ số chặn thì chưa. Lý do nằm ở cách mỗi bước tác động lên từng toạ độ. Thay gradient vào quy tắc cập nhật,
Mỗi bước nhân khoảng cách tới đáy theo hướng với , theo hướng với . Vì vậy tới đích sau một bước, còn đi các giá trị 0,45; 0,81; 1,098; 1,3284 và cần 35 bước mới cách 2,25 dưới 0,001.
Thử tăng tốc độ học lên thì hệ số co theo hướng tốt lên thành , nhưng theo hướng thành : nhảy qua lại giữa 0,48 và 0 mãi mãi, và thuật toán không hội tụ. Ví dụ nhỏ này chứa gần như mọi điều cần biết về tốc độ học. Mỗi hướng có độ cong co sai số theo hệ số mỗi bước, nên hội tụ khi và chỉ khi . Hướng cong nhất đặt giới hạn trên cho , còn hướng phẳng nhất quyết định thuật toán chạy chậm tới đâu. Mục 5.3 và 5.4 tổng quát hoá hai nhận xét này.
5.3Tốc độ hội tụ và số điều kiện#
Ví dụ căn hộ cho thấy khó khăn của hàm nhiều biến: mỗi hướng cần một tốc độ học riêng, mà thuật toán chỉ có một. Tốc độ học tốt nhất cân bằng hai hướng, , cho , và khi đó cả hai hướng cùng co sai số theo hệ số mỗi bước. Để thấy hệ số này phụ thuộc vào điều gì, xét hàm bậc hai hai biến
có cực tiểu tại gốc. Ma trận Hessian là , nên số điều kiện đúng bằng (Định nghĩa 2.4). Các đường mức của là elip, dẹt theo trục khi lớn. Một bước gradient descent cập nhật hai toạ độ độc lập với nhau:
Toạ độ chỉ hội tụ nếu , tức . Nhưng với nhỏ như vậy, toạ độ chỉ co lại theo hệ số mỗi bước, rất chậm. Tốc độ học tối ưu cân bằng hai hệ số co, , cho và hệ số co chung
Sai số sau bước là lần sai số ban đầu. Để giảm sai số đi lần cần bước; với , con số này là .
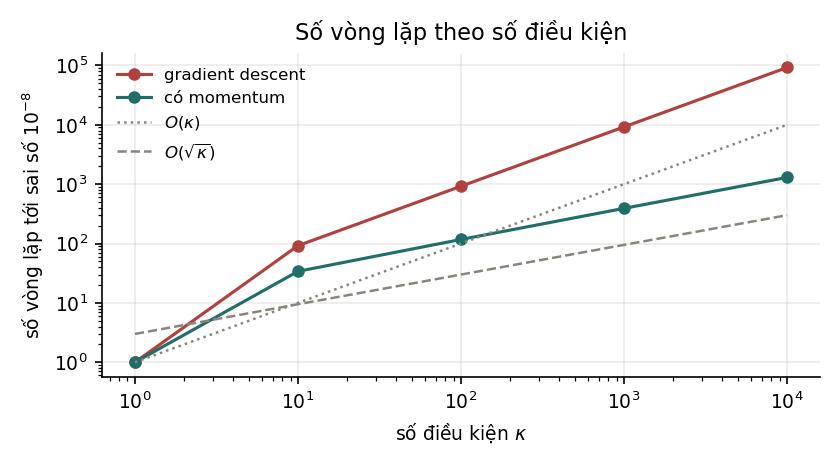
Một cải tiến đơn giản làm giảm đáng kể con số đó là momentum, còn gọi là phương pháp heavy ball của Polyak. Momentum cộng thêm vào bước cập nhật một phần của bước trước, . Với tham số chọn tối ưu cho hàm bậc hai, hệ số co trở thành , nên số vòng lặp chỉ còn tỉ lệ với thay vì .
| Gradient descent | Có momentum | Tỉ số | ||
|---|---|---|---|---|
| 1 | 1 | 1 | 1,00 | 1,00 |
| 10 | 92 | 34 | 2,71 | 3,16 |
| 100 | 922 | 117 | 7,88 | 10,00 |
| 1 000 | 9 211 | 391 | 23,56 | 31,62 |
| 10 000 | 92 104 | 1 297 | 71,01 | 100,00 |
Bảng khớp với phân tích ở trên theo ba cách. Cột gradient descent tăng đúng 10 lần mỗi khi tăng 10 lần, và ở số đo 92 104 gần như trùng với ước lượng 92 103. Cột momentum tăng khoảng 3,3 lần mỗi hàng, xấp xỉ . Còn tỉ số giữa hai cột tăng theo với hệ số khoảng 0,7.
Như vậy tốc độ hội tụ của gradient descent phụ thuộc vào hình dạng của hàm mất mát, đo bằng số điều kiện, chứ không phụ thuộc vào số chiều. Một bài toán một triệu chiều có nhỏ dễ hơn nhiều một bài toán hai chiều có lớn. Với hồi quy tuyến tính, lớn thường do các đặc trưng có thang đo rất khác nhau, chẳng hạn một cột tính bằng mét và một cột tính bằng milimét, hoặc do đặc trưng không được trừ trung bình. Bốn căn hộ cho thấy mức độ của vấn đề. Nếu để diện tích nguyên đơn vị mét vuông, từ 40 tới 100, và không trừ trung bình, Hessian của hàm mất mát có hai trị riêng khoảng 10 802 và 0,185, nên . Tốc độ học khi đó phải nhỏ hơn , và theo công thức trên cần khoảng 537 000 bước để giảm sai số lần. Chỉ chia diện tích cho 100, còn khoảng 45; trừ trung bình rồi chia cho 10 như ở Mục 5.2, ; còn chia cho độ lệch chuẩn 22,36 thì , và gradient descent với tới nghiệm sau đúng một bước. Chuẩn hoá đặc trưng về cùng thang đo, như trừ trung bình rồi chia độ lệch chuẩn, vì vậy là cách rẻ nhất để giảm và tăng tốc huấn luyện.
5.4Chọn tốc độ học#
Ví dụ căn hộ ở Mục 5.2 cho thấy với hàm bậc hai, hướng có độ cong hội tụ khi và chỉ khi . Với hàm bậc hai nhiều biến, mỗi hướng riêng của Hessian có một điều kiện như vậy, và hướng khắt khe nhất là hướng có trị riêng lớn nhất:
Vượt ngưỡng này thì thuật toán chắc chắn phân kỳ theo hướng đó, không chỉ là chậm. Với bốn căn hộ, nên ngưỡng là : đúng tại ngưỡng, hệ số góc dao động mãi giữa hai giá trị như đã thấy, còn vượt ngưỡng một chút là nó phân kỳ. Với hàm không phải bậc hai, không có ngưỡng chính xác như vậy, nhưng đường cong mất mát vẫn cho biết khá rõ tốc độ học đang ở mức nào, như bảng dưới tóm tắt.
| Tốc độ học | Hiện tượng | Dấu hiệu trên đường cong mất mát |
|---|---|---|
| Quá nhỏ | hội tụ nhưng rất chậm | mất mát giảm đều và chậm, chưa phẳng khi hết số vòng lặp |
| Phù hợp | hội tụ nhanh | mất mát giảm nhanh lúc đầu rồi phẳng dần |
| Hơi lớn | dao động quanh cực tiểu | mất mát giảm rồi dao động, không phẳng hẳn |
| Quá lớn | phân kỳ | mất mát tăng, rồi thành inf hoặc nan |
Trong thực tế, ta thử các giá trị cách nhau 3 tới 10 lần, chẳng hạn 0,3; 0,1; 0,03; 0,01, chạy một số vòng lặp ngắn, rồi chọn giá trị lớn nhất mà mất mát vẫn giảm ổn định. Nhiều quy trình huấn luyện còn giảm dần tốc độ học theo thời gian. Chương 5 của Học sâu trình bày các lịch tốc độ học và các thuật toán tự điều chỉnh tốc độ học theo từng tham số như RMSProp, Adam và AdamW.
5.5Kiểm tra gradient bằng sai phân hữu hạn#
Suy ra công thức gradient bằng tay, hoặc cài đặt nó trong mã, rất dễ sai: sai dấu, thiếu hệ số, nhầm chiều ma trận. Một lỗi như vậy thường không làm chương trình báo lỗi, mà chỉ làm mô hình học kém đi một cách khó giải thích. Cách phát hiện đáng tin cậy là so sánh gradient tính bằng công thức với gradient xấp xỉ bằng sai phân hữu hạn:
Với hàm nhiều biến, ta áp dụng công thức cho từng toạ độ, mỗi lần dịch chuyển một toạ độ một lượng .
Thử trên ví dụ căn hộ tại điểm , nơi công thức cho gradient . Sai phân trung tâm với cho khoảng và , lệch khỏi công thức cỡ . Với hàm bậc hai như hàm mất mát này, sai phân trung tâm đúng tuyệt đối về mặt toán học, nên phần lệch nhỏ đó hoàn toàn do làm tròn số. Với hàm tổng quát, xấp xỉ còn mắc thêm sai số cắt cụt, và việc chọn cần cân nhắc.
Câu hỏi là chọn bao nhiêu. Theo định nghĩa đạo hàm, càng nhỏ thì xấp xỉ càng chính xác. Trên máy tính điều đó không đúng, vì có hai nguồn sai số ngược chiều nhau.
| Sai phân trung tâm | Sai phân tiến | |
|---|---|---|
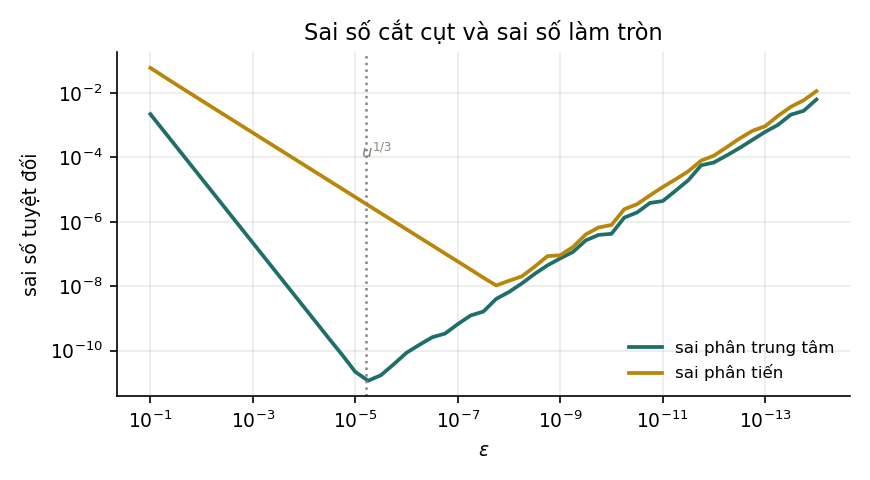
Nguồn thứ nhất là sai số cắt cụt, sinh ra do bỏ các số hạng bậc cao trong khai triển Taylor. Khai triển tới bậc ba cho thấy sai số này tỉ lệ với ở sai phân tiến và với ở sai phân trung tâm, vì các số hạng bậc chẵn triệt tiêu nhau khi lấy hiệu. Sai số này giảm khi nhỏ đi. Nguồn thứ hai là sai số làm tròn, sinh ra do mỗi giá trị chỉ được lưu với độ chính xác tương đối khoảng , tức epsilon máy của số thực 64 bit. Lấy hiệu hai số gần bằng nhau rồi chia cho khuếch đại sai số này lên cỡ , nên nó tăng khi nhỏ đi.
Tổng sai số của sai phân trung tâm có dạng . Đạo hàm theo và cho bằng 0 được điểm tối ưu . Làm tương tự với sai phân tiến, , được :
Giá trị đo được trong thí nghiệm là và , khớp với lý thuyết trong phạm vi độ mịn của lưới quét. Tại điểm tối ưu của từng cách, sai số của sai phân trung tâm xuống tới , còn sai số của sai phân tiến chỉ xuống tới khoảng , kém hơn hơn ba bậc độ lớn. Sai phân trung tâm tốn gấp đôi số lần tính , nhưng độ chính xác tăng thêm xứng đáng với chi phí đó.
Lưu ý (Quy tắc kiểm tra gradient)
Dùng sai phân trung tâm với khoảng tới khi tính bằng số thực 64 bit. So sánh bằng sai số tương đối
Sai số tương đối dưới cho thấy công thức đúng; trên gần như chắc chắn có lỗi. Không chọn với suy nghĩ nhỏ hơn là chính xác hơn: bảng trên cho thấy cho sai số lớn gấp khoảng lần so với tối ưu.
5.6Batch, stochastic và mini-batch gradient descent#
Với hàm mất mát là trung bình trên điểm dữ liệu, , gradient cũng là trung bình của gradient thành phần. Ba biến thể của gradient descent khác nhau ở số điểm dữ liệu dùng để tính gradient mỗi bước.
| Biến thể | Mỗi bước dùng | Ưu điểm | Nhược điểm |
|---|---|---|---|
| Batch gradient descent | toàn bộ điểm | gradient chính xác, đường đi trơn | mỗi bước đắt, cần toàn bộ dữ liệu trong bộ nhớ |
| Stochastic gradient descent (SGD) | 1 điểm chọn ngẫu nhiên | mỗi bước rất rẻ | gradient nhiễu lớn, đường đi dao động |
| Mini-batch gradient descent | điểm chọn ngẫu nhiên | cân bằng hai cách trên, tận dụng tính toán song song | thêm siêu tham số |
Bốn căn hộ cho thấy gradient tính trên một điểm dữ liệu có thể khác gradient đầy đủ tới mức nào. Tại , gradient tính riêng trên căn A, B, C, D lần lượt là , , và . Thành phần theo đi từ tới , thậm chí đổi dấu, nên một bước SGD có thể đi sai hướng hẳn. Nhưng trung bình của bốn vector đúng bằng gradient đầy đủ .
Gradient tính trên một mini-batch chọn ngẫu nhiên là một ước lượng không chệch của gradient đầy đủ, vì kỳ vọng của nó đúng bằng . Phương sai của ước lượng này giảm tỉ lệ với , nên tăng kích thước mini-batch làm hướng đi chính xác hơn, nhưng lợi ích giảm dần: tăng gấp 4 lần chỉ giảm độ lệch chuẩn của gradient đi 2 lần.
Vì gradient ngẫu nhiên luôn có nhiễu, SGD với tốc độ học cố định không hội tụ hẳn về cực tiểu mà dao động trong một vùng quanh nó. Muốn hội tụ, tốc độ học phải giảm dần theo thời gian. Điều kiện cổ điển của Robbins và Monro (1951) là , để đi đủ xa mà tới được cực tiểu, và , để nhiễu bị dập dần; chẳng hạn .
Mini-batch được dùng phổ biến nhất trên thực tế, chủ yếu vì lý do phần cứng: nhân một ma trận với vector trọng số tận dụng GPU tốt hơn nhiều so với phép nhân vector riêng lẻ. Nhiễu của gradient ngẫu nhiên còn có ích với các bài toán không lồi như mạng nơ-ron, vì nó giúp thuật toán thoát khỏi các điểm yên ngựa và các cực tiểu địa phương nông. Với bài toán lồi, nhiễu chỉ là thứ phải chấp nhận để đổi lấy các bước tính rẻ.
5.7Tóm tắt#
Gradient descent đi từng bước ngược hướng gradient, và tốc độ học quyết định nó hội tụ, dao động hay phân kỳ. Trên bốn căn hộ, mỗi bước nhân khoảng cách tới đáy theo một hướng với , trong đó là độ cong theo hướng đó; vì vậy với hàm bậc hai, điều kiện hội tụ là , và ở ví dụ này ngưỡng là 0,2. Số vòng lặp cần thiết tỉ lệ với số điều kiện , tăng từ 1 lên 92 104 khi tăng từ 1 lên trong thí nghiệm, còn momentum hạ con số đó xuống tỉ lệ với . Chuẩn hoá đặc trưng là cách tăng tốc rẻ nhất: với diện tích để nguyên mét vuông, bài toán căn hộ có ; sau khi chuẩn hoá, . Gradient tự tính cần được kiểm tra bằng sai phân trung tâm với cỡ tới , vì quá nhỏ làm sai số làm tròn lấn át. Mini-batch là cách dùng phổ biến nhất: gradient trên từng điểm có thể lệch hẳn hướng, nhưng trung bình của chúng không chệch, và phương sai giảm theo .
Có công cụ tối ưu cho các hàm mất mát không giải được bằng công thức, ta chuyển sang loại bài toán cần tới nó nhiều nhất: phân loại. Chương 6 dùng lại mô hình tuyến tính, thay đổi hàm mất mát, và thấy mỗi lựa chọn hàm mất mát cho một thuật toán khác nhau.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Tốc độ hội tụ của gradient descent trên hàm bậc hai phụ thuộc vào điều gì?
Vì sao: Ở Mục 5.3, khi tăng từ 1 lên 10 000, số vòng lặp tăng từ 1 lên 92 104, khớp với ước lượng . Số chiều ảnh hưởng tới chi phí mỗi vòng lặp, không ảnh hưởng tới số vòng lặp.2Momentum (heavy ball) thay đổi bậc của số vòng lặp thế nào?
Vì sao: Ở , gradient descent cần 92 104 vòng lặp, có momentum chỉ cần 1 297. Lợi ích càng lớn khi càng lớn.3Bước tiền xử lý đơn giản nào giúp gradient descent nhanh hơn nhiều nhất?
Vì sao: Nếu một đặc trưng có độ lớn cỡ và một đặc trưng khác cỡ , các trị riêng của chênh nhau rất nhiều bậc. Chuẩn hoá đưa chúng về cùng cỡ.4Với , gradient descent hội tụ khi tốc độ học nằm trong khoảng nào?
Vì sao: Mỗi bước nhân khoảng cách tới cực tiểu với , nên cần . Tổng quát, với hàm bậc hai cần ; ở đây .5Khi kiểm tra gradient bằng sai phân trung tâm, nên chọn thế nào?
Vì sao: Sai số cắt cụt tỉ lệ , sai số làm tròn tỉ lệ . Thí nghiệm đo được điểm tối ưu , khớp lý thuyết ; với sai số lớn hơn khoảng lần.
Đã trả lời 0/5