10Mạng đối sinh#
Chương 9 kết thúc ở chỗ độ mờ của VAE đến từ hàm mất mát bình phương viết sẵn. Mạng đối sinh (generative adversarial network, GAN; Goodfellow và cộng sự, 2014) không viết ra hàm đo mức giống thật mà học nó bằng một mạng thứ hai. Cách làm này cho mẫu sắc nét, nhưng biến việc huấn luyện thành một trò chơi giữa hai mạng, và trò chơi đó khó điều khiển hơn nhiều so với cực tiểu một hàm mất mát.
10.1Trò chơi giữa bộ sinh và bộ phân biệt#
GAN gồm hai mạng có mục tiêu ngược nhau: một bộ sinh biến nhiễu thành mẫu , và một bộ phân biệt nhận một mẫu rồi cho xác suất mẫu đó là thật. được huấn luyện để phân biệt mẫu thật với mẫu sinh ra, còn được huấn luyện để nhầm. Bài toán viết là
Bộ sinh không bao giờ nhìn thấy dữ liệu thật; nó chỉ nhận gradient qua bộ phân biệt. Mọi thông tin về "thế nào là thật" đi qua một kênh duy nhất là đánh giá của .
Mệnh đề 10.1 (Goodfellow và cộng sự, 2014)
Với cố định sinh ra phân phối , bộ phân biệt tối ưu là
và khi đó , với JS là phân kỳ Jensen–Shannon.
Chứng minh
Viết . Với mỗi , hàm đạt cực đại tại , cho . Thay vào và dùng định nghĩa với được biểu thức cần chứng minh.
Công thức của đọc được trực tiếp: tại một điểm mà mật độ dữ liệu là 0,3 còn mật độ của bộ sinh là 0,1, bộ phân biệt tối ưu trả lời ; ở nơi hai mật độ bằng nhau, nó trả lời 0,5, tức không phân biệt được. Như vậy, nếu bộ phân biệt luôn tối ưu, bộ sinh đang cực tiểu phân kỳ Jensen–Shannon giữa phân phối của nó và phân phối dữ liệu, đạt cực tiểu khi .
10.2Gradient của hàm mất mát gốc và bản không bão hoà#
Phân tích ở Mục 10.1 giả định bộ phân biệt luôn tối ưu. Khi huấn luyện thật, hai mạng cùng học dần từ đầu, và cách viết hàm mất mát cho bộ sinh quyết định nó có học được hay không. Thí nghiệm dùng dữ liệu hai chiều gồm 8 cụm Gauss đặt đều trên một đường tròn bán kính 2,4, mỗi cụm có độ lệch chuẩn 0,13. Bộ sinh và bộ phân biệt đều là MLP một lớp ẩn, huấn luyện 4 000 vòng, với hai hàm mất mát khác nhau cho bộ sinh, mỗi hàm 4 lần khởi tạo. Một cụm được tính là "được phủ" nếu có ít nhất một điểm sinh ra cách tâm cụm dưới 0,55; cột cuối là tỉ lệ điểm sinh ra nằm trong phạm vi đó của một cụm nào đó.
| Hàm mất mát của bộ sinh | Số cụm được phủ (4 lần khởi tạo) | Tỉ lệ điểm nằm trong cụm |
|---|---|---|
| Cực tiểu , dạng gốc | 0, 0, 0, 0 | 0,0% |
| Cực đại , dạng không bão hoà | 8, 8, 8, 8 | 15,3% |
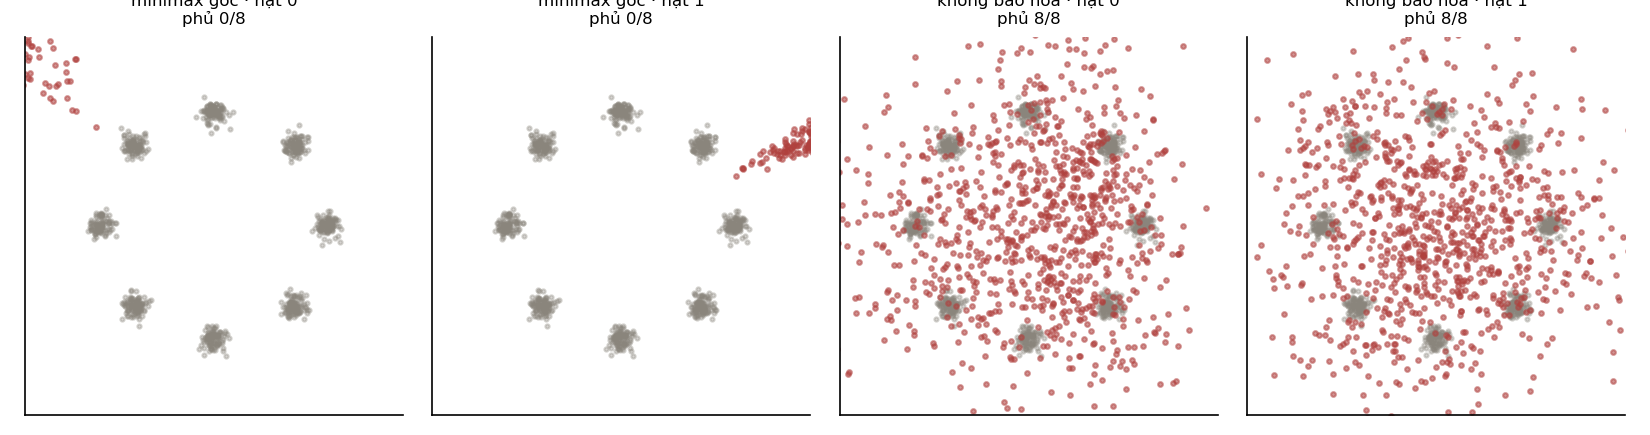
Dạng gốc thất bại hoàn toàn: bộ sinh không học được gì ở cả bốn lần. Nguyên nhân nằm ở đạo hàm. Viết với là đầu ra trước sigmoid của bộ phân biệt cho một mẫu sinh ra. Khi đó
Lúc bắt đầu huấn luyện, bộ sinh còn rất tệ nên bộ phân biệt dễ dàng nhận ra mẫu giả: . Gradient mà bộ sinh nhận được tỉ lệ với , nên cũng gần 0. Bộ sinh càng tệ càng nhận ít tín hiệu để sửa, và bị kẹt ngay từ đầu.
Bài báo GAN gốc đã nêu vấn đề này và đề xuất cách sửa: thay vì cực tiểu , cho bộ sinh cực đại . Hai hàm có cùng điểm cố định trong trò chơi nhưng đạo hàm khác hẳn:
lớn nhất đúng khi bộ sinh đang tệ nhất, . Với một mẫu giả mà bộ phân biệt cho xác suất là thật , dạng gốc cho đạo hàm theo bằng , còn dạng không bão hoà cho , lớn gấp 99 lần.
Ví dụ này cho thấy hai hàm mất mát có cùng điểm tối ưu vẫn có thể cho quá trình huấn luyện rất khác nhau, vì thứ quyết định việc học là gradient tại các điểm mà quá trình tối ưu thực sự đi qua, không phải vị trí của điểm tối ưu. Ý này đã xuất hiện khi so sánh hàm mất mát của perceptron, hinge và logistic ở Chương 6 của Nền tảng.
10.3Độ phủ các chế độ#
Sụp chế độ (mode collapse) là hiện tượng bộ sinh chỉ sinh ra một phần của phân phối: nó tìm được vài vùng làm bộ phân biệt nhầm rồi tập trung vào đó, bỏ qua các chế độ khác. Đây là hiện tượng có thật và thường gặp với dữ liệu nhiều chiều (Arjovsky, Chintala và Bottou, 2017).
Thí nghiệm này không tái hiện được sụp chế độ: với hàm mất mát không bão hoà, cả bốn lần khởi tạo đều phủ đủ 8 cụm, và các thay đổi như làm bộ phân biệt yếu đi hay giảm kích thước lô cũng không làm thay đổi kết quả đó. Vì vậy thí nghiệm không được dùng làm minh hoạ cho sụp chế độ; một ví dụ hai chiều đơn giản không đủ để hiện tượng này xuất hiện. Bài tập 10 đề xuất các thay đổi có thể làm nó xuất hiện.
Thí nghiệm lại cho thấy một vấn đề khác về chất lượng: chỉ 15,3% số điểm sinh ra nằm trong phạm vi một cụm. Phần lớn điểm nằm rải rác giữa các cụm. Bộ sinh phủ đúng vị trí các chế độ nhưng phân phối của nó không khớp với phân phối dữ liệu. Phủ đủ các chế độ vì vậy chưa có nghĩa là học đúng phân phối.
10.4Khó khăn khi huấn luyện GAN#
Ngoài vấn đề gradient ở Mục 10.2, GAN khó huấn luyện vì ba nguyên nhân mang tính cấu trúc. Nguyên nhân thứ nhất là không có hàm mục tiêu giảm đơn điệu. Khi huấn luyện mô hình thông thường, mất mát giảm là dấu hiệu tiến bộ. Với GAN, mất mát của bộ sinh tăng có thể vì bộ sinh kém đi, cũng có thể vì bộ phân biệt vừa tốt lên, nên đường cong mất mát không cho biết mô hình có đang tốt lên hay không.
Nguyên nhân thứ hai là bài toán tìm điểm cân bằng chứ không phải tìm cực tiểu. Nghiệm là một điểm yên ngựa của , tức cân bằng Nash của trò chơi hai người. Gradient descent xen kẽ cho hai bên không có bảo đảm hội tụ tới điểm yên ngựa, và có thể dao động quanh nó.
Nguyên nhân thứ ba là không có cách đánh giá dựa trên hợp lý. VAE và mô hình khuếch tán cho một chặn dưới của log hợp lý để so sánh các mô hình; GAN thì không. Các chỉ số như FID (Heusel và cộng sự, 2017) so sánh thống kê của đặc trưng trích từ một mạng phân loại ảnh, và có những điểm mù riêng.
Nhiều biến thể đã được đề xuất để giảm các khó khăn này, như Wasserstein GAN (Arjovsky, Chintala và Bottou, 2017) thay phân kỳ Jensen–Shannon bằng khoảng cách Wasserstein để gradient có ý nghĩa ngay cả khi hai phân phối không giao nhau. Nhưng ba nguyên nhân trên giải thích vì sao mô hình khuếch tán, vốn được huấn luyện bằng một bài hồi quy thông thường, thay thế GAN trong phần lớn ứng dụng sinh ảnh.
10.5Tóm tắt#
GAN học hàm đo mức giống thật bằng một bộ phân biệt. Khi bộ phân biệt tối ưu, bộ sinh cực tiểu phân kỳ Jensen–Shannon giữa phân phối của nó và phân phối dữ liệu. Dạng gốc của hàm mất mát cho bộ sinh có gradient tỉ lệ với , gần 0 đúng lúc bộ sinh còn tệ, nên trong thí nghiệm nó không phủ được cụm nào; dạng không bão hoà phủ đủ 8 cụm ở cả bốn lần khởi tạo. Thí nghiệm không tái hiện được sụp chế độ, nhưng cho thấy phủ đủ các chế độ chưa phải là học đúng phân phối: chỉ 15,3% số điểm sinh ra nằm trong một cụm. Việc không có hàm mục tiêu giảm đơn điệu, phải tìm điểm cân bằng thay vì cực tiểu, và không đánh giá được bằng hợp lý khiến GAN khó huấn luyện.
Một mô hình sinh lý tưởng sẽ cho mẫu sắc nét như GAN mà huấn luyện chỉ bằng cách cực tiểu một hàm mất mát thông thường. Mô hình khuếch tán ở Chương 11 đạt được điều đó bằng cách chia việc sinh thành nhiều bước khử nhiễu nhỏ.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Đạo hàm của theo là gì, và hệ quả với dạng gốc của hàm mất mát cho bộ sinh?
Vì sao: Ở Mục 10.2, dạng gốc phủ 0 trong 8 cụm ở cả bốn lần khởi tạo. Bộ sinh càng kém càng nhận ít tín hiệu để sửa.2Dạng không bão hoà của hàm mất mát cho bộ sinh khác gì?
Vì sao: Hai dạng có cùng điểm cố định nhưng gradient khác hẳn; với dạng không bão hoà, cả bốn lần khởi tạo đều phủ đủ 8 cụm.3Thí nghiệm GAN ở Mục 10.3 cho thấy gì về sụp chế độ?
Vì sao: Phủ đủ các chế độ chưa có nghĩa là học đúng phân phối: phần lớn điểm sinh ra nằm rải rác giữa các cụm. Sụp chế độ là hiện tượng có thật, nhưng một ví dụ hai chiều đơn giản không đủ để nó xuất hiện.4Vì sao đường cong mất mát của GAN khó dùng để theo dõi chất lượng?
Vì sao: Đây là một trong ba nguyên nhân cấu trúc khiến GAN khó huấn luyện, cùng với việc không có bảo đảm hội tụ tới điểm yên ngựa và không có đánh giá dựa trên hợp lý.
Đã trả lời 0/4