4Hồi quy tuyến tính#
Ta bắt đầu với một bài toán quen thuộc: định giá căn hộ. Bảng dưới ghi diện tích và giá bán của bốn căn hộ trong cùng một khu, chính là bốn căn hộ của ma trận dữ liệu ở Mục 2.1. Đây là số liệu minh hoạ, chọn tròn để tính tay được.
| Căn hộ | Diện tích (m²) | Giá (tỉ đồng) |
|---|---|---|
| A | 40 | 1,5 |
| B | 60 | 2,1 |
| C | 80 | 2,4 |
| D | 100 | 3,0 |
Nếu được hỏi một căn 90 m² trong khu này đáng giá bao nhiêu, hầu hết mọi người sẽ trả lời khoảng 2,7 tỉ, vì giá tăng gần đều theo diện tích. Hồi quy tuyến tính biến trực giác "tăng gần đều" đó thành một quy trình chính xác: chọn một đường thẳng, đo xem đường thẳng khớp dữ liệu tới mức nào, rồi tìm đường khớp nhất. Đây là thuật toán học có giám sát đơn giản nhất, nhưng đáng học kỹ vì bài toán có nghiệm dạng đóng. Nhờ vậy, những hiện tượng sẽ gặp lại ở mọi mô hình phức tạp hơn, như overfitting, regularization, ảnh hưởng của số điều kiện và đánh đổi độ chệch – phương sai, đều quan sát được trực tiếp mà không bị lẫn với câu hỏi thuật toán tối ưu có hội tụ hay không.
4.1Bài toán hồi quy tuyến tính#
Mô hình đơn giản nhất cho bảng trên là một đường thẳng,
Hệ số là phần giá tăng thêm khi diện tích tăng 1 m², còn là điểm đường thẳng cắt trục tung. Học từ dữ liệu ở đây nghĩa là chọn và . Nhưng trước khi chọn, ta cần một cách nói đường thẳng nào tốt hơn đường thẳng nào.
Với mỗi căn hộ, đường thẳng mắc một sai số , tức chênh lệch giữa giá thật và giá dự đoán. Cộng thẳng các sai số thì không dùng được, vì sai số dương và sai số âm triệt tiêu nhau: một đường dự đoán quá cao cho nửa số căn và quá thấp cho nửa còn lại vẫn có thể cho tổng bằng 0. Cách phổ biến nhất là lấy trung bình bình phương sai số,
Bình phương làm mọi sai số thành số dương, phạt sai số lớn nặng hơn nhiều so với sai số nhỏ, và cho một hàm trơn, dễ lấy đạo hàm. Còn vì sao là bình phương mà không phải trị tuyệt đối thì có một câu trả lời chính xác hơn, trình bày ở Mục 10.2: bình phương sai số là hệ quả của giả thiết nhiễu có phân phối Gauss.
Có hàm , ta so sánh được các đường thẳng bằng số. Đường , tức giá 30 triệu đồng mỗi mét vuông, dự đoán 1,2; 1,8; 2,4 và 3,0 tỉ cho bốn căn. Sai số là 0,3; 0,3; 0 và 0, nên . Đường dự đoán 1,56; 2,04; 2,52 và 3,0 tỉ, với sai số ; ; và , nên , nhỏ hơn khoảng tám lần. Đường thứ hai tốt hơn hẳn. Câu hỏi còn lại là có đường nào tốt hơn nữa không, và đường tốt nhất là đường nào. Mục 4.2 trả lời câu hỏi đó.
Trước khi giải, ta viết bài toán ở dạng tổng quát. Giá căn hộ còn phụ thuộc số phòng, tầng và khoảng cách tới trung tâm, nên mỗi điểm dữ liệu thường là một vector đặc trưng chứ không phải một số. Để công thức gọn, ta thêm vào mỗi một thành phần hằng bằng 1 ở vị trí đầu. Khi đó hệ số chặn trở thành trọng số ứng với thành phần này, và mô hình viết được là . Xếp các thành các hàng của ma trận và các nhãn thành vector , toàn bộ dự đoán trên tập dữ liệu là . Giáo trình dùng quy ước này ở mọi chỗ: cột đầu tiên của ma trận dữ liệu gồm toàn số 1.
Một cách tốt để nắm ký hiệu là tự kiểm tra kích thước. Với điểm dữ liệu, có hàng và cột, vector có thành phần, nên là vector chiều, cùng kích thước với , đúng như cần để so từng dự đoán với nhãn của nó. Trong ví dụ căn hộ, , , và hàng đầu tiên của là .
Định nghĩa 4.1 (Hồi quy tuyến tính bình phương tối thiểu)
Với ma trận dữ liệu và vector nhãn , hồi quy tuyến tính tìm
Phương pháp này còn gọi là bình phương tối thiểu thông thường (ordinary least squares, OLS).
Theo khung ở Hình 1, đây là đủ ba thành phần của một thuật toán học: mô hình là họ hàm tuyến tính , hàm mất mát là bình phương sai số, còn thuật toán tối ưu là cách tìm mà Mục 4.2 sẽ trình bày.
Bài toán còn có một cách hiểu hình học, sẽ dùng nhiều ở các mục sau. Khi chạy khắp , vector dự đoán chạy khắp không gian cột của (Mục 2.1). Trong ví dụ căn hộ, là một vector trong , còn không gian cột là mặt phẳng hai chiều sinh bởi và : dự đoán của mọi đường thẳng đều nằm trên mặt phẳng này. Cực tiểu nghĩa là tìm điểm trên mặt phẳng gần nhất, tức hình chiếu vuông góc của lên không gian cột. Vector phần dư vì thế phải vuông góc với mọi cột của .
4.2Phương trình chuẩn#
Ta tìm đường thẳng tốt nhất cho ví dụ căn hộ trước, rồi mới tổng quát hoá. Hàm là hàm bậc hai của hai biến và có dạng một cái chén: đi xa theo hướng nào nó cũng tăng. Đáy chén là điểm mà đạo hàm riêng theo cả hai biến đều bằng 0.
Đạo hàm theo cho
với và là trung bình của các và các . Phương trình này đã cho biết một điều cụ thể: đường thẳng tốt nhất luôn đi qua điểm trung bình của dữ liệu. Đạo hàm theo cho
Thay vào phương trình thứ hai, mỗi số hạng trong tổng trở thành , và giải ra
Ở bước cuối, thừa số đứng trước được thay bằng . Phép thay không làm đổi tử số và mẫu số, vì và .
Công thức có một cách đọc quen thuộc từ Chương 3. Chia cả tử và mẫu cho , hệ số góc chính là hiệp phương sai mẫu giữa và chia cho phương sai mẫu của ; với bốn căn hộ, đó là tỉ số ở Mục 3.3. Hệ số góc lớn khi biến thiên cùng chiều với và mạnh so với độ phân tán của .
Với bốn căn hộ, và . Các độ lệch là ; ; ; và các độ lệch là ; ; ; , nên tử số bằng và mẫu số bằng . Do đó tỉ đồng mỗi mét vuông, tức 24 triệu đồng, và . Đường thẳng này dự đoán 1,53; 2,01; 2,49 và 2,97 tỉ cho bốn căn, với sai số ; ; ; và , nhỏ hơn cả đường thứ hai ở Mục 4.1. Căn 90 m² được định giá tỉ, khớp với ước đoán bằng mắt ở đầu chương.
Hệ số chặn tỉ không có nghĩa một căn hộ 0 m² đáng giá 570 triệu đồng. Nó chỉ là điểm đường thẳng cắt trục tung, cần có để đường thẳng khớp dữ liệu trong khoảng 40 tới 100 m². Dùng mô hình cho những điểm nằm xa ngoài khoảng dữ liệu đã thấy, gọi là ngoại suy (extrapolation), luôn cần thận trọng.
Cách làm vừa rồi tổng quát hoá trực tiếp sang đặc trưng nhờ ký hiệu ma trận. Viết bình phương chuẩn thành tích vô hướng rồi khai triển như khai triển :
Hai số hạng chéo và gộp được làm một vì chúng là cùng một số: một số thực bằng chuyển vị của chính nó. Áp dụng hai quy tắc đạo hàm ở Mục 2.7, và với đối xứng, ta được
Cho gradient bằng 0:
Hệ phương trình tuyến tính này gọi là phương trình chuẩn (normal equations). Nó có đúng phương trình và ẩn, bất kể có bao nhiêu điểm dữ liệu. Với một đặc trưng, hai phương trình của nó chính là hai phương trình đạo hàm riêng ở trên.
Viết dưới dạng , phương trình chuẩn giải thích được tên gọi của nó và cho thấy nghiệm có tính chất gì. Đặt là vector phần dư. Thành phần thứ của bằng , tích vô hướng giữa cột đặc trưng thứ và phần dư. Phương trình chuẩn đòi hỏi mọi tích vô hướng này bằng 0, tức phần dư vuông góc (normal) với mọi cột của , đúng như cách hiểu hình học ở Mục 4.1. Theo cách nhìn thống kê, ở nghiệm tối ưu phần dư không còn tương quan tuyến tính với đặc trưng nào. Nếu còn, ta chưa ở điểm tốt nhất: chỉnh trọng số theo đặc trưng đó còn giảm được sai số. Riêng cột hằng số cho , nên với mọi mô hình có hệ số chặn, tổng phần dư bằng 0. Bốn sai số ; ; ; ở ví dụ căn hộ đúng là có tổng bằng 0.
Định lý 4.1 (Nghiệm của bình phương tối thiểu)
Nếu đủ hạng cột thì khả nghịch và bài toán ở Định nghĩa 4.1 có nghiệm duy nhất
Nghiệm này là cực tiểu chứ không phải cực đại hay điểm yên ngựa, vì ma trận Hessian của bằng , nửa xác định dương theo Mục 2.5. Do đó là hàm lồi và mọi điểm có gradient bằng 0 đều là cực tiểu toàn cục. Khi đủ hạng cột, Hessian xác định dương và cực tiểu là duy nhất. Chương 11 trình bày tính lồi một cách đầy đủ.
Ví dụ 4.1
Với bốn căn hộ ở đầu chương, ma trận dữ liệu và các tích cần thiết là
Định thức của là , nên
trùng với kết quả tính bằng trung bình, hiệp phương sai và phương sai ở trên.
Trên dữ liệu lớn hơn, ta có thể kiểm tra rằng các cách tính khác nhau cho cùng một nghiệm. Thí nghiệm trong code/nentang/experiments.py sinh 200 điểm với bốn hệ số thật cộng nhiễu, rồi giải bằng ba cách.
| Cách giải | ||||
|---|---|---|---|---|
| Phương trình chuẩn | 1,9906 | −1,4985 | 0,7992 | 2,9749 |
| Giả nghịch đảo Moore–Penrose | 1,9906 | −1,4985 | 0,7992 | 2,9749 |
lstsq (phân tích QR/SVD) |
1,9906 | −1,4985 | 0,7992 | 2,9749 |
Ba cách lệch nhau lớn nhất , tức bằng nhau tới sai số làm tròn của máy tính. Các hệ số ước lượng cũng gần hệ số thật, và sai lệch còn lại là do nhiễu.
Lưu ý
Công thức dùng để suy luận, không nên dùng để tính trong mã. Theo Mục 2.6, , nên lập ma trận làm mất khoảng gấp đôi số chữ số có nghĩa so với làm việc trực tiếp với . Hàm
np.linalg.lstsqgiải bài toán bằng phân tích SVD của và tránh được vấn đề này.
4.3Trường hợp ma trận suy biến#
Định lý 4.1 cần một điều kiện: đủ hạng cột, tức không cột nào biểu diễn được qua các cột còn lại. Theo Mục 2.5, đó cũng là điều kiện để khả nghịch. Trong thực tế có hai tình huống khiến điều kiện này không thoả. Tình huống thứ nhất là số đặc trưng lớn hơn số điểm dữ liệu (): hạng của không vượt quá , nên không thể đủ hạng cột. Tình huống thứ hai là có đặc trưng phụ thuộc tuyến tính vào các đặc trưng khác. Nếu bảng căn hộ có thêm cột diện tích tính bằng feet vuông, cột đó đúng bằng 10,764 lần cột diện tích tính bằng mét vuông, và dữ liệu không có cách nào tách ảnh hưởng của hai cột ra khỏi nhau. Một trường hợp hay gặp hơn là mã hoá one-hot một biến hạng mục có giá trị thành đủ cột trong khi vẫn giữ cột hằng số, vì tổng cột one-hot đúng bằng cột hằng số; cách xử lý thông thường là bỏ một cột one-hot, hoặc bỏ cột hằng số.
Thí nghiệm sau sao chép một cột của rồi thử giải.
hang cua X = 4 nhung X co 5 cot  ->  X^T X suy bien
  solve: BAO LOI 'Singular matrix'
  pinv : van cho mot nghiem, chuan ||w|| = 3.8176
  mot nghiem khac cung du bao y het: ||w|| = 4.0711 (sai so du bao lech 0.00e+00)
Dòng cuối cho thấy bản chất của trường hợp suy biến. Bài toán không vô nghiệm mà có vô số nghiệm cho cùng một dự đoán: cộng một lượng vào hệ số của cột gốc và trừ đi đúng lượng đó ở cột bản sao thì không đổi. Tập nghiệm là một đường thẳng, tổng quát là một không gian affine, trong không gian tham số.
Khi có nhiều nghiệm, ta cần một quy tắc chọn. Giả nghịch đảo Moore–Penrose chọn nghiệm có chuẩn nhỏ nhất: là nghiệm của phương trình chuẩn có nhỏ nhất trong mọi nghiệm. Trong thí nghiệm, nghiệm của pinv có chuẩn 3,8176, nhỏ hơn nghiệm khác có chuẩn 4,0711 dù hai nghiệm cho cùng dự đoán. Quy tắc này hợp lý, và Mục 9.2 sẽ cho thấy nó trùng với giới hạn của hồi quy ridge khi hệ số regularization tiến về 0 từ phía dương.
4.4Đa cộng tuyến#
Phụ thuộc tuyến tính chính xác dễ phát hiện, vì thuật toán giải báo lỗi. Khó hơn là trường hợp các cột gần phụ thuộc tuyến tính mà không phụ thuộc hẳn, như diện tích sàn xây dựng và diện tích sử dụng của một căn hộ: hai con số gần tỉ lệ với nhau nhưng không đúng tỉ lệ. Khi đó vẫn đủ hạng cột và nghiệm vẫn duy nhất, nhưng không ổn định. Hiện tượng này gọi là đa cộng tuyến (multicollinearity). Thí nghiệm sau dựng hai đặc trưng có hệ số tương quan tăng dần. Với mỗi , ma trận được giữ cố định và nhãn được sinh lại 300 lần với nhiễu khác nhau, để đo xem hệ số và dự đoán dao động bao nhiêu.
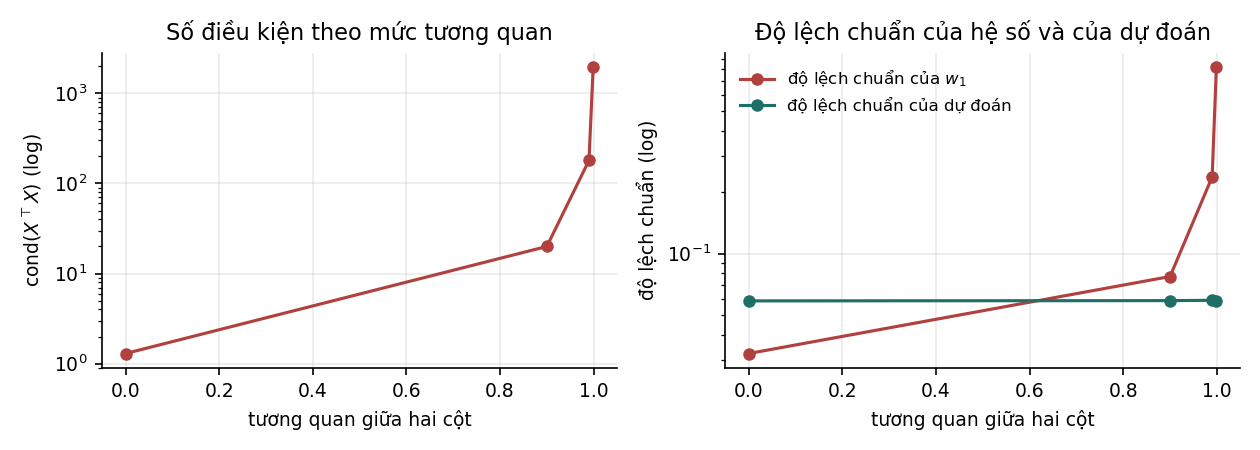
| Tương quan hai cột | Độ lệch chuẩn của | Độ lệch chuẩn của dự đoán | |
|---|---|---|---|
| 0,000 | 1,3 | 0,0324 | 0,0586 |
| 0,900 | 20,0 | 0,0772 | 0,0588 |
| 0,990 | 180,3 | 0,2373 | 0,0590 |
| 0,999 | 1958,9 | 0,8196 | 0,0585 |
Khi tương quan tăng từ 0 lên 0,999, độ lệch chuẩn của hệ số tăng khoảng 25 lần, trong khi độ lệch chuẩn của dự đoán gần như không đổi, từ 0,0586 xuống 0,0585.
Nguyên nhân nằm ở chỗ khi hai cột gần trùng nhau, dữ liệu chỉ xác định được tổng ảnh hưởng của hai đặc trưng, còn cách chia ảnh hưởng đó cho từng đặc trưng thì gần như tuỳ ý. Tổng ảnh hưởng ổn định nên dự đoán ổn định; cách chia phụ thuộc vào nhiễu nên từng hệ số dao động mạnh.
Mức tăng này có thể dự đoán bằng lý thuyết. Với mô hình có hệ số chặn, phương sai của hệ số bằng phương sai khi các đặc trưng không tương quan nhân với hệ số phóng đại phương sai (variance inflation factor)
trong đó là hệ số xác định khi hồi quy đặc trưng theo các đặc trưng còn lại. Với hai đặc trưng có tương quan thì , nên độ lệch chuẩn của hệ số tăng theo , tức khoảng 2,3; 7,1 và 22,4 lần tại ; ; . Số đo trong bảng là 2,4; 7,3 và 25,3 lần. Chênh lệch nhỏ đến từ việc mỗi hàng dùng một ma trận sinh ngẫu nhiên riêng, nên tương quan mẫu và phương sai mẫu của các cột không đúng bằng giá trị danh nghĩa.
Như vậy đa cộng tuyến là vấn đề của việc diễn giải hệ số, không phải của dự đoán. Nếu mô hình chỉ dùng để dự đoán trên dữ liệu có cùng cấu trúc tương quan, không cần xử lý gì. Nếu cần đọc hệ số để kết luận "đặc trưng này ảnh hưởng bao nhiêu", các hệ số đó không đáng tin, và cách xử lý là dùng hồi quy ridge (Chương 9), gộp các đặc trưng tương quan thành một, hoặc bỏ bớt đặc trưng. Quy tắc kinh nghiệm thường dùng là VIF lớn hơn 10 cho thấy đa cộng tuyến đáng kể.
4.5Các giả định của mô hình#
Phương pháp bình phương tối thiểu luôn cho ra một nghiệm, nhưng việc diễn giải nghiệm đó, như khoảng tin cậy của hệ số hay kiểm định ý nghĩa thống kê, dựa trên ba giả định.
Giả định đầu tiên là mô hình tuyến tính theo tham số, tức kỳ vọng của là hàm tuyến tính của . Cần chú ý là tuyến tính theo tham số chứ không nhất thiết theo đầu vào: vẫn là hồi quy tuyến tính vì nó tuyến tính theo , chỉ cần coi là một đặc trưng mới. Để kiểm tra, ta vẽ phần dư theo giá trị dự đoán; nếu thấy dạng cong có hệ thống thì giả định bị vi phạm và cần thêm đặc trưng phi tuyến. Chẳng hạn, nếu giá căn hộ tăng nhanh dần theo diện tích, một đường thẳng sẽ dự đoán thấp ở hai đầu và cao ở giữa, và đồ thị phần dư có dạng chữ U.
Giả định thứ hai là phương sai của nhiễu không đổi. Độ lớn của nhiễu thay đổi theo , hiện tượng gọi là phương sai thay đổi, rất hay gặp với dữ liệu tiền tệ: sai số dự đoán giá một căn nhà đắt lớn hơn sai số với căn nhà rẻ. Khi đó bình phương tối thiểu vẫn cho ước lượng không chệch, nhưng không còn là ước lượng có phương sai nhỏ nhất, và các khoảng tin cậy tính theo công thức chuẩn bị sai. Cách xử lý thường dùng là lấy logarit của , hoặc dùng bình phương tối thiểu có trọng số.
Giả định thứ ba là các quan sát độc lập. Dữ liệu chuỗi thời gian hầu như luôn vi phạm giả định này, vì sai số ở các thời điểm liền nhau thường tương quan.
Giả định thứ hai và thứ ba không ảnh hưởng tới giá trị của , mà ảnh hưởng tới độ tin cậy ta gán cho nó. Khi mục tiêu chỉ là dự đoán, vi phạm hai giả định này ít nghiêm trọng hơn; khi mục tiêu là suy luận thống kê về hệ số, chúng cần được kiểm tra.
4.6Tóm tắt#
Hồi quy tuyến tính chọn đường thẳng, hay tổng quát là siêu phẳng, có trung bình bình phương sai số nhỏ nhất. Với một đặc trưng, đường tốt nhất đi qua điểm trung bình của dữ liệu và có hệ số góc bằng hiệp phương sai chia phương sai; trong ví dụ căn hộ, hệ số góc là 24 triệu đồng mỗi mét vuông. Với nhiều đặc trưng, cho gradient bằng 0 được phương trình chuẩn , nói rằng phần dư vuông góc với mọi cột của , tức là hình chiếu vuông góc của lên không gian cột. Phương trình có nghiệm duy nhất khi đủ hạng cột; trong mã nên giải bằng lstsq thay vì lập , vì số điều kiện bị bình phương. Khi không đủ hạng cột, bài toán có vô số nghiệm cho cùng dự đoán, và giả nghịch đảo chọn nghiệm có chuẩn nhỏ nhất. Khi các cột gần phụ thuộc tuyến tính, hệ số dao động mạnh, gấp khoảng 25 lần ở tương quan 0,999 trong thí nghiệm, trong khi dự đoán gần như không đổi; hệ số phóng đại phương sai dự đoán được mức tăng này. Việc diễn giải hệ số còn dựa trên các giả định về tính tuyến tính, phương sai không đổi và tính độc lập của nhiễu.
Hồi quy tuyến tính giải được bằng một công thức, nhưng công thức đó đòi hỏi giải một hệ phương trình, còn hầu hết các mô hình khác không có công thức nào cả. Chương 5 trình bày phương pháp lặp được dùng cho gần như mọi mô hình học máy: gradient descent.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Khi nào phương trình chuẩn không có nghiệm duy nhất?
Vì sao: Trường hợp hay gặp: mã hoá one-hot đủ giá trị trong khi vẫn giữ cột hằng số, vì tổng cột one-hot bằng đúng cột hằng số.2Khi suy biến, bài toán bình phương tối thiểu có đặc điểm gì?
Vì sao: Ở Mục 4.3, hai vector trọng số có chuẩn 3,8176 và 4,0711 cho cùng một dự đoán. Nghiệm chuẩn nhỏ nhất của giả nghịch đảo là giới hạn của nghiệm ridge khi .3Đa cộng tuyến ảnh hưởng chủ yếu tới điều gì?
Vì sao: Ở Mục 4.4, khi tương quan tăng từ 0 lên 0,999, độ lệch chuẩn của tăng khoảng 25 lần (0,0324 lên 0,8196) trong khi độ lệch chuẩn của dự đoán gần như không đổi. Lý thuyết dự đoán mức tăng .4Trong hồi quy tuyến tính có hệ số chặn, tổng các phần dư trên tập huấn luyện bằng bao nhiêu?
Vì sao: Phương trình chuẩn nói . Hàng ứng với cột hằng số của gồm toàn số 1, nên .
Đã trả lời 0/4