13Máy vector hỗ trợ#
Quay lại perceptron ở Mục 6.2: trên dữ liệu tách được, nó dừng ở siêu phẳng tách đúng đầu tiên mà nó tìm được, trong khi có vô số siêu phẳng như vậy. Với phiên bản tách được của sáu sinh viên ở Mục 6.5, ba người ôn 1, 2, 3 giờ trượt và ba người ôn 4, 5, 6 giờ đỗ, nên mọi ngưỡng nằm giữa 3 và 4 giờ đều tách đúng. Perceptron xuất phát từ , duyệt lần lượt sáu người theo thứ tự, và dừng ở , hệ số chặn , tức ngưỡng giờ, cách sinh viên 3 chỉ một phần ba giờ. Máy vector hỗ trợ (support vector machine, SVM) đặt ra một tiêu chí để chọn giữa chúng: lấy siêu phẳng cách xa dữ liệu nhất. Tiêu chí đơn giản này dẫn tới một bài toán tối ưu có ràng buộc, và toàn bộ công cụ của Chương 11 và 12 giờ được dùng tới: bài toán là lồi, điều kiện bù chỉ ra những điểm quyết định nghiệm, và bài toán đối ngẫu mở đường cho kernel, cách để SVM vẽ được biên quyết định phi tuyến.
13.1Ý tưởng lề cực đại#
Khi dữ liệu tách được tuyến tính, có vô số siêu phẳng tách đúng hai lớp. Perceptron dừng ở siêu phẳng đầu tiên nó tìm được, và siêu phẳng đó có thể nằm sát một điểm dữ liệu. Một điểm mới ở gần điểm đó, chỉ lệch đi một chút vì nhiễu, có thể bị phân loại sai.
SVM chọn siêu phẳng có lề lớn nhất, tức khoảng cách từ siêu phẳng tới điểm dữ liệu gần nhất là lớn nhất. Siêu phẳng như vậy nằm "chính giữa" khoảng trống giữa hai lớp. Với sáu sinh viên tách được, đó là ngưỡng 3,5 giờ, cách đều sinh viên 3 và sinh viên 4 nửa giờ. Trực giác là biên càng xa dữ liệu thì càng chịu được nhiễu. Lý thuyết học thống kê (Vapnik, 1995) chính xác hoá trực giác này: với dữ liệu nằm trong hình cầu bán kính , chiều VC của lớp các siêu phẳng có lề ít nhất không vượt quá . Khi lề đủ rộng, độ phức tạp của mô hình được kiểm soát bởi tỉ số chứ không bởi số chiều. Tỉ số này cũng là đại lượng xuất hiện trong định lý Novikoff ở Mục 6.2.
13.2Bài toán tối ưu của SVM lề cứng#
Theo Định lý 2.1, khoảng cách từ tới siêu phẳng là . Siêu phẳng không đổi nếu nhân và với cùng một số dương, nên ta có thể chọn thang đo sao cho điểm gần nhất thoả . Khi đó mọi điểm thoả , và khoảng cách giữa hai siêu phẳng và , tức độ rộng của lề, bằng .
Cực đại tương đương cực tiểu , và tương đương cực tiểu , dạng thuận tiện hơn vì khả vi.
Định nghĩa 13.1 (SVM lề cứng)
Với dữ liệu tách được tuyến tính, SVM lề cứng giải bài toán
Hàm mục tiêu là hàm bậc hai lồi với Hessian bằng ma trận đơn vị, còn các ràng buộc là affine. Đây là một bài toán quy hoạch toàn phương lồi ở đúng dạng chuẩn của Mục 12.1, nên có nghiệm duy nhất và mọi công cụ của Chương 12 đều áp dụng được.
Với sáu sinh viên tách được, mỗi người có một ràng buộc , với cho người trượt và cho người đỗ. Hai ràng buộc chặt nhất thuộc về hai người gần ngưỡng nhất: sinh viên 4 cần , sinh viên 3 cần . Trừ hai bất đẳng thức cho nhau được . Muốn nhỏ nhất thì lấy , kéo theo . Biên nằm ở 3,5 giờ, và lề rộng giờ, đúng khoảng trống từ 3 tới 4 giờ. Bốn người còn lại thoả ràng buộc với dư: sinh viên 2 và 5 có , sinh viên 1 và 6 có 5.
13.3Bài toán đối ngẫu và vector hỗ trợ#
Viết ràng buộc ở dạng chuẩn, , và lập hàm Lagrange:
Cho đạo hàm theo và bằng 0, ta được
Thay trở lại hàm Lagrange, số hạng chứa biến mất nhờ , và ta được bài toán đối ngẫu.
Định lý 13.1 (Bài toán đối ngẫu của SVM lề cứng)
Từ nghiệm , trọng số là , và bộ phân loại là .
Từ định lý rút ra ngay hai điều. Điều thứ nhất là là tổ hợp tuyến tính của các điểm dữ liệu, với trọng số . Điều thứ hai đến từ điều kiện bù (Mục 12.4): , nên chỉ có thể xảy ra với những điểm có , tức nằm đúng trên lề. Các điểm đó gọi là vector hỗ trợ. Mọi điểm khác có và không đóng góp gì vào .
Hệ số chặn tính được từ một vector hỗ trợ bất kỳ: vì và , ta có . Trên thực tế người ta lấy trung bình trên mọi vector hỗ trợ để giảm sai số số học.
Với sáu sinh viên tách được, chỉ sinh viên 3 và 4 nằm trên lề, nên chỉ và có thể khác 0. Điều kiện cho , và . Vì , ta được . Giá trị bài toán đối ngẫu là , bằng giá trị của bài toán gốc, và hệ số chặn tính từ sinh viên 4 là . Bốn sinh viên còn lại có : bỏ họ khỏi dữ liệu, nghiệm không đổi.
Thí nghiệm giải SVM bằng thư viện libsvm (qua scikit-learn) trên 120 điểm tách được, rồi kiểm tra các khẳng định trên từ nghiệm đối ngẫu:
Dung lai w tu nghiem doi ngau: lech so voi coef_ cua sklearn = 0.000e+00
Vector ho tro co thoa y_i(w.x_i + b) = 1 khong? lech lon nhat = 2.523e-08
So vector ho tro: 3 tren 120 diem (2.5%)

Doi ngau manh:
  gia tri bai toan goc  0.5*||w||^2  = 1.1037868651
  gia tri bai toan doi ngau          = 1.1037868254
  khe doi ngau                       = 3.961e-08
Le = 2/||w|| = 1.346085; khoang cach nho nhat tu diem toi sieu phang x 2 = 1.346085
Kết quả khớp với lý thuyết ở cả bốn điểm: công thức cho đúng vector trọng số của thư viện; các vector hỗ trợ nằm trên lề với sai lệch ; khe đối ngẫu bằng , tức bằng 0 trong phạm vi dung sai của bộ giải; và độ rộng lề đúng bằng hai lần khoảng cách từ điểm gần nhất tới siêu phẳng.
Chỉ 3 trong 120 điểm là vector hỗ trợ. Bỏ 117 điểm còn lại khỏi tập huấn luyện và huấn luyện lại thì nghiệm không đổi. Tính thưa này của SVM là hệ quả trực tiếp của điều kiện bù.
13.4SVM lề mềm#
Bài toán ở Định nghĩa 13.1 vô nghiệm khi dữ liệu không tách được tuyến tính, và ngay cả khi tách được, một điểm nhiễu nằm lẫn sang lớp kia có thể ép lề hẹp lại rất nhiều. SVM lề mềm (Cortes và Vapnik, 1995) cho phép vi phạm lề nhưng tính giá cho mỗi vi phạm.
Định nghĩa 13.2 (SVM lề mềm)
Với các biến bù và tham số :
Biến bù đo mức vi phạm của điểm thứ : nếu điểm nằm ngoài lề và đúng phía, nếu điểm nằm trong lề nhưng vẫn đúng phía, nếu điểm bị phân loại sai. Tại nghiệm tối ưu, , đúng bằng mất mát hinge ở Mục 6.1. Do đó bài toán tương đương với
tức mất mát hinge cộng regularization . Cách viết này cho thấy SVM lề mềm nằm trong cùng khung với hồi quy logistic có regularization: cùng mô hình tuyến tính, cùng thành phần phạt , khác nhau ở hàm mất mát. Tham số đóng vai trò nghịch đảo của hệ số regularization: lớn nghĩa là phạt vi phạm nặng, tức regularization yếu.
Bài toán đối ngẫu của SVM lề mềm giống hệt Định lý 13.1, chỉ thêm chặn trên . Điều kiện KKT chia các điểm dữ liệu thành ba nhóm, như bảng dưới.
| Nhân tử | Vị trí của điểm | Ảnh hưởng tới nghiệm |
|---|---|---|
| ngoài lề, đúng phía () | không | |
| đúng trên lề () | có | |
| vi phạm lề: trong lề hoặc sai phía () | có |
Sáu sinh viên ban đầu, với sinh viên 3 đỗ và sinh viên 4 trượt, có đủ cả ba nhóm. Dữ liệu này không tách được nên SVM lề cứng vô nghiệm. Với lề mềm và mọi , nghiệm là , : biên vẫn ở 3,5 giờ, hai mép lề ở 2 giờ và 5 giờ, lề rộng 3 giờ. Sinh viên 1 và 6 nằm ngoài lề, , nên . Sinh viên 2 và 5 nằm đúng trên mép lề, , với ; ở thì . Sinh viên 3 và 4 nằm sai phía, , nên . Tăng thêm nữa không đổi nghiệm, vì tăng chỉ làm lề hẹp lại mà không cứu được sinh viên 3 và 4: không ngưỡng nào phân loại đúng cả hai người. Ngược lại, khi nhỏ thì vi phạm rẻ và lề rộng ra: ở , , hai mép lề ở 1 giờ và 6 giờ, và cả sáu sinh viên đều là vector hỗ trợ.
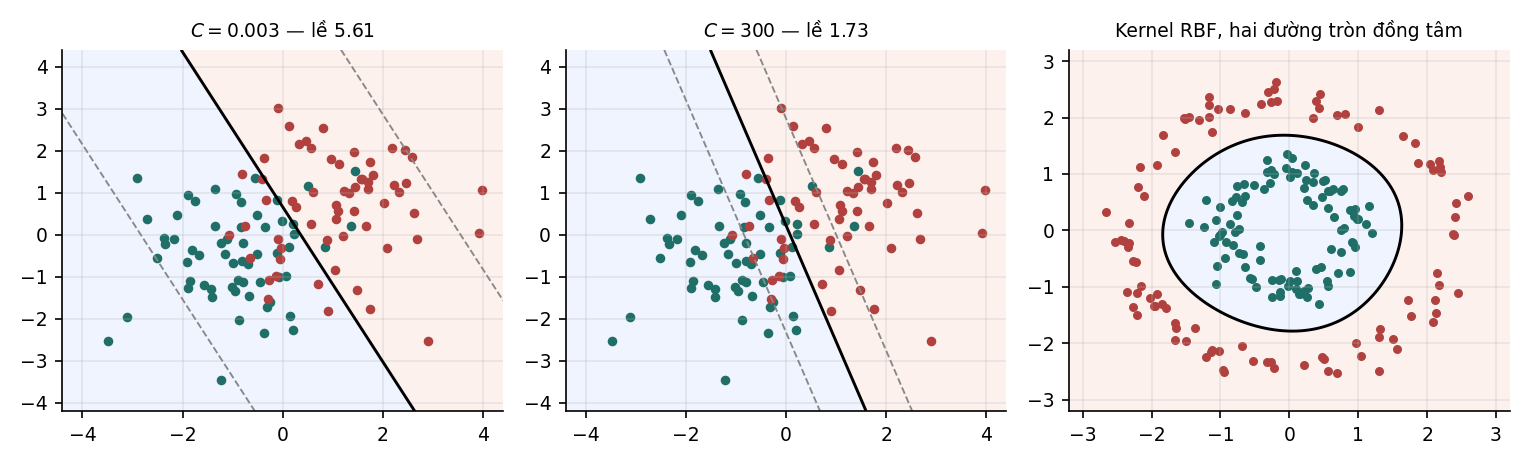
Thí nghiệm trên hai lớp chồng lấn nhau, với năm giá trị , đếm số điểm trong từng nhóm.
| Lề | Số vector hỗ trợ | Đúng trên lề | Vi phạm lề | Sai số huấn luyện | Sai số kiểm tra | |
|---|---|---|---|---|---|---|
| 0,003 | 5,6121 | 114 | 0 | 114 | 0,1500 | 0,1795 |
| 0,030 | 2,6409 | 66 | 3 | 63 | 0,1750 | 0,1727 |
| 0,300 | 1,8286 | 48 | 3 | 45 | 0,1583 | 0,1790 |
| 3,000 | 1,7312 | 45 | 3 | 42 | 0,1667 | 0,1795 |
| 300,000 | 1,7311 | 45 | 3 | 42 | 0,1667 | 0,1795 |
Với nhỏ, vi phạm rẻ nên lề rộng (5,61) và rất nhiều điểm vi phạm lề: ở , cả 114 vector hỗ trợ đều là điểm vi phạm, không điểm nào nằm đúng trên lề. Với lớn, vi phạm đắt nên lề hẹp lại (1,73) và số vector hỗ trợ giảm còn 45. Từ trở lên nghiệm gần như không đổi, vì các điểm vi phạm còn lại là những điểm nằm sâu trong vùng chồng lấn, không siêu phẳng nào tránh được, giống sinh viên 3 và 4 ở trên.
Sai số kiểm tra chỉ dao động trong khoảng 0,173 tới 0,180, tức ảnh hưởng ít tới chất lượng trong thí nghiệm này. Điều đó phản ánh bản chất của dữ liệu: biên tối ưu ở đây vốn là tuyến tính, và SVM tuyến tính không đủ linh hoạt để overfitting đáng kể. Với kernel phi tuyến, mô hình linh hoạt hơn nhiều, và trở thành siêu tham số quan trọng cần chọn bằng cross-validation.
13.5Kernel#
Bài toán đối ngẫu ở Định lý 13.1 và bộ phân loại chỉ dùng dữ liệu qua các tích vô hướng. Giả sử ta muốn biến đổi dữ liệu sang một không gian đặc trưng mới bằng ánh xạ , chẳng hạn thêm các đặc trưng bậc hai, rồi chạy SVM tuyến tính trong không gian mới. Khi đó ta chỉ cần tính được tích vô hướng trong không gian mới:
Hàm gọi là kernel. Nếu tính được trực tiếp từ và mà không cần tính , ta làm việc được trong không gian đặc trưng mà không bao giờ phải dựng nó. Kỹ thuật này gọi là thủ thuật kernel (kernel trick).
Ví dụ 13.1
Với , xét . Khai triển:
Tính trực tiếp tốn một tích vô hướng hai chiều và một phép bình phương. Chẳng hạn với và : nên ; còn và cho . Với và kernel đa thức bậc , không gian đặc trưng có số chiều cỡ , trong khi vẫn chỉ tốn .
Không phải hàm hai biến nào cũng là một kernel. Điều kiện cần và đủ, theo định lý Mercer, là với mọi tập điểm , ma trận kernel đối xứng và nửa xác định dương. Điều kiện này bảo đảm bài toán đối ngẫu vẫn lồi. Bảng dưới liệt kê ba kernel thông dụng.
| Kernel | Công thức | Không gian đặc trưng |
|---|---|---|
| Tuyến tính | chính | |
| Đa thức bậc | mọi đơn thức bậc không quá | |
| RBF (Gauss) | vô hạn chiều |
Kernel RBF cho giá trị gần 1 khi hai điểm gần nhau và gần 0 khi chúng xa nhau, nên có thể hiểu nó như một thước đo độ giống nhau. Tham số quyết định "gần" là bao xa: lớn làm mỗi điểm chỉ ảnh hưởng một vùng rất nhỏ quanh nó, biên quyết định uốn lượn theo từng điểm và dễ overfitting; nhỏ làm biên trơn. Không gian đặc trưng của kernel RBF có vô hạn chiều, nhưng mỗi lần tính kernel chỉ tốn .
Thí nghiệm trên dữ liệu hai đường tròn đồng tâm, loại dữ liệu không tách được bằng bất kỳ đường thẳng nào, cho kết quả sau.
| Kernel | Độ chính xác |
|---|---|
| Tuyến tính | 0,6150 |
| Đa thức bậc 2 | 1,0000 |
| RBF | 1,0000 |
Kernel đa thức bậc 2 đạt độ chính xác tuyệt đối vì không gian đặc trưng của nó chứa và , nên chứa , bình phương khoảng cách tới tâm, đúng là đại lượng phân biệt hai đường tròn. Ví dụ này minh hoạ một nguyên tắc chung: chọn kernel là đưa vào mô hình một giả thiết về dạng của biên quyết định.
13.6SVM nhiều lớp và chi phí tính toán#
SVM được thiết kế cho hai lớp. Có ba cách mở rộng sang lớp, tóm tắt trong bảng dưới.
| Cách | Số mô hình | Ghi chú |
|---|---|---|
| Một chọi phần còn lại (one-vs-rest) | đơn giản; điểm số của các mô hình không cùng thang đo | |
| Một chọi một (one-vs-one) | mỗi mô hình chỉ học trên dữ liệu hai lớp; cách mặc định của libsvm | |
| Crammer–Singer | 1 | một bài toán tối ưu chung cho mọi lớp; ít dùng hơn |
Điểm yếu thật sự của SVM với kernel là chi phí tính toán. Huấn luyện cần làm việc với ma trận kernel , và các thuật toán thực tế như SMO có chi phí trong khoảng tới tuỳ dữ liệu. Khi dự đoán, phải tính kernel giữa điểm mới và mọi vector hỗ trợ, mà số vector hỗ trợ thường tăng tuyến tính theo khi dữ liệu chồng lấn. Với cỡ hàng triệu, cả hai chi phí đều quá lớn, trong khi mỗi epoch của SGD trên mạng nơ-ron chỉ tốn chi phí tuyến tính theo . Vì vậy SVM với kernel ít được dùng cho dữ liệu rất lớn, và lý do không nằm ở độ chính xác.
SVM vẫn là lựa chọn tốt khi số điểm dữ liệu vừa phải, tới vài chục nghìn, số đặc trưng lớn so với số điểm, và cần một mô hình mạnh với ít siêu tham số. Với dữ liệu văn bản biểu diễn bằng vector TF-IDF, SVM tuyến tính đến nay vẫn là một mô hình cơ sở rất khó vượt qua.
13.7Tóm tắt#
SVM chọn siêu phẳng có lề lớn nhất, và với thang đo chọn sao cho điểm gần nhất có , bài toán trở thành cực tiểu dưới các ràng buộc affine, một bài toán lồi. Với sáu sinh viên tách được, SVM đặt ngưỡng ở 3,5 giờ với , , trong khi perceptron dừng ở giờ. Bài toán đối ngẫu cho , và điều kiện bù làm bằng 0 với mọi điểm không nằm trên lề, nên chỉ vài vector hỗ trợ quyết định nghiệm: sinh viên 3 và 4 với trong ví dụ, 3 trên 120 điểm trong thí nghiệm, với khe đối ngẫu cỡ . SVM lề mềm thêm biến bù và tương đương với mất mát hinge cộng regularization , với là nghịch đảo của cường độ regularization; trên sáu sinh viên ban đầu, nó chia các điểm thành ba nhóm của điều kiện KKT, với sinh viên 3 và 4 vi phạm lề ở mọi . Vì bài toán đối ngẫu chỉ dùng tích vô hướng, thay tích vô hướng bằng kernel cho biên phi tuyến mà không phải dựng không gian đặc trưng. Điểm yếu của SVM với kernel là chi phí tăng nhanh theo số điểm dữ liệu.
Mười ba chương đầu đều làm việc với dữ liệu có nhãn. Ba chương còn lại chuyển sang dữ liệu không có nhãn, bắt đầu bằng câu hỏi: trong hàng trăm đặc trưng, những hướng nào thật sự mang thông tin? Chương 14 trả lời bằng PCA.
Tự kiểm tra
6 câu. Chọn đáp án để xem ngay lời giải thích.
1SVM chọn siêu phẳng nào trong các siêu phẳng tách đúng dữ liệu?
Vì sao: Cực đại độ rộng lề tương đương cực tiểu với các ràng buộc , một bài toán quy hoạch toàn phương lồi.2Trong thí nghiệm ở Mục 13.3, có bao nhiêu vector hỗ trợ?
Vì sao: Tính thưa này là hệ quả của điều kiện bù: điểm nằm ngoài lề có và không đóng góp vào .3Điều kiện KKT chia các điểm trong SVM lề mềm thành những nhóm nào?
Vì sao: Ở Mục 13.4, với cả 114 vector hỗ trợ đều thuộc nhóm vi phạm lề và không điểm nào nằm đúng trên lề.4SVM lề mềm tương đương với bài toán nào?
Vì sao: Tại nghiệm, biến bù , đúng bằng mất mát hinge. Tham số đóng vai trò nghịch đảo của hệ số regularization.5Thủ thuật kernel cho phép làm gì?
Vì sao: Với kernel RBF, không gian đặc trưng có vô hạn chiều nhưng mỗi lần tính kernel chỉ tốn . Ở Mục 13.5, trên dữ liệu hai đường tròn đồng tâm, kernel tuyến tính đạt 0,615, còn kernel đa thức bậc 2 và RBF đều đạt 1,000.6Vì sao SVM với kernel ít được dùng cho dữ liệu rất lớn?
Vì sao: Mỗi epoch của SGD trên mạng nơ-ron chỉ tốn chi phí tuyến tính theo . SVM vẫn phù hợp khi vừa phải và lớn, như văn bản biểu diễn bằng TF-IDF.
Đã trả lời 0/6