6Phân loại tuyến tính#
Chương 4 và 5 dự đoán giá căn hộ, một số thực. Phần lớn bài toán thực tế lại cần dự đoán một lớp: thư là rác hay không, giao dịch có gian lận không, sinh viên đỗ hay trượt. Ta lấy một ví dụ nhỏ để đi suốt chương: sáu sinh viên, số giờ mỗi người ôn thi và kết quả.
| Sinh viên | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Giờ ôn | 1 | 2 | 3 | 4 | 5 | 6 |
| Kết quả | trượt | trượt | đỗ | trượt | đỗ | đỗ |
Nhìn chung ôn nhiều thì dễ đỗ hơn, nhưng sinh viên 3 ôn 3 giờ đã đỗ còn sinh viên 4 ôn 4 giờ lại trượt, nên không có ngưỡng giờ ôn nào chia đúng cả sáu người. Dữ liệu thật thường như vậy, và cách mỗi thuật toán xử lý những điểm chồng lấn như sinh viên 3 và 4 là chỗ chúng khác nhau.
Cách đơn giản nhất là dùng lại mô hình tuyến tính, nhưng lấy dấu của làm nhãn. Ba thuật toán kinh điển làm đúng như vậy: perceptron, hồi quy logistic và hồi quy softmax. Chúng dùng chung mô hình và chung cách tối ưu, chỉ khác nhau ở hàm mất mát, và chính khác biệt đó quyết định perceptron có hội tụ hay không, hồi quy logistic có cho ra xác suất hay không. Ta bắt đầu bằng việc đặt các hàm mất mát cạnh nhau.
6.1Mô hình tuyến tính và các hàm mất mát cho phân loại#
Xét bài toán phân loại hai lớp với nhãn . Một bộ phân loại tuyến tính tính điểm số rồi dự đoán lớp nếu và lớp nếu . Theo Mục 2.2, biên quyết định là một siêu phẳng. Với sáu sinh viên, một bộ phân loại tự nhiên là , tức dự đoán đỗ khi ôn hơn 3,5 giờ; nó đoán sai đúng hai người, sinh viên 3 và 4.
Định nghĩa 6.1 (Lề của một điểm)
Lề (margin) của điểm đối với bộ phân loại là
Lề dương nghĩa là điểm được phân loại đúng, lề âm nghĩa là phân loại sai, và trị tuyệt đối của lề cho biết điểm nằm xa biên quyết định tới mức nào, tỉ lệ với khoảng cách ở Định lý 2.1. Với bộ phân loại và nhãn đỗ là , trượt là , lề của sáu sinh viên là 2,5; 1,5; ; ; 1,5; 2,5. Hai người bị đoán sai có lề âm, còn hai người ở hai đầu, ôn 1 giờ và 6 giờ, nằm xa biên nhất. Mọi hàm mất mát cho phân loại hai lớp trong chương này đều viết được như một hàm của lề, như Hình 5 và bảng dưới cho thấy.
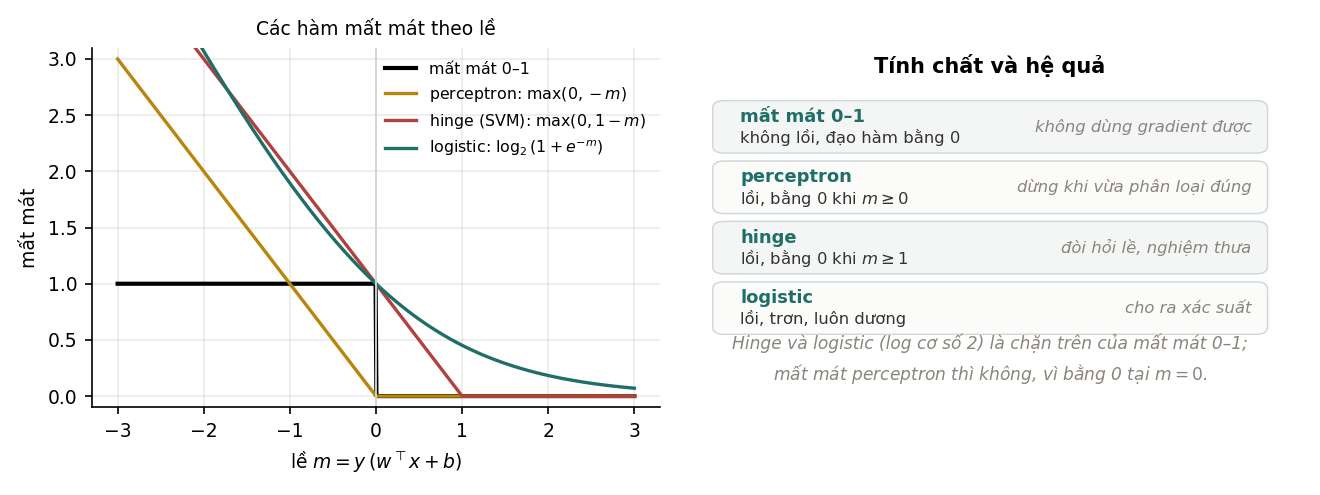
| Hàm mất mát | Công thức | Tính chất | Thuật toán tương ứng |
|---|---|---|---|
| 0–1 | không lồi, đạo hàm bằng 0 hầu khắp nơi | không tối ưu trực tiếp được | |
| Perceptron | lồi, bằng 0 khi | perceptron | |
| Hinge | lồi, bằng 0 khi | SVM (Chương 13) | |
| Logistic | lồi, trơn, luôn dương | hồi quy logistic |
Áp dụng bốn hàm mất mát cho sáu sinh viên với bộ phân loại :
| Hàm mất mát | Sinh viên 1 và 6 () | Sinh viên 2 và 5 () | Sinh viên 3 và 4 () |
|---|---|---|---|
| 0–1 | 0 | 0 | 1 |
| Perceptron | 0 | 0 | 0,5 |
| Hinge | 0 | 0 | 1,5 |
| Logistic | 0,114 | 0,291 | 1,405 |
Bảng cho thấy mỗi hàm mất mát chú ý tới ai. Perceptron chỉ phạt hai người bị đoán sai, và phạt nhẹ vì họ nằm sát biên. Hinge cũng chỉ phạt hai người đó nhưng nặng hơn, và sẽ phạt cả người được đoán đúng nếu lề của họ nhỏ hơn 1. Logistic phạt tất cả, kể cả người được đoán đúng ở xa biên, chỉ là phạt rất nhẹ: nó luôn còn lý do để đẩy các điểm ra xa biên hơn nữa.
Mất mát 0–1 đếm số điểm bị phân loại sai, đúng là thứ ta muốn giảm. Nhưng nó là hàm bậc thang: đạo hàm bằng 0 ở mọi chỗ khả vi và không tồn tại tại , nên gradient không chỉ ra hướng nào để cải thiện. Hơn nữa, bài toán cực tiểu hoá mất mát 0–1 trên một tập dữ liệu là bài toán NP-khó. Vì vậy người ta thay nó bằng một hàm thay thế lồi (convex surrogate) để có thể tối ưu bằng gradient.
Hinge và logistic viết theo logarit cơ số 2 còn là chặn trên của mất mát 0–1: với mọi , giá trị của chúng lớn hơn hoặc bằng . Do đó làm nhỏ tổng mất mát hinge hoặc logistic kéo theo làm nhỏ số điểm bị phân loại sai trên tập huấn luyện. Mất mát perceptron không có tính chất này: tại nó bằng 0 trong khi mất mát 0–1 bằng 1, và với lề âm rất nhỏ nó gần bằng 0. Đây là một cách nhìn vì sao perceptron yếu hơn hai thuật toán kia, như Mục 6.2 sẽ cho thấy bằng thí nghiệm. Dùng logarit tự nhiên thay cho cơ số 2 chỉ nhân hàm mất mát logistic với hằng số , không làm thay đổi nghiệm.
6.2Perceptron#
Perceptron (Rosenblatt, 1958) là thuật toán học đầu tiên cho bộ phân loại tuyến tính. Để đơn giản, ta gộp hệ số chặn vào bằng cách thêm thành phần hằng 1 vào như ở Chương 4.
Định nghĩa 6.2 (Thuật toán perceptron)
Khởi tạo . Lần lượt duyệt các điểm dữ liệu; mỗi khi gặp một điểm bị phân loại sai hoặc nằm đúng trên biên, tức , cập nhật
Dừng khi một lượt duyệt toàn bộ dữ liệu không có cập nhật nào.
Bước cập nhật có ý nghĩa trực quan: nếu một điểm lớp bị đoán sai, cộng vào làm tăng thêm , kéo điểm số của nó về phía dương. Quy tắc này chính là SGD trên mất mát perceptron với tốc độ học 1, vì đạo hàm của theo bằng khi và bằng 0 khi .
Với dữ liệu tách được tuyến tính, perceptron có một bảo đảm hội tụ rất gọn.
Định lý 6.1 (Novikoff, 1962)
Giả sử mọi điểm dữ liệu thoả , và tồn tại vector đơn vị sao cho với mọi (dữ liệu tách được với lề ). Khi đó perceptron thực hiện không quá lần cập nhật.
Chặn trên trong định lý không phụ thuộc số điểm dữ liệu hay số chiều , mà chỉ phụ thuộc tỉ số giữa kích thước của dữ liệu và độ rộng của lề. Thí nghiệm sinh dữ liệu tách được với lề cho trước để kiểm tra.
| Lề | Chặn | Số lần cập nhật đo được | Hội tụ | |
|---|---|---|---|---|
| 0,300 | 1,3273 | 19,5 | 4 | có |
| 0,201 | 1,2631 | 39,5 | 4 | có |
| 0,100 | 1,1703 | 136,8 | 10 | có |
| 0,050 | 1,1519 | 526,9 | 14 | có |
Ở cả bốn trường hợp, số lần cập nhật nằm dưới chặn lý thuyết, và tăng lên khi lề hẹp lại, đúng xu hướng mà định lý dự báo. Chặn khá lỏng so với số đo, điều thường gặp với các chặn trong trường hợp xấu nhất.
Trên dữ liệu không tách được tuyến tính, tình hình khác hẳn:
hoi tu = False, so lan sai sau 2000 luot = 17,977
Thuật toán không dừng. Định lý Novikoff chỉ áp dụng cho dữ liệu tách được; ngoài trường hợp đó, perceptron không có bảo đảm nào và có thể dao động mãi mãi. Nguyên nhân nhìn thấy được trên Hình 5: mất mát perceptron bằng 0 ngay khi , nên thuật toán ngừng điều chỉnh một điểm ngay khi điểm đó vừa được phân loại đúng, dù nó nằm sát biên. Khi các lớp chồng lấn, sửa một điểm sai này lại làm một điểm khác thành sai, và quá trình lặp lại không kết thúc. Sáu sinh viên là phiên bản nhỏ nhất của tình huống này: muốn đoán đúng sinh viên 3 thì ngưỡng phải dưới 3 giờ, muốn đoán đúng sinh viên 4 thì ngưỡng phải trên 4 giờ, nên mỗi lần perceptron sửa cho người này thì người kia lại sai.
6.3Hồi quy logistic#
Hồi quy logistic khắc phục hạn chế của perceptron bằng một hàm mất mát trơn và không bao giờ bằng 0. Thay vì chỉ đưa ra nhãn, mô hình đưa ra xác suất. Trong mục này ta dùng nhãn , cách viết thuận tiện hơn cho xác suất.
Định nghĩa 6.3 (Hồi quy logistic)
Mô hình hồi quy logistic cho xác suất lớp dương là
trong đó là hàm sigmoid. Tham số được học bằng cách cực tiểu hoá hàm mất mát cross-entropy
Hàm sigmoid ép mọi số thực vào khoảng , với . Nghịch đảo của nó cho một cách hiểu hệ số rất cụ thể: , tức mô hình tuyến tính đang dự đoán log tỉ lệ cược (log-odds). Tăng đặc trưng thêm một đơn vị làm log tỉ lệ cược tăng , tức nhân tỉ lệ cược với . Tên gọi "hồi quy" đến từ đây: mô hình hồi quy log tỉ lệ cược theo , dù bài toán là phân loại.
Ví dụ 6.1
Với và hệ số chặn , xác suất đỗ mà mô hình gán cho sáu sinh viên là :
Sinh viên 3 được cho 38% khả năng đỗ dù thực tế đã đỗ, sinh viên 4 được cho 62% dù đã trượt. Mỗi giờ ôn thêm nhân tỉ lệ cược đỗ với . Cross-entropy cộng cho người đỗ và cho người trượt; sáu số hạng là 0,079; 0,201; 0,974; 0,974; 0,201; 0,079, trung bình . Hai người bị đoán sai đóng góp hơn ba phần tư tổng mất mát.
Gradient của cross-entropy có dạng rất gọn. Dùng tính chất , đạo hàm của số hạng thứ theo là
Lấy trung bình trên mọi điểm, ta được
Mỗi điểm dữ liệu kéo trọng số theo hướng của chính nó, với độ mạnh bằng sai lệch giữa xác suất dự đoán và nhãn: điểm được đoán gần đúng gần như không kéo, điểm bị đoán sai kéo mạnh nhất. Ở Ví dụ 6.1, các sai lệch là 0,076; 0,182; ; 0,622; ; . Chúng có tổng bằng 0, nên đạo hàm theo hệ số chặn bằng 0, còn đạo hàm theo là . Đạo hàm âm nên tăng còn giảm được mất mát. Chạy tối ưu tới hội tụ được và hệ số chặn : biên quyết định vẫn ở 3,5 giờ, mất mát giảm còn 0,413, và mỗi giờ ôn thêm nhân tỉ lệ cược với khoảng 3,37.
Công thức có cùng dạng với gradient của hồi quy tuyến tính, : ma trận dữ liệu chuyển vị nhân với vector sai lệch giữa dự đoán và nhãn. Đây không phải trùng hợp. Mục 10.3 giải thích rằng cả hai đều là mô hình tuyến tính tổng quát với hàm liên kết chính tắc, và mọi mô hình như vậy đều có gradient dạng này.
Hàm mất mát cross-entropy của hồi quy logistic là hàm lồi theo (Mục 11.4 kiểm tra bằng số), nên gradient descent với tốc độ học phù hợp hội tụ về cực tiểu toàn cục, nếu cực tiểu đó tồn tại. Mục 6.5 trình bày trường hợp nó không tồn tại.
Lưu ý (Vì sao không dùng bình phương sai số cho phân loại)
Có hai lý do. Thứ nhất, không lồi theo , nên mất bảo đảm hội tụ về cực tiểu toàn cục. Thứ hai, khi mô hình đoán sai với độ tự tin cao, ví dụ trong khi , đạo hàm của bình phương sai số chứa thừa số nên gần như triệt tiêu, và mô hình học rất chậm từ chính những lỗi nặng nhất. Gradient của cross-entropy là , không bị triệt tiêu.
6.4Hồi quy softmax#
Khi kết quả có nhiều hơn hai mức, chẳng hạn trượt, đỗ và đỗ loại giỏi, ta có lớp. Mỗi lớp có một vector trọng số và một điểm số . Hàm softmax biến điểm số thành xác suất.
Định nghĩa 6.4 (Hồi quy softmax)
Mô hình hồi quy softmax cho
và được huấn luyện bằng cross-entropy nhiều lớp .
Softmax có một tính chất cần biết: cộng cùng một vector vào mọi không làm thay đổi xác suất, vì cả tử số và mẫu số đều nhân thêm . Do đó chỉ hiệu giữa các vector trọng số được dữ liệu xác định, còn bản thân từng vector thì không. Trên thực tế người ta cố định một vector bằng 0, hoặc thêm regularization để chọn ra một nghiệm.
Tính chất này dẫn tới một liên hệ quan trọng. Với ,
Vậy hồi quy softmax với hai lớp chính là hồi quy logistic, với vector trọng số . Thí nghiệm khớp cả hai mô hình trên cùng dữ liệu, không dùng regularization, chạy tới hội tụ:
Sai khac lon nhat giua xac suat cua logistic va cua softmax(K=2): 3.331e-16
Hieu hai cot trong so cua softmax:  [ 0.10864027  1.53215349 -1.83422929]
Trong so cua hoi quy logistic:      [ 0.10864027  1.53215349 -1.83422929]
  -> lech 1.554e-15
Tong hai cot trong so cua softmax (phai bang 0): 6.661e-16
Hai mô hình cho xác suất lệch nhau và trọng số lệch nhau , tức trùng nhau tới sai số làm tròn. Dòng cuối cho thấy thuật toán, xuất phát từ , luôn giữ tổng hai vector bằng 0, vì gradient của hai lớp luôn đối nhau.
Lưu ý (Tính softmax ổn định số học)
Khi các điểm số lớn, có thể vượt quá giới hạn của số thực dấu phẩy động. Vì cộng cùng một hằng số vào mọi điểm số không đổi kết quả, các thư viện luôn tính để số mũ lớn nhất bằng 0.
6.5Dữ liệu tách được và sự cần thiết của regularization#
Có một trường hợp hồi quy logistic không có nghiệm, và trường hợp này gặp trên thực tế nhiều hơn người ta nghĩ.
Giả sử dữ liệu tách được hoàn toàn: tồn tại sao cho mọi điểm lớp 1 có và mọi điểm lớp 0 có . Nhân với một số không đổi biên quyết định, nhưng đẩy mọi xác suất về gần 0 hoặc 1 hơn, tức gần nhãn đúng hơn, nên hàm mất mát giảm. Hàm mất mát giảm mãi khi mà không bao giờ đạt giá trị nhỏ nhất. Do đó không tồn tại nghiệm hữu hạn, và gradient descent làm tăng không giới hạn.
Sáu sinh viên cho thấy điều này bằng số. Đổi kết quả của sinh viên 3 và 4 cho nhau thì dữ liệu tách được ở ngưỡng 3,5 giờ. Giữ biên ở 3,5 giờ và tăng dần độ dốc , cross-entropy là 0,2515 ở , 0,1229 ở , 0,0431 ở và 0,0061 ở : càng dốc càng tốt, không có điểm dừng. Thí nghiệm dưới chạy gradient descent trên một tập dữ liệu tách được lớn hơn.
| Số vòng lặp | khi | khi |
|---|---|---|
| 500 | 10,164 | 3,993 |
| 2 000 | 15,930 | 3,993 |
| 10 000 | 24,703 | 3,993 |
| 50 000 | 34,784 | 3,993 |
Không có regularization, chuẩn của tăng chậm dần nhưng không có dấu hiệu dừng. Về lý thuyết, trên dữ liệu tách được, gradient descent làm tăng theo logarit của số vòng lặp, còn hướng của tiến dần tới hướng của siêu phẳng có lề lớn nhất (Soudry và cộng sự, 2018). Thêm thành phần regularization với làm hàm mất mát có cực tiểu duy nhất, và đứng yên ở 3,993 từ vòng lặp thứ 500.
Hiện tượng này có mấy hệ quả thực tế. LogisticRegression của scikit-learn mặc định dùng regularization với , trong đó là nghịch đảo của cường độ regularization, và đây là lựa chọn có chủ đích. Khi thấy hệ số hồi quy logistic lớn bất thường, nên kiểm tra xem có đặc trưng nào làm lộ nhãn không, vì dữ liệu tách được hoàn toàn thường là dấu hiệu của rò rỉ dữ liệu. Và hiện tượng tương tự xuất hiện với mạng nơ-ron phân loại, là một trong các lý do dùng weight decay (xem Chương 6 của Học sâu).
6.6Các lỗi thường gặp#
Bảng dưới gom các phát biểu sai hay gặp về phân loại tuyến tính, cùng điều đúng tương ứng.
| Phát biểu sai | Thực tế |
|---|---|
| Hồi quy logistic là thuật toán hồi quy. | Nó là thuật toán phân loại. Chữ "hồi quy" đến từ việc nó hồi quy log tỉ lệ cược theo (Mục 6.3). |
| Perceptron và SVM là hai loại mô hình khác nhau. | Cả hai dùng mô hình tuyến tính. Khác biệt nằm ở hàm mất mát: hinge bằng 0 khi thay vì , và khác biệt đó sinh ra khái niệm lề. |
| Softmax với lớp có vector trọng số độc lập. | Chỉ vector là tự do, vì cộng cùng một vector vào tất cả không đổi kết quả (Mục 6.4). |
| Xác suất do hồi quy logistic đưa ra là xác suất thật. | Chỉ đúng khi mô hình được hiệu chuẩn (calibrated) tốt. Regularization mạnh kéo xác suất về gần 0,5; lấy mẫu lại để cân bằng lớp làm xác suất lệch khỏi tỉ lệ thật. Kiểm tra bằng biểu đồ độ tin cậy (reliability diagram) và hiệu chỉnh bằng Platt scaling hoặc hồi quy isotonic trên tập xác thực. |
| Perceptron không hội tụ thì giảm tốc độ học. | Trên dữ liệu không tách được, perceptron dao động với mọi tốc độ học (khởi tạo từ 0, tốc độ học chỉ nhân với một hằng số). Vấn đề nằm ở hàm mất mát. |
6.7Tóm tắt#
Perceptron, hồi quy logistic và hồi quy softmax dùng chung mô hình tuyến tính và khác nhau ở hàm mất mát, viết được như hàm của lề . Mất mát 0–1 không tối ưu trực tiếp được, nên được thay bằng các hàm lồi; hinge và logistic là chặn trên của nó, còn mất mát perceptron thì không. Với sáu sinh viên, perceptron và hinge chỉ phạt hai người bị đoán sai, còn logistic phạt cả những người được đoán đúng nhưng chưa đủ xa biên. Perceptron hội tụ sau không quá lần cập nhật trên dữ liệu tách được, nhưng dao động mãi trên dữ liệu chồng lấn. Hồi quy logistic dự đoán log tỉ lệ cược, có gradient cùng dạng với hồi quy tuyến tính, trong đó mỗi điểm kéo trọng số theo sai lệch của chính nó; softmax hai lớp trùng với nó tới sai số làm tròn. Trên dữ liệu tách được hoàn toàn, hồi quy logistic không có nghiệm hữu hạn và cần regularization.
Cả ba thuật toán trên đều học trực tiếp một biên quyết định. Chương 7 xét hai cách tiếp cận khác: không học tham số nào mà tra cứu những điểm gần nhất, hoặc mô tả dữ liệu của từng lớp rồi suy ngược bằng định lý Bayes.
Tự kiểm tra
5 câu. Chọn đáp án để xem ngay lời giải thích.
1Perceptron, hồi quy logistic và SVM khác nhau ở đâu?
Vì sao: Mất mát 0–1 không tối ưu được bằng gradient, nên cả ba dùng hàm thay thế lồi. Hinge và logistic (theo logarit cơ số 2) còn là chặn trên của mất mát 0–1; mất mát perceptron thì không, vì nó bằng 0 tại .2Vì sao perceptron không hội tụ trên dữ liệu không tách được?
Vì sao: Ở Mục 6.2, trên dữ liệu không tách được, perceptron mắc 17 977 lỗi qua 2 000 lượt duyệt mà không dừng. Định lý Novikoff chỉ áp dụng cho dữ liệu tách được.3Hồi quy logistic và hồi quy softmax với quan hệ thế nào?
Vì sao: Ở Mục 6.4, khớp cả hai mô hình tới hội tụ, xác suất lệch nhau và trọng số lệch nhau , tức trùng nhau tới sai số làm tròn.4Vì sao hồi quy logistic thường cần regularization?
Vì sao: Ở Mục 6.5, không có regularization thì tăng từ 10,2 lên 34,8 khi số vòng lặp tăng từ 500 lên 50 000; với , đứng yên ở 3,993.5Gradient của cross-entropy trong hồi quy logistic có dạng nào?
Vì sao: Nhờ , các thừa số rút gọn còn cho mỗi điểm. Dạng này giống gradient của hồi quy tuyến tính vì cả hai là mô hình tuyến tính tổng quát với hàm liên kết chính tắc.
Đã trả lời 0/5