15Phân cụm K-means#
Phân cụm là bài toán học không giám sát điển hình: chia dữ liệu không có nhãn thành các nhóm sao cho điểm trong cùng nhóm giống nhau hơn điểm khác nhóm. Thuật toán phổ biến nhất cho việc này, K-means, đơn giản tới mức có thể mô tả trong hai câu. Nhưng khi dùng thật, nó đặt ra ba câu hỏi mà người mới hay bỏ qua: kết quả có phụ thuộc vào cách khởi tạo không, thuật toán ngầm giả định cụm có hình dạng gì, và chọn số cụm thế nào khi không có nhãn để đối chiếu. Ta xét thuật toán trước, rồi lần lượt trả lời ba câu hỏi đó, mỗi câu trước hết trên một ví dụ tính tay được rồi mới bằng thí nghiệm. Ví dụ đó là bốn cửa hàng trên bản đồ, hai cửa hàng phía tây ở và , hai cửa hàng phía đông ở và , toạ độ tính bằng km. Cần đặt hai kho hàng sao cho tổng bình phương khoảng cách từ mỗi cửa hàng tới kho gần nó nhất là nhỏ nhất, và đó đúng là bài toán K-means với .
15.1Bài toán phân cụm và thuật toán Lloyd#
Định nghĩa 15.1 (Bài toán K-means)
Cho điểm và số cụm . Tìm cách chia các điểm thành cụm cùng các tâm cụm để cực tiểu tổng bình phương khoảng cách từ mỗi điểm tới tâm cụm của nó:
Giá trị của hàm mục tiêu tại một nghiệm gọi là inertia (tổng bình phương trong cụm).
Tìm nghiệm tối ưu toàn cục của bài toán này là NP-khó, kể cả khi với số chiều tuỳ ý, hoặc khi dữ liệu nằm trong mặt phẳng với tuỳ ý. Thuật toán thông dụng là thuật toán Lloyd (1957, công bố 1982), tìm nghiệm xấp xỉ bằng cách lặp lại hai bước. Ở bước gán, mỗi điểm được gán vào cụm có tâm gần nó nhất. Ở bước cập nhật, mỗi tâm được thay bằng trung bình của các điểm thuộc cụm đó. Hai bước lặp lại cho tới khi các phép gán không thay đổi.
Với bốn cửa hàng, đặt hai tâm ban đầu tại và . Bước gán đưa về tâm thứ nhất và về tâm thứ hai. Bước cập nhật dời hai tâm tới trung điểm của mỗi cặp, và . Bước gán tiếp theo không đổi gì, và thuật toán dừng với mỗi kho nằm giữa hai cửa hàng cùng phía, inertia .
Mỗi bước tối ưu một phần của bài toán khi giữ phần kia cố định: bước gán chọn cụm tốt nhất cho từng điểm khi biết tâm, còn bước cập nhật chọn tâm tốt nhất cho từng cụm khi biết các điểm, vì trung bình là điểm làm tổng bình phương khoảng cách nhỏ nhất. Vì vậy hàm mục tiêu không bao giờ tăng. Số cách chia điểm thành cụm là hữu hạn, nên thuật toán chắc chắn dừng sau hữu hạn bước, và mỗi vòng lặp tốn phép tính.
Tuy nhiên, thuật toán chỉ dừng ở một cực tiểu địa phương: một trạng thái mà không bước nào cải thiện được, nhưng chưa chắc tốt nhất. Hàm mục tiêu không lồi theo , nên theo Chương 11 không có bảo đảm nào về chất lượng của điểm dừng. Với bốn cửa hàng, đặt hai tâm ban đầu tại và , tức cả hai ở phía tây. Bước gán đưa về tâm thứ nhất và về tâm thứ hai, vì mỗi cửa hàng phía đông gần tâm cùng hàng với nó hơn. Bước cập nhật dời hai tâm tới và , và từ đó không gì thay đổi nữa: mỗi cửa hàng cách kho của nó 2 km, inertia bằng 16, gấp 16 lần nghiệm tốt nhất.
15.2Khởi tạo và k-means++#
Điểm dừng của thuật toán Lloyd phụ thuộc vào các tâm ban đầu, và mức độ phụ thuộc lớn hơn nhiều so với hình dung. Thí nghiệm chạy K-means 200 lần trên dữ liệu 720 điểm gồm 8 cụm, trong đó một số cụm nằm gần nhau, mỗi lần với một hạt giống ngẫu nhiên khác. Một lần chạy được tính là "kẹt ở nghiệm tồi" nếu inertia lớn hơn giá trị nhỏ nhất tìm được trong mọi lần chạy quá 2%.
| Cách khởi tạo | Inertia nhỏ nhất | Inertia trung bình | Tỉ lệ kẹt ở nghiệm tồi |
|---|---|---|---|
| Ngẫu nhiên | 407,992 | 517,838 | 71,5% |
| k-means++ | 407,992 | 476,529 | 46,5% |
Chọn ngẫu nhiên điểm dữ liệu làm tâm ban đầu dẫn tới nghiệm tồi trong 71,5% số lần chạy. Ngay với bốn cửa hàng, tỉ lệ này đã là 1/3: trong 6 cặp điểm có thể chọn làm tâm ban đầu, 2 cặp nằm cùng phía và dẫn tới nghiệm có inertia 16. Nghiệm tồi điển hình là hai tâm rơi vào cùng một cụm thật trong khi hai cụm thật khác bị gộp chung một tâm; thuật toán Lloyd không sửa được tình huống này, vì mỗi bước chỉ dịch chuyển tâm một cách cục bộ.
Cách khởi tạo k-means++ (Arthur và Vassilvitskii, 2007) chọn tâm ban đầu tuần tự: tâm đầu tiên chọn ngẫu nhiên đều từ dữ liệu, mỗi tâm tiếp theo được chọn với xác suất tỉ lệ với bình phương khoảng cách từ điểm đó tới tâm gần nhất đã chọn. Các điểm xa những tâm hiện có được ưu tiên, nên các tâm ban đầu có xu hướng trải đều ra các cụm. Với bốn cửa hàng, giả sử tâm đầu tiên là . Bình phương khoảng cách từ ba cửa hàng còn lại tới nó là 1, 16 và 17, nên xác suất tâm thứ hai rơi vào , cùng phía với tâm đầu, chỉ là . Do tính đối xứng, tâm đầu là cửa hàng nào cũng vậy, nên k-means++ kẹt với xác suất khoảng 3% thay vì 33%. Arthur và Vassilvitskii chứng minh rằng riêng bước khởi tạo này đã cho kỳ vọng inertia không quá lần giá trị tối ưu. Trong thí nghiệm, k-means++ giảm tỉ lệ kẹt từ 71,5% xuống 46,5%: cải thiện rõ, nhưng vẫn gần một nửa số lần chạy cho nghiệm tồi, vì với 8 cụm trong đó có những cụm nằm gần nhau, bình phương khoảng cách không chênh lệch rõ như ở bốn cửa hàng.
Lưu ý
Luôn chạy K-means nhiều lần với các khởi tạo khác nhau và giữ kết quả có inertia nhỏ nhất. Trong scikit-learn từ phiên bản 1.4, tham số
n_initcủaKMeansmặc định là'auto', nghĩa là chỉ chạy một lần khi dùng khởi tạo k-means++. Với dữ liệu như thí nghiệm trên, cần đặtn_inittường minh, chẳng hạnn_init=10.
15.3Các giả định của K-means#
Câu hỏi thứ hai là K-means ngầm giả định gì về dữ liệu. Thí nghiệm chạy cùng thuật toán trên ba dạng dữ liệu.
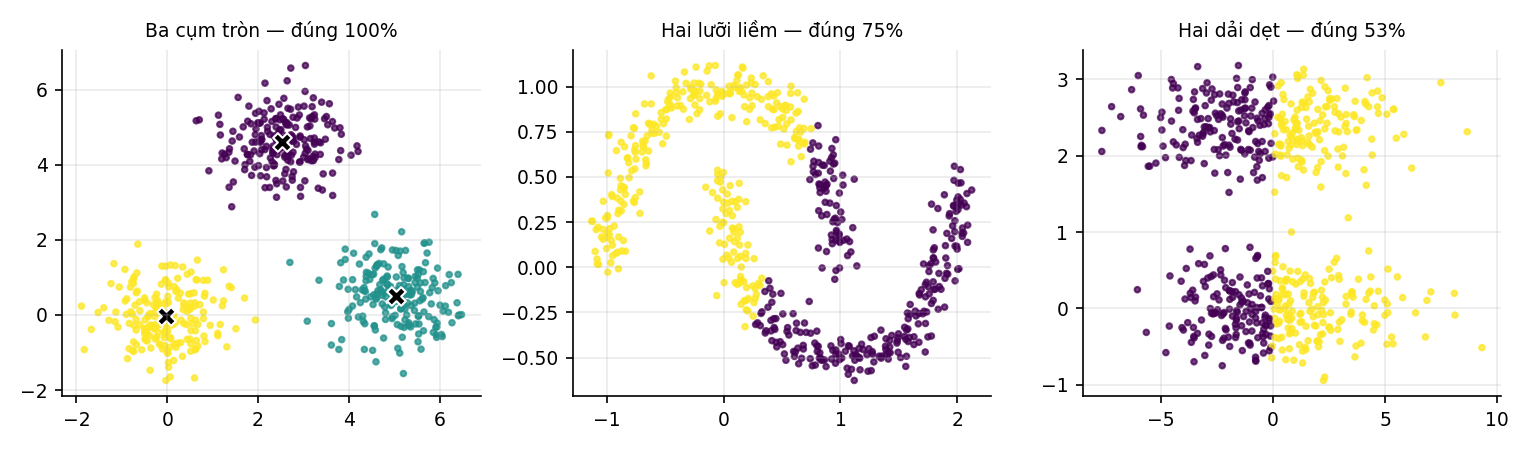
| Dạng cụm | Độ chính xác phân cụm |
|---|---|
| Ba cụm tròn, tách rời | 1,0000 |
| Hai hình lưỡi liềm lồng nhau | 0,7517 |
| Hai dải dẹt nằm ngang song song | 0,5317 |
Độ chính xác phân cụm ở đây được tính sau khi thử mọi cách ghép nhãn cụm với nhãn thật và lấy cách tốt nhất, vì tên cụm do K-means đặt là tuỳ ý. Với hai dải dẹt, độ chính xác 0,5317 gần như bằng đoán ngẫu nhiên (0,5).
Nguyên nhân nằm ở bước gán. Mỗi điểm thuộc về tâm gần nhất theo khoảng cách Euclid, nên biên giới giữa hai cụm luôn là mặt phẳng trung trực của đoạn nối hai tâm, và toàn bộ không gian bị chia thành các ô lồi gọi là sơ đồ Voronoi. Từ đó suy ra ba giả định ngầm của K-means: các cụm có dạng lồi và gần tròn, các cụm có kích thước tương đương nhau, và mọi chiều có cùng thang đo để khoảng cách Euclid có ý nghĩa.
Hai dải dẹt vi phạm giả định thứ nhất. Mỗi dải dài theo phương ngang và hẹp theo phương dọc, và hai dải cách nhau theo phương dọc một khoảng nhỏ hơn chiều dài của chúng. Cách chia có inertia nhỏ nhất vì vậy là cắt đôi theo phương thẳng đứng, mỗi cụm lấy nửa trái hoặc nửa phải của cả hai dải, thay vì tách hai dải ra. Bốn cửa hàng là phiên bản nhỏ nhất của tình huống này. Nếu hai nhóm cần tìm là hai hàng ngang và , chẳng hạn hai tuyến đường giao hàng, thì cách chia theo hàng có inertia 16, còn cách chia trái phải có inertia 1, nên K-means luôn chọn trái phải.
Khi các giả định trên không thoả, có các phương pháp khác. Mô hình hỗn hợp Gauss (Gaussian mixture model) cho phép mỗi cụm có dạng elip với ma trận hiệp phương sai riêng, và K-means là trường hợp giới hạn của nó khi mọi cụm có hiệp phương sai với . DBSCAN gom các điểm theo mật độ, cho phép cụm có hình dạng tuỳ ý và tự xác định số cụm. Phân cụm phổ (spectral clustering) biến đổi dữ liệu dựa trên đồ thị láng giềng rồi mới áp dụng K-means, và xử lý tốt dữ liệu hình lưỡi liềm.
15.4Chọn số cụm#
Câu hỏi thứ ba là chọn . Inertia luôn giảm khi tăng, và bằng 0 khi , tức mỗi điểm là một cụm, nên không thể chọn bằng cách cực tiểu inertia. Với bốn cửa hàng, inertia tốt nhất là 17, 1, 0,5 và 0 với : giảm 16 khi tăng từ một lên hai kho, rồi chỉ giảm 0,5 mỗi bước sau đó. Thêm kho thứ ba gần như không rút ngắn được quãng đường nào. Bảng sau cho inertia tốt nhất trong 8 lần chạy k-means++ ở mỗi , trên dữ liệu 8 cụm của Mục 15.2.
| Inertia | Giảm so với | |
|---|---|---|
| 5 | 902,24 | 21,6% |
| 6 | 727,79 | 19,3% |
| 7 | 563,93 | 22,5% |
| 8 | 407,99 | 27,7% |
| 9 | 385,82 | 5,4% |
| 10 | 364,76 | 5,5% |
Mức giảm là 27,7% khi tăng lên và chỉ 5,4% khi tăng lên . Điểm mà inertia ngừng giảm nhanh gọi là khuỷu tay (elbow) của đồ thị inertia theo , và ở đây nó rơi đúng vào số cụm thật. Cách chọn tại khuỷu tay gọi là phương pháp elbow.
Lưu ý
Khuỷu tay không có định nghĩa toán học; nó là một quy tắc quan sát bằng mắt, và trên dữ liệu thật đồ thị thường giảm đều, không có khuỷu rõ ràng. Hai tiêu chí khác có định nghĩa chặt hơn. Hệ số silhouette của một điểm là , với là khoảng cách trung bình tới các điểm cùng cụm và là khoảng cách trung bình tới các điểm của cụm gần nhất khác; ta chọn có silhouette trung bình lớn nhất. Gap statistic (Tibshirani, Walther và Hastie, 2001) so sánh inertia với inertia trên dữ liệu ngẫu nhiên không có cấu trúc cụm. Trong nhiều ứng dụng, còn được quyết định bởi yêu cầu nghiệp vụ, chẳng hạn số nhóm khách hàng mà bộ phận marketing có thể xử lý.
15.5Tóm tắt#
K-means chia dữ liệu thành cụm để cực tiểu tổng bình phương khoảng cách tới tâm, và thuật toán Lloyd lặp giữa bước gán và bước cập nhật, không bao giờ làm tăng hàm mục tiêu nhưng chỉ dừng ở cực tiểu địa phương: với bốn cửa hàng, hai tâm ban đầu cùng phía cho inertia 16 thay vì 1. Kết quả phụ thuộc mạnh vào khởi tạo. Với bốn cửa hàng, khởi tạo ngẫu nhiên kẹt với xác suất 1/3 và k-means++ chỉ 1/34; trong thí nghiệm 8 cụm, khởi tạo ngẫu nhiên kẹt ở nghiệm tồi 71,5% số lần, k-means++ vẫn 46,5%, nên cần chạy nhiều lần. Vì bước gán chia không gian thành các ô lồi, K-means giả định cụm lồi, gần tròn, cỡ tương đương và các chiều cùng thang đo; với hai dải dẹt song song, nó chỉ đạt 0,5317. Số cụm được chọn bằng khuỷu tay của đồ thị inertia, hệ số silhouette, gap statistic hoặc yêu cầu nghiệp vụ.
PCA và K-means tìm cấu trúc trong một ma trận dữ liệu đầy đủ. Chương cuối xét một bài toán mà phần lớn ma trận bị trống, và cấu trúc hạng thấp của nó là thứ duy nhất cho phép điền vào các ô trống: hệ thống gợi ý.
Tự kiểm tra
4 câu. Chọn đáp án để xem ngay lời giải thích.
1Thuật toán K-means (Lloyd) bảo đảm điều gì?
Vì sao: Cả bước gán và bước cập nhật đều không làm tăng hàm mục tiêu, và số cách chia là hữu hạn, nên thuật toán chắc chắn dừng; điểm dừng phụ thuộc vào khởi tạo.2Trong thí nghiệm ở Mục 15.2, k-means++ cải thiện được bao nhiêu?
Vì sao: Vẫn cần chạy nhiều lần và giữ kết quả có inertia nhỏ nhất. Trong scikit-learn từ phiên bản 1.4,KMeansmặc địnhn_init='auto', tức chỉ chạy một lần với k-means++, nên cần đặtn_inittường minh.3Các giả định ngầm của K-means là gì?
Vì sao: Vì mỗi điểm được gán cho tâm gần nhất theo khoảng cách Euclid, biên giữa hai cụm luôn là một siêu phẳng. Ở Mục 15.3: ba cụm tròn đạt độ chính xác 100%, hai hình lưỡi liềm 75%, hai dải dẹt 53%.4Vì sao không chọn số cụm bằng cách cực tiểu inertia?
Vì sao: Phương pháp elbow tìm chỗ inertia ngừng giảm nhanh: trên dữ liệu 8 cụm, mức giảm là 27,7% khi lên và 5,4% khi lên . Trên dữ liệu thật, có thể dùng thêm hệ số silhouette hoặc gap statistic.
Đã trả lời 0/4